--robust; domyślny wariant to zwykle HC1, a przy N ≤ 250 warto ustawić HC3.Gretl na zajęciach z ekonometrii: co znajdziesz w tym wpisie
Gretl to program do ekonometrii. Jeśli pracujesz w nim na zajęciach z ekonomii, finansów lub zarządzania, ten wpis prowadzi przez jedną analizę od początku do końca: import pliku CSV, model metodą najmniejszych kwadratów (KMNK, ang. OLS), odczyt okna modelu, testy diagnostyczne i błędy odporne. Na końcu dostajesz tabelę i zdania do pracy.
Trzy zasady tego wpisu:
- Nazwy menu podajemy po angielsku, tak jak w oficjalnej dokumentacji poleceń Gretla (Cottrell i Lucchetti, b.d.-a). Polskich etykiet nie potwierdziliśmy w dokumentacji, więc jeśli korzystasz z interfejsu po polsku, nazwy mogą brzmieć inaczej.
- Liczby policzyliśmy w R na danych symulowanych. Współczynniki, błędy standardowe, t, p, R² i F w KMNK to te same wzory w każdym programie, więc Gretl na tym samym pliku powinien dać te same wartości (z dokładnością do zaokrągleń). Przy testach diagnostycznych i kryteriach informacyjnych zaznaczamy, gdzie programy mogą liczyć różne warianty.
Model, założenia i interpretację współczynników omawia poradnik regresja wieloraka krok po kroku, a pełną weryfikację modelu ekonometrycznego – wpis statystyka w pracy z zarządzania i ekonomii. Tutaj skupiamy się na tym, gdzie co jest w Gretlu i jak przepisać to do pracy.
Przykład i plik CSV do pobrania
Przykład jest fikcyjny: 160 pracowników, dla których znamy płacę i cztery cechy. Pytanie brzmi: czy wykształcenie wyższe i szkolenia wiążą się z wyższą płacą przy kontroli stażu i wieku?
| Zmienna | Opis | M | SD |
|---|---|---|---|
placa | płaca miesięczna brutto, tys. zł (zmienna zależna) | 6.34 | 1.52 |
staz | staż pracy w latach | 12.93 | 9.81 |
wiek | wiek w latach | 40.07 | 9.81 |
wyzsze | wykształcenie wyższe: 1 = tak, 0 = nie (odsetek 59%) | 0.59 | 0.49 |
szkolenia | godziny szkoleń w ostatnim roku | 17.23 | 11.42 |
Pobierz plik CSV. Kolumny są rozdzielone przecinkiem, a liczby mają kropkę dziesiętną. Staż i wiek są silnie skorelowane (r = .96) – celowo, bo pokażemy na tym diagnozę współliniowości.
Krok 1. Import CSV: File → Open data
Plik otwórz z menu File → Open data. To samo robi polecenie open, a plik można też przeciągnąć na główne okno programu (Cottrell i Lucchetti, b.d.-a). Gretl sam rozpoznaje format pliku po nazwie i zawartości.
Dokumentacja polecenia open mówi o pliku tekstowym trzy rzeczy, które warto znać przed importem (Cottrell i Lucchetti, b.d.-a):
- Separator. Gretl oczekuje kolumn rozdzielonych w standardowy sposób: przecinkiem, tabulatorem, spacją lub średnikiem.
- Pierwsza kolumna. Jeśli jej nagłówek jest pusty albo brzmi np. „obs”, „date” lub „year”, Gretl może potraktować ją jako etykiety obserwacji lub daty, a nie jako zmienną. Gdy to nie jest zamierzone, zmień nagłówek albo w skrypcie dodaj opcję
--all-cols. - Kody braków. W kolumnach liczbowych Gretl domyślnie czyta jako brak danych nie tylko pustą komórkę i „NA”, ale też m.in. „.”, „-999” i „-9999” (ustawienie
csv_read_na). Jeśli −999 to u Ciebie prawdziwa wartość, zmień to ustawienie. Jeśli brak oznaczasz innym kodem, np. 99, Gretl potraktuje go jak liczbę.
Plik z Excela zapisz jako CSV z kropką dziesiętną. Pułapki eksportu opisuje wpis import z Excela do SPSS i R. Format pliku wyjaśnia hasło plik CSV.
Po imporcie sprawdź dane: View → Summary statistics (polecenie summary) pokazuje m.in. średnią, medianę, minimum, maksimum, odchylenie standardowe i liczbę braków, a View → Correlation matrix (polecenie corr) – korelacje Pearsona (Cottrell i Lucchetti, b.d.-a).
Krok 2. Model KMNK: Model → Ordinary Least Squares
Model otwórz z menu Model → Ordinary Least Squares albo przyciskiem z symbolem β z daszkiem (Beta-hat) na pasku narzędzi (Cottrell i Lucchetti, b.d.-a). W oknie specyfikacji wskaż:
- zmienną zależną:
placa; - zmienne niezależne (regresory):
staz,wiek,wyzsze,szkolenia; - stałą
const. W skrypcie stała to zmienna o numerze 0, np.ols placa 0 staz wiek wyzsze szkolenia.
Dokumentacja poleceń w HTML nie opisuje wyglądu okna specyfikacji, dlatego nie podajemy nazw jego pól. Po zatwierdzeniu otwiera się okno modelu z wydrukiem i własnym menu. Z niego uruchomisz testy z kroku 4.
Krok 3. Tabela współczynników: co znaczy każda kolumna
Według dokumentacji ols drukuje współczynniki, błędy standardowe, dwustronne wartości p dla statystyk t oraz statystykę F. Cztery kolumny tabeli to coefficient, standard error, t-ratio i p-value. W oknie modelu nagłówki mogą być skrócone (Cottrell i Lucchetti, b.d.-a).
| coefficient | standard error | t-ratio | p-value | ||
|---|---|---|---|---|---|
| const | 5.3000 | 1.0570 | 5.014 | < .001 | *** |
| staz | 0.1236 | 0.0369 | 3.347 | .001 | *** |
| wiek | −0.0376 | 0.0369 | −1.020 | .309 | |
| wyzsze | 0.8977 | 0.1952 | 4.598 | < .001 | *** |
| szkolenia | 0.0245 | 0.0085 | 2.885 | .004 | *** |
Kolejne kolumny:
- coefficient – oszacowanie b. Osoba z wykształceniem wyższym zarabia średnio o 0.90 tys. zł więcej niż osoba bez niego, przy tym samym stażu, wieku i liczbie godzin szkoleń. Każda godzina szkoleń to średnio 0.0245 tys. zł (ok. 25 zł) więcej.
- standard error – błąd standardowy, czyli niepewność oszacowania b. Zależy od założeń o składniku losowym (krok 5).
- t-ratio – współczynnik podzielony przez błąd standardowy, np. 0.8977 / 0.1952 = 4.598.
- p-value – dwustronna wartość p testu H0: współczynnik = 0. Liczba stopni swobody to n − k = 160 − 5 = 155.
Uwaga na gwiazdki. Gretl oznacza *** wynik z p poniżej .01, ** – od .01 do .05, a * – od .05 do .10 (Cottrell i Lucchetti, b.d.-a). To inna skala niż w R czy w zwyczaju APA. Dla szkoleń (p = .004) Gretl pokaże ***, a R tylko **, bo w R trzy gwiazdki oznaczają p < .001. Jedna gwiazdka w Gretlu nie oznacza wyniku istotnego przy α = .05. Jeśli przyjąłeś poziom .05, wynik z jedną gwiazdką opisz jako nieistotny, a nie jako „trend” (zob. marginalna istotność). W pracy podawaj dokładne p, a gwiazdki pomiń albo opisz w nocie tabeli.
Współczynnik wieku jest nieistotny, a współczynnik stażu – istotny. Oba są jednak oszacowane z dużym błędem, bo staż i wiek niosą prawie tę samą informację. Wrócimy do tego przy VIF.
Pod tabelą: R², F i kryteria informacyjne
Pod tabelą współczynników jest blok statystyk modelu. Poniżej opisujemy tylko te, które wymienia dokumentacja (Cottrell i Lucchetti, b.d.-a, b.d.-b):
| Statystyka | Akcesor w skrypcie | Model 1 | Jak czytać |
|---|---|---|---|
| R² (nieskorygowany) | $rsq | .388 | model wyjaśnia 38.8% wariancji płacy |
| statystyka F i jej p | $Fstat | F(4, 155) = 24.53, p < .001 | czy regresory razem wyjaśniają coś ponad samą średnią |
| błąd standardowy regresji | $sigma | 1.204 | typowy rozrzut płacy wokół prognozy, tys. zł |
| log-wiarygodność | $lnl | −254.157 | podstawa kryteriów informacyjnych |
| kryterium Akaikego (AIC) | $aic | 518.315 | porównanie modeli: mniejsze = lepsze |
| kryterium Schwarza (BIC) | $bic | 533.690 | jak AIC, ale mocniej karze za liczbę parametrów |
| kryterium Hannana–Quinna (HQC) | $hqc | 524.558 | jak wyżej, kara pośrednia |
Pomocne są hasła R-kwadrat skorygowany i AIC i BIC w regresji. Dwie uwagi:
- R² skorygowany wynosi tu .372. Dokumentacja HTML wymienia akcesor tylko dla nieskorygowanego R², więc nie podajemy etykiety tej pozycji w wydruku. Odczytaj ją z okna modelu i porównaj z wartością z tego wpisu.
- AIC zależy od tego, co liczy się jako parametr. Dokumentacja podaje wzór Akaikego (1974): minus dwa razy maksymalna log-wiarygodność plus dwa razy liczba szacowanych parametrów. Przy pięciu współczynnikach daje to 518.315. Funkcja
AIC()w R wlicza też wariancję reszt i podaje 520.315. Nie porównuj więc AIC z dwóch programów. BIC i HQC liczyliśmy też z pięcioma parametrami.
Statystyka F testuje hipotezę, że wszystkie współczynniki poza stałą są równe zero. Samo R² nie mówi, czy model jest poprawny – to sprawdzają testy z następnego kroku.
Krok 4. Testy diagnostyczne z okna modelu
Testy uruchamiasz z menu Tests w oknie modelu. Dokumentacja opisuje je jako opcje polecenia modtest oraz osobne polecenia reset i vif (Cottrell i Lucchetti, b.d.-a). Dokładne nazwy pozycji w menu Tests potwierdziliśmy tylko dla testu RESET. Pozostałe testy szukaj w tym samym menu po nazwie.
| Test | Gdzie w Gretlu | H0 | Wynik |
|---|---|---|---|
| test White’a (z iloczynami) | okno modelu, Tests; modtest --white | homoskedastyczność | LM = 33.50, df = 13, p = .001 |
| test Breuscha–Pagana | okno modelu, Tests; modtest --breusch-pagan | homoskedastyczność | LM = 62.06, df = 4, p < .001 |
| Breusch–Pagan, wariant Koenkera | modtest --breusch-pagan --robust | homoskedastyczność | LM = 28.53, df = 4, p < .001 |
| normalność reszt (Doornik–Hansen) | okno modelu, Tests; modtest --normality | reszty z rozkładu normalnego | nie liczyliśmy – odczytaj w Gretlu |
| test RESET Ramseya | Tests → Ramsey's RESET; reset | poprawna postać funkcyjna | F(2, 153) = 0.40, p = .673 |
| VIF | Analysis → Collinearity; vif | (to nie test) | staż 14.42, wiek 14.38, wyższe 1.02, szkolenia 1.03 |
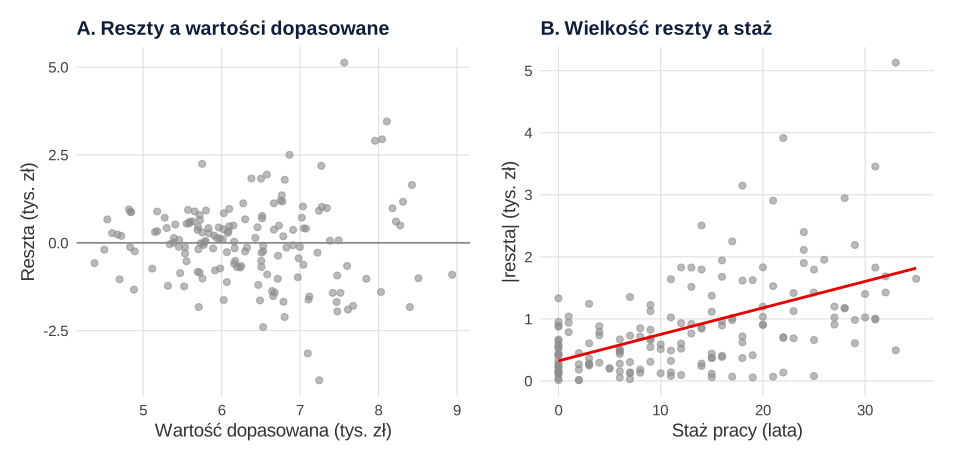
series uh = $uhat (Cottrell i Lucchetti, b.d.-a) i narysujesz je względem stażu. Obliczenia: R (dane symulowane).Heteroskedastyczność: White i Breusch–Pagan
Oba testy sprawdzają, czy wariancja składnika losowego jest stała (homoskedastyczność). Test Breuscha–Pagana to test mnożnika Lagrange’a liczony z reszt KMNK (Breusch i Pagan, 1979). Test White’a nie wymaga określenia postaci heteroskedastyczności (White, 1980). W Gretlu test White’a ma też wersję tylko z kwadratami, bez iloczynów (--white-nocross). Tutaj wszystkie wersje odrzucają H0, co zgadza się z rysunkiem 1.
Pułapka: dwa warianty testu Breuscha–Pagana. Bez dodatkowej opcji Gretl liczy wersję pierwotną. Opcja --robust daje wariant z estymatorem wariancji zaproponowanym przez Koenkera (1981), mniej wrażliwy na brak normalności (Cottrell i Lucchetti, b.d.-a). Funkcja bptest() z pakietu lmtest w R domyślnie liczy właśnie wersję studentyzowaną. Stąd dwie różne liczby dla „tego samego” testu: 62.06 i 28.53. W pracy napisz, którego wariantu użyłeś.
Normalność reszt: test Doornika–Hansena
Opcja --normality uruchamia test Doornika–Hansena (Cottrell i Lucchetti, b.d.-a). To test oparty na skośności i kurtozie, który dobrze trzyma poziom istotności już przy małych próbach (Doornik i Hansen, 2008). To inny test niż Jarque–Bera czy Shapiro–Wilk, więc jego wartości nie porównuj z wynikami z innych programów. Szerzej: normalność reszt czy zmiennych i reszty regresji.
RESET: postać funkcyjna
Polecenie reset dodaje do modelu kwadraty i sześciany wartości dopasowanych i testem F sprawdza, czy coś wnoszą. Opcje --squares-only i --cubes-only ograniczają test do jednej potęgi (Cottrell i Lucchetti, b.d.-a). To jedna z procedur wykrywania błędów specyfikacji opisanych przez Ramseya (1969). Tu p = .673, więc nie ma sygnału, że liniowa postać modelu jest zła.
Współliniowość: Analysis → Collinearity
Pozycja Analysis → Collinearity w oknie modelu (polecenie vif) podaje VIF dla każdego regresora. Dokumentacja przypomina, że minimum VIF to 1, a wartość powyżej 10 bywa uznawana za problem (Cottrell i Lucchetti, b.d.-a). Staż i wiek mają VIF około 14. Dlatego błąd standardowy stażu wynosi 0.0369. Po usunięciu wieku z modelu spada do 0.0099, a współczynnik stażu zmienia się z 0.1236 na 0.0873. R² prawie się nie zmienia (.384 zamiast .388).
Nie usuwaj jednak zmiennej tylko z powodu VIF. Zdecyduj na podstawie pytania badawczego: czy chcesz znać efekt stażu przy stałym wieku, czy efekt stażu w ogóle. Opcje opisuje wpis wysoki VIF – co zrobić ze współliniowością. Tu pytanie dotyczy wykształcenia i szkoleń, a ich VIF wynosi około 1.
Krok 5. Błędy odporne (HC) w Gretlu
Heteroskedastyczność nie obciąża współczynników KMNK, ale zaburza ich błędy standardowe, a przez to testy i przedziały ufności. Dlatego zaleca się błędy standardowe odporne na heteroskedastyczność (Hayes i Cai, 2007). W Gretlu robi to opcja --robust polecenia ols. Dokumentacja podaje kilka szczegółów, które warto znać (Cottrell i Lucchetti, b.d.-a):
- Wariant HC ustawia
set hc_version: 0, 1, 2, 3 albo 3a. HC0 to „błędy White’a”, a 3a to procedura jackknife. - Domyślnie zwykle HC1. W interfejsie zmienisz to na karcie HCCME w Tools → Preferences → General. Ustawienie z interfejsu obowiązuje także w kolejnych sesjach, a
setw skrypcie – tylko w bieżącej. - Wartości p przy błędach odpornych Gretl domyślnie liczy z rozkładu t. Ustawienie
robust_zprzełącza na rozkład normalny. - Opcja
--clusterdaje błędy odporne na klastrowanie, gdy obserwacje są pogrupowane, np. pracownicy w firmach.
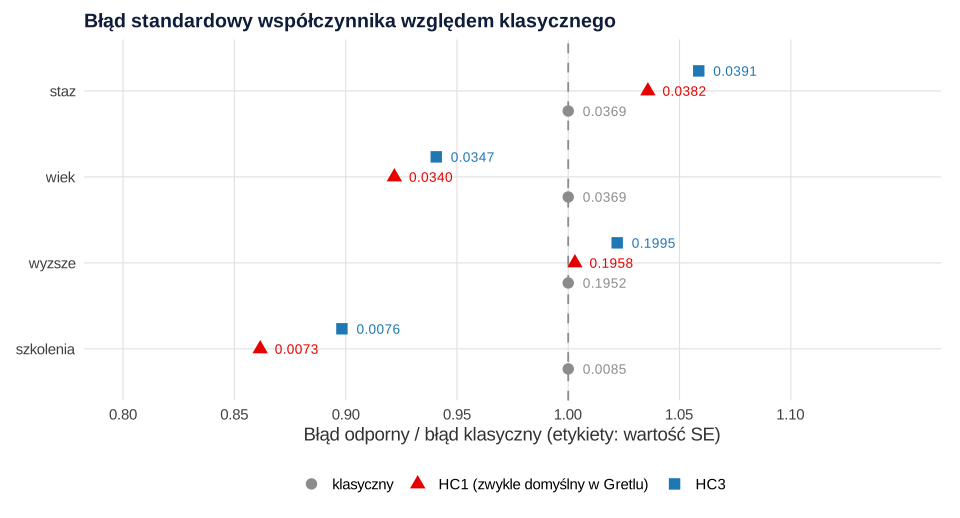
Którego wariantu użyć? W symulacjach Longa i Ervina (2000) HC3 działał dobrze nawet przy N = 25. Autorzy zalecają go przy N ≤ 250 i radzą stosować błędy odporne zawsze, gdy można podejrzewać heteroskedastyczność, a nie dopiero po istotnym teście. Mamy 160 obserwacji, więc w skrypcie ustawiamy set hc_version 3. Wybór zapisz przed analizą i podaj go w pracy. Więcej: odporne błędy standardowe (HC3).
Współczynniki się nie zmieniają, zmieniają się tylko błędy, t i p. Z HC3: staż t = 3.16, p = .002; wiek t = −1.08, p = .280; wykształcenie wyższe t = 4.50, p < .001; szkolenia t = 3.21, p = .002. Przy domyślnym HC1 wnioski są takie same (np. szkolenia p = .001). Te same estymatory HC liczy w R pakiet sandwich (Zeileis, 2004), z którego pochodzą liczby w tym wpisie.
Wydruk z opcją --robust może się różnić od klasycznego nie tylko błędami. Raportuj R², F i współczynniki z jednego, opisanego wydruku i napisz, z którego.
Ten sam przebieg jako skrypt hansl
Skrypt hansl pozwala powtórzyć analizę i dołączyć ją do aneksu. Zawiera tylko polecenia i opcje z dokumentacji poleceń (Cottrell i Lucchetti, b.d.-a). modtest według dokumentacji musi następować bezpośrednio po estymacji, dlatego przed każdym testem model szacujemy ponownie z opcją --quiet. Skryptu nie uruchamialiśmy w Gretlu. Liczby na tej stronie pochodzą z R.
open regresja-gretl-dane.csv
summary placa staz wiek wyzsze szkolenia
corr placa staz wiek wyzsze szkolenia
# Model 1: KMNK z klasycznymi błędami standardowymi
ols placa 0 staz wiek wyzsze szkolenia
vif
ols placa 0 staz wiek wyzsze szkolenia --quiet
modtest --white
ols placa 0 staz wiek wyzsze szkolenia --quiet
modtest --breusch-pagan
ols placa 0 staz wiek wyzsze szkolenia --quiet
modtest --breusch-pagan --robust
ols placa 0 staz wiek wyzsze szkolenia --quiet
modtest --normality
ols placa 0 staz wiek wyzsze szkolenia --quiet
reset
# Model 1 z błędami odpornymi HC3 i zapis tabeli do pliku RTF
set hc_version 3
ols placa 0 staz wiek wyzsze szkolenia --robust
tabprint --output=model1-hc3.rtf
Polecenie tabprint zapisuje tabelę modelu do pliku .rtf (do otwarcia w Wordzie), .tex lub .csv (Cottrell i Lucchetti, b.d.-a). To surowa tabela z wydruku, a nie tabela APA – w pracy przerób ją według wzoru niżej.
Jak opisać wynik w pracy (APA)
Do tabeli przepisz b, błąd standardowy (napisz, który), t, p i 95% CI. Gwiazdki Gretla pomiń. Pod tabelą podaj R², skorygowany R², F i N. Wzór tabeli opisuje hasło tabela regresji liniowej w APA, a współczynniki standaryzowane – wpis współczynniki standaryzowane czy niestandaryzowane.
Tabela 1
Wyniki regresji liniowej (KMNK) dla płacy miesięcznej (tys. zł)
| Predyktor | b | SEHC3 | t | p | 95% CI |
|---|---|---|---|---|---|
| Stała | 5.300 | 0.960 | 5.52 | < .001 | [3.404, 7.196] |
| Staż pracy (lata) | 0.124 | 0.039 | 3.16 | .002 | [0.046, 0.201] |
| Wiek (lata) | −0.038 | 0.035 | −1.08 | .280 | [−0.106, 0.031] |
| Wykształcenie wyższe (1 = tak) | 0.898 | 0.200 | 4.50 | < .001 | [0.504, 1.292] |
| Szkolenia (godziny) | 0.025 | 0.008 | 3.21 | .002 | [0.009, 0.040] |
Uwaga. N = 160. SEHC3 = błąd standardowy odporny na heteroskedastyczność (HC3); t, p i 95% CI liczone z tym błędem i rozkładem t o 155 stopniach swobody. R² = .39, skorygowany R² = .37, F(4, 155) = 24.53, p < .001 (model z klasycznymi błędami). Staż i wiek: VIF ≈ 14. Dane symulowane.
Ostatnie zdanie dopasuj do programu, którego naprawdę użyłeś. Podaj w nim wersję Gretla z menu pomocy, a w bibliografii wpisz program według zasad z wpisu jak cytować kwestionariusz, SPSS i R. Zdania do innych analiz złożysz w generatorze opisu wyników APA. Ten sam model w innych programach pokazują wpisy korelacja i regresja w SPSS oraz korelacja i regresja w jamovi. Przykład z błędami odpornymi na danych finansowych spółek opisuje wpis statystyka w pracy z finansów i rachunkowości.
Liczby z tego wpisu w R
Pierwszy przepis tworzy fikcyjny plik CSV, drugi liczy model i wszystkie testy z kroków 3–5. Parametry symulacji (efekty, rosnący ze stażem rozrzut płacy, związek wieku ze stażem) ustawiono ręcznie, żeby pokazać heteroskedastyczność i współliniowość. Testy odpowiadają opcjom Gretla: White z kwadratami i iloczynami regresorów, Breusch–Pagan w obu wariantach, RESET z kwadratami i sześcianami wartości dopasowanych, błędy HC1 i HC3. Testu Doornika–Hansena tu nie liczymy.
1. Dane: plik CSV do Gretla
R
# Fikcyjne dane do regresji w Gretlu: 160 pracowników (dane symulowane)
set.seed(531)
n <- 160
wiek <- round(runif(n, 23, 60))
staz <- pmax(0, round(wiek - 23 - runif(n, 0, 9)))          # staż rośnie z wiekiem
wyzsze <- rbinom(n, 1, 0.55)                                 # 1 = wykształcenie wyższe
szkolenia <- round(rgamma(n, shape = 2, scale = 9))          # godziny szkoleń w roku
# rozrzut płacy rośnie ze stażem (heteroskedastyczność)
placa <- 4.2 + 0.075 * staz + 1.10 * wyzsze + 0.030 * szkolenia +
         rnorm(n, 0, 0.45 + 0.045 * staz)
dane <- data.frame(placa = round(placa, 2), staz, wiek, wyzsze, szkolenia)

write.csv(dane, "regresja-gretl-dane.csv", row.names = FALSE)
cat("Wiersze:", nrow(dane), " Kolumny:", ncol(dane), "\n")
print(head(dane, 4))
print(round(sapply(dane, function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2))
cat("r(wiek, staz) =", round(cor(dane$wiek, dane$staz), 2), "\n")
Wynik w R
Wiersze: 160  Kolumny: 5
  placa staz wiek wyzsze szkolenia
1  6.37    0   23      1        16
2  5.93   12   43      0        10
3  6.19    8   34      1        17
4  6.88   15   41      1        20
    placa  staz  wiek wyzsze szkolenia
M    6.34 12.93 40.07   0.59     17.23
SD   1.52  9.81  9.81   0.49     11.42
min  3.33  0.00 23.00   0.00      1.00
max 12.69 35.00 59.00   1.00     56.00
r(wiek, staz) = 0.96
2. Model KMNK, testy diagnostyczne i błędy odporne
R
# KMNK i testy z okna modelu – te same estymatory co w Gretlu (dane z pliku CSV ze strony)
suppressPackageStartupMessages({ library(lmtest); library(sandwich); library(car) })
d <- read.csv("regresja-gretl-dane.csv")
m <- lm(placa ~ staz + wiek + wyzsze + szkolenia, data = d)
n <- nobs(m); k <- length(coef(m))

# 1. Tabela współczynników z gwiazdkami według reguły z dokumentacji Gretla
gw <- function(p) ifelse(p < .01, "***", ifelse(p < .05, "**", ifelse(p < .10, "*", "")))
tab <- coef(summary(m))
print(data.frame(b = round(tab[, 1], 4), SE = round(tab[, 2], 4), t = round(tab[, 3], 3),
                 p = signif(tab[, 4], 3), gw = gw(tab[, 4])))

# 2. Miary dopasowania
s <- summary(m); lnL <- as.numeric(logLik(m))
cat("\nn =", n, " k =", k, " df reszt =", df.residual(m), "\n")
cat("R2 =", round(s$r.squared, 4), " skorygowany R2 =", round(s$adj.r.squared, 4), "\n")
cat("F(", s$fstatistic[2], ",", s$fstatistic[3], ") =", round(s$fstatistic[1], 2),
    " p =", signif(pf(s$fstatistic[1], s$fstatistic[2], s$fstatistic[3], lower.tail = FALSE), 3), "\n")
cat("błąd standardowy regresji =", round(s$sigma, 4), " log-wiarygodność =", round(lnL, 3), "\n")
cat("AIC (k = liczba współczynników) =", round(-2 * lnL + 2 * k, 3),
    " AIC() w R (wlicza też wariancję) =", round(AIC(m), 3), "\n")
cat("BIC (k współczynników) =", round(-2 * lnL + k * log(n), 3),
    " HQC =", round(-2 * lnL + 2 * k * log(log(n)), 3), "\n")

# 3. Heteroskedastyczność: White (kwadraty i iloczyny), Breusch–Pagan i wariant Koenkera
u2 <- resid(m)^2
pom <- lm(u2 ~ (staz + wiek + wyzsze + szkolenia)^2 + I(staz^2) + I(wiek^2) + I(szkolenia^2), data = d)
lm_white <- n * summary(pom)$r.squared; df_white <- sum(!is.na(coef(pom))) - 1
cat("\nWhite: LM =", round(lm_white, 3), " df =", df_white,
    " p =", sub("^0", "", signif(pchisq(lm_white, df_white, lower.tail = FALSE), 3)), "\n")
print(bptest(m, studentize = FALSE))   # Breusch–Pagan w wersji pierwotnej
print(bptest(m))                       # wariant studentyzowany (Koenker)

# 4. RESET: kwadraty i sześciany wartości dopasowanych
print(resettest(m, power = 2:3, type = "fitted"))

# 5. Współliniowość
print(round(vif(m), 3))

# 6. Błędy odporne: HC1 (domyślny wariant Gretla) i HC3; p z rozkładu t
klas <- sqrt(diag(vcov(m)))
hc1 <- sqrt(diag(vcovHC(m, type = "HC1"))); hc3 <- sqrt(diag(vcovHC(m, type = "HC3")))
print(round(cbind(SE_klasyczny = klas, SE_HC1 = hc1, SE_HC3 = hc3), 4))
print(coeftest(m, vcov. = vcovHC(m, type = "HC1"), df = df.residual(m)))   # jak --robust przy HC1
print(coeftest(m, vcov. = vcovHC(m, type = "HC3"), df = df.residual(m)))   # jak --robust przy hc_version 3
print(round(coefci(m, vcov. = vcovHC(m, type = "HC3"), df = df.residual(m)), 3))   # 95% CI z HC3

# 7. Wariant bez wieku (staż i wiek mierzą prawie to samo)
m2 <- lm(placa ~ staz + wyzsze + szkolenia, data = d)
print(round(coef(summary(m2)), 4))
cat("R2 =", round(summary(m2)$r.squared, 4), " skorygowany R2 =", round(summary(m2)$adj.r.squared, 4), "\n")
print(round(vif(m2), 3))
Wynik w R
                  b     SE      t        p  gw
(Intercept)  5.3000 1.0570  5.014 1.44e-06 ***
staz         0.1236 0.0369  3.347 1.03e-03 ***
wiek        -0.0376 0.0369 -1.020 3.09e-01
wyzsze       0.8977 0.1952  4.598 8.78e-06 ***
szkolenia    0.0245 0.0085  2.885 4.47e-03 ***

n = 160  k = 5  df reszt = 155
R2 = 0.3876  skorygowany R2 = 0.3718
F( 4 , 155 ) = 24.53  p = 9.66e-16
błąd standardowy regresji = 1.2037  log-wiarygodność = -254.157
AIC (k = liczba współczynników) = 518.315  AIC() w R (wlicza też wariancję) = 520.315
BIC (k współczynników) = 533.69  HQC = 524.558

White: LM = 33.498  df = 13  p = .00143

	Breusch-Pagan test

data:  m
BP = 62.061, df = 4, p-value = 1.069e-12


	studentized Breusch-Pagan test

data:  m
BP = 28.526, df = 4, p-value = 9.754e-06


	RESET test

data:  m
RESET = 0.39666, df1 = 2, df2 = 153, p-value = 0.6733

     staz      wiek    wyzsze szkolenia
   14.415    14.382     1.015     1.033
            SE_klasyczny SE_HC1 SE_HC3
(Intercept)       1.0570 0.9405 0.9598
staz              0.0369 0.0382 0.0391
wiek              0.0369 0.0340 0.0347
wyzsze            0.1952 0.1958 0.1995
szkolenia         0.0085 0.0073 0.0076

t test of coefficients:

              Estimate Std. Error t value  Pr(>|t|)
(Intercept)  5.2999528  0.9404879  5.6353 8.035e-08 ***
staz         0.1235845  0.0382498  3.2310  0.001507 **
wiek        -0.0376484  0.0340334 -1.1062  0.270345
wyzsze       0.8977138  0.1958059  4.5847 9.307e-06 ***
szkolenia    0.0245131  0.0073202  3.3487  0.001019 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


t test of coefficients:

              Estimate Std. Error t value  Pr(>|t|)
(Intercept)  5.2999528  0.9598016  5.5219 1.382e-07 ***
staz         0.1235845  0.0390939  3.1612  0.001890 **
wiek        -0.0376484  0.0347276 -1.0841  0.280001
wyzsze       0.8977138  0.1995165  4.4994 1.330e-05 ***
szkolenia    0.0245131  0.0076323  3.2118  0.001604 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

             2.5 % 97.5 %
(Intercept)  3.404  7.196
staz         0.046  0.201
wiek        -0.106  0.031
wyzsze       0.504  1.292
szkolenia    0.009  0.040
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   4.2565     0.2654 16.0392    0.000
staz          0.0873     0.0099  8.8466    0.000
wyzsze        0.9142     0.1946  4.6984    0.000
szkolenia     0.0242     0.0085  2.8490    0.005
R2 = 0.3835  skorygowany R2 = 0.3717
     staz    wyzsze szkolenia
    1.029     1.008     1.031
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lmtest, sandwich i car; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. Gretla nie uruchamialiśmy. W pracy podaj wersje programów, których faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1–17. https://doi.org/10.18637/jss.v011.i10
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy przy regresji w Gretlu
- Czytanie gwiazdek jak w SPSS lub R. W Gretlu * oznacza p < .10, a *** – p < .01. Wynik z jedną gwiazdką nie jest istotny przy α = .05.
- Pierwsza kolumna potraktowana jako etykiety. Kolumna z pustym nagłówkiem albo nazwą „obs” lub „year” może zniknąć z listy zmiennych. Sprawdź listę zmiennych po imporcie.
- Kody braków jako liczby albo liczby jako braki. −999 i −9999 Gretl domyślnie czyta jako braki, ale 99 – już jako liczbę. Sprawdź minimum i maksimum w Summary statistics.
- Nieopisany wariant testu. „Test Breuscha–Pagana” w Gretlu i w R może dać różne liczby (wersja pierwotna i wariant Koenkera). Podaj, której użyłeś.
- Wybór błędów odpornych po wynikach. Wariant HC (HC1 domyślnie, HC3 przy mniejszych próbach) wybierz przed analizą. Nie przełączaj go, aż p spadnie poniżej .05.
- Porównywanie AIC z dwóch programów. Programy mogą liczyć parametry inaczej. Porównuj modele w jednym programie, na tych samych obserwacjach.
Najczęstsze pytania
Co oznaczają gwiazdki w wynikach Gretla?
W wydruku modelu Gretl oznacza *** współczynniki z p < .01, ** – z p od .01 do .05, a * – z p od .05 do .10. Jedna gwiazdka nie oznacza więc istotności przy α = .05. W pracy podawaj dokładne wartości p, a gwiazdki pomiń albo opisz w nocie tabeli.
Jak w Gretlu włączyć odporne błędy standardowe?
W skrypcie dodaj opcję --robust do polecenia ols. Wariant ustawia set hc_version (0, 1, 2, 3 lub 3a), a w interfejsie – karta HCCME w Tools → Preferences → General. Domyślny wariant to zwykle HC1. Przy próbach do ok. 250 obserwacji częściej zaleca się HC3. Wybierz wariant przed analizą i podaj go w pracy.
Dlaczego test Breuscha–Pagana w Gretlu daje inny wynik niż w R?
Bez opcji Gretl liczy pierwotną wersję testu, a z opcją --robust – wariant Koenkera, mniej wrażliwy na brak normalności. Funkcja bptest() w R domyślnie liczy wariant studentyzowany (Koenkera). W przykładzie z tego wpisu wersja pierwotna dała LM = 62.06, a wariant Koenkera 28.53. Napisz w pracy, którego wariantu użyłeś.
Gdzie w Gretlu jest VIF?
W oknie modelu wybierz Analysis → Collinearity albo w skrypcie wpisz vif po oszacowaniu modelu. Dokumentacja Gretla przypomina, że wartość powyżej 10 bywa uznawana za problem. Wysoki VIF nie jest jednak automatycznym powodem usunięcia zmiennej – najpierw sprawdź, na jakie pytanie odpowiada model.
Czy Gretl i R dają te same wyniki regresji?
Współczynniki, błędy standardowe, t, p, R² i F w KMNK liczy się wszędzie tymi samymi wzorami, więc na tych samych danych powinny być takie same z dokładnością do zaokrągleń. Różnice zdarzają się w testach diagnostycznych (warianty testów), w domyślnym wariancie błędów odpornych i w kryteriach informacyjnych (sposób liczenia parametrów).
Powiązane hasła
Przeczytaj też
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikWysoki VIF – co zrobić ze współliniowością?
Kiedy wysoki VIF jest problemem, a kiedy nie, dlaczego nie usuwać predyktorów tylko z jego powodu i jak opisać współliniowość w pracy – z przykładem w R.
Czytaj →Masz model z Gretla i nie wiesz, co przepisać do pracy?
Sprawdzimy specyfikację modelu, testy diagnostyczne i wybór błędów standardowych oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/tac.1974.1100705 ● Otwarty dostęp: pełny tekst
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cottrell, A., & Lucchetti, R. (b.d.-a). Gretl command reference. gretl: Gnu Regression, Econometrics and Time-series Library. https://gretl.sourceforge.net/gretl-help/cmdref.html ● Otwarty dostęp
- Cottrell, A., & Lucchetti, R. (b.d.-b). Gretl function reference. gretl: Gnu Regression, Econometrics and Time-series Library. https://gretl.sourceforge.net/gretl-help/funcref.html ● Otwarty dostęp
- Doornik, J. A., & Hansen, H. (2008). An omnibus test for univariate and multivariate normality. Oxford Bulletin of Economics and Statistics, 70(s1), 927–939. https://doi.org/10.1111/j.1468-0084.2008.00537.x ● Otwarty dostęp: pełny tekst
- Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/bf03192961 ● Otwarty dostęp
- Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107–112. https://doi.org/10.1016/0304-4076(81)90062-2
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1–17. https://doi.org/10.18637/jss.v011.i10 ● Otwarty dostęp
Cytowania BibTeX
@article{akaike1974new, author={Akaike, Hirotugu}, title={{A new look at the statistical model identification}}, journal={IEEE Transactions on Automatic Control}, year={1974}, volume={19}, number={6}, pages={716--723}, doi={10.1109/tac.1974.1100705}}@article{breusch1979simple, author={Breusch, T. S. and Pagan, A. R.}, title={{A simple test for heteroscedasticity and random coefficient variation}}, journal={Econometrica}, year={1979}, volume={47}, number={5}, pages={1287--1294}, doi={10.2307/1911963}}@misc{cottrellndgretlcmd, author={Cottrell, Allin and Lucchetti, Riccardo}, title={{Gretl command reference}}, howpublished={gretl: Gnu Regression, Econometrics and Time-series Library}, year={b.d.-a}, url={https://gretl.sourceforge.net/gretl-help/cmdref.html}}@misc{cottrellndgretlfunc, author={Cottrell, Allin and Lucchetti, Riccardo}, title={{Gretl function reference}}, howpublished={gretl: Gnu Regression, Econometrics and Time-series Library}, year={b.d.-b}, url={https://gretl.sourceforge.net/gretl-help/funcref.html}}@article{doornik2008omnibus, author={Doornik, Jurgen A. and Hansen, Henrik}, title={{An omnibus test for univariate and multivariate normality}}, journal={Oxford Bulletin of Economics and Statistics}, year={2008}, volume={70}, number={s1}, pages={927--939}, doi={10.1111/j.1468-0084.2008.00537.x}}@article{hayes2007using, author={Hayes, Andrew F. and Cai, Li}, title={{Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation}}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={4}, pages={709--722}, doi={10.3758/bf03192961}}@article{koenker1981note, author={Koenker, Roger}, title={{A note on studentizing a test for heteroscedasticity}}, journal={Journal of Econometrics}, year={1981}, volume={17}, number={1}, pages={107--112}, doi={10.1016/0304-4076(81)90062-2}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{ramsey1969tests, author={Ramsey, J. B.}, title={{Tests for specification errors in classical linear least-squares regression analysis}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1969}, volume={31}, number={2}, pages={350--371}, doi={10.1111/j.2517-6161.1969.tb00796.x}}@article{white1980heteroskedasticity, author={White, Halbert}, title={{A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity}}, journal={Econometrica}, year={1980}, volume={48}, number={4}, pages={817--838}, doi={10.2307/1912934}}@article{zeileis2004econometric, author={Zeileis, Achim}, title={{Econometric computing with HC and HAC covariance matrix estimators}}, journal={Journal of Statistical Software}, year={2004}, volume={11}, number={10}, pages={1--17}, doi={10.18637/jss.v011.i10}}