Co to jest test White’a?
Test White’a (ang. White test) sprawdza, czy wariancja reszt w regresji liniowej jest stała. Hipoteza zerowa mówi, że spełnione jest założenie homoskedastyczności. White (1980) zaproponował go razem z estymatorem macierzy kowariancji odpornym na heteroskedastyczność: test porównuje ten estymator ze zwykłym, bo przy stałej wariancji oba dają zbliżone wyniki, i nie wymaga modelu postaci heteroskedastyczności.
Jak działa test
Kwadraty reszt regresuje się na predyktory, ich kwadraty i iloczyny par. Statystyka n · R² tej regresji pomocniczej ma przy H₀ w przybliżeniu rozkład χ² z liczbą stopni swobody równą liczbie zmiennych pomocniczych. Przy dwóch predyktorach jest ich pięć: x₁, x₂, x₁², x₂² i x₁x₂. To w praktyce studentyzowany test Breuscha–Pagana z rozszerzonym zestawem zmiennych, więc w R liczy się go funkcją bptest() z odpowiednią formułą. Dzięki kwadratom wykrywa też nieliniową zależność wariancji od predyktorów.
Przykład
W danych symulowanych (200 osób, dwa predyktory) rozrzut wyniku rośnie wraz z odległością x₁ od zera, więc reszty układają się w kształt litery U. Zwykły test Breuscha–Pagana nie widzi problemu: χ²(2) = 3.33, p = .190. Test White’a wykrywa go wyraźnie: χ²(5) = 42.85, p < .001. Błąd standardowy nachylenia x₁ rośnie z 0.093 do 0.161 po przejściu na błędy standardowe HC3.
Na rysunku
Obie wersje testu regresują kwadraty reszt na zmienne pomocnicze. Rysunek pokazuje kwadraty reszt z przykładu względem x₁ i dwie uproszczone regresje pomocnicze tylko z x₁: prostą, jak w zwykłym teście Breuscha–Pagana, i parabolę, jak w teście White’a.
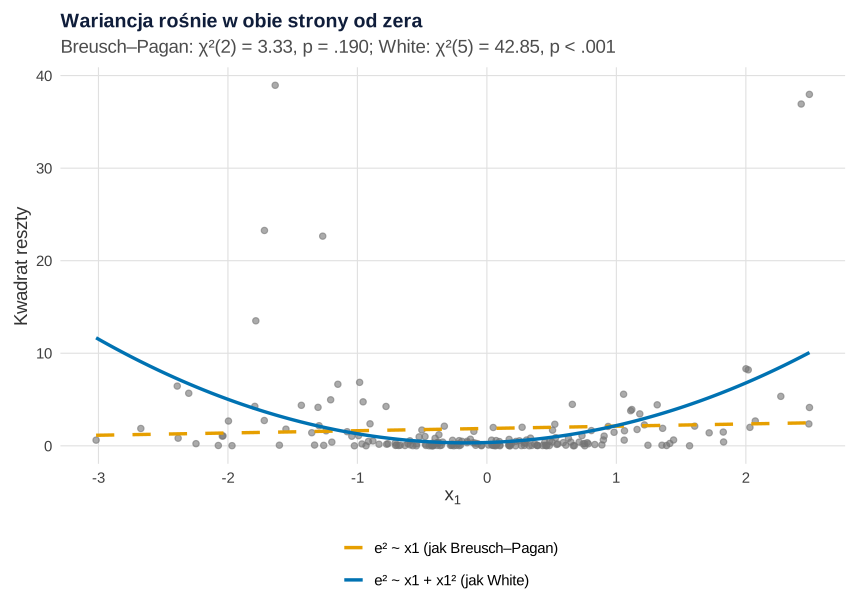
set.seed(595)).Co widać. Rozrzut reszt rośnie w obie strony od zera, więc średni kwadrat reszty prawie nie zmienia się liniowo z x₁: prosta wyjaśnia 0.2% zmienności kwadratów reszt i test Breuscha–Pagana nic nie znajduje (p = .190). Parabola wyjaśnia 18.4%, a pełny test White’a, z x₂, kwadratami i iloczynem, daje χ²(5) = 42.85, p < .001. Zwykły test BP jest ślepy na heteroskedastyczność, która nie rośnie monotonicznie z predyktorem.
Na co uważać. Linie na rysunku to uproszczenie – pomijają x₂, więc ich R² nie są statystykami testów. Kilka dużych reszt w ogonach mocno wpływa na regresję kwadratów reszt. Ten sam kształt U dałby też pominięty człon x₁² w modelu średniej; to sprawdza test RESET. W modelu z wieloma predyktorami wygodniej obejrzeć jeden wykres skala–położenie dla wartości dopasowanych, ale wariancja zależna od |x₁| może się na nim rozmyć.
Podpis do pracy:
Dane i ziarno 595 są te same co w przykładzie; rysunek nie ma ręcznie dobieranych parametrów poza tymi z przykładu (rozrzut 0.5 + 0.8 · x₁²). Rysunek na stronie różni się od wyniku kodu tylko motywem (krój i kolor czcionki, siatka).
R – kod rysunku
# Rysunek 1. Co widzi test Breuscha–Pagana, a co test White'a: kwadraty reszt względem x1
# Dane jak w przykładzie hasła: 200 obserwacji, rozrzut wyniku rośnie z |x1| (kształt U)
library(ggplot2)
suppressPackageStartupMessages(library(lmtest))
set.seed(595)
n <- 200
x1 <- rnorm(n); x2 <- rnorm(n)
y <- 2 + 0.5 * x1 + 0.3 * x2 + rnorm(n, sd = 0.5 + 0.8 * x1^2)
m <- lm(y ~ x1 + x2)
d <- data.frame(x1 = x1, e2 = resid(m)^2)
bp <- bptest(m); wh <- bptest(m, ~ x1 + x2 + I(x1^2) + I(x2^2) + x1:x2)
round(c(BP = unname(bp$statistic), p_BP = unname(bp$p.value),
        White = unname(wh$statistic), p_White = unname(wh$p.value)), 4)
# Uproszczone regresje pomocnicze tylko z x1 (dla rysunku): prosta jak w BP, parabola jak w White
lin <- lm(e2 ~ x1, data = d); kw <- lm(e2 ~ x1 + I(x1^2), data = d)
wsp <- rbind(prosta = c(coef(lin), NA, summary(lin)$r.squared),
             parabola = c(coef(kw), summary(kw)$r.squared))
colnames(wsp) <- c("wyraz_wolny", "x1", "x1_kwadrat", "R2")
round(wsp, 3)
siatka <- data.frame(x1 = seq(min(x1), max(x1), length.out = 200))
linie <- rbind(data.frame(siatka, e2 = predict(lin, siatka), test = "e² ~ x1 (jak Breusch–Pagan)"),
               data.frame(siatka, e2 = predict(kw, siatka), test = "e² ~ x1 + x1² (jak White)"))
kol <- c("#E69F00", "#0072B2")                            # Okabe–Ito
motyw <- theme_minimal(base_size = 14) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
p1 <- ggplot(d, aes(x1, e2)) +
  geom_point(colour = "grey45", alpha = 0.6, size = 1.8) +
  geom_line(data = linie, aes(colour = test, linetype = test), linewidth = 1.2) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = expression(x[1]), y = "Kwadrat reszty",
       title = "Wariancja rośnie w obie strony od zera",
       subtitle = sprintf("Breusch–Pagan: χ²(2) = %.2f, p = %s;  White: χ²(5) = %.2f, p < .001",
                          bp$statistic, sub("^0", "", sprintf("%.3f", bp$p.value)), wh$statistic)) +
  motyw
p1   # zapis: ggsave("test-white-a-kwadraty-reszt.svg", p1, width = 9, height = 6.4)
Wynik w R
     BP    p_BP   White p_White
 3.3263  0.1895 42.8465  0.0000
         wyraz_wolny    x1 x1_kwadrat    R2
prosta         1.874 0.244         NA 0.002
parabola       0.355 0.443      1.388 0.184
Jak opisać w pracy
Na co uważać
- Liczba zmiennych pomocniczych szybko rośnie: przy 10 predyktorach jest ich 65, co w małej próbie obniża moc. Stosuje się wtedy wersję uproszczoną z wartościami dopasowanymi i ich kwadratem (2 stopnie swobody).
- Zmiennych zero-jedynkowych nie podnosi się do kwadratu, bo x² = x.
- Istotny wynik może też sygnalizować pominięty kwadrat lub interakcję w samym modelu, nie tylko niestałą wariancję.
- Long i Ervin (2000) radzą nie uzależniać decyzji o błędach odpornych od testu wstępnego i przy N ≤ 250 stosować HC3.
- Zawsze obejrzyj wykres reszt względem wartości dopasowanych. Przyczyny i sposoby radzenia sobie z problemem opisuje hasło heterogeniczność wariancji, a całą diagnostykę – wpis Diagnostyka regresji w R.
Test White’a w R
Kod odtwarza statystykę White’a z regresji pomocniczej, liczy ją też przez bptest(), porównuje ze zwykłym testem Breuscha–Pagana, zestawia błędy standardowe klasyczne z HC3 i na końcu liczy wersję uproszczoną z wartościami dopasowanymi i ich kwadratem.
Test White’a przy heteroskedastyczności w kształcie U
R
# Test White'a: regresja pomocnicza e² na predyktory, ich kwadraty i iloczyn (dane symulowane)
suppressPackageStartupMessages(library(lmtest))
library(sandwich)
set.seed(595)
n <- 200
x1 <- rnorm(n); x2 <- rnorm(n)
y <- 2 + 0.5 * x1 + 0.3 * x2 + rnorm(n, sd = 0.5 + 0.8 * x1^2)  # rozrzut rośnie z |x1| (kształt U)
m <- lm(y ~ x1 + x2)
e2 <- resid(m)^2
pom <- lm(e2 ~ x1 + x2 + I(x1^2) + I(x2^2) + x1:x2)           # regresja pomocnicza White'a
LM <- n * summary(pom)$r.squared; df <- 5
round(c(White_nR2 = LM, df = df, p = pchisq(LM, df, lower.tail = FALSE)), 4)
bptest(m, ~ x1 + x2 + I(x1^2) + I(x2^2) + x1:x2)              # to samo przez bptest()
bptest(m)                                                     # zwykły BP: tylko x1 i x2 liniowo
round(rbind(klasyczne = coeftest(m)["x1", ],
            HC3 = coeftest(m, vcov = vcovHC(m, type = "HC3"))["x1", ]), 3)
# Wersja uproszczona: wartości dopasowane i ich kwadrat (2 df)
yhat <- fitted(m)
bptest(m, ~ yhat + I(yhat^2))
Wynik w R
White_nR2        df         p
  42.8465    5.0000    0.0000

	studentized Breusch-Pagan test

data:  m
BP = 42.847, df = 5, p-value = 3.969e-08


	studentized Breusch-Pagan test

data:  m
BP = 3.3263, df = 2, p-value = 0.1895

          Estimate Std. Error t value Pr(>|t|)
klasyczne    0.357      0.093   3.834    0.000
HC3          0.357      0.161   2.218    0.028

	studentized Breusch-Pagan test

data:  m
BP = 21.158, df = 2, p-value = 2.544e-05
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety lmtest i sandwich); rysunki narysowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym test White’a różni się od testu Breuscha–Pagana?
Podstawowy test Breuscha–Pagana sprawdza liniową zależność wariancji od predyktorów. Test White’a dodaje ich kwadraty i iloczyny, więc wykrywa także zależność nieliniową, ale ma więcej stopni swobody i mniejszą moc w małej próbie.
Co zrobić, gdy test White’a jest istotny?
Najprościej użyć odpornych błędów standardowych HC3. Warto też sprawdzić postać modelu (brakujący kwadrat, interakcja), rozważyć transformację zmiennej zależnej albo ważoną metodę najmniejszych kwadratów.
Czy test White’a wymaga normalności reszt?
Wersja n · R² nie wymaga normalności reszt. Rozkład χ² jest jednak przybliżeniem asymptotycznym, więc w małych próbach wartość p jest tylko orientacyjna.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
Cytowania BibTeX
@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{white1980heteroskedasticity, author={White, Halbert}, title={{A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity}}, journal={Econometrica}, year={1980}, volume={48}, number={4}, pages={817--838}, doi={10.2307/1912934}}