Co to jest wykres skala–położenie?
Wykres skala–położenie (ang. scale-location plot, nazywany też spread-location) pokazuje pierwiastek z wartości bezwzględnej reszt standaryzowanych względem wartości dopasowanych modelu. Służy do oceny homoskedastyczności, czyli tego, czy rozrzut reszt jest taki sam przy niskich i wysokich wartościach przewidywanych. W R to trzeci wykres diagnostyczny modelu: plot(model, which = 3). Cook i Weisberg (1983) zaproponowali procedurę graficzną jako uzupełnienie formalnego testu heteroskedastyczności.
Każdy element przekształcenia ma swój cel. Wartość bezwzględna „składa” reszty ujemne na dodatnie, więc zmiana rozrzutu staje się zmianą poziomu, którą widać jako trend. Pierwiastek zmniejsza skośność, żeby kilka dużych reszt nie zdominowało obrazu. Standaryzacja wyrównuje reszty, których wariancja zależy od dźwigni punktu.
Jak czytać wykres
- Płaska linia trendu (zwykle LOESS) oznacza stały rozrzut. Przy normalnym błędzie leży ona w okolicy 0.8, bo tyle wynosi średnia √|z| dla rozkładu normalnego.
- Linia rosnąca oznacza, że rozrzut rośnie z wartością przewidywaną. To ten sam lejek, który na wykresie reszt względem wartości dopasowanych rozszerza się w prawo. Linia malejąca – odwrotnie, a garb – większy rozrzut w środku.
- Oś pionowa nie ma wartości ujemnych. Nie szukaj tu symetrii wokół zera; patrz na nachylenie linii.
Przykład
W danych symulowanych 150 osób podało liczbę stresujących zdarzeń z ostatniego roku (0–10) i wynik skali lęku. Przygotowano dwie wersje wyniku. W wersji A błąd ma stałe SD = 5. W wersji B SD błędu rośnie od 1 do 10 wraz z liczbą zdarzeń. Te parametry i liczebność ustawiono ręcznie tak, by różnica była wyraźna; ziarna 749 nie zmieniano. W wersji A SD reszt w kolejnych tercylach wartości dopasowanych wynosi 5.10, 5.16 i 4.65, a w wersji B 2.91, 6.58 i 8.92. Średnie √|reszty standaryzowanej| w tercylach to 0.80, 0.84 i 0.80 (A) oraz 0.52, 0.84 i 0.93 (B). Studentyzowany test Breuscha–Pagana (Breusch i Pagan, 1979) nie wykrywa problemu w wersji A, BP(1) = 0.01, p = .930, a w wersji B tak, BP(1) = 27.99, p < .001.
Na rysunku
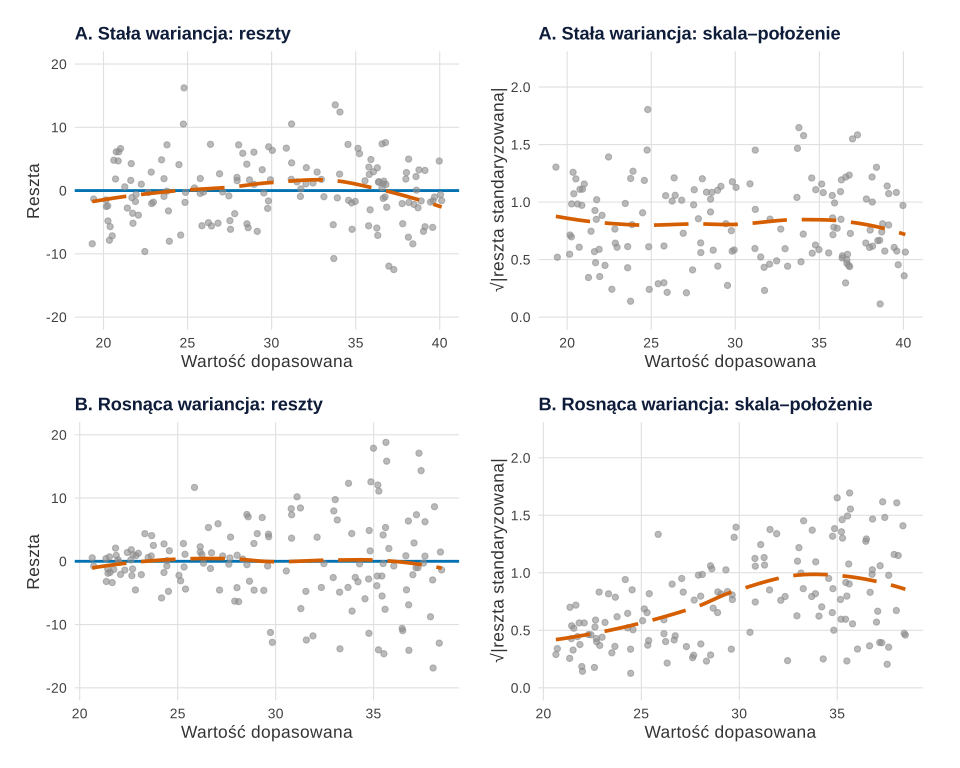
set.seed(749)).Co widać. W rzędzie A oba wykresy są „nudne”: pas reszt ma stałą szerokość, a linia na wykresie skala–położenie jest płaska. W rzędzie B lejek widać na wykresie reszt, ale linia LOESS w lewym panelu stoi przy zerze, bo dodatnie i ujemne reszty się znoszą. Dopiero po złożeniu reszt (prawy panel) zmiana rozrzutu zamienia się w rosnącą linię, którą łatwo opisać.
Na co uważać. Wykres pokazuje, że rozrzut się zmienia, ale nie mówi dlaczego ani z którym predyktorem się to wiąże. Do tego narysuj √|reszt| względem każdego predyktora. Nie ocenia też kształtu zależności – łuk w średniej sprawdzasz na zwykłym wykresie reszt. Na prawym krańcu linia w panelu B lekko opada, bo LOESS opiera się tam na kilkunastu punktach. Przy heteroskedastyczności współczynniki MNK pozostają nieobciążone, ale zwykłe błędy standardowe mogą mylić; więcej o tym w haśle heterogeniczność wariancji i we wpisie Galeria wykresów reszt.
Podpis do pracy:
Kod rysunku i testu z przykładu znajdziesz w sekcji Wykres skala–położenie w R.
Jak opisać w pracy
Na co uważać
- Nie uzależniaj odpornych błędów od testu. Long i Ervin (2000) zalecają błędy standardowe HC3 zawsze, gdy można podejrzewać heteroskedastyczność, bez testu wstępnego. Wykres służy do zrozumienia problemu, nie do „zaliczenia” założenia.
- Nie używaj reszt surowych zamiast standaryzowanych. Punkty o dużej dźwigni mają z natury mniejsze reszty surowe i mogą udawać mniejszy rozrzut.
- Nie myl wykresów diagnostycznych.
which = 3to skala–położenie;which = 5pokazuje reszty względem dźwigni.
Wykres skala–położenie w R
Pierwszy przepis liczy SD reszt w tercylach i test Breuscha–Pagana (pakiet lmtest, domyślnie wersja studentyzowana). Drugi rysuje Rysunek 1; jest samowystarczalny (paleta Okabe–Ito i motyw zdefiniowane w kodzie). Oba zaczynają się od tego samego set.seed(749), więc skopiowane osobno dają te same liczby co na stronie. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Gotowy wykres bez ggplot2 rysuje plot(mB, which = 3).
Rozrzut reszt w tercylach i test Breuscha–Pagana
R
suppressPackageStartupMessages(library(lmtest))       # test Breuscha–Pagana
set.seed(749)                                         # te same dane co na rysunku 1
n <- 150
zdarzenia <- runif(n, 0, 10)
lek_stala <- 20 + 2 * zdarzenia + rnorm(n, sd = 5)
lek_rosnaca <- 20 + 2 * zdarzenia + rnorm(n, sd = 1 + 0.9 * zdarzenia)
mA <- lm(lek_stala ~ zdarzenia)
mB <- lm(lek_rosnaca ~ zdarzenia)
sd_tercyle <- function(m) {                           # SD reszt w tercylach wartości dopasowanych
  t3 <- cut(fitted(m), quantile(fitted(m), 0:3 / 3), include.lowest = TRUE,
            labels = c("niskie", "srednie", "wysokie"))
  round(tapply(resid(m), t3, sd), 2)
}
rbind(A_stala = sd_tercyle(mA), B_rosnaca = sd_tercyle(mB))
bptest(mA)                                            # wersja studentyzowana (Koenkera)
bptest(mB)
# plot(mB, which = 3)                                 # wbudowany wykres skala–położenie
Wynik w R
          niskie srednie wysokie
A_stala     5.10    5.16    4.65
B_rosnaca   2.91    6.58    8.92

	studentized Breusch-Pagan test

data:  mA
BP = 0.0077531, df = 1, p-value = 0.9298


	studentized Breusch-Pagan test

data:  mB
BP = 27.993, df = 1, p-value = 1.217e-07
Kod rysunku 1
Kod R rysunku 1
# Rysunek 1. Reszty a dopasowane (lewa kolumna) i skala–położenie (prawa) przy stałej i rosnącej wariancji
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(zero = "#0072B2", loess = "#D55E00")          # Okabe–Ito; LOESS także linią przerywaną
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
set.seed(749)                                         # 150 osób: stresujące zdarzenia i lęk
n <- 150
zdarzenia <- runif(n, 0, 10)
lek_stala <- 20 + 2 * zdarzenia + rnorm(n, sd = 5)                          # ten sam rozrzut wszędzie
lek_rosnaca <- 20 + 2 * zdarzenia + rnorm(n, sd = 1 + 0.9 * zdarzenia)      # rozrzut rośnie
panele <- function(y, opis) {
  m <- lm(y ~ zdarzenia)
  d <- data.frame(dop = fitted(m), res = resid(m), sl = sqrt(abs(rstandard(m))))
  lo <- geom_smooth(method = "loess", formula = y ~ x, span = 0.75, se = FALSE,
                    colour = kol[["loess"]], linewidth = 1.3, linetype = "longdash")
  pr <- ggplot(d, aes(dop, res)) + geom_hline(yintercept = 0, colour = kol[["zero"]], linewidth = 1) +
    geom_point(colour = "grey55", alpha = 0.6) + lo + coord_cartesian(ylim = c(-20, 20)) +
    labs(title = paste0(opis, ": reszty"), x = "Wartość dopasowana", y = "Reszta")
  ps <- ggplot(d, aes(dop, sl)) + geom_point(colour = "grey55", alpha = 0.6) + lo +
    coord_cartesian(ylim = c(0, 2.2)) +
    labs(title = paste0(opis, ": skala–położenie"), x = "Wartość dopasowana",
         y = "√|reszta standaryzowana|")
  list(pr, ps, m)
}
a <- panele(lek_stala, "A. Stała wariancja")
b <- panele(lek_rosnaca, "B. Rosnąca wariancja")
p1 <- (a[[1]] + a[[2]]) / (b[[1]] + b[[2]]) & motyw
sl_tercyle <- function(m) {                           # średnia √|reszty std.| w tercylach dopasowanych
  t3 <- cut(fitted(m), quantile(fitted(m), 0:3 / 3), include.lowest = TRUE,
            labels = c("niskie", "srednie", "wysokie"))
  round(tapply(sqrt(abs(rstandard(m))), t3, mean), 2)
}
rbind(A_stala = sl_tercyle(a[[3]]), B_rosnaca = sl_tercyle(b[[3]]))
p1
Wynik w R
          niskie srednie wysokie
A_stala     0.80    0.84    0.80
B_rosnaca   0.52    0.84    0.93
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe lm(), rstandard(), fitted(); test Breuscha–Pagana – pakiet lmtest; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- lmtest (wersja 0.9-40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego na wykresie skala–położenie jest pierwiastek z modułu reszt?
Moduł zamienia reszty ujemne na dodatnie, więc lejek staje się rosnącą linią, którą widać i można wygładzić. Pierwiastek zmniejsza skośność wartości bezwzględnych, żeby pojedyncze duże reszty nie zdominowały obrazu.
Na jakiej wysokości powinna leżeć linia na wykresie skala–położenie?
Przy normalnym błędzie i stałej wariancji – w okolicy 0.8, bo tyle wynosi średnia pierwiastka z modułu zmiennej standaryzowanej. Ważniejsza od poziomu jest jednak płaskość linii: rosnąca lub malejąca linia oznacza zmienny rozrzut.
Co zrobić, gdy linia na wykresie skala–położenie rośnie?
Najprościej oprzeć wnioskowanie na odpornych błędach standardowych HC3. Gdy rozrzut rośnie proporcjonalnie do poziomu wyniku (np. czasy, kwoty), rozważ też transformację logarytmiczną albo model, który jawnie opisuje wariancję.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Galeria wykresów reszt
Łuk, lejek, skos, dźwignia, dwa pasma i fale w czasie – jak wyglądają złamane założenia regresji na wykresach reszt z R, z podpisami i ćwiczeniem.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cook, R. D., & Weisberg, S. (1983). Diagnostics for heteroscedasticity in regression. Biometrika, 70(1), 1–10. https://doi.org/10.1093/biomet/70.1.1 ● Otwarty dostęp: pełny tekst
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
Cytowania BibTeX
@article{breusch1979simple, author={Breusch, T. S. and Pagan, A. R.}, title={{A simple test for heteroscedasticity and random coefficient variation}}, journal={Econometrica}, year={1979}, volume={47}, number={5}, pages={1287--1294}, doi={10.2307/1911963}}@article{cook1983diagnostics, author={Cook, R. Dennis and Weisberg, Sanford}, title={{Diagnostics for heteroscedasticity in regression}}, journal={Biometrika}, year={1983}, volume={70}, number={1}, pages={1--10}, doi={10.1093/biomet/70.1.1}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}