Co to jest wykres reszt względem wartości dopasowanych?
Wykres reszt względem wartości dopasowanych (ang. residuals vs fitted plot) to podstawowy wykres diagnostyczny regresji liniowej. Na osi poziomej leżą wartości przewidywane przez model (ŷ), a na pionowej – reszty, czyli różnice y − ŷ. Gdy model dobrze opisuje dane, punkty tworzą poziomą chmurę o stałej szerokości wokół zera. Wartości dopasowane łączą wszystkie predyktory w jedną liczbę, więc jeden wykres wystarcza także w regresji wielorakiej.
Jak czytać wykres
- Linia trendu reszt – zwykle wygładzenie LOESS, czyli regresja lokalnie ważona (Cleveland, 1979) – powinna biec blisko zera. Łuk w kształcie U albo odwróconego U oznacza, że model pomija krzywiznę.
- Szerokość chmury powinna być podobna na całej osi. Lejek, czyli rozrzut rosnący w prawo, to heterogeniczność wariancji. Dokładniej pokazuje ją wykres skala–położenie.
- Prostego trendu tu nie zobaczysz. W modelu MNK z wyrazem wolnym reszty są z definicji nieskorelowane z wartościami dopasowanymi (w przykładzie r = .000). Wykres wykrywa więc tylko wzorce nieliniowe i zmiany rozrzutu.
- Pojedyncze punkty daleko od zera to kandydaci na obserwacje odstające. Ich wpływ na model oceniasz osobnymi miarami.
Przykład
W danych symulowanych 150 dzieci w wieku 4–10 lat rozwiązało test słownikowy. Liczba poprawnych odpowiedzi rosła z wiekiem coraz szybciej, ale model zakładał prostą. R² wyniósł .902, więc „na liczbach” model wygląda bardzo dobrze. Wykres reszt pokazuje jednak łuk: średnia reszta wynosi 0.83 punktu w dolnym tercylu wartości dopasowanych, −2.25 w środkowym i 1.42 w górnym. Po dodaniu członu kwadratowego (regresja krzywoliniowa) średnie reszty w tercylach spadają do −0.26, 0.31 i −0.05, a R² rośnie do .933. Poprawa dopasowania jest istotna, F(1, 147) = 68.22, p < .001. Krzywiznę i rozrzut w symulacji ustawiono ręcznie tak, by łuk był wyraźny; ziarna 748 nie zmieniano.
Na rysunku
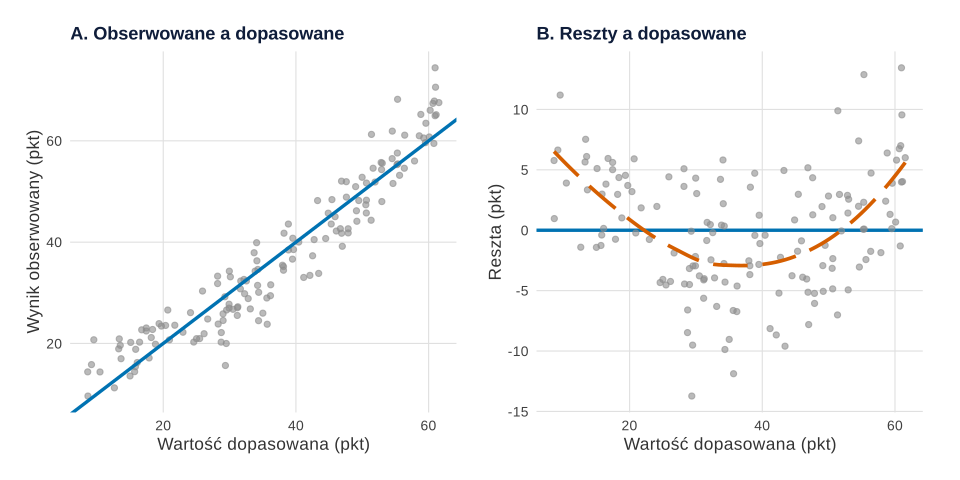
set.seed(748)).Co widać. Panel A to wykres wyników obserwowanych względem dopasowanych. Punkty leżą wzdłuż przekątnej, więc łatwo uznać model za trafny. Panel B pokazuje te same 150 dzieci po odjęciu przekątnej. Silny trend przestaje zasłaniać odchylenia i krzywa LOESS układa się w wyraźne U. Model zaniża wyniki najmłodszych i najstarszych dzieci, a zawyża wyniki dzieci ze środka zakresu.
Na co uważać. Kształt krzywej LOESS zależy od wygładzania (tu span = 0.75, domyślny w ggplot2). Na krańcach osi krzywa opiera się na nielicznych punktach, więc nie interpretuj zagięcia wywołanego dwiema, trzema obserwacjami. Wykres nie mówi też, którego predyktora dotyczy krzywizna; w modelu z wieloma zmiennymi sprawdź reszty względem każdego predyktora. Przy małej próbie losowe zmarszczki łatwo wziąć za wzorzec. Buja i in. (2009) proponują porównać prawdziwy wykres z kilkoma wykresami danych symulowanych z modelu. Typowe wzorce (łuk, lejek, skośny błąd, pasma, autokorelacja) zebrano we wpisie Galeria wykresów reszt.
Podpis do pracy:
Kod rysunku i obliczeń z przykładu znajdziesz w sekcji Wykres reszt w R.
Jak opisać w pracy
Na co uważać
- Wysokie R² nie zastępuje wykresu. W przykładzie R² = .902, a model i tak był źle określony.
- Nie rysuj reszt względem obserwowanego y. Reszty korelują z y nawet w poprawnym modelu, więc taki wykres zawsze pokazuje pozorny trend.
- Ten wykres nie ocenia normalności. Do tego służy wykres kwantylowy Q-Q reszt.
- Nie usuwaj punktów, żeby wyprostować LOESS. Łuk zwykle oznacza zły kształt modelu, a nie złe obserwacje.
Wykres reszt w R
Pierwszy przepis porównuje model liniowy i kwadratowy na danych z przykładu. Drugi rysuje Rysunek 1; jest samowystarczalny (paleta Okabe–Ito i motyw zdefiniowane w kodzie). Oba zaczynają się od tego samego set.seed(748), więc skopiowane osobno dają te same liczby co na stronie. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Gotowy wykres bez ggplot2 rysuje plot(m1, which = 1).
Łuk w resztach i poprawka członem kwadratowym
R
set.seed(748)                                         # te same dane co na rysunku 1
n <- 150
wiek <- runif(n, 4, 10)
slowa <- 15 + 3 * (wiek - 4) + 0.9 * (wiek - 4)^2 + rnorm(n, sd = 4)
m1 <- lm(slowa ~ wiek)                                # model z rysunku: prosta
m2 <- lm(slowa ~ wiek + I(wiek^2))                    # model z członem kwadratowym
tercyle <- function(m) {                              # średnia reszta w tercylach wartości dopasowanych
  t3 <- cut(fitted(m), quantile(fitted(m), 0:3 / 3), include.lowest = TRUE,
            labels = c("niskie", "srednie", "wysokie"))
  round(tapply(resid(m), t3, mean), 2)
}
rbind(liniowy = tercyle(m1), kwadratowy = tercyle(m2))
round(c(R2_liniowy = summary(m1)$r.squared, R2_kwadratowy = summary(m2)$r.squared), 3)
anova(m1, m2)                                         # czy łuk na wykresie reszt to coś więcej niż szum
# plot(m1, which = 1)                                 # wbudowany wykres reszt względem dopasowanych
Wynik w R
           niskie srednie wysokie
liniowy      0.83   -2.25    1.42
kwadratowy  -0.26    0.31   -0.05
   R2_liniowy R2_kwadratowy
        0.902         0.933
Analysis of Variance Table

Model 1: slowa ~ wiek
Model 2: slowa ~ wiek + I(wiek^2)
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    148 3621.2
2    147 2473.4  1    1147.8 68.216 7.806e-14 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Kod rysunku 1
Kod R rysunku 1
# Rysunek 1. Te same dane: obserwowane względem dopasowanych (A) i reszty względem dopasowanych (B)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(model = "#0072B2", loess = "#D55E00")         # Okabe–Ito; linie różnią się też rodzajem
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
set.seed(748)                                         # 150 dzieci w wieku 4–10 lat
n <- 150
wiek <- runif(n, 4, 10)
slowa <- 15 + 3 * (wiek - 4) + 0.9 * (wiek - 4)^2 + rnorm(n, sd = 4)   # wzrost przyspiesza z wiekiem
m <- lm(slowa ~ wiek)                                 # model liniowy pomija człon kwadratowy
d <- data.frame(dop = fitted(m), obs = slowa, res = resid(m))
pA <- ggplot(d, aes(dop, obs)) + geom_point(colour = "grey55", alpha = 0.6) +
  geom_abline(intercept = 0, slope = 1, colour = kol[["model"]], linewidth = 1.2) +
  labs(title = "A. Obserwowane a dopasowane", x = "Wartość dopasowana (pkt)",
       y = "Wynik obserwowany (pkt)")
pB <- ggplot(d, aes(dop, res)) + geom_hline(yintercept = 0, colour = kol[["model"]], linewidth = 1.2) +
  geom_point(colour = "grey55", alpha = 0.6) +
  geom_smooth(method = "loess", formula = y ~ x, span = 0.75, se = FALSE,
              colour = kol[["loess"]], linewidth = 1.3, linetype = "longdash") +
  labs(title = "B. Reszty a dopasowane", x = "Wartość dopasowana (pkt)", y = "Reszta (pkt)")
p1 <- (pA + pB) & motyw
trzecie <- cut(d$dop, quantile(d$dop, 0:3 / 3), include.lowest = TRUE, labels = c("niskie", "srednie", "wysokie"))
round(tapply(d$res, trzecie, mean), 2)                # średnia reszta w tercylach wartości dopasowanych
round(c(R2_liniowy = summary(m)$r.squared, r_reszty_dopasowane = cor(d$res, d$dop)), 3)
p1
Wynik w R
 niskie srednie wysokie
   0.83   -2.25    1.42
         R2_liniowy r_reszty_dopasowane
              0.902               0.000
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe lm(), anova(), resid(), fitted(); rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego na osi poziomej wykresu reszt są wartości dopasowane, a nie predyktor?
Wartości dopasowane łączą wszystkie predyktory modelu w jedną liczbę, więc jeden wykres podsumowuje cały model, także w regresji wielorakiej. Wykresy reszt względem poszczególnych predyktorów są uzupełnieniem: pokazują, której zmiennej dotyczy krzywizna.
Czy linia LOESS na wykresie reszt musi być idealnie płaska?
Nie. Nawet w poprawnym modelu krzywa faluje, zwłaszcza na krańcach osi i przy małej próbie. Niepokój powinien budzić wyraźny, systematyczny kształt (łuk), a nie pojedyncze zagięcia oparte na kilku punktach.
Jak zrobić wykres reszt względem wartości dopasowanych w SPSS?
W oknie regresji liniowej wybierz Wykresy i ustaw *ZRESID na osi Y oraz *ZPRED na osi X. SPSS rysuje wtedy reszty standaryzowane względem standaryzowanych wartości przewidywanych; linię trendu możesz dodać w edytorze wykresu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Galeria wykresów reszt
Łuk, lejek, skos, dźwignia, dwa pasma i fale w czasie – jak wyglądają złamane założenia regresji na wykresach reszt z R, z podpisami i ćwiczeniem.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikMetoda najmniejszych kwadratów w obrazkach
Reszty jako kwadraty, parabola sumy kwadratów, regresja y na x i x na y, oś główna, dźwignia i R² – skąd się bierze prosta regresji, na rysunkach z R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Buja, A., Cook, D., Hofmann, H., Lawrence, M., Lee, E.-K., Swayne, D. F., & Wickham, H. (2009). Statistical inference for exploratory data analysis and model diagnostics. Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences, 367(1906), 4361–4383. https://doi.org/10.1098/rsta.2009.0120 ● Otwarty dostęp: pełny tekst
- Cleveland, W. S. (1979). Robust locally weighted regression and smoothing scatterplots. Journal of the American Statistical Association, 74(368), 829–836. https://doi.org/10.1080/01621459.1979.10481038
Cytowania BibTeX
@article{buja2009statistical, author={Buja, Andreas and Cook, Dianne and Hofmann, Heike and Lawrence, Michael and Lee, Eun-Kyung and Swayne, Deborah F. and Wickham, Hadley}, title={{Statistical inference for exploratory data analysis and model diagnostics}}, journal={Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences}, year={2009}, volume={367}, number={1906}, pages={4361--4383}, doi={10.1098/rsta.2009.0120}}@article{cleveland1979robust, author={Cleveland, William S.}, title={{Robust locally weighted regression and smoothing scatterplots}}, journal={Journal of the American Statistical Association}, year={1979}, volume={74}, number={368}, pages={829--836}, doi={10.1080/01621459.1979.10481038}}