Jak czytać tę galerię
Ten wpis to atlas wzorców, nie procedura. Kolejność kroków diagnostyki, wybór reszt, testy i analizę wrażliwości opisuje wpis diagnostyka regresji w R. Tutaj każdy problem pokazuję osobno, na danych symulowanych, w których wiem, co jest „zepsute” – a Ty uczysz się rozpoznawać obraz.
Każdy model ma dwa panele. Po lewej reszty studentyzowane względem wartości dopasowanych: przerywane linie to ±2, pomarańczowa krzywa to wygładzenie LOESS. Po prawej wykres Q-Q tych samych reszt. Obserwacje wyróżnione w danym przykładzie mają kształt trójkąta. Przy każdym rysunku znajdziesz: co widać, czego wykres nie pokazuje, co zrobić, gotowy podpis i zdanie do Wyników. Podpisy są w jednym ciągu – w pracy rozdziel numer, tytuł i notę „Uwaga.” według APA 7.
Kolory. Rysunki używają palety Okabe–Ito, a grupy i wyróżnione osoby rozróżnia też kształt punktu. W przepisie 7 sprawdzam to symulacją deuteranopii: odległość barw niebieski–cynober prawie się nie zmienia (ΔE 114.6 wobec 108.3), a dla pary czerwony–zielony spada ze 121.7 do 21.1.
Punkt odniesienia: poprawny model przy n = 30
Najpierw model, w którym wszystko jest w porządku: dobrostan zależy liniowo od wsparcia społecznego, błąd ma rozkład normalny o stałej wariancji. Z tego modelu losuję trzy niezależne próby po 30 osób.
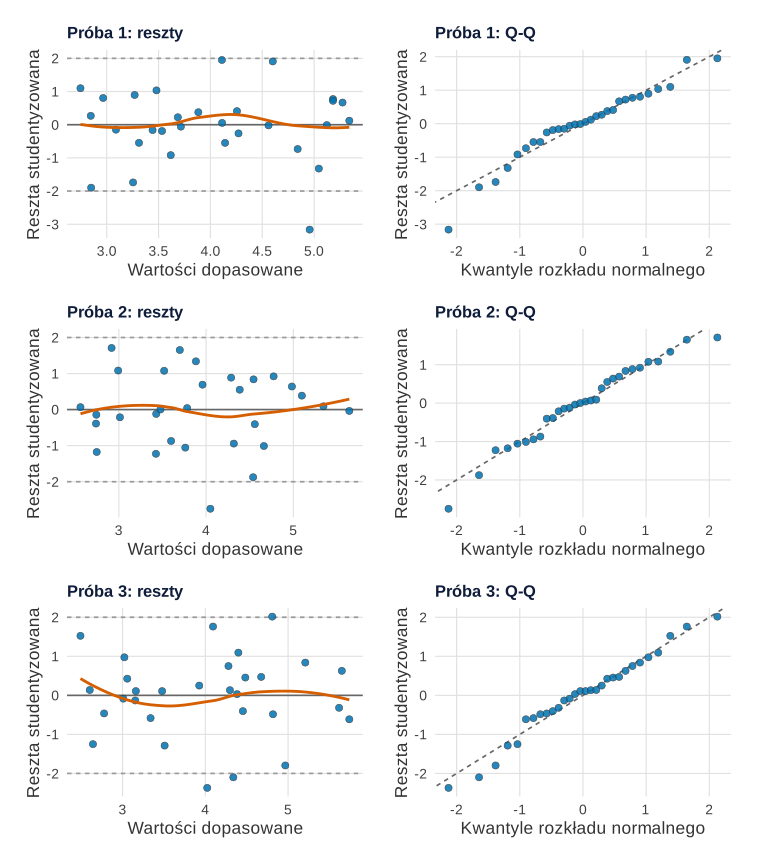
Co widać. Żaden z sześciu paneli nie wygląda „podręcznikowo”. Krzywa LOESS faluje, w próbie 1 jedna reszta wynosi co do wartości bezwzględnej 3.16, a w próbie 3 trzy reszty wychodzą poza ±2. Na wykresach Q-Q skrajne punkty odchodzą od linii. A przecież model jest dokładnie prawdziwy. W 10 000 takich próbach przynajmniej jedna reszta poza ±2 pojawiła się w 92.9% z nich (błąd Monte Carlo ≈ 0.3 pp), a test Shapiro–Wilka dał p < .05 w 5.2% (≈ 0.2 pp) – tyle, ile wynosi poziom α.
Czego ten wykres nie pokazuje. Przy 30 osobach losowe zmarszczki wyglądają jak wzorce. Buja i in. (2009) proponują, by przed oceną prawdziwego wykresu obejrzeć kilka wykresów danych symulowanych z modelu – właśnie po to, by oswoić oko z przypadkową zmiennością. W tym samym nurcie Loy i in. (2016) pokazali, że rozpoznawanie wykresu prawdziwych danych wśród wykresów symulowanych było czulsze niż klasyczne testy normalności. Wniosek praktyczny: przy małym n szukaj wyraźnych, powtarzalnych kształtów, a nie pojedynczych punktów.
Co zrobić. Nic – i to też jest decyzja. Jedna reszta poza ±2 na 30 to wynik oczekiwany, nie obserwacja odstająca do usunięcia.
Podpis do pracy.
Zdanie do Wyników (gdyby to była Twoja próba 1):
Łuk, lejek i skośny ogon
Trzy modele po 120 obserwacji, w każdym złamane jest jedno założenie. Łuk: wynik egzaminu rośnie z godzinami nauki coraz wolniej, a model zakłada prostą. Lejek: przy trudniejszych zadaniach czasy reakcji są dłuższe i bardziej rozproszone. Skos: czas zamartwiania się zależy od stresu liniowo, ale błąd ma długi prawy ogon.
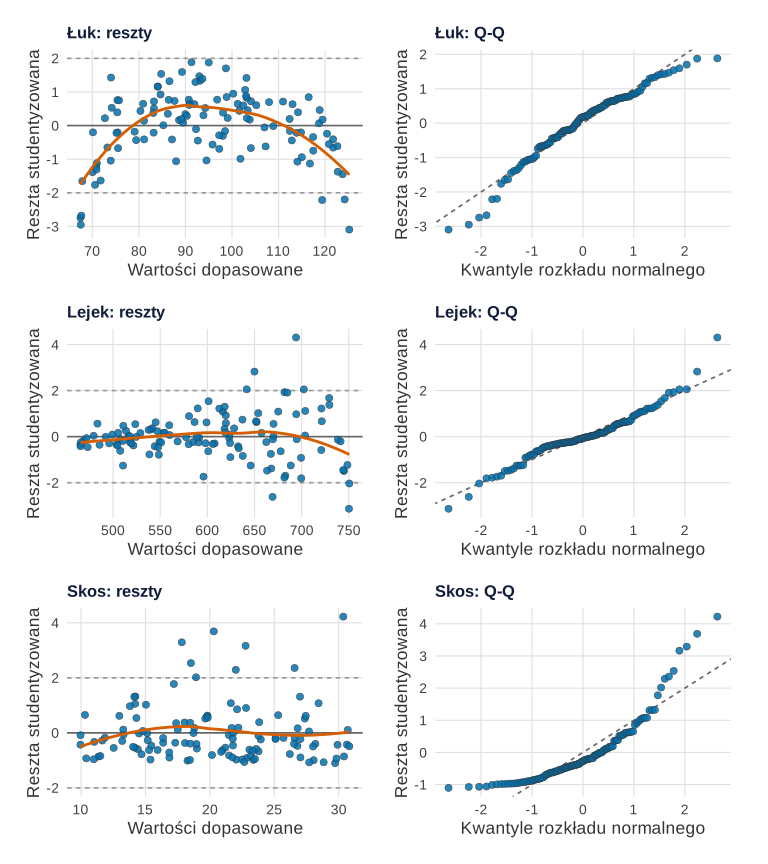
Co widać. Łuk: reszty ujemne na obu krańcach i dodatnie w środku, LOESS układa się w odwrócone U. Lejek: chmura reszt rozszerza się w prawo – SD reszt surowych wynosi 28.94 ms przy zadaniach łatwych (trudność poniżej 4) i 111.49 ms przy trudnych (powyżej 7). Skos: na wykresie reszt wiele punktów tuż pod zerem i rzadkie duże wartości nad zerem; na wykresie Q-Q punkty układają się w łuk wygięty do góry, skośność reszt wynosi 1.70.
Czego ten wykres nie pokazuje. Wykres Q-Q nie widzi złego kształtu modelu: przy łuku punkty leżą prawie na linii. Odwrotnie przy lejku – Q-Q pokazuje „ciężkie ogony”, choć błąd w każdym punkcie jest normalny, tylko o różnej wariancji. Dlatego zaczynaj od lewego panelu, a Q-Q oglądaj na końcu. Ile kosztuje lejek? W 10 000 próbach z tym samym lejkiem, ale nachyleniem równym zeru, klasyczny test nachylenia dawał p < .05 w 7.1% prób (≈ 0.3 pp), a test z błędami HC3 – w 5.4% (≈ 0.2 pp). W innych układach danych różnica bywa większa albo mniejsza; wykres nie powie, jak duża jest u Ciebie.
Co zrobić.
- Łuk – dodaj człon kwadratowy albo inną krzywą (regresja krzywoliniowa); tu R² rośnie z .84 do .91. Jak pokazać taki model na wykresie przewidywań, opisuje wpis wynik regresji na wykresie.
- Lejek – naruszona jest homoskedastyczność. Użyj odpornych błędów standardowych HC3; Long i Ervin (2000) zalecają je zawsze, gdy można podejrzewać heteroskedastyczność, bez uzależniania od testu wstępnego. Przy czasach reakcji rozważ też transformację logarytmiczną.
- Skos – przy dużej próbie często nic: Knief i Forstmeier (2021) w symulacjach pokazali, że modele z normalnym błędem dają dość wiarygodne wartości p także przy danych nienormalnych, z wyjątkiem wpływowych obserwacji odstających. Więcej we wpisie normalność reszt czy zmiennych.
Podpis do pracy (wersja dla lejka – w pracy pokaż tylko swój model):
Zdanie do Wyników.
Odstająca, dźwignia, wpływ: trzy różne punkty
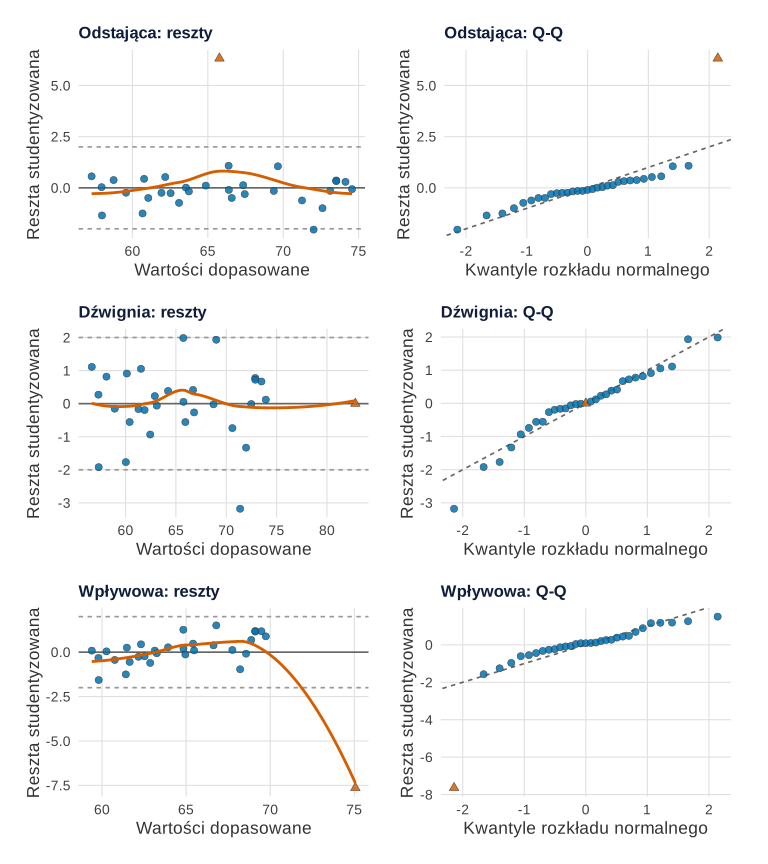
Te same 30 osób (motywacja 1–5, wynik testu) i za każdym razem jedna dopisana osoba. Odstająca: przeciętna motywacja (3), bardzo wysoki wynik (85). Dźwignia: skrajna motywacja (7), wynik dokładnie na przedłużeniu prostej. Wpływowa: skrajna motywacja (7) i niski wynik (55).
| Dopisana osoba | Dźwignia h | Reszta studentyzowana | D Cooka | Nachylenie b z nią (bez niej 4.42) |
|---|---|---|---|---|
| odstająca | .03 | 6.32 | 0.28 | 4.42 |
| dźwignia | .28 | 0.00 | 0.00 | 4.42 |
| wpływowa | .28 | −7.64 | 3.79 | 2.65 |
Co widać. Odstająca to trójkąt wysoko nad resztą chmury i daleko od linii Q-Q, ale nachylenie prawie się nie zmienia. Jej D = 0.28 przekracza heurystykę 4/n = 0.13, bo przesuwa wyraz wolny (z 51.86 na 52.51). Punkt dźwigni jest na wykresie reszt niewidoczny: leży na zerze, na skraju osi. Ma dźwignię .28 (ponad dwa razy więcej niż próg 2p/n = .13), ale zerowy wpływ. Punkt wpływowy łączy jedno z drugim – odległość Cooka (Cook, 1977) wynosi 3.79, a nachylenie spada z 4.42 do 2.65. LOESS „ciągnie” w jego stronę cały prawy kraniec wykresu.
Czego ten wykres nie pokazuje. Dźwigni nie ma na osi reszt, więc wykres reszt względem wartości dopasowanych jej nie ujawni – potrzebujesz wykresu reszt względem dźwigni albo wartości h. Duża reszta studentyzowana punktu wpływowego wynika z tego, że reszty studentyzowane liczy się bez danej obserwacji; zwykła reszta bywa mniejsza, bo punkt przyciągnął do siebie prostą. Wykres nie mówi też, czy to błąd wpisania, czy prawdziwa osoba.
Co zrobić. Sprawdź dane źródłowe, a potem pokaż wynik z tą osobą i bez niej. Reguły decyzji i przykłady opisuje wpis wartości odstające: jak je wykryć.
Podpis do pracy.
Zdanie do Wyników.
Dwa pasma: pominięta zmienna grupująca
160 osób, po 80 ze studiów stacjonarnych i niestacjonarnych; wynik zależy od godzin nauki, a niestacjonarni mają średnio niższy poziom. Górny wiersz to model bez trybu studiów, dolny – z trybem.
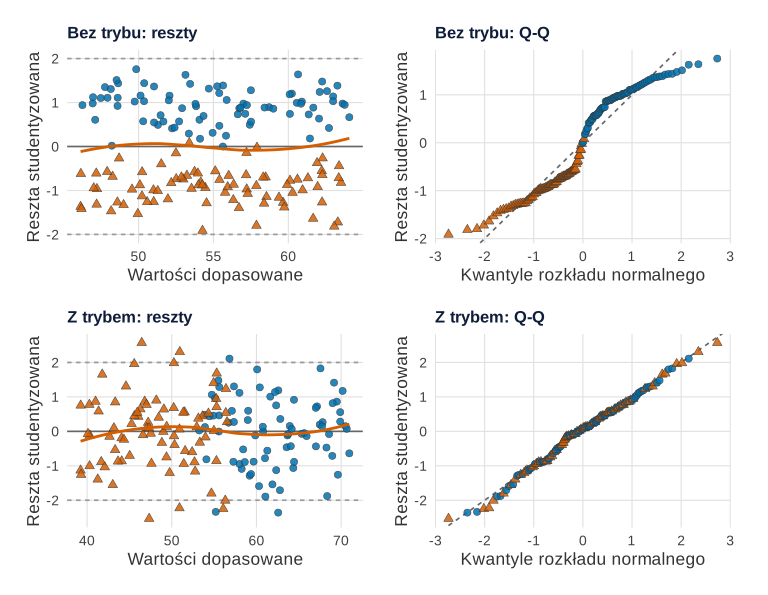
Co widać. W modelu bez trybu reszty tworzą dwa równoległe pasma: stacjonarni (kółka) średnio 6.94 punktu nad zerem, niestacjonarni (trójkąty) 6.94 pod zerem. Wykres Q-Q ma charakterystyczny „schodek” na środku – rozkład reszt jest dwumodalny. Po dodaniu trybu pasma się zlewają, R² rośnie z .31 do .89, a SD reszt spada z 7.60 do 3.00.
Czego ten wykres nie pokazuje. Pasma widać tylko wtedy, gdy grupy różnią się wyraźnie, a Ty oznaczysz je kształtem. Bez oznaczeń zobaczysz co najwyżej szeroką chmurę i nieco spłaszczony Q-Q. Wykres nie wskaże też, jaka to zmienna – musisz ją znać i mieć w danych.
Co zrobić. Dodaj zmienną grupującą do modelu. Gdy grup jest wiele (klasy, szkoły, oddziały), sięgnij po model wielopoziomowy.
Podpis do pracy.
Zdanie do Wyników.
Fale w czasie: autokorelacja reszt
Dzienniczek jednej osoby przez 100 dni: nastrój względem liczby godzin snu. Błąd ma „pamięć” dnia poprzedniego (proces autoregresyjny pierwszego rzędu).
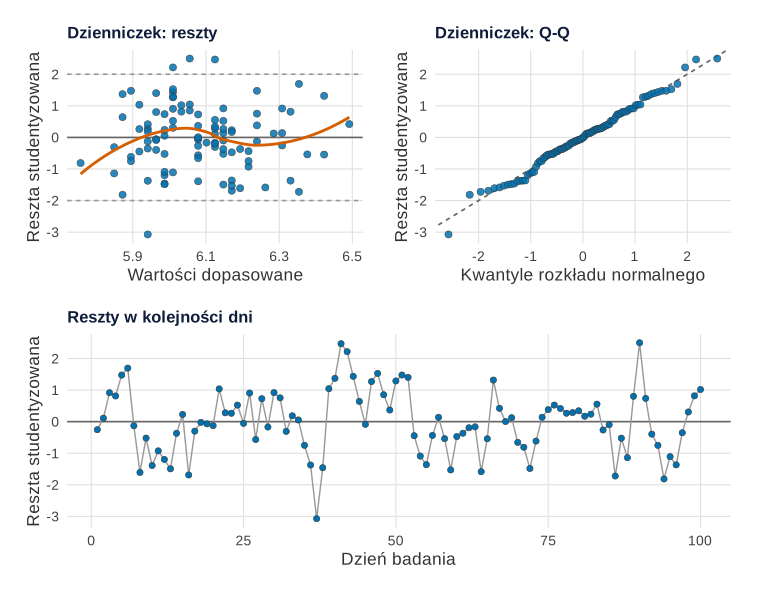
Co widać. Dwa standardowe panele wyglądają przyzwoicie: wykres reszt bez wyraźnego kształtu, Q-Q blisko linii (Shapiro–Wilk p = .656). Problem widać dopiero w trzecim panelu, gdy reszty ułożysz w kolejności dni: tworzą fale – kilka dni nad zerem, potem kilka pod. Korelacja reszty z resztą z dnia poprzedniego wynosi .59, a statystyka Durbina–Watsona 0.82 (bez autokorelacji reszt byłaby bliska 2).
Czego ten wykres nie pokazuje. Dwa standardowe panele z definicji tego nie pokażą, bo gubią kolejność obserwacji. Koszt jest duży: gdy sen i nastrój nie są ze sobą związane, ale oba mają pamięć dnia poprzedniego, klasyczny test nachylenia dawał p < .05 w 24.9% z 10 000 szeregów (błąd MC ≈ 0.4 pp). W krótkich szeregach trudne jest też samo oszacowanie autokorelacji (Huitema i McKean, 1991).
Co zrobić. Zawsze, gdy dane mają kolejność (dni, sesje, pomiary), narysuj reszty względem czasu i policz test Durbina-Watsona. Błędy AR(1) uwzględnisz w modelu dopasowanym metodą GLS.
Podpis do pracy.
Zdanie do Wyników.
Ćwiczenie: cztery wykresy bez podpisu
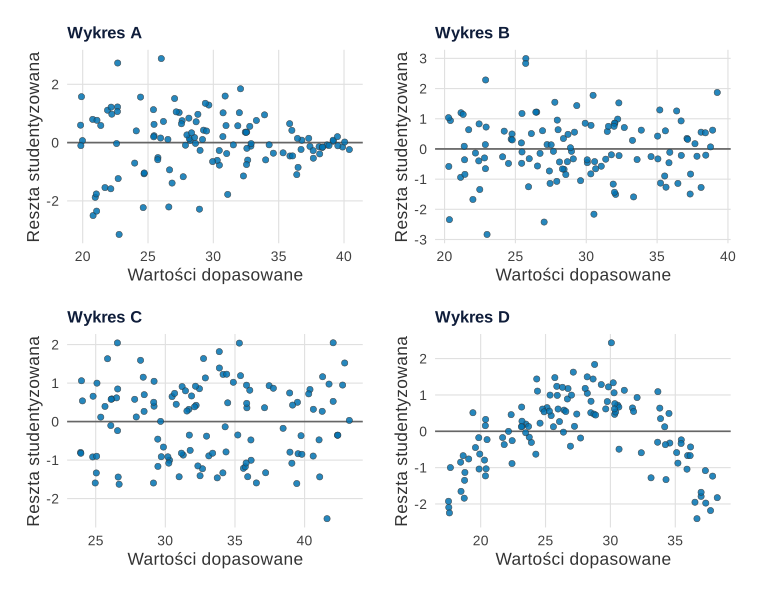
Każdy panel pochodzi z innego modelu (po 120 obserwacji, przepis 6). Jeden jest poprawny, w trzech złamano po jednym założeniu. Rozpoznaj, który jest który, zanim rozwiniesz rozwiązanie.
Rozwiązanie
- A – lejek odwrócony. Rozrzut reszt maleje wraz z wartością dopasowaną: heteroskedastyczność. Kierunek lejka nie ma znaczenia.
- B – model poprawny. Pojedyncze reszty blisko ±3 to nie wzorzec; przy 120 obserwacjach kilka takich jest oczekiwanych.
- C – dwa pasma. Pominięta zmienna grupująca. Odstęp między pasmami jest mniejszy niż na Rysunku 4, a punkty nie mają oznaczeń grup, więc łatwo go przeoczyć.
- D – łuk. Nieliniowość: reszty ujemne na krańcach, dodatnie w środku.
Czego ćwiczenie nie pokazuje: w prawdziwych danych naruszenia rzadko występują pojedynczo – lejek często idzie w parze ze skośnością, a łuk z wartościami odstającymi na krańcu.
Ściąga: wzorzec i pierwszy krok
| Co widzisz | Co to znaczy | Pierwszy krok |
|---|---|---|
| falująca chmura bez kształtu, kilka reszt poza ±2 | nic – zwykła losowość | nie zmieniaj modelu |
| łuk, U, odwrócone U | nieliniowość | człon kwadratowy, krzywa |
| lejek | heteroskedastyczność | błędy HC3, ewentualnie transformacja |
| łuk na Q-Q, rzadkie duże reszty z jednej strony | skośny błąd | zwykle nic przy dużym n |
| jeden punkt daleko | odstająca, dźwignia lub wpływ | h, D, analiza z punktem i bez |
| dwa pasma, schodek na Q-Q | pominięta grupa | dodaj zmienną grupującą |
| fale w kolejności pomiarów | autokorelacja | Durbin–Watson, model AR(1) |
Wykresy reszt nie ujawnią współliniowości predyktorów – tę oceniasz osobno. Jeśli chcesz zobaczyć, jak te same problemy wyglądają na zwykłym wykresie rozrzutu, zajrzyj do wpisu zawsze narysuj dane.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje paletę, motyw i funkcję para(), z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu przepisu 1. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Dane symulowane nie wymagają pobierania – kod sam je tworzy. Dla wygody dane z przepisów 2–5 są też w pliku wykresy-reszt-dane-symulowane.csv (kolumny przyklad, x, y, grupa; wartości zaokrąglone do trzech miejsc). Ziarno losowania 570 ustalono z góry, jednakowe we wszystkich przepisach, bez dobierania pod wynik. Parametry modeli (kształt łuku, siłę lejka, skośność błędu, położenie dopisanych osób, różnicę między trybami studiów, autokorelację .7 i parametry ćwiczenia) dobrano ręcznie, żeby każdy wzorzec był widoczny. Symulacje Monte Carlo mają po 10 000 powtórzeń; błąd Monte Carlo proporcji to √(p(1 − p)/10 000).
1. Paleta, motyw, funkcja para() i poprawny model: Rysunek 1
R
# Punkt odniesienia: poprawny model regresji przy n = 30 też bywa „brzydki” (dane symulowane)
library(ggplot2)
library(patchwork)
# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw) i prosty motyw
okabe <- c(niebieski = "#0072B2", cynober = "#D55E00", zielony = "#009E73", pomarancz = "#E69F00")
theme_set(theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(size = rel(0.95), face = "bold")))

# Para wykresów diagnostycznych: reszty studentyzowane a wartości dopasowane + wykres Q-Q reszt.
# wyroznij = numery obserwacji pokazanych trójkątem (np. punkt odstający).
para <- function(model, tytul, wyroznij = NULL) {
  d <- data.frame(dopasowane = fitted(model), reszta = rstudent(model), typ = "pozostałe")
  d$typ[wyroznij] <- "wyróżniona"
  ksztalt <- scale_shape_manual(values = c("pozostałe" = 21, "wyróżniona" = 24), guide = "none")
  wypelnienie <- scale_fill_manual(values = c("pozostałe" = okabe[["niebieski"]],
                                              "wyróżniona" = okabe[["cynober"]]), guide = "none")
  rvf <- ggplot(d, aes(dopasowane, reszta)) +
    geom_hline(yintercept = 0, colour = "grey40") +
    geom_hline(yintercept = c(-2, 2), linetype = "22", colour = "grey60") +
    geom_point(aes(shape = typ, fill = typ), size = 2.3, colour = "grey20", stroke = 0.3, alpha = 0.85) +
    geom_smooth(method = "loess", formula = y ~ x, se = FALSE, span = 0.9,
                colour = okabe[["cynober"]], linewidth = 1) +
    ksztalt + wypelnienie +
    labs(title = paste0(tytul, ": reszty"), x = "Wartości dopasowane", y = "Reszta studentyzowana")
  o <- order(d$reszta)                                   # wykres Q-Q liczony ręcznie, żeby zachować kształty
  q <- data.frame(teoretyczne = qnorm(ppoints(nrow(d))), reszta = d$reszta[o], typ = d$typ[o])
  qq <- ggplot(q, aes(teoretyczne, reszta)) +
    geom_abline(intercept = 0, slope = 1, linetype = "22", colour = "grey40") +
    geom_point(aes(shape = typ, fill = typ), size = 2.3, colour = "grey20", stroke = 0.3, alpha = 0.85) +
    ksztalt + wypelnienie +
    labs(title = paste0(tytul, ": Q-Q"), x = "Kwantyle rozkładu normalnego", y = "Reszta studentyzowana")
  rvf + qq
}

# Model prawdziwy: dobrostan = 2 + 0.5 × wsparcie + błąd N(0, 0.6); trzy niezależne próby po 30 osób
set.seed(570)
proba <- function(n = 30) {
  wsparcie <- runif(n, 1, 7)                             # wsparcie społeczne 1–7
  data.frame(wsparcie, dobrostan = 2 + 0.5 * wsparcie + rnorm(n, 0, 0.6))
}
wzorzec <- lapply(1:3, function(i) lm(dobrostan ~ wsparcie, data = proba()))
round(t(sapply(wzorzec, function(m) c(b = coef(m)[[2]], R2 = summary(m)$r.squared,
  max_abs_reszta = max(abs(rstudent(m))), reszt_poza_2 = sum(abs(rstudent(m)) > 2),
  p_Shapiro = shapiro.test(rstudent(m))$p.value))), 3)

# Monte Carlo: 10 000 prób po 30 osób z tego samego, poprawnego modelu
R <- 10000
mc <- t(replicate(R, {
  m <- lm(dobrostan ~ wsparcie, data = proba())
  c(poza_2 = any(abs(rstudent(m)) > 2), shapiro = shapiro.test(residuals(m))$p.value < .05)
}))
odsetek <- colMeans(mc)
round(rbind(odsetek_proc = 100 * odsetek, blad_MC_pp = 100 * sqrt(odsetek * (1 - odsetek) / R)), 1)

p1 <- para(wzorzec[[1]], "Próba 1") / para(wzorzec[[2]], "Próba 2") / para(wzorzec[[3]], "Próba 3")
p1
# ggsave("wykresy-reszt-wzorzec.svg", p1, width = 8, height = 9)   # zapis do pliku (pakiet svglite)
Wynik w R
         b    R2 max_abs_reszta reszt_poza_2 p_Shapiro
[1,] 0.442 0.767          3.162            1     0.173
[2,] 0.547 0.644          2.750            1     0.540
[3,] 0.552 0.748          2.370            3     0.625
             poza_2 shapiro
odsetek_proc   92.9     5.2
blad_MC_pp      0.3     0.2
2. Łuk, lejek i skośny błąd: Rysunek 2
R
# Trzy naruszenia naraz po jednym: łuk (nieliniowość), lejek (heteroskedastyczność), skośne reszty
set.seed(570)
n <- 120
# Łuk: wynik egzaminu rośnie z godzinami nauki coraz wolniej, a model zakłada prostą
nauka <- runif(n, 0, 20)
luk <- data.frame(nauka, egzamin = 40 + 25 * log1p(nauka) + rnorm(n, 0, 5))
m_luk <- lm(egzamin ~ nauka, data = luk)
m_luk2 <- lm(egzamin ~ nauka + I(nauka^2), data = luk)
# Lejek: przy trudniejszych zadaniach czasy reakcji są dłuższe i bardziej rozproszone
trudnosc <- runif(n, 1, 10)
lejek <- data.frame(trudnosc, czas = 400 + 40 * trudnosc + rnorm(n, 0, 12 * trudnosc))
m_lejek <- lm(czas ~ trudnosc, data = lejek)
# Skośne reszty: błąd z rozkładu wykładniczego (długi prawy ogon), średnio 0, stała wariancja
stres <- runif(n, 0, 10)
skos <- data.frame(stres, zamartwianie = 10 + 2 * stres + (rexp(n, rate = 1 / 6) - 6))
m_skos <- lm(zamartwianie ~ stres, data = skos)

skosnosc <- function(x) mean((x - mean(x))^3) / sd(x)^3
round(c(R2_prosta = summary(m_luk)$r.squared, R2_z_kwadratem = summary(m_luk2)$r.squared,
        p_kwadrat = summary(m_luk2)$coefficients["I(nauka^2)", 4],
        SD_reszt_latwe = sd(residuals(m_lejek)[trudnosc < 4]),
        SD_reszt_trudne = sd(residuals(m_lejek)[trudnosc > 7]),
        skosnosc_reszt = skosnosc(residuals(m_skos))), 3)

# Monte Carlo: czy lejek psuje test nachylenia? Ten sam lejek, ale prawdziwe nachylenie = 0; 10 000 prób po 100 obserwacji.
# Porównanie klasycznego błędu standardowego z odpornym HC3 (wzór liczony ręcznie).
test_nachylenia <- function(n = 100) {
  x <- runif(n, 1, 10); y <- 400 + rnorm(n, 0, 12 * x)
  X <- cbind(1, x); XtXi <- solve(crossprod(X)); b <- XtXi %*% crossprod(X, y)
  e <- drop(y - X %*% b); h <- rowSums((X %*% XtXi) * X)
  se_klas <- sqrt(sum(e^2) / (n - 2) * XtXi[2, 2])
  se_hc3 <- sqrt((XtXi %*% crossprod(X * (e / (1 - h)), X * (e / (1 - h))) %*% XtXi)[2, 2])
  2 * pt(abs(b[2] / c(klasyczny = se_klas, HC3 = se_hc3)), n - 2, lower.tail = FALSE) < .05
}
R <- 10000
alarmy <- rowMeans(replicate(R, test_nachylenia()))
round(rbind(falszywe_alarmy_proc = 100 * alarmy, blad_MC_pp = 100 * sqrt(alarmy * (1 - alarmy) / R)), 1)

p2 <- para(m_luk, "Łuk") / para(m_lejek, "Lejek") / para(m_skos, "Skos")
p2
Wynik w R
      R2_prosta  R2_z_kwadratem       p_kwadrat  SD_reszt_latwe SD_reszt_trudne
          0.839           0.912           0.000          28.937         111.487
 skosnosc_reszt
          1.697
                     klasyczny HC3
falszywe_alarmy_proc       7.1 5.4
blad_MC_pp                 0.3 0.2
3. Wartość odstająca, dźwignia i wpływ: Rysunek 3
R
# Wartość odstająca, punkt dźwigni i punkt wpływowy: te same 30 osób + jedna dopisana osoba (dane symulowane)
set.seed(570)
baza <- data.frame(motywacja = runif(30, 1, 5))          # motywacja 1–7, w próbie 1–5
baza$wynik <- 50 + 5 * baza$motywacja + rnorm(30, 0, 4)    # wynik testu
m_baza <- lm(wynik ~ motywacja, data = baza)
na_prostej <- unname(predict(m_baza, data.frame(motywacja = 7)))   # przedłużenie prostej do motywacji 7
dopisana <- list(odstajaca = c(motywacja = 3, wynik = 85),          # zwykła motywacja, bardzo wysoki wynik
                 dzwignia = c(motywacja = 7, wynik = na_prostej),   # skrajna motywacja, wynik na prostej
                 wplywowa = c(motywacja = 7, wynik = 55))           # skrajna motywacja, wynik wbrew trendowi
modele <- lapply(dopisana, function(o) lm(wynik ~ motywacja, data = rbind(baza, o)))
round(rbind(sapply(modele, function(m) c(
  dzwignia_h = hatvalues(m)[[31]], reszta_stud = rstudent(m)[[31]], Cook_D = cooks.distance(m)[[31]],
  b_z_osoba = coef(m)[[2]], b_bez_osoby = coef(m_baza)[[2]],
  b0_z_osoba = coef(m)[[1]], b0_bez_osoby = coef(m_baza)[[1]]))), 3)
round(c(prog_dzwigni_2p_n = 2 * 2 / 31, prog_Cooka_4_n = 4 / 31), 3)

p3 <- para(modele$odstajaca, "Odstająca", 31) / para(modele$dzwignia, "Dźwignia", 31) /
  para(modele$wplywowa, "Wpływowa", 31)
p3
Wynik w R
             odstajaca dzwignia wplywowa
dzwignia_h       0.032    0.279    0.279
reszta_stud      6.324    0.000   -7.643
Cook_D           0.284    0.000    3.793
b_z_osoba        4.420    4.422    2.647
b_bez_osoby      4.422    4.422    4.422
b0_z_osoba      52.511   51.864   56.531
b0_bez_osoby    51.864   51.864   51.864
prog_dzwigni_2p_n    prog_Cooka_4_n
            0.129             0.129
4. Pominięta zmienna grupująca: Rysunek 4
R
# Pominięta zmienna grupująca: dwie grupy o różnym poziomie wyniku w jednym modelu (dane symulowane)
set.seed(570)
tryb <- rep(c("stacjonarne", "niestacjonarne"), each = 80)
nauka <- runif(160, 2, 14)                                # godziny nauki tygodniowo
grupy <- data.frame(tryb = factor(tryb, levels = c("stacjonarne", "niestacjonarne")), nauka,
                    wynik = 50 + 1.5 * nauka + ifelse(tryb == "niestacjonarne", -14, 0) + rnorm(160, 0, 3))
m_bez <- lm(wynik ~ nauka, data = grupy)
m_z <- lm(wynik ~ nauka + tryb, data = grupy)
round(c(R2_bez_trybu = summary(m_bez)$r.squared, R2_z_trybem = summary(m_z)$r.squared,
        SD_reszt_bez = sigma(m_bez), SD_reszt_z = sigma(m_z),
        b_trybu = coef(m_z)[["trybniestacjonarne"]]), 3)
# Średnia reszta modelu bez trybu w każdej grupie: tu ukrywa się pominięta zmienna
round(tapply(residuals(m_bez), grupy$tryb, mean), 2)

p4 <- para(m_bez, "Bez trybu", which(grupy$tryb == "niestacjonarne")) /
  para(m_z, "Z trybem", which(grupy$tryb == "niestacjonarne"))
p4
Wynik w R
R2_bez_trybu  R2_z_trybem SD_reszt_bez   SD_reszt_z      b_trybu
       0.311        0.893        7.601        3.003      -13.886
   stacjonarne niestacjonarne
          6.94          -6.94
5. Autokorelacja reszt: Rysunek 5
R
# Zależność w czasie: dzienniczek jednej osoby przez 100 dni, błędy z procesu AR(1) (dane symulowane)
set.seed(570)
dni <- 100
ar1 <- function(n, phi, sd) as.numeric(arima.sim(list(ar = phi), n = n, sd = sd))
dziennik <- data.frame(dzien = 1:dni, sen = round(7 + ar1(dni, 0.5, 0.6), 1))   # godziny snu
dziennik$nastroj <- 4 + 0.3 * dziennik$sen + ar1(dni, 0.7, 0.5)                 # nastrój 1–7
m_czas <- lm(nastroj ~ sen, data = dziennik)
e <- residuals(m_czas)
round(c(r_reszt_lag1 = cor(e[-1], e[-dni]),
        Durbin_Watson = sum(diff(e)^2) / sum(e^2),             # ≈ 2 – brak autokorelacji
        p_Shapiro = shapiro.test(e)$p.value), 3)

# Monte Carlo: sen nie wpływa na nastrój (nachylenie = 0), ale oba szeregi mają pamięć dnia poprzedniego.
# Jak często klasyczny test nachylenia daje p < .05? 10 000 szeregów po 100 dni.
R <- 10000
alarm <- replicate(R, {
  x <- ar1(dni, 0.7, 1); y <- ar1(dni, 0.7, 1)
  summary(lm(y ~ x))$coefficients[2, 4] < .05
})
round(c(falszywe_alarmy_proc = 100 * mean(alarm), blad_MC_pp = 100 * sqrt(mean(alarm) * (1 - mean(alarm)) / R)), 1)

dziennik$reszta <- rstudent(m_czas)
p_czas <- ggplot(dziennik, aes(dzien, reszta)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(colour = "grey60", linewidth = 0.5) +
  geom_point(shape = 21, size = 2, fill = okabe[["niebieski"]], colour = "grey20", stroke = 0.3) +
  labs(title = "Reszty w kolejności dni", x = "Dzień badania", y = "Reszta studentyzowana")
p5 <- para(m_czas, "Dzienniczek") / p_czas
p5
Wynik w R
 r_reszt_lag1 Durbin_Watson     p_Shapiro
        0.589         0.818         0.656
falszywe_alarmy_proc           blad_MC_pp
                24.9                  0.4
6. Ćwiczenie: Rysunek 6
R
# Ćwiczenie: cztery wykresy reszt bez podpisu – rozpoznaj wzorzec (dane symulowane, rozwiązanie w tekście)
set.seed(570)
n <- 120
x <- runif(n, 0, 10)
grupa <- rbinom(n, 1, 0.5)
zagadki <- list(
  A = lm(y ~ x, data.frame(x, y = 20 + 2 * x + rnorm(n, 0, 0.3 + 0.5 * (10 - x)))),
  B = lm(y ~ x, data.frame(x, y = 20 + 2 * x + rnorm(n, 0, 3))),
  C = lm(y ~ x, data.frame(x, y = 20 + 2 * x + 6 * grupa + rnorm(n, 0, 2))),
  D = lm(y ~ x, data.frame(x, y = 20 + 2 * x - 0.3 * (x - 5)^2 + rnorm(n, 0, 1.5))))
wykres_zagadki <- function(m, litera)
  ggplot(data.frame(dopasowane = fitted(m), reszta = rstudent(m)), aes(dopasowane, reszta)) +
    geom_hline(yintercept = 0, colour = "grey40") +
    geom_point(shape = 21, size = 2, fill = okabe[["niebieski"]], colour = "grey20", stroke = 0.3, alpha = 0.85) +
    labs(title = paste("Wykres", litera), x = "Wartości dopasowane", y = "Reszta studentyzowana")
p6 <- wrap_plots(Map(wykres_zagadki, zagadki, names(zagadki)), ncol = 2)
p6
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory wykresów przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (punkty i linia LOESS)" = c("#0072B2", "#D55E00"),
             "szary – cynober (linia ±2 i LOESS)" = c("#999999", "#D55E00"),
             "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                           widzenie_typowe deuteranopia
niebieski – cynober (punkty i linia LOESS)           114.6        108.3
szary – cynober (linia ±2 i LOESS)                    77.2         62.9
czerwony – zielony (dla porównania)                  121.7         21.1
                                           protanopia
niebieski – cynober (punkty i linia LOESS)       91.9
szary – cynober (linia ±2 i LOESS)               56.0
czerwony – zielony (dla porównania)              31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Uznanie jednej reszty poza ±2 za problem. Przy 30 osobach zdarza się to w ponad 9 próbach na 10 z poprawnego modelu.
- Ocena założeń tylko z wykresu Q-Q. Q-Q nie widzi łuku ani fal w czasie, a lejek udaje na nim ciężkie ogony.
- Szukanie dźwigni na wykresie reszt. Punkt dźwigni może mieć resztę równą zeru.
- Odczytywanie wzorców z krzywej LOESS przy małym n. Wygładzenie faluje nawet przy prawdziwym modelu, a na krańcach osi opiera się na kilku punktach.
- Brak wykresu reszt względem czasu w dzienniczkach, pomiarach sesyjnych i danych z kolejnych dni.
- Grupy bez oznaczeń. Dwa pasma znikają, gdy wszystkie punkty mają ten sam kształt i kolor.
Najczęstsze pytania
Jak wygląda heteroskedastyczność na wykresie reszt?
Jak lejek: rozrzut reszt rośnie (albo maleje) wraz z wartością dopasowaną. W przykładzie na tej stronie odchylenie standardowe reszt wynosiło 28.94 ms przy łatwych zadaniach i 111.49 ms przy trudnych. Kierunek lejka nie ma znaczenia. Typowa odpowiedź to odporne błędy standardowe HC3; na wykresie Q-Q heteroskedastyczność może udawać ciężkie ogony.
Czy reszta studentyzowana większa niż 2 oznacza, że model jest zły?
Nie. Około 5% reszt z poprawnego modelu przekracza ±2. W symulacji 10 000 prób po 30 osób z poprawnego modelu aż 92.9% prób miało przynajmniej jedną taką resztę. Problemem jest dopiero wyraźny kształt (łuk, lejek, pasma) albo pojedyncza reszta o dużej dźwigni i dużym wpływie na wyniki.
Dlaczego punktu o dużej dźwigni nie widać na wykresie reszt?
Bo dźwignia dotyczy położenia na osi predyktora, nie reszty. Osoba o skrajnej wartości predyktora, ale wyniku zgodnym z trendem, leży na zerze na skraju osi wartości dopasowanych. W przykładzie miała dźwignię .28 i odległość Cooka 0.00. Takie punkty pokazuje wykres reszt względem dźwigni albo wartości h.
Co oznaczają dwa pasma na wykresie reszt?
Najczęściej pominiętą zmienną grupującą: model ma jeden wyraz wolny, a grupy różnią się poziomem wyniku. Reszty jednej grupy leżą wtedy nad zerem, drugiej pod zerem, a wykres Q-Q ma schodek na środku. Dodaj zmienną grupującą do modelu – w przykładzie R² wzrosło z .31 do .89.
Jak sprawdzić na wykresie autokorelację reszt?
Narysuj reszty w kolejności pomiarów (dni, sesji) i połącz je linią. Autokorelacja daje fale – kilka kolejnych reszt nad zerem, potem kilka pod. Standardowy wykres reszt i wykres Q-Q jej nie pokażą, bo gubią kolejność. Liczbowo pomoże korelacja reszt z dnia na dzień i statystyka Durbina–Watsona.
Powiązane hasła
Przeczytaj też
Diagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikZawsze narysuj dane
Kwartet Anscombe’a i cztery pułapki korelacji na wykresach z R – z podpisem APA i zdaniem do Wyników przy każdym rysunku.
Czytaj →PoradnikWynik regresji na wykresie
Współczynniki z CI, pasmo ufności a predykcji, ekstrapolacja, interakcja, efekty brzegowe i prawdopodobieństwa – pięć rysunków z kodem R i podpisami APA.
Czytaj →Nie wiesz, co pokazują Twoje wykresy reszt?
Pomożemy ocenić diagnostykę modelu regresji, rozpoznać nieliniowość, heteroskedastyczność i obserwacje wpływowe oraz opisać decyzje w pracy – tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Buja, A., Cook, D., Hofmann, H., Lawrence, M., Lee, E.-K., Swayne, D. F., & Wickham, H. (2009). Statistical inference for exploratory data analysis and model diagnostics. Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences, 367(1906), 4361–4383. https://doi.org/10.1098/rsta.2009.0120 ● Otwarty dostęp: pełny tekst
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Huitema, B. E., & McKean, J. W. (1991). Autocorrelation estimation and inference with small samples. Psychological Bulletin, 110(2), 291–304. https://doi.org/10.1037/0033-2909.110.2.291
- Knief, U., & Forstmeier, W. (2021). Violating the normality assumption may be the lesser of two evils. Behavior Research Methods, 53(6), 2576–2590. https://doi.org/10.3758/s13428-021-01587-5 ● Otwarty dostęp
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Loy, A., Follett, L., & Hofmann, H. (2016). Variations of Q–Q plots: The power of our eyes! The American Statistician, 70(2), 202–214. https://doi.org/10.1080/00031305.2015.1077728
Cytowania BibTeX
@article{buja2009statistical, author={Buja, Andreas and Cook, Dianne and Hofmann, Heike and Lawrence, Michael and Lee, Eun-Kyung and Swayne, Deborah F. and Wickham, Hadley}, title={{Statistical inference for exploratory data analysis and model diagnostics}}, journal={Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences}, year={2009}, volume={367}, number={1906}, pages={4361--4383}, doi={10.1098/rsta.2009.0120}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{huitema1991autocorrelation, author={Huitema, Bradley E. and McKean, Joseph W.}, title={{Autocorrelation estimation and inference with small samples}}, journal={Psychological Bulletin}, year={1991}, volume={110}, number={2}, pages={291--304}, doi={10.1037/0033-2909.110.2.291}}@article{knief2021violating, author={Knief, Ulrich and Forstmeier, Wolfgang}, title={{Violating the normality assumption may be the lesser of two evils}}, journal={Behavior Research Methods}, year={2021}, volume={53}, number={6}, pages={2576--2590}, doi={10.3758/s13428-021-01587-5}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{loy2016variations, author={Loy, Adam and Follett, Lendie and Hofmann, Heike}, title={{Variations of Q–Q plots: The power of our eyes!}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={202--214}, doi={10.1080/00031305.2015.1077728}}