Co to jest metoda uogólnionych najmniejszych kwadratów?
Metoda uogólnionych najmniejszych kwadratów (ang. generalized least squares, GLS) to odmiana metody najmniejszych kwadratów, w której rozbieżności między danymi a modelem nie są traktowane jednakowo. Każda z nich dostaje wagę zależną od tego, jak bardzo jest zmienna i jak koreluje z innymi. Idea pochodzi od Aitkena (1936). W psychologii GLS spotkasz w dwóch miejscach: w regresji, gdy błędy mają nierówne wariancje albo są skorelowane, oraz w SEM i CFA jako jeden ze standardowych estymatorów obok ML. Ten tekst dotyczy głównie drugiego zastosowania.
GLS w regresji i w SEM – wzory
W regresji zwykła MNK zakłada, że błędy mają równą wariancję i nie korelują. Gdy znamy (albo modelujemy) macierz kowariancji błędów Ω, oszacowanie GLS ma postać:
Obserwacje o dużej wariancji błędu ważą mniej, a skorelowane błędy – np. w szeregu czasowym albo w pomiarach powtarzanych – przestają udawać niezależną informację. Gdy chodzi tylko o heteroskedastyczność, a nie o jej model, prostszym wyjściem są odporne błędy standardowe HC3 (zob. też homoskedastyczność).
W SEM „danymi” są wariancje i kowariancje zmiennych obserwowalnych. Jöreskog i Goldberger (1972) zastosowali zasadę Aitkena do analizy czynnikowej, używając jako macierzy wag odwrotności macierzy kowariancji z próby S. Funkcja rozbieżności ma postać:
Σ(θ) to macierz kowariancji odtworzona przez model, a tr – ślad macierzy (suma elementów na przekątnej). Autorzy pokazali, że oszacowania GLS nie zależą od skali zmiennych i są asymptotycznie efektywne. Przy wielowymiarowej normalności i poprawnym modelu GLS i ML mają w dużych próbach te same własności, a statystyka N × FGLS ma rozkład χ².
Różnica leży w wagach. GLS waży rozbieżności odwrotnością S, czyli macierzy ustalonej z góry. ML w każdym kroku iteracji używa Σ(θ), czyli macierzy z aktualnego modelu. ADF zastępuje obie macierze wagami z momentów czwartego rzędu. GLS jest więc „normalno-teoretycznym” przypadkiem ważonych najmniejszych kwadratów, tak samo jak ML zakłada normalność.
Przykład: GLS „lepiej pasuje”, ale bardziej się myli
Trzystu uczniów (dane symulowane) wypełniło 9 pozycji samooceny akademickiej. Trzy pozycje dotyczą matematyki (M1–M3), trzy – języka polskiego (J1–J3), a trzy – ogólnej samooceny szkolnej (O1–O3). W populacji pozycja J3 („Dobrze radzę sobie z zadaniami, w których trzeba czytać ze zrozumieniem”) ładuje też czynnik matematyczny, a prawdziwa korelacja czynników M i J wynosi .30. Badacz dopasowuje czysty model trójczynnikowy bez tego ładunku krzyżowego. Model jest więc źle określony, jak bywa w praktyce.
| Miara | ML | GLS |
|---|---|---|
| χ²(24) | 92.49 | 69.23 |
| RMSEA | .098 | .079 |
| SRMR | .069 | .093 |
| χ² modelu bazowego | 691.90 | 237.13 |
| CFI | .896 | .775 |
| Korelacja czynników M–J (prawdziwa .30) | .549 | .608 |
Według χ² i RMSEA model oszacowany metodą GLS wygląda lepiej. CFI jest jednak dużo niższy, bo GLS stosuje się też do modelu bazowego, a jego χ² spada aż do 237.13. Indeksów przyrostowych z GLS nie można więc porównywać z progami opracowanymi dla ML. Najważniejszy jest ostatni wiersz. Pominięty ładunek krzyżowy zawyża korelację czynników w obu metodach, ale w GLS bardziej (.608 wobec .549).
Żeby sprawdzić, czy to nie przypadek, analizę powtórzono w 500 próbach z tej samej populacji (rysunek 1). Średni RMSEA wyniósł .081 dla ML i .064 dla GLS. Średnia korelacja M–J wyniosła .542 dla ML i .628 dla GLS, przy wartości prawdziwej .30. CFI z GLS był niższy niż z ML w każdej z 500 prób (średnio .848 wobec .935).
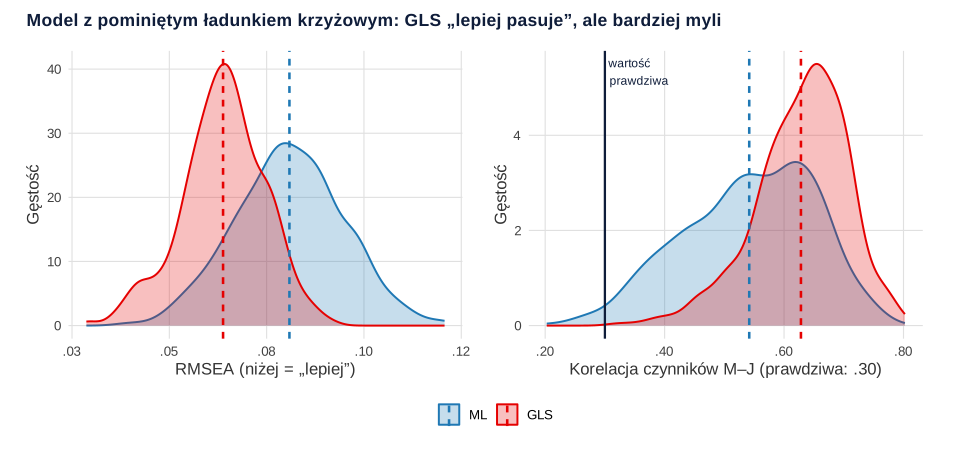
Ten wzór opisali Olsson i in. (1999). Gdy model jest uproszczeniem prawdziwej struktury, GLS daje lepsze dopasowanie empiryczne niż ML, ale osiąga je kosztem większego zniekształcenia parametrów. W kolejnym badaniu Olsson i in. (2000) stwierdzili, że przy błędnej specyfikacji ML daje bardziej realistyczne indeksy dopasowania i mniej obciążone parametry niż GLS. Lepsze dopasowanie nie oznacza więc lepszego modelu.
Kiedy wybrać GLS
- W SEM z danymi ciągłymi zwykle nie ma powodu, by zastępować nim ML. Obie metody zakładają normalność, a ML lepiej znosi błędy specyfikacji i daje indeksy dopasowania porównywalne z literaturą.
- GLS bywa używany jako analiza wrażliwości – jeśli wnioski różnią się między ML a GLS, to sygnał, że model może być źle określony (zob. analiza wrażliwości).
- Przy nienormalności GLS niczego nie poprawia. Wybierz ML z korektą (MLR), bootstrap albo, przy pozycjach porządkowych, WLSMV.
- W regresji GLS ma sens, gdy potrafisz uzasadnić strukturę wariancji i kowariancji błędów, np. autokorelację w danych dziennikowych albo wariancję zależną od grupy. Źle określona Ω daje pozornie precyzyjne błędy standardowe.
GLS w programach statystycznych
GLS jest dostępny w większości programów do SEM i analizy czynnikowej, często bez zmiany domyślnych ustawień w innych miejscach:
- lavaan (R): argument
estimator = "GLS"w funkcjachcfa()isem(); program wypisuje wtedy także χ² modelu bazowego oszacowanego metodą GLS. - AMOS: GLS (Generalized least squares) to jedna z metod do wyboru w ustawieniach estymacji, obok ML, ULS i ADF.
- SPSS, analiza czynnikowa: metoda wyodrębniania Generalized least squares to eksploracyjna wersja tej samej idei. Daje test χ² dla liczby czynników i jest wrażliwa na te same problemy co w CFA.
Niezależnie od programu sprawdź w wynikach, którą metodą oszacowano model bazowy. Od tego zależy, z czym wolno porównywać CFI i TLI.
Jak opisać estymację w pracy
Zawsze podaj metodę estymacji. Jeśli porównujesz estymatory, napisz, który jest główny i dlaczego, a różnice skomentuj. Wzór zdania dla analizy wrażliwości:
GLS i ML w R (lavaan)
Kod generuje dane z populacji z ładunkiem krzyżowym, dopasowuje model bez tego ładunku metodami ML i GLS (estimator = "GLS"), zestawia miary dopasowania i standaryzowane parametry, a następnie powtarza porównanie w 500 próbach. Liczby w tekście, w tabeli i na rysunku 1 pochodzą z tego kodu (symulacja trwa ok. minuty).
Ten sam źle określony model: ML a GLS
R
# R121 – GLS a ML w CFA, gdy model jest źle określony (pakiet lavaan)
# Dane symulowane: 300 osób, 9 pozycji kwestionariusza samooceny akademickiej (1–5):
# trzy czynniki (matematyka M, język J, ogólna O). W populacji J3 ma ładunek krzyżowy na M,
# a model badacza go pomija.
suppressPackageStartupMessages(library(lavaan))
populacja <- '
  M =~ 0.75*M1 + 0.70*M2 + 0.70*M3 + 0.45*J3
  J =~ 0.75*J1 + 0.70*J2 + 0.45*J3
  O =~ 0.70*O1 + 0.70*O2 + 0.65*O3
  M ~~ 0.30*J
  M ~~ 0.50*O
  J ~~ 0.50*O
'
model <- '
  M =~ M1 + M2 + M3
  J =~ J1 + J2 + J3
  O =~ O1 + O2 + O3
'
set.seed(121)
dane <- simulateData(populacja, sample.nobs = 300, standardized = TRUE)

# Funkcja rozbieżności GLS: F = ½ tr{[(S − Σ(θ)) S⁻¹]²}; ML: F = ln|Σ| − ln|S| + tr(S Σ⁻¹) − p
# Model bazowy (niezależności) też jest szacowany metodą GLS – to zmienia CFI i TLI
fit_ml  <- cfa(model, data = dane, estimator = "ML")
fit_gls <- cfa(model, data = dane, estimator = "GLS")
miary <- c("chisq", "df", "pvalue", "baseline.chisq", "cfi", "tli", "rmsea", "srmr")
round(rbind(ML = fitMeasures(fit_ml, miary), GLS = fitMeasures(fit_gls, miary)), 3)

# Standaryzowane ładunki i korelacje czynników: ML i GLS
std <- function(f) { s <- standardizedSolution(f); s <- s[s$op %in% c("=~", "~~") & s$lhs != s$rhs, ]
  setNames(round(s$est.std, 3), paste(s$lhs, s$op, s$rhs)) }
cbind(ML = std(fit_ml), GLS = std(fit_gls))

# Symulacja: 500 prób po N = 300 z tej samej populacji – średnie miary dopasowania i korelacja M–J
set.seed(1211)
sym <- t(replicate(500, {
  d <- simulateData(populacja, sample.nobs = 300, standardized = TRUE)
  f1 <- suppressWarnings(cfa(model, data = d, estimator = "ML"))
  f2 <- suppressWarnings(cfa(model, data = d, estimator = "GLS"))
  ujemne <- function(f) any(diag(lavInspect(f, "est")$theta) < 0)
  r <- function(f) { s <- standardizedSolution(f); s$est.std[s$lhs == "M" & s$op == "~~" & s$rhs == "J"] }
  c(cfi_ML = fitMeasures(f1, "cfi"), cfi_GLS = fitMeasures(f2, "cfi"),
    rmsea_ML = fitMeasures(f1, "rmsea"), rmsea_GLS = fitMeasures(f2, "rmsea"),
    odrz_ML = fitMeasures(f1, "pvalue") < .05, odrz_GLS = fitMeasures(f2, "pvalue") < .05,
    rMJ_ML = r(f1), rMJ_GLS = r(f2), heywood_ML = ujemne(f1), heywood_GLS = ujemne(f2))
}))
colnames(sym) <- sub("\\..*$", "", colnames(sym))
round(colMeans(sym), 3)
round(mean(sym[, "cfi_GLS"] > sym[, "cfi_ML"]), 3)   # odsetek prób, w których CFI z GLS jest wyższe
saveRDS(as.data.frame(sym), "gls-symulacja.rds")
Wynik w R
     chisq df pvalue baseline.chisq   cfi   tli rmsea  srmr
ML  92.488 24      0        691.902 0.896 0.843 0.098 0.069
GLS 69.230 24      0        237.133 0.775 0.663 0.079 0.093
           ML   GLS
M =~ M1 0.726 0.666
M =~ M2 0.649 0.617
M =~ M3 0.727 0.690
J =~ J1 0.575 0.654
J =~ J2 0.553 0.685
J =~ J3 0.768 0.782
O =~ O1 0.708 0.701
O =~ O2 0.678 0.685
O =~ O3 0.575 0.596
M ~~ J  0.549 0.608
M ~~ O  0.303 0.332
J ~~ O  0.614 0.591
     cfi_ML     cfi_GLS    rmsea_ML   rmsea_GLS     odrz_ML    odrz_GLS
      0.935       0.848       0.081       0.064       0.998       0.964
     rMJ_ML     rMJ_GLS  heywood_ML heywood_GLS
      0.542       0.628       0.002       0.000
[1] 0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Wybór GLS, „bo model lepiej pasuje”. Niższe χ² i RMSEA przy GLS w źle określonym modelu idą w parze z bardziej zniekształconymi parametrami.
- Porównywanie CFI i TLI z GLS z progami dla ML. Model bazowy też jest szacowany metodą GLS, więc indeksy przyrostowe mają inną skalę. W przykładzie CFI spadł z .896 do .775.
- Traktowanie GLS jako metody dla danych nienormalnych. Normalno-teoretyczne wagi S−1 nie korygują ani testu, ani błędów standardowych przy kurtozie.
- Mylenie GLS w SEM z GLS w regresji (np.
nlme::gls()). Nazwa jest wspólna, ale w regresji ważysz reszty obserwacji, a w SEM – elementy macierzy kowariancji.
Miejsce estymatora w całym procesie analizy SEM opisuje przewodnik CB-SEM, a przykład z kodem dla ML i MLR – wpis CB-SEM w R w pakiecie lavaan.
Najczęstsze pytania
Czym różni się GLS od ML w SEM?
Obie metody zakładają wielowymiarową normalność i przy poprawnym modelu dają w dużych próbach równoważne wyniki. GLS waży rozbieżności odwrotnością macierzy kowariancji z próby, ustaloną przed estymacją, a ML – macierzą odtworzoną przez model, aktualizowaną w każdej iteracji. Przy źle określonym modelu GLS zwykle pokazuje niższe χ², ale bardziej zniekształca parametry.
Czy GLS nadaje się do danych nienormalnych?
Nie. Wagi w GLS wynikają z teorii normalnej, więc przy dużej kurtozie test χ² i błędy standardowe są tak samo zawodne jak w zwykłym ML. Przy nienormalnych danych ciągłych wybierz MLR, MLM lub bootstrap, a przy pozycjach porządkowych – WLSMV.
Dlaczego CFI z GLS jest niższy niż z ML?
Bo model bazowy (niezależności) też jest szacowany metodą GLS, a jego χ² jest wtedy znacznie mniejsze. W przykładzie z tego hasła χ² modelu bazowego spadło z 691.90 (ML) do 237.13 (GLS), a CFI tego samego modelu – z .896 do .775. Progów CFI opracowanych dla ML nie stosuj więc do GLS.
Kiedy używa się GLS w regresji?
Gdy błędy mają znaną albo modelowaną strukturę wariancji i kowariancji, np. autokorelację w danych zbieranych codziennie albo różne wariancje w grupach. W R służy do tego funkcja nlme::gls(). Jeśli nie potrafisz uzasadnić tej struktury, bezpieczniejsza jest zwykła regresja z odpornymi błędami standardowymi.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aitken, A. C. (1936). On least squares and linear combination of observations. Proceedings of the Royal Society of Edinburgh, 55, 42–48. https://doi.org/10.1017/s0370164600014346
- Jöreskog, K. G., & Goldberger, A. S. (1972). Factor analysis by generalized least squares. Psychometrika, 37(3), 243–260. https://doi.org/10.1007/bf02306782
- Olsson, U. H., Foss, T., Troye, S. V., & Howell, R. D. (2000). The performance of ML, GLS, and WLS estimation in structural equation modeling under conditions of misspecification and nonnormality. Structural Equation Modeling: A Multidisciplinary Journal, 7(4), 557–595. https://doi.org/10.1207/s15328007sem0704_3
- Olsson, U. H., Troye, S. V., & Howell, R. D. (1999). Theoretic fit and empirical fit: The performance of maximum likelihood versus generalized least squares estimation in structural equation models. Multivariate Behavioral Research, 34(1), 31–58. https://doi.org/10.1207/s15327906mbr3401_2
Cytowania BibTeX
@article{aitken1936least, author={Aitken, A. C.}, title={{On least squares and linear combination of observations}}, journal={Proceedings of the Royal Society of Edinburgh}, year={1936}, volume={55}, pages={42--48}, doi={10.1017/s0370164600014346}}@article{joreskog1972factor, author={Jöreskog, Karl G. and Goldberger, Arthur S.}, title={{Factor analysis by generalized least squares}}, journal={Psychometrika}, year={1972}, volume={37}, number={3}, pages={243--260}, doi={10.1007/bf02306782}}@article{olsson2000performance, author={Olsson, Ulf Henning and Foss, Tron and Troye, Sigurd V. and Howell, Roy D.}, title={{The performance of ML, GLS, and WLS estimation in structural equation modeling under conditions of misspecification and nonnormality}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2000}, volume={7}, number={4}, pages={557--595}, doi={10.1207/s15328007sem0704_3}}@article{olsson1999theoretic, author={Olsson, Ulf Henning and Troye, Sigurd Villads and Howell, Roy D.}, title={{Theoretic fit and empirical fit: The performance of maximum likelihood versus generalized least squares estimation in structural equation models}}, journal={Multivariate Behavioral Research}, year={1999}, volume={34}, number={1}, pages={31--58}, doi={10.1207/s15327906mbr3401_2}}