Co to jest MLR?
MLR (ang. robust maximum likelihood, odporna metoda największej wiarygodności) to sposób estymacji modeli SEM, w którym parametry szacuje się zwykłą metodą największej wiarygodności (ML), ale błędy standardowe i test dopasowania koryguje się na nienormalność danych. Oszacowania ładunków i ścieżek są identyczne jak w ML. Zmieniają się trzy rzeczy:
- błędy standardowe – liczone odpornym estymatorem „kanapkowym” (Huber–White), zwykle większe niż w ML, gdy rozkłady mają grube ogony;
- statystyka χ² – dzielona przez współczynnik skalujący (ang. scaling correction factor). W lavaan i Mplus MLR daje skalowany test Yuana–Bentlera, asymptotycznie równoważny poprawce Satorry–Bentlera;
- wskaźniki oparte na χ² – CFI, TLI i RMSEA mają wersje odporne (
cfi.robust,rmsea.robust).
Yuan i Bentler (2000) zauważają, że dane w naukach społecznych rzadko mają rozkład normalny. Metody oparte na normalności często prowadzą wtedy do błędnej oceny modelu. Autorzy podali statystyki testu, których rozkład asymptotyczny jest chi-kwadrat, o ile dane mają skończone momenty czwartego rzędu, także przy brakach danych. Dzięki temu MLR łączy się z FIML (missing = "ml"), co jest jego dużą praktyczną zaletą.
Dlaczego zwykły test χ² zawodzi przy nienormalnych danych?
Statystyka χ² w ML zakłada wielowymiarowy rozkład normalny. Gdy rozkłady są skośne, a zwłaszcza mają dodatnią kurtozę, χ² jest zawyżony. Prawdziwe modele są wtedy odrzucane zbyt często, a błędy standardowe są za małe. Curran i in. (1996) pokazali w symulacji CFA, że zwykła statystyka ML była tym bardziej zawyżona, im silniej dane odbiegały od normalności. Statystyka skalowana (Satorry–Bentlera) nie była obciążona przy żadnej liczebności próby. Ma to jednak cenę: przy modelach błędnych moc testów odpornych malała wraz z nienormalnością.
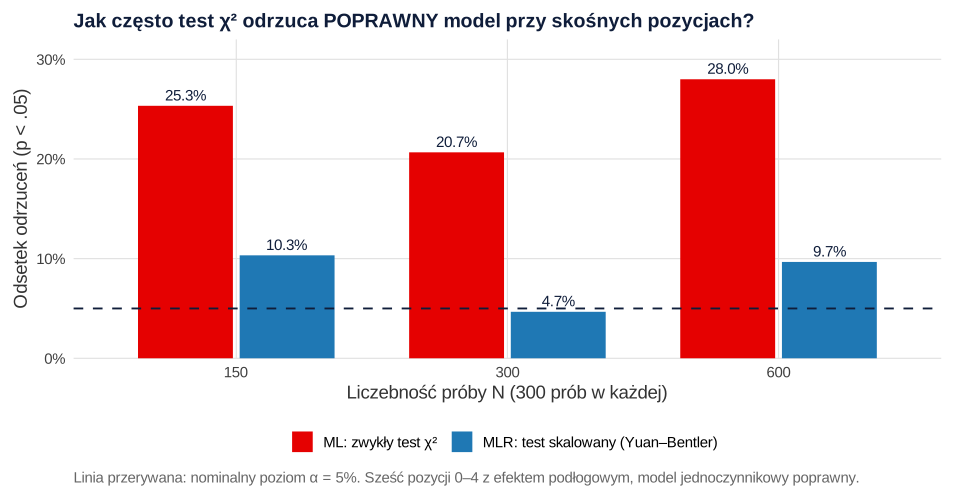
Na rysunku 1 pokazano symulację z kodu niżej. Model jednoczynnikowy z sześcioma pozycjami 0–4 i efektem podłogowym był dokładnie poprawny, a mimo to zwykły test χ² odrzucał go w 20.7–28.0% prób zamiast w 5%. Test skalowany MLR odrzucał go w 4.7–10.3% prób. To dużo bliżej nominalnego poziomu, choć przy N = 150 i 600 nadal nieco za często.
Przykład: skala objawów depresyjnych w próbie nieklinicznej
300 studentów (dane symulowane) odpowiedziało na sześć pozycji objawów depresyjnych (0 = wcale – 4 = prawie codziennie). Jak zwykle w próbie nieklinicznej odpowiedzi skupiają się przy zerze: 58.4% wszystkich odpowiedzi to „0”, a tylko 1.7% to „4”. Skośność pozycji wynosi 1.19–1.61, a kurtoza 0.80–2.34. Wielowymiarowa kurtoza Mardii wynosi 70.99 przy wartości oczekiwanej 48 dla rozkładu normalnego. To typowa sytuacja efektu podłogowego.
| Wynik | ML | MLR |
|---|---|---|
| χ²(9) | 18.52, p = .030 | 13.64, p = .136 (współczynnik skalujący 1.358) |
| CFI / TLI | .977 / .962 | .985 / .974 (odporne) |
| RMSEA | .059 | .048 (odporny) |
| SRMR | .032 | .032 |
| Ładunki (niestand.) | 0.48–0.65 | te same |
| SE ładunków | 0.054–0.057 | 0.058–0.075 (1.03–1.34 razy większe) |
Wniosek o dopasowaniu zależy od estymatora. Zwykły test χ² odrzuca model (p = .030), a po skalowaniu χ² = 18.52 / 1.358 = 13.64 i model nie jest odrzucony (p = .136). SRMR się nie zmienia, bo nie opiera się na χ². Błędy standardowe najbardziej wzrosły dla pozycji najbardziej skośnych (d3, d6), co osłabia też wnioski o istotności parametrów.
Porównując modele zagnieżdżone przy MLR, nie odejmuj od siebie skalowanych χ². Satorra i Bentler (2001) pokazali, że różnica dwóch skalowanych statystyk nie jest poprawną skalowaną statystyką różnicy, i podali prosty wzór na właściwą. W przykładzie model z równymi ładunkami (tau-równoważność) porównano z modelem swobodnym. Zwykła różnica wynosi 28.10 − 18.52 = 9.58, a skalowana Δχ²(5) = 6.47, p = .264. lavaan stosuje tę poprawkę automatycznie w lavTestLRT() (zob. test różnicy chi-kwadrat w SEM).
MLR działa też z brakami danych. Po usunięciu 6.6% odpowiedzi (braki zależne od d1, czyli MAR) model oszacowany MLR z FIML dał χ²(9) = 11.67, p = .233, CFI = .991, RMSEA = .038.
Kiedy MLR, a kiedy inny estymator?
| Dane | Estymator |
|---|---|
| Zmienne ciągłe, w przybliżeniu normalne, bez braków | ML (MLR da prawie te same wyniki) |
| Zmienne ciągłe lub sumy skal, skośne albo leptokurtyczne | MLR |
| Braki danych (MAR) przy danych ciągłych | MLR z FIML |
| Pozycje porządkowe z 5–7 kategoriami, rozkłady w miarę symetryczne | MLR albo WLSMV |
| Pozycje z 2–4 kategoriami albo silnie asymetryczne progi | WLSMV (estymacja kategorialna) |
Rhemtulla i in. (2012) w symulacji CFA z pozycjami porządkowymi zalecili estymację kategorialną przy mniej niż 5 kategoriach. Odporny ML wystarczał przy 5 i więcej kategoriach, małej próbie i w przybliżeniu symetrycznych progach. Pozycje z przykładu mają 5 kategorii, ale silnie asymetryczne progi, więc warto oszacować model także WLSMV i porównać wnioski w analizie wrażliwości. Szczegóły obliczeniowe odpornych błędów standardowych i testów w lavaan (macierz informacji obserwowana czy oczekiwana itd.) omawiają Savalei i Rosseel (2021). Alternatywą dla bardzo dużych prób jest metoda ADF.
Jak opisać MLR w pracy (APA)
Podaj powód wyboru (np. skośność, kurtoza, braki), skalowany χ² z df i p, współczynnik skalujący oraz odporne wersje CFI, TLI i RMSEA. Wzór:
Więcej o wyborze estymatora i raportowaniu dopasowania przeczytasz w poradnikach CB-SEM krok po kroku i CB-SEM w R: lavaan.
Przykład w R
Kod tworzy dane z przykładu i opisuje ich rozkład. Następnie porównuje ML i MLR, liczy skalowany test różnicy i model z brakami danych (FIML). Na końcu powtarza symulację z rysunku 1 (900 modeli; ok. 30 sekund).
ML a MLR w lavaan
R
# MLR (odporna metoda największej wiarygodności) a zwykłe ML w lavaan: skośne odpowiedzi na skali objawów
library(lavaan)

# Generator: jeden czynnik (objawy depresyjne), 6 pozycji 0–4 z efektem podłogowym (próba nieklinicza)
lam <- c(.80, .75, .70, .70, .65, .60)
progi <- c(0.25, 0.95, 1.55, 2.10)                      # większość odpowiedzi "0" i "1"
gen <- function(n) {
  f <- rnorm(n)
  x <- sapply(lam, function(l) findInterval(l * f + sqrt(1 - l^2) * rnorm(n), progi))
  colnames(x) <- paste0("d", 1:6); as.data.frame(x)
}
set.seed(117)
dane <- gen(300)                                        # dane symulowane
skosnosc <- function(x) mean((x - mean(x))^3) / sd(x)^3
kurtoza  <- function(x) mean((x - mean(x))^4) / sd(x)^4 - 3
round(rbind(M = colMeans(dane), skosnosc = sapply(dane, skosnosc), kurtoza = sapply(dane, kurtoza)), 2)
round(prop.table(table(unlist(dane))), 3)              # rozkład wszystkich odpowiedzi
# wielowymiarowa kurtoza Mardii (wartość oczekiwana przy normalności: p(p + 2) = 48)
X <- scale(dane, scale = FALSE); S <- cov(dane) * (nrow(dane) - 1) / nrow(dane)
d2 <- rowSums((X %*% solve(S)) * X); round(c(mardia_b2p = mean(d2^2), oczekiwana = 6 * 8), 2)

model <- 'depresja =~ d1 + d2 + d3 + d4 + d5 + d6'
f_ml  <- cfa(model, data = dane, estimator = "ML", std.lv = TRUE)
f_mlr <- cfa(model, data = dane, estimator = "MLR", std.lv = TRUE)
round(fitMeasures(f_ml, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "srmr")), 3)
round(fitMeasures(f_mlr, c("chisq.scaled", "df.scaled", "pvalue.scaled", "chisq.scaling.factor",
                           "cfi.robust", "tli.robust", "rmsea.robust", "srmr")), 3)
# Te same oszacowania, inne błędy standardowe
pe_ml <- parameterEstimates(f_ml); pe_mlr <- parameterEstimates(f_mlr)
w <- pe_ml$op == "=~"
print(data.frame(ladunek = pe_ml$rhs[w], est = round(pe_ml$est[w], 3), SE_ML = round(pe_ml$se[w], 3),
                 SE_MLR = round(pe_mlr$se[w], 3), iloraz = round(pe_mlr$se[w] / pe_ml$se[w], 2)), row.names = FALSE)

# Porównanie modeli zagnieżdżonych: równe ładunki (tau-równoważność) vs swobodne – skalowana różnica chi2
f_tau <- cfa('depresja =~ a*d1 + a*d2 + a*d3 + a*d4 + a*d5 + a*d6', data = dane, estimator = "MLR", std.lv = TRUE)
lavTestLRT(f_mlr, f_tau)                                # domyślnie poprawka Satorry–Bentlera (2001)

# MLR z brakami danych: FIML (missing = "ml"), ok. 8% braków zależnych od d1 (MAR)
set.seed(1171)
dane_b <- dane
for (j in 2:6) dane_b[runif(300) < plogis(-3.2 + 0.6 * dane$d1), j] <- NA
round(mean(is.na(dane_b[, 2:6])), 3)
f_b <- cfa(model, data = dane_b, estimator = "MLR", missing = "ml")
round(fitMeasures(f_b, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "rmsea.robust")), 3)

# Symulacja: model jest POPRAWNY – jak często test chi2 go odrzuca (alfa = .05)?
set.seed(1172)
sym <- expand.grid(N = c(150, 300, 600), rep = 1:300)
odrz <- t(sapply(seq_len(nrow(sym)), function(i) {
  d <- gen(sym$N[i])
  f <- cfa(model, data = d, estimator = "MLR")
  c(N = sym$N[i], ML = unname(fitMeasures(f, "pvalue") < .05), MLR = unname(fitMeasures(f, "pvalue.scaled") < .05))
}))
wyn <- aggregate(cbind(ML, MLR) ~ N, data = as.data.frame(odrz), FUN = mean)
print(round(wyn, 3), row.names = FALSE)
saveRDS(wyn, "mlr-symulacja.rds")
Wynik w R
           d1   d2   d3   d4   d5   d6
M        0.76 0.72 0.65 0.64 0.63 0.61
skosnosc 1.19 1.40 1.61 1.55 1.44 1.54
kurtoza  0.80 1.57 2.34 1.74 1.32 1.67

    0     1     2     3     4
0.584 0.239 0.117 0.043 0.017
mardia_b2p oczekiwana
     70.99      48.00
 chisq     df pvalue    cfi    tli  rmsea   srmr
18.517  9.000  0.030  0.977  0.962  0.059  0.032
        chisq.scaled            df.scaled        pvalue.scaled
              13.640                9.000                0.136
chisq.scaling.factor           cfi.robust           tli.robust
               1.358                0.985                0.974
        rmsea.robust                 srmr
               0.048                0.032
 ladunek   est SE_ML SE_MLR iloraz
      d1 0.654 0.057  0.061   1.08
      d2 0.632 0.055  0.064   1.16
      d3 0.627 0.054  0.071   1.31
      d4 0.625 0.056  0.071   1.28
      d5 0.519 0.056  0.058   1.03
      d6 0.484 0.056  0.075   1.34

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

      Df    AIC    BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
f_mlr  9 4548.5 4593.0 18.517
f_tau 14 4548.1 4574.1 28.102     6.4651 0.038053       5     0.2636
[1] 0.066
 chisq.scaled     df.scaled pvalue.scaled    cfi.robust  rmsea.robust
       11.665         9.000         0.233         0.991         0.038
   N    ML   MLR
 150 0.253 0.103
 300 0.207 0.047
 600 0.280 0.097
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Raportowanie zwykłego χ² przy MLR. lavaan wypisuje obie kolumny, standardową i skalowaną. W pracy podaj skalowaną (
chisq.scaled) i odporne wskaźniki. - Odejmowanie skalowanych χ² przy porównaniu modeli. Użyj skalowanego testu różnicy (Satorra i Bentler, 2001), np. przez
lavTestLRT(). - Przekonanie, że MLR zmienia oszacowania. Ładunki i ścieżki są te same co w ML. MLR koryguje tylko niepewność i test.
- MLR dla pozycji z 2–4 kategoriami. Przy dychotomicznych i trzykategorialnych pozycjach ładunki z ML są obciążone niezależnie od korekty. Wybierz estymację kategorialną.
- Testy normalności jako jedyne kryterium. W dużej próbie każdy test odrzuci normalność. Patrz na skośność, kurtozę i charakter danych, a przy wątpliwościach wybierz MLR – przy normalnych danych daje prawie to samo co ML.
- Brak informacji o estymatorze. „Model oszacowano w lavaan” nie wystarczy. Podaj estymator, sposób obsługi braków i rodzaj poprawki.
Najczęstsze pytania
Czym różni się MLR od ML?
Oszacowania parametrów są identyczne. MLR zmienia błędy standardowe (estymator odporny na nienormalność) i dzieli statystykę χ² przez współczynnik skalujący, a na tej podstawie liczy odporne CFI, TLI i RMSEA. Przy danych normalnych oba estymatory dają prawie takie same wyniki.
Kiedy używać estymatora MLR?
Gdy zmienne ciągłe albo pozycje z co najmniej pięcioma kategoriami mają wyraźną skośność lub kurtozę oraz gdy masz braki danych typu MAR (MLR z FIML). Przy pozycjach z 2–4 kategoriami albo silnie asymetrycznymi progami lepsza jest estymacja kategorialna, np. WLSMV.
Co oznacza współczynnik skalujący w MLR?
To liczba, przez którą dzieli się zwykły χ², by uzyskać statystykę skalowaną. Wartość 1 oznacza brak korekty, a wartości powyżej 1 – dane o grubszych ogonach niż normalne. W przykładzie na tej stronie współczynnik wynosi 1.358, więc χ² = 18.52 spada do 13.64.
Jak porównać modele zagnieżdżone przy MLR?
Nie odejmuj skalowanych χ² od siebie, bo taka różnica nie ma rozkładu chi-kwadrat. Użyj skalowanego testu różnicy Satorry–Bentlera, który w lavaan wykonuje lavTestLRT(model1, model2). W przykładzie zwykła różnica wynosi 9.58, a skalowana Δχ²(5) = 6.47.
Jak włączyć MLR w lavaan?
Dodaj argument estimator = "MLR" do cfa() albo sem(), a przy brakach danych także missing = "ml". W fitMeasures() odczytaj chisq.scaled, pvalue.scaled, chisq.scaling.factor, cfi.robust i rmsea.robust.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Curran, P. J., West, S. G., & Finch, J. F. (1996). The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis. Psychological Methods, 1(1), 16–29. https://doi.org/10.1037/1082-989x.1.1.16
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. https://doi.org/10.1037/a0029315
- Satorra, A., & Bentler, P. M. (2001). A scaled difference chi-square test statistic for moment structure analysis. Psychometrika, 66(4), 507–514. https://doi.org/10.1007/bf02296192
- Savalei, V., & Rosseel, Y. (2021). Computational options for standard errors and test statistics with incomplete normal and nonnormal data in SEM. Structural Equation Modeling: A Multidisciplinary Journal, 29(2), 163–181. https://doi.org/10.1080/10705511.2021.1877548 ● Otwarty dostęp
- Yuan, K.-H., & Bentler, P. M. (2000). Three likelihood-based methods for mean and covariance structure analysis with nonnormal missing data. Sociological Methodology, 30(1), 165–200. https://doi.org/10.1111/0081-1750.00078
Cytowania BibTeX
@article{curran1996robustness, author={Curran, Patrick J. and West, Stephen G. and Finch, John F.}, title={{The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis}}, journal={Psychological Methods}, year={1996}, volume={1}, number={1}, pages={16--29}, doi={10.1037/1082-989x.1.1.16}}@article{rhemtulla2012when, author={Rhemtulla, Mijke and Brosseau-Liard, Patricia É. and Savalei, Victoria}, title={{When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={354--373}, doi={10.1037/a0029315}}@article{satorra2001scaled, author={Satorra, Albert and Bentler, Peter M.}, title={{A scaled difference chi-square test statistic for moment structure analysis}}, journal={Psychometrika}, year={2001}, volume={66}, number={4}, pages={507--514}, doi={10.1007/bf02296192}}@article{savalei2021computational, author={Savalei, Victoria and Rosseel, Yves}, title={{Computational options for standard errors and test statistics with incomplete normal and nonnormal data in SEM}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2021}, volume={29}, number={2}, pages={163--181}, doi={10.1080/10705511.2021.1877548}}@article{yuan2000three, author={Yuan, Ke-Hai and Bentler, Peter M.}, title={{Three likelihood-based methods for mean and covariance structure analysis with nonnormal missing data}}, journal={Sociological Methodology}, year={2000}, volume={30}, number={1}, pages={165--200}, doi={10.1111/0081-1750.00078}}