Co naprawdę ma mieć rozkład normalny
W regresji liniowej, teście t i ANOVA założenie dotyczy błędów modelu, które szacujesz resztami. Reszta to różnica między wynikiem osoby a wartością przewidzianą przez model. W ANOVA jest to więc wynik minus średnia grupy. Williams i in. (2013) przypominają, że regresja metodą najmniejszych kwadratów wymaga normalności błędów, a nie zmiennej zależnej ani predyktorów. Mimo to w przeglądzie artykułów z psychologii klinicznej część autorów nadal uznawała za założenie normalność samych zmiennych (Ernst i Albers, 2017).
Różnica nie jest formalnością. Jeśli grupy albo predyktory silnie różnicują wyniki, rozkład całej zmiennej zależnej musi odbiegać od normalnego, bo jest mieszaniną kilku rozkładów. Test normalności na surowej zmiennej wykrywa wtedy efekt, który chcesz badać, a nie problem z założeniami. Pełną procedurę sprawdzania rozkładu, z tabelą „co ma być normalne” dla różnych analiz, opisuje poradnik jak sprawdzić normalność rozkładu. Tu pokazujemy tę różnicę na jednym przykładzie.
Przykład: dwa garby w zmiennej, normalne reszty
Studentka pielęgniarstwa porównuje wynik testu wiedzy z farmakologii (0–40 pkt) u 60 osób z 1. roku i 60 osób z 3. roku (dane symulowane). Rozkład całej zmiennej ma dwa garby (rysunek 1A): M = 22.02, SD = 7.32, skośność −0.01, kurtoza −1.20. Skośność bliska zeru niczego tu nie mówi, bo rozkład jest symetryczny, tylko dwugarbny. Test Shapiro-Wilka na całej zmiennej odrzuca normalność: W = 0.958, p < .001.
Dopasowujemy model z rokiem studiów jako predyktorem. To jednoczynnikowa ANOVA, a zarazem regresja liniowa z jednym predyktorem jakościowym. Osoby z 3. roku miały wynik wyższy o 12.67 punktu (SE = 0.66), F(1, 118) = 364.87, p < .001, R² = .76. Reszty tego modelu mają rozkład zbliżony do normalnego: skośność −0.18, kurtoza −0.59, W = 0.986, p = .258. Na wykresie Q-Q punkty leżą wzdłuż linii (rysunek 1B). W każdej grupie osobno test Shapiro-Wilka dał p = .507 i p = .228, bo reszty w ANOVA to właśnie odchylenia od średnich grup.
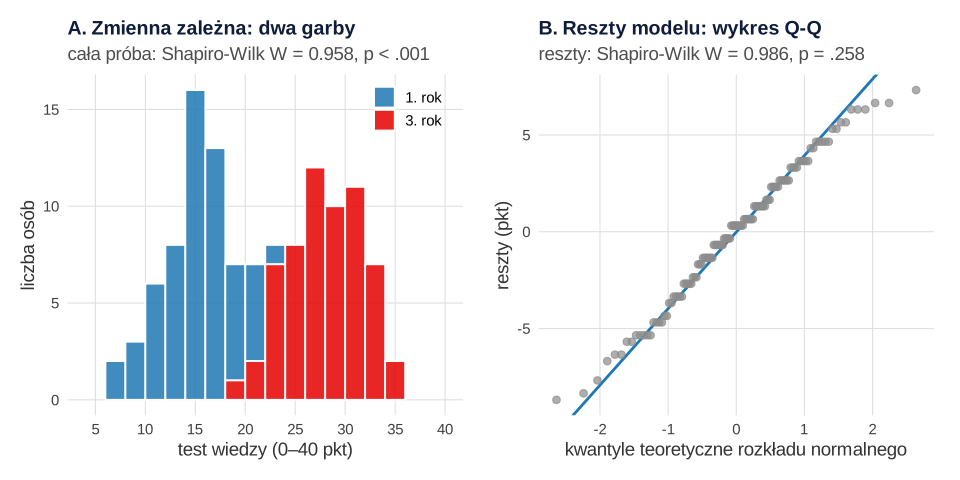
Gdyby studentka sprawdziła tylko surową zmienną, uznałaby, że „rozkład nie jest normalny”, i zrezygnowała z ANOVA na rzecz testu nieparametrycznego. Tymczasem założenie modelu jest spełnione, a nienormalność zmiennej jest skutkiem dużej różnicy między grupami.
Wykres Q-Q reszt zamiast testu na zmiennej
Sprawdzaj więc reszty z pełnego modelu, czyli ze wszystkimi predyktorami, kowariantami i interakcjami. Najwięcej powie wykres kwantylowy Q-Q reszt. W R daje go plot(model, which = 2). Czytaj go tak:
- Punkty wzdłuż linii, z niewielkimi odchyleniami na końcach, to obraz typowy dla rozkładu zbliżonego do normalnego.
- Łuk, w którym oba końce odginają się w tę samą stronę, oznacza skośność reszt.
- Litera S, z końcami odginającymi się w przeciwne strony, oznacza grubsze albo cieńsze ogony niż w rozkładzie normalnym.
- Pojedyncze punkty daleko od linii to kandydaci na obserwacje odstające. Sprawdź, skąd się wzięły, zanim zrobisz cokolwiek innego.
Test Shapiro-Wilka na resztach traktuj jako uzupełnienie wykresu, a nie decyzję. W dużych próbach wykrywa odchylenia bez praktycznego znaczenia, a w małych przeocza poważne. Wykres Q-Q to tylko jeden z kilku wykresów diagnostycznych. Pozostałe, czyli reszty względem wartości przewidywanych, dźwignię i odległość Cooka, omawia wpis diagnostyka regresji w R.
Kiedy normalność reszt ma małe znaczenie
Nawet normalność reszt nie jest najważniejszym założeniem. Schmidt i Finan (2018) pokazują w symulacjach, że jej naruszenie nie obciąża oszacowań współczynników. Wpływa tylko na błędy standardowe, a więc na przedziały ufności i wartości p. W dużych próbach (np. powyżej 10 obserwacji na zmienną) zwykle nie zmienia to zauważalnie wyników. Ważniejsze pozostają poprawna postać modelu, brak skrajnych obserwacji, homoskedastyczność i niezależność błędów. Lumley i in. (2002) dochodzą do podobnego wniosku dla dużych zbiorów danych. Mechanizm wyjaśnia centralne twierdzenie graniczne.
Sprawdziliśmy to w R. Błędy pochodziły z silnie prawoskośnego rozkładu log-normalnego, a każdy warunek powtórzono 5000 razy. 95% przedział ufności dla nachylenia obejmował prawdziwą wartość w 94.9% powtórzeń przy n = 10, w 94.5% przy n = 30 i w 95.0% przy n = 100. Knief i Forstmeier (2021) w obszernych symulacjach również stwierdzili, że modele zakładające normalne błędy są odporne w szerokim zakresie warunków. Wyjątkiem były wpływowe obserwacje odstające.
Są jednak sytuacje, w których kształt reszt ma znaczenie także w dużej próbie:
- Przewidywanie wyniku pojedynczej osoby. Przedział predykcji opiera się wprost na rozkładzie błędów. W symulacji z n = 300 nowa obserwacja nigdy nie wypadła poniżej 95% przedziału predykcji, a powyżej – w 4.4% przypadków, zamiast po około 2.5% z każdej strony.
- Mała próba z kilkoma skrajnymi wynikami. Tu problemem są obserwacje wpływowe, a nie sama krzywizna wykresu Q-Q.
- Zmienna, której model liniowy nie opisuje dobrze, np. zliczenia z wieloma zerami albo wynik z silnym efektem sufitu. Wtedy zmień model, a nie tylko test.
Jeśli porównujesz dwie grupy przy skośnych danych, szczegóły opisuje wpis test t przy rozkładzie innym niż normalny. Wybór analizy w innych układach ułatwia przewodnik po testach statystycznych.
Jak to opisać w pracy
Napisz, co sprawdzono (reszty modelu), jak (wykres Q-Q i ewentualnie test) i z jakim wynikiem. Wzór dla przykładu:
Normalność zmiennej i reszt w R
Kod odtwarza wszystkie liczby z tekstu: statystyki opisowe i test Shapiro-Wilka dla całej zmiennej, model lm() z rokiem studiów, te same miary dla reszt i dla każdej grupy oraz dwie symulacje z prawoskośnymi błędami. Skośność i kurtozę liczy funkcja describe() z pakietu psych.
Zmienna dwugarbna, reszty normalne i symulacje
R
# B167 – Normalność reszt czy zmiennej? Zmienna zależna dwugarbna przez różnicę grup, reszty normalne
# Dane symulowane: test wiedzy z farmakologii (0–40 pkt) u 60 osób z 1. roku i 60 osób z 3. roku pielęgniarstwa.
library(psych)
set.seed(1671)
wynik <- function(n, m) pmin(40, pmax(0, round(rnorm(n, m, 3.5))))
dane <- data.frame(rok = factor(rep(c("1. rok", "3. rok"), each = 60)),
                   wiedza = c(wynik(60, 15), wynik(60, 28)))

# 1. Rozkład całej zmiennej zależnej: dwa garby, test Shapiro-Wilka odrzuca normalność
round(describe(dane$wiedza)[, c("n", "mean", "sd", "median", "skew", "kurtosis")], 2)
shapiro.test(dane$wiedza)

# 2. Model: ANOVA jednoczynnikowa = regresja z jednym predyktorem jakościowym
m <- lm(wiedza ~ rok, data = dane)
summary(m)$coefficients
anova(m)
round(c(R2 = summary(m)$r.squared), 3)

# 3. Reszty modelu (wynik minus średnia grupy): rozkład zbliżony do normalnego
r <- residuals(m)
round(describe(r)[, c("n", "mean", "sd", "skew", "kurtosis")], 2)
shapiro.test(r)
# to samo w każdej grupie osobno
aggregate(wiedza ~ rok, dane, function(x) round(c(M = mean(x), SD = sd(x), SW_p = shapiro.test(x)$p.value), 3))

# 4. Kiedy normalność reszt ma znaczenie? Symulacja z silnie prawoskośnymi błędami (log-normalne,
#    przeskalowane do średniej 0 i SD 1); prawdziwe nachylenie 0.3
bledy <- function(n) { e <- rlnorm(n, 0, 1); (e - exp(0.5)) / sqrt((exp(1) - 1) * exp(1)) }
# 4a. Pokrycie 95% CI dla nachylenia (5000 powtórzeń na warunek)
set.seed(1672)
pokrycie <- function(n, R = 5000) mean(replicate(R, {
  x <- rnorm(n); y <- 0.3 * x + bledy(n)
  ci <- confint(lm(y ~ x))[2, ]
  ci[1] <= 0.3 & 0.3 <= ci[2]
}))
round(sapply(c(n10 = 10, n30 = 30, n100 = 100), pokrycie), 3)
# 4b. 95% przedział predykcji dla nowej osoby przy n = 300: jak często nowa obserwacja wypada poniżej i powyżej
set.seed(1673)
pi_sim <- function(n, R = 4000) rowMeans(replicate(R, {
  x <- rnorm(n); y <- 0.3 * x + bledy(n); m4 <- lm(y ~ x)
  x0 <- rnorm(1); y0 <- 0.3 * x0 + bledy(1)
  p <- predict(m4, data.frame(x = x0), interval = "prediction")
  c(ponizej = y0 < p[2], powyzej = y0 > p[3])
}))
round(pi_sim(300), 3)
Wynik w R
     n  mean   sd median  skew kurtosis
X1 120 22.02 7.32     22 -0.01     -1.2

	Shapiro-Wilk normality test

data:  dane$wiedza
W = 0.95764, p-value = 0.0008209

            Estimate Std. Error  t value     Pr(>|t|)
(Intercept) 15.68333  0.4688960 33.44736 4.823677e-62
rok3. rok   12.66667  0.6631191 19.10165 6.601803e-38
Analysis of Variance Table

Response: wiedza
           Df Sum Sq Mean Sq F value    Pr(>F)
rok         1 4813.3  4813.3  364.87 < 2.2e-16 ***
Residuals 118 1556.6    13.2
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   R2
0.756
     n mean   sd  skew kurtosis
X1 120    0 3.62 -0.18    -0.59

	Shapiro-Wilk normality test

data:  r
W = 0.98611, p-value = 0.2578

     rok wiedza.M wiedza.SD wiedza.SW_p
1 1. rok   15.683     3.587       0.507
2 3. rok   28.350     3.677       0.228
  n10   n30  n100
0.949 0.945 0.950
ponizej powyzej
  0.000   0.044
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), shapiro.test() i predict() z pakietu stats); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy zmienna zależna w regresji musi mieć rozkład normalny?
Nie. Założenie dotyczy błędów modelu, które szacujesz resztami, a nie zmiennej zależnej ani predyktorów (Williams i in., 2013). Jeśli predyktory silnie różnicują wyniki, rozkład zmiennej zależnej może być dwugarbny lub skośny, a reszty i tak mogą być normalne.
Czy w ANOVA sprawdzać normalność w każdej grupie, czy na resztach?
To prawie to samo, bo reszty w ANOVA to odchylenia wyników od średnich grup. Wygodniej obejrzeć jeden wykres Q-Q wszystkich reszt modelu, zwłaszcza gdy grup jest dużo, a każda jest mała. Nie sprawdzaj rozkładu całej zmiennej zależnej bez podziału na grupy.
Co zrobić, gdy reszty regresji nie mają rozkładu normalnego?
Najpierw sprawdź, czy przyczyną nie są obserwacje odstające, źle dobrana postać modelu albo heteroskedastyczność. W większej próbie umiarkowana nienormalność reszt zwykle nie zmienia wniosków (Schmidt i Finan, 2018). Gdy próba jest mała albo zależy Ci na przedziałach predykcji, rozważ bootstrap, transformację albo inny model.
Powiązane hasła
Przeczytaj też
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikTest t przy rozkładzie nienormalnym
Kiedy skośność naprawdę szkodzi testowi t: symulacja w R, test Welcha, bootstrap, test Yuena i Mann–Whitney na jednym przykładzie oraz opis APA.
Czytaj →Promotor pyta o normalność rozkładu, a nie wiesz, co sprawdzić?
Sprawdzimy założenia Twojego modelu na resztach, ocenimy, czy wymagają zmiany analizy, i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ernst, A. F., & Albers, C. J. (2017). Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions. PeerJ, 5, Article e3323. https://doi.org/10.7717/peerj.3323 ● Otwarty dostęp
- Knief, U., & Forstmeier, W. (2021). Violating the normality assumption may be the lesser of two evils. Behavior Research Methods, 53(6), 2576–2590. https://doi.org/10.3758/s13428-021-01587-5 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Schmidt, A. F., & Finan, C. (2018). Linear regression and the normality assumption. Journal of Clinical Epidemiology, 98, 146–151. https://doi.org/10.1016/j.jclinepi.2017.12.006 ● Otwarty dostęp: pełny tekst
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{ernst2017regression, author={Ernst, Anja F. and Albers, Casper J.}, title={{Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions}}, journal={PeerJ}, year={2017}, volume={5}, eid={e3323}, doi={10.7717/peerj.3323}}@article{knief2021violating, author={Knief, Ulrich and Forstmeier, Wolfgang}, title={{Violating the normality assumption may be the lesser of two evils}}, journal={Behavior Research Methods}, year={2021}, volume={53}, number={6}, pages={2576--2590}, doi={10.3758/s13428-021-01587-5}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{schmidt2018linear, author={Schmidt, Amand F. and Finan, Chris}, title={{Linear regression and the normality assumption}}, journal={Journal of Clinical Epidemiology}, year={2018}, volume={98}, pages={146--151}, doi={10.1016/j.jclinepi.2017.12.006}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}