Co to jest rozkład normalny?
Rozkład normalny (rozkład Gaussa, ang. normal distribution) to symetryczny, dzwonowaty rozkład zmiennej ciągłej, w którym większość wyników skupia się wokół średniej, a im dalej od niej, tym wyniki są rzadsze. Zapisuje się go jako X ~ N(μ, σ²): pełny kształt wyznaczają tylko dwa parametry – średnia μ i odchylenie standardowe σ (σ² to wariancja).
W psychologii rozkład normalny pełni trzy role. Jest modelem dla wielu wyników testów (na nim opiera się np. skala IQ o średniej 100 i odchyleniu 15), przybliżeniem rozkładu średnich z prób (dzięki centralnemu twierdzeniu granicznemu) i założeniem o resztach w teście t, ANOVA i regresji liniowej.
Wzór i parametry μ oraz σ
Gęstość rozkładu normalnego opisuje wzór:
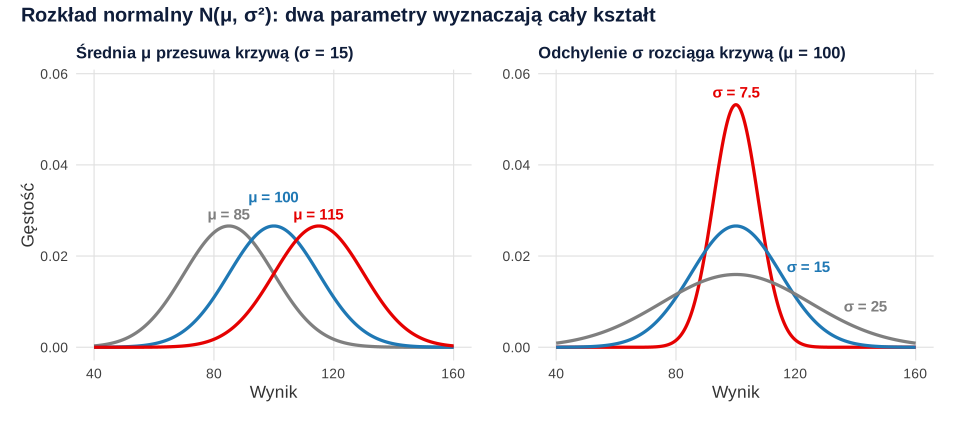
Wysokość krzywej nie jest prawdopodobieństwem pojedynczego wyniku. Prawdopodobieństwo to pole pod krzywą w danym przedziale, a całe pole wynosi 1. Rysunek 1 pokazuje, co robią parametry: μ przesuwa krzywą wzdłuż osi, a σ ją rozciąga lub zwęża – im większe σ, tym niższy i szerszy „dzwon”.
Najważniejsze własności rozkładu normalnego:
- jest symetryczny, więc średnia, mediana i dominanta są równe;
- jego skośność wynosi 0, a kurtoza nadmiarowa – 0;
- ogony ciągną się w nieskończoność, ale szybko cienieją: wyniki odległe od średniej o ponad 3σ to tylko 0.27%.
Reguła 68–95–99.7
W każdym rozkładzie normalnym – niezależnie od μ i σ – w przedziale ±1σ wokół średniej leży 68.27% wyników, w przedziale ±2σ – 95.45%, a w przedziale ±3σ – 99.73%. To tzw. reguła trzech sigm. Na skali IQ oznacza to, że dwie trzecie osób ma wynik między 85 a 115, a poniżej 55 lub powyżej 145 – tylko około trzy osoby na tysiąc.
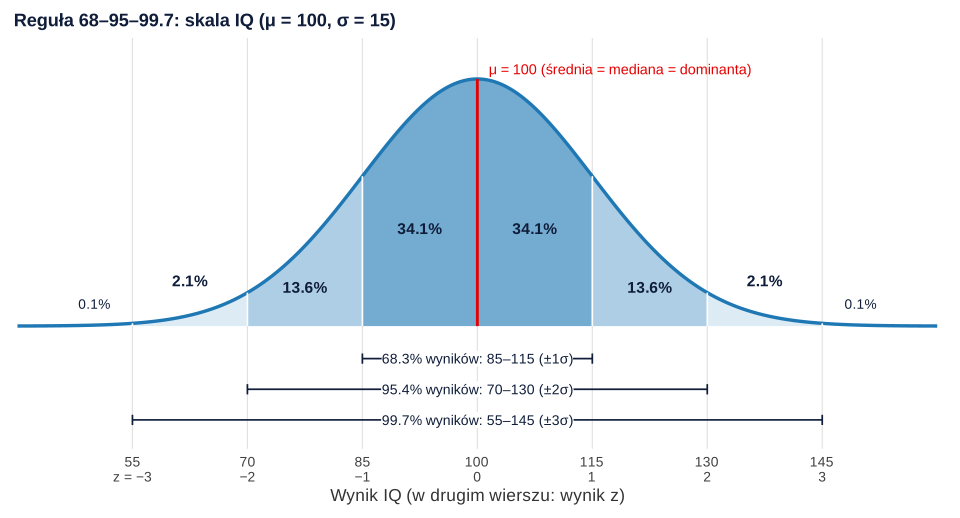
Reguła dotyczy tylko rozkładu normalnego. W rozkładach skośnych i o ciężkich ogonach udział wyników skrajnych bywa wielokrotnie większy, dlatego nie używaj jej do oceny prawdziwych danych bez sprawdzenia ich kształtu.
Standardowy rozkład normalny i wyniki z: przykład
Rozkład normalny o średniej 0 i odchyleniu standardowym 1, N(0, 1), nazywa się standardowym rozkładem normalnym. Każdy rozkład normalny można do niego sprowadzić przez standaryzację: z = (x − μ) / σ. Dzięki temu z jednej tablicy (albo jednej funkcji w R) odczytasz odsetki dla dowolnej skali.
Przykład: osoba uzyskała w teście inteligencji 118 punktów (μ = 100, σ = 15).
- Wynik z = (118 − 100) / 15 = 1.20.
- Pole pod krzywą na lewo od z = 1.20 wynosi 0.885, więc wynik jest wyższy niż u 88.5% populacji (percentyl 88.5).
- Wynik powyżej 130 (z > 2) ma 2.28% osób, a wynik od 85 do 115 – 68.27%.
- Do 10% najwyższych wyników należy każdy wynik od 119.22 punktów wzwyż.
Z tego samego rozkładu pochodzi liczba 1.96 – wartość krytyczna odcinająca po 2.5% w każdym ogonie, której używa się przy 95% przedziale ufności dla dużych prób. Pole pod krzywą standardowego rozkładu normalnego jest też podstawą wartości p – zob. wpis P value krok po kroku.
Czy dane muszą mieć rozkład normalny?
Idealnie normalne dane prawie się nie zdarzają. Micceri (1989) przeanalizował 440 dużych rozkładów wyników testów osiągnięć i miar psychometrycznych: wszystkie istotnie odbiegały od normalności, m.in. pod względem ciężkości ogonów, asymetrii i wielomodalności. Na szczęście większość metod tego nie wymaga. Założenie normalności w teście t, ANOVA i regresji dotyczy reszt modelu (czyli rozkładu wyników wokół średnich grup lub linii regresji), a nie surowej zmiennej (zob. regresja liniowa i ANOVA krok po kroku).
Co więcej, przy większych próbach i to założenie traci na znaczeniu. Ghasemi i Zahediasl (2012) piszą, że przy liczebności powyżej 30–40 osób naruszenie normalności nie powinno powodować poważnych problemów, a Lumley i in. (2002) pokazują, że test t i regresja liniowa w dużych próbach są trafne przy dowolnym rozkładzie zmiennej wynikowej. Sprawdziliśmy to symulacyjnie: 10 000 razy losowaliśmy próby z populacji czasów reakcji o silnej skośności (1.75) i liczyliśmy 95% przedział ufności dla średniej z rozkładu t.
| Liczebność próby | Populacja normalna | Populacja skośna (czas reakcji) |
|---|---|---|
| n = 10 | 94.7% | 92.1% |
| n = 30 | 94.8% | 93.7% |
| n = 100 | 94.8% | 94.2% |
| n = 300 | 94.8% | 94.9% |
Przy dziesięciu osobach przedział obejmował prawdziwą średnią w 92.1% prób zamiast w 95%, ale przy 300 osobach – w 94.9%, czyli tak samo jak przy danych normalnych. Mechanizm wyjaśnia centralne twierdzenie graniczne: rozkład średnich z prób zbliża się do normalnego, nawet gdy same wyniki są skośne. Przy silnej skośności i bardzo małej próbie przedział bywa jednak zbyt wąski – opisz to w pracy albo rozważ metody omówione w haśle skośność.
Jak sprawdzić normalność?
Mishra i in. (2019) dzielą metody oceny normalności na liczbowe (testy Shapiro-Wilka i Kołmogorowa-Smirnowa, wartości z skośności i kurtozy) i graficzne (histogram, wykres pudełkowy, wykresy P-P i Q-Q). W praktyce łącz obie grupy:
- wykres – histogram pokazuje kształt, a wykres kwantylowy Q-Q – odstępstwa w ogonach; Q-Q jest łatwiejszy w interpretacji przy dużych próbach (Ghasemi i Zahediasl, 2012);
- skośność i kurtoza z ich błędami standardowymi – Kim (2013) uzależnia kryterium od liczebności (dla n > 300 liczą się same wartości, np. |skośność| > 2);
- test formalny – Ghasemi i Zahediasl (2012) zalecają test Shapiro-Wilka, bo test Kołmogorowa-Smirnowa ma małą moc i nie jest zalecany, gdy parametry szacuje się z danych.
Wynik testu interpretuj ostrożnie. W małych próbach testy normalności mają małą moc, więc dane zwykle je „przechodzą”; w dużych wykrywają nawet drobne odchylenia, które nie wpływają na wyniki testów parametrycznych (Ghasemi i Zahediasl, 2012). Decyzję opieraj na wykresie reszt i liczebności próby, a nie na samym p.
Jak opisać ocenę normalności w pracy (APA)
W rozdziale z wynikami opisz, czego dotyczyła ocena (zmiennej czy reszt), jakich metod użyto i co z niej wynika dla wyboru analizy. Przykład dla wyników testu inteligencji z sekcji z kodem:
Przykład w R
Funkcje pnorm() (pole pod krzywą) i qnorm() (kwantyl) zastępują tablice rozkładu normalnego. Druga część kodu losuje 200 wyników IQ i sprawdza regułę 68–95–99.7 w próbie. W SPSS normalność sprawdzisz w menu Analiza → Opis statystyczny → Eksploracja → Wykresy → Wykresy normalności z testami.
Odsetki i kwantyle rozkładu normalnego
R
# prawdopodobieństwa i kwantyle rozkładu normalnego na skali IQ (M = 100, SD = 15)
pnorm(118, mean = 100, sd = 15)            # odsetek osób z wynikiem niższym niż 118
1 - pnorm(130, mean = 100, sd = 15)        # odsetek wyników powyżej 130
pnorm(115, 100, 15) - pnorm(85, 100, 15)   # odsetek wyników od 85 do 115
qnorm(0.90, mean = 100, sd = 15)           # próg 10% najwyższych wyników
qnorm(0.975)                               # wartość krytyczna z dla 95% CI

# próba 200 osób: ile wyników mieści się w ±1, ±2 i ±3 SD?
set.seed(8)
iq <- round(rnorm(200, mean = 100, sd = 15))
z  <- (iq - mean(iq)) / sd(iq)             # standaryzacja: wyniki z
round(100 * sapply(1:3, function(k) mean(abs(z) <= k)), 1)
round(c(skosnosc = psych::skew(iq, type = 2), kurtoza = psych::kurtosi(iq, type = 2)), 2)
shapiro.test(iq)
Wynik w R
[1] 0.8849303
[1] 0.02275013
[1] 0.6826895
[1] 119.2233
[1] 1.959964
[1]  69.0  95.5 100.0
skosnosc  kurtoza
   -0.15    -0.11

	Shapiro-Wilk normality test

data:  iq
W = 0.99415, p-value = 0.6234
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Sprawdzanie normalności surowej zmiennej zależnej zamiast reszt – w ANOVA różnice między grupami mogą dać rozkład dwu- lub trójmodalny, choć reszty są normalne.
- Decyzja tylko na podstawie testu normalności – w małych próbach test prawie zawsze „przepuści” dane, w dużych prawie zawsze je „odrzuci”.
- Stosowanie reguły 68–95–99.7 do danych skośnych, np. do czasów reakcji – odsetki wyników skrajnych są wtedy inne.
- Test Kołmogorowa-Smirnowa bez poprawki Lillieforsa, gdy średnią i odchylenie standardowe oszacowano z tych samych danych.
- Traktowanie wysokości krzywej jako prawdopodobieństwa – prawdopodobieństwo to pole pod krzywą w przedziale, a nie wartość gęstości w punkcie.
Najczęstsze pytania
Co to jest rozkład normalny?
To symetryczny rozkład zmiennej ciągłej w kształcie dzwonu: najwięcej wyników leży blisko średniej, a im dalej od niej, tym jest ich mniej. Jest w pełni opisany przez średnią μ i odchylenie standardowe σ; średnia, mediana i dominanta są w nim równe.
Ile wyników mieści się w jednym odchyleniu standardowym od średniej?
W rozkładzie normalnym w przedziale ±1 odchylenie standardowe leży 68.27% wyników, w przedziale ±2 – 95.45%, a w przedziale ±3 – 99.73%. Na skali IQ (średnia 100, odchylenie 15) oznacza to, że dwie trzecie osób ma wynik od 85 do 115.
Jak sprawdzić, czy rozkład jest normalny?
Połącz wykres z liczbami: obejrzyj histogram i wykres kwantylowy Q-Q, policz skośność i kurtozę, a jako uzupełnienie wykonaj test Shapiro-Wilka. W dużych próbach test wykrywa nawet nieważne odchylenia, a w małych ma małą moc, więc nie opieraj decyzji na samym p.
Co zrobić, gdy rozkład nie jest normalny?
Najpierw sprawdź, czy założenie w ogóle dotyczy surowej zmiennej – w teście t, ANOVA i regresji dotyczy reszt. Przy większych próbach te metody są odporne na odstępstwa od normalności. Przy małej próbie i silnej skośności rozważ transformację, metody odporne albo test nieparametryczny.
Czym różni się rozkład normalny od standardowego rozkładu normalnego?
Standardowy rozkład normalny to szczególny przypadek o średniej 0 i odchyleniu standardowym 1, N(0, 1). Każdy rozkład normalny można do niego sprowadzić, zamieniając wyniki na wyniki z = (x − μ) / σ.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Centralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →PoradnikPrawdopodobieństwo i rozkłady – zadania
Dziesięć zadań jak na kolokwium: prawdopodobieństwo warunkowe, wartość oczekiwana, rozkład dwumianowy, Poissona i normalny, CTG – z rozwiązaniami krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505 ● Otwarty dostęp
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Mishra, P., Pandey, C. M., Singh, U., Gupta, A., Sahu, C., & Keshri, A. (2019). Descriptive statistics and normality tests for statistical data. Annals of Cardiac Anaesthesia, 22(1), 67–72. https://doi.org/10.4103/aca.ACA_157_18 ● Otwarty dostęp
Cytowania BibTeX
@article{ghasemi2012normality, author={Ghasemi, Asghar and Zahediasl, Saleh}, title={{Normality tests for statistical analysis: A guide for non-statisticians}}, journal={International Journal of Endocrinology and Metabolism}, year={2012}, volume={10}, number={2}, pages={486--489}, doi={10.5812/ijem.3505}}@article{kim2013assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis}}, journal={Restorative Dentistry \& Endodontics}, year={2013}, volume={38}, number={1}, pages={52--54}, doi={10.5395/rde.2013.38.1.52}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}@article{mishra2019descriptive, author={Mishra, Prabhaker and Pandey, Chandra M. and Singh, Uttam and Gupta, Anshul and Sahu, Chinmoy and Keshri, Amit}, title={{Descriptive statistics and normality tests for statistical data}}, journal={Annals of Cardiac Anaesthesia}, year={2019}, volume={22}, number={1}, pages={67--72}, doi={10.4103/aca.aca_157_18}}