Po co rysować wynik regresji
Tabela regresji liniowej mówi, które współczynniki różnią się od zera. Promotor pyta jednak o coś innego: jak duży jest efekt w jednostkach wyniku, dla kogo i w jakim zakresie danych. Na te pytania lepiej odpowiada rysunek. Gelman i in. (2002) pokazali, że tabele wyników da się zastąpić wykresami zajmującymi mniej miejsca.
Ten wpis prowadzi przez pięć rysunków z jednego badania: współczynniki, przewidywane wartości, interakcję, efekty brzegowe i regresję logistyczną. Przy każdym: co widać, czego wykres nie pokazuje, podpis i zdanie do Wyników. Ogólne zasady (numer, tytuł, czcionka, eksport) opisują wpisy wykresy w pracy dyplomowej i tabele i rysunki do artykułu. Sam model krok po kroku omawia regresja wieloraka krok po kroku. Rysunek nie zastępuje tabeli regresji w APA – w pracy zwykle są oba. A zanim cokolwiek policzysz, narysuj surowe dane.
Przykład: egzamin, godziny nauki i tryb zajęć
Przykład jest fikcyjny (dane symulowane). 240 osób studiujących zdawało egzamin ze statystyki (0–100 punktów; M = 51.49, SD = 13.18). Predyktory to godziny nauki tygodniowo (M = 9.03, SD = 4.27), lęk przed statystyką (1–5; M = 2.95, SD = 0.71), frekwencja na ćwiczeniach w procentach (M = 77.07, SD = 12.02) i tryb zajęć: stacjonarnie (n = 100, kategoria odniesienia), hybrydowo (n = 80) albo zdalnie (n = 60). Tryb wchodzi do modelu jako dwie zmienne zero-jedynkowe. Osoby uczące się zdalnie deklarowały od 1.2 do 13 godzin nauki, a stacjonarnie – od 2 do 20. Ta różnica wróci przy rysunkach 3 i 4.
Model 1 zawiera efekty główne, model 2 dodaje interakcję godzin nauki z trybem. Iloczyny poprawiły dopasowanie, F(2, 232) = 9.12, p < .001; R² wzrósł z .409 do .452. Plik z danymi: wynik-regresji-dane.csv. Ziarno symulacji (562) ustalono raz, bez dobierania pod wynik. Pełny kod wszystkich liczb i rysunków jest w sekcji Kod R.
Rysunek 1. Wykres współczynników
Wykres współczynników (ang. coefficient plot) to tabela regresji jako punkty z 95% przedziałami ufności i linią w zerze. Rysujemy go dla modelu 1, bo w modelu z interakcją współczynniki efektów głównych są warunkowe (wrócimy do tego przy rysunku 3).
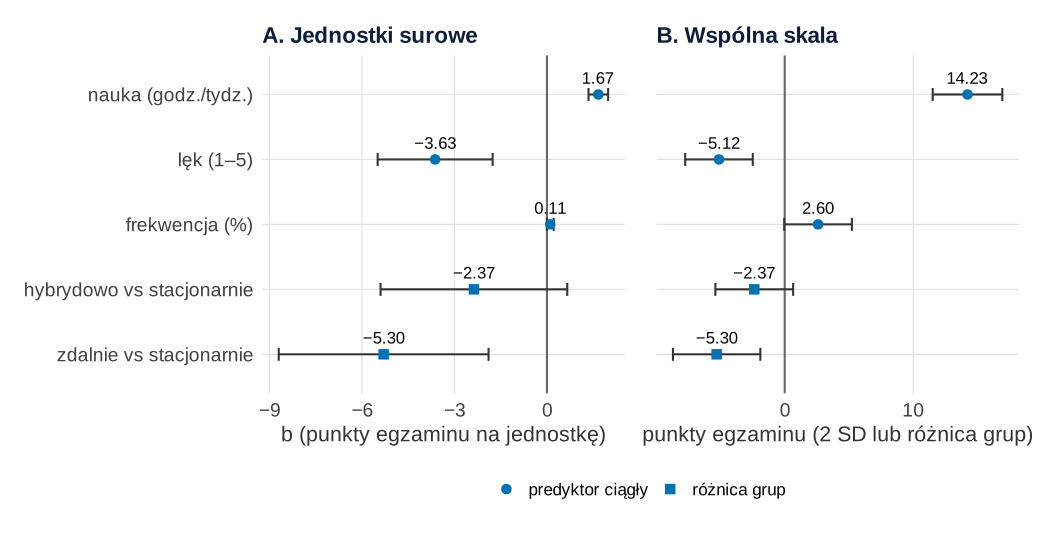
Co widać. Panel A: punkty egzaminu na godzinę nauki (b = 1.67, 95% CI [1.35, 1.98]), na punkt lęku (b = −3.63, 95% CI [−5.49, −1.76]), na punkt procentowy frekwencji (b = 0.11, 95% CI [0.00, 0.22], z dolną granicą tuż poniżej zera) oraz różnice trybów względem zajęć stacjonarnych. Frekwencja „przykleja się” do zera, bo jeden punkt procentowy to bardzo mała zmiana. W panelu B predyktory ciągłe podzielono przez dwa odchylenia standardowe, by dało się je porównać ze zmiennymi 0/1 (Gelman, 2008). Każdy punkt to różnica w punktach egzaminu: między osobą o 1 SD poniżej i 1 SD powyżej średniej (14.23 dla nauki, −5.12 dla lęku, 2.60 dla frekwencji) albo między grupami (−2.37 i −5.30).
Czego wykres nie pokazuje. Na jednym wykresie zestawiaj tylko współczynniki na porównywalnej skali. Panel A łączy godziny z procentami, więc długość odcinków nic nie mówi o „sile” predyktorów. Pułapka: β dla zmiennej 0/1 zależy od proporcji grup, a „jedno SD trybu zajęć” nie ma sensu. Trzy pułapki β opisuje wpis współczynniki standaryzowane czy niestandaryzowane.
Podpis do pracy.
Zdanie do Wyników.
Rysunek 2. Przewidywane wartości i dwa rodzaje pasm
Wykres przewidywań pokazuje wynik modelu przy kolejnych wartościach jednego predyktora, gdy pozostałe ustawisz na wybranym poziomie (tu: średnie i tryb stacjonarny). W pakiecie marginaleffects służy do tego siatka danych; Arel-Bundock i in. (2024) porządkują nazwy takich wielkości (predykcje, efekty krańcowe, kontrasty). Funkcja datagrid() ustawia niewymienione predyktory liczbowe na średniej, a czynniki – na najczęstszej kategorii.
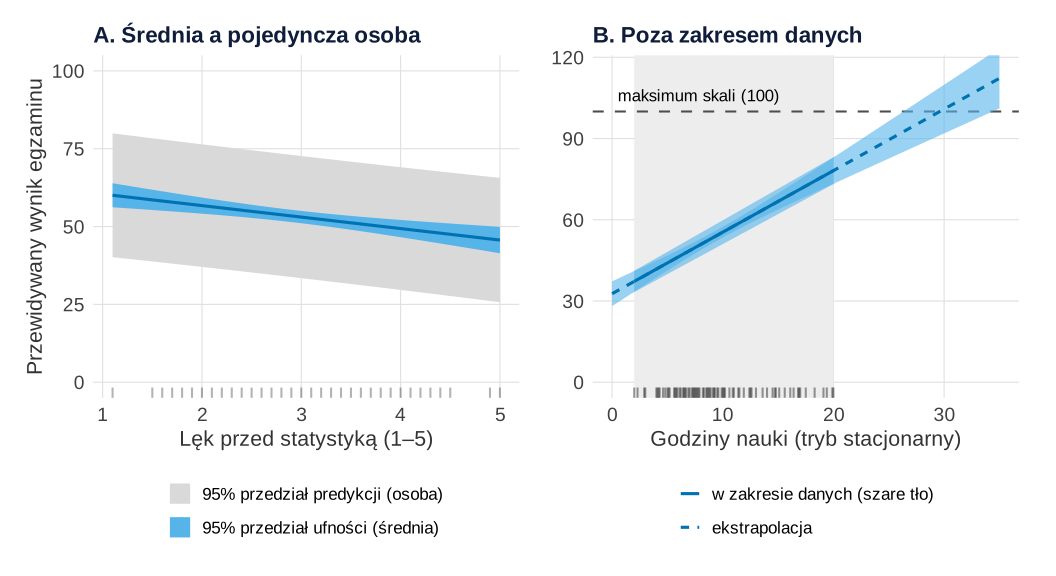
Co widać. Panel A: przy lęku równym 3 model przewiduje 53.04 punktu. 95% przedział ufności dla tej średniej to [51.06, 55.01], ale 95% przedział predykcji dla pojedynczej osoby o tym profilu sięga od 33.43 do 72.65 punktu. Kreski przy osi (ang. rug) pokazują, gdzie leżą obserwowane wartości lęku. Panel B: w trybie stacjonarnym godziny nauki obserwowano od 2 do 20 (szare tło). Prosta przedłużona do 30 godzin daje 100.89 punktu, a do 35 godzin – 112.25, czyli więcej, niż pozwala skala.
Czego wykres nie pokazuje. Wąskie pasmo ufności opisuje średnią, nie osoby – pasmo predykcji jest tu prawie dziesięć razy szersze. Zawsze napisz w podpisie, które pasmo rysujesz. Wykres nie sprawdza liniowości – model narysuje prostą nawet przez dane zakrzywione. Rysuj linię tylko w zakresie danych, a przedłużenie zaznacz linią przerywaną. Wartość przy zerze godzin (32.69 punktu) też jest ekstrapolacją – nikt w trybie stacjonarnym nie uczył się mniej niż 2 godziny.
Podpis do pracy.
Zdanie do Wyników.
Rysunek 3. Interakcja zmiennej ciągłej i kategorialnej
Wykres interakcji dla predyktora ciągłego to kilka prostych regresji – po jednej dla każdej grupy. McCabe i in. (2018) zwracają uwagę, że typowe wykresy interakcji pomijają niepewność oszacowań i obserwowane dane, a to może prowadzić do błędnych wniosków. Dlatego rysunek 3 ma pasma 95% CI, punkty danych i proste tylko w zakresie danych każdej grupy. Grupy rozróżniają kolor (paleta Okabe–Ito, sprawdzona w symulacji deuteranopii funkcją colorspace::deutan()), rodzaj linii, kształt punktu i etykieta.
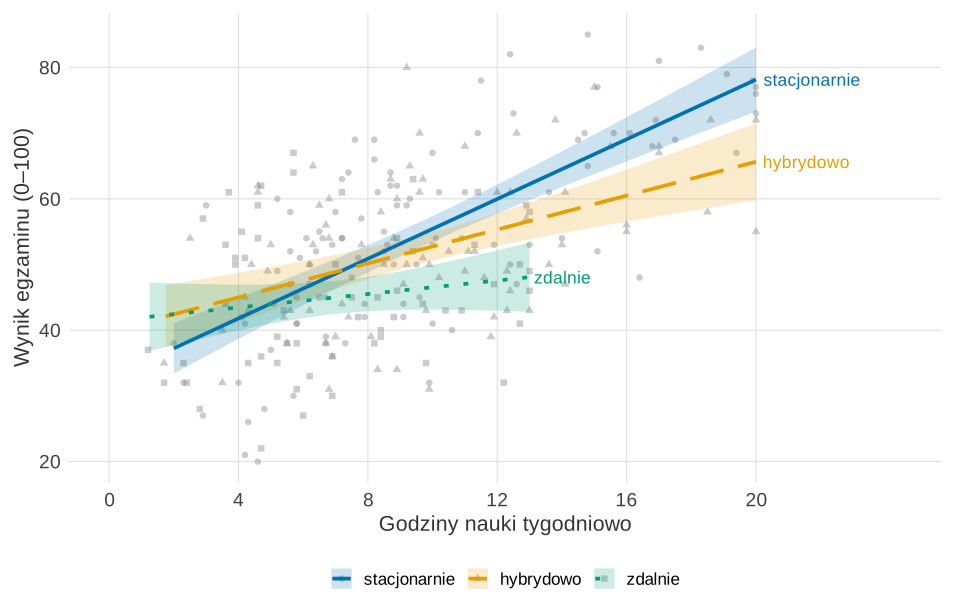
Co widać. Proste się przecinają. Przy 4 godzinach nauki przewidywane wyniki trzech grup są bliskie (41.78, 45.00 i 43.45 punktu), a ich przedziały ufności się nakładają. Przy 12 godzinach osoby uczące się stacjonarnie mają przewidywane 59.97 punktu, hybrydowo 55.32, a zdalnie 47.55. Linia trybu zdalnego kończy się na 13 godzinach – dalej nie ma danych.
Czego wykres nie pokazuje. Kształt linii nie jest testem interakcji – decyduje test iloczynów. Uważaj na współczynniki modelu 2: współczynnik trybu zdalnego (b = 8.71) to różnica grup przy zerze godzin nauki, czyli poza danymi. Jeśli chcesz, by opisywał osobę o przeciętnym czasie nauki, wycentruj predyktor przed dopasowaniem modelu. Dwa czynniki omawia wpis interakcja w ANOVA, dwie zmienne ciągłe – analiza moderacji krok po kroku.
Podpis do pracy.
Zdanie do Wyników.
Rysunek 4. Efekty brzegowe przy wartościach moderatora
Rysunek 4 pokazuje efekty, czyli o ile zmienia się wynik. Panel A to nachylenie godzin nauki w każdym trybie (proste nachylenia, funkcja slopes()). Panel B odwraca role: pokazuje różnicę między trybem zdalnym a stacjonarnym przy każdej wartości godzin nauki, z pasmem 95% CI. Punkty, w których pasmo przecina zero, wyznaczają granice przedziału Johnsona–Neymana. Spiller i in. (2013) nazywają to podejście „reflektorem” (ang. floodlight) i zalecają je, gdy moderator nie ma wyróżnionych wartości, zamiast rutynowego ±1 SD.
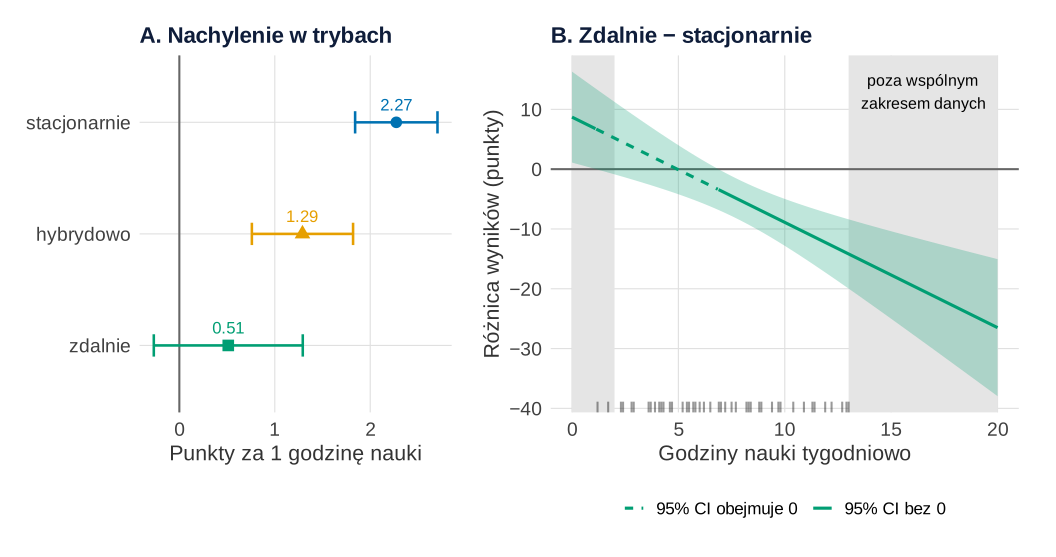
Co widać. Godzina nauki daje 2.27 punktu, 95% CI [1.84, 2.70], w trybie stacjonarnym, 1.29 punktu, 95% CI [0.76, 1.82], w hybrydowym i 0.51 punktu, 95% CI [−0.27, 1.29], p = .197, w zdalnym. W panelu B różnica zdalnie − stacjonarnie jest istotnie ujemna od około 6.9 godziny nauki: przy 8 godzinach wynosi −5.37 punktu, 95% CI [−8.72, −2.02], a przy 12 godzinach −12.41 punktu. Istotna dodatnia różnica poniżej około 1.1 godziny leży poza danymi trybu stacjonarnego.
Czego wykres nie pokazuje. Model zakłada, że różnica zmienia się liniowo. Hainmueller i in. (2019) pokazali, że to założenie często się nie sprawdza, a efekty warunkowe wprowadzają w błąd, gdy brakuje wspólnego zakresu danych moderatora. Dlatego szare tło oznacza wartości poza wspólnym zakresem obu grup (2–13 godzin), a kreski na osi – godziny nauki osób zdalnych. Granic Johnsona–Neymana nie raportuj poza tym zakresem. Brambor i in. (2006) pokazali, że modele z iloczynem często stosowano z błędami wnioskowania, i zaproponowali listę zasad ich użycia.
Te same granice policzysz bez R w kalkulatorze efektów prostych i Johnsona–Neymana. X to zmienna 0/1 „zdalnie”, W to godziny nauki: b1 = 8.712, b3 = −1.761, var(b1) = 14.9033, var(b3) = 0.204, cov(b1, b3) = −1.567, df = 232. Wersję w jamovi pokazuje wpis moderacja w jamovi.
Podpis do pracy.
Zdanie do Wyników.
Rysunek 5. Regresja logistyczna: prawdopodobieństwa zamiast OR
W tym samym badaniu sprawdzono, kto zaliczył ćwiczenia w pierwszym terminie (45% osób). Model logistyczny z godzinami nauki, lękiem i trybem daje ilorazy szans (OR). Panel A pokazuje je na osi logarytmicznej, na której OR = 0.5 i OR = 2 leżą równo daleko od 1. Panel B – to, co czytelnik rozumie od razu: prawdopodobieństwo.
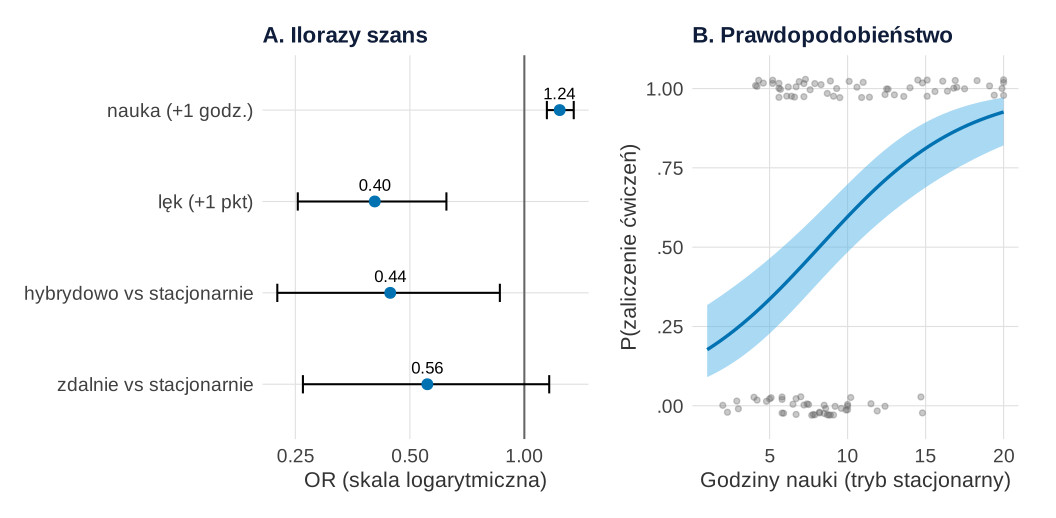
Co widać. Godzina nauki zwiększa szanse zaliczenia (OR = 1.24, 95% CI [1.15, 1.35]), wyższy lęk je zmniejsza (OR = 0.40, 95% CI [0.25, 0.62]). Panel B przekłada to na prawdopodobieństwa: przy 4 godzinach .290, 95% CI [.185, .424], przy 8 godzinach .490, a przy 12 godzinach .694, 95% CI [.576, .790]. Stały OR daje różne przyrosty prawdopodobieństwa. Jedną liczbę w punktach procentowych daje przeciętny efekt krańcowy (AME): godzina nauki to średnio +4.1 punktu procentowego, 95% CI [2.9, 5.4].
Czego wykres nie pokazuje. Panel B dotyczy jednego profilu (tryb stacjonarny, przeciętny lęk) – wpisz go w podpis. OR = 1.24 nie znaczy „o 24% większe prawdopodobieństwo” – to zmiana szans, nie prawdopodobieństwa. Resztę interpretacji i założenia opisuje regresja logistyczna krok po kroku.
Podpis do pracy.
Zdanie do Wyników.
Lista kontrolna przed wstawieniem rysunku
- Każde pasmo i każdy odcinek ma w podpisie nazwę: przedział ufności, przedział predykcji czy błąd standardowy.
- Linie przewidywań kończą się na granicach danych (osobno w każdej grupie), a dane widać na wykresie lub jako kreski przy osi.
- Na wykresie współczynników jest tylko jedna skala: surowa albo wspólna; bez β dla zmiennych 0/1.
- Podpis mówi, przy jakich wartościach są pozostałe predyktory.
- Kolor wspierają kształt, rodzaj linii albo etykieta.
Współczynniki z przedziałami ufności z SPSS wypiszesz według wpisu korelacja i regresja w SPSS. Przewidywane średnie grup przy wyrównanych kowariantach to średnie brzegowe (EMM).
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i wszystkie rysunki. Pobierz plik wynik-regresji-dane.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – kolejne przepisy korzystają z obiektów utworzonych wcześniej. Każdy przepis z rysunkiem tworzy obiekt (p1–p5): wpisz jego nazwę, żeby zobaczyć wykres, albo zapisz go funkcją ggsave() (przykład w komentarzu na końcu przepisu 1). Rysunki na stronie powstały z tego kodu; różnią się od wyniku pokazanego kodu tylko motywem serwisu (kolor tekstu i siatki) – dane, geometrie i skale są te same. Przedziały w funkcjach marginaleffects dla modelu liniowego liczymy z rozkładu t (argument df), tak jak predict() i summary(). Ziarno danych fikcyjnych (562) ustalono raz, bez dobierania pod wynik; ziarno 562 w position_jitter() służy tylko do rozsunięcia punktów.
1. Dane, modele, motyw i paleta
R
# Wynik egzaminu ze statystyki: 240 osób w trzech trybach zajęć (dane fikcyjne)
options(width = 100)
library(ggplot2)
library(patchwork)
library(marginaleffects)
dane <- read.csv("wynik-regresji-dane.csv", encoding = "UTF-8")
dane$tryb <- factor(dane$tryb, levels = c("stacjonarnie", "hybrydowo", "zdalnie"))
table(dane$tryb)
round(sapply(dane[, c("nauka", "lek", "frekwencja", "wynik")],
             function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2)
tapply(dane$nauka, dane$tryb, range)     # zakres godzin nauki w każdym trybie
m1 <- lm(wynik ~ nauka + lek + frekwencja + tryb, data = dane)   # model 1: efekty główne
m2 <- lm(wynik ~ nauka * tryb + lek + frekwencja, data = dane)   # model 2: + interakcja nauka × tryb
anova(m1, m2)                            # test łączny dwóch iloczynów
round(c(R2_m1 = summary(m1)$r.squared, R2_m2 = summary(m2)$r.squared), 3)
round(summary(m2)$coefficients, 3)

# Wspólny motyw i paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw)
motyw <- theme_minimal(base_size = 16) +
  theme(legend.position = "bottom", panel.grid.minor = element_blank(),
        axis.text = element_text(size = rel(0.9)), plot.title = element_text(face = "bold"))
kolory <- c(stacjonarnie = "#0072B2", hybrydowo = "#E69F00", zdalnie = "#009E73")
ksztalty <- c(stacjonarnie = 16, hybrydowo = 17, zdalnie = 15)
linie <- c(stacjonarnie = "solid", hybrydowo = "longdash", zdalnie = "dotted")
z_minusem <- function(x) gsub("-", "−", x)   # typograficzny minus na osiach i etykietach
colorspace::deutan(kolory)               # tak paletę widzi osoba z deuteranopią
# Zapis rysunku do pliku: ggsave("rysunek-1.svg", p1, width = 10, height = 5.6)
Wynik w R
stacjonarnie    hybrydowo      zdalnie
         100           80           60
    nauka  lek frekwencja wynik
M    9.03 2.95      77.07 51.49
SD   4.27 0.71      12.02 13.18
min  1.20 1.10      46.00 20.00
max 20.00 5.00     100.00 85.00
$stacjonarnie
[1]  2 20

$hybrydowo
[1]  1.7 20.0

$zdalnie
[1]  1.2 13.0

Analysis of Variance Table

Model 1: wynik ~ nauka + lek + frekwencja + tryb
Model 2: wynik ~ nauka * tryb + lek + frekwencja
  Res.Df   RSS Df Sum of Sq      F    Pr(>F)
1    234 24547
2    232 22758  2    1788.9 9.1181 0.0001542 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
R2_m1 R2_m2
0.409 0.452
                    Estimate Std. Error t value Pr(>|t|)
(Intercept)           35.216      5.810   6.061    0.000
nauka                  2.273      0.219  10.381    0.000
trybhybrydowo          7.153      3.682   1.942    0.053
trybzdalnie            8.712      3.860   2.257    0.025
lek                   -3.688      0.922  -4.000    0.000
frekwencja             0.109      0.054   2.010    0.046
nauka:trybhybrydowo   -0.983      0.348  -2.828    0.005
nauka:trybzdalnie     -1.761      0.452  -3.898    0.000
stacjonarnie    hybrydowo      zdalnie
   "#3B67B1"    "#CAB411"    "#8A8676"
2. Rysunek 1: wykres współczynników
R
# Rysunek 1: współczynniki modelu 1 z 95% CI – jednostki surowe i wspólna skala (kontynuacja: dane, m1, motyw)
wsp_tab <- function(model) {
  w <- data.frame(term = names(coef(model)), b = coef(model), confint(model))[-1, ]
  setNames(w, c("term", "b", "dolna", "gorna"))
}
# A: b w jednostkach surowych (godzina, punkt lęku, punkt procentowy, różnica grup)
wA <- wsp_tab(m1)
# B: predyktory ciągłe podzielone przez 2 SD (Gelman, 2008); tryb bez zmian (różnica grup)
dwa_sd <- function(x) (x - mean(x)) / (2 * sd(x))
m1_2sd <- lm(wynik ~ dwa_sd(nauka) + dwa_sd(lek) + dwa_sd(frekwencja) + tryb, data = dane)
wB <- wsp_tab(m1_2sd)
etyk <- c("nauka (godz./tydz.)", "lęk (1–5)", "frekwencja (%)", "hybrydowo vs stacjonarnie", "zdalnie vs stacjonarnie")
wA$etyk <- wB$etyk <- factor(etyk, levels = rev(etyk))
wA$rodzaj <- wB$rodzaj <- rep(c("predyktor ciągły", "różnica grup"), c(3, 2))
data.frame(predyktor = wA$etyk, round(wA[, c("b", "dolna", "gorna")], 2), b_2SD = round(wB$b, 2),
           dolna_2SD = round(wB$dolna, 2), gorna_2SD = round(wB$gorna, 2), row.names = NULL)
rysuj_wsp <- function(w, tytul, os_x) {
  ggplot(w, aes(x = b, y = etyk)) +
    geom_vline(xintercept = 0, colour = "grey40") +
    geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = "grey20") +
    geom_point(aes(shape = rodzaj), size = 3.2, colour = "#0072B2") +
    geom_text(aes(label = z_minusem(sprintf("%.2f", b))), vjust = -0.9, size = 4.4) +
    scale_x_continuous(labels = z_minusem) +
    scale_shape_manual(values = c("predyktor ciągły" = 16, "różnica grup" = 15), name = NULL) +
    labs(title = tytul, x = os_x, y = NULL) + motyw
}
p1 <- rysuj_wsp(wA, "A. Jednostki surowe", "b (punkty egzaminu na jednostkę)") +
  rysuj_wsp(wB, "B. Wspólna skala", "punkty egzaminu (2 SD lub różnica grup)") +
  scale_y_discrete(labels = NULL) +       # te same predyktory w tej samej kolejności co w panelu A
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
Wynik w R
                  predyktor     b dolna gorna b_2SD dolna_2SD gorna_2SD
1       nauka (godz./tydz.)  1.67  1.35  1.98 14.23     11.53     16.94
2                 lęk (1–5) -3.63 -5.49 -1.76 -5.12     -7.75     -2.48
3            frekwencja (%)  0.11  0.00  0.22  2.60     -0.04      5.23
4 hybrydowo vs stacjonarnie -2.37 -5.40  0.66 -2.37     -5.40      0.66
5   zdalnie vs stacjonarnie -5.30 -8.70 -1.89 -5.30     -8.70     -1.89
3. Rysunek 2: pasmo ufności, pasmo predykcji, ekstrapolacja
R
# Rysunek 2: przewidywania z modelu 2 – pasmo ufności, pasmo predykcji, ekstrapolacja (kontynuacja: dane, m2, motyw)
# datagrid(): pozostałe predyktory liczbowe na średniej, tryb = najczęstszy (stacjonarnie)
przewidz <- function(nowe) {
  ci <- predict(m2, nowe, interval = "confidence")
  pi <- predict(m2, nowe, interval = "prediction")
  cbind(nowe, fit = ci[, "fit"], ci_d = ci[, "lwr"], ci_g = ci[, "upr"], pi_d = pi[, "lwr"], pi_g = pi[, "upr"])
}
# A: lęk w zakresie danych
pA <- przewidz(datagrid(model = m2, lek = seq(min(dane$lek), max(dane$lek), length.out = 60)))
round(przewidz(datagrid(model = m2, lek = 3))[, c("fit", "ci_d", "ci_g", "pi_d", "pi_g")], 2)
# B: godziny nauki od 0 do 35, choć w trybie stacjonarnym obserwowano 2–20 godzin
zakres <- range(dane$nauka[dane$tryb == "stacjonarnie"])
pB <- przewidz(datagrid(model = m2, nauka = seq(0, 35, by = 0.25)))
pB$poza <- pB$nauka < zakres[1] | pB$nauka > zakres[2]
round(przewidz(datagrid(model = m2, nauka = c(0, 20, 30, 35)))[, c("nauka", "fit", "ci_d", "ci_g")], 2)
p2a <- ggplot(pA, aes(lek, fit)) +
  geom_ribbon(aes(ymin = pi_d, ymax = pi_g, fill = "95% przedział predykcji (osoba)")) +
  geom_ribbon(aes(ymin = ci_d, ymax = ci_g, fill = "95% przedział ufności (średnia)")) +
  geom_line(linewidth = 1.1, colour = "#0072B2") +
  geom_rug(data = dane, aes(x = lek), inherit.aes = FALSE, alpha = 0.3, length = unit(0.03, "npc")) +
  scale_fill_manual(values = c("95% przedział predykcji (osoba)" = "grey85",
                               "95% przedział ufności (średnia)" = "#56B4E9"), name = NULL) +
  guides(fill = guide_legend(ncol = 1)) +
  coord_cartesian(ylim = c(0, 100)) +
  labs(title = "A. Średnia a pojedyncza osoba", x = "Lęk przed statystyką (1–5)", y = "Przewidywany wynik egzaminu") + motyw
p2b <- ggplot(pB, aes(nauka, fit)) +
  annotate("rect", xmin = zakres[1], xmax = zakres[2], ymin = -Inf, ymax = Inf, fill = "grey93") +
  geom_hline(yintercept = 100, linetype = "dashed", colour = "grey30") +
  annotate("text", x = 0.5, y = 106, label = "maksimum skali (100)", hjust = 0, size = 4.4) +
  geom_ribbon(aes(ymin = ci_d, ymax = ci_g, group = poza), fill = "#56B4E9", alpha = 0.6) +
  geom_line(aes(linetype = poza, group = poza), linewidth = 1.1, colour = "#0072B2") +
  geom_rug(data = subset(dane, tryb == "stacjonarnie"), aes(x = nauka), inherit.aes = FALSE,
           alpha = 0.4, length = unit(0.03, "npc")) +
  scale_linetype_manual(values = c("FALSE" = "solid", "TRUE" = "22"),
                        labels = c("w zakresie danych (szare tło)", "ekstrapolacja"), name = NULL) +
  guides(linetype = guide_legend(ncol = 1)) +
  coord_cartesian(ylim = c(0, 115)) +
  labs(title = "B. Poza zakresem danych", x = "Godziny nauki (tryb stacjonarny)", y = NULL) + motyw
p2 <- p2a + p2b
Wynik w R
    fit  ci_d  ci_g  pi_d  pi_g
1 53.04 51.06 55.01 33.43 72.65
  nauka    fit   ci_d   ci_g
1     0  32.69  28.09  37.29
2    20  78.15  73.28  83.03
3    30 100.89  91.89 109.88
4    35 112.25 101.14 123.36
4. Rysunek 3: wykres interakcji
R
# Rysunek 3: interakcja nauka × tryb – proste regresji w zakresie danych każdej grupy (kontynuacja: dane, m2, motyw)
# df = stopnie swobody reszt: przedziały z rozkładu t, jak w predict() i summary() (domyślnie marginaleffects używa z)
siatka <- predictions(m2, newdata = datagrid(nauka = seq(1, 20, by = 0.25), tryb = levels(dane$tryb)),
                      df = df.residual(m2))
siatka <- as.data.frame(siatka)
zakresy <- tapply(dane$nauka, dane$tryb, range)   # używane też w przepisie 5
w_zakresie <- mapply(function(x, g) x >= zakresy[[g]][1] & x <= zakresy[[g]][2], siatka$nauka, as.character(siatka$tryb))
siatka <- siatka[w_zakresie, ]
# przewidywania przy 4 i 12 godzinach (lęk i frekwencja na średniej)
p_tab <- predictions(m2, newdata = datagrid(nauka = c(4, 12), tryb = levels(dane$tryb)), df = df.residual(m2))
data.frame(tryb = p_tab$tryb, nauka = p_tab$nauka, wynik = round(p_tab$estimate, 2),
           dolna = round(p_tab$conf.low, 2), gorna = round(p_tab$conf.high, 2))
konce <- do.call(rbind, lapply(split(siatka, siatka$tryb), function(d) d[which.max(d$nauka), ]))
p3 <- ggplot(siatka, aes(nauka, estimate, colour = tryb, fill = tryb)) +
  geom_point(data = dane, aes(nauka, wynik, shape = tryb), inherit.aes = FALSE, colour = "grey55", alpha = 0.45, size = 1.8) +
  geom_ribbon(aes(ymin = conf.low, ymax = conf.high), alpha = 0.2, colour = NA) +
  geom_line(aes(linetype = tryb), linewidth = 1.3) +
  geom_text(data = konce, aes(label = tryb), hjust = -0.08, size = 4.6, show.legend = FALSE) +
  scale_colour_manual(values = kolory, name = NULL) + scale_fill_manual(values = kolory, name = NULL) +
  scale_linetype_manual(values = linie, name = NULL) + scale_shape_manual(values = ksztalty, name = NULL) +
  scale_x_continuous(breaks = seq(0, 20, 4), limits = c(0, 24.5)) +
  labs(x = "Godziny nauki tygodniowo", y = "Wynik egzaminu (0–100)") + motyw
Wynik w R
          tryb nauka wynik dolna gorna
1 stacjonarnie     4 41.78 38.66 44.90
2    hybrydowo     4 45.00 41.26 48.74
3      zdalnie     4 43.45 39.96 46.94
4 stacjonarnie    12 59.97 57.77 62.17
5    hybrydowo    12 55.32 52.83 57.81
6      zdalnie    12 47.55 42.96 52.15
5. Rysunek 4: efekty brzegowe i Johnson–Neyman
R
# Rysunek 4: efekty brzegowe – nachylenie nauki w trybach i różnica trybów wzdłuż godzin nauki (kontynuacja: dane, m2, motyw)
nachyl <- slopes(m2, variables = "nauka", by = "tryb", df = df.residual(m2))
data.frame(tryb = nachyl$tryb, nachylenie = round(nachyl$estimate, 2), dolna = round(nachyl$conf.low, 2),
           gorna = round(nachyl$conf.high, 2), p = round(nachyl$p.value, 4))
# różnica zdalnie − stacjonarnie przy kolejnych wartościach godzin nauki (siatka co 0.01 godziny)
roznica <- comparisons(m2, variables = list(tryb = c("stacjonarnie", "zdalnie")),
                       newdata = datagrid(nauka = seq(0, 20, by = 0.01)), df = df.residual(m2))
roznica <- as.data.frame(roznica)
roznica$istotna <- roznica$conf.low > 0 | roznica$conf.high < 0
roznica$odcinek <- cumsum(c(1, diff(roznica$istotna) != 0))    # numer ciągłego odcinka do rysowania linii
# granice obszarów istotności (przybliżenie Johnsona–Neymana z siatki): pierwsza wartość nowego odcinka
roznica$nauka[c(FALSE, diff(roznica$istotna) != 0)]
round(subset(roznica, nauka %in% c(2, 4, 8, 12))[, c("nauka", "estimate", "conf.low", "conf.high")], 2)
# te same liczby do kalkulatora Johnsona–Neymana: współczynniki i ich macierz kowariancji
k <- c("trybzdalnie", "nauka:trybzdalnie")
round(coef(m2)[k], 3); round(vcov(m2)[k, k], 4); df.residual(m2)
# wspólny zakres danych obu trybów: od większego z minimów do mniejszego z maksimów
wspolny <- c(max(sapply(zakresy[c("stacjonarnie", "zdalnie")], min)), min(sapply(zakresy[c("stacjonarnie", "zdalnie")], max)))
wspolny
do_rysunku <- roznica[round(roznica$nauka * 100) %% 5 == 0 | c(FALSE, diff(roznica$istotna) != 0), ]   # co 0.05 godz. + granice
p4a <- ggplot(nachyl, aes(estimate, tryb, colour = tryb, shape = tryb)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = conf.low, xmax = conf.high), width = 0.2, orientation = "y", linewidth = 0.9) +
  geom_point(size = 3.6) +
  geom_text(aes(label = z_minusem(sprintf("%.2f", estimate))), vjust = -1, size = 4.4, show.legend = FALSE) +
  scale_colour_manual(values = kolory, guide = "none") + scale_shape_manual(values = ksztalty, guide = "none") +
  scale_y_discrete(limits = rev(levels(dane$tryb))) +
  labs(title = "A. Nachylenie w trybach", x = "Punkty za 1 godzinę nauki", y = NULL) + motyw
p4b <- ggplot(do_rysunku, aes(nauka, estimate)) +
  annotate("rect", xmin = c(0, wspolny[2]), xmax = c(wspolny[1], 20), ymin = -Inf, ymax = Inf, fill = "grey90") +
  annotate("text", x = 16.5, y = 13, label = "poza wspólnym\nzakresem danych", size = 4.2) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_ribbon(aes(ymin = conf.low, ymax = conf.high), fill = "#009E73", alpha = 0.25) +
  geom_line(aes(linetype = istotna, group = odcinek), linewidth = 1.1, colour = "#009E73") +
  geom_rug(data = subset(dane, tryb == "zdalnie"), aes(x = nauka), inherit.aes = FALSE, alpha = 0.4, length = unit(0.03, "npc")) +
  scale_linetype_manual(values = c("FALSE" = "22", "TRUE" = "solid"), labels = c("95% CI obejmuje 0", "95% CI bez 0"), name = NULL) +
  scale_y_continuous(labels = z_minusem) +
  labs(title = "B. Zdalnie − stacjonarnie", x = "Godziny nauki tygodniowo", y = "Różnica wyników (punkty)") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(0.8, 1.2))
Wynik w R
          tryb nachylenie dolna gorna      p
1 stacjonarnie       2.27  1.84  2.70 0.0000
2    hybrydowo       1.29  0.76  1.82 0.0000
3      zdalnie       0.51 -0.27  1.29 0.1968
[1] 1.14 6.89
     nauka estimate conf.low conf.high
201      2     5.19    -0.87     11.25
401      4     1.67    -3.01      6.35
801      8    -5.37    -8.72     -2.02
1201    12   -12.41   -17.50     -7.33
      trybzdalnie nauka:trybzdalnie
            8.712            -1.761
                  trybzdalnie nauka:trybzdalnie
trybzdalnie           14.9033            -1.567
nauka:trybzdalnie     -1.5670             0.204
[1] 232
[1]  2 13
6. Rysunek 5: regresja logistyczna
R
# Rysunek 5: regresja logistyczna – ilorazy szans a przewidywane prawdopodobieństwa (kontynuacja: dane, motyw)
m3 <- glm(zaliczenie ~ nauka + lek + tryb, family = binomial, data = dane)
round(mean(dane$zaliczenie), 3)          # odsetek osób, które zaliczyły ćwiczenia
or <- data.frame(term = names(coef(m3)), OR = exp(coef(m3)), exp(confint(m3)))[-1, ]
names(or)[3:4] <- c("dolna", "gorna")
or$etyk <- factor(c("nauka (+1 godz.)", "lęk (+1 pkt)", "hybrydowo vs stacjonarnie", "zdalnie vs stacjonarnie"),
                  levels = rev(c("nauka (+1 godz.)", "lęk (+1 pkt)", "hybrydowo vs stacjonarnie", "zdalnie vs stacjonarnie")))
round(or[, c("OR", "dolna", "gorna")], 2)
pr <- predictions(m3, newdata = datagrid(nauka = c(4, 8, 12), tryb = "stacjonarnie"))
data.frame(nauka = pr$nauka, p = round(pr$estimate, 3), dolna = round(pr$conf.low, 3), gorna = round(pr$conf.high, 3))
avg_slopes(m3, variables = "nauka")      # przeciętny efekt krańcowy (AME) godziny nauki
siatka_p <- as.data.frame(predictions(m3, newdata = datagrid(nauka = seq(1, 20, by = 0.25), tryb = "stacjonarnie")))
p5a <- ggplot(or, aes(OR, etyk)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y") +
  geom_point(size = 3.2, colour = "#0072B2") +
  geom_text(aes(label = sprintf("%.2f", OR)), vjust = -0.9, size = 4.4) +
  scale_x_log10(breaks = c(0.25, 0.5, 1, 2)) +
  labs(title = "A. Ilorazy szans", x = "OR (skala logarytmiczna)", y = NULL) + motyw
p5b <- ggplot(siatka_p, aes(nauka, estimate)) +
  geom_point(data = subset(dane, tryb == "stacjonarnie"), aes(nauka, zaliczenie), inherit.aes = FALSE,
             position = position_jitter(width = 0, height = 0.03, seed = 562), alpha = 0.35, size = 1.6, colour = "grey40") +
  geom_ribbon(aes(ymin = conf.low, ymax = conf.high), fill = "#56B4E9", alpha = 0.5) +
  geom_line(linewidth = 1.2, colour = "#0072B2") +
  scale_y_continuous(limits = c(-0.05, 1.05), breaks = seq(0, 1, 0.25), labels = function(x) sub("^0\\.", ".", format(x))) +
  labs(title = "B. Prawdopodobieństwo", x = "Godziny nauki (tryb stacjonarny)", y = "P(zaliczenie ćwiczeń)") + motyw
p5 <- p5a + p5b
Wynik w R
[1] 0.45
                OR dolna gorna
nauka         1.24  1.15  1.35
lek           0.40  0.25  0.62
trybhybrydowo 0.44  0.22  0.86
trybzdalnie   0.56  0.26  1.16
  nauka     p dolna gorna
1     4 0.290 0.185 0.424
2     8 0.490 0.381 0.600
3    12 0.694 0.576 0.790

 Estimate Std. Error    z Pr(>|z|)    S  2.5 % 97.5 %
   0.0414    0.00625 6.62   <0.001 34.7 0.0291 0.0537

Term: nauka
Type: response
Comparison: dY/dX
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki na stronie zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Pasmo ufności opisane jako zakres wyników osób – to przedział dla średniej, nie dla pojedynczej osoby.
- Linia przedłużona poza dane, aż za maksimum skali.
- Współczynniki w różnych jednostkach na jednej osi albo β dla zmiennej zero-jedynkowej.
- Interakcja bez danych i bez niepewności.
- Granice Johnsona–Neymana podane poza zakresem danych jednej z grup.
- OR czytany jak iloraz prawdopodobieństw.
Najczęstsze pytania
Jak zrobić wykres współczynników regresji w R?
Zbierz współczynniki i ich przedziały ufności (coef() i confint()) w ramce danych i narysuj je w ggplot2 jako punkty z poziomymi odcinkami oraz linią w zerze. Pomiń wyraz wolny i trzymaj jedną skalę: albo wszystkie współczynniki w jednostkach surowych, albo predyktory ciągłe przeskalowane (np. przez 2 SD) tak, by dało się je porównać z różnicami grup.
Czym różni się pasmo ufności od pasma predykcji na wykresie regresji?
Pasmo ufności pokazuje niepewność przewidywanej średniej dla danego profilu, a pasmo predykcji – zakres, w którym prawdopodobnie znajdzie się wynik pojedynczej osoby. Pasmo predykcji jest zawsze szersze; w przykładzie z tego wpisu przy lęku równym 3 było prawie dziesięć razy szersze. W R oba daje predict(model, interval = "confidence") i interval = "prediction".
Czy na jednym wykresie można pokazać współczynniki standaryzowane i niestandaryzowane?
Lepiej nie mieszać ich na jednej osi. Współczynniki niestandaryzowane mają różne jednostki (godziny, punkty, procenty), a β dla zmiennej 0/1 zależy od proporcji grup. Jeśli chcesz porównać predyktory, przeskaluj ciągłe (np. dzieląc przez 2 SD) i pokaż je w osobnym panelu obok współczynników surowych.
Jak narysować interakcję zmiennej ciągłej i kategorialnej w regresji?
Policz przewidywania modelu z iloczynem dla siatki wartości zmiennej ciągłej w każdej grupie (np. marginaleffects::predictions() z datagrid()) i narysuj po jednej prostej na grupę z pasmem 95% CI i surowymi danymi. Proste kończ na zakresie danych danej grupy, a grupy rozróżniaj kolorem i rodzajem linii.
Dlaczego w regresji logistycznej lepiej pokazać prawdopodobieństwa niż ilorazy szans?
Iloraz szans opisuje zmianę szans, nie prawdopodobieństwa, a ten sam OR daje różne przyrosty prawdopodobieństwa przy różnych wartościach predyktora. Wykres przewidywanych prawdopodobieństw z pasmem ufności pokazuje to wprost. Ilorazy szans, jeśli je rysujesz, umieść na osi logarytmicznej z linią w 1.
Powiązane hasła
Przeczytaj też
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikWspółczynniki standaryzowane czy niestandaryzowane?
Co mówi b, a co β, dlaczego β zależy od zakresu danych i proporcji grup, kiedy podać który współczynnik i jak opisać je w pracy – z przykładem w R.
Czytaj →PoradnikZawsze narysuj dane
Kwartet Anscombe’a i cztery pułapki korelacji na wykresach z R – z podpisem APA i zdaniem do Wyników przy każdym rysunku.
Czytaj →Masz model regresji i nie wiesz, jak go pokazać?
Pomożemy dobrać rysunki do pytań badawczych, przygotować wykresy współczynników, przewidywań i interakcji oraz opisać je tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09 ● Otwarty dostęp
- Brambor, T., Clark, W. R., & Golder, M. (2006). Understanding interaction models: Improving empirical analyses. Political Analysis, 14(1), 63–82. https://doi.org/10.1093/pan/mpi014
- Gelman, A. (2008). Scaling regression inputs by dividing by two standard deviations. Statistics in Medicine, 27(15), 2865–2873. https://doi.org/10.1002/sim.3107
- Gelman, A., Pasarica, C., & Dodhia, R. (2002). Let's practice what we preach: Turning tables into graphs. The American Statistician, 56(2), 121–130. https://doi.org/10.1198/000313002317572790
- Hainmueller, J., Mummolo, J., & Xu, Y. (2019). How much should we trust estimates from multiplicative interaction models? Simple tools to improve empirical practice. Political Analysis, 27(2), 163–192. https://doi.org/10.1017/pan.2018.46 ● Otwarty dostęp
- McCabe, C. J., Kim, D. S., & King, K. M. (2018). Improving present practices in the visual display of interactions. Advances in Methods and Practices in Psychological Science, 1(2), 147–165. https://doi.org/10.1177/2515245917746792 ● Otwarty dostęp: pełny tekst
- Spiller, S. A., Fitzsimons, G. J., Lynch, J. G., Jr., & McClelland, G. H. (2013). Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression. Journal of Marketing Research, 50(2), 277–288. https://doi.org/10.1509/jmr.12.0420
Cytowania BibTeX
@article{arelbundock2024how, author={Arel-Bundock, Vincent and Greifer, Noah and Heiss, Andrew}, title={{How to interpret statistical models using marginaleffects for R and Python}}, journal={Journal of Statistical Software}, year={2024}, volume={111}, number={9}, pages={1--32}, doi={10.18637/jss.v111.i09}}@article{brambor2006understanding, author={Brambor, Thomas and Clark, William Roberts and Golder, Matt}, title={{Understanding interaction models: Improving empirical analyses}}, journal={Political Analysis}, year={2006}, volume={14}, number={1}, pages={63--82}, doi={10.1093/pan/mpi014}}@article{gelman2008scaling, author={Gelman, Andrew}, title={{Scaling regression inputs by dividing by two standard deviations}}, journal={Statistics in Medicine}, year={2008}, volume={27}, number={15}, pages={2865--2873}, doi={10.1002/sim.3107}}@article{gelman2002lets, author={Gelman, Andrew and Pasarica, Cristian and Dodhia, Rahul}, title={{Let's practice what we preach: Turning tables into graphs}}, journal={The American Statistician}, year={2002}, volume={56}, number={2}, pages={121--130}, doi={10.1198/000313002317572790}}@article{hainmueller2019how, author={Hainmueller, Jens and Mummolo, Jonathan and Xu, Yiqing}, title={{How much should we trust estimates from multiplicative interaction models? Simple tools to improve empirical practice}}, journal={Political Analysis}, year={2019}, volume={27}, number={2}, pages={163--192}, doi={10.1017/pan.2018.46}}@article{mccabe2018improving, author={McCabe, Connor J. and Kim, Dale S. and King, Kevin M.}, title={{Improving present practices in the visual display of interactions}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={147--165}, doi={10.1177/2515245917746792}}@article{spiller2013spotlights, author={Spiller, Stephen A. and Fitzsimons, Gavan J. and Lynch, Jr., John G. and McClelland, Gary H.}, title={{Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression}}, journal={Journal of Marketing Research}, year={2013}, volume={50}, number={2}, pages={277--288}, doi={10.1509/jmr.12.0420}}