Co to są efekty krańcowe (AME)?
Przeciętny efekt krańcowy (ang. average marginal effect, AME) to średnia zmiana przewidywanego prawdopodobieństwa wyniku: dla zmiennej ciągłej pochodna, czyli tempo zmiany na jednostkę predyktora (w przybliżeniu efekt wzrostu o jednostkę), a dla zmiennej binarnej różnica przy zmianie kategorii. Liczy się go dla każdej osoby w próbie i uśrednia. W regresji logistycznej AME wyraża wynik w punktach procentowych, a nie w szansach.
Dlaczego nie wystarczy iloraz szans
Iloraz szans jest stały w całym modelu, ale zmiana prawdopodobieństwa już nie: zależy od tego, gdzie na krzywej logistycznej leży dana osoba. Mood (2010) pokazuje też, że ilorazy szans odzwierciedlają nieobserwowaną heterogeniczność, więc nie da się ich wprost porównywać między modelami z różnymi predyktorami ani między grupami. AME, wyrażony w punktach procentowych, jest dla czytelnika łatwiejszy do zrozumienia.
Hanmer i Kalkan (2013) zalecają podejście wartości obserwowanych: efekt liczy się dla każdej rzeczywistej osoby i uśrednia, zamiast liczyć go dla „przeciętnego przypadku” z wartościami średnimi wszystkich predyktorów (MEM). Oba podejścia mogą dać różne wyniki.
Jak liczyć
- Predyktor ciągły: AME = średnia z b·pi(1 − pi), czyli pochodnych prawdopodobieństwa.
- Predyktor binarny: każdej osobie przypisuje się raz 1, raz 0, i uśrednia różnicę przewidywanych prawdopodobieństw.
Przedział ufności daje bootstrap albo metoda delta. Tak samo liczy się AME w regresji probitowej.
Przykład
W symulowanych danych 400 studentów zdanie egzaminu zależało od godzin nauki i udziału w kursie. Iloraz szans dla kursu wyniósł 2.26, a AME 0.178, 95% CI [0.090, 0.277]: kurs podnosił prawdopodobieństwo zdania średnio o 17.8 punktu procentowego. Każda godzina nauki dawała OR = 1.13 i AME = 0.027 [0.020, 0.033], czyli 2.7 punktu procentowego.
Na rysunku
Rysunek pokazuje model z przykładu: efekt krańcowy godzin nauki policzony osobno dla każdej z 400 osób. To, że ta sama godzina zmienia prawdopodobieństwo różnie w różnych miejscach krzywej logistycznej, pokazuje krok po kroku wpis Regresja logistyczna w obrazkach; tu chodzi o to, jak z tych efektów powstaje jedna liczba.
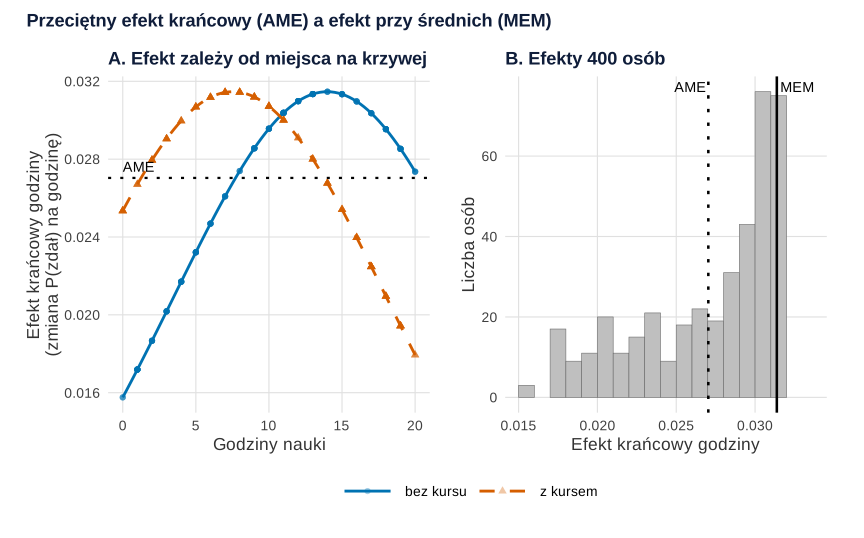
set.seed(512)).Co widać. Efekt godziny to nachylenie krzywej logistycznej, b·p(1 − p), więc jest największy tam, gdzie p jest bliskie .5. U osób z kursem ten punkt wypada wcześniej, przy mniejszej liczbie godzin. Efekty osób wahają się od 0.016 do 0.031; ich średnia to AME = 0.027. MEM liczy efekt dla jednej „przeciętnej osoby” (10.04 godziny, kurs = 0.482) i daje 0.031 – prawie maksimum, bo ta fikcyjna osoba ma p bliskie .5. Dla kursu różnica jest podobna: AME = 0.178, a MEM = 0.200.
Na co uważać. Kurs = 0.482 nie opisuje nikogo – to jedna z przyczyn, dla których Hanmer i Kalkan (2013) wolą AME. Histogram pokazuje skład tej konkretnej próby: w próbie z większą liczbą osób na krańcach krzywej AME byłby mniejszy przy tym samym modelu. Wykres nie pokazuje niepewności – przedziały ufności podaje przykład w R.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tej sekcji. Jest samowystarczalny: kolory Okabe–Ito i prosty motyw definiuje sam, a dane powstają od własnego set.seed(512), tego samego co w przykładzie (ziarna nie zmieniano). Rysunek na stronie to ten sam obiekt p1 z motywem serwisu (inna czcionka i siatka).
Kod R rysunku 1
# Rysunek 1. Efekt krańcowy godzin nauki u każdej osoby, jego średnia (AME) i efekt w punkcie średnich (MEM)
library(ggplot2)
library(patchwork)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))
kolory <- c("bez kursu" = "#0072B2", "z kursem" = "#D55E00")

# Te same dane i model co w przykładzie
set.seed(512)
n <- 400
d <- data.frame(godziny = round(runif(n, 0, 20)), kurs = rbinom(n, 1, 0.5))
d$zdal <- rbinom(n, 1, plogis(-2 + 0.15 * d$godziny + 0.9 * d$kurs))
m <- glm(zdal ~ godziny + kurs, family = binomial, data = d)
b <- coef(m)

# Efekt krańcowy godzin u osoby i: b_godziny · p_i · (1 − p_i)
p <- fitted(m)
d$efekt <- b["godziny"] * p * (1 - p)
d$grupa <- factor(ifelse(d$kurs == 1, "z kursem", "bez kursu"), names(kolory))
AME <- mean(d$efekt)
p_sr <- plogis(b[1] + b["godziny"] * mean(d$godziny) + b["kurs"] * mean(d$kurs))  # „przeciętna osoba”
MEM <- unname(b["godziny"] * p_sr * (1 - p_sr))
round(c(AME = AME, MEM = MEM, min = min(d$efekt), max = max(d$efekt),
        sr_godziny = mean(d$godziny), sr_kurs = mean(d$kurs)), 3)
round(tapply(d$efekt, d$grupa, mean), 3)               # średni efekt w grupach kursu
# Dla kursu (zmienna 0/1): AME = średnia różnic u osób, MEM = różnica przy średnich godzinach
MEM_kurs <- unname(plogis(b[1] + b["godziny"] * mean(d$godziny) + b["kurs"]) -
                   plogis(b[1] + b["godziny"] * mean(d$godziny)))
AME_kurs <- mean(plogis(b[1] + b["godziny"] * d$godziny + b["kurs"]) - plogis(b[1] + b["godziny"] * d$godziny))
round(c(AME_kurs = AME_kurs, MEM_kurs = MEM_kurs), 3)

# A: efekt krańcowy w funkcji godzin – krzywe dla obu grup, punkty = osoby
siatka <- expand.grid(godziny = seq(0, 20, 0.25), kurs = 0:1)
siatka$p <- predict(m, siatka, type = "response")
siatka$efekt <- b["godziny"] * siatka$p * (1 - siatka$p)
siatka$grupa <- factor(ifelse(siatka$kurs == 1, "z kursem", "bez kursu"), names(kolory))
pA <- ggplot(siatka, aes(godziny, efekt, colour = grupa)) +
  geom_line(aes(linetype = grupa), linewidth = 1) +
  geom_point(data = d, aes(shape = grupa), alpha = 0.35, size = 1.8) +
  geom_hline(yintercept = AME, linetype = "dotted", linewidth = 0.8) +
  annotate("text", x = 0, y = AME, label = "AME", vjust = -0.6, hjust = 0, size = 3.8) +
  labs(title = "A. Efekt zależy od miejsca na krzywej", x = "Godziny nauki",
       y = "Efekt krańcowy godziny\n(zmiana P(zdał) na godzinę)", colour = NULL, linetype = NULL, shape = NULL) +
  scale_colour_manual(values = kolory) +
  scale_shape_manual(values = c("bez kursu" = 16, "z kursem" = 17)) +
  scale_linetype_manual(values = c("bez kursu" = "solid", "z kursem" = "dashed"))

# B: rozkład efektów 400 osób; linia kropkowana = AME (średnia), linia ciągła = MEM
pB <- ggplot(d, aes(efekt)) +
  geom_histogram(binwidth = 0.001, boundary = 0, fill = "grey75", colour = "grey40", linewidth = 0.2) +
  geom_vline(xintercept = AME, linetype = "dotted", linewidth = 0.9) +
  geom_vline(xintercept = MEM, linetype = "solid", linewidth = 0.9) +
  annotate("text", x = AME, y = Inf, label = "AME", vjust = 1.5, hjust = 1.1, size = 3.8) +
  annotate("text", x = MEM, y = Inf, label = "MEM", vjust = 1.5, hjust = -0.1, size = 3.8) +
  scale_x_continuous(expand = expansion(mult = c(0.05, 0.15))) +
  labs(title = "B. Efekty 400 osób", x = "Efekt krańcowy godziny", y = "Liczba osób")
p1 <- (pA + pB) + plot_layout(guides = "collect") +
  plot_annotation(title = "Przeciętny efekt krańcowy (AME) a efekt przy średnich (MEM)") & motyw & theme(legend.key.width = unit(3, "lines"))
p1   # zapis: ggsave("efekty-krancowe-ame-a-mem.svg", p1, width = 9, height = 5.6)
Wynik w R
       AME        MEM        min        max sr_godziny    sr_kurs
     0.027      0.031      0.016      0.031     10.040      0.482
bez kursu  z kursem
    0.027     0.027
AME_kurs MEM_kurs
   0.178    0.200
Jak opisać w pracy
Na co uważać
AME zależy od składu próby – w innej populacji ten sam model da inny efekt. W modelach z interakcją współczynnik iloczynu w skali logitów nie jest interakcją w skali prawdopodobieństwa; porównaj AME w podgrupach.
AME w R: obliczenie ręczne i marginaleffects
Kod dopasowuje regresję logistyczną, liczy AME ręcznie (średnia pochodnych dla godzin, średnia różnic przewidywanych prawdopodobieństw dla kursu) i przedziały bootstrapowe z pakietu boot. Funkcja marginaleffects::avg_slopes() daje te same AME (0.027 i 0.178), a jej przedziały metodą delta wynoszą [0.020, 0.034] i [0.087, 0.269].
OR a AME dla dwóch predyktorów
R
library(boot)
set.seed(512)
n <- 400
d <- data.frame(godziny = round(runif(n, 0, 20)), kurs = rbinom(n, 1, 0.5))
d$zdal <- rbinom(n, 1, plogis(-2 + 0.15 * d$godziny + 0.9 * d$kurs))
m <- glm(zdal ~ godziny + kurs, family = binomial, data = d)
round(exp(coef(m))[-1], 2)                       # ilorazy szans
ame <- function(dane, i = seq_len(nrow(dane))) {
  dd <- dane[i, ]
  f <- glm(zdal ~ godziny + kurs, family = binomial, data = dd)
  p <- fitted(f)
  c(godziny = mean(coef(f)["godziny"] * p * (1 - p)),       # średnia pochodnych
    kurs = mean(predict(f, transform(dd, kurs = 1), type = "response") -
                predict(f, transform(dd, kurs = 0), type = "response")))  # średnia różnic
}
round(ame(d), 3)                                 # AME na skali prawdopodobieństwa
b <- boot(d, ame, R = 1000)
round(rbind(godziny = boot.ci(b, type = "perc", index = 1)$percent[4:5],
            kurs = boot.ci(b, type = "perc", index = 2)$percent[4:5]), 3)  # 95% CI
me <- marginaleffects::avg_slopes(m)             # to samo pakietem; CI metodą delta
round(data.frame(AME = me$estimate, dolna = me$conf.low, gorna = me$conf.high,
                 row.names = me$term), 3)
Wynik w R
godziny    kurs
   1.13    2.26
godziny    kurs
  0.027   0.178
        [,1]  [,2]
godziny 0.02 0.033
kurs    0.09 0.277
          AME dolna gorna
godziny 0.027 0.020 0.034
kurs    0.178 0.087 0.269
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami boot 1.3-32 i marginaleffects 1.0.0. Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- marginaleffects (wersja 1.0.0): Arel-Bundock, V. (2026). marginaleffects: Predictions, comparisons, slopes, marginal means, and hypothesis tests (R package version 1.0.0) [Computer software]. https://doi.org/10.32614/CRAN.package.marginaleffects
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym AME różni się od ilorazu szans?
Iloraz szans opisuje mnożnik szans i jest stały w modelu. AME podaje średnią zmianę prawdopodobieństwa w punktach procentowych. W przykładzie kurs miał OR = 2.26 i AME = 0.178.
Czym AME różni się od efektu krańcowego przy średnich (MEM)?
MEM liczy efekt dla jednej hipotetycznej osoby o średnich wartościach predyktorów. AME liczy efekt dla każdej rzeczywistej osoby i uśrednia, co lepiej opisuje próbę.
Jak policzyć AME w R bez dodatkowych pakietów?
Dla predyktora ciągłego uśrednij b·p(1 − p) z dopasowanych prawdopodobieństw. Dla binarnego uśrednij różnicę predict() przy wartościach 1 i 0. Przedział ufności daje bootstrap z pakietu boot.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Standaryzacja (g-computation): różnica ryzyk
Od ilorazu szans do różnicy ryzyk i RR: standaryzacja w R, bootstrap i metoda delta, ATE i ATT, nieskładalność OR i porównanie z IPW.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hanmer, M. J., & Kalkan, K. O. (2013). Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models. American Journal of Political Science, 57(1), 263–277. https://doi.org/10.1111/j.1540-5907.2012.00602.x
- Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{hanmer2013behind, author={Hanmer, Michael J. and Kalkan, Kerem Ozan}, title={{Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models}}, journal={American Journal of Political Science}, year={2013}, volume={57}, number={1}, pages={263--277}, doi={10.1111/j.1540-5907.2012.00602.x}}@article{mood2010logistic, author={Mood, Carina}, title={{Logistic regression: Why we cannot do what we think we can do, and what we can do about it}}, journal={European Sociological Review}, year={2010}, volume={26}, number={1}, pages={67--82}, doi={10.1093/esr/jcp006}}