Co to jest wykres efektów modelu?
Wykres efektów modelu (ang. effect plot, effect display) pokazuje przewidywany wynik modelu w funkcji jednego predyktora, z pasmem ufności. W regresji logistycznej na osi pionowej jest prawdopodobieństwo zdarzenia, a nie logit ani iloraz szans. Dzięki temu czytelnik widzi wynik w zrozumiałej skali. Pozostałe predyktory trzeba jednak gdzieś „ustawić”, a ten wybór zmienia krzywą.
Jak czytać wykres
- Linia to przewidywana wartość wyniku dla kolejnych wartości predyktora, pasmo – zwykle 95% przedział ufności dla tej średniej przewidywanej wartości (nie dla pojedynczej osoby).
- Nachylenie zmienia się wzdłuż osi. Stały iloraz szans daje małe przyrosty prawdopodobieństwa przy wartościach bliskich 0 lub 1 i największe w pobliżu .50.
- Profil pozostałych zmiennych musi być podany. „Przy średnich” oznacza jedną, przeciętną osobę. „Uśrednione po próbie” oznacza, że każdej osobie w danych przypisuje się daną wartość predyktora i uśrednia jej przewidywane prawdopodobieństwa.
Hanmer i Kalkan (2013) pokazują, że oba podejścia mogą dawać merytorycznie różne wyniki, i zalecają uśrednianie po obserwowanych wartościach, bo opisuje przeciętny efekt w populacji, a nie efekt dla „przeciętnego przypadku”. Muller i MacLehose (2014) dodają, że różne sposoby liczenia odpowiadają różnym populacjom docelowym. Ten sam podział dotyczy efektów krańcowych (AME a MEM).
Przykład
W symulowanych danych 400 osób zaproszono na badanie przesiewowe; zgłosiło się 28.2%. Model logistyczny zawierał wiek, odległość od punktu badań (średnio 15.8 km, mediana 13.2 km – rozkład prawostronnie skośny) i przypomnienie SMS (38.8% osób). Współczynniki symulacji ustawiono ręcznie tak, by odległość silnie wpływała na zgłaszalność i różnica dwóch sposobów liczenia była wyraźna; ziarna (751) nie zmieniano. Iloraz szans dla wieku wyniósł 1.97 na 10 lat, 95% CI [1.46, 2.66], dla odległości 0.28 na 10 km, 95% CI [0.20, 0.41], a dla SMS 2.13, 95% CI [1.29, 3.53].
Na rysunku
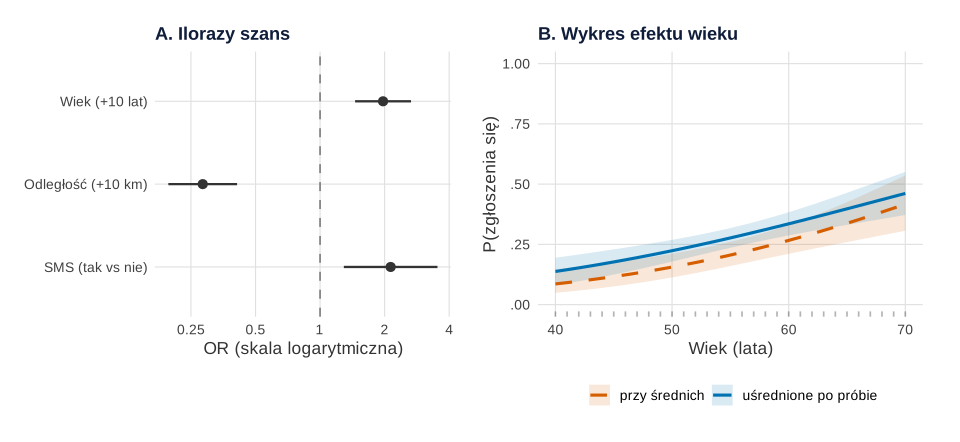
set.seed(751)).Co widać. Panel A mówi, że szanse rosną z wiekiem, ale nie mówi, jak duże jest prawdopodobieństwo. Panel B to pokazuje. W wieku 55 lat krzywa uśredniona po próbie daje .277, 95% CI [.236, .318], a krzywa „przy średnich” – .206, 95% CI [.160, .260]. Przy 45 latach to .177 wobec .116, przy 65 latach .398 wobec .338. Krzywa „przy średnich” dotyczy osoby mieszkającej 15.8 km od punktu badań i mającej 0.39 SMS-a. Takiej osoby nie ma, a średnia prawdopodobieństw nie równa się prawdopodobieństwu dla średniej osoby. Większość osób mieszka bliżej niż średnio i ma wyższe szanse, a nieliczne dalekie osoby nie mogą „zejść” poniżej zera.
Na co uważać. Krzywa nie pokazuje rozrzutu wyników osób ani tego, czy model dobrze opisuje kształt zależności. Kreski przy osi poziomej pokazują, gdzie są dane; poza nimi krzywa to ekstrapolacja. Pasmo przy średnich jest tu szersze, bo dotyczy jednego profilu, a nie średniej po 400 osobach. Inne przykłady – krzywą S z odsetkami w przedziałach i interakcję w dwóch skalach – pokazuje wpis regresja logistyczna w obrazkach, a zestaw rysunków do jednego modelu – wynik regresji na wykresie.
Podpis do pracy:
Kod rysunku zawiera sekcja Wykres efektów w R. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Jak opisać w pracy
Na co uważać
- Brak informacji o profilu. Napisz w podpisie, przy jakich wartościach pozostałych zmiennych liczono krzywą. Domyślne ustawienia pakietów bywają różne (średnia, wartość modalna, poziom odniesienia).
- „OR = 1.97, czyli prawdopodobieństwo prawie dwa razy większe”. To zmiana szans; zmianę prawdopodobieństwa odczytuje się z wykresu efektów.
- Interakcje. Przy interakcji narysuj osobne krzywe dla wartości moderatora; średnie brzegowe i wykres współczynników pokażą wtedy tylko część obrazu.
Wykres efektów w R
Kod symuluje dane, dopasowuje model logistyczny, liczy ilorazy szans i dwie krzywe przewidywań funkcjami pakietu marginaleffects (Arel-Bundock i in., 2024): predictions() z datagrid() dla przeciętnej osoby i avg_predictions() z siatką kontrfaktyczną dla przewidywań uśrednionych po próbie.
Ilorazy szans i dwie krzywe przewidywań
R
# Wykres efektów regresji logistycznej: ilorazy szans (A) i przewidywane prawdopodobieństwo (B)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(marginaleffects)})
kol <- c("uśrednione po próbie" = "#0072B2", "przy średnich" = "#D55E00")  # Okabe–Ito
lin <- c("uśrednione po próbie" = "solid", "przy średnich" = "dashed")    # metoda też typem linii
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(751)                                       # 400 zaproszonych na badanie przesiewowe
n <- 400
wiek <- round(runif(n, 40, 70))                     # lata
odleglosc <- round(rgamma(n, shape = 2, scale = 8), 1)  # km do punktu badań
sms <- rbinom(n, 1, 0.4)                            # przypomnienie SMS: 1 = tak
p <- plogis(0.5 + 0.06 * (wiek - 55) - 0.15 * odleglosc + 1.0 * sms)
zgloszenie <- rbinom(n, 1, p)                       # 1 = zgłosił(a) się na badanie
d <- data.frame(zgloszenie, wiek, odleglosc, sms)
m <- glm(zgloszenie ~ I(wiek / 10) + I(odleglosc / 10) + sms, family = binomial, data = d)
or <- data.frame(predyktor = c("Wiek (+10 lat)", "Odległość (+10 km)", "SMS (tak vs nie)"),
                 OR = exp(coef(m)[-1]), exp(confint.default(m)[-1, ]), row.names = NULL)
names(or)[3:4] <- c("dolna", "gorna")
siatka <- 40:70
przy_srednich <- predictions(m, newdata = datagrid(wiek = siatka, odleglosc = mean(d$odleglosc),
                                                    sms = mean(d$sms)))          # „przeciętna osoba”
usrednione <- avg_predictions(m, newdata = datagrid(wiek = siatka, grid_type = "counterfactual"),
                              by = "wiek")                                    # każdy z wiekiem = x, potem średnia
krzywe <- rbind(data.frame(metoda = "przy średnich", przy_srednich[, c("wiek", "estimate", "conf.low", "conf.high")]),
                data.frame(metoda = "uśrednione po próbie", usrednione[, c("wiek", "estimate", "conf.low", "conf.high")]))
pA <- ggplot(or, aes(OR, factor(predyktor, levels = rev(predyktor)))) +
  geom_vline(xintercept = 1, linetype = "dashed", colour = "grey50") +
  geom_pointrange(aes(xmin = dolna, xmax = gorna), colour = "grey20", size = 0.5, linewidth = 0.8) +
  scale_x_log10(breaks = c(0.25, 0.5, 1, 2, 4), labels = c("0.25", "0.5", "1", "2", "4")) +
  labs(title = "A. Ilorazy szans", x = "OR (skala logarytmiczna)", y = NULL)
pB <- ggplot(krzywe, aes(wiek, estimate, colour = metoda, fill = metoda, linetype = metoda)) +
  geom_ribbon(aes(ymin = conf.low, ymax = conf.high), alpha = 0.15, colour = NA) +
  geom_line(linewidth = 1.1) +
  geom_rug(data = d, aes(x = wiek), inherit.aes = FALSE, alpha = 0.3, length = unit(0.02, "npc")) +
  scale_colour_manual(values = kol, name = NULL) + scale_fill_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = lin, name = NULL) +
  scale_y_continuous(limits = c(0, 1), labels = function(x) sub("^0\\.", ".", format(x))) +
  labs(title = "B. Wykres efektu wieku", x = "Wiek (lata)", y = "P(zgłoszenia się)")
p1 <- (pA + pB + plot_layout(widths = c(1, 1.3))) & motyw
print(transform(or, OR = round(OR, 2), dolna = round(dolna, 2), gorna = round(gorna, 2)), row.names = FALSE)
wybrane <- krzywe[krzywe$wiek %in% c(45, 55, 65), ]
wybrane[, 3:5] <- round(wybrane[, 3:5], 3)
print(wybrane[order(wybrane$metoda, wybrane$wiek), ], row.names = FALSE)
round(c(odsetek_zgloszen = mean(zgloszenie), srednia_odleglosc = mean(odleglosc),
        mediana_odleglosci = median(odleglosc), odsetek_sms = mean(sms)), 3)
p1
Wynik w R
          predyktor   OR dolna gorna
     Wiek (+10 lat) 1.97  1.46  2.66
 Odległość (+10 km) 0.28  0.20  0.41
   SMS (tak vs nie) 2.13  1.29  3.53
               metoda wiek estimate conf.low conf.high
        przy średnich   45    0.116    0.075     0.175
        przy średnich   55    0.206    0.160     0.260
        przy średnich   65    0.338    0.260     0.426
 uśrednione po próbie   45    0.177    0.125     0.229
 uśrednione po próbie   55    0.277    0.236     0.318
 uśrednione po próbie   65    0.398    0.331     0.464
  odsetek_zgloszen  srednia_odleglosc mediana_odleglosci        odsetek_sms
             0.282             15.809             13.200              0.388
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja bazowa glm(); przewidywania – pakiet marginaleffects; rysunek – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym różni się wykres efektów od wykresu ilorazów szans?
Wykres ilorazów szans pokazuje po jednej liczbie na predyktor w skali szans, zwykle na osi logarytmicznej. Wykres efektów pokazuje całą krzywą przewidywanego prawdopodobieństwa, więc widać, że ten sam iloraz szans daje różne przyrosty prawdopodobieństwa w różnych miejscach osi.
Co znaczy przewidywanie „przy średnich” na wykresie efektów?
Pozostałe predyktory ustawia się na średniej i liczy prawdopodobieństwo dla jednej, „przeciętnej” osoby. W modelu nieliniowym nie jest to średnie prawdopodobieństwo w próbie, a przy zmiennych 0/1 taka osoba w ogóle nie istnieje (np. 0.39 przypomnienia SMS).
Jak narysować wykres efektów w R?
Najprościej funkcjami pakietu marginaleffects: predictions() z datagrid() daje przewidywania dla wybranego profilu, a avg_predictions() z siatką kontrfaktyczną – przewidywania uśrednione po próbie. Wynik to ramka danych, którą rysuje się w ggplot2 jako linię z pasmem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna w obrazkach
Prosta MNK na 0/1, krzywa S, logit a prawdopodobieństwo, interakcja w dwóch skalach i separacja – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikWynik regresji na wykresie
Współczynniki z CI, pasmo ufności a predykcji, ekstrapolacja, interakcja, efekty brzegowe i prawdopodobieństwa – pięć rysunków z kodem R i podpisami APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09 ● Otwarty dostęp
- Hanmer, M. J., & Kalkan, K. O. (2013). Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models. American Journal of Political Science, 57(1), 263–277. https://doi.org/10.1111/j.1540-5907.2012.00602.x
- Muller, C. J., & MacLehose, R. F. (2014). Estimating predicted probabilities from logistic regression: Different methods correspond to different target populations. International Journal of Epidemiology, 43(3), 962–970. https://doi.org/10.1093/ije/dyu029 ● Otwarty dostęp
Cytowania BibTeX
@article{arelbundock2024how, author={Arel-Bundock, Vincent and Greifer, Noah and Heiss, Andrew}, title={{How to interpret statistical models using marginaleffects for R and Python}}, journal={Journal of Statistical Software}, year={2024}, volume={111}, number={9}, pages={1--32}, doi={10.18637/jss.v111.i09}}@article{hanmer2013behind, author={Hanmer, Michael J. and Kalkan, Kerem Ozan}, title={{Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models}}, journal={American Journal of Political Science}, year={2013}, volume={57}, number={1}, pages={263--277}, doi={10.1111/j.1540-5907.2012.00602.x}}@article{muller2014estimating, author={Muller, Clemma J. and MacLehose, Richard F.}, title={{Estimating predicted probabilities from logistic regression: Different methods correspond to different target populations}}, journal={International Journal of Epidemiology}, year={2014}, volume={43}, number={3}, pages={962--970}, doi={10.1093/ije/dyu029}}