Co to jest wykres współczynników?
Wykres współczynników (ang. coefficient plot, czasem dot-and-whisker plot) to tabela regresji zamieniona na rysunek. Każdy współczynnik modelu, np. z regresji wielorakiej, jest punktem na wspólnej osi, a jego przedział ufności – poziomym odcinkiem. Pionowa linia w zerze oznacza brak związku. Gelman, Pasarica i Dodhia (2002) pokazali, że tabele wyników z czasopisma statystycznego można zastąpić wykresami, które zajmują mniej miejsca niż oryginalne tabele. Wykres współczynników przypomina wykres lasu z metaanalizy, ale w wierszach są predyktory jednego modelu, a nie wyniki kolejnych badań.
Jak czytać wykres
- Punkt to oszacowanie współczynnika, czyli przewidywana zmiana wyniku przy wzroście predyktora o jedną jednostkę i stałych pozostałych zmiennych.
- Odcinek to zwykle 95% przedział ufności. Gdy nie obejmuje zera, współczynnik jest istotny na poziomie .05; długość odcinka mówi o precyzji.
- Porównanie wierszy ma sens tylko na wspólnej skali. Współczynnik „na minutę” i „na godzinę” leżą na tej samej osi, ale znaczą co innego.
- Dwa modele rysuje się w tych samych wierszach, lekko przesunięte, z różnym kolorem i kształtem punktu. Widać wtedy, jak zmienia się współczynnik po dodaniu zmiennej.
Przykład
W symulowanych danych 300 dorosłych przewidywano satysfakcję z życia (w punktach) na podstawie wieku, dochodu (tys. zł), snu (godziny na dobę) i aktywności fizycznej (minuty tygodniowo) – model M1. Model M2 dodawał wsparcie społeczne (skala 1–7), skorelowane ze snem (r = .27) i aktywnością (r = .35). Współczynniki symulacji ustawiono ręcznie tak, by aktywność miała wyraźny związek z wynikiem mimo drobnej jednostki; ziarna (750) nie zmieniano. W M1 każda minuta aktywności tygodniowo to tylko 0.024 punktu, 95% CI [0.018, 0.030], a godzina snu – 1.440 punktu. Ta różnica wynika jednak z jednostek, a nie z siły związków.
Na rysunku
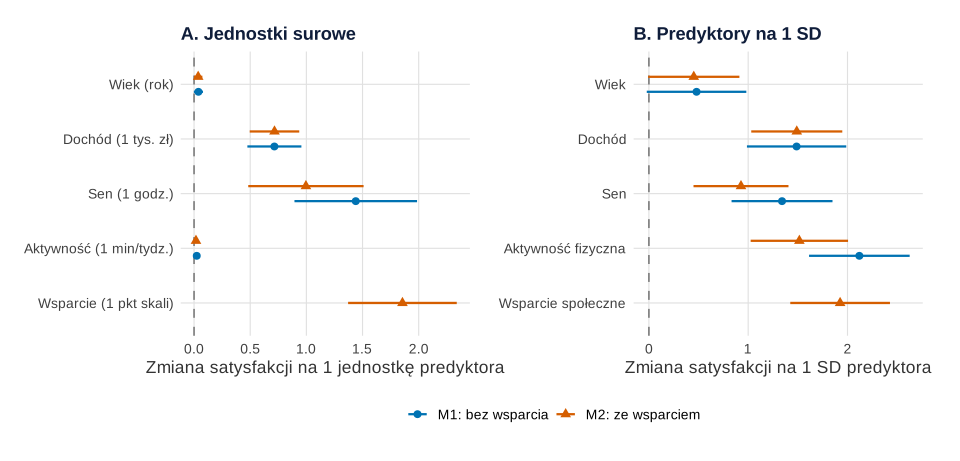
set.seed(750)).Co widać. W panelu A aktywność fizyczna „przykleja się” do zera, jakby nic nie znaczyła. Po przeliczeniu predyktorów na odchylenia standardowe (panel B; SD aktywności to 88.59 minuty) okazuje się najsilniejszym predyktorem w M1: 2.12 punktu na 1 SD, 95% CI [1.61, 2.63]. Drugi wniosek dotyczy porównania modeli. Po dodaniu wsparcia współczynnik snu maleje z 1.34 do 0.93, a aktywności – z 2.12 do 1.52 punktu na 1 SD. Dochód prawie się nie zmienia (1.49), bo nie jest związany ze wsparciem. Przedział wieku w obu modelach obejmuje zero.
Na co uważać. Przeliczenie na 1 SD zależy od rozrzutu w próbie, więc w innej próbie te same zależności dadzą inne liczby. Przy zmiennych 0/1 lepiej dzielić predyktory ciągłe przez dwa odchylenia standardowe (Gelman, 2008) – inny wariant tego rysunku pokazuje wpis wynik regresji na wykresie. Wykres nie pokazuje też, czy wsparcie jest zakłócaczem, czy mediatorem – a od tego zależy, który model opisuje interesujący nas efekt. Pułapki współczynników standaryzowanych omawia wpis współczynniki standaryzowane czy niestandaryzowane.
Podpis do pracy:
Kod rysunku i tabelę współczynników zawiera sekcja Wykres współczynników w R. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Jak opisać w pracy
Na co uważać
- Różne jednostki na jednej osi. Panel A to typowy błąd: wniosek „aktywność nie ma znaczenia” wynika z wyboru jednostki.
- Brak opisu odcinków. Napisz w podpisie, czy to 95% CI, błąd standardowy czy inny przedział.
- Współczynniki z interakcją. W modelu z interakcją efekty główne są warunkowe; zamiast nich narysuj wykres efektów modelu.
- Ranking predyktorów. Kolejność punktów nie jest testem, który predyktor jest „ważniejszy”; to wymaga porównania współczynników, a nie oglądania.
Wykres współczynników w R
Kod symuluje dane, dopasowuje oba modele w jednostkach surowych i po przeliczeniu predyktorów na 1 SD, wypisuje współczynniki z 95% przedziałami ufności i rysuje oba panele. Wyraz wolny pominięto.
Dwa modele, dwie skale
R
# Wykres współczynników dwóch modeli: jednostki surowe (A) i predyktory na 1 SD (B)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("M1: bez wsparcia" = "#0072B2", "M2: ze wsparciem" = "#D55E00")  # Okabe–Ito
ksz <- c("M1: bez wsparcia" = 16, "M2: ze wsparciem" = 17)               # model też kształtem
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(750)                                       # 300 dorosłych, dane symulowane
n <- 300
wiek <- round(runif(n, 20, 65))                     # lata
wsparcie <- rnorm(n, 5, 1)                          # wsparcie społeczne, skala 1–7
dochod <- round(rlnorm(n, log(5), 0.4), 1)          # tys. zł netto miesięcznie
sen <- 7 + 0.3 * (wsparcie - 5) + rnorm(n, 0, 0.9)  # godziny snu na dobę
aktywnosc <- pmax(0, round(150 + 40 * (wsparcie - 5) + rnorm(n, 0, 90)))  # minuty tygodniowo
satysf <- 2 + 0.02 * wiek + 0.6 * dochod + 1.0 * sen + 0.012 * aktywnosc +
  1.8 * wsparcie + rnorm(n, 0, 4)                   # satysfakcja z życia (punkty)
d <- data.frame(satysf, wiek, dochod, sen, aktywnosc, wsparcie)
nazwy <- c(wiek = "Wiek", dochod = "Dochód", sen = "Sen",
           aktywnosc = "Aktywność fizyczna", wsparcie = "Wsparcie społeczne")
jednostki <- c(wiek = "Wiek (rok)", dochod = "Dochód (1 tys. zł)", sen = "Sen (1 godz.)",
               aktywnosc = "Aktywność (1 min/tydz.)", wsparcie = "Wsparcie (1 pkt skali)")
wspolczynniki <- function(dane) {                   # oba modele, 95% CI, bez wyrazu wolnego
  m1 <- lm(satysf ~ wiek + dochod + sen + aktywnosc, data = dane)
  m2 <- lm(satysf ~ wiek + dochod + sen + aktywnosc + wsparcie, data = dane)
  do.call(rbind, lapply(list("M1: bez wsparcia" = m1, "M2: ze wsparciem" = m2), function(m) {
    ci <- confint(m)[-1, , drop = FALSE]
    data.frame(predyktor = rownames(ci), b = coef(m)[-1], dolna = ci[, 1], gorna = ci[, 2])
  })) |> transform(model = rep(names(kol), c(4, 5)))
}
surowe <- wspolczynniki(d)
d_sd <- d
for (v in names(nazwy)) d_sd[[v]] <- (d[[v]] - mean(d[[v]])) / sd(d[[v]])  # predyktory na 1 SD
na_sd <- wspolczynniki(d_sd)
rysuj <- function(tab, tytul, os_x, etykiety) {
  tab$predyktor <- factor(etykiety[tab$predyktor], levels = rev(etykiety))
  ggplot(tab, aes(b, predyktor, colour = model, shape = model)) +
    geom_vline(xintercept = 0, linetype = "dashed", colour = "grey50") +
    geom_pointrange(aes(xmin = dolna, xmax = gorna), position = position_dodge(width = 0.55),
                    size = 0.5, linewidth = 0.8) +
    scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
    labs(title = tytul, x = os_x, y = NULL)
}
pA <- rysuj(surowe, "A. Jednostki surowe", "Zmiana satysfakcji na 1 jednostkę predyktora", jednostki)
pB <- rysuj(na_sd, "B. Predyktory na 1 SD", "Zmiana satysfakcji na 1 SD predyktora", nazwy)
p1 <- (pA + pB + plot_layout(guides = "collect")) & motyw
tabela <- merge(surowe, na_sd, by = c("model", "predyktor"), suffixes = c("", "_SD"))
tabela$model <- substr(tabela$model, 1, 2)
tabela[, 3:5] <- round(tabela[, 3:5], 3)
tabela[, 6:8] <- round(tabela[, 6:8], 2)
print(tabela[order(tabela$model, -tabela$b_SD), ], row.names = FALSE)
round(sapply(d[names(nazwy)], sd), 2)               # SD predyktorów
round(c(r_wsparcie_sen = cor(wsparcie, sen), r_wsparcie_aktywnosc = cor(wsparcie, aktywnosc)), 2)
p1
Wynik w R
 model predyktor     b  dolna gorna b_SD dolna_SD gorna_SD
    M1 aktywnosc 0.024  0.018 0.030 2.12     1.61     2.63
    M1    dochod 0.715  0.475 0.956 1.49     0.99     1.99
    M1       sen 1.440  0.894 1.985 1.34     0.83     1.85
    M1      wiek 0.039 -0.002 0.080 0.48    -0.02     0.98
    M2  wsparcie 1.855  1.372 2.339 1.93     1.42     2.43
    M2 aktywnosc 0.017  0.012 0.023 1.52     1.02     2.01
    M2    dochod 0.716  0.496 0.937 1.49     1.03     1.95
    M2       sen 0.996  0.482 1.509 0.93     0.45     1.41
    M2      wiek 0.037 -0.001 0.074 0.45    -0.01     0.91
     wiek    dochod       sen aktywnosc  wsparcie
    12.32      2.08      0.93     88.59      1.04
      r_wsparcie_sen r_wsparcie_aktywnosc
                0.27                 0.35
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe lm() i confint(); rysunek – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy na wykresie współczynników pokazuje się wyraz wolny?
Zwykle nie. Wyraz wolny ma inną interpretację niż nachylenia (przewidywany wynik przy zerowych predyktorach) i często leży daleko od pozostałych punktów, przez co spłaszcza oś. Podaj go w tabeli albo w nocie pod rysunkiem.
Co zrobić, gdy predyktory mają bardzo różne jednostki?
Przed rysowaniem sprowadź predyktory ciągłe do wspólnej skali – podziel je przez odchylenie standardowe albo przez dwa odchylenia, jeśli obok są zmienne 0/1. Bez tego współczynnik zmiennej mierzonej w drobnych jednostkach przylega do zera, choć związek może być silny.
Jak pokazać dwa modele na jednym wykresie współczynników?
Narysuj współczynniki obu modeli w tych samych wierszach, lekko przesunięte w pionie, i odróżnij modele kolorem oraz kształtem punktu. Predyktor obecny tylko w jednym modelu ma wtedy jeden punkt, a zmiana pozostałych współczynników jest widoczna od razu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wynik regresji na wykresie
Współczynniki z CI, pasmo ufności a predykcji, ekstrapolacja, interakcja, efekty brzegowe i prawdopodobieństwa – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikWspółczynniki standaryzowane czy niestandaryzowane?
Co mówi b, a co β, dlaczego β zależy od zakresu danych i proporcji grup, kiedy podać który współczynnik i jak opisać je w pracy – z przykładem w R.
Czytaj →PoradnikRegresja wieloraka w obrazkach
Wykres zmiennej dodanej, zmiana znaku współczynnika, elipsa ufności przy współliniowości i ten sam predyktor w pięciu modelach – „kontrolując” na rysunkach z R.
Czytaj →PoradnikCo zwiększa zasięg posta
Producent mebli na wymiar: regresja ujemna dwumianowa z efektem konta, IRR w procentach, zmiana algorytmu i eksperyment z porą – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Gelman, A. (2008). Scaling regression inputs by dividing by two standard deviations. Statistics in Medicine, 27(15), 2865–2873. https://doi.org/10.1002/sim.3107
- Gelman, A., Pasarica, C., & Dodhia, R. (2002). Let's practice what we preach: Turning tables into graphs. The American Statistician, 56(2), 121–130. https://doi.org/10.1198/000313002317572790
Cytowania BibTeX
@article{gelman2008scaling, author={Gelman, Andrew}, title={{Scaling regression inputs by dividing by two standard deviations}}, journal={Statistics in Medicine}, year={2008}, volume={27}, number={15}, pages={2865--2873}, doi={10.1002/sim.3107}}@article{gelman2002lets, author={Gelman, Andrew and Pasarica, Cristian and Dodhia, Rahul}, title={{Let's practice what we preach: Turning tables into graphs}}, journal={The American Statistician}, year={2002}, volume={56}, number={2}, pages={121--130}, doi={10.1198/000313002317572790}}