„Kontrolując” – zdanie, które trzeba umieć narysować
W wynikach regresji wielorakiej pada zdanie: „godziny korepetycji wiązały się z wynikiem egzaminu, kontrolując wynik testu wstępnego”. Wzór jest w haśle, procedura – w poradniku regresja wieloraka krok po kroku. Tu pięć rysunków: co zostaje po „kontroli”, czemu współczynnik zmienia znak, jak skorelowane predyktory rozmywają współczynniki i czemu ten sam predyktor ma inny współczynnik w każdym modelu.
Dane są fikcyjne: 120 studentów, godziny korepetycji w semestrze (M = 14.08, SD = 6.42), test wstępny na początku semestru (0–50 pkt; M = 29.65, SD = 7.55) i egzamin (0–100 pkt; M = 58.89, SD = 12.29). Korepetycje brały głównie osoby słabsze na starcie: korelacja korepetycji z testem wynosi r = −.74. Do ostatniego rysunku dochodzą motywacja (1–7), liczba oddanych zestawów zadań i czas dojazdu na uczelnię. Parametry modelu, z którego losowano dane, ustawiono ręcznie tak, by zmiana znaku po kontroli testu była wyraźna; ziarna nie zmieniano.
Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis (w pracy rozdziel numer, tytuł i notę „Uwaga.” według APA 7) i zdanie do pracy. Rysunki używają palety Okabe–Ito, a grupy różnią się też kształtem punktu albo rodzajem linii; symulację deuteranopii zawiera przepis 6.
Wykres zmiennej dodanej: co zostaje po „kontroli”
„Kontrolując test” znaczy w regresji coś bardzo konkretnego: z korepetycji i z egzaminu usuwamy tę część, którą da się liniowo przewidzieć z testu, i patrzymy na związek reszt. Takie zestawienie to wykres zmiennej dodanej.
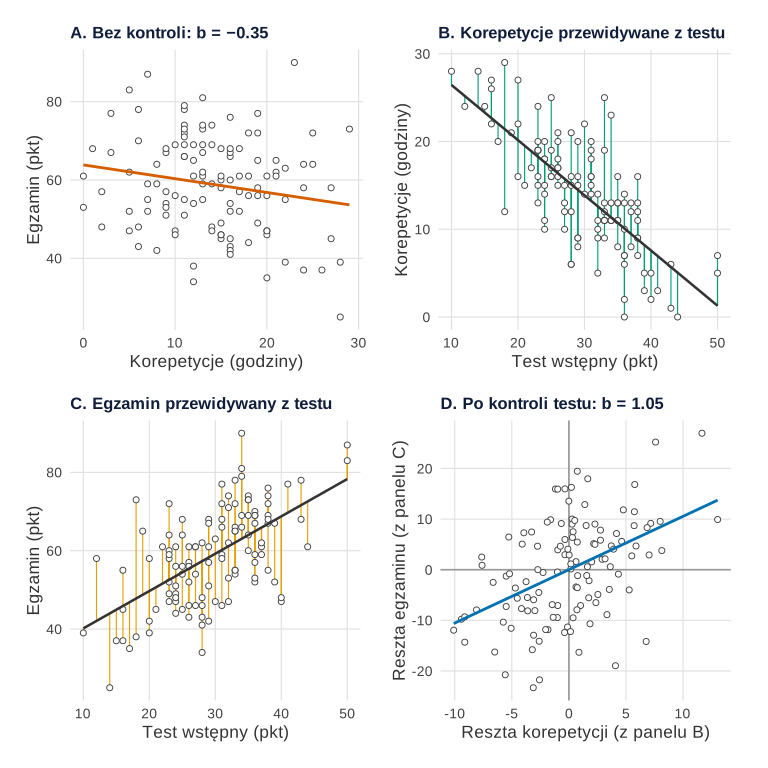
Co widać. Bez kontroli (panel A) prosta opada: b = −0.35, r = −.18 – więcej korepetycji, słabszy egzamin. Panel B pokazuje, ile godzin korepetycji „przewiduje” test; zielony odcinek to reszta – o ile więcej lub mniej godzin wzięła osoba niż inni z tym samym testem. Panel C robi to samo z egzaminem. W panelu D zostają same reszty i prosta rośnie: nachylenie wynosi 1.05 – dokładnie tyle, ile współczynnik korepetycji w modelu egzamin ~ korepetycje + test (95% CI [0.68, 1.43]). To twierdzenie Frischa–Waugha–Lovella; Lovell (1963) uogólnił wcześniejszy wynik Frischa i Waugha. Korelacja punktów w panelu D to korelacja cząstkowa, r = .46. Nawet błąd standardowy się zgadza (0.1897), jeśli uwzględnić, że model wieloraki ma o jeden stopień swobody mniej.
Czego ten wykres nie pokazuje. Kontrola jest liniowa i dotyczy tylko testu – nie motywacji ani cech, których nikt nie zmierzył. Oś pozioma panelu D to godziny ponad lub poniżej tego, co przewiduje test. Cook (1996) ostrzega też, że wykres zmiennej dodanej może poważnie mylić przy ocenie krzywoliniowości i doborze transformacji predyktora, chyba że predyktory są niezależne – kształt sprawdzaj na wykresach reszt. Jak sama prosta powstaje z kwadratów reszt, pokazuje wpis metoda najmniejszych kwadratów w obrazkach.
Podpis do pracy.
Zdanie do Wyników.
Dlaczego znak się odwrócił
Drugi sposób czytania „kontrolując”: porównujemy osoby o podobnym wyniku testu. Panel A dzieli próbę na trzy grupy według testu – tylko do rysunku, bo model używa testu jako zmiennej ciągłej – i rysuje proste z modelu wielorakiego przy średnim teście każdej grupy.
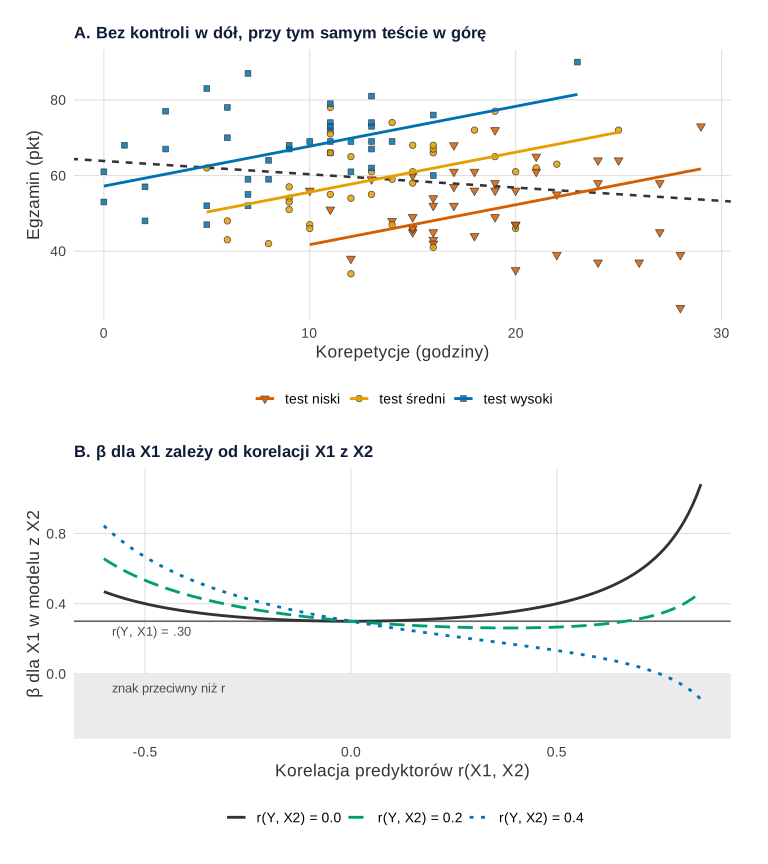
Co widać. Osoby z niskim testem (trójkąty) wzięły średnio 19.2 godziny korepetycji, z wysokim (kwadraty) – 8.9 godziny, i mają wyższe wyniki egzaminu. Przerywana prosta dla wszystkich łączy te dwie chmury i opada. W obrębie każdej grupy prosta rośnie. To ten sam mechanizm, co w paradoksie Simpsona, tylko trzecia zmienna jest ciągła. Panel B pokazuje ogólną regułę dla dwóch predyktorów w skali standaryzowanej. Gdy X1 koreluje z wynikiem na poziomie .30, a predyktory są nieskorelowane, β1 = .30. Przy r(Y, X2) = .4 i r(X1, X2) = .5 współczynnik spada do .133, przy korelacji predyktorów .75 do zera, a powyżej – zmienia znak. Gdy X2 z wynikiem nie koreluje (krzywa ciągła), β1 rośnie: przy korelacji predyktorów .5 wynosi .400. To klasyczna supresja.
Ta sama arytmetyka, różne nazwy. W naszych danych współczynnik po kontroli jest większy co do wartości bezwzględnej i ma przeciwny znak – statystycznie wygląda to jak supresja. Merytorycznie test wstępny jest raczej zmienną zakłócającą: wpływa i na decyzję o korepetycjach, i na egzamin. MacKinnon i in. (2000) pokazali, że mediację, zakłócanie i supresję mierzy się tak samo – zmianą związku po dodaniu trzeciej zmiennej – a różnią się one pojęciowo. Nazwę wybierasz więc na podstawie wiedzy o badaniu, nie liczb.
Czego ten wykres nie pokazuje. Proste w panelu A są równoległe, bo model nie ma interakcji – zakłada jedno nachylenie dla wszystkich poziomów testu. Policzone osobno w grupach nachylenia wyniosły −0.10, 0.92 i 0.94; przy 38–43 osobach w grupie to może być szum. Gdy jednak podejrzewasz różne nachylenia, potrzebujesz interakcji, a nie podziału na tercyle. Panel B to wzór, nie dane: nie mówi, czy X2 należy do modelu.
Podpis do pracy.
Zdanie do Wyników.
Współliniowość: wąska oś wykresu zmiennej dodanej
Skoro współczynnik cząstkowy to nachylenie w panelu D, jego precyzja zależy od tego, ile zmienności predyktora zostaje po usunięciu drugiego. Tu osobna symulacja: ten sam model w populacji (Y = 0.3 × X1 + 0.3 × X2 + błąd, wszystko w skali z), po 80 osób, raz przy korelacji predyktorów .2, raz .9. W próbach korelacje wyniosły .29 i .90.
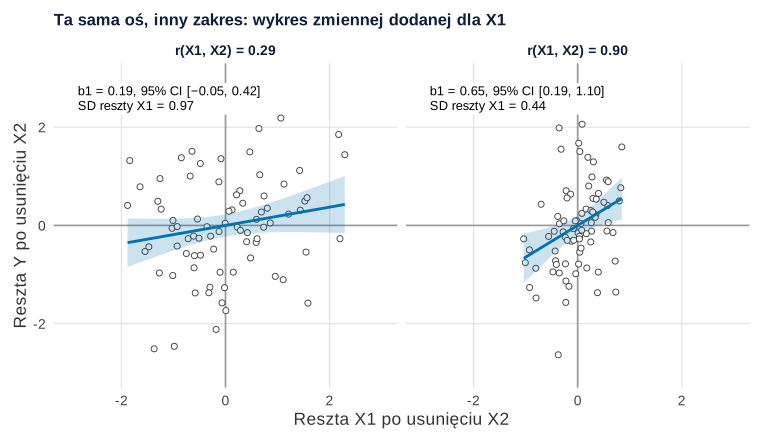
Co widać. Przy korelacji .29 reszta X1 ma odchylenie standardowe 0.97 – prawie cała zmienność X1 zostaje. Przy .90 zostaje 0.44: punkty ściskają się wokół zera, a prostą trzeba oprzeć na wąskim odcinku osi. Pasmo ufności się rozchyla, a VIF rośnie z 1.09 do 5.41. W tej próbie przy r = .90 wyszło b1 = 0.65, 95% CI [0.19, 1.10], p = .006, i b2 = 0.04, p = .849. Model „przypisał” prawie cały efekt X1, choć w populacji oba predyktory działają tak samo.
Czego ten wykres nie pokazuje. Jedna próba nie pokazuje, jak bardzo oszacowania skaczą między próbami – to robi symulacja 2000 prób w haśle współliniowość. Współliniowość nie obciąża współczynnika – odbiera mu precyzję.
Podpis do pracy.
Zdanie do Wyników.
Elipsa ufności: co model wie, a czego nie
Dwa współczynniki szacuje się razem, więc mają wspólny obszar ufności – elipsę. Friendly i in. (2013) pokazują, że geometria elips porządkuje wiele pojęć modelu liniowego; tu wystarczy jedna elipsa na panel. Prostokąt z linii przerywanych to dwa zwykłe 95% przedziały ufności – dla b1 i dla b2 osobno.
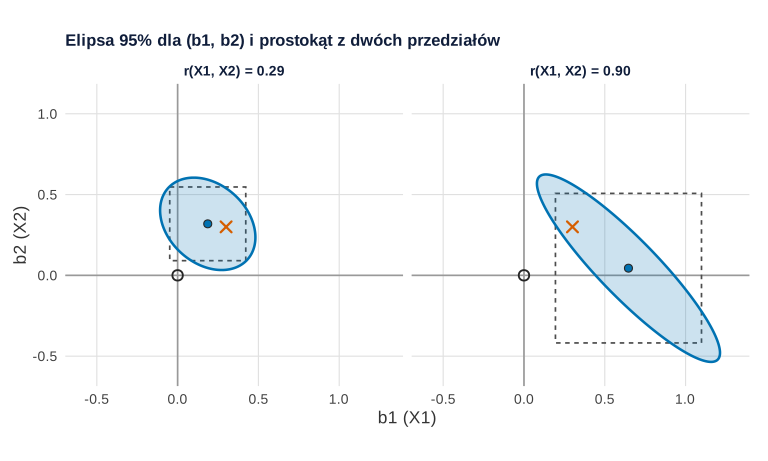
Co widać. Przy r = .90 elipsa jest długa i ukośna: korelacja oszacowań b1 i b2 wynosi −.90. Model nie wie, jak podzielić efekt – większe b1 idzie w parze z mniejszym b2. Wie natomiast, ile wynoszą razem: suma b1 + b2 = 0.69 ma błąd standardowy 0.10, mniejszy niż przy r = .29 (0.51, SE = 0.14). Przedział dla b2 obejmuje zero, ale punkt (0, 0) leży daleko poza elipsą. Elipsa jest zbudowana na rozkładzie F, więc wyklucza (0, 0) dokładnie wtedy, gdy łączny test obu współczynników jest istotny: F(2, 77) = 24.71, p < .001. Przy r = .29 elipsa jest mniejsza i tylko lekko pochylona: F(2, 77) = 7.00, p = .002, choć b1 osobno jest nieistotne (p = .119).
Czego ten wykres nie pokazuje. Elipsa dotyczy jednej próby i nie mówi, który predyktor „naprawdę” działa. Vanhove (2021) przekonuje, że współliniowość nie jest chorobą do leczenia, a popularne sposoby radzenia sobie z nią obciążają oszacowania albo zmieniają pytanie badawcze. Praktyczne opcje omawia wpis wysoki VIF – co zrobić.
Podpis do pracy.
Zdanie do Wyników.
Ten sam predyktor w pięciu modelach
Wracamy do korepetycji i dokładamy zmienne po kolei: test wstępny, motywację, liczbę oddanych zestawów zadań i czas dojazdu. Wszystkie b są w tej samej jednostce (punkty egzaminu na godzinę), więc wolno je zestawić na jednej osi – o tym, kiedy nie wolno, pisze wpis wynik regresji na wykresie.
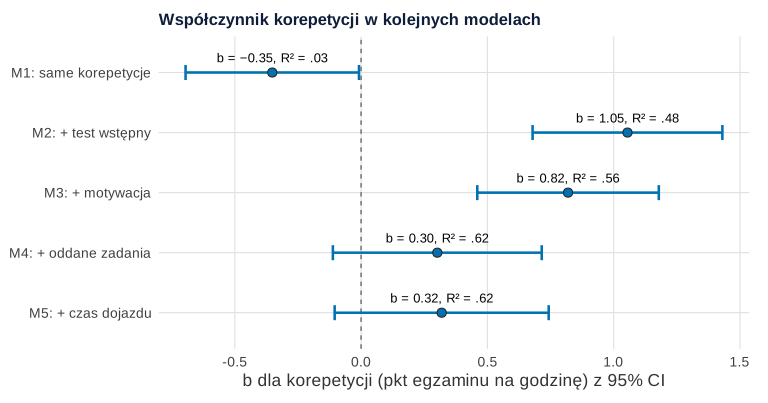
Co widać. Współczynnik korepetycji wynosi −0.35 (M1), 1.05 po dodaniu testu (M2), 0.82 po dodaniu motywacji (M3) i 0.30 po dodaniu oddanych zadań (M4, 95% CI [−0.11, 0.72], p = .151). Czas dojazdu nie koreluje ani z korepetycjami (r = .02), ani z egzaminem (r = −.08), więc prawie nic nie zmienia (M5: 0.32). R² rośnie od .03 do .62, ale to nie mówi, który współczynnik jest „właściwy”.
Który model odpowiada na pytanie? Wiemy to tylko dlatego, że dane są fikcyjne. W modelu, z którego je wylosowano, test i motywacja wpływają na korepetycje i egzamin, a korepetycje działają na egzamin bezpośrednio (0.3 pkt na godzinę) i przez oddane zadania (0.5 zestawu na godzinę × 0.6 pkt na zestaw). Razem to 0.6 pkt na godzinę. Na pytanie „ile daje godzina korepetycji” odpowiada więc M3 – kontroluje zmienne zakłócające i nie rusza drogi przez zadania; jego 95% CI [0.46, 1.18] obejmuje 0.6. M4 kontroluje zmienną pośredniczącą i pokazuje tylko efekt bezpośredni. Spadek do 0.30 nie znaczy, że korepetycje „nie działają” (zob. mediacja w obrazkach). Wysocki i in. (2022) zwracają uwagę, że źle dobrana zmienna kontrolna może zwiększyć obciążenie zamiast je zmniejszyć, i zalecają uzasadniać jej wybór założoną strukturą przyczynową. Jak to zrobić, pokazuje wpis grafy przyczynowe (DAG). Bez takiego uzasadnienia regresja opisuje związki warunkowe, a nie skutki korepetycji.
Czego ten wykres nie pokazuje. Wykres dotyczy jednego predyktora. Współczynniki pozostałych zmiennych z tego samego modelu mają inną interpretację. Na przykład współczynnik testu w M4 nie jest całkowitym efektem testu, bo część jego wpływu idzie przez korepetycje i zadania. Westreich i Greenland (2013) nazywają mylenie tych współczynników błędem tabeli 2: zmienne kontrolne dostają w jednym modelu oszacowania efektów bezpośrednich, a łatwo je wziąć za efekty całkowite.
Podpis do pracy.
Zdanie do Metody.
Ściąga: pięć obrazów „kontrolując”
| Pojęcie | Obraz | Liczba w przykładzie |
|---|---|---|
| współczynnik cząstkowy | nachylenie w wykresie zmiennej dodanej | b = 1.05 (bez kontroli −0.35) |
| korelacja cząstkowa | korelacja punktów w tym wykresie | r = .46 |
| zakłócanie i supresja | proste w grupach rosną, prosta ogólna opada | r(korepetycje, test) = −.74 |
| współliniowość | wąska oś reszt predyktora | SD reszty 0.44 zamiast 0.97 |
| niepewność dwóch b | ukośna elipsa ufności | korelacja oszacowań −.90 |
| wybór zmiennych kontrolnych | wykres współczynnika w kolejnych modelach | od −0.35 do 1.05 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i modele, z których korzystają przepisy 2 i 5, a przepis 4 korzysta z prób z przepisu 3. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu przepisu 1. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Dane z przepisu 1 są też w pliku regresja-wieloraka-dane-korepetycje.csv (kolumny egzamin, korepetycje, test, motywacja, zadania, dojazd). Losują tylko dwa przepisy i każdy ma własne ziarno, ustalone z góry: 581 (przepis 1, dane 120 osób) i 5813 (przepis 3, dwie próby po 80 osób). Parametry ręczne: współczynniki modelu generującego dane w przepisie 1 (dobrane tak, by zmiana znaku była wyraźna), a w przepisie 3 – b1 = b2 = 0.3, n = 80 i korelacje .2 oraz .9. Przepisy nie są symulacjami Monte Carlo – każda liczba pochodzi z jednej wylosowanej próby.
1. Dane, paleta, motyw i wykres zmiennej dodanej: Rysunek 1
R
# Wykres zmiennej dodanej: co znaczy „kontrolując wynik testu wstępnego” (dane symulowane, 120 studentów)
library(ggplot2)
library(patchwork)
# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw) i prosty motyw
okabe <- c(niebieski = "#0072B2", cynober = "#D55E00", zielony = "#009E73", pomarancz = "#E69F00")
theme_set(theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(size = rel(0.95), face = "bold")))
minus <- function(s) gsub("-", "\u2212", s)              # typograficzny minus w etykietach

set.seed(581)                                           # ziarno przepisu 1 (dane 120 osób)
n <- 120
test <- pmin(50, pmax(0, round(rnorm(n, 30, 8))))       # test wstępny, 0–50 pkt
motywacja <- pmin(7, pmax(1, round(rnorm(n, 4, 1), 1))) # motywacja, skala 1–7
korepetycje <- pmax(0, round(14 - 0.6 * (test - 30) + 1.5 * (motywacja - 4) + rnorm(n, 0, 4)))  # godziny w semestrze
zadania <- pmax(0, round(10 + 0.5 * korepetycje + 1.5 * (motywacja - 4) + rnorm(n, 0, 3)))      # oddane zestawy zadań
dojazd <- pmax(5, round(rnorm(n, 35, 15)))              # czas dojazdu na uczelnię, min
egzamin <- pmin(100, pmax(0, round(10 + 1.2 * test + 0.3 * korepetycje + 0.6 * zadania +
                                   2 * (motywacja - 4) + rnorm(n, 0, 8))))   # egzamin, 0–100 pkt
dane <- data.frame(egzamin, korepetycje, test, motywacja, zadania, dojazd)
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane[, c("egzamin", "korepetycje", "test")]), 2)

m_prosty <- lm(egzamin ~ korepetycje, data = dane)          # bez kontroli
m_wiel   <- lm(egzamin ~ korepetycje + test, data = dane)   # „kontrolując wynik testu”
# Dwie regresje pomocnicze: co zostaje z korepetycji i z egzaminu po usunięciu tego, co przewiduje test
dane$r_korep <- residuals(lm(korepetycje ~ test, data = dane))
dane$r_egz   <- residuals(lm(egzamin ~ test, data = dane))
m_av <- lm(r_egz ~ r_korep, data = dane)
round(c(b_prosty = coef(m_prosty)[["korepetycje"]], b_wieloraki = coef(m_wiel)[["korepetycje"]],
        nachylenie_av = coef(m_av)[["r_korep"]], r_proste = cor(dane$egzamin, dane$korepetycje),
        r_czastkowe = cor(dane$r_egz, dane$r_korep)), 3)
# Błąd standardowy: ten sam, z dokładnością do liczby stopni swobody (n − 2 zamiast n − 3)
round(c(SE_wieloraki = coef(summary(m_wiel))["korepetycje", "Std. Error"],
        SE_av = coef(summary(m_av))["r_korep", "Std. Error"],
        SE_av_skorygowany = coef(summary(m_av))["r_korep", "Std. Error"] * sqrt((n - 2) / (n - 3))), 4)
round(confint(m_wiel)["korepetycje", ], 2)

punkty <- geom_point(shape = 21, fill = "white", colour = "grey25", size = 1.8, stroke = 0.5)
pA <- ggplot(dane, aes(korepetycje, egzamin)) + punkty +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = okabe[["cynober"]], linewidth = 1) +
  labs(title = minus(sprintf("A. Bez kontroli: b = %.2f", coef(m_prosty)[["korepetycje"]])),
       x = "Korepetycje (godziny)", y = "Egzamin (pkt)")
pB <- ggplot(dane, aes(test, korepetycje)) +
  geom_segment(aes(xend = test, yend = korepetycje - r_korep), colour = okabe[["zielony"]], linewidth = 0.4) +
  punkty + geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "grey20", linewidth = 0.9) +
  labs(title = "B. Korepetycje przewidywane z testu", x = "Test wstępny (pkt)", y = "Korepetycje (godziny)")
pC <- ggplot(dane, aes(test, egzamin)) +
  geom_segment(aes(xend = test, yend = egzamin - r_egz), colour = okabe[["pomarancz"]], linewidth = 0.4) +
  punkty + geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "grey20", linewidth = 0.9) +
  labs(title = "C. Egzamin przewidywany z testu", x = "Test wstępny (pkt)", y = "Egzamin (pkt)")
pD <- ggplot(dane, aes(r_korep, r_egz)) +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  punkty + geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = okabe[["niebieski"]], linewidth = 1) +
  labs(title = minus(sprintf("D. Po kontroli testu: b = %.2f", coef(m_av)[["r_korep"]])),
       x = "Reszta korepetycji (z panelu B)", y = "Reszta egzaminu (z panelu C)")

p1 <- (pA + pB) / (pC + pD)
p1
# ggsave("regresja-wieloraka-wykres-zmiennej-dodanej.svg", p1, width = 8, height = 8)   # zapis (pakiet svglite)
Wynik w R
   egzamin korepetycje  test motywacja zadania dojazd
M    58.89       14.08 29.65      3.96   16.59  35.98
SD   12.29        6.42  7.55      0.95    5.04  15.22
            egzamin korepetycje  test
egzamin        1.00       -0.18  0.59
korepetycje   -0.18        1.00 -0.74
test           0.59       -0.74  1.00
     b_prosty   b_wieloraki nachylenie_av      r_proste   r_czastkowe
       -0.352         1.055         1.055        -0.184         0.457
     SE_wieloraki             SE_av SE_av_skorygowany
           0.1897            0.1889            0.1897
 2.5 % 97.5 %
  0.68   1.43
2. Grupy testu i wzór na β: Rysunek 2
R
# Zmiana znaku po dodaniu zmiennej: porównanie osób o podobnym teście i wzór na β z dwóch predyktorów (wymaga przepisu 1)
# A. Trzy grupy według testu wstępnego (tercyle) – tylko do rysunku; model używa testu jako zmiennej ciągłej
dane$grupa_testu <- cut(dane$test, quantile(dane$test, c(0, 1/3, 2/3, 1)), include.lowest = TRUE,
                        labels = c("test niski", "test średni", "test wysoki"))
srodki <- aggregate(cbind(test, korepetycje) ~ grupa_testu, data = dane, FUN = mean)
b <- coef(m_wiel)
# Proste z modelu wielorakiego przy średnim teście w każdej grupie: ta sama wartość nachylenia,
# narysowane tylko w zakresie korepetycji obserwowanym w danej grupie
srodki$b0 <- b[["(Intercept)"]] + b[["test"]] * srodki$test
srodki$nachylenie <- b[["korepetycje"]]
zakres <- aggregate(korepetycje ~ grupa_testu, data = dane, FUN = range)
srodki$od <- zakres$korepetycje[, 1]; srodki$do <- zakres$korepetycje[, 2]
print(transform(srodki, n = as.vector(table(dane$grupa_testu))), digits = 3, row.names = FALSE)
# Nachylenie w każdej grupie osobno (dla porównania z jednym nachyleniem modelu)
round(sapply(split(dane, dane$grupa_testu), function(d) coef(lm(egzamin ~ korepetycje, data = d))[[2]]), 2)

ksztalty <- c("test niski" = 25, "test średni" = 21, "test wysoki" = 22)
kolory_grup <- c("test niski" = okabe[["cynober"]], "test średni" = okabe[["pomarancz"]],
                 "test wysoki" = okabe[["niebieski"]])
pA <- ggplot(dane, aes(korepetycje, egzamin)) +
  geom_abline(intercept = coef(m_prosty)[[1]], slope = coef(m_prosty)[[2]],
              colour = "grey20", linewidth = 0.9, linetype = "22") +
  geom_point(aes(shape = grupa_testu, fill = grupa_testu), colour = "grey20", size = 2, stroke = 0.4, alpha = 0.85) +
  geom_segment(data = srodki, aes(x = od, xend = do, y = b0 + nachylenie * od, yend = b0 + nachylenie * do,
                                   colour = grupa_testu), linewidth = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) + scale_fill_manual(values = kolory_grup, name = NULL) +
  scale_colour_manual(values = kolory_grup, name = NULL) +
  guides(shape = guide_legend(nrow = 1)) +
  labs(title = "A. Bez kontroli w dół, przy tym samym teście w górę",
       x = "Korepetycje (godziny)", y = "Egzamin (pkt)")

# B. Współczynnik standaryzowany β1 w modelu z dwoma predyktorami jako funkcja korelacji predyktorów r12
beta1 <- function(rY1, rY2, r12) (rY1 - rY2 * r12) / (1 - r12^2)
dopuszczalne <- function(rY1, rY2, r12) 1 - rY1^2 - rY2^2 - r12^2 + 2 * rY1 * rY2 * r12 > 0  # macierz korelacji poprawna
siatka <- expand.grid(r12 = seq(-0.6, 0.85, by = 0.01), rY2 = c(0, 0.2, 0.4))
siatka <- siatka[dopuszczalne(0.3, siatka$rY2, siatka$r12), ]
siatka$beta1 <- beta1(0.3, siatka$rY2, siatka$r12)
siatka$rY2 <- factor(sprintf("r(Y, X2) = %.1f", siatka$rY2))
# Kilka punktów do odczytu: X1 koreluje z Y na poziomie .30
odczyt <- expand.grid(rY2 = c(0, 0.2, 0.4), r12 = c(-0.4, 0, 0.5, 0.75))
odczyt$beta1 <- round(beta1(0.3, odczyt$rY2, odczyt$r12), 3)
print(reshape(odczyt, idvar = "rY2", timevar = "r12", direction = "wide"), row.names = FALSE)

pB <- ggplot(siatka, aes(r12, beta1, linetype = rY2, colour = rY2)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = -Inf, ymax = 0, fill = "grey92") +
  geom_hline(yintercept = 0.3, colour = "grey40") +
  annotate("text", x = -0.58, y = 0.27, label = "r(Y, X1) = .30", hjust = 0, vjust = 1, size = 3.4, colour = "grey30") +
  annotate("text", x = -0.58, y = -0.08, label = "znak przeciwny niż r", hjust = 0, size = 3.4, colour = "grey30") +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = c("grey20", okabe[["zielony"]], okabe[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "42", "12"), name = NULL) +
  coord_cartesian(ylim = c(-0.3, 1.1)) +
  labs(title = "B. β dla X1 zależy od korelacji X1 z X2",
       x = "Korelacja predyktorów r(X1, X2)", y = "β dla X1 w modelu z X2")

p2 <- pA / pB
p2
Wynik w R
 grupa_testu test korepetycje   b0 nachylenie od do  n
  test niski 21.7        19.2 31.2       1.05 10 29 43
 test średni 30.3        13.6 45.1       1.05  5 25 38
 test wysoki 37.8         8.9 57.2       1.05  0 23 39
 test niski test średni test wysoki
      -0.10        0.92        0.94
 rY2 beta1.-0.4 beta1.0 beta1.0.5 beta1.0.75
 0.0      0.357     0.3     0.400      0.686
 0.2      0.452     0.3     0.267      0.343
 0.4      0.548     0.3     0.133      0.000
3. Dwie próby o różnej korelacji predyktorów: Rysunek 3
R
# Współliniowość na wykresie zmiennej dodanej: ten sam model, korelacja predyktorów .2 albo .9 (wymaga przepisu 1)
set.seed(5813)                                          # własne ziarno przepisu 3
N <- 80
proba <- function(rho) {                                # X1, X2 w skali z; w populacji b1 = b2 = 0.3
  x1 <- rnorm(N)
  x2 <- rho * x1 + sqrt(1 - rho^2) * rnorm(N)
  data.frame(rho = rho, x1, x2, y = 0.3 * x1 + 0.3 * x2 + rnorm(N))
}
proby <- list(niska = proba(0.2), wysoka = proba(0.9))
modele <- lapply(proby, function(d) lm(y ~ x1 + x2, data = d))
podsumowanie <- t(sapply(names(proby), function(k) {
  d <- proby[[k]]; m <- modele[[k]]; ci <- confint(m)
  r_x1 <- residuals(lm(x1 ~ x2, data = d))
  f <- summary(m)$fstatistic
  c(r12 = cor(d$x1, d$x2), b1 = coef(m)[["x1"]], b1_dolna = ci["x1", 1], b1_gorna = ci["x1", 2],
    b2 = coef(m)[["x2"]], b2_dolna = ci["x2", 1], b2_gorna = ci["x2", 2],
    SD_reszty_x1 = sd(r_x1), VIF = 1 / (1 - summary(lm(x1 ~ x2, data = d))$r.squared),
    p_b1 = coef(summary(m))["x1", 4], p_b2 = coef(summary(m))["x2", 4],
    F = f[["value"]], p_F = pf(f[["value"]], f[["numdf"]], f[["dendf"]], lower.tail = FALSE),
    R2 = summary(m)$r.squared)
}))
round(podsumowanie, 3)

av <- do.call(rbind, lapply(names(proby), function(k) {
  d <- proby[[k]]
  data.frame(proba = sprintf("r(X1, X2) = %.2f", cor(d$x1, d$x2)),
             r_x1 = residuals(lm(x1 ~ x2, data = d)), r_y = residuals(lm(y ~ x2, data = d)))
}))
etykiety <- data.frame(proba = unique(av$proba),
                       opis = minus(sprintf("b1 = %.2f, 95%% CI [%.2f, %.2f]\nSD reszty X1 = %.2f",
                                      podsumowanie[, "b1"], podsumowanie[, "b1_dolna"],
                                      podsumowanie[, "b1_gorna"], podsumowanie[, "SD_reszty_x1"])))
p3 <- ggplot(av, aes(r_x1, r_y)) +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  geom_point(shape = 21, fill = "white", colour = "grey25", size = 1.8, stroke = 0.5) +
  geom_smooth(method = "lm", formula = y ~ x, colour = okabe[["niebieski"]], fill = okabe[["niebieski"]],
              alpha = 0.2, linewidth = 1) +
  geom_label(data = etykiety, aes(x = -2.9, y = 2.9, label = opis), hjust = 0, vjust = 1, size = 3.4,
             lineheight = 0.95, fill = "white", linewidth = 0) +
  facet_wrap(~ proba) +
  coord_cartesian(xlim = c(-3, 3), ylim = c(-3, 3)) +
  labs(title = "Ta sama oś, inny zakres: wykres zmiennej dodanej dla X1",
       x = "Reszta X1 po usunięciu X2", y = "Reszta Y po usunięciu X2")
p3
Wynik w R
         r12    b1 b1_dolna b1_gorna    b2 b2_dolna b2_gorna SD_reszty_x1   VIF
niska  0.293 0.186   -0.049    0.422 0.319    0.091    0.547        0.974 1.094
wysoka 0.903 0.647    0.195    1.098 0.044   -0.418    0.507        0.440 5.410
        p_b1  p_b2      F   p_F    R2
niska  0.119 0.007  7.004 0.002 0.154
wysoka 0.006 0.849 24.711 0.000 0.391
4. Elipsa ufności dla pary współczynników: Rysunek 4
R
# Elipsa ufności dla pary (b1, b2) i pojedyncze przedziały: modele z przepisu 3 (wymaga przepisów 1 i 3)
elipsa <- function(m, poziom = 0.95, k = 200) {
  V <- vcov(m)[c("x1", "x2"), c("x1", "x2")]
  srodek <- coef(m)[c("x1", "x2")]
  promien <- sqrt(2 * qf(poziom, 2, df.residual(m)))   # wspólny obszar dla dwóch współczynników
  kat <- seq(0, 2 * pi, length.out = k)
  okrag <- cbind(cos(kat), sin(kat))
  pkt <- t(srodek + promien * t(chol(V)) %*% t(okrag))
  data.frame(b1 = pkt[, 1], b2 = pkt[, 2])
}
elipsy <- do.call(rbind, lapply(names(modele), function(k)
  data.frame(proba = sprintf("r(X1, X2) = %.2f", podsumowanie[k, "r12"]), elipsa(modele[[k]]))))
przedzialy <- data.frame(proba = sprintf("r(X1, X2) = %.2f", podsumowanie[, "r12"]),
                         as.data.frame(podsumowanie[, c("b1", "b1_dolna", "b1_gorna", "b2", "b2_dolna", "b2_gorna")]))
# Korelacja oszacowań b1 i b2 (z macierzy kowariancji współczynników) i czy (0, 0) leży w elipsie
round(t(sapply(modele, function(m) {
  V <- vcov(m)[c("x1", "x2"), c("x1", "x2")]
  b <- coef(m)[c("x1", "x2")]
  c(kor_b1_b2 = cov2cor(V)[1, 2],
    zero_w_elipsie = as.numeric(t(b) %*% solve(V) %*% b <= 2 * qf(0.95, 2, df.residual(m))),
    suma_b = sum(b), SE_sumy = sqrt(sum(V)))
})), 3)

p4 <- ggplot() +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  geom_rect(data = przedzialy, aes(xmin = b1_dolna, xmax = b1_gorna, ymin = b2_dolna, ymax = b2_gorna),
            fill = NA, colour = "grey30", linetype = "22", linewidth = 0.6) +
  geom_polygon(data = elipsy, aes(b1, b2), fill = okabe[["niebieski"]], alpha = 0.2,
               colour = okabe[["niebieski"]], linewidth = 0.9) +
  geom_point(data = przedzialy, aes(b1, b2), shape = 21, fill = okabe[["niebieski"]], colour = "grey15", size = 2.4) +
  annotate("point", x = 0.3, y = 0.3, shape = 4, size = 3, stroke = 1.2, colour = okabe[["cynober"]]) +
  annotate("point", x = 0, y = 0, shape = 1, size = 3, stroke = 1, colour = "grey15") +
  facet_wrap(~ proba) +
  coord_equal(xlim = c(-0.6, 1.3), ylim = c(-0.6, 1.1)) +
  labs(title = "Elipsa 95% dla (b1, b2) i prostokąt z dwóch przedziałów",
       x = "b1 (X1)", y = "b2 (X2)")
p4
Wynik w R
       kor_b1_b2 zero_w_elipsie suma_b SE_sumy
niska     -0.293              0  0.505   0.138
wysoka    -0.903              0  0.691   0.101
5. Pięć modeli z rosnącą liczbą zmiennych: Rysunek 5
R
# Współczynnik korepetycji w pięciu modelach z rosnącą liczbą zmiennych (wymaga przepisu 1)
wzory <- list(
  "M1: same korepetycje"  = egzamin ~ korepetycje,
  "M2: + test wstępny"    = egzamin ~ korepetycje + test,
  "M3: + motywacja"       = egzamin ~ korepetycje + test + motywacja,
  "M4: + oddane zadania"  = egzamin ~ korepetycje + test + motywacja + zadania,
  "M5: + czas dojazdu"    = egzamin ~ korepetycje + test + motywacja + zadania + dojazd)
kolejne <- do.call(rbind, lapply(names(wzory), function(nazwa) {
  m <- lm(wzory[[nazwa]], data = dane)
  ci <- confint(m)["korepetycje", ]
  data.frame(model = nazwa, b = coef(m)[["korepetycje"]], dolna = ci[[1]], gorna = ci[[2]],
             p = coef(summary(m))["korepetycje", 4], R2 = summary(m)$r.squared)
}))
kolejne$model <- factor(kolejne$model, levels = rev(names(wzory)))
print(kolejne, digits = 3, row.names = FALSE)
# Korelacje zmiennych dodawanych w M3–M5 z korepetycjami i egzaminem
round(cor(dane[, c("motywacja", "zadania", "dojazd")], dane[, c("korepetycje", "egzamin")]), 2)

p5 <- ggplot(kolejne, aes(b, model)) +
  geom_vline(xintercept = 0, colour = "grey50", linetype = "22") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", colour = okabe[["niebieski"]], linewidth = 0.9) +
  geom_point(shape = 21, fill = okabe[["niebieski"]], colour = "grey15", size = 2.8) +
  geom_text(aes(label = minus(sprintf("b = %.2f, R² = %s", b, sub("^0", "", sprintf("%.2f", R2))))),
            vjust = -1.1, size = 3.4) +
  scale_x_continuous(breaks = seq(-0.5, 1.5, by = 0.5)) +
  labs(title = "Współczynnik korepetycji w kolejnych modelach",
       x = "b dla korepetycji (pkt egzaminu na godzinę) z 95% CI", y = NULL)
p5
Wynik w R
                model      b  dolna    gorna        p     R2
 M1: same korepetycje -0.352 -0.695 -0.00844 4.47e-02 0.0337
   M2: + test wstępny  1.055  0.679  1.43018 1.73e-07 0.4802
      M3: + motywacja  0.819  0.460  1.17847 1.52e-05 0.5641
 M4: + oddane zadania  0.302 -0.112  0.71507 1.51e-01 0.6232
   M5: + czas dojazdu  0.319 -0.105  0.74260 1.39e-01 0.6237
          korepetycje egzamin
motywacja        0.18    0.39
zadania          0.74    0.13
dojazd           0.02   -0.08
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy kolory wykresów przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – pomarańcz (test niski i średni)" = c("#D55E00", "#E69F00"),
             "pomarańcz – niebieski (test średni i wysoki)" = c("#E69F00", "#0072B2"),
             "cynober – niebieski (bez kontroli i po kontroli)" = c("#D55E00", "#0072B2"),
             "zielony – niebieski (linie w panelu 2B)" = c("#009E73", "#0072B2"),
             "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                 widzenie_typowe deuteranopia
cynober – pomarańcz (test niski i średni)                   33.4         18.4
pomarańcz – niebieski (test średni i wysoki)               120.2        121.5
cynober – niebieski (bez kontroli i po kontroli)           114.6        108.3
zielony – niebieski (linie w panelu 2B)                     70.1         55.4
czerwony – zielony (dla porównania)                        121.7         21.1
                                                 protanopia
cynober – pomarańcz (test niski i średni)              24.9
pomarańcz – niebieski (test średni i wysoki)          109.3
cynober – niebieski (bez kontroli i po kontroli)       91.9
zielony – niebieski (linie w panelu 2B)                58.0
czerwony – zielony (dla porównania)                    31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele: funkcja lm() z pakietu stats); rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Kontrolując X” jako „X nie ma znaczenia”. Kontrola jest tylko liniowa i dotyczy tylko zmiennych w modelu; niezmierzone zmienne zakłócające zostają.
- Wnioski z korelacji, gdy predyktory są skorelowane. Korepetycje korelowały z egzaminem ujemnie, a przy tym samym teście związek był dodatni.
- Uznanie predyktora za nieważny, bo jego b jest nieistotne przy wysokim VIF. Sprawdź łączny test i elipsę – razem predyktory mogą wyjaśniać wiele.
- Dokładanie zmiennych, aż wynik będzie istotny. Współczynnik zmieniał się od −0.35 do 1.05 zależnie od zestawu – wybór zestawu musi poprzedzać analizę.
- Kontrolowanie zmiennej pośredniczącej. Wtedy zostaje tylko efekt bezpośredni (tu 0.30 zamiast 0.82).
- Interpretowanie wszystkich współczynników z jednej tabeli jak efektów całkowitych. Współczynnik zmiennej kontrolnej odpowiada na inne pytanie niż współczynnik predyktora głównego.
Najczęstsze pytania
Co znaczy „kontrolując” w regresji wielorakiej?
Że współczynnik predyktora opisuje związek z wynikiem przy stałych wartościach pozostałych predyktorów. Technicznie to nachylenie zależności reszt wyniku od reszt predyktora, gdy z obu usunięto to, co liniowo przewidują pozostałe zmienne (wykres zmiennej dodanej). Kontrola dotyczy tylko zmiennych w modelu i tylko ich liniowej części.
Dlaczego współczynnik regresji zmienił znak po dodaniu zmiennej?
Bo nowa zmienna jest skorelowana zarówno z predyktorem, jak i z wynikiem. W przykładzie korepetycje brały głównie osoby z niskim testem wstępnym (r = −.74), więc bez kontroli testu związek korepetycji z egzaminem był ujemny (b = −0.35), a przy tym samym teście – dodatni (b = 1.05). Czy nazwać to zakłócaniem, czy supresją, zależy od wiedzy o badaniu, nie od liczb.
Jak narysować wykres zmiennej dodanej w R?
Policz reszty z dwóch regresji pomocniczych: wyniku na pozostałe predyktory i badanego predyktora na te same predyktory, a potem narysuj jedne względem drugich z prostą lm. Nachylenie tej prostej równa się współczynnikowi z modelu wielorakiego, a korelacja punktów – korelacji cząstkowej. Kod jest w przepisie 1 na tej stronie.
Co pokazuje elipsa ufności dla dwóch współczynników?
Wspólny obszar wartości (b1, b2) zgodnych z danymi. Przy silnie skorelowanych predyktorach jest długa i ukośna: pojedyncze przedziały mogą obejmować zero, a mimo to punkt (0, 0) leży poza elipsą, czyli łączny test F jest istotny. W przykładzie przy r = .90 dało to F(2, 77) = 24.71, p < .001, przy b2 nieistotnym.
Ile zmiennych kontrolnych dodać do regresji?
Tyle, ile wynika z założonego modelu przyczynowego, a nie tyle, ile podnosi R² albo daje istotny wynik. Kontroluj zmienne zakłócające, a nie zmienne pośredniczące ani skutki wyniku. W przykładzie dodanie zmiennej pośredniczącej zmniejszyło współczynnik korepetycji z 0.82 do 0.30, choć korepetycje w modelu generującym dane działały.
Powiązane hasła
Przeczytaj też
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikMetoda najmniejszych kwadratów w obrazkach
Reszty jako kwadraty, parabola sumy kwadratów, regresja y na x i x na y, oś główna, dźwignia i R² – skąd się bierze prosta regresji, na rysunkach z R.
Czytaj →Nie wiesz, które zmienne kontrolować w regresji?
Pomożemy dobrać zmienne kontrolne, sprawdzić współliniowość i opisać wyniki regresji wielorakiej z przedziałami ufności – tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cook, R. D. (1996). Added-variable plots and curvature in linear regression. Technometrics, 38(3), 275–278. https://doi.org/10.1080/00401706.1996.10484507
- Friendly, M., Monette, G., & Fox, J. (2013). Elliptical insights: Understanding statistical methods through elliptical geometry. Statistical Science, 28(1), 1–39. https://doi.org/10.1214/12-sts402 ● Otwarty dostęp: pełny tekst
- Lovell, M. C. (1963). Seasonal adjustment of economic time series and multiple regression analysis. Journal of the American Statistical Association, 58(304), 993–1010. https://doi.org/10.1080/01621459.1963.10480682
- MacKinnon, D. P., Krull, J. L., & Lockwood, C. M. (2000). Equivalence of the mediation, confounding and suppression effect. Prevention Science, 1(4), 173–181. https://doi.org/10.1023/a:1026595011371 ● Otwarty dostęp: pełny tekst
- Vanhove, J. (2021). Collinearity isn’t a disease that needs curing. Meta-Psychology, 5. https://doi.org/10.15626/mp.2021.2548 ● Otwarty dostęp
- Westreich, D., & Greenland, S. (2013). The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients. American Journal of Epidemiology, 177(4), 292–298. https://doi.org/10.1093/aje/kws412 ● Otwarty dostęp
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{cook1996addedvariable, author={Cook, R. Dennis}, title={{Added-variable plots and curvature in linear regression}}, journal={Technometrics}, year={1996}, volume={38}, number={3}, pages={275--278}, doi={10.1080/00401706.1996.10484507}}@article{friendly2013elliptical, author={Friendly, Michael and Monette, Georges and Fox, John}, title={{Elliptical insights: Understanding statistical methods through elliptical geometry}}, journal={Statistical Science}, year={2013}, volume={28}, number={1}, pages={1--39}, doi={10.1214/12-sts402}}@article{lovell1963seasonal, author={Lovell, Michael C.}, title={{Seasonal adjustment of economic time series and multiple regression analysis}}, journal={Journal of the American Statistical Association}, year={1963}, volume={58}, number={304}, pages={993--1010}, doi={10.1080/01621459.1963.10480682}}@article{mackinnon2000equivalence, author={MacKinnon, David P. and Krull, Jennifer L. and Lockwood, Chondra M.}, title={{Equivalence of the mediation, confounding and suppression effect}}, journal={Prevention Science}, year={2000}, volume={1}, number={4}, pages={173--181}, doi={10.1023/a:1026595011371}}@article{vanhove2021collinearity, author={Vanhove, Jan}, title={{Collinearity isn’t a disease that needs curing}}, journal={Meta-Psychology}, year={2021}, volume={5}, doi={10.15626/mp.2021.2548}}@article{westreich2013table, author={Westreich, Daniel and Greenland, Sander}, title={{The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients}}, journal={American Journal of Epidemiology}, year={2013}, volume={177}, number={4}, pages={292--298}, doi={10.1093/aje/kws412}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}