Co to jest wykres zmiennej dodanej?
Wykres zmiennej dodanej (ang. added-variable plot, nazywany też partial regression plot) pokazuje związek wyniku z jednym predyktorem w regresji wielorakiej po usunięciu z obu zmiennych wpływu pozostałych predyktorów. Na osi pionowej leżą reszty z regresji wyniku na pozostałe predyktory, a na poziomej – reszty z regresji badanego predyktora na te same zmienne. Velleman i Welsch (1981) zwracają uwagę, że w literaturze o diagnostyce regresji podobne wykresy i statystyki występują pod różnymi nazwami, więc w pracy warto podać, jak wykres zbudowano.
Jak czytać wykres
- Nachylenie prostej dopasowanej do punktów jest równe współczynnikowi b z modelu wielorakiego. To wynik znany jako twierdzenie Frischa–Waugha–Lovella; Lovell (1963) uogólnił wcześniejsze twierdzenie Frischa i Waugha.
- Korelacja punktów to korelacja cząstkowa wyniku i predyktora.
- Punkty daleko na osi poziomej mają dużą dźwignię dla tego współczynnika. Jeśli jeden punkt wyraźnie „ciągnie” prostą, sprawdź odległość Cooka.
- Wąski zakres osi poziomej oznacza, że predyktor jest w dużej części przewidywalny z pozostałych – to obraz współliniowości.
Przykład
W symulowanych danych 200 osób stres był skorelowany ze wsparciem społecznym. Zwykły wykres rozrzutu satysfakcji względem stresu pokazuje związek dodatni: b = 0.170, r = .15. Po uwzględnieniu wsparcia znak się odwraca: w modelu wielorakim b = −0.154, a nachylenie wykresu zmiennej dodanej wynosi dokładnie tyle samo. Korelacja cząstkowa to −.12. Wykres pokazuje, co znaczy „przy kontroli wsparcia” – więcej o takim czytaniu modelu we wpisie Regresja wieloraka krok po kroku.
Na rysunku
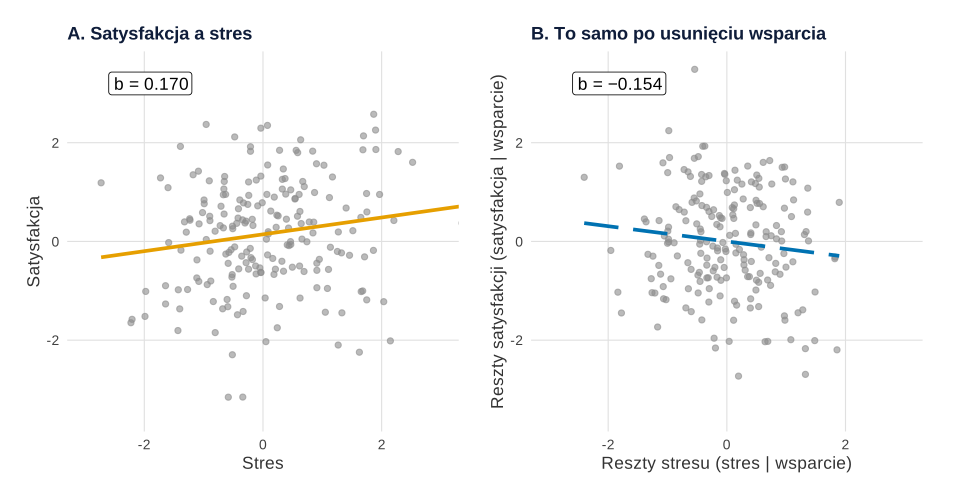
set.seed(598)).Co widać. Panel A to surowy związek: prosta rośnie, b = 0.170. Panel B pokazuje te same 200 osób po „oczyszczeniu” obu zmiennych ze wsparcia społecznego. Prosta opada, a jej nachylenie, −0.154, jest identyczne ze współczynnikiem stresu w modelu wielorakim. Oba panele mają te same zakresy osi, więc widać też drugą rzecz: chmura w panelu B jest węższa w poziomie. Stres korelował ze wsparciem (r = .62), więc po usunięciu wsparcia zostało mniej jego zmienności (SD 0.81 zamiast 1.03). To właśnie zmienność, na której model opiera współczynnik.
Na co uważać. Na osiach panelu B są reszty, a nie wyniki osób – nie podpisuj ich jako „stres” i „satysfakcja”. Wykres nie pokazuje, czy wsparcie powinno być w modelu. To decyzja merytoryczna (zakłócacz czy mediator), a nie statystyczna. Do oceny krzywoliniowości ten wykres się nie nadaje, gdy predyktory są skorelowane (Cook, 1996). Pełną sekwencję – od surowego związku przez dwie regresje pomocnicze do wykresu zmiennej dodanej – oraz obraz współliniowości pokazuje wpis regresja wieloraka w obrazkach.
Podpis do pracy:
Kod rysunku korzysta z tych samych danych co przykład (ziarno 598, niezmieniane; współczynniki symulacji ustawiono ręcznie tak, by znak związku odwrócił się po kontroli wsparcia). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Zwykły wykres rozrzutu (A) i wykres zmiennej dodanej (B) – te same dane co w przykładzie
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(prosta = "#E69F00", wieloraka = "#0072B2")   # Okabe–Ito; linie różnią się też rodzajem
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
set.seed(598)                                      # 200 osób, dwa skorelowane predyktory
n <- 200
wsparcie <- rnorm(n)
stres <- 0.6 * wsparcie + rnorm(n, sd = 0.8)       # stres częściowo wynika ze wsparcia
satysf <- 0.5 * wsparcie - 0.3 * stres + rnorm(n)
e_y <- resid(lm(satysf ~ wsparcie))                # satysfakcja „oczyszczona” ze wsparcia
e_x <- resid(lm(stres ~ wsparcie))                 # stres „oczyszczony” ze wsparcia
b_prosta <- coef(lm(satysf ~ stres))[["stres"]]
b_wykres <- coef(lm(e_y ~ e_x))[["e_x"]]
b_wieloraka <- coef(lm(satysf ~ stres + wsparcie))[["stres"]]
d <- data.frame(stres, satysf, e_x, e_y)
pA <- ggplot(d, aes(stres, satysf)) + geom_point(colour = "grey55", alpha = 0.6) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["prosta"]], linewidth = 1.3) +
  annotate("label", x = -2.6, y = 3.2, hjust = 0, label = sub("-", "\u2212", sprintf("b = %.3f", b_prosta))) +
  coord_cartesian(xlim = c(-3, 3), ylim = c(-3.5, 3.5)) +
  labs(title = "A. Satysfakcja a stres", x = "Stres", y = "Satysfakcja")
pB <- ggplot(d, aes(e_x, e_y)) + geom_point(colour = "grey55", alpha = 0.6) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["wieloraka"]], linewidth = 1.3,
              linetype = "longdash") +
  annotate("label", x = -2.6, y = 3.2, hjust = 0, label = sub("-", "\u2212", sprintf("b = %.3f", b_wykres))) +
  coord_cartesian(xlim = c(-3, 3), ylim = c(-3.5, 3.5)) +
  labs(title = "B. To samo po usunięciu wsparcia", x = "Reszty stresu (stres | wsparcie)",
       y = "Reszty satysfakcji (satysfakcja | wsparcie)")
p1 <- (pA + pB) & motyw
round(c(b_prosta = b_prosta, b_wykres = b_wykres, b_wieloraka = b_wieloraka), 3)
round(c(SD_stres = sd(stres), SD_reszt_stresu = sd(e_x), r_stres_wsparcie = cor(stres, wsparcie)), 2)
p1
Wynik w R
   b_prosta    b_wykres b_wieloraka
      0.170      -0.154      -0.154
        SD_stres  SD_reszt_stresu r_stres_wsparcie
            1.03             0.81             0.62
Jak opisać w pracy
Na co uważać
Cook (1996) ostrzega, że wykres zmiennej dodanej może poważnie mylić, gdy na jego podstawie ocenia się krzywoliniowość i dobiera transformację predyktora, chyba że predyktory są niezależne. Wykres dobrze pokazuje nachylenie i obserwacje wpływowe, ale nie zastępuje sprawdzenia kształtu zależności w modelu. Nie dowodzi też przyczynowości – „kontrola” dotyczy tylko zmiennych, które są w modelu.
Wykres zmiennej dodanej w R
Kod liczy reszty z dwóch regresji pomocniczych i pokazuje, że nachylenie ich zależności równa się współczynnikowi z modelu wielorakiego, a ich korelacja – korelacji cząstkowej. Gotowe wykresy dla wszystkich predyktorów rysuje funkcja avPlots() z pakietu car (wywołanie pokazano jako komentarz, bo rysuje grafikę, a nie zwraca liczb).
Nachylenie wykresu a współczynnik regresji wielorakiej
R
set.seed(598)                                      # 200 osób, dwa skorelowane predyktory
n <- 200
wsparcie <- rnorm(n)
stres <- 0.6 * wsparcie + rnorm(n, sd = 0.8)       # stres częściowo wynika ze wsparcia
satysf <- 0.5 * wsparcie - 0.3 * stres + rnorm(n)
m <- lm(satysf ~ stres + wsparcie)
e_y <- resid(lm(satysf ~ wsparcie))                # oś pionowa: satysfakcja „oczyszczona” ze wsparcia
e_x <- resid(lm(stres ~ wsparcie))                 # oś pozioma: stres „oczyszczony” ze wsparcia
round(c(b_wieloraka = coef(m)[["stres"]],
        b_wykres = coef(lm(e_y ~ e_x))[["e_x"]],
        b_prosta = coef(lm(satysf ~ stres))[["stres"]]), 3)
round(c(r_czastkowa = cor(e_y, e_x), r_prosta = cor(satysf, stres)), 2)
# car::avPlots(m)                                  # gotowe wykresy dla wszystkich predyktorów
Wynik w R
b_wieloraka    b_wykres    b_prosta
     -0.154      -0.154       0.170
r_czastkowa    r_prosta
      -0.12        0.15
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe lm(), resid(), cor(); rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego nachylenie wykresu zmiennej dodanej równa się współczynnikowi z regresji wielorakiej?
Tak działa twierdzenie Frischa–Waugha–Lovella: regresja reszt wyniku na reszty predyktora, obie po usunięciu wpływu pozostałych zmiennych, daje ten sam współczynnik co pełny model. W przykładzie oba wyniosły −0.154.
Czy wykres zmiennej dodanej nadaje się do oceny nieliniowości?
Tylko ostrożnie. Gdy predyktory są skorelowane, wykres może fałszywie sugerować krzywiznę albo jej brak. Kształt zależności lepiej sprawdzić, dodając do modelu składnik kwadratowy lub splajn.
Jak narysować wykresy zmiennej dodanej w R?
Najprościej funkcją avPlots() z pakietu car, która rysuje wykres dla każdego predyktora. Ręcznie wystarczą dwie regresje pomocnicze, funkcja resid() i plot() reszt wyniku względem reszt predyktora.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka w obrazkach
Wykres zmiennej dodanej, zmiana znaku współczynnika, elipsa ufności przy współliniowości i ten sam predyktor w pięciu modelach – „kontrolując” na rysunkach z R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cook, R. D. (1996). Added-variable plots and curvature in linear regression. Technometrics, 38(3), 275–278. https://doi.org/10.1080/00401706.1996.10484507
- Lovell, M. C. (1963). Seasonal adjustment of economic time series and multiple regression analysis. Journal of the American Statistical Association, 58(304), 993–1010. https://doi.org/10.1080/01621459.1963.10480682
- Velleman, P. F., & Welsch, R. E. (1981). Efficient computing of regression diagnostics. The American Statistician, 35(4), 234–242. https://doi.org/10.1080/00031305.1981.10479362
Cytowania BibTeX
@article{cook1996addedvariable, author={Cook, R. Dennis}, title={{Added-variable plots and curvature in linear regression}}, journal={Technometrics}, year={1996}, volume={38}, number={3}, pages={275--278}, doi={10.1080/00401706.1996.10484507}}@article{lovell1963seasonal, author={Lovell, Michael C.}, title={{Seasonal adjustment of economic time series and multiple regression analysis}}, journal={Journal of the American Statistical Association}, year={1963}, volume={58}, number={304}, pages={993--1010}, doi={10.1080/01621459.1963.10480682}}@article{velleman1981efficient, author={Velleman, Paul F. and Welsch, Roy E.}, title={{Efficient computing of regression diagnostics}}, journal={The American Statistician}, year={1981}, volume={35}, number={4}, pages={234--242}, doi={10.1080/00031305.1981.10479362}}