Jedna strzałka, dwie drogi
Definicje i procedurę znajdziesz w haśle mediacja (analiza mediacji) i we wpisie analiza mediacji krok po kroku. Tu nie powtarzamy procedury. Pokazujemy na pięciu rysunkach, skąd bierze się liczba nazywana efektem pośrednim, dlaczego jej rozkład jest krzywy i co z tego wynika dla wyboru testu.
Przykład jest fikcyjny. 120 studentów ocenia wsparcie promotora (X, skala 1–7), poczucie skuteczności w pisaniu pracy (M, 10–50 punktów) i zaangażowanie w pisanie (Y, 0–100 punktów). Hipoteza brzmi: wsparcie podnosi poczucie skuteczności, a ono zwiększa zaangażowanie. Parametry populacji ustawiono ręcznie tak, by efekt pośredni był wyraźny (a = 2, b = 0.7, c′ = 1.5, czyli ab = 1.4). Ziarno 582 ustalono raz i nie zmieniano go. Dane pobierzesz jako mediacja-dane-symulowane.csv.
Jedno zastrzeżenie na start. Mediacja to model przyczynowy. Liczby z regresji opisują go poprawnie tylko wtedy, gdy kolejność zmiennych jest prawdziwa i nie ma pominiętych zakłócaczy, zwłaszcza między M a Y (Rohrer i in., 2022). Co z tego wynika i jak sprawdzić wrażliwość wniosku, opisujemy we wpisie mediacja przyczynowa i analiza wrażliwości. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: diagram ścieżek z liczbami
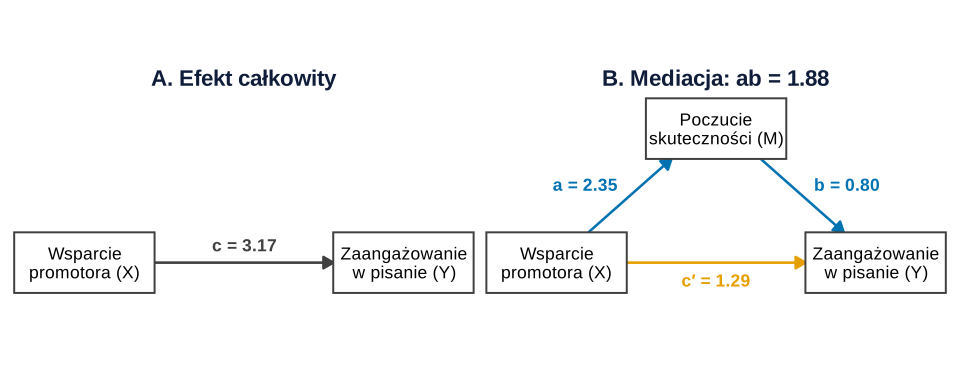
lm(); diagram narysowany w ggplot2 (dane symulowane, set.seed(582)).Co widać. Panel A to jedna regresja: zaangażowanie na wsparcie. Wynik c = 3.17 znaczy, że student oceniający wsparcie o punkt wyżej ma średnio o 3.17 punktu wyższe zaangażowanie. Panel B to dwie kolejne regresje: poczucie skuteczności na wsparcie (ścieżka a = 2.35) oraz zaangażowanie na wsparcie i poczucie skuteczności naraz (ścieżki b = 0.80 i c′ = 1.29). Iloczyn a · b = 1.88 to efekt pośredni, a c′ – efekt bezpośredni. Diagram narysowaliśmy zwykłymi warstwami ggplot2: prostokąty to geom_rect(), strzałki – geom_segment() z arrow(), etykiety – geom_label().
Czego ten wykres nie pokazuje. Nie ma tu niepewności: c′ = 1.29 wygląda solidnie, a jego przedział obejmuje zero (rysunek 4). Diagram nie pokazuje też założeń. Brak strzałki między dwiema zmiennymi to twierdzenie, że nie ma tam bezpośredniego wpływu, a nie przemilczenie. Zasady rysowania i symbole omawia hasło wykres ścieżkowy. Przy współczynnikach nieustandaryzowanych porównuj ścieżki ostrożnie: a i b są w różnych jednostkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: skąd się bierze iloczyn ab
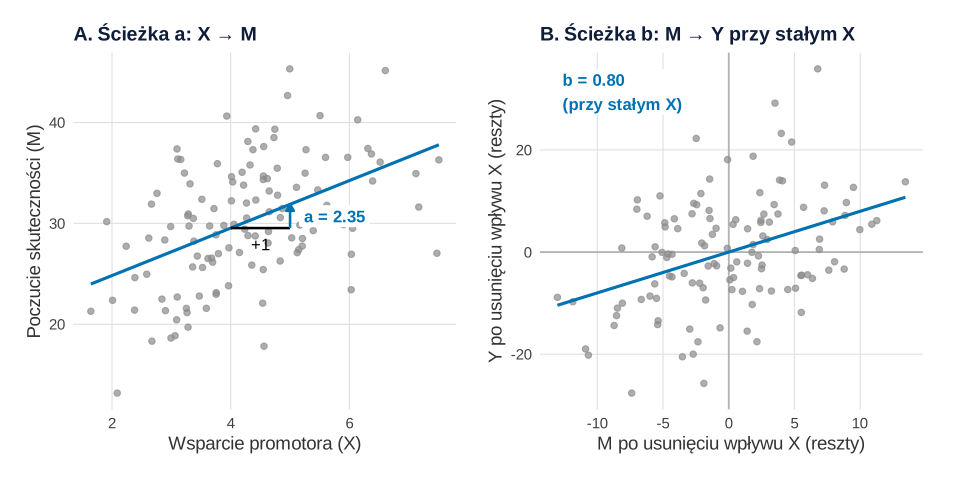
lm() (dane symulowane).Co widać. Panel A: wsparcie wyższe o punkt to średnio o 2.35 punktu wyższe poczucie skuteczności. Panel B pokazuje ścieżkę b „przy stałym X”. Z obu zmiennych usunęliśmy to, co przewiduje wsparcie, i zostały same reszty. Nachylenie prostej przez reszty wynosi 0.7987, dokładnie tyle co współczynnik b w regresji z dwoma predyktorami. Łańcuch czyta się więc tak: +1 punkt wsparcia → +2.35 punktu skuteczności → +2.35 · 0.80 = +1.88 punktu zaangażowania. To jest cały efekt pośredni.
Czego ten wykres nie pokazuje. Rysunek nie dowodzi, że to wsparcie zmienia skuteczność, a nie odwrotnie. Oba panele wyglądałyby tak samo, gdyby studenci pewni siebie częściej szukali kontaktu z promotorem. Panel B jest też łatwy do przecenienia: reszty usuwają tylko wpływ X, a nie innych, niezmierzonych zmiennych. Więcej o tym, co znaczy „przy kontroli” jednej zmiennej, pokazuje wpis regresja wieloraka w obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: rozkład ab z bootstrapu a przybliżenie Sobela
Aby ocenić niepewność ab, potrzebujemy jego rozkładu z próby do próby. Test Sobela zakłada, że jest to rozkład normalny z błędem standardowym z metody delta (Sobel, 1982). Bootstrap nic nie zakłada o kształcie. Losujemy 5000 razy ze zwracaniem 120 osób z naszej próby, w każdej próbie liczymy a i b, a potem iloczyn. Pokazujemy też to samo dla pierwszych 40 osób.
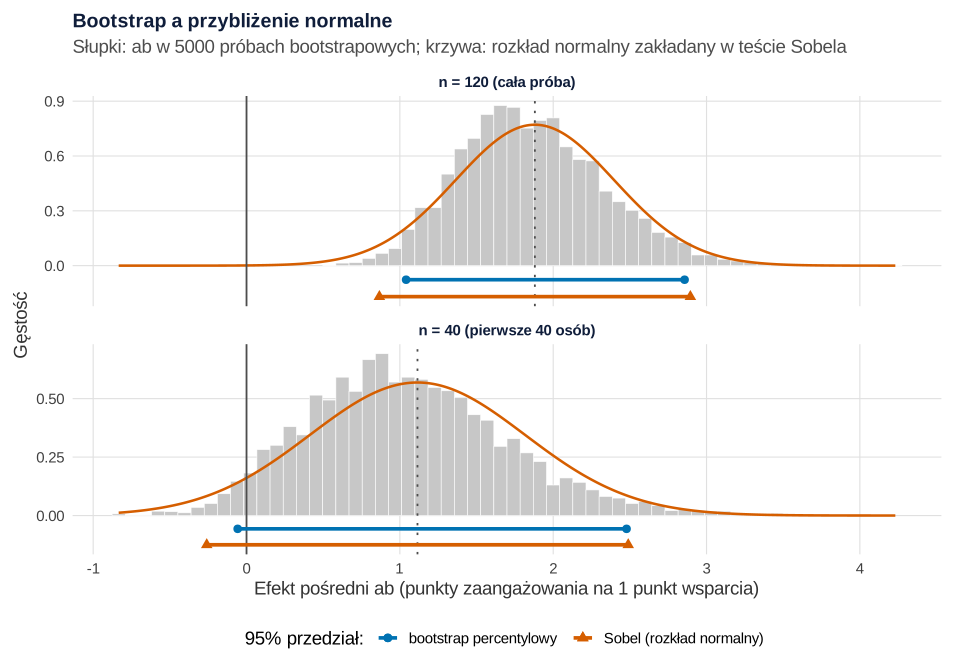
set.seed(582)).Co widać. Histogram nie jest symetryczny: ma dłuższy prawy ogon (skośność 0.42 przy n = 120 i 0.47 przy n = 40). Krzywa Sobela jest symetryczna z definicji. Przy n = 120 percentylowy przedział bootstrapowy to [1.04, 2.86]: dolna granica leży 0.84 poniżej oszacowania, górna 0.98 powyżej. Przedział Sobela [0.87, 2.89] sięga po 1.01 w obie strony. Wniosek jest ten sam. Przy 40 osobach ab = 1.12, a różnicę widać na lewym ogonie. Krzywa normalna kładzie poniżej zera 5.6% masy, a rozkład bootstrapowy – 3.5%. Przedział Sobela zaczyna się od −0.26, a bootstrapowy od −0.06 (Sobel: z = 1.59, p = .112).
Czego ten wykres nie pokazuje. W tej próbie 40 osób oba przedziały obejmują zero, więc żadna metoda nie daje tu „istotności”. Rysunek pokazuje kierunek różnicy, nie jej regułę: o tym, jak często metody się rozjeżdżają, mówi dopiero symulacja na rysunku 5. Bootstrap nie naprawia też małej próby. Rozkład bootstrapowy przy 40 osobach jest szeroki, a jego kształt zależy od tych konkretnych 40 osób. Symulacje MacKinnona i in. (2004) pokazały, że przedziały oparte na rozkładzie normalnym są niezrównoważone, bo rozkład efektu pośredniego jest normalny tylko w szczególnych przypadkach. Szerzej o odczytywaniu przedziałów piszemy we wpisie przedział ufności w obrazkach, a alternatywę bez losowania osób – przedział Monte Carlo – policzysz w kalkulatorze efektu pośredniego.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: c = c′ + ab na jednym słupku
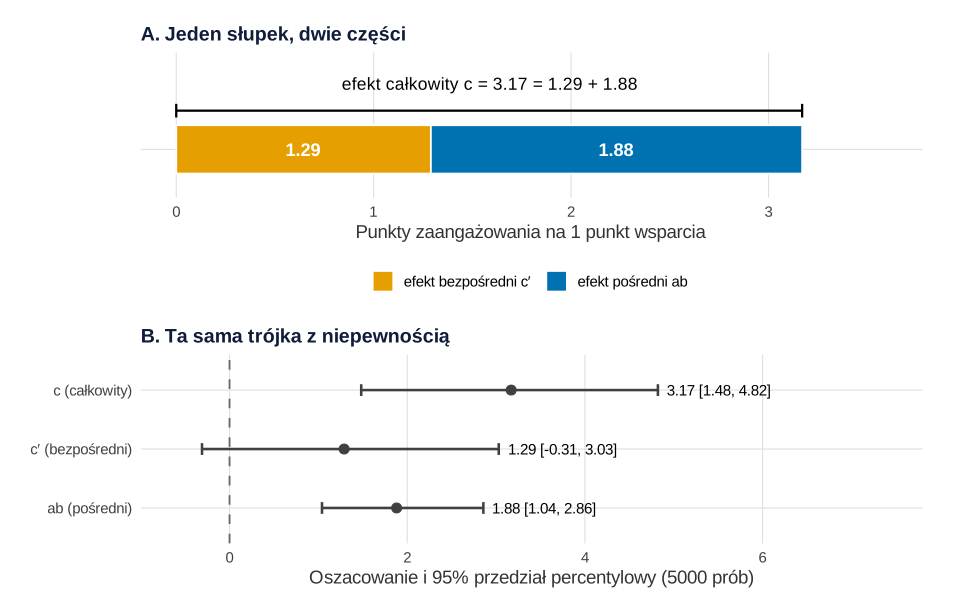
set.seed(582)).Co widać. Efekt całkowity c = 3.17 składa się z dwóch części: 1.29 + 1.88. W regresji liniowej MNK na tych samych obserwacjach to dokładna tożsamość, nie przybliżenie. Różnica c − c′ − ab wynosi zero, a w 5000 próbach bootstrapowych największe odchylenie to 2.2 · 10⁻¹⁵, czyli błąd zaokrągleń komputera. Panel B dodaje niepewność. Przedział efektu pośredniego [1.04, 2.86] nie obejmuje zera, przedział efektu bezpośredniego [−0.31, 3.03] – obejmuje.
Czego ten wykres nie pokazuje. Słupek kusi, by napisać, że „59% efektu przechodzi przez mediator” (ab / c = 0.593). Ten iloraz jest bardzo niestabilny: w tych samych 5000 próbach jego 95% przedział to [0.31, 1.18], czyli od jednej trzeciej do więcej niż całości. Dlaczego odsetek mediacji bywa mylący, opisuje hasło mediacja częściowa. Nieistotne c′ nie oznacza też mediacji całkowitej: przedział c′ sięga do 3.03. Tożsamość c = c′ + ab nie zachodzi w modelach nieliniowych, np. w regresji logistycznej, ani gdy regresje liczysz na różnych podzbiorach osób z powodu braków danych.
Podpis do pracy:
Zdanie do Wyników:
Gotowy układ tabeli znajdziesz w haśle tabela mediacji w APA.
Rysunek 5: moc testu Sobela i bootstrapu przy małych próbach
Pojedyncza próba nie rozstrzyga, która metoda jest lepsza. Dlatego losujemy z populacji z bloku danych po 1000 prób dla każdej liczebności od 30 do 150 osób. W każdej liczymy test Sobela i percentylowy przedział bootstrapowy z 1000 prób. Drugi wariant ma b = 0: wtedy efekt pośredni jest zerowy, choć ścieżka a nadal istnieje. Pierwszy wariant mierzy moc, drugi – błąd I rodzaju (oba pojęcia na rysunkach pokazuje wpis moc testu w obrazkach). Wąsy pokazują ±1.96 błędu Monte Carlo.
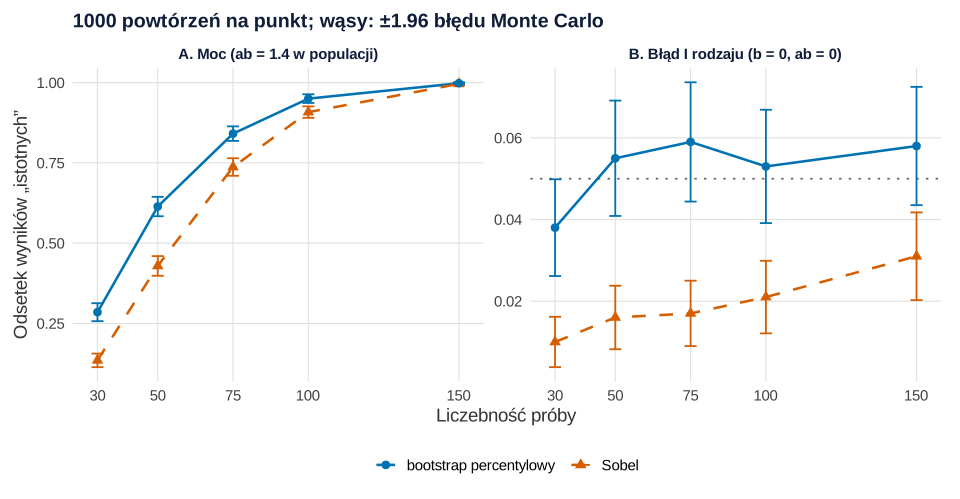
set.seed(582).Co widać. Przy 30 osobach bootstrap wykrył efekt pośredni w 28.5% prób, a test Sobela w 13.5%. Przy 50 osobach było to 61.4% wobec 42.9%, przy 75 – 84.1% wobec 73.7%. Od 100 osób różnica znika (95.0% wobec 90.8%, przy 150 – 99.8% wobec 99.6%). Błąd Monte Carlo tych odsetków nie przekracza 1.6 punktu procentowego. Przy 50 osobach w 19.0% prób istotny był tylko bootstrap, a tylko Sobel – w 0.5%. Panel B wyjaśnia, skąd ta przewaga. Test Sobela przy zerowym efekcie pośrednim odrzuca hipotezę zerową rzadziej, niż obiecuje α = .05: od 1.0% przy 30 osobach do 3.1% przy 150. Bootstrap trzyma się blisko 5% (od 3.8% do 5.9%, błąd MC około 0.7 punktu).
Czego ten wykres nie pokazuje. To jedna populacja, z jednym zestawem ścieżek i rozkładem normalnym reszt. Przy innych wartościach a i b liczby będą inne, a przy słabszych ścieżkach różnica rozciągnie się na większe próby. Liczebności potrzebne do mocy .80 dla sześciu testów mediacji w wielu wariantach ścieżek podali Fritz i MacKinnon (2007). Ich tabele i symulację mocy dla własnego modelu omawia wpis analiza mediacji krok po kroku. Przy 75 osobach bootstrap przekroczył 5% (5.9%), ale mieści się to w granicach błędu Monte Carlo. Hayes i Scharkow (2013) uznają przedział percentylowy za dobry kompromis między mocą a kontrolą błędu I rodzaju. Wybór metody po obejrzeniu wyników nie wchodzi w grę: tę samą metodę zapisz w planie analizy.
Podpis do pracy (np. przy uzasadnieniu liczebności lub w aneksie):
Zdanie do Metody:
Który rysunek do pracy
- Do Wyników – rysunek 1 (panel B) albo rysunek 4 (panel B). Diagram z liczbami jest standardem, a wykres trzech efektów z przedziałami zastępuje osobną tabelę, gdy mediator jest jeden.
- Do Metody albo aneksu – rysunek 3, gdy recenzent pyta, dlaczego bootstrap, a nie Sobel. Rysunek 5 przyda się przy uzasadnieniu liczebności, ale w wersji policzonej dla własnych założeń.
- Do prezentacji na obronę – rysunek 2. Najlepiej tłumaczy, że efekt pośredni to łańcuch dwóch zależności, a nie osobna „magiczna” liczba.
Liczby do rysunków policzysz też w programach: w SPSS z makrem PROCESS albo w jamovi. W R wyniki z lm() sprawdziliśmy w lavaan (blok 6 w kodzie): współczynniki są identyczne, a błąd standardowy ab z metody delta (0.512) różni się od Sobela z lm() (0.517) tylko mianownikiem wariancji reszt. Gdy mediatorów jest więcej, przejdź do wpisu mediacja równoległa i szeregowa. Dlaczego kroki Barona i Kenny’ego mają małą moc, a test łącznej istotności ścieżek a i b daje najlepszą równowagę błędów (MacKinnon i in., 2002), opisuje hasło podejście Barona i Kenny’ego. Zakłócacze między zmiennymi warto narysować przed analizą jako graf przyczynowy (DAG).
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a przepis 3 – funkcje bootstrapu i testu Sobela, z których korzystają następne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Dane są symulowane w kodzie; ten sam zbiór 120 osób pobierzesz też jako plik CSV (link na początku wpisu). Ziarno 582 ustalono z góry i nie dobierano go pod wynik; każdy przepis, który losuje (1, 3, 4 i 5), ustawia je na początku losowania, więc pojedynczy przepis uruchomiony po swoich poprzednikach daje te same liczby co na stronie. Ręcznie wybrano parametry populacji (a = 2, b = 0.7, c′ = 1.5, średnie i SD zmiennych), liczebność 120, podpróbę pierwszych 40 osób, liczebności w symulacji (30–150) i liczby powtórzeń (5000 prób bootstrapowych w przepisach 3–4; 1000 powtórzeń × 1000 prób w przepisie 5). Bootstrap liczymy bez pętli, ze wzorów MNK na sumy iloczynów odchyleń – daje te same ścieżki co lm(), a jest szybszy.
1. Dane, trzy regresje i diagram ścieżek: Rysunek 1
R
# Rysunek 1. Diagram ścieżek narysowany w ggplot2 z oszacowaniami a, b, c i c′ z regresji (dane fikcyjne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(boot = "#0072B2", sobel = "#D55E00", bezp = "#E69F00", posr = "#0072B2", ciemny = "grey25")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Dane fikcyjne: 120 studentów; X – wsparcie promotora (1–7), M – poczucie skuteczności (10–50),
# Y – zaangażowanie w pisanie pracy (0–100). Parametry populacji ustalone ręcznie.
n <- 120
a_pop <- 2; b_pop <- 0.7; cp_pop <- 1.5             # a: X → M, b: M → Y przy stałym X, c′: X → Y przy stałym M
set.seed(582)                                       # ziarno ustalone raz, bez dobierania pod wynik
wsparcie <- rnorm(n, 4.2, 1.2)
skutecznosc <- 30 + a_pop * (wsparcie - 4.2) + rnorm(n, 0, 5.5)
zaangazowanie <- 60 + cp_pop * (wsparcie - 4.2) + b_pop * (skutecznosc - 30) + rnorm(n, 0, 10)
dane <- data.frame(wsparcie, skutecznosc, zaangazowanie)
round(sapply(dane, function(v) c(M = mean(v), SD = sd(v))), 2)

# Trzy regresje MNK: efekt całkowity c, ścieżka a, ścieżki b i c′
m_c <- lm(zaangazowanie ~ wsparcie, data = dane)
m_a <- lm(skutecznosc ~ wsparcie, data = dane)
m_b <- lm(zaangazowanie ~ wsparcie + skutecznosc, data = dane)
sc <- c(a = coef(m_a)[["wsparcie"]], b = coef(m_b)[["skutecznosc"]],
        c_prim = coef(m_b)[["wsparcie"]], c = coef(m_c)[["wsparcie"]])
sc[["ab"]] <- sc[["a"]] * sc[["b"]]
round(sc, 3)
round(rbind(a = summary(m_a)$coefficients["wsparcie", ], b = summary(m_b)$coefficients["skutecznosc", ],
            c_prim = summary(m_b)$coefficients["wsparcie", ], c = summary(m_c)$coefficients["wsparcie", ]), 4)

# Diagram: prostokąty i strzałki jako zwykłe warstwy ggplot2 (bez pakietów do diagramów)
wezly <- data.frame(id = c("X", "M", "Y"), x = c(0, 5, 10), y = c(0, 4.2, 0),
                    tekst = c("Wsparcie\npromotora (X)", "Poczucie\nskuteczności (M)", "Zaangażowanie\nw pisanie (Y)"))
w <- 2.2; h <- 0.95                                  # połowa szerokości i wysokości prostokąta
rysuj_diagram <- function(wezly, strzalki, tytul) {
  ggplot() +
    geom_segment(data = strzalki, aes(x = x0, y = y0, xend = x1, yend = y1), linewidth = 0.9,
                 colour = strzalki$kolor, arrow = arrow(length = unit(0.3, "cm"), type = "closed")) +
    geom_label(data = strzalki, aes(x = (x0 + x1) / 2 + dx, y = (y0 + y1) / 2 + dy, label = etykieta),
               size = 4.6, linewidth = 0, fill = "white", colour = strzalki$kolor, fontface = "bold") +
    geom_rect(data = wezly, aes(xmin = x - w, xmax = x + w, ymin = y - h, ymax = y + h),
              fill = "white", colour = "grey25", linewidth = 0.7) +
    geom_text(data = wezly, aes(x, y, label = tekst), size = 4.6, lineheight = 0.9) +
    coord_equal(xlim = c(-2.4, 12.4), ylim = c(-1.6, 5.4), expand = FALSE) +
    labs(title = tytul) + theme_void(base_size = 14) +
    theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", hjust = 0.5),
          plot.background = element_rect(fill = "white", colour = NA))
}
f <- function(v) formatC(v, format = "f", digits = 2)
strz_c <- data.frame(x0 = 0 + w, y0 = 0, x1 = 10 - w, y1 = 0, dx = 0, dy = 0.55,
                     etykieta = paste0("c = ", f(sc[["c"]])), kolor = kol[["ciemny"]])
strz_m <- data.frame(x0 = c(1, 5 + w - 0.8, 0 + w), y0 = c(h, 4.2 - h, 0),
                     x1 = c(5 - w + 0.8, 9, 10 - w), y1 = c(4.2 - h, h, 0),
                     dx = c(-1.4, 1.4, 0), dy = c(0.35, 0.35, -0.55),
                     etykieta = c(paste0("a = ", f(sc[["a"]])), paste0("b = ", f(sc[["b"]])),
                                  paste0("c′ = ", f(sc[["c_prim"]]))),
                     kolor = c(kol[["posr"]], kol[["posr"]], kol[["bezp"]]))
p1 <- rysuj_diagram(wezly[c(1, 3), ], strz_c, "A. Efekt całkowity") +
  rysuj_diagram(wezly, strz_m, paste0("B. Mediacja: ab = ", f(sc[["ab"]])))
p1   # zapis: ggsave("mediacja-diagram-sciezek.svg", p1, width = 10, height = 3.9)
Wynik w R
   wsparcie skutecznosc zaangazowanie
M      4.25       30.12         61.96
SD     1.23        6.13         11.59
     a      b c_prim      c     ab
 2.355  0.799  1.290  3.170  1.880
       Estimate Std. Error t value Pr(>|t|)
a        2.3545     0.4053  5.8086   0.0000
b        0.7987     0.1714  4.6598   0.0000
c_prim   1.2898     0.8558  1.5071   0.1345
c        3.1702     0.8182  3.8744   0.0002
2. Ścieżki a i b na wykresach: Rysunek 2
R
# Rysunek 2. Skąd się bierze iloczyn ab: ścieżka a na wykresie rozrzutu i ścieżka b po usunięciu wpływu X
# (kontynuacja: dane, sc, m_a, kol, motyw, f z bloku 1)

# Ścieżka b to nachylenie reszt Y|X względem reszt M|X (wykres zmiennej dodanej)
dane$res_m <- resid(m_a)
dane$res_y <- resid(lm(zaangazowanie ~ wsparcie, data = dane))
b_z_reszt <- coef(lm(res_y ~ res_m, data = dane))[["res_m"]]
round(c(b_z_modelu = sc[["b"]], b_z_reszt = b_z_reszt), 4)

# Łańcuch: +1 punkt wsparcia → +a punktów skuteczności → +a·b punktów zaangażowania
round(c(wzrost_M = sc[["a"]], wzrost_Y_przez_M = sc[["a"]] * sc[["b"]],
        wzrost_Y_o_1_pkt_M = sc[["b"]]), 3)

x0 <- 4; x1 <- 5                                     # dwa poziomy wsparcia do pokazania „+1 punktu”
m0 <- predict(m_a, data.frame(wsparcie = x0)); m1 <- predict(m_a, data.frame(wsparcie = x1))
pa <- ggplot(dane, aes(wsparcie, skutecznosc)) +
  geom_point(colour = "grey55", alpha = 0.7, size = 1.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["posr"]], linewidth = 1.1) +
  annotate("segment", x = x0, xend = x1, y = m0, yend = m0, linewidth = 0.9) +
  annotate("segment", x = x1, xend = x1, y = m0, yend = m1, linewidth = 0.9, colour = kol[["posr"]],
           arrow = arrow(length = unit(0.2, "cm"), type = "closed")) +
  annotate("label", x = x1 + 0.15, y = (m0 + m1) / 2, hjust = 0, size = 4.4, linewidth = 0,
           label = paste0("a = ", f(sc[["a"]])), colour = kol[["posr"]], fontface = "bold") +
  annotate("text", x = (x0 + x1) / 2, y = m0 - 1.6, label = "+1", size = 4.4) +
  labs(x = "Wsparcie promotora (X)", y = "Poczucie skuteczności (M)",
       title = "A. Ścieżka a: X → M") + motyw
pb <- ggplot(dane, aes(res_m, res_y)) +
  geom_hline(yintercept = 0, colour = "grey70") + geom_vline(xintercept = 0, colour = "grey70") +
  geom_point(colour = "grey55", alpha = 0.7, size = 1.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["posr"]], linewidth = 1.1) +
  annotate("label", x = min(dane$res_m), y = max(dane$res_y), hjust = 0, vjust = 1, size = 4.4,
           linewidth = 0, label = paste0("b = ", f(sc[["b"]]), "\n(przy stałym X)"),
           colour = kol[["posr"]], fontface = "bold") +
  labs(x = "M po usunięciu wpływu X (reszty)", y = "Y po usunięciu wpływu X (reszty)",
       title = "B. Ścieżka b: M → Y przy stałym X") + motyw
p2 <- pa + pb
p2   # zapis: ggsave("mediacja-sciezki-a-b.svg", p2, width = 10, height = 5)
Wynik w R
b_z_modelu  b_z_reszt
    0.7987     0.7987
          wzrost_M   wzrost_Y_przez_M wzrost_Y_o_1_pkt_M
             2.355              1.880              0.799
3. Bootstrap i test Sobela: Rysunek 3
R
# Rysunek 3. Rozkład ab z bootstrapu a przybliżenie normalne testu Sobela: n = 120 i pierwsze 40 osób
# (kontynuacja: dane, kol, motyw, f z bloku 1)

# Bootstrap bez pętli: każda kolumna macierzy indeksów to jedna próba bootstrapowa.
# Ścieżki liczone ze wzorów MNK na sumy iloczynów odchyleń (te same liczby co z lm()).
sciezki_boot <- function(x, m, y, B) {
  n <- length(x)
  i <- matrix(sample.int(n, n * B, replace = TRUE), n, B)
  X <- matrix(x[i], n); M <- matrix(m[i], n); Y <- matrix(y[i], n)
  s <- function(u, v) colSums(u * v) - colSums(u) * colSums(v) / n   # suma iloczynów odchyleń
  sxx <- s(X, X); smm <- s(M, M); sxm <- s(X, M); sxy <- s(X, Y); smy <- s(M, Y)
  wyzn <- sxx * smm - sxm^2
  data.frame(a = sxm / sxx, b = (sxx * smy - sxm * sxy) / wyzn,
             c_prim = (smm * sxy - sxm * smy) / wyzn, c = sxy / sxx)
}
# Test Sobela: ab / SE(ab), SE(ab) = √(b²·SE(a)² + a²·SE(b)²) z dwóch regresji lm()
sobel <- function(d) {
  ka <- summary(lm(skutecznosc ~ wsparcie, data = d))$coefficients["wsparcie", 1:2]
  kb <- summary(lm(zaangazowanie ~ wsparcie + skutecznosc, data = d))$coefficients["skutecznosc", 1:2]
  ab <- ka[[1]] * kb[[1]]; se <- sqrt(kb[[1]]^2 * ka[[2]]^2 + ka[[1]]^2 * kb[[2]]^2)
  c(ab = ab, se = se, z = ab / se, p = 2 * pnorm(-abs(ab / se)), dolna = ab - 1.96 * se, gorna = ab + 1.96 * se)
}
skosnosc <- function(v) mean((v - mean(v))^3) / sd(v)^3

B <- 5000
proby <- list("n = 120 (cała próba)" = dane, "n = 40 (pierwsze 40 osób)" = dane[1:40, ])
set.seed(582)
wyniki <- lapply(names(proby), function(nazwa) {
  d <- proby[[nazwa]]
  bt <- sciezki_boot(d$wsparcie, d$skutecznosc, d$zaangazowanie, B)
  ab_b <- bt$a * bt$b
  s <- sobel(d)
  list(rozklad = data.frame(proba = nazwa, ab = ab_b),
       podsum = data.frame(proba = nazwa, ab = s[["ab"]], se_sobel = s[["se"]], z = s[["z"]], p_sobel = s[["p"]],
                           sobel_dolna = s[["dolna"]], sobel_gorna = s[["gorna"]],
                           boot_dolna = quantile(ab_b, 0.025)[[1]], boot_gorna = quantile(ab_b, 0.975)[[1]],
                           sd_boot = sd(ab_b), skosnosc = skosnosc(ab_b),
                           boot_ponizej_0 = mean(ab_b < 0), normalny_ponizej_0 = pnorm(0, s[["ab"]], s[["se"]])))
})
rozklad <- do.call(rbind, lapply(wyniki, `[[`, "rozklad"))
podsum <- do.call(rbind, lapply(wyniki, `[[`, "podsum"))
print(data.frame(proba = podsum$proba, round(podsum[, -1], 3)), row.names = FALSE)
# odległość granic od oszacowania: bootstrap jest niesymetryczny, Sobel – symetryczny
print(data.frame(proba = podsum$proba,
                 boot_w_dol = round(podsum$ab - podsum$boot_dolna, 3), boot_w_gore = round(podsum$boot_gorna - podsum$ab, 3),
                 sobel_w_obie = round(1.96 * podsum$se_sobel, 3)), row.names = FALSE)

rozklad$proba <- factor(rozklad$proba, levels = names(proby)); podsum$proba <- factor(podsum$proba, levels = names(proby))
siatka <- do.call(rbind, lapply(seq_len(nrow(podsum)), function(k) {
  xs <- seq(min(rozklad$ab), max(rozklad$ab), length.out = 300)
  data.frame(proba = podsum$proba[k], ab = xs, gestosc = dnorm(xs, podsum$ab[k], podsum$se_sobel[k]))
}))
szczyt <- dnorm(0) / podsum$se_sobel                 # wysokość krzywej – do ustawienia przedziałów pod osią
przedzialy <- rbind(data.frame(proba = podsum$proba, metoda = "bootstrap percentylowy", lo = podsum$boot_dolna,
                               hi = podsum$boot_gorna, y = -0.1 * szczyt),
                    data.frame(proba = podsum$proba, metoda = "Sobel (rozkład normalny)", lo = podsum$sobel_dolna,
                               hi = podsum$sobel_gorna, y = -0.22 * szczyt))
p3 <- ggplot(rozklad, aes(ab)) +
  geom_histogram(aes(y = after_stat(density)), bins = 60, fill = "grey78", colour = "white", linewidth = 0.2) +
  geom_line(data = siatka, aes(y = gestosc), colour = kol[["sobel"]], linewidth = 0.9) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_vline(data = podsum, aes(xintercept = ab), colour = "grey30", linetype = "dotted") +
  geom_errorbar(data = przedzialy, aes(xmin = lo, xmax = hi, y = y, colour = metoda), orientation = "y",
                width = 0, linewidth = 1.3, inherit.aes = FALSE) +
  geom_point(data = przedzialy, aes(x = lo, y = y, colour = metoda, shape = metoda), size = 2.6, inherit.aes = FALSE) +
  geom_point(data = przedzialy, aes(x = hi, y = y, colour = metoda, shape = metoda), size = 2.6, inherit.aes = FALSE) +
  scale_colour_manual(values = c("bootstrap percentylowy" = kol[["boot"]], "Sobel (rozkład normalny)" = kol[["sobel"]]),
                      name = "95% przedział:") +
  scale_shape_manual(values = c("bootstrap percentylowy" = 16, "Sobel (rozkład normalny)" = 17), name = "95% przedział:") +
  facet_wrap(~ proba, ncol = 1, scales = "free_y") +
  labs(x = "Efekt pośredni ab (punkty zaangażowania na 1 punkt wsparcia)", y = "Gęstość",
       title = "Bootstrap a przybliżenie normalne",
       subtitle = "Słupki: ab w 5000 próbach bootstrapowych; krzywa: rozkład normalny zakładany w teście Sobela") + motyw
p3   # zapis: ggsave("mediacja-bootstrap-a-sobel.svg", p3, width = 10, height = 7)
Wynik w R
                     proba    ab se_sobel     z p_sobel sobel_dolna sobel_gorna
      n = 120 (cała próba) 1.880    0.517 3.635   0.000       0.866       2.894
 n = 40 (pierwsze 40 osób) 1.115    0.701 1.590   0.112      -0.260       2.489
 boot_dolna boot_gorna sd_boot skosnosc boot_ponizej_0 normalny_ponizej_0
      1.041      2.857   0.474    0.416          0.000              0.000
     -0.058      2.478   0.652    0.466          0.035              0.056
                     proba boot_w_dol boot_w_gore sobel_w_obie
      n = 120 (cała próba)      0.840       0.976        1.014
 n = 40 (pierwsze 40 osób)      1.173       1.364        1.374
4. c = c′ + ab i przedziały trzech efektów: Rysunek 4
R
# Rysunek 4. c = c′ + ab: efekt całkowity rozłożony na bezpośredni i pośredni, z przedziałami z bootstrapu
# (kontynuacja: dane, sc, kol, motyw, f z bloku 1; sciezki_boot() z bloku 3)

# Tożsamość w próbie: c − c′ = a·b dokładnie (MNK, ten sam zbiór obserwacji, bez braków danych)
round(c(c = sc[["c"]], c_prim_plus_ab = sc[["c_prim"]] + sc[["ab"]], roznica = sc[["c"]] - sc[["c_prim"]] - sc[["ab"]]), 10)
round(c(udzial_ab_w_c = sc[["ab"]] / sc[["c"]]), 3)

# Ta sama tożsamość w każdej z 5000 prób bootstrapowych
set.seed(582)
bt <- sciezki_boot(dane$wsparcie, dane$skutecznosc, dane$zaangazowanie, B = 5000)
bt$ab <- bt$a * bt$b
max(abs(bt$c - bt$c_prim - bt$ab))                  # największe odchylenie od c = c′ + ab (błąd zaokrągleń)
ci <- t(sapply(bt[c("c", "c_prim", "ab")], quantile, probs = c(0.025, 0.975)))
print(round(cbind(oszacowanie = sc[c("c", "c_prim", "ab")], ci), 3))
# „odsetek mediacji” ab / c jest niestabilny: jego przedział z tych samych prób
round(quantile(bt$ab / bt$c, c(0.025, 0.5, 0.975)), 3)

slupek <- data.frame(czesc = factor(c("efekt bezpośredni c′", "efekt pośredni ab"),
                                    levels = c("efekt pośredni ab", "efekt bezpośredni c′")),
                     wartosc = c(sc[["c_prim"]], sc[["ab"]]))
slupek$srodek <- c(sc[["c_prim"]] / 2, sc[["c_prim"]] + sc[["ab"]] / 2)
pa <- ggplot(slupek, aes(x = wartosc, y = "c", fill = czesc)) +
  geom_col(width = 0.5, colour = "white") +
  geom_text(aes(x = srodek, label = f(wartosc)), colour = "white", fontface = "bold", size = 4.8) +
  annotate("segment", x = 0, xend = sc[["c"]], y = 1.4, yend = 1.4, linewidth = 0.8,
           arrow = arrow(ends = "both", length = unit(0.18, "cm"), angle = 90)) +
  annotate("text", x = sc[["c"]] / 2, y = 1.68, size = 4.6,
           label = paste0("efekt całkowity c = ", f(sc[["c"]]), " = ", f(sc[["c_prim"]]), " + ", f(sc[["ab"]]))) +
  scale_fill_manual(values = c("efekt bezpośredni c′" = kol[["bezp"]], "efekt pośredni ab" = kol[["posr"]]), name = NULL) +
  scale_x_continuous(limits = c(0, 3.6)) + scale_y_discrete(labels = NULL, expand = expansion(add = c(0.5, 1))) +
  labs(x = "Punkty zaangażowania na 1 punkt wsparcia", y = NULL, title = "A. Jeden słupek, dwie części") +
  guides(fill = guide_legend(reverse = TRUE)) + motyw
pkt <- data.frame(efekt = factor(c("c (całkowity)", "c′ (bezpośredni)", "ab (pośredni)"),
                                 levels = rev(c("c (całkowity)", "c′ (bezpośredni)", "ab (pośredni)"))),
                  est = sc[c("c", "c_prim", "ab")], lo = ci[, 1], hi = ci[, 2])
pb <- ggplot(pkt, aes(est, efekt)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = lo, xmax = hi), orientation = "y", width = 0.2, linewidth = 0.9, colour = kol[["ciemny"]]) +
  geom_point(size = 3, colour = kol[["ciemny"]]) +
  geom_text(aes(x = hi, label = paste0(f(est), " [", f(lo), ", ", f(hi), "]")), hjust = -0.08, size = 4) +
  scale_x_continuous(limits = c(-0.6, 7.4)) +
  labs(x = "Oszacowanie i 95% przedział percentylowy (5000 prób)", y = NULL, title = "B. Ta sama trójka z niepewnością") + motyw
p4 <- pa / pb + plot_layout(heights = c(1, 1.3))
p4   # zapis: ggsave("mediacja-c-rowna-sie-c-prim-plus-ab.svg", p4, width = 10, height = 6.4)
Wynik w R
             c c_prim_plus_ab        roznica
      3.170226       3.170226       0.000000
udzial_ab_w_c
        0.593
[1] 2.220446e-15
       oszacowanie   2.5% 97.5%
c             3.17  1.482 4.822
c_prim        1.29 -0.310 3.030
ab            1.88  1.041 2.857
 2.5%   50% 97.5%
0.308 0.584 1.179
5. Symulacja mocy i błędu I rodzaju: Rysunek 5
R
# Rysunek 5. Symulacja: moc testu Sobela i przedziału bootstrapowego przy małych próbach oraz błąd I rodzaju
# (kontynuacja: a_pop, b_pop, cp_pop, kol, motyw z bloku 1; sciezki_boot() i sobel() z bloku 3)

# Ta sama populacja co w bloku 1 (ab = 2 · 0.7 = 1.4) oraz wariant z b = 0 (efekt pośredni zerowy, a ≠ 0)
losuj <- function(n, b) {
  x <- rnorm(n, 4.2, 1.2)
  m <- 30 + a_pop * (x - 4.2) + rnorm(n, 0, 5.5)
  y <- 60 + cp_pop * (x - 4.2) + b * (m - 30) + rnorm(n, 0, 10)
  data.frame(wsparcie = x, skutecznosc = m, zaangazowanie = y)
}
R <- 1000; B <- 1000                                 # powtórzenia i próby bootstrapowe w każdym powtórzeniu
warunki <- expand.grid(n = c(30, 50, 75, 100, 150), b = c(b_pop, 0))
set.seed(582)
wyn <- do.call(rbind, lapply(seq_len(nrow(warunki)), function(k) {
  n <- warunki$n[k]; b <- warunki$b[k]
  odrz <- t(replicate(R, {
    d <- losuj(n, b)
    bt <- sciezki_boot(d$wsparcie, d$skutecznosc, d$zaangazowanie, B)
    gr <- quantile(bt$a * bt$b, c(0.025, 0.975))
    c(sobel = sobel(d)[["p"]] < 0.05, bootstrap = gr[[1]] > 0 | gr[[2]] < 0)
  }))
  data.frame(n = n, b = b, metoda = c("Sobel", "bootstrap percentylowy"),
             odsetek = colMeans(odrz)[c("sobel", "bootstrap")],
             tylko_ta_metoda = c(mean(odrz[, "sobel"] & !odrz[, "bootstrap"]), mean(odrz[, "bootstrap"] & !odrz[, "sobel"])))
}))
wyn$blad_mc <- sqrt(wyn$odsetek * (1 - wyn$odsetek) / R)   # błąd Monte Carlo odsetka
rownames(wyn) <- NULL
print(transform(wyn, odsetek = round(odsetek, 3), tylko_ta_metoda = round(tylko_ta_metoda, 3),
                blad_mc = round(blad_mc, 3)), row.names = FALSE)
c(powtorzenia = R, proby_bootstrap = B)

wyn$panel <- factor(ifelse(wyn$b > 0, "A. Moc (ab = 1.4 w populacji)", "B. Błąd I rodzaju (b = 0, ab = 0)"),
                    levels = c("A. Moc (ab = 1.4 w populacji)", "B. Błąd I rodzaju (b = 0, ab = 0)"))
linia <- data.frame(panel = levels(wyn$panel)[2], y = 0.05)
p5 <- ggplot(wyn, aes(n, odsetek, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_hline(data = linia, aes(yintercept = y), colour = "grey40", linetype = "dotted") +
  geom_line(linewidth = 0.9) +
  geom_errorbar(aes(ymin = odsetek - 1.96 * blad_mc, ymax = odsetek + 1.96 * blad_mc), width = 4, linetype = "solid") +
  geom_point(size = 2.6) +
  scale_colour_manual(values = c("bootstrap percentylowy" = kol[["boot"]], "Sobel" = kol[["sobel"]]), name = NULL) +
  scale_shape_manual(values = c("bootstrap percentylowy" = 16, "Sobel" = 17), name = NULL) +
  scale_linetype_manual(values = c("bootstrap percentylowy" = "solid", "Sobel" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(30, 50, 75, 100, 150)) +
  facet_wrap(~ panel, scales = "free_y") +
  labs(x = "Liczebność próby", y = "Odsetek wyników „istotnych”",
       title = "1000 powtórzeń na punkt; wąsy: ±1.96 błędu Monte Carlo") + motyw
p5   # zapis: ggsave("mediacja-moc-sobel-bootstrap.svg", p5, width = 10, height = 5.2)
Wynik w R
   n   b                 metoda odsetek tylko_ta_metoda blad_mc
  30 0.7                  Sobel   0.135           0.009   0.011
  30 0.7 bootstrap percentylowy   0.285           0.159   0.014
  50 0.7                  Sobel   0.429           0.005   0.016
  50 0.7 bootstrap percentylowy   0.614           0.190   0.015
  75 0.7                  Sobel   0.737           0.005   0.014
  75 0.7 bootstrap percentylowy   0.841           0.109   0.012
 100 0.7                  Sobel   0.908           0.001   0.009
 100 0.7 bootstrap percentylowy   0.950           0.043   0.007
 150 0.7                  Sobel   0.996           0.000   0.002
 150 0.7 bootstrap percentylowy   0.998           0.002   0.001
  30 0.0                  Sobel   0.010           0.001   0.003
  30 0.0 bootstrap percentylowy   0.038           0.029   0.006
  50 0.0                  Sobel   0.016           0.000   0.004
  50 0.0 bootstrap percentylowy   0.055           0.039   0.007
  75 0.0                  Sobel   0.017           0.000   0.004
  75 0.0 bootstrap percentylowy   0.059           0.042   0.007
 100 0.0                  Sobel   0.021           0.000   0.005
 100 0.0 bootstrap percentylowy   0.053           0.032   0.007
 150 0.0                  Sobel   0.031           0.001   0.005
 150 0.0 bootstrap percentylowy   0.058           0.028   0.007
    powtorzenia proby_bootstrap
           1000            1000
6. Kontrola w lavaan
R
# Kontrola w lavaan: te same ścieżki, efekt pośredni jako parametr zdefiniowany, SE z metody delta
# (kontynuacja: dane i sc z bloku 1, sobel() z bloku 3)
library(lavaan)

model <- '
  skutecznosc   ~ a * wsparcie
  zaangazowanie ~ cp * wsparcie + b * skutecznosc
  ab := a * b          # efekt pośredni
  c  := cp + a * b     # efekt całkowity
'
fit_ml <- sem(model, data = dane)                    # ML, błędy standardowe z macierzy informacji (metoda delta dla ab)
pe <- parameterEstimates(fit_ml)
print(subset(pe, label %in% c("a", "b", "cp", "ab", "c"),
             select = c(label, est, se, z, pvalue, ci.lower, ci.upper)), digits = 3, row.names = FALSE)
round(sobel(dane)[c("ab", "se", "z")], 3)           # Sobel z lm(): SE różni się nieco (n − k zamiast n w wariancji reszt)
Wynik w R
 label   est    se    z pvalue ci.lower ci.upper
     a 2.355 0.402 5.86  0.000    1.567     3.14
    cp 1.290 0.845 1.53  0.127   -0.366     2.95
     b 0.799 0.169 4.72  0.000    0.467     1.13
    ab 1.880 0.512 3.67  0.000    0.878     2.88
     c 3.170 0.811 3.91  0.000    1.580     4.76
   ab    se     z
1.880 0.517 3.635
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (bootstrap / Sobel)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (ab / c′)" = c("#0072B2", "#E69F00"),
             "niebieski – szary (linia / punkty danych)" = c("#0072B2", "#8C8C8C"),
             "cynober – jasnoszary (krzywa / słupki)" = c("#D55E00", "#C7C7C7"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                          widzenie_typowe deuteranopia
niebieski – cynober (bootstrap / Sobel)             114.6        108.3
niebieski – pomarańczowy (ab / c′)                  120.2        121.5
niebieski – szary (linia / punkty danych)            43.2         47.1
cynober – jasnoszary (krzywa / słupki)               81.0         66.5
czerwony – zielony (do unikania)                    121.7         21.1
                                          protanopia
niebieski – cynober (bootstrap / Sobel)         91.9
niebieski – pomarańczowy (ab / c′)             109.3
niebieski – szary (linia / punkty danych)       39.2
cynober – jasnoszary (krzywa / słupki)          62.9
czerwony – zielony (do unikania)                31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresje dopasowano funkcją lm(), a losowania i bootstrap wykonano w pakiecie stats; kontrolny model ścieżek dopasowano pakietem lavaan. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Diagram bez liczb albo bez informacji, czy współczynniki są standaryzowane. Podaj to w nocie (rysunek 1).
- Szukanie istotności ab w wydruku jednej regresji. Efekt pośredni to iloczyn z dwóch równań; potrzebuje własnego przedziału (rysunek 2).
- Przedział symetryczny wokół ab. Rozkład iloczynu jest skośny – raportuj przedział bootstrapowy (rysunek 3).
- „Odsetek mediacji” bez przedziału. W przykładzie 59% z przedziałem od 31% do 118% (rysunek 4).
- Wniosek „mediacja całkowita”, bo c′ jest nieistotne. Brak dowodu na c′ ≠ 0 to nie dowód, że c′ = 0 (rysunek 4).
- Test Sobela jako jedyny test przy małej próbie. Ma mniejszą moc i zaniżony błąd I rodzaju (rysunek 5).
- Słowo „wpływ” bez planu badania, który go uzasadnia. Model ścieżek nie sprawdza kolejności zmiennych.
Najczęstsze pytania
Skąd się bierze efekt pośredni w analizie mediacji?
Z połączenia dwóch zależności. Ścieżka a mówi, o ile zmienia się mediator, gdy X rośnie o jednostkę; ścieżka b – o ile zmienia się Y, gdy mediator rośnie o jednostkę przy stałym X. Efekt pośredni to ich iloczyn ab. W przykładzie wsparcie promotora wyższe o punkt dawało poczucie skuteczności wyższe o 2.35, a to – zaangażowanie wyższe o 2.35 · 0.80 = 1.88 punktu.
Dlaczego rozkład efektu pośredniego ab nie jest normalny?
Bo jest iloczynem dwóch oszacowań, z których każde ma własną niepewność, a iloczyn takich wielkości ma zwykle rozkład skośny. W przykładzie rozkład ab z 5000 prób bootstrapowych miał skośność 0.42 przy 120 osobach i 0.47 przy 40. Test Sobela przybliża go symetryczną krzywą normalną, więc jego przedział jest przesunięty względem rzeczywistego rozrzutu.
Czy efekt całkowity zawsze równa się sumie efektu bezpośredniego i pośredniego?
W regresji liniowej MNK z jednym mediatorem, liczonej na tych samych obserwacjach – tak, dokładnie: c = c′ + ab. W przykładzie 3.17 = 1.29 + 1.88, a w 5000 próbach bootstrapowych odchylenie nie przekroczyło błędu zaokrągleń. W modelach nieliniowych, np. w regresji logistycznej, albo przy różnych zbiorach osób w regresjach (braki danych) ta równość nie musi zachodzić.
Czy test Sobela ma mniejszą moc niż bootstrap?
W naszej symulacji – tak, przy małych próbach. Przy 30 osobach test Sobela wykrył efekt pośredni w 13.5% prób, a percentylowy przedział bootstrapowy w 28.5%; przy 50 osobach 42.9% wobec 61.4%. Od około 100 osób różnica zanikała. Przy zerowym efekcie pośrednim test Sobela odrzucał hipotezę zerową w 1.0–3.1% prób, czyli rzadziej niż zakładane 5%.
Jak narysować diagram mediacji w R bez dodatkowych pakietów?
Wystarczy ggplot2: prostokąty zmiennych rysuje geom_rect(), nazwy – geom_text(), strzałki – geom_segment() z argumentem arrow(), a wartości ścieżek – geom_label() w połowie strzałki. Współrzędne prostokątów ustal ręcznie, a liczby wstaw z obiektów lm(), żeby rysunek zawsze zgadzał się z wynikami.
Powiązane hasła
Przeczytaj też
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikMediacja przyczynowa i analiza wrażliwości
NDE, NIE i ACME zamiast samego ab, interakcja ekspozycja × mediator, sekwencyjna ignorowalność i analiza wrażliwości ρ – na jednym przykładzie w R.
Czytaj →PoradnikRegresja wieloraka w obrazkach
Wykres zmiennej dodanej, zmiana znaku współczynnika, elipsa ufności przy współliniowości i ten sam predyktor w pięciu modelach – „kontrolując” na rysunkach z R.
Czytaj →Testujesz mediację w pracy i nie wiesz, jak to pokazać?
Pomożemy oszacować ścieżki i efekt pośredni z przedziałem bootstrapowym, przygotować czytelny diagram i opisać wyniki tak, żebyś umiał(a) je obronić przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Fritz, M. S., & MacKinnon, D. P. (2007). Required sample size to detect the mediated effect. Psychological Science, 18(3), 233–239. https://doi.org/10.1111/j.1467-9280.2007.01882.x ● Otwarty dostęp: pełny tekst
- Hayes, A. F., & Scharkow, M. (2013). The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter? Psychological Science, 24(10), 1918–1927. https://doi.org/10.1177/0956797613480187
- MacKinnon, D. P., Lockwood, C. M., & Williams, J. (2004). Confidence limits for the indirect effect: Distribution of the product and resampling methods. Multivariate Behavioral Research, 39(1), 99–128. https://doi.org/10.1207/s15327906mbr3901_4 ● Otwarty dostęp
- MacKinnon, D. P., Lockwood, C. M., Hoffman, J. M., West, S. G., & Sheets, V. (2002). A comparison of methods to test mediation and other intervening variable effects. Psychological Methods, 7(1), 83–104. https://doi.org/10.1037/1082-989x.7.1.83 ● Otwarty dostęp: pełny tekst
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Shrout, P. E., & Bolger, N. (2002). Mediation in experimental and nonexperimental studies: New procedures and recommendations. Psychological Methods, 7(4), 422–445. https://doi.org/10.1037/1082-989x.7.4.422
- Sobel, M. E. (1982). Asymptotic confidence intervals for indirect effects in structural equation models. Sociological Methodology, 13, 290–312. https://doi.org/10.2307/270723
Cytowania BibTeX
@article{fritz2007required, author={Fritz, Matthew S. and MacKinnon, David P.}, title={{Required sample size to detect the mediated effect}}, journal={Psychological Science}, year={2007}, volume={18}, number={3}, pages={233--239}, doi={10.1111/j.1467-9280.2007.01882.x}}@article{hayes2013relative, author={Hayes, Andrew F. and Scharkow, Michael}, title={{The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter?}}, journal={Psychological Science}, year={2013}, volume={24}, number={10}, pages={1918--1927}, doi={10.1177/0956797613480187}}@article{mackinnon2004confidence, author={MacKinnon, David P. and Lockwood, Chondra M. and Williams, Jason}, title={{Confidence limits for the indirect effect: Distribution of the product and resampling methods}}, journal={Multivariate Behavioral Research}, year={2004}, volume={39}, number={1}, pages={99--128}, doi={10.1207/s15327906mbr3901_4}}@article{mackinnon2002comparison, author={MacKinnon, David P. and Lockwood, Chondra M. and Hoffman, Jeanne M. and West, Stephen G. and Sheets, Virgil}, title={{A comparison of methods to test mediation and other intervening variable effects}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={83--104}, doi={10.1037/1082-989x.7.1.83}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{shrout2002mediation, author={Shrout, Patrick E. and Bolger, Niall}, title={{Mediation in experimental and nonexperimental studies: New procedures and recommendations}}, journal={Psychological Methods}, year={2002}, volume={7}, number={4}, pages={422--445}, doi={10.1037/1082-989x.7.4.422}}@article{sobel1982asymptotic, author={Sobel, Michael E.}, title={{Asymptotic confidence intervals for indirect effects in structural equation models}}, journal={Sociological Methodology}, year={1982}, volume={13}, pages={290--312}, doi={10.2307/270723}}