Int_1 i efektach warunkowych, a moderowaną mediację po indeksie z przedziałem. Granice bootstrapu różnią się między uruchomieniami, więc w pracy podaj liczbę prób, ziarno i wersję makra.Co robi PROCESS i kiedy po niego sięgnąć
PROCESS to bezpłatne makro Andrew F. Hayesa, które dodaje do SPSS regresyjną analizę mediacji, moderacji i ich połączeń. Każdy model ma numer z katalogu w podręczniku Hayesa (2022). Wpisujesz zmienne i numer, a makro szacuje równania, efekty warunkowe i przedziały bootstrapowe, których zwykła regresja w SPSS nie daje.
Ten wpis pokazuje instalację makra i wydruki trzech najczęstszych modeli: 1 (moderacja), 4 (mediacja) i 7 (moderowana mediacja). Ścieżki a, b i c′ wyjaśnia analiza mediacji krok po kroku, interakcje i proste nachylenia – analiza moderacji krok po kroku, a modele 7, 14 i 58 w R – moderowana mediacja i modele PROCESS w R.
Przykład. 240 osób piszących pracę dyplomową (dane symulowane) oceniło wsparcie promotora (wsparcie, 1–7), poczucie skuteczności w pisaniu (skut, 10–40), lęk przed pisaniem (lek, 1–5) i zaangażowanie w pisanie pracy (zaang, 1–7). Średnie: wsparcie M = 4.54 (SD = 1.17), skuteczność 25.82 (4.78), lęk 2.90 (0.77), zaangażowanie 4.80 (1.03). Dane pobierzesz jako plik SPSS .sav (z etykietami) albo plik CSV. Etykiety i braki danych przygotujesz według wpisu przygotowanie danych w SPSS.
Krok 1. Pobierz i zainstaluj PROCESS
Makro pobierasz tylko ze strony autora. Dawna domena processmacro.org kieruje dziś na afhayes.com i ma zostać wygaszona. 1 listopada 2026 r. strona podawała wersję 5.1 z października 2026 r., działającą w SPSS na Windows i Mac. Wydanie dla SPSS wymaga wersji 26 lub nowszej (Hayes, b.d.).
Warunki użycia (odczyt 1 listopada 2026 r.). PROCESS jest bezpłatny do użytku w postaci, w jakiej go pobierasz. Użycie komercyjne wymaga zgody właściciela praw. Nie wolno rozpowszechniać zmienionego makra ani wrzucać go na publiczne strony i serwery bez pisemnej zgody autora. Autor zaleca najnowsze wydanie i nie daje gwarancji (Hayes, b.d.).
- Rozpakuj archiwum ZIP. Znajdziesz w nim m.in. plik okna dialogowego, plik makra dla składni i dodatek do dokumentacji. Pełna instrukcja instalacji jest w dodatku A podręcznika (Hayes, b.d., 2022).
- Zainstaluj okno dialogowe. Dokumentacja IBM dla wersji 32 opisuje instalację okien zapisanych w pakiecie .spd przez Extensions → Utilities → Install Custom Dialog (Compatibility mode) (IBM Corp., b.d.). Ponowna instalacja zastępuje starszą wersję okna. W polskiej wersji interfejsu nazwy mogą się różnić.
- Windows: uprawnienia. Według FAQ autora najczęstszy problem to instalacja bez uprawnień administratora (Hayes, b.d.). Na komputerze uczelnianym uruchom SPSS jako administrator albo poproś o to dział IT.
- Sprawdź menu. Po instalacji PROCESS pojawia się w Analyze → Regression.
Bez instalacji: składnia. Okno dialogowe nie jest konieczne (Hayes, b.d.). Otwórz plik makra dla składni (.sps) i uruchom go w całości. Makro działa wtedy do końca sesji SPSS. Autor poleca tę drogę jako przejrzystszą i łatwiejszą do powtórzenia. Poniższe polecenia zapisaliśmy według podręcznika (Hayes, 2022), ale nie uruchamialiśmy ich w SPSS.
Krok 2. Numer modelu wybierz z hipotezy
Najpierw narysuj model hipotez (zob. model badawczy – schemat hipotez), potem znajdź pasujący schemat w katalogu Hayesa (2022). Rysunek 1 pokazuje trzy modele z tego wpisu.
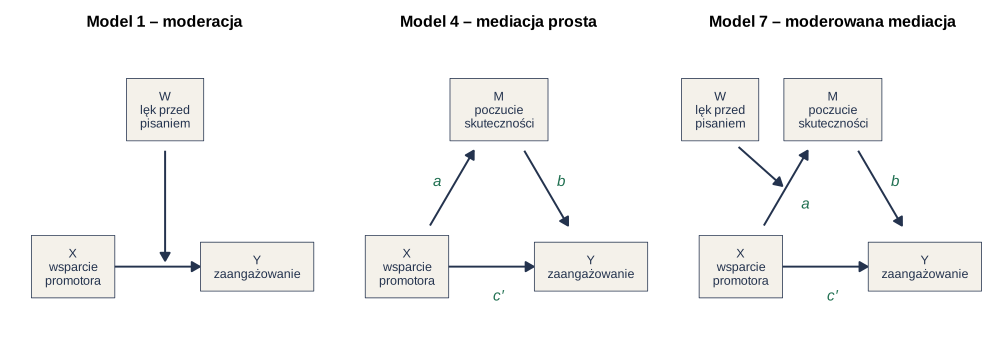
- Model 1 – czy związek X z Y zależy od W? Jedno równanie z iloczynem X × W.
- Model 4 – czy X wiąże się z Y przez M? Dwa równania i efekt pośredni ab.
- Model 7 – czy efekt pośredni zależy od W, bo W moderuje ścieżkę a? Efekt pośredni zmienia się z W, a testem jest indeks moderowanej mediacji (Hayes, 2015).
Krok 3. Model 4: mediacja prosta
W oknie przenieś zaang do Y variable, wsparcie do X variable, a skut do Mediator(s) M. Wybierz Model number 4 i 5000 prób bootstrap. W opcjach poproś o model efektu całkowitego i efekty standaryzowane (od wersji 4 opcja stand zastąpiła effsize; Hayes, b.d.). Nazwy pól mogą się różnić między wersjami makra. Ta sama analiza w składni:
Model  : 4
    Y  : zaang
    X  : wsparcie
    M  : skut

Sample
Size:  240

OUTCOME VARIABLE:
 skut

Model
                 coeff         se          t          p       LLCI       ULCI
constant       20.6718     1.1894    17.3799      .0000    18.3287    23.0150
wsparcie        1.1346      .2536     4.4742      .0000      .6351     1.6342

OUTCOME VARIABLE:
 zaang

Model
                 coeff         se          t          p       LLCI       ULCI
constant        1.2866      .3188     4.0355      .0001      .6585     1.9147
wsparcie         .0561      .0470     1.1930      .2341     -.0365      .1486
skut             .1260      .0115    10.9241      .0000      .1033      .1487

************** TOTAL, DIRECT, AND INDIRECT EFFECTS OF X ON Y **************

Total effect of X on Y
                Effect         se          t          p       LLCI       ULCI
                 .1990      .0552     3.6044      .0004      .0902      .3078

Direct effect of X on Y
                Effect         se          t          p       LLCI       ULCI
                 .0561      .0470     1.1930      .2341     -.0365      .1486

Indirect effect(s) of X on Y:
                Effect     BootSE   BootLLCI   BootULCI
skut .1430 .0310 .0840 .2058set.seed(2941)); układ jak w wydruku tekstowym PROCESS, a nie zrzut z SPSS. Granice bootstrapowe (BootSE, BootLLCI, BootULCI) różnią się między uruchomieniami, więc w SPSS dostaniesz nieco inne wartości.Jak czytać. Pierwsze równanie (OUTCOME VARIABLE: skut) daje ścieżkę a = 1.13: wyższe wsparcie wiązało się z wyższym poczuciem skuteczności. Drugie równanie daje b = 0.13 (wiersz skut) i c′ = 0.06 (wiersz wsparcie). Najważniejsza jest ostatnia część. Efekt pośredni ab = 0.14 ma przedział bootstrapowy [0.08, 0.21] bez zera. Efekt bezpośredni 0.06 jest nieistotny, a efekt całkowity 0.20 = 0.06 + 0.14. Efekt pośredni nie ma wartości p, więc wnioskujesz z przedziału (Preacher i Hayes, 2008). Opcja stand=1 doda też efekt w pełni standaryzowany (tu 0.16, 95% CI [0.10, 0.23]).
Krok 4. Model 1: moderacja
Przenieś lek do pola moderatora W, wybierz model 1 i zaznacz centrowanie zmiennych tworzących iloczyn. Autor nie uważa centrowania za konieczne, ale zaleca opcję center zamiast ręcznego liczenia nowych zmiennych (Hayes, b.d.). Opcja jn=1 dodaje przedział Johnsona–Neymana.
Model  : 1
    Y  : zaang
    X  : wsparcie
    W  : lek

Sample
Size:  240

OUTCOME VARIABLE:
 zaang

Model
                 coeff         se          t          p       LLCI       ULCI
constant        4.8015      .0634    75.7820      .0000     4.6767     4.9263
wsparcie         .2064      .0543     3.8020      .0002      .0995      .3134
lek             -.1745      .0827    -2.1089      .0360     -.3375     -.0115
Int_1            .2129      .0818     2.6022      .0098      .0517      .3741

Product terms key:
 Int_1    :        wsparcie x        lek

Test(s) of highest order unconditional interaction(s):
               R2-chng          F        df1        df2          p
 X*W             .0259     6.7714     1.0000   236.0000      .0098

Conditional effects of the focal predictor at values of the moderator(s):
                   lek     Effect         se          t          p       LLCI       ULCI
                -.6967      .0581      .0754      .7698      .4422     -.0905      .2067
                -.0967      .1858      .0542     3.4273      .0007      .0790      .2926
.7033 .3562 .0823 4.3287 .0000 .1941 .5183lek po wycentrowaniu. Liczby z R (metoda równoważna, bootstrap 5000 prób, set.seed(2941)), układ jak w PROCESS; granice bootstrapowe różnią się między uruchomieniami.Jak czytać. Wiersz Int_1 to iloczyn wsparcia i lęku (klucz pod tabelą to wyjaśnia). Współczynnik 0.21 z przedziałem [0.05, 0.37] oznacza, że związek wsparcia z zaangażowaniem rośnie z poziomem lęku. R2-chng: interakcja dodała 2.6% wyjaśnionej wariancji. Po centrowaniu współczynnik wsparcie (0.21) to efekt wsparcia przy średnim lęku, a nie przy lęku równym zero.
Wartości moderatora. Domyślnie PROCESS liczy efekty warunkowe przy 16., 50. i 84. percentylu W, a opcja moments=1 zmienia je na M − 1 SD, M i M + 1 SD (Hayes, 2022). Po centrowaniu kolumna lek pokazuje odchylenia od średniej (2.90). Wartości −.6967, −.0967 i .7033 to więc lęk 2.20, 2.80 i 3.60. Przy niskim lęku wsparcie nie wiązało się z zaangażowaniem (p = .442), przy średnim i wysokim – tak. Według granicy Johnsona–Neymana efekt jest istotny od lęku 2.49 w górę, czyli dla około 69% próby. Sprawdzisz ją w kalkulatorze Johnsona–Neymana. Interakcja jest sondowana domyślnie tylko przy p ≤ .10 – próg zmienia opcja intprobe (Hayes, b.d.).
Krok 5. Model 7: moderowana mediacja
X, M i Y zostają jak w modelu 4, a lęk trafia do W jako moderator ścieżki a.
Model  : 7
    Y  : zaang
    X  : wsparcie
    M  : skut
    W  : lek

Sample
Size:  240

OUTCOME VARIABLE:
 skut

Model
                 coeff         se          t          p       LLCI       ULCI
constant       25.8514      .2750    93.9931      .0000    25.3096    26.3933
wsparcie        1.1362      .2357     4.8210      .0000      .6719     1.6004
lek            -2.0671      .3591    -5.7558      .0000    -2.7746    -1.3596
Int_1            .8854      .3552     2.4928      .0134      .1857     1.5852

Product terms key:
 Int_1    :        wsparcie x        lek

OUTCOME VARIABLE:
 zaang

(równanie Y jak w modelu 4 – pominięte)

****************** DIRECT AND INDIRECT EFFECTS OF X ON Y *****************

Direct effect of X on Y
                Effect         se          t          p       LLCI       ULCI
                 .0561      .0470     1.1930      .2341     -.0365      .1486

Conditional indirect effects of X on Y:

INDIRECT EFFECT:
 wsparcie    ->    skut    ->    zaang

                   lek     Effect     BootSE   BootLLCI   BootULCI
                -.6967      .0654      .0359     -.0014      .1400
                -.0967      .1324      .0298      .0769      .1928
                 .7033      .2216      .0444      .1406      .3147

Index of moderated mediation:
                 Index     BootSE   BootLLCI   BootULCI
lek .1116 .0379 .0388 .1884set.seed(2941)), układ jak w PROCESS; granice bootstrapowe różnią się między uruchomieniami.Jak czytać. W równaniu skuteczności Int_1 = 0.89 (p = .013): wsparcie silniej wiązało się z poczuciem skuteczności u osób z wyższym lękiem. Równanie zaangażowania ma te same b i c′ co w modelu 4 (inna jest tylko stała, bo wsparcie wycentrowano). Niżej masz warunkowe efekty pośrednie, czyli a(W) × b przy trzech wartościach lęku. Przy lęku 2.20 przedział [−0.001, 0.140] obejmuje zero, a przy 2.80 i 3.60 już nie.
Testem moderowanej mediacji jest jednak indeks, a nie porównanie trzech przedziałów. Indeks = 0.11, 95% CI [0.04, 0.19], więc efekt pośredni rósł o 0.11 z każdym punktem lęku (Hayes, 2015). PROCESS podaje indeks, gdy efekt pośredni jest liniową funkcją jednego moderatora (Hayes, b.d.). Wybór między modelami 7, 14 i 58 omawia poradnik o moderowanej mediacji w R, a kilka mediatorów naraz – mediacja równoległa i szeregowa.
Dlaczego granice bootstrapu zmieniają się między uruchomieniami
Bootstrap 5000 razy losuje osoby ze zwracaniem i szacuje model od nowa, więc BootSE, BootLLCI i BootULCI zależą od losowania. Ten sam model 7 z innym ziarnem dał w R indeks z przedziałem [0.04, 0.19], ale z dolną granicą .0405 zamiast .0388. Od wersji 3 PROCESS liczy domyślnie przedziały percentylowe. Przedziały z korekcją obciążenia daje opcja bc, a przedziałów BCa makro nie liczy (Hayes, b.d.). Żeby dostać identyczny wynik przy ponownym uruchomieniu, ustaw ziarno (seed).
W pracy podaj wersję PROCESS, numer modelu, liczbę prób, rodzaj przedziału i ziarno. Twoje granice z SPSS nie będą identyczne z wydrukami na tej stronie, bo SPSS i R mają inne generatory liczb losowych. Współczynniki, SE i p z regresji powinny się zgadzać co do czwartego miejsca po kropce. Jeśli masz tylko a, b i ich błędy standardowe, bez surowych danych, przedział policzysz w kalkulatorze efektu pośredniego Monte Carlo.
Zapis wyników w stylu APA
Według FAQ autora jedynym właściwym źródłem do zacytowania PROCESS jest podręcznik Hayesa (2022), a nie starsze artykuły ani dokumentacja (Hayes, b.d.). Hayes i Rockwood (2017) pokazują, jak zwięźle opisać takie modele w artykule. Wyniki kilku ścieżek zbierzesz w tabeli mediacji w APA, a pojedyncze zdania – w generatorze opisu wyników APA.
W badaniu z jednego pomiaru pisz o związkach, nie o wpływie. Modele z PROCESS dają wnioski przyczynowe tylko przy mocnych założeniach o braku pominiętych zmiennych (Rohrer i in., 2022). Inne analizy dobierzesz w kreatorze doboru testu.
Te same liczby w R
SPSS ani PROCESS nie były używane przy przygotowaniu tej strony. Wszystkie liczby z wydruków 1–3 policzyliśmy w R metodą równoważną: regresja MNK dla każdego równania, efekty warunkowe θ = b1 + b3W z błędem standardowym z macierzy kowariancji współczynników oraz percentylowy bootstrap (losowanie osób ze zwracaniem, 5000 prób, ustalone ziarno). Percentyle moderatora liczy funkcja quantile() z domyślną definicją R; przy innych danych PROCESS może wyznaczyć je nieco inaczej. Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych. Przepis 1 tworzy plik CSV i plik .sav (pakiet haven).
1. Dane: CSV i plik SPSS .sav z etykietami
R
# B294 – dane przykładowe: wsparcie promotora, poczucie skuteczności, lęk przed pisaniem
# i zaangażowanie w pisanie pracy (dane symulowane, set.seed(2941)); plik CSV i plik SPSS .sav
suppressPackageStartupMessages(library(haven))
set.seed(2941)
n <- 240
stopien  <- sample(1:2, n, replace = TRUE, prob = c(.55, .45))        # 1 = licencjackie, 2 = magisterskie
wsparcie <- round(pmin(pmax(rnorm(n, 4.6, 1.15), 1), 7) * 4) / 4         # wsparcie promotora (średnia 4 pozycji, 1–7)
lek      <- round(pmin(pmax(rnorm(n, 2.9, 0.80), 1), 5) * 5) / 5         # lęk przed pisaniem (średnia 5 pozycji, 1–5)
wc <- wsparcie - 4.6; lc <- lek - 2.9
skut     <- round(pmin(pmax(26 + 1.5 * wc - 1.6 * lc + 1.2 * wc * lc + rnorm(n, 0, 4.2), 10), 40))  # skuteczność (10–40)
zaang    <- round(pmin(pmax(1.6 + 0.10 * skut + 0.12 * wsparcie + 0.15 * wc * lc + rnorm(n, 0, 0.85), 1), 7), 2)    # zaangażowanie (1–7)
dane <- data.frame(id = 1:n, stopien, wsparcie, lek, skut, zaang)
write.csv(dane, "../mediacja-moderacja-process-dane.csv", row.names = FALSE)

sav <- dane
sav$stopien <- labelled(sav$stopien, c("licencjackie" = 1, "magisterskie" = 2), label = "Stopień studiów")
attr(sav$id, "label")       <- "Numer osoby"
attr(sav$wsparcie, "label") <- "Wsparcie promotora (1–7)"
attr(sav$lek, "label")      <- "Lęk przed pisaniem (1–5)"
attr(sav$skut, "label")     <- "Poczucie skuteczności w pisaniu (10–40)"
attr(sav$zaang, "label")    <- "Zaangażowanie w pisanie pracy (1–7)"
write_sav(sav, "../mediacja-moderacja-process-dane.sav")

table(stopien = dane$stopien)
round(sapply(dane[, c("wsparcie", "lek", "skut", "zaang")], function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2)
round(cor(dane[, c("wsparcie", "lek", "skut", "zaang")]), 2)
Wynik w R
stopien
  1   2
134 106
    wsparcie  lek  skut zaang
M       4.54 2.90 25.82  4.80
SD      1.17 0.77  4.78  1.03
min     1.00 1.00 13.00  2.06
max     7.00 5.00 39.00  7.00
         wsparcie   lek  skut zaang
wsparcie     1.00 -0.03  0.28  0.23
lek         -0.03  1.00 -0.35 -0.15
skut         0.28 -0.35  1.00  0.60
zaang        0.23 -0.15  0.60  1.00
2. Model 4: równania MNK, efekt całkowity, bezpośredni i pośredni z bootstrapem
R
# Model 4 (mediacja prosta): wsparcie -> skut -> zaang; MNK + percentylowy bootstrap 5000 prób
dane <- read.csv("../mediacja-moderacja-process-dane.csv")
# Pomocnicze: liczby w stylu wydruku PROCESS (4 miejsca, bez zera przed kropką)
f4 <- function(x, w = 11) { s <- formatC(x, format = "f", digits = 4, width = w)
  sub("^( *)0\\.", "\\1 .", sub("^( *)-0\\.", "\\1 -.", s)) }
wiersz <- function(nazwa, x) cat(formatC(nazwa, width = -11), paste(f4(x), collapse = ""), "\n", sep = "")
naglowek <- function(h) cat(formatC("", width = 11), paste(formatC(h, width = 11), collapse = ""), "\n", sep = "")
model_summary <- function(m) {
  s <- summary(m); fs <- s$fstatistic
  cat("Model Summary\n"); naglowek(c("R", "R-sq", "MSE", "F", "df1", "df2", "p"))
  wiersz("", c(sqrt(s$r.squared), s$r.squared, s$sigma^2, fs[1], fs[2], fs[3], pf(fs[1], fs[2], fs[3], lower.tail = FALSE)))
}
model_coef <- function(m) {
  s <- summary(m); ci <- confint(m)
  cat("Model\n"); naglowek(c("coeff", "se", "t", "p", "LLCI", "ULCI"))
  nz <- sub("\\(Intercept\\)", "constant", sub("wsparcie:lek", "Int_1", rownames(coef(s))))
  for (i in seq_len(nrow(coef(s)))) wiersz(nz[i], c(coef(s)[i, ], ci[i, ]))
}
# Bootstrap: losowanie osób ze zwracaniem, ponowne MNK, percentyle 2.5 i 97.5
bootstrap <- function(d, stat, B = 5000, seed) {
  set.seed(seed)
  t(replicate(B, stat(d[sample(nrow(d), replace = TRUE), ])))
}

ma <- lm(skut ~ wsparcie, data = dane)
my <- lm(zaang ~ wsparcie + skut, data = dane)
mc <- lm(zaang ~ wsparcie, data = dane)
cat("OUTCOME VARIABLE:\n skut\n\n"); model_summary(ma); cat("\n"); model_coef(ma)
cat("\nOUTCOME VARIABLE:\n zaang\n\n"); model_summary(my); cat("\n"); model_coef(my)
cat("\n************************** TOTAL EFFECT MODEL ****************************\n")
model_summary(mc); cat("\n"); model_coef(mc)

a <- coef(ma)["wsparcie"]; b <- coef(my)["skut"]
ind <- function(d) {
  a <- coef(lm(skut ~ wsparcie, data = d))["wsparcie"]
  b <- coef(lm(zaang ~ wsparcie + skut, data = d))["skut"]
  c(ab = unname(a * b), ab_std = unname(a * b * sd(d$wsparcie) / sd(d$zaang)))
}
bt <- bootstrap(dane, ind, B = 5000, seed = 2941)
cat("\n************** TOTAL, DIRECT, AND INDIRECT EFFECTS OF X ON Y **************\n")
cat("\nTotal effect of X on Y\n"); naglowek(c("Effect", "se", "t", "p", "LLCI", "ULCI"))
wiersz("", c(coef(summary(mc))["wsparcie", ], confint(mc)["wsparcie", ]))
cat("\nDirect effect of X on Y\n"); naglowek(c("Effect", "se", "t", "p", "LLCI", "ULCI"))
wiersz("", c(coef(summary(my))["wsparcie", ], confint(my)["wsparcie", ]))
cat("\nIndirect effect(s) of X on Y:\n"); naglowek(c("Effect", "BootSE", "BootLLCI", "BootULCI"))
wiersz("skut", c(a * b, sd(bt[, "ab"]), quantile(bt[, "ab"], c(.025, .975))))
cat("\nCompletely standardized indirect effect(s) of X on Y:\n"); naglowek(c("Effect", "BootSE", "BootLLCI", "BootULCI"))
wiersz("skut", c(a * b * sd(dane$wsparcie) / sd(dane$zaang), sd(bt[, "ab_std"]), quantile(bt[, "ab_std"], c(.025, .975))))
# Kontrola: c = c' + ab
round(c(c = unname(coef(mc)["wsparcie"]), c_prim = unname(coef(my)["wsparcie"]), ab = unname(a * b)), 4)
# Zmienność bootstrapu: te same dane, inne ziarno
bt2 <- bootstrap(dane, ind, B = 5000, seed = 7)
round(quantile(bt2[, "ab"], c(.025, .975)), 4)
Wynik w R
OUTCOME VARIABLE:
 skut

Model Summary
                     R       R-sq        MSE          F        df1        df2          p
                 .2785      .0776    21.1561    20.0181     1.0000   238.0000      .0000

Model
                 coeff         se          t          p       LLCI       ULCI
constant       20.6718     1.1894    17.3799      .0000    18.3287    23.0150
wsparcie        1.1346      .2536     4.4742      .0000      .6351     1.6342

OUTCOME VARIABLE:
 zaang

Model Summary
                     R       R-sq        MSE          F        df1        df2          p
                 .6077      .3693      .6699    69.3932     2.0000   237.0000      .0000

Model
                 coeff         se          t          p       LLCI       ULCI
constant        1.2866      .3188     4.0355      .0001      .6585     1.9147
wsparcie         .0561      .0470     1.1930      .2341     -.0365      .1486
skut             .1260      .0115    10.9241      .0000      .1033      .1487

************************** TOTAL EFFECT MODEL ****************************
Model Summary
                     R       R-sq        MSE          F        df1        df2          p
                 .2275      .0518     1.0029    12.9914     1.0000   238.0000      .0004

Model
                 coeff         se          t          p       LLCI       ULCI
constant        3.8912      .2590    15.0258      .0000     3.3811     4.4014
wsparcie         .1990      .0552     3.6044      .0004      .0902      .3078

************** TOTAL, DIRECT, AND INDIRECT EFFECTS OF X ON Y **************

Total effect of X on Y
                Effect         se          t          p       LLCI       ULCI
                 .1990      .0552     3.6044      .0004      .0902      .3078

Direct effect of X on Y
                Effect         se          t          p       LLCI       ULCI
                 .0561      .0470     1.1930      .2341     -.0365      .1486

Indirect effect(s) of X on Y:
                Effect     BootSE   BootLLCI   BootULCI
skut             .1430      .0310      .0840      .2058

Completely standardized indirect effect(s) of X on Y:
                Effect     BootSE   BootLLCI   BootULCI
skut             .1634      .0339      .0968      .2302
     c c_prim     ab
0.1990 0.0561 0.1430
  2.5%  97.5%
0.0853 0.2085
3. Model 1: interakcja, R2-chng, efekty warunkowe i granica Johnsona–Neymana
R
# Model 1 (moderacja): czy związek wsparcia z zaangażowaniem zależy od lęku przed pisaniem?
# Odpowiednik opcji center=1: X i W wycentrowane przed utworzeniem iloczynu (korzysta z funkcji z przepisu 2)
dane <- read.csv("../mediacja-moderacja-process-dane.csv")
d <- transform(dane, wsparcie = wsparcie - mean(wsparcie), lek = lek - mean(lek))
m1 <- lm(zaang ~ wsparcie * lek, data = d)
m0 <- lm(zaang ~ wsparcie + lek, data = d)
cat("OUTCOME VARIABLE:\n zaang\n\n"); model_summary(m1); cat("\n"); model_coef(m1)
r2 <- summary(m1)$r.squared - summary(m0)$r.squared; an <- anova(m0, m1)
cat("\nTest(s) of highest order unconditional interaction(s):\n"); naglowek(c("R2-chng", "F", "df1", "df2", "p"))
wiersz(" X*W", c(r2, an$F[2], an$Df[2], an$Res.Df[2], an$`Pr(>F)`[2]))
# Efekty warunkowe X: theta = b1 + b3 * W, SE z wariancji i kowariancji współczynników
efekt_warunkowy <- function(m, w) {
  b <- coef(m); V <- vcov(m); df <- m$df.residual
  th <- b["wsparcie"] + b["wsparcie:lek"] * w
  se <- sqrt(V["wsparcie", "wsparcie"] + w^2 * V["wsparcie:lek", "wsparcie:lek"] + 2 * w * V["wsparcie", "wsparcie:lek"])
  t <- th / se; q <- qt(.975, df)
  cbind(w, th, se, t, 2 * pt(-abs(t), df), th - q * se, th + q * se)
}
pokaz <- function(tab) { naglowek(c("lek", "Effect", "se", "t", "p", "LLCI", "ULCI"))
  for (i in seq_len(nrow(tab))) cat(formatC("", width = 11), paste(f4(tab[i, ]), collapse = ""), "\n", sep = "") }
cat("\nConditional effects of the focal predictor at values of the moderator(s):\n")
pokaz(efekt_warunkowy(m1, quantile(d$lek, c(.16, .50, .84))))           # domyślnie: 16., 50. i 84. percentyl W
cat("\nTo samo przy M - 1 SD, M i M + 1 SD (odpowiednik moments=1):\n")
pokaz(efekt_warunkowy(m1, c(-1, 0, 1) * sd(d$lek)))
# Wartości W na skali surowej (dodaj średnią lęku)
round(c(srednia_lek = mean(dane$lek), quantile(dane$lek, c(.16, .50, .84)), M_minus_SD = mean(dane$lek) - sd(dane$lek), M_plus_SD = mean(dane$lek) + sd(dane$lek)), 2)
# Granica Johnsona–Neymana: wartość W, przy której p efektu warunkowego = .05 (skala surowa)
jn <- function(w) { e <- efekt_warunkowy(m1, w); e[, 4]^2 - qt(.975, m1$df.residual)^2 }
siatka <- seq(min(d$lek), max(d$lek), by = .001); zm <- which(diff(sign(jn(siatka))) != 0)
gr <- sapply(zm, function(i) uniroot(jn, c(siatka[i], siatka[i + 1]))$root)
round(c(granica_JN = gr + mean(dane$lek), procent_ponizej = 100 * mean(d$lek < gr)), 2)
Wynik w R
OUTCOME VARIABLE:
 zaang

Model Summary
                     R       R-sq        MSE          F        df1        df2          p
                 .3132      .0981      .9620     8.5550     3.0000   236.0000      .0000

Model
                 coeff         se          t          p       LLCI       ULCI
constant        4.8015      .0634    75.7820      .0000     4.6767     4.9263
wsparcie         .2064      .0543     3.8020      .0002      .0995      .3134
lek             -.1745      .0827    -2.1089      .0360     -.3375     -.0115
Int_1            .2129      .0818     2.6022      .0098      .0517      .3741

Test(s) of highest order unconditional interaction(s):
               R2-chng          F        df1        df2          p
 X*W             .0259     6.7714     1.0000   236.0000      .0098

Conditional effects of the focal predictor at values of the moderator(s):
                   lek     Effect         se          t          p       LLCI       ULCI
                -.6967      .0581      .0754      .7698      .4422     -.0905      .2067
                -.0967      .1858      .0542     3.4273      .0007      .0790      .2926
                 .7033      .3562      .0823     4.3287      .0000      .1941      .5183

To samo przy M - 1 SD, M i M + 1 SD (odpowiednik moments=1):
                   lek     Effect         se          t          p       LLCI       ULCI
                -.7695      .0426      .0797      .5341      .5938     -.1145      .1996
                 .0000      .2064      .0543     3.8020      .0002      .0995      .3134
                 .7695      .3703      .0864     4.2837      .0000      .2000      .5405
srednia_lek         16%         50%         84%  M_minus_SD   M_plus_SD
       2.90        2.20        2.80        3.60        2.13        3.67
     granica_JN procent_ponizej
           2.49           30.83
4. Model 7: warunkowe efekty pośrednie i indeks moderowanej mediacji
R
# Model 7 (moderowana mediacja): lęk moderuje ścieżkę a (wsparcie -> skut); korzysta z funkcji z przepisów 2–3
dane <- read.csv("../mediacja-moderacja-process-dane.csv")
d <- transform(dane, wsparcie = wsparcie - mean(wsparcie), lek = lek - mean(lek))   # center=1
ma <- lm(skut ~ wsparcie * lek, data = d)
my <- lm(zaang ~ wsparcie + skut, data = d)
cat("OUTCOME VARIABLE:\n skut\n\n"); model_summary(ma); cat("\n"); model_coef(ma)
r2 <- summary(ma)$r.squared - summary(lm(skut ~ wsparcie + lek, data = d))$r.squared
cat("\nR2-chng dla Int_1:", f4(r2), "\n")
cat("\nOUTCOME VARIABLE:\n zaang\n\n"); model_summary(my); cat("\n"); model_coef(my)
wq <- quantile(d$lek, c(.16, .50, .84))
stat7 <- function(x) {
  a <- coef(lm(skut ~ wsparcie * lek, data = x)); b <- coef(lm(zaang ~ wsparcie + skut, data = x))["skut"]
  c(unname((a["wsparcie"] + a["wsparcie:lek"] * wq) * b), indeks = unname(a["wsparcie:lek"] * b))
}
est <- stat7(d)
bt <- bootstrap(d, stat7, B = 5000, seed = 2941)
cat("\n****************** DIRECT AND INDIRECT EFFECTS OF X ON Y *****************\n")
cat("\nDirect effect of X on Y\n"); naglowek(c("Effect", "se", "t", "p", "LLCI", "ULCI"))
wiersz("", c(coef(summary(my))["wsparcie", ], confint(my)["wsparcie", ]))
cat("\nConditional indirect effects of X on Y:\n\nINDIRECT EFFECT:\n wsparcie    ->    skut    ->    zaang\n\n")
naglowek(c("lek", "Effect", "BootSE", "BootLLCI", "BootULCI"))
for (i in 1:3) cat(formatC("", width = 11), paste(f4(c(wq[i], est[i], sd(bt[, i]), quantile(bt[, i], c(.025, .975)))), collapse = ""), "\n", sep = "")
cat("\nIndex of moderated mediation:\n"); naglowek(c("Index", "BootSE", "BootLLCI", "BootULCI"))
wiersz("lek", c(est[4], sd(bt[, 4]), quantile(bt[, 4], c(.025, .975))))
# Inne ziarno: granice przesuwają się w trzecim miejscu po kropce
bt2 <- bootstrap(d, stat7, B = 5000, seed = 7)
round(quantile(bt2[, 4], c(.025, .975)), 4)
Wynik w R
OUTCOME VARIABLE:
 skut

Model Summary
                     R       R-sq        MSE          F        df1        df2          p
                 .4650      .2163    18.1277    21.7074     3.0000   236.0000      .0000

Model
                 coeff         se          t          p       LLCI       ULCI
constant       25.8514      .2750    93.9931      .0000    25.3096    26.3933
wsparcie        1.1362      .2357     4.8210      .0000      .6719     1.6004
lek            -2.0671      .3591    -5.7558      .0000    -2.7746    -1.3596
Int_1            .8854      .3552     2.4928      .0134      .1857     1.5852

R2-chng dla Int_1:       .0206

OUTCOME VARIABLE:
 zaang

Model Summary
                     R       R-sq        MSE          F        df1        df2          p
                 .6077      .3693      .6699    69.3932     2.0000   237.0000      .0000

Model
                 coeff         se          t          p       LLCI       ULCI
constant        1.5412      .3025     5.0944      .0000      .9452     2.1371
wsparcie         .0561      .0470     1.1930      .2341     -.0365      .1486
skut             .1260      .0115    10.9241      .0000      .1033      .1487

****************** DIRECT AND INDIRECT EFFECTS OF X ON Y *****************

Direct effect of X on Y
                Effect         se          t          p       LLCI       ULCI
                 .0561      .0470     1.1930      .2341     -.0365      .1486

Conditional indirect effects of X on Y:

INDIRECT EFFECT:
 wsparcie    ->    skut    ->    zaang

                   lek     Effect     BootSE   BootLLCI   BootULCI
                -.6967      .0654      .0359     -.0014      .1400
                -.0967      .1324      .0298      .0769      .1928
                 .7033      .2216      .0444      .1406      .3147

Index of moderated mediation:
                 Index     BootSE   BootLLCI   BootULCI
lek              .1116      .0379      .0388      .1884
  2.5%  97.5%
0.0405 0.1911
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych programów i pakietów (w R: sessionInfo()), a dla PROCESS – numer wersji makra.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files (R package version 2.5.5) [Computer software]. https://CRAN.R-project.org/package=haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy z PROCESS w SPSS
- Numer modelu dobrany po obejrzeniu wyników – to ukryte wielokrotne testowanie.
- Szukanie p dla efektu pośredniego albo wnioskowanie z testu Sobela. Wnioskuj z przedziału bootstrapowego.
- Moderowana mediacja z porównania przedziałów („przy niskim W nieistotny, przy wysokim istotny”) zamiast z indeksu.
- Przepisanie wartości W z kolumny po centrowaniu jako surowych („lęk = −0.70”). Dodaj średnią.
- Brak ziarna i liczby prób w opisie.
- Dzielenie ciągłego moderatora medianą zamiast modelu 1 z ciągłym W (zob. dzielenie medianą).
Jeśli chcesz, żeby ktoś sprawdził wybór modelu PROCESS i opis wyników w Twojej pracy, zajrzyj do oferty analizy statystyczne dla studentów.
Najczęstsze pytania
Skąd pobrać makro PROCESS do SPSS i czy jest darmowe?
Tylko ze strony autora, afhayes.com – dawna domena processmacro.org została tam przeniesiona. Makro jest bezpłatne do użytku w niezmienionej postaci, ale użycie komercyjne wymaga zgody autora. Nie wolno też udostępniać kopii makra na publicznych stronach i serwerach (Hayes, b.d.). W listopadzie 2026 r. aktualna była wersja 5.1, wymagająca SPSS 26 lub nowszego.
Dlaczego po instalacji nie widzę PROCESS w menu SPSS?
Na Windows najczęstszą przyczyną jest instalacja okna dialogowego bez uprawnień administratora (Hayes, b.d.). Uruchom SPSS jako administrator i zainstaluj okno ponownie przez Extensions → Utilities → Install Custom Dialog (Compatibility mode) (IBM Corp., b.d.). PROCESS powinien pojawić się w Analyze → Regression. Jeśli nie masz uprawnień, uruchom makro ze składni – okno dialogowe nie jest do tego potrzebne.
Dlaczego BootLLCI i BootULCI w moim wydruku PROCESS różnią się od wyniku kolegi?
Bo przedział bootstrapowy powstaje z losowania osób ze zwracaniem, a każde uruchomienie losuje inne próby. Różnice zwykle dotyczą trzeciego miejsca po kropce. Żeby uzyskać ten sam wynik przy ponownym uruchomieniu, ustaw ziarno generatora (opcja seed) i podaj je w pracy razem z liczbą prób (Hayes, b.d.).
Model 7 czy model 14 w PROCESS – jak wybrać przy moderowanej mediacji w SPSS?
Ten, który odpowiada Twojej hipotezie. Jeśli moderator zmienia związek X z mediatorem (ścieżkę a), to model 7. Jeśli zmienia związek mediatora z Y (ścieżkę b), to model 14. Numer wybierz z rysunku modelu przed analizą, korzystając z katalogu modeli w podręczniku Hayesa (2022), a nie po obejrzeniu wyników.
Jak zacytować makro PROCESS w pracy dyplomowej?
Według FAQ autora jedynym właściwym źródłem jest podręcznik: Hayes (2022), Introduction to mediation, moderation, and conditional process analysis (3rd ed.). W metodzie podaj też wersję makra, numer modelu, liczbę prób bootstrap, rodzaj przedziału (domyślnie percentylowy) i ziarno.
Powiązane hasła
Przeczytaj też
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikModerowana mediacja i modele PROCESS w R
Modele 7, 14 i 58, indeks moderowanej mediacji, efekty warunkowe z bootstrapem, lavaan i analiza wrażliwości – z kodem R i wzorem opisu APA.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →Masz wydruk z PROCESS i nie wiesz, co z niego przepisać?
Sprawdzimy dobór modelu, ustawienia bootstrapu i centrowania oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hayes, A. F. (2015). An index and test of linear moderated mediation. Multivariate Behavioral Research, 50(1), 1–22. https://doi.org/10.1080/00273171.2014.962683
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Hayes, A. F. (b.d.). The PROCESS macro for SPSS, SAS, and R: Download, FAQ and version history. afhayes.com. Pobrano 1 listopada 2026 z https://www.afhayes.com/download.html ● Otwarty dostęp
- Hayes, A. F., & Rockwood, N. J. (2017). Regression-based statistical mediation and moderation analysis in clinical research: Observations, recommendations, and implementation. Behaviour Research and Therapy, 98, 39–57. https://doi.org/10.1016/j.brat.2016.11.001
- IBM Corp. (b.d.). Managing custom dialogs in compatibility mode. IBM SPSS Statistics 32.0.0 documentation. Pobrano 1 listopada 2026 z https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=dialogs-managing-custom-in-compatibility-mode ● Otwarty dostęp
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879 ● Otwarty dostęp
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
Cytowania BibTeX
@article{hayes2015index, author={Hayes, Andrew F.}, title={{An index and test of linear moderated mediation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={1}, pages={1--22}, doi={10.1080/00273171.2014.962683}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@misc{hayesndprocessmacro, author={Hayes, Andrew F.}, title={{The PROCESS macro for SPSS, SAS, and R: Download, FAQ and version history}}, howpublished={afhayes.com}, url={https://www.afhayes.com/download.html}}@article{hayes2017regression, author={Hayes, Andrew F. and Rockwood, Nicholas J.}, title={{Regression-based statistical mediation and moderation analysis in clinical research: Observations, recommendations, and implementation}}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={39--57}, doi={10.1016/j.brat.2016.11.001}}@misc{ibmnd32customdialogs, author={{IBM Corp.}}, title={{Managing custom dialogs in compatibility mode}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=dialogs-managing-custom-in-compatibility-mode}}@article{preacher2008asymptotic, author={Preacher, Kristopher J. and Hayes, Andrew F.}, title={{Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models}}, journal={Behavior Research Methods}, year={2008}, volume={40}, number={3}, pages={879--891}, doi={10.3758/brm.40.3.879}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}