Równolegle czy szeregowo? Decyduje teoria
W prostej mediacji jeden mediator przenosi część związku X z Y. Podstawy, czyli ścieżki a, b i c′, bootstrap oraz PROCESS w SPSS, omawia wpis analiza mediacji krok po kroku. Pokazuje on też na jednym przykładzie, czym różnią się model z dwoma mediatorami obok siebie i model z łańcuchem. Tutaj idziemy dalej: trzy mediatory naraz, wszystkie kontrasty, model szeregowy z trzema drogami pośrednimi i pułapki, na które trafia się w lavaan.
- Mediacja równoległa (w numeracji PROCESS model 4 z kilkoma mediatorami; Hayes, 2022): X wpływa na kilka mediatorów, a każdy z nich osobno na Y. Mediatory mogą być skorelowane, ale żaden nie wpływa na drugi. Pytanie brzmi: którymi drogami płynie efekt?
- Mediacja szeregowa, nazywana też sekwencyjną (model 6): mediatory tworzą łańcuch X → M1 → M2 → Y. Dochodzi ścieżka d21 z M1 do M2. Pytanie brzmi: czy efekt przechodzi przez kolejne ogniwa?
Oba modele są zwykle nasycone, czyli równie dobrze odtwarzają dane. Rohrer i in. (2022) przypominają, że ani dopasowanie, ani odwracanie strzałek nie rozstrzyga, który model jest prawdziwy. O wyborze decyduje teoria i kolejność pomiaru, zapisane przed analizą.
Przykład: samotność i objawy depresji
Trzysta osób studiujących wypełniło skale: samotności (X, 1–4), ruminacji (M1, 1–5), problemów ze snem (M2, 0–21), aktywności fizycznej w godzinach tygodniowo (M3) i objawów depresji (Y, 0–27). Dane są symulowane i dostępne w pliku CSV. Samotność korelowała z objawami depresji (r = .36), z ruminacjami (r = .48), z problemami ze snem (r = .30) i ujemnie z aktywnością (r = −.22).
Hipoteza równoległa zakłada trzy drogi: samotność nasila ruminacje i problemy ze snem oraz obniża aktywność, a wszystkie trzy zmienne wiążą się z objawami depresji. Hipoteza szeregowa zakłada łańcuch: samotność → ruminacje → problemy ze snem → depresja.
Krok 1. Model równoległy w lavaan
W pakiecie lavaan (Rosseel, 2012) każdą ścieżkę oznaczasz etykietą, a efekty pośrednie definiujesz operatorem := jako iloczyny ścieżek. Najważniejsze linie modelu wyglądają tak:
rum ~ a1 * samot;  sen ~ a2 * samot;  akt ~ a3 * samot
dep ~ b1 * rum + b2 * sen + b3 * akt + c_prim * samot
rum ~~ sen + akt;  sen ~~ akt          # kowariancje reszt mediatorów
ind_rum := a1 * b1;  ind_laczny := ind_rum + ind_sen + ind_akt
k_rum_sen := ind_rum - ind_sen         # kontrast
Pułapka: kowariancje reszt mediatorów. lavaan nie dodaje ich automatycznie, bo mediatory są jednocześnie predyktorami Y. Bez linii z ~~ model zakłada, że ruminacje, sen i aktywność po uwzględnieniu samotności nie są ze sobą powiązane. W przykładzie taki model ma χ²(3) = 22.62, p < .001, a RMSEA = .148. Nie jest to model równoległy z PROCESS, tylko model z dodatkowym, odrzuconym założeniem. Po dodaniu kowariancji reszt model ma 0 stopni swobody, tak jak w regresji.
Krok 2. Bootstrap i efekty pośrednie szczegółowe
Efekt pośredni to iloczyn, a jego rozkład zwykle nie jest normalny. Dlatego przedziały ufności liczysz bootstrapem (MacKinnon i in., 2004). W lavaan służą do tego argumenty se = "bootstrap" i bootstrap = 5000, a przedziały percentylowe zwraca parameterEstimates(fit, boot.ci.type = "perc"). Dodaliśmy też fixed.x = FALSE. W tej wersji lavaan przy domyślnym ustawieniu część prób bootstrapowych kończyła się błędem. Zawsze sprawdź, ile prób się udało. U nas 4999 z 5000.
| Parametr | Oszacowanie | 95% CI |
|---|---|---|
| a1: samotność → ruminacje | 0.750 | [0.581, 0.914] |
| a2: samotność → problemy ze snem | 2.057 | [1.318, 2.782] |
| a3: samotność → aktywność | −1.003 | [−1.461, −0.534] |
| b1: ruminacje → depresja | 1.052 | [0.455, 1.634] |
| b2: problemy ze snem → depresja | 0.341 | [0.217, 0.467] |
| b3: aktywność → depresja | −0.416 | [−0.586, −0.240] |
| c′: efekt bezpośredni | 1.022 | [0.036, 1.966] |
| Pośredni przez ruminacje (a1b1) | 0.790 | [0.317, 1.312] |
| Pośredni przez sen (a2b2) | 0.702 | [0.389, 1.102] |
| Pośredni przez aktywność (a3b3) | 0.417 | [0.172, 0.733] |
| Łączny efekt pośredni | 1.909 | [1.284, 2.593] |
| Efekt całkowity c | 2.931 | [2.085, 3.742] |
| Kontrast: ruminacje − sen | 0.087 | [−0.558, 0.724] |
| Kontrast: ruminacje − aktywność | 0.373 | [−0.158, 0.929] |
| Kontrast: sen − aktywność | 0.286 | [−0.171, 0.780] |
Wszystkie trzy efekty pośrednie szczegółowe są dodatnie, a ich przedziały nie obejmują zera. Droga przez aktywność też jest dodatnia, choć obie jej ścieżki są ujemne. Samotność obniża aktywność, a mniejsza aktywność wiąże się z silniejszymi objawami. Łączny efekt pośredni (1.909) to suma trzech dróg. Efekt całkowity (2.931) to suma efektu pośredniego i bezpośredniego. Wzrost samotności o 1 punkt wiąże się z objawami depresji wyższymi średnio o 2.93 punktu, z czego 1.91 punktu przypada na trzy badane drogi.
Krok 3. Kontrasty: czy któryś mediator przenosi więcej?
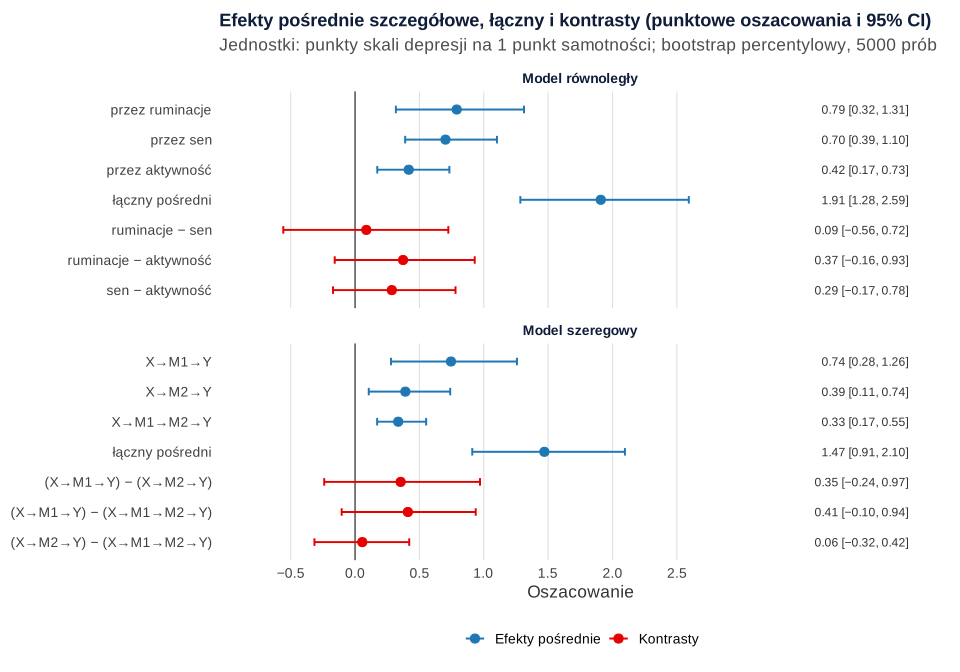
Preacher i Hayes (2008) opisują, jak porównywać efekty pośrednie w jednym modelu. Zamiast patrzeć na wartości p, liczysz różnicę dwóch efektów z przedziałem bootstrap. Przy trzech mediatorach są trzy kontrasty i żaden z nich nie wykluczył zera. Nawet różnica 0.373 między ruminacjami a aktywnością ma przedział [−0.158, 0.929]. Dane nie pozwalają więc twierdzić, że ruminacje są „najważniejszym” mediatorem, choć mają największe oszacowanie.
Często słychać, że kontrasty mają sens tylko przy mediatorach na tej samej skali. Efekt pośredni ab jest jednak wyrażony w jednostkach Y na jednostkę X, więc skala mediatora się skraca. W kodzie przemnożyliśmy problemy ze snem przez 10. Ścieżka a2 wzrosła do 20.572, b2 spadła do 0.034, a efekt pośredni pozostał równy 0.702. Skala mediatora ma znaczenie przy porównywaniu samych ścieżek a albo b, ale nie przy porównywaniu efektów pośrednich.
Do opisu wielkości efektu możesz dodać efekty w pełni standaryzowane (w SD Y na 1 SD X): 0.097 przez ruminacje, 0.086 przez sen, 0.051 przez aktywność i 0.233 łącznie, przy efekcie całkowitym 0.358 (zob. współczynniki standaryzowane czy niestandaryzowane).
Krok 4. Model szeregowy: trzy drogi pośrednie
W modelu szeregowym ruminacje wpływają na problemy ze snem (d21). Z dwoma mediatorami powstają trzy drogi: X → M1 → Y (a1b1), X → M2 → Y (a2b2) i X → M1 → M2 → Y (a1d21b2). Taylor i in. (2008) porównali w symulacji metody testowania drogi przez trzy ścieżki. Gdy potrzebny jest przedział ufności, zalecają bootstrap percentylowy albo z korektą obciążenia, przy czym ten drugi może nieco zawyżać błąd I rodzaju.
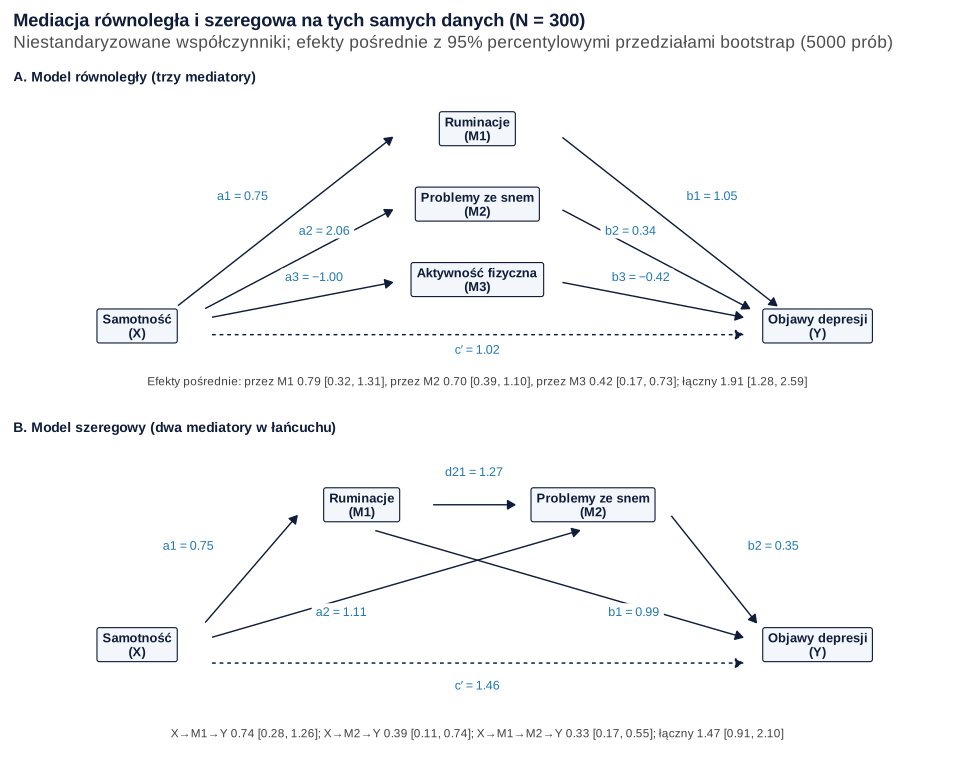
Ścieżka d21 wyniosła 1.266, 95% CI [0.801, 1.738]. Droga przez oba mediatory wyniosła 0.335, 95% CI [0.171, 0.552]. Droga tylko przez ruminacje wyniosła 0.745 [0.279, 1.258], a tylko przez sen 0.391 [0.106, 0.739]. Łączny efekt pośredni to 1.471 [0.910, 2.097], a efekt bezpośredni 1.460 [0.524, 2.394].
Porównaj to z modelem równoległym. Efekt całkowity jest ten sam (2.931), bo to wciąż regresja Y na X. Zmienił się podział: bez aktywności fizycznej w modelu łączny efekt pośredni zmalał, a bezpośredni wzrósł. Droga „tylko przez sen” zmalała z 0.702 do 0.391, bo część związku przejął łańcuch przez ruminacje. Wynik zależy więc od tego, które mediatory włączysz do modelu i w jakiej kolejności je ustawisz. Kontrasty trzech dróg również obejmowały zero (rysunek 2).
Bootstrap czy przedział Monte Carlo?
Alternatywą dla bootstrapu jest przedział ufności Monte Carlo. Losuje się wtedy ścieżki z ich rozkładu i mnoży je. Preacher i Selig (2012) pokazali, że działa porównywalnie z innymi uznanymi metodami i wymaga mniej obliczeń. Funkcja monteCarloCI() z pakietu semTools dała dla drogi przez oba mediatory przedział [0.162, 0.560] wobec [0.171, 0.552] z bootstrapu. Wybierz jedną metodę przed analizą i podaj ją w opisie.
Jak opisać mediację równoległą i szeregową w pracy
Podaj model (równoległy lub szeregowy, liczba mediatorów), program, liczbę prób bootstrap i rodzaj przedziału. Następnie opisz efekty szczegółowe, łączny efekt pośredni, efekt bezpośredni i kontrasty. Ścieżki zbierz w tabeli; wzór układu znajdziesz w haśle tabela mediacji w APA, a diagram – w haśle wykres ścieżkowy.
Mediacja równoległa i szeregowa w R (lavaan)
Kod odtwarza wszystkie liczby z tekstu i rysunków, a na początku zapisuje plik CSV do pobrania. Modele szacuje pakiet lavaan z bootstrapem (5000 prób, iseed zapewnia powtarzalność), a przedział Monte Carlo liczy pakiet semTools. Bootstrap obu modeli trwa kilka minut.
Model równoległy, szeregowy i kontrasty
R
# B186 – mediacja równoległa (3 mediatory) i szeregowa (2 mediatory) w lavaan z bootstrapem
# (dane symulowane, set.seed(1861)). 300 osób studiujących: samotność (X, 1–4), ruminacje (M1, 1–5),
# problemy ze snem (M2, 0–21), aktywność fizyczna (M3, godziny tygodniowo), objawy depresji (Y, 0–27).
suppressPackageStartupMessages({ library(lavaan); library(semTools) })
set.seed(1861)
n <- 300
ogr <- function(x, lo, hi) pmin(pmax(x, lo), hi)
samot <- round(ogr(rnorm(n, 2.2, 0.5), 1, 4), 2)
rum <- round(ogr(0.70 * samot + rnorm(n, 1.3, 0.7), 1, 5), 2)
sen <- round(ogr(1.40 * samot + 1.60 * rum + rnorm(n, 1.5, 3.0), 0, 21))
akt <- round(ogr(-1.30 * samot + rnorm(n, 8.0, 2.2), 0, 20), 1)
dep <- round(ogr(1.10 * rum + 0.30 * sen - 0.25 * akt + 0.90 * samot + rnorm(n, 1.5, 3.5), 0, 27))
dane <- data.frame(samot, rum, sen, akt, dep)
write.csv(dane, "../mediacja-rownolegla-szeregowa-dane.csv", row.names = FALSE)

# Krok 1. Statystyki opisowe i korelacje
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2)
round(cor(dane), 2)

# Krok 2. Model równoległy: trzy mediatory, kowariancje reszt mediatorów, efekty szczegółowe, łączny i kontrasty
m_rown <- '
  rum ~ a1 * samot
  sen ~ a2 * samot
  akt ~ a3 * samot
  dep ~ b1 * rum + b2 * sen + b3 * akt + c_prim * samot
  rum ~~ sen + akt
  sen ~~ akt
  ind_rum := a1 * b1
  ind_sen := a2 * b2
  ind_akt := a3 * b3
  ind_laczny := ind_rum + ind_sen + ind_akt
  calkowity := c_prim + ind_laczny
  k_rum_sen := ind_rum - ind_sen
  k_rum_akt := ind_rum - ind_akt
  k_sen_akt := ind_sen - ind_akt
'
# Pułapka: bez linii z „~~” lavaan zakłada nieskorelowane reszty mediatorów
bez_kow <- sem(gsub("  rum ~~ sen \\+ akt\n  sen ~~ akt\n", "", m_rown), data = dane)
round(fitMeasures(bez_kow, c("chisq", "df", "pvalue", "rmsea")), 3)
fit_r <- sem(m_rown, data = dane, fixed.x = FALSE, se = "bootstrap", bootstrap = 5000, iseed = 1861)
round(fitMeasures(fit_r, c("chisq", "df")), 3)
sum(complete.cases(lavInspect(fit_r, "boot")))      # liczba udanych prób bootstrap
pe_r <- parameterEstimates(fit_r, boot.ci.type = "perc")
pe_r$label[pe_r$label == ""] <- paste(pe_r$lhs, pe_r$op, pe_r$rhs)[pe_r$label == ""]
wiersze <- c("a1", "a2", "a3", "b1", "b2", "b3", "c_prim", "ind_rum", "ind_sen", "ind_akt", "ind_laczny",
             "calkowity", "k_rum_sen", "k_rum_akt", "k_sen_akt")
pr <- pe_r[match(wiersze, pe_r$label), c("label", "est", "ci.lower", "ci.upper", "pvalue")]
pr[, 2:5] <- round(pr[, 2:5], 3); pr

# Krok 3. Efekty pośrednie w pełni standaryzowane (SD Y na 1 SD X)
st_r <- standardizedSolution(fit_r)
st_r <- st_r[st_r$label %in% c("ind_rum", "ind_sen", "ind_akt", "ind_laczny", "c_prim", "calkowity"), c("label", "est.std")]
st_r$est.std <- round(st_r$est.std, 3); st_r

# Krok 4. Skala mediatora nie zmienia efektu pośredniego: problemy ze snem × 10 (te same liczby a2 × b2)
d10 <- transform(dane, sen = sen * 10)
a2_10 <- coef(lm(sen ~ samot, d10))["samot"]; b2_10 <- coef(lm(dep ~ rum + sen + akt + samot, d10))["sen"]
round(c(a2 = unname(a2_10), b2 = unname(b2_10), ind_sen = unname(a2_10 * b2_10)), 3)

# Krok 5. Model szeregowy: samotność → ruminacje → problemy ze snem → depresja
m_szer <- '
  rum ~ a1 * samot
  sen ~ a2 * samot + d21 * rum
  dep ~ b1 * rum + b2 * sen + c_prim * samot
  ind_X_rum_Y := a1 * b1
  ind_X_sen_Y := a2 * b2
  ind_X_rum_sen_Y := a1 * d21 * b2
  ind_laczny := ind_X_rum_Y + ind_X_sen_Y + ind_X_rum_sen_Y
  calkowity := c_prim + ind_laczny
  k1_2 := ind_X_rum_Y - ind_X_sen_Y
  k1_3 := ind_X_rum_Y - ind_X_rum_sen_Y
  k2_3 := ind_X_sen_Y - ind_X_rum_sen_Y
'
fit_s <- sem(m_szer, data = dane, fixed.x = FALSE, se = "bootstrap", bootstrap = 5000, iseed = 1862)
round(fitMeasures(fit_s, c("chisq", "df")), 3)
sum(complete.cases(lavInspect(fit_s, "boot")))
pe_s <- parameterEstimates(fit_s, boot.ci.type = "perc")
ws <- c("a1", "a2", "d21", "b1", "b2", "c_prim", "ind_X_rum_Y", "ind_X_sen_Y", "ind_X_rum_sen_Y", "ind_laczny",
        "calkowity", "k1_2", "k1_3", "k2_3")
ps <- pe_s[match(ws, pe_s$label), c("label", "est", "ci.lower", "ci.upper", "pvalue")]
ps[, 2:5] <- round(ps[, 2:5], 3); ps

# Krok 6. Dla porównania: przedziały Monte Carlo (20 000 losowań) dla efektów pośrednich modelu szeregowego
fit_s_ml <- sem(m_szer, data = dane, fixed.x = FALSE)
mc <- monteCarloCI(fit_s_ml, nRep = 20000)
round(as.matrix(mc)[c("ind_X_rum_Y", "ind_X_sen_Y", "ind_X_rum_sen_Y", "ind_laczny"), ], 3)
Wynik w R
    samot  rum   sen   akt   dep
M    2.27 2.93  9.19  4.92  8.39
SD   0.48 0.75  3.27  2.17  3.94
min  1.00 1.00  1.00  0.00  0.00
max  3.82 4.96 18.00 11.50 19.00
      samot   rum   sen   akt   dep
samot  1.00  0.48  0.30 -0.22  0.36
rum    0.48  1.00  0.37 -0.08  0.38
sen    0.30  0.37  1.00 -0.09  0.42
akt   -0.22 -0.08 -0.09  1.00 -0.30
dep    0.36  0.38  0.42 -0.30  1.00
 chisq     df pvalue  rmsea
22.615  3.000  0.000  0.148
chisq    df
    0     0
[1] 4999
        label    est ci.lower ci.upper pvalue
1          a1  0.750    0.581    0.914  0.000
2          a2  2.057    1.318    2.782  0.000
3          a3 -1.003   -1.461   -0.534  0.000
4          b1  1.052    0.455    1.634  0.000
5          b2  0.341    0.217    0.467  0.000
6          b3 -0.416   -0.586   -0.240  0.000
7      c_prim  1.022    0.036    1.966  0.036
16    ind_rum  0.790    0.317    1.312  0.002
17    ind_sen  0.702    0.389    1.102  0.000
18    ind_akt  0.417    0.172    0.733  0.003
19 ind_laczny  1.909    1.284    2.593  0.000
20  calkowity  2.931    2.085    3.742  0.000
21  k_rum_sen  0.087   -0.558    0.724  0.788
22  k_rum_akt  0.373   -0.158    0.929  0.187
23  k_sen_akt  0.286   -0.171    0.780  0.241
        label est.std
7      c_prim   0.125
16    ind_rum   0.097
17    ind_sen   0.086
18    ind_akt   0.051
19 ind_laczny   0.233
20  calkowity   0.358
     a2      b2 ind_sen
 20.572   0.034   0.702
chisq    df
    0     0
[1] 4999
             label   est ci.lower ci.upper pvalue
1               a1 0.750    0.579    0.922  0.000
2               a2 1.108    0.325    1.876  0.005
3              d21 1.266    0.801    1.738  0.000
4               b1 0.993    0.396    1.573  0.001
5               b2 0.353    0.220    0.489  0.000
6           c_prim 1.460    0.524    2.394  0.002
11     ind_X_rum_Y 0.745    0.279    1.258  0.003
12     ind_X_sen_Y 0.391    0.106    0.739  0.016
13 ind_X_rum_sen_Y 0.335    0.171    0.552  0.001
14      ind_laczny 1.471    0.910    2.097  0.000
15       calkowity 2.931    2.097    3.756  0.000
16            k1_2 0.354   -0.240    0.971  0.261
17            k1_3 0.410   -0.104    0.937  0.125
18            k2_3 0.056   -0.316    0.421  0.763
                  est ci.lower ci.upper
ind_X_rum_Y     0.745    0.278    1.250
ind_X_sen_Y     0.391    0.103    0.740
ind_X_rum_sen_Y 0.335    0.162    0.560
ind_laczny      1.471    0.916    2.066
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (Version 0.5-8) [R package]. https://doi.org/10.32614/CRAN.package.semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Brak kowariancji reszt mediatorów w modelu równoległym. Model ma wtedy dodatnie stopnie swobody i zakłada coś, czego nie zakłada PROCESS.
- „Mediator A jest silniejszy, bo ma mniejsze p”. Porównanie wymaga kontrastu z przedziałem ufności.
- Odczytywanie nieistotnego c′ jako mediacji całkowitej. Opisz liczby i przedziały zamiast etykiet.
- Model szeregowy bez uzasadnienia kolejności. Przy danych z jednego pomiaru odwrotny łańcuch pasuje tak samo dobrze.
- Wnioski przyczynowe z danych przekrojowych. Maxwell i Cole (2007) pokazali, że przekrojowe analizy procesów rozwijających się w czasie dają zwykle obciążone oszacowania efektów pośrednich. Lepszy jest schemat podłużny, np. modele z wpisu CLPM i RI-CLPM. Które zmienne kontrolować, pomaga ustalić graf przyczynowy (DAG).
- Za mała próba na wiele dróg naraz. Fritz i MacKinnon (2007) podają, że już przy jednym mediatorze i średnich ścieżkach bootstrap percentylowy potrzebuje około 78 osób do mocy .80, a przy małych ścieżkach – kilkuset. Każdy dodatkowy mediator i droga przez trzy ścieżki zwiększają te wymagania (zob. dobór liczebności próby).
Gdy efekt pośredni ma zależeć od moderatora, przejdź do wpisu moderowana mediacja i modele PROCESS w R. Dane zagnieżdżone omawia mediacja wielopoziomowa, a składnię lavaan od podstaw – CB-SEM w R. Jeśli chcesz, żeby ktoś sprawdził specyfikację modelu i opis wyników w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Model i wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Ile mediatorów można wstawić do modelu mediacji równoległej?
Formalnie dowolnie wiele, ale każdy mediator to kolejne ścieżki do oszacowania i kolejne kontrasty. Liczbę mediatorów wyznacza teoria i wielkość próby. Fritz i MacKinnon (2007) pokazują, że już jeden mediator z małymi ścieżkami wymaga kilkuset osób do mocy .80.
Dlaczego model równoległy w lavaan ma stopnie swobody większe od zera?
Najczęściej dlatego, że brakuje kowariancji reszt mediatorów. lavaan nie dodaje ich automatycznie, gdy mediatory są predyktorami Y. Dopisz np. M1 ~~ M2 dla każdej pary mediatorów; model równoległy jest wtedy nasycony (df = 0), tak jak w PROCESS.
Jak porównać dwa efekty pośrednie w mediacji równoległej?
Zdefiniuj ich różnicę jako nowy parametr, np. k := a1*b1 - a2*b2, i oceń ją przedziałem bootstrap. Jeśli przedział obejmuje zero, dane nie pozwalają wskazać silniejszej drogi. Efekty pośrednie są wyrażone w jednostkach Y na jednostkę X, więc skala mediatorów nie przeszkadza w porównaniu.
Czy w mediacji szeregowej kolejność mediatorów ma znaczenie?
Tak. Zamiana M1 i M2 zmienia ścieżkę d21 i podział efektu między drogi, a dopasowanie modelu się nie zmienia. Kolejność musi wynikać z teorii, a najlepiej z pomiaru w kolejnych falach badania. Przy jednym pomiarze opisz ją jako założenie.
Bootstrap percentylowy czy z korektą obciążenia w mediacji szeregowej?
Taylor i in. (2008) zalecają oba przy drodze przez trzy ścieżki. Bootstrap z korektą obciążenia ma nieco większą moc, ale w części warunków zawyża błąd I rodzaju. Przedział percentylowy jest bezpieczniejszym wyborem domyślnym.
Powiązane hasła
Przeczytaj też
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikModerowana mediacja i modele PROCESS w R
Modele 7, 14 i 58, indeks moderowanej mediacji, efekty warunkowe z bootstrapem, lavaan i analiza wrażliwości – z kodem R i wzorem opisu APA.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Masz kilka mediatorów i nie wiesz, jak zbudować model?
Sprawdzimy specyfikację modelu, kontrasty i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Fritz, M. S., & MacKinnon, D. P. (2007). Required sample size to detect the mediated effect. Psychological Science, 18(3), 233–239. https://doi.org/10.1111/j.1467-9280.2007.01882.x ● Otwarty dostęp: pełny tekst
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- MacKinnon, D. P., Lockwood, C. M., & Williams, J. (2004). Confidence limits for the indirect effect: Distribution of the product and resampling methods. Multivariate Behavioral Research, 39(1), 99–128. https://doi.org/10.1207/s15327906mbr3901_4 ● Otwarty dostęp
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879 ● Otwarty dostęp
- Preacher, K. J., & Selig, J. P. (2012). Advantages of Monte Carlo confidence intervals for indirect effects. Communication Methods and Measures, 6(2), 77–98. https://doi.org/10.1080/19312458.2012.679848
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Taylor, A. B., MacKinnon, D. P., & Tein, J.-Y. (2008). Tests of the three-path mediated effect. Organizational Research Methods, 11(2), 241–269. https://doi.org/10.1177/1094428107300344
Cytowania BibTeX
@article{fritz2007required, author={Fritz, Matthew S. and MacKinnon, David P.}, title={{Required sample size to detect the mediated effect}}, journal={Psychological Science}, year={2007}, volume={18}, number={3}, pages={233--239}, doi={10.1111/j.1467-9280.2007.01882.x}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@article{mackinnon2004confidence, author={MacKinnon, David P. and Lockwood, Chondra M. and Williams, Jason}, title={{Confidence limits for the indirect effect: Distribution of the product and resampling methods}}, journal={Multivariate Behavioral Research}, year={2004}, volume={39}, number={1}, pages={99--128}, doi={10.1207/s15327906mbr3901_4}}@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@article{preacher2008asymptotic, author={Preacher, Kristopher J. and Hayes, Andrew F.}, title={{Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models}}, journal={Behavior Research Methods}, year={2008}, volume={40}, number={3}, pages={879--891}, doi={10.3758/brm.40.3.879}}@article{preacher2012advantages, author={Preacher, Kristopher J. and Selig, James P.}, title={{Advantages of Monte Carlo confidence intervals for indirect effects}}, journal={Communication Methods and Measures}, year={2012}, volume={6}, number={2}, pages={77--98}, doi={10.1080/19312458.2012.679848}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{taylor2008tests, author={Taylor, Aaron B. and MacKinnon, David P. and Tein, Jenn-Yun}, title={{Tests of the three-path mediated effect}}, journal={Organizational Research Methods}, year={2008}, volume={11}, number={2}, pages={241--269}, doi={10.1177/1094428107300344}}