Regresja nie powie, co kontrolować
Recenzent pyta: „Dlaczego kontrolowali Państwo wykształcenie, a nie stres w pracy?”. W badaniu obserwacyjnym to pytanie o model przyczynowy, a nie o statystykę. Ten sam zbiór danych daje różne współczynniki zależnie od tego, jakie zmienne kontrolne dodasz do regresji wielorakiej. Żaden test dopasowania nie wskaże wersji właściwej. Wysocki i in. (2022) pokazują, że źle dobrana kontrola może dać oszacowanie bardziej obciążone niż brak kontroli. Zalecają więc uzasadniać dobór zmiennych założoną strukturą przyczynową.
Narzędziem do zapisania tej struktury jest skierowany graf acykliczny, czyli DAG (ang. directed acyclic graph). Greenland i in. (1999) wprowadzili go do epidemiologii jako punkt wyjścia do ustalenia, które zmienne trzeba zmierzyć i kontrolować. Pokazali też, że tradycyjne kryteria zakłócania zawodzą, gdy kandydatów do kontroli jest wiele. W słowniku znajdziesz podstawy: zmienną zakłócającą i hasło korelacja a przyczynowość. Krótką odpowiedź dla prac dyplomowych daje wpis czy kontrolować wiek i płeć. Tutaj przechodzimy przez pełną procedurę: od grafu przez wyprowadzenie zbioru dostosowującego po symulację, która pokazuje koszt błędnego wyboru.
Węzły, strzałki i trzy podstawowe struktury
Węzeł DAG to zmienna, strzałka to założony bezpośredni wpływ przyczynowy. Graf jest acykliczny, więc żadna zmienna nie może pośrednio wpływać sama na siebie. Najważniejsze jest to, czego w grafie nie ma: brak strzałki to mocne założenie o braku bezpośredniego wpływu. Ścieżka to dowolny ciąg połączonych węzłów, bez względu na kierunek strzałek. Każda ścieżka między ekspozycją X a wynikiem Y składa się z trzech typów fragmentów.
| Struktura | Zapis | Ścieżka bez kontroli | Co robi kontrola Z |
|---|---|---|---|
| Łańcuch (Z jest mediatorem) | X → Z → Y | otwarta, przenosi efekt | zamyka ścieżkę i usuwa część efektu całkowitego |
| Rozwidlenie (Z jest wspólną przyczyną) | X ← Z → Y | otwarta, tworzy związek pozorny | zamyka ścieżkę i usuwa zakłócenie |
| Zderzacz (Z jest wspólnym skutkiem) | X → Z ← Y | zamknięta | otwiera ścieżkę i tworzy fałszywy związek |
Ostatni wiersz najczęściej zaskakuje. Wspólny skutek dwóch zmiennych nie przenosi między nimi związku, dopóki go nie kontrolujesz. Kontrola, warstwowanie albo dobór próby według zderzacza otwierają ścieżkę (Elwert i Winship, 2014). Kontrola potomka zderzacza, czyli zmiennej, na którą zderzacz wpływa, działa podobnie. Rohrer (2018) przypomina, że w psychologii tak samo działa niereprezentatywna próba.
Kryterium tylnych drzwi
Ścieżki od X do Y dzielą się na dwa rodzaje. Ścieżki przyczynowe wychodzą z X strzałką i prowadzą zgodnie z kierunkiem strzałek do Y. Razem tworzą efekt całkowity. Ścieżki tylnymi drzwiami (ang. backdoor paths) zaczynają się od strzałki wchodzącej do X, np. X ← Z → Y. Zbiór zmiennych kontrolnych pozwala oszacować efekt całkowity, gdy spełnia dwa warunki:
- blokuje każdą ścieżkę tylnymi drzwiami, czyli zawiera na niej niezderzacz albo nie zawiera zderzacza ani jego potomka;
- nie zawiera żadnego potomka X, a więc ani mediatora, ani skutku X.
Taki zbiór nazywa się zbiorem dostosowującym (ang. adjustment set). Zwykle jest ich kilka. Wybór między poprawnymi zbiorami to już sprawa precyzji i jakości pomiaru, a nie obciążenia.
Przykład: aktywność fizyczna a objawy depresji
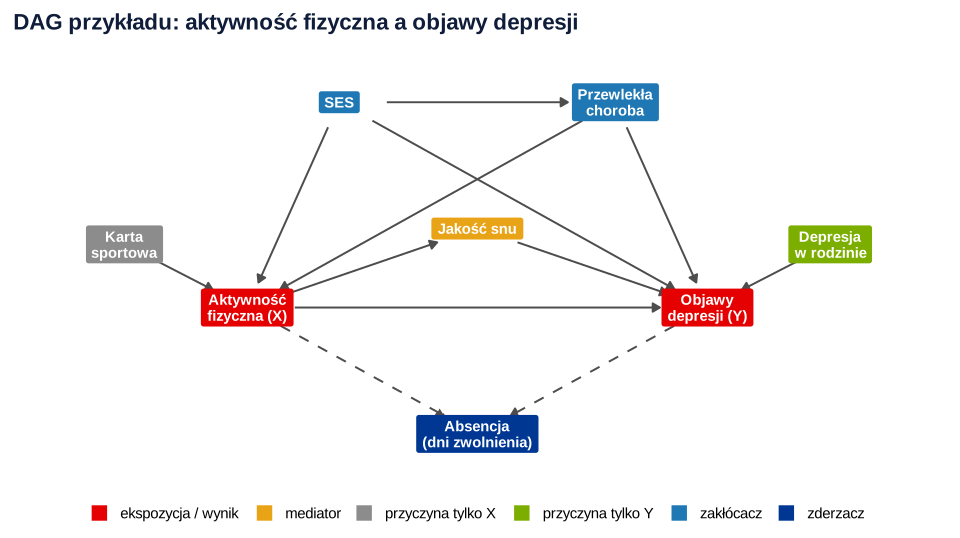
Badacz pyta, o ile tygodniowa godzina aktywności fizycznej zmienia objawy depresji u dorosłych. Objawy mierzy na skali T (M = 50, SD = 10). Ma osiem zmiennych, a ich założone związki przedstawia Rysunek 1. Dane symulowaliśmy według tego grafu (set.seed(2061), N = 600), więc znamy prawdę. Efekt całkowity godziny aktywności wynosi −1.0 pkt T. Składa się z efektu bezpośredniego −0.5 pkt i działania przez lepszy sen: 0.25 pkt jakości snu × (−2.0) = −0.5 pkt.
Bez żadnej kontroli korelacja aktywności z objawami wynosi r = −.37, a regresja daje b = −1.84 pkt, 95% CI [−2.21, −1.47]. To prawie dwa razy więcej niż prawdziwy efekt.
Wyprowadzenie zbioru dostosowującego krok po kroku
Przy kilku zmiennych zbiór dostosowujący wyprowadzisz ręcznie. Wypisz ścieżki, sprawdź, które są otwarte, i dobierz zmienne, które je zamkną.
- Ścieżki przyczynowe (zostaw otwarte): aktywność → objawy oraz aktywność → sen → objawy. Sen jest mediatorem, więc nie może trafić do zbioru, jeśli pytasz o efekt całkowity.
- Ścieżki tylnymi drzwiami (trzeba zamknąć): aktywność ← SES → objawy; aktywność ← choroba → objawy; aktywność ← SES → choroba → objawy; aktywność ← choroba ← SES → objawy. Wszystkie są otwarte, bo nie ma na nich zderzacza. Zamyka je kontrola SES i choroby.
- Ścieżka przez zderzacz: aktywność → absencja ← objawy jest zamknięta. Absencja to skutek X, więc jej kontrola łamie oba warunki kryterium.
- Zmienne z jedną strzałką: karta sportowa wpływa tylko na aktywność, a depresja w rodzinie tylko na objawy. Nie leżą na żadnej ścieżce tylnymi drzwiami, więc ich kontrola nie zmienia obciążenia.
Minimalny zbiór dostosowujący to {SES, choroba}. Poprawne są też zbiory rozszerzone o depresję w rodzinie, kartę sportową albo obie zmienne. Schisterman i in. (2009) nazywają kontrolę zmiennych, która nie zmienia obciążenia, niepotrzebną kontrolą. Może ona jednak zmienić precyzję. Przyczyna tylko wyniku zmniejsza wariancję resztową i zwęża przedział ufności. Przyczyna tylko ekspozycji usuwa część zmienności X i błąd standardowy rośnie. VanderWeele (2019) zaleca wykluczać zmienne, o których wiadomo, że są instrumentalne, czyli wpływają na wynik wyłącznie przez ekspozycję. Takie zmienne można za to wykorzystać inaczej, co pokazujemy we wpisie o zmiennych instrumentalnych.
Osiem zbiorów zmiennych kontrolnych: jedno badanie i 1000 powtórzeń
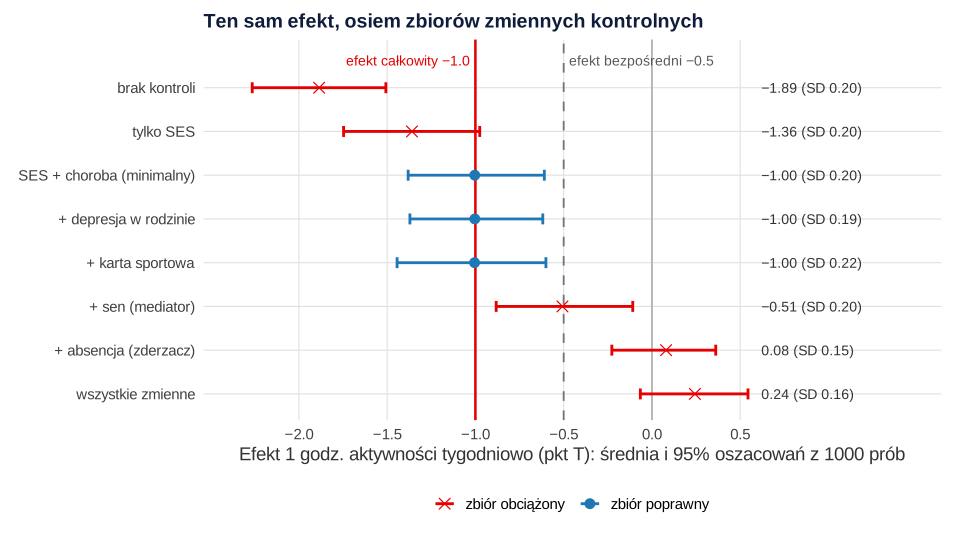
Tabela zestawia wyniki regresji objawów na aktywność dla ośmiu zbiorów zmiennych kontrolnych w jednym badaniu oraz średnie z 1000 symulowanych powtórzeń badania.
| Zmienne kontrolne | Rola w DAG | b [95% CI], N = 600 | Średnia z 1000 prób | SD oszacowań |
|---|---|---|---|---|
| brak | zakłócenie otwarte | −1.84 [−2.21, −1.47] | −1.89 | 0.20 |
| SES | jedna ścieżka otwarta | −1.33 [−1.72, −0.95] | −1.36 | 0.20 |
| SES, choroba | zbiór minimalny | −1.02 [−1.42, −0.62] | −1.00 | 0.20 |
| + depresja w rodzinie | przyczyna tylko Y | −1.04 [−1.42, −0.66] | −1.00 | 0.19 |
| + karta sportowa | przyczyna tylko X | −1.01 [−1.45, −0.58] | −1.01 | 0.22 |
| + jakość snu | mediator | −0.59 [−0.99, −0.18] | −0.51 | 0.20 |
| + absencja | zderzacz | 0.17 [−0.12, 0.47] | 0.08 | 0.15 |
| wszystkie zmienne | mediator i zderzacz | 0.19 [−0.14, 0.51] | 0.24 | 0.16 |
Wnioski z symulacji:
- Trzy poprawne zbiory trafiają w −1.00. Różnią się tylko precyzją. SD oszacowań wynosi 0.19 z przyczyną wyniku i 0.22 z przyczyną ekspozycji.
- Kontrola snu daje efekt bezpośredni, a nie całkowity. Średnia −0.51 odpowiada efektowi bezpośredniemu z danych generujących. To błąd nadmiernej kontroli: kontrola zmiennej pośredniczącej albo jej potomka (Schisterman i in., 2009). Jeśli naprawdę pytasz o efekt bezpośredni, potrzebujesz analizy mediacji z jej własnymi założeniami (zob. mediacja i wpis o mediacji równoległej i szeregowej).
- Kontrola absencji odwraca znak. Ochronny efekt aktywności znika, a średnia wynosi 0.08. Wśród osób o tej samej liczbie dni zwolnienia ci, którzy więcej ćwiczą, „muszą” mieć więcej objawów, bo inaczej mieliby mniej dni zwolnienia.
- „Kontroluj wszystko” nie jest bezpieczną strategią. Model ze wszystkimi zmiennymi jest najbardziej obciążony (0.24). Automatyczny dobór predyktorów, np. selekcja postępująca, nie odróżnia zderzacza od zmiennej zakłócającej.
Zderzacz w doborze próby
Zderzacz nie musi trafić do modelu. Wystarczy, że to on decyduje, kto znajdzie się w próbie. Hernán i in. (2004) pokazują, że różne rodzaje błędu selekcji mają tę samą strukturę: warunkowanie na wspólnym skutku ekspozycji (lub jej przyczyny) i wyniku (lub jego przyczyny). Gdyby badacz z przykładu zbierał dane tylko w poradni medycyny pracy, wśród osób z co najmniej siedmioma dniami zwolnienia, miałby 254 osoby. Mimo poprawnego zbioru {SES, choroba} oszacowanie wyniosłoby −0.33 pkt, 95% CI [−0.86, 0.21], p = .229. Efekt zmniejszyłby się o dwie trzecie i stałby się nieistotny. Dlatego przy doborze celowym lub wygodnym zaznacz w DAG, od czego zależy udział w badaniu.
Gdy nie znasz całego grafu
Pełny DAG rzadko jest pewny. Są trzy uczciwe sposoby radzenia sobie z tą niepewnością.
- Reguła VanderWeele’a. Gdy wiesz tylko, czy dana zmienna jest przyczyną ekspozycji lub wyniku, kontroluj każdą przyczynę ekspozycji, wyniku albo obu. Wyklucz znane zmienne instrumentalne i dodaj zastępczą miarę niezmierzonej wspólnej przyczyny (VanderWeele, 2019).
- Zmienne sprzed ekspozycji. Także zmienna zmierzona przed ekspozycją może być zderzaczem dwóch niezmierzonych czynników. Taki układ nazywa się M-bias. Ding i Miratrix (2015) pokazali jednak, że w modelach liniowych to obciążenie jest zwykle małe w porównaniu z obciążeniem przez zakłócenie. Kontrola takiej zmiennej jest więc na ogół lepszym wyborem niż jej pominięcie.
- Sprawdzenie grafu na danych. DAG przewiduje niezależności warunkowe. W przykładzie karta sportowa nie powinna wiązać się z objawami po kontroli aktywności, SES i choroby. W danych b = 0.17, SE = 0.70, p = .806. Zgodność nie dowodzi grafu, ale wyraźna niezgodność wskazuje strzałkę, której brakuje.
Niezmierzone zakłócenie zostaje zawsze. Opisz je w dyskusji i oceń jego możliwą siłę w analizie wrażliwości. Jeśli zbiór dostosowujący jest duży, a grupy porównywane, rozważ ważenie albo dopasowanie (zob. propensity score). DAG mówi, które zmienne uwzględnić, a nie którą metodą to zrobić.
Jeden model, jedna odpowiedź: błąd tabeli 2
Model dobrany pod efekt aktywności odpowiada tylko na pytanie o aktywność. Współczynnik SES w tym samym modelu nie jest efektem całkowitym SES. Część wpływu SES biegnie przez aktywność i chorobę, które są w modelu, a zmienne zakłócające sam SES mogą nie być kontrolowane. Westreich i Greenland (2013) nazywają ten błąd „błędem tabeli 2”. Polega on na interpretowaniu wszystkich współczynników z jednej tabeli jak efektów. Zalecają raportować współczynniki zmiennych kontrolnych bez interpretacji przyczynowej, a dla innych ekspozycji budować osobne modele. Różnicę między czynnikiem zakłócającym a modyfikatorem efektu omawiamy w osobnym haśle.
Jak opisać DAG w artykule
Narysuj graf przed analizą danych i dołącz go do planu analizy albo materiałów uzupełniających. Cinelli i in. (2024) przedstawiają diagramy przyczynowe jako narzędzie do rozpoznawania złej kontroli na przykładach, które warto przejrzeć przed odpowiedzią recenzentowi. W tekście podaj:
- pytanie o efekt (całkowity czy bezpośredni) i ekspozycję;
- źródło założeń: literaturę, kolejność pomiaru, wiedzę dziedzinową;
- wyprowadzony zbiór dostosowujący i powód włączenia każdej zmiennej;
- zmienne celowo pominięte (mediatory, zderzacze) z uzasadnieniem;
- wynik bez kontroli i z kontrolą oraz analizę wrażliwości.
Jeśli recenzent kwestionuje dobór zmiennych kontrolnych, możemy wspólnie narysować graf, wyprowadzić zbiór dostosowujący i przygotować analizę wrażliwości w ramach wsparcia statystycznego dla badaczy.
DAG i symulacja w R
Pakiet dagitty wyznacza zbiory dostosowujące automatycznie, ale nie jest potrzebny. Przy kilku zmiennych zbiór wyprowadzisz ręcznie jak wyżej, a symulacja z bazowego R sprawdzi wybór. Kod generuje dane według grafu z Rysunku 1, szacuje efekt dla ośmiu zbiorów zmiennych kontrolnych, pokazuje selekcję na zderzaczu i jedną testowalną implikację grafu, a potem powtarza badanie 1000 razy.
Dane według DAG, zbiory dostosowujące i symulacja
R
# Dane symulowane według DAG: aktywność fizyczna (godz./tydz.) a objawy depresji (skala T: M = 50, SD = 10); N = 600 dorosłych
# Prawdziwy efekt całkowity 1 godz. aktywności: −1.0 pkt T (bezpośredni −0.5 + przez sen 0.25 × −2.0 = −0.5)
generuj <- function(n = 600) {
  ses <- rnorm(n)                                                  # status socjoekonomiczny (z)
  choroba <- rbinom(n, 1, plogis(-1.2 - 0.4 * ses))                # przewlekła choroba
  rodzina <- rbinom(n, 1, .20)                                     # depresja w rodzinie (przyczyna tylko wyniku)
  karta <- rbinom(n, 1, .35)                                       # karta sportowa od pracodawcy (przyczyna tylko aktywności)
  aktywnosc <- pmax(3 + 0.6 * ses - 1.2 * choroba + 1.5 * karta + rnorm(n, 0, 1.5), 0)
  sen <- 6 + 0.25 * (aktywnosc - 3) + rnorm(n, 0, 1.2)              # jakość snu (mediator)
  depresja <- 50 - 0.5 * (aktywnosc - 3) - 2.0 * (sen - 6) - 2.5 * ses + 5 * choroba + 6 * rodzina + rnorm(n, 0, 7)
  absencja <- round(pmax(0, 5 - 0.5 * (aktywnosc - 3) + 0.4 * (depresja - 50) + rnorm(n, 0, 3)))   # dni zwolnienia (zderzacz)
  data.frame(ses, choroba, rodzina, karta, aktywnosc, sen, depresja, absencja)
}
zbiory <- list(
  "brak kontroli"                   = character(0),
  "tylko SES"                       = "ses",
  "SES + choroba (minimalny)"       = c("ses", "choroba"),
  "+ depresja w rodzinie"           = c("ses", "choroba", "rodzina"),
  "+ karta sportowa"                = c("ses", "choroba", "karta"),
  "+ sen (mediator)"                = c("ses", "choroba", "sen"),
  "+ absencja (zderzacz)"           = c("ses", "choroba", "absencja"),
  "wszystkie zmienne"               = c("ses", "choroba", "rodzina", "karta", "sen", "absencja"))
efekt <- function(d, z) {
  f <- lm(reformulate(c("aktywnosc", z), "depresja"), data = d)
  c(b = coef(f)[["aktywnosc"]], SE = sqrt(vcov(f)["aktywnosc", "aktywnosc"]), confint(f)["aktywnosc", ],
    p = summary(f)$coefficients["aktywnosc", 4])
}

# 1. Jedno badanie (N = 600)
set.seed(2061)
d <- generuj()
round(sapply(d[, c("aktywnosc", "sen", "depresja", "absencja")], function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(d$aktywnosc, d$depresja), 3)
wyniki <- t(sapply(zbiory, efekt, d = d)); colnames(wyniki) <- c("b", "SE", "dolny", "gorny", "p")
round(wyniki, 3)

# Błąd selekcji: badanie prowadzone tylko wśród osób z co najmniej 7 dniami zwolnienia (selekcja na zderzaczu)
wybrani <- d[d$absencja >= 7, ]
nrow(wybrani); round(efekt(wybrani, c("ses", "choroba")), 3)

# Sprawdzenie implikacji DAG: karta ⫫ depresja | aktywność, SES, choroba (współczynnik karty powinien być bliski 0)
round(summary(lm(depresja ~ karta + aktywnosc + ses + choroba + rodzina, data = d))$coefficients["karta", ], 3)

# 2. Symulacja: 1000 powtórzeń badania, rozkład oszacowań dla każdego zbioru zmiennych kontrolnych
set.seed(2062)
sym <- replicate(1000, { dd <- generuj(); sapply(zbiory, function(z) efekt(dd, z)[["b"]]) })
podsum <- data.frame(srednia = rowMeans(sym), obciazenie = rowMeans(sym) - (-1), SD = apply(sym, 1, sd),
                     p2.5 = apply(sym, 1, quantile, .025), p97.5 = apply(sym, 1, quantile, .975))
round(podsum, 3)
Wynik w R
   aktywnosc  sen depresja absencja
M       3.24 6.09    52.21     5.95
SD      1.79 1.23     8.84     4.46
[1] -0.372
                               b    SE  dolny  gorny     p
brak kontroli             -1.838 0.188 -2.207 -1.470 0.000
tylko SES                 -1.331 0.196 -1.716 -0.946 0.000
SES + choroba (minimalny) -1.021 0.203 -1.418 -0.623 0.000
+ depresja w rodzinie     -1.039 0.193 -1.418 -0.660 0.000
+ karta sportowa          -1.011 0.221 -1.445 -0.576 0.000
+ sen (mediator)          -0.585 0.208 -0.994 -0.177 0.005
+ absencja (zderzacz)      0.174 0.151 -0.122  0.470 0.249
wszystkie zmienne          0.186 0.163 -0.135  0.507 0.256
[1] 254
     b     SE  2.5 % 97.5 %      p
-0.326  0.270 -0.858  0.206  0.229
  Estimate Std. Error    t value   Pr(>|t|)
     0.172      0.702      0.245      0.806
                          srednia obciazenie    SD   p2.5  p97.5
brak kontroli              -1.885     -0.885 0.195 -2.264 -1.507
tylko SES                  -1.360     -0.360 0.197 -1.747 -0.975
SES + choroba (minimalny)  -1.004     -0.004 0.201 -1.381 -0.609
+ depresja w rodzinie      -1.003     -0.003 0.189 -1.371 -0.618
+ karta sportowa           -1.005     -0.005 0.218 -1.444 -0.601
+ sen (mediator)           -0.507      0.493 0.199 -0.882 -0.109
+ absencja (zderzacz)       0.080      1.080 0.152 -0.227  0.362
wszystkie zmienne           0.243      1.243 0.155 -0.066  0.544
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), confint(), replicate()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Dobór zmiennych kontrolnych według istotności lub korelacji z wynikiem. Zderzacz koreluje z wynikiem równie dobrze jak zmienna zakłócająca.
- Kontrola mediatora przy pytaniu o efekt całkowity, np. snu, motywacji albo innej zmiennej mierzonej po ekspozycji.
- Kontrola skutku wyniku albo dobór próby według niego (pacjenci poradni, osoby, które ukończyły program).
- Graf narysowany po obejrzeniu wyników. Taki graf jest tylko ilustracją wybranej analizy. Zapisz go w prerejestracji.
- Interpretowanie współczynników zmiennych kontrolnych jako efektów (błąd tabeli 2).
- Słowo „wpływ” bez założeń. W schemacie korelacyjnym wniosek przyczynowy jest warunkowy: podaj graf i założenie o braku niezmierzonych zmiennych zakłócających. Szerzej o tym, jak bronić takich decyzji w doktoracie, piszemy w przewodniku po doktoracie i publikacjach.
Najczęstsze pytania
Jak wyznaczyć zmienne kontrolne na podstawie DAG?
Wypisz wszystkie ścieżki od ekspozycji do wyniku. Ścieżki przyczynowe zostaw otwarte, a każdą ścieżkę tylnymi drzwiami (zaczynającą się strzałką wchodzącą do ekspozycji) zamknij kontrolą niezderzacza, który na niej leży. Do zbioru nie dodawaj mediatorów, zderzaczy ani innych skutków ekspozycji. Z kilku poprawnych zbiorów wybierz najlepiej zmierzony i najbardziej precyzyjny.
Co to jest błąd zderzacza (collider bias)?
Zderzacz to wspólny skutek dwóch zmiennych, np. absencja zależna od aktywności i od objawów depresji. Bez kontroli zamyka ścieżkę, ale jego kontrola, warstwowanie albo dobór próby według niego tworzy fałszywy związek (Elwert i Winship, 2014). W przykładzie z tego wpisu kontrola absencji zmieniła efekt aktywności z −1.0 na średnio 0.08.
Czy kontrolowanie mediatora jest błędem?
Tak, jeśli pytasz o efekt całkowity. Kontrola zmiennej pośredniczącej usuwa część efektu, która przez nią przechodzi; to błąd nadmiernej kontroli (Schisterman i in., 2009). Jeśli interesuje Cię efekt bezpośredni, zaplanuj analizę mediacji z jej własnymi założeniami.
Co zrobić, gdy nie znam pełnego grafu przyczynowego?
Kontroluj zmienne, o których wiesz, że są przyczyną ekspozycji, wyniku albo obu, pomiń znane zmienne instrumentalne i dodaj zastępcze miary niezmierzonych wspólnych przyczyn (VanderWeele, 2019). Niepewne strzałki opisz i sprawdź w analizie wrażliwości, jak zmienia się wynik przy różnych zbiorach zmiennych kontrolnych.
Czy można interpretować współczynniki zmiennych kontrolnych w regresji?
Zwykle nie. Model dobrany pod jedną ekspozycję daje dla zmiennych kontrolnych efekty warunkowe, które mogą być zakłócone lub pomijać ścieżki przez inne zmienne w modelu. Westreich i Greenland (2013) nazywają ich interpretowanie błędem tabeli 2 i zalecają osobne modele dla każdej ekspozycji.
Powiązane hasła
Przeczytaj też
Czy kontrolować wiek i płeć?
Kiedy wiek i płeć usuwają zakłócenie, kiedy tylko zwiększają precyzję, a kiedy szkodzą – z przykładem czterech modeli w R i wzorem opisu.
Czytaj →PoradnikPropensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikAnaliza wrażliwości w artykule naukowym
Jak dobrać warianty, policzyć je w R (braki danych, obserwacje odstające, specyfikacje), zbudować krzywą specyfikacji i opisać wyniki w artykule.
Czytaj →Recenzent pyta, dlaczego kontrolujesz te, a nie inne zmienne?
Pomożemy narysować graf przyczynowy, wyprowadzić zbiór zmiennych kontrolnych i przygotować analizę wrażliwości tak, żebyś mógł(a) samodzielnie uzasadnić decyzje w artykule i odpowiedzi recenzentom.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cinelli, C., Forney, A., & Pearl, J. (2024). A crash course in good and bad controls. Sociological Methods & Research, 53(3), 1071–1104. https://doi.org/10.1177/00491241221099552 ● Otwarty dostęp: pełny tekst
- Ding, P., & Miratrix, L. W. (2015). To adjust or not to adjust? Sensitivity analysis of M-bias and butterfly-bias. Journal of Causal Inference, 3(1), 41–57. https://doi.org/10.1515/jci-2013-0021 ● Otwarty dostęp
- Elwert, F., & Winship, C. (2014). Endogenous selection bias: The problem of conditioning on a collider variable. Annual Review of Sociology, 40(1), 31–53. https://doi.org/10.1146/annurev-soc-071913-043455 ● Otwarty dostęp
- Greenland, S., Pearl, J., & Robins, J. M. (1999). Causal diagrams for epidemiologic research. Epidemiology, 10(1), 37–48. https://doi.org/10.1097/00001648-199901000-00008
- Hernán, M. A., Hernández-Díaz, S., & Robins, J. M. (2004). A structural approach to selection bias. Epidemiology, 15(5), 615–625. https://doi.org/10.1097/01.ede.0000135174.63482.43
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Schisterman, E. F., Cole, S. R., & Platt, R. W. (2009). Overadjustment bias and unnecessary adjustment in epidemiologic studies. Epidemiology, 20(4), 488–495. https://doi.org/10.1097/ede.0b013e3181a819a1 ● Otwarty dostęp: pełny tekst
- VanderWeele, T. J. (2019). Principles of confounder selection. European Journal of Epidemiology, 34(3), 211–219. https://doi.org/10.1007/s10654-019-00494-6 ● Otwarty dostęp
- Westreich, D., & Greenland, S. (2013). The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients. American Journal of Epidemiology, 177(4), 292–298. https://doi.org/10.1093/aje/kws412 ● Otwarty dostęp
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{cinelli2024crash, author={Cinelli, Carlos and Forney, Andrew and Pearl, Judea}, title={{A crash course in good and bad controls}}, journal={Sociological Methods \& Research}, year={2024}, volume={53}, number={3}, pages={1071--1104}, doi={10.1177/00491241221099552}}@article{ding2015adjust, author={Ding, Peng and Miratrix, Luke W.}, title={{To adjust or not to adjust? Sensitivity analysis of M-bias and butterfly-bias}}, journal={Journal of Causal Inference}, year={2015}, volume={3}, number={1}, pages={41--57}, doi={10.1515/jci-2013-0021}}@article{elwert2014endogenous, author={Elwert, Felix and Winship, Christopher}, title={{Endogenous selection bias: The problem of conditioning on a collider variable}}, journal={Annual Review of Sociology}, year={2014}, volume={40}, number={1}, pages={31--53}, doi={10.1146/annurev-soc-071913-043455}}@article{greenland1999causal, author={Greenland, Sander and Pearl, Judea and Robins, James M.}, title={{Causal diagrams for epidemiologic research}}, journal={Epidemiology}, year={1999}, volume={10}, number={1}, pages={37--48}, doi={10.1097/00001648-199901000-00008}}@article{hernan2004structural, author={Hernán, Miguel A. and Hernández-Díaz, Sonia and Robins, James M.}, title={{A structural approach to selection bias}}, journal={Epidemiology}, year={2004}, volume={15}, number={5}, pages={615--625}, doi={10.1097/01.ede.0000135174.63482.43}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{schisterman2009overadjustment, author={Schisterman, Enrique F. and Cole, Stephen R. and Platt, Robert W.}, title={{Overadjustment bias and unnecessary adjustment in epidemiologic studies}}, journal={Epidemiology}, year={2009}, volume={20}, number={4}, pages={488--495}, doi={10.1097/ede.0b013e3181a819a1}}@article{vanderweele2019principles, author={VanderWeele, Tyler J.}, title={{Principles of confounder selection}}, journal={European Journal of Epidemiology}, year={2019}, volume={34}, number={3}, pages={211--219}, doi={10.1007/s10654-019-00494-6}}@article{westreich2013table, author={Westreich, Daniel and Greenland, Sander}, title={{The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients}}, journal={American Journal of Epidemiology}, year={2013}, volume={177}, number={4}, pages={292--298}, doi={10.1093/aje/kws412}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}