Kiedy potrzebujesz propensity score?
W badaniu obserwacyjnym nikt nie losuje, kto dostanie interwencję. Osoby same zgłaszają się na program, lekarz decyduje o terapii, szkoła sama wybiera, czy wdroży projekt. Grupy różnią się więc już na starcie, a prosta różnica wyników miesza efekt interwencji z tymi różnicami. Taką sytuację znają doktoranci i doktorantki analizujący dane z rejestrów, dokumentacji szpitalnej albo badań w miejscu pracy, a także badacze oceniający programy, których nie dało się zrandomizować.
Propensity score (PS) to prawdopodobieństwo otrzymania interwencji przy obserwowanych cechach wyjściowych. Definicję i krótki przykład ważenia znajdziesz w haśle propensity score. Rosenbaum i Rubin (1983) pokazali, że korekta o ten jeden wynik wystarcza, by usunąć obciążenie związane ze wszystkimi obserwowanymi zmiennymi, które do niego włączono. Stuart (2010) zaleca, by przy szacowaniu efektów z danych obserwacyjnych jak najwierniej odtworzyć eksperyment z randomizacją: zbudować grupę porównawczą o rozkładach cech podobnych do grupy, która dostała interwencję. Propensity score jest do tego najwygodniejszym narzędziem.
W tym poradniku przechodzimy przez całą analizę na jednym zbiorze danych: wybór efektu, który chcesz oszacować, dobór zmiennych, model PS, wspólny zakres, dopasowanie 1:1 z kaliprem, ważenie IPTW, diagnostykę równowagi, oszacowanie efektu z poprawnym błędem standardowym, analizę wrażliwości (E-value) i opis do artykułu. Jedno zastrzeżenie od razu: propensity score równoważy tylko zmierzone cechy. Nieobserwowane zmienne zakłócające zostają, dlatego każda analiza PS kończy się analizą wrażliwości.
Zanim zaczniesz: ATE czy ATT?
Pierwsza decyzja nie dotyczy metody, tylko pytania. W analizach PS rozróżnia się dwa główne średnie efekty przyczynowe:
- ATE (average treatment effect) – średni efekt w całej populacji, gdyby wszyscy dostali interwencję, w porównaniu z sytuacją, w której nikt jej nie dostaje. Pytanie decydenta: „Co by się stało, gdybyśmy wdrożyli program dla wszystkich?”.
- ATT (average treatment effect on the treated) – średni efekt u osób, które faktycznie skorzystały z interwencji. Pytanie oceny programu: „Czy uczestnikom program pomógł?”.
Gdy efekt jest u wszystkich taki sam, oba wskaźniki są równe. Zwykle jednak efekt zależy od cech osób, a uczestnicy różnią się od reszty. Wtedy ATE i ATT się rozchodzą i różne metody szacują różne wielkości. Dopasowanie osób z grupy kontrolnej do uczestników szacuje ATT, wagi 1/PS i 1/(1 − PS) – ATE, a wagi PS/(1 − PS) dla grupy kontrolnej – znowu ATT. Wybierz efekt w planie analizy, zanim spojrzysz na wyniki, i nazwij go w artykule.
| Metoda | Co robi | Szacowany efekt |
|---|---|---|
| Dopasowanie 1:1 najbliższego sąsiada | do każdego uczestnika szuka osoby z grupy kontrolnej o podobnym PS | ATT (dla dopasowanych uczestników) |
| IPTW, wagi ATE | uczestnik: 1/PS, osoba z kontroli: 1/(1 − PS) | ATE |
| IPTW, wagi ATT | uczestnik: 1, osoba z kontroli: PS/(1 − PS) | ATT |
| Stratyfikacja według kwintyli PS | porównuje grupy w warstwach i uśrednia wyniki | zależnie od wag warstw (zwykle ATE) |
| PS jako kowariant w regresji | dodaje PS do modelu wyniku | zależy od poprawności modelu wyniku |
Badanie przykładowe: program redukcji stresu w szpitalach
Wyobraź sobie projekt doktorski oceniający ośmiotygodniowy program redukcji stresu dla personelu szpitali. W badaniu wzięło udział 1200 osób (pielęgniarki, pielęgniarze i ratownicy). Udział był dobrowolny i zgłosiło się 277 osób. Na początku zmierzono wiek, staż pracy, płeć, pracę w systemie zmianowym z nocami, liczbę godzin pracy w tygodniu i wyczerpanie emocjonalne (skala 9–45, wyższy wynik oznacza większe wyczerpanie). Po sześciu miesiącach wszyscy ponownie wypełnili skalę wyczerpania.
Dane są symulowane, dzięki czemu znamy prawdziwy efekt. W symulacji program obniża wyczerpanie tym silniej, im wyższe było ono na starcie. Prawdziwy ATE w tej próbie wynosi −2.68 punktu, a ATT −3.01, bo uczestnicy byli na starcie bardziej wyczerpani. Dane możesz pobrać jako plik CSV (kolumny: id, program, wiek, staz, kobieta, nocne, godziny, wycz0, wycz6).
Surowe porównanie jest mylące. Po sześciu miesiącach uczestnicy mieli średnio tylko o 1.06 punktu niższe wyczerpanie niż pozostali, 95% CI [−1.82, −0.30]. To prawie trzy razy mniej niż prawdziwy efekt, bo do programu zgłaszały się osoby bardziej wyczerpane. To klasyczny przykład tego, jak czynnik zakłócający maskuje efekt. Gdyby selekcja działała odwrotnie (zgłaszają się najzdrowsi), surowa różnica przeszacowałaby efekt.
Jedna uwaga techniczna. Pakiety MatchIt, WeightIt i cobalt, którymi zwykle wykonuje się takie analizy w R, nie były dostępne w środowisku, w którym liczyliśmy przykład. Dopasowanie, wagi i diagnostykę równowagi zaprogramowaliśmy więc funkcjami bazowego R, a odporne błędy standardowe policzyliśmy pakietem sandwich. Ma to zaletę dydaktyczną: każdy krok jest widoczny. W pracy możesz użyć wymienionych pakietów, ale sprawdź, czy ich ustawienia odpowiadają opisanym tu decyzjom.
Krok 1. Wybierz zmienne do modelu PS
To najważniejsza decyzja w całej analizie i nie da się jej podjąć na podstawie samych danych. Do modelu PS włącz cechy zmierzone przed decyzją o udziale, które mogą wpływać jednocześnie na udział i na wynik. Brookhart i in. (2006) pokazali w symulacjach, że zmienne związane z wynikiem warto włączać zawsze, nawet gdy nie wiążą się z udziałem: zmniejszają wariancję oszacowania i nie zwiększają obciążenia. Zmienne związane tylko z udziałem, a nie z wynikiem, zwiększają wariancję i nie zmniejszają obciążenia. Autorzy podkreślają też, że dobry model predykcyjny udziału nie musi być dobrym modelem PS.
Czego nie włączać? Rohrer (2018) przypomina, że kontrolowanie mediatorów (zmiennych na drodze od interwencji do wyniku) i kolajderów (wspólnych skutków interwencji i wyniku) oddala oszacowanie od efektu przyczynowego. W praktyce oznacza to zakaz włączania czegokolwiek zmierzonego po rozpoczęciu programu, np. zaangażowania w trakcie zajęć czy liczby zwolnień lekarskich w czasie trwania programu. Pomaga narysowanie prostego grafu przyczynowego, a uzasadnienie wyboru zmiennych warto zapisać w planie analizy. Szerzej o tym, które zmienne kontrolować, piszemy w hasłach zmienna kontrolna i korelacja a przyczynowość.
W przykładzie włączamy wszystkie sześć cech wyjściowych. Wyczerpanie na starcie jest tu najważniejsze, bo silnie wiąże się zarówno z decyzją o udziale, jak i z wynikiem po sześciu miesiącach.
Krok 2. Oceń równowagę grup przed korektą
Równowagę ocenia się standaryzowaną różnicą średnich (SMD), a nie testami istotności. Austin (2009) omawia SMD dla średnich i odsetków, ilorazy wariancji i porównanie rozkładów na wykresach. W odróżnieniu od wartości p miary te nie zależą od liczebności próby. Dla zmiennych 0/1 SMD liczy się z odsetków. Jako górną granicę akceptowalnej nierównowagi przyjmuje się zwykle wartość 0.1. Iloraz wariancji powinien być bliski 1; wartości poza przedziałem od mniej więcej 0.5 do 2 sygnalizują problem.
Tabela 1
Cechy wyjściowe uczestników programu i osób bez programu oraz standaryzowane różnice średnich przed korektą i po niej
| Cecha | Program (n = 277) | Bez programu (n = 923) | SMD przed | SMD po dopasowaniu | SMD po IPTW (ATE) |
|---|---|---|---|---|---|
| Wiek, M (SD) | 39.11 (9.45) | 41.51 (9.51) | −0.25 | −0.05 | 0.02 |
| Staż pracy w latach, M (SD) | 13.46 (9.45) | 16.00 (9.35) | −0.27 | −0.06 | 0.03 |
| Kobiety, % | 88.4 | 81.6 | 0.19 | 0.02 | 0.04 |
| Nocne zmiany, % | 45.1 | 54.4 | −0.19 | −0.01 | −0.03 |
| Godziny pracy w tygodniu, M (SD) | 41.49 (6.51) | 41.98 (6.27) | −0.08 | 0.00 | 0.03 |
| Wyczerpanie na starcie (9–45), M (SD) | 30.27 (6.45) | 26.71 (6.48) | 0.55 | −0.02 | −0.02 |
Uwaga. SMD – standaryzowana różnica średnich (program minus bez programu); mianownik: pierwiastek ze średniej wariancji obu grup przed korektą, dla zmiennych 0/1 liczony z odsetków. Dopasowanie: 275 par, 1:1 bez zwracania, kaliper 0.2 SD logitu PS. IPTW (ATE): wagi stabilizowane. Dane symulowane.
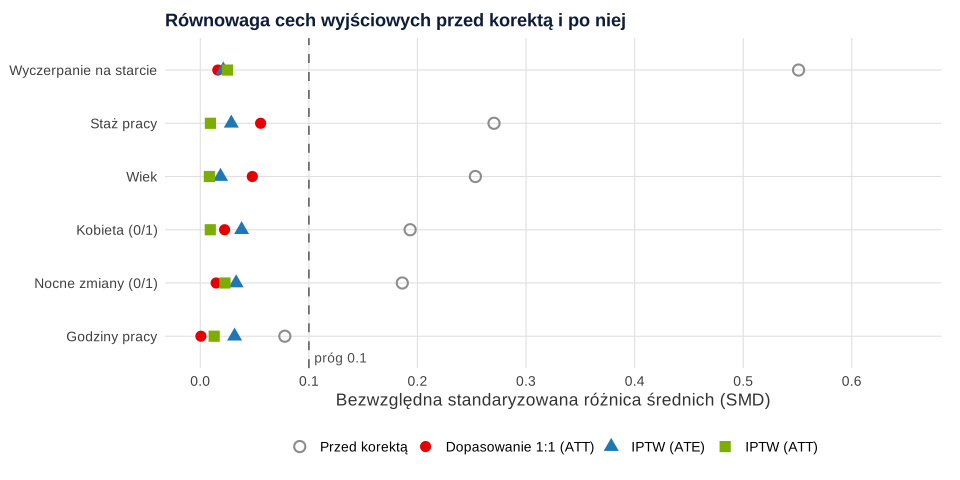
Przed korektą największa nierównowaga dotyczy wyczerpania na starcie: SMD = 0.55, czyli uczestnicy byli bardziej wyczerpani o ponad pół odchylenia standardowego. Uczestnicy byli też młodsi, mieli krótszy staż, częściej byli kobietami i rzadziej pracowali na nocnych zmianach. Ilorazy wariancji wynosiły od 0.98 do 1.08, więc grupy różniły się głównie średnimi, a nie rozrzutem.
Krok 3. Oszacuj propensity score
Propensity score szacujesz w regresji logistycznej. Zmienną zależną jest udział w programie (0/1), a predyktorami cechy wyjściowe. Wyniku do modelu nie wstawiasz. Krok po kroku przez taki model prowadzi poradnik regresja logistyczna krok po kroku.
Współczynników modelu PS nie interpretuj tak jak w zwykłej regresji. Celem jest równowaga grup, a nie wyjaśnianie, kto się zgłasza. W przykładzie wiek i staż są silnie skorelowane, więc ich współczynniki mają przeciwne znaki (0.044 i −0.072). To nie przeszkadza, jeśli model dobrze równoważy grupy. Jeśli po korekcie któraś zmienna pozostaje niezrównoważona, dodaj do modelu jej kwadrat albo interakcję i sprawdź równowagę ponownie. Taka iteracja jest dozwolona, bo dotyczy tylko cech wyjściowych. Model PS buduje się bez zaglądania do wyniku, co oddziela projekt badania od analizy wyniku.
Mediana PS wyniosła .286 wśród uczestników i .185 w grupie kontrolnej. Uczestnicy mieli więc wyraźnie wyższe przewidywane prawdopodobieństwo udziału, czego należało się spodziewać.
Krok 4. Sprawdź wspólny zakres PS
Porównanie ma sens tylko tam, gdzie w obu grupach są osoby o podobnym PS. Cole i Hernán (2008) wymieniają to wśród czterech założeń ważenia jako dodatniość (positivity): każda osoba musi mieć niezerową szansę znalezienia się w każdej grupie. Gdy ktoś ma PS bliskie 0 albo 1, nie ma dla niego odpowiednika w drugiej grupie, a jego waga w IPTW rośnie.
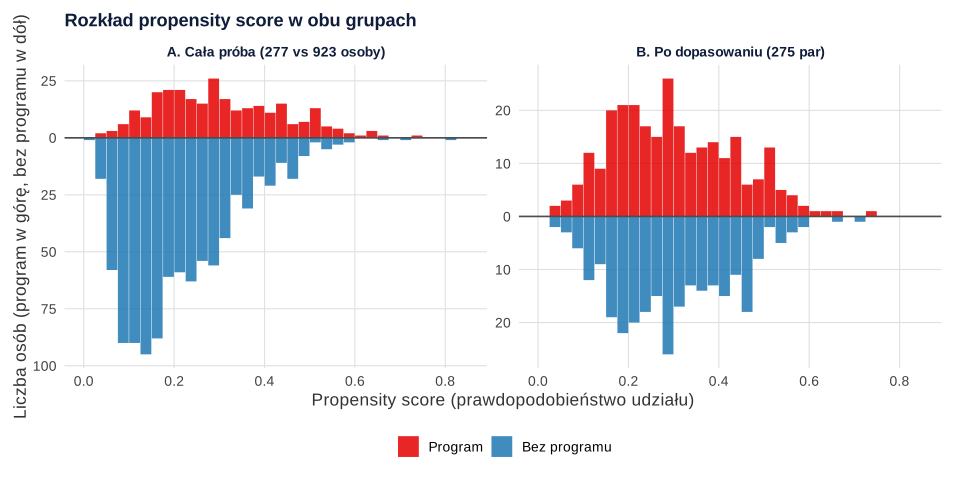
W przykładzie zakres PS uczestników wynosi od .039 do .727, a osób z grupy kontrolnej od .019 do .812. Żaden uczestnik nie leży poza zakresem grupy kontrolnej. Poza zakresem uczestników znalazło się 9 osób z grupy kontrolnej. Zakresy pokrywają się więc dobrze, ale po prawej stronie rysunku 1A widać, że przy wysokim PS osób z grupy kontrolnej jest niewiele. Tam powstaną duże wagi w IPTW. Przy słabym pokryciu masz trzy wyjścia: zawęzić próbę do wspólnego zakresu (i opisać, do kogo odnosi się wtedy wynik), wybrać ATT zamiast ATE albo uczciwie napisać, że dane nie pozwalają oszacować efektu dla części populacji.
Krok 5. Dopasowanie 1:1 z kaliprem
Najpopularniejsza wersja to dopasowanie najbliższego sąsiada w proporcji 1:1 bez zwracania. Do każdego uczestnika wybierasz z grupy kontrolnej jedną osobę o najbliższym PS, która nie została jeszcze dopasowana. Stuart (2010) porządkuje metody dopasowania i opisuje ich wspólny cel: grupę porównawczą o rozkładach cech możliwie podobnych do grupy leczonej. Więcej o doborze porównywalnych osób znajdziesz w haśle grupa porównawcza.
Kaliper to maksymalna dopuszczalna odległość między parą. Austin (2011) w symulacjach Monte Carlo zalecił dopasowanie na logicie PS z kaliprem równym 0.2 odchylenia standardowego logitu PS. Przy takim kaliprze usuwano co najmniej 98% obciążenia surowego oszacowania, a przedziały ufności miały prawie poprawne pokrycie. W przykładzie odchylenie standardowe logitu PS daje kaliper 0.156.
Algorytm jest prosty: ustaw uczestników od najwyższego PS (dla nich najtrudniej znaleźć parę), a potem kolejno szukaj najbliższej wolnej osoby z grupy kontrolnej w odległości nie większej niż kaliper. Wynik: 275 par. Dla dwóch uczestników z najwyższym PS nie znaleziono pary w granicach kalipra. Odrzucenie uczestników zmienia nieco populację, dla której szacujesz efekt, więc zawsze podaj tę liczbę.
Po dopasowaniu wszystkie SMD spadły poniżej 0.1, a największe wyniosło 0.06 dla stażu pracy (tabela 1). Ilorazy wariancji mieściły się w przedziale od 0.99 do 1.10. Rysunek 1B pokazuje, że rozkłady PS w obu grupach mają teraz prawie identyczny kształt.
Efekt w próbie dopasowanej
Po dopasowaniu średnie wyczerpanie po sześciu miesiącach wynosiło 25.86 u uczestników i 29.01 w dobranej grupie kontrolnej. Różnica, czyli ATT, wynosi −3.16 punktu, 95% CI [−4.01, −2.30]. Błąd standardowy powinien uwzględniać to, że osoby tworzą pary, dlatego użyliśmy odpornego błędu grupowanego według par (SE = 0.44). Dodanie cech wyjściowych do modelu wyniku w próbie dopasowanej dało −3.09, 95% CI [−3.75, −2.43]. Taka podwójna korekta usuwa resztkową nierównowagę i zwykle zawęża przedział. Oba wyniki są blisko prawdziwego ATT (−3.01).
Krok 6. Ważenie odwrotnością prawdopodobieństwa (IPTW)
Ważenie nie odrzuca nikogo. Każda osoba dostaje wagę odwrotną do prawdopodobieństwa otrzymania tej interwencji, którą faktycznie otrzymała. Austin i Stuart (2015) opisują efekt jako syntetyczną próbę, w której przydział nie zależy już od zmierzonych cech. Uczestnik z niskim PS (mało kto taki się zgłaszał) reprezentuje wiele podobnych osób i dostaje dużą wagę. Osoba z grupy kontrolnej z wysokim PS jest rzadka, więc także waży dużo.
Wagi, wagi stabilizowane i efektywna liczebność
Wagi ATE u uczestników wynosiły od 1.37 do 25.79 (mediana 3.49). Najwyższa waga oznacza, że jedna osoba reprezentuje prawie 26 osób. Wagi stabilizowane, w których licznik to odsetek osób w danej grupie, mają tę samą proporcję między osobami, ale bardziej czytelną skalę: suma wag w każdej grupie jest bliska jej liczebności (277.29 i 924.58), a maksimum wynosi 5.95. Oszacowanie efektu jest dla obu rodzajów wag identyczne.
Duże wagi zmniejszają precyzję. Pokazuje to efektywna liczebność (Kisha): suma wag do kwadratu podzielona przez sumę kwadratów wag. U uczestników przy wagach ATE wynosi ona 186.6 z 277 osób. W grupie kontrolnej przy wagach ATT – 503.5 z 923 osób. Podaj ją w artykule, bo mówi więcej niż sama liczebność próby.
Austin i Stuart (2015) w przeglądzie literatury stwierdzili, że w najnowszych badaniach większość autorów stosujących IPTW nie sprawdzała formalnie równowagi po ważeniu. Zalecają ważone SMD dla średnich i odsetków, a także dla wyższych momentów i interakcji, oraz wykresy rozkładów. W przykładzie po ważeniu ATE wszystkie SMD wyniosły co najwyżej 0.04, a po ważeniu ATT co najwyżej 0.03 (rysunek 2). Najwyższy iloraz wariancji po ważeniu ATE (1.17 dla wyczerpania na starcie) mieści się w akceptowalnym zakresie.
Efekt i błąd standardowy
Efekt szacujesz w ważonej regresji wyniku na udział w programie. Zwykły błąd standardowy z lm() z wagami jest tu niepoprawny, bo traktuje wagi jak liczbę obserwacji. Masz dwie dobre opcje: odporny błąd standardowy (np. HC0 z pakietu sandwich) albo bootstrap, w którym w każdej próbie od nowa szacujesz PS i wagi. W przykładzie:
- ATE: −2.79 punktu; odporny SE = 0.47, 95% CI [−3.70, −1.87]; bootstrap (1000 prób) SE = 0.34, 95% CI [−3.42, −2.08];
- ATT: −3.30 punktu; odporny SE = 0.44, 95% CI [−4.17, −2.44].
Przedział z bootstrapu jest tu węższy niż odporny. Odporny błąd pomija to, że PS został oszacowany, i w tej sytuacji okazał się bardziej zachowawczy. W artykule napisz, którą metodę wybrałeś, i nie zmieniaj jej po obejrzeniu wyników.
Przycinanie wag
Cole i Hernán (2008) opisują kompromis między obciążeniem a precyzją i proponują przycinanie wag jako prosty sposób radzenia sobie ze skrajnymi wartościami. Po przycięciu wag stabilizowanych na 1. i 99. percentylu efekt wyniósł −2.56, 95% CI [−3.44, −1.68]. Przycięcie przesunęło oszacowanie w stronę zera, co jest typową ceną za większą stabilność. Traktuj taki wynik jako analizę wrażliwości, a nie jako główne oszacowanie wybrane dlatego, że lepiej wygląda.
Porównanie metod na jednych danych
Rysunek 3 zestawia wszystkie oszacowania z prawdziwymi efektami, które znamy tylko dzięki symulacji. Surowa różnica (−1.06) jest daleko od obu. Dopasowanie (−3.16) i IPTW dla ATT (−3.30) trafiają w okolice prawdziwego ATT (−3.01), a IPTW dla ATE (−2.79) – w okolice prawdziwego ATE (−2.68). Gdybyśmy porównali wynik dopasowania z wynikiem IPTW dla ATE i uznali, że metody „dają różne wyniki”, popełnilibyśmy błąd. Odpowiadają na różne pytania.
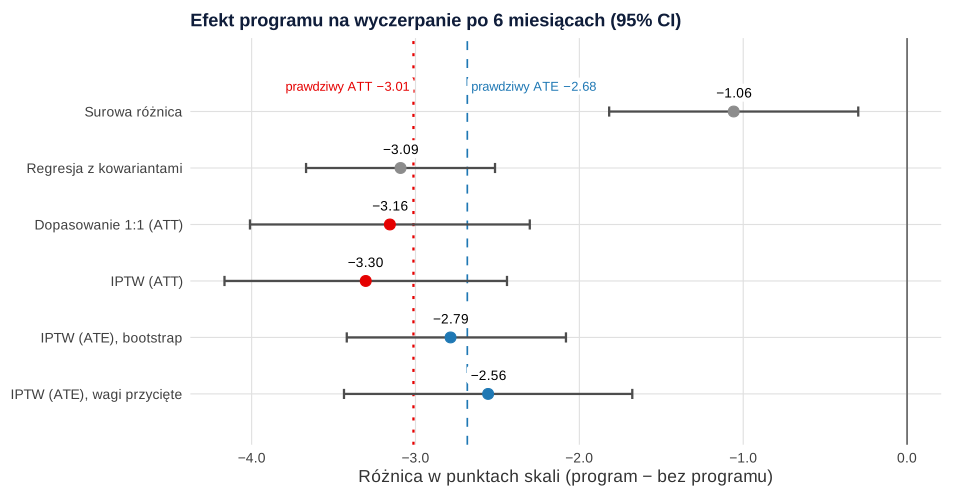
Zwykła regresja z sześcioma kowariantami dała −3.09, 95% CI [−3.67, −2.51]. Jest więc blisko i ma najwęższy przedział. Czy propensity score jest w ogóle potrzebny? Różnice między podejściami są praktyczne. PS oddziela projekt od analizy wyniku, pozwala sprawdzić równowagę i wspólny zakres, a regresja tego nie pokazuje. Przy rzadkim wyniku dychotomicznym pozwala też uwzględnić wiele kowariantów. Regresja daje dobry wynik wtedy, gdy model wyniku jest poprawnie określony. W naszej symulacji związek był liniowy, więc regresja miała łatwe zadanie. W prawdziwych danych tego nie wiesz. Dlatego rozsądnie jest podać wynik metody PS jako główny, a regresję jako analizę uzupełniającą, albo połączyć oba podejścia, jak w kroku 5.
Krok 7. Analiza wrażliwości: E-value
Ponieważ PS nie usuwa niezmierzonego zakłócenia, recenzent zapyta: „A gdyby uczestnicy byli bardziej zmotywowani do dbania o siebie?”. Na to pytanie odpowiada analiza wrażliwości. VanderWeele i Ding (2017) zaproponowali E-value: najmniejszą siłę związku, wyrażoną jako ryzyko względne, jaką niezmierzona zmienna musiałaby mieć zarówno z udziałem, jak i z wynikiem, by całkowicie wyjaśnić obserwowany efekt. Autorzy zalecają podawanie E-value dla oszacowania punktowego i dla granicy przedziału ufności bliższej braku efektu.
E-value liczy się z ryzyka względnego, dlatego w przykładzie zdefiniowaliśmy wynik dychotomiczny: wysokie wyczerpanie po sześciu miesiącach (co najmniej 30 punktów). Bez korekty dotyczyło ono 29.2% uczestników i 32.7% pozostałych osób (RR = 0.89). Po ważeniu IPTW (ATE) odsetki wyniosły 23.1% i 35.8%, RR = 0.65, 95% CI z bootstrapu [0.51, 0.80]. Dla RR < 1 bierzesz odwrotność (1/0.65), a E-value liczysz ze wzoru:
Wynik: E-value = 2.48 dla oszacowania punktowego i 1.81 dla górnej granicy przedziału. Interpretacja: niezmierzona zmienna musiałaby być związana zarówno z udziałem w programie, jak i z wysokim wyczerpaniem ryzykiem względnym co najmniej 2.48, by całkowicie wyjaśnić obserwowany efekt. Do przesunięcia przedziału tak, by objął 1, wystarczyłby związek o sile 1.81. Czy to dużo? Porównaj tę wartość z siłą związków zmierzonych zmiennych. Jeśli nawet wyczerpanie na starcie nie wiąże się z wynikiem tak silnie, trudno o niezmierzony czynnik o takiej sile. E-value nie dowodzi braku zakłócenia, ale pozwala rzeczowo o nim dyskutować.
Jak opisać analizę w artykule
Dla badań obserwacyjnych punktem odniesienia jest lista STROBE. Von Elm i in. (2007) opisują 22 punkty: od tytułu i streszczenia po dyskusję, z częścią wspólną dla badań kohortowych, kliniczno-kontrolnych i przekrojowych. Dla analizy PS w części „Metoda” opisz:
- szacowany efekt (ATE czy ATT) i uzasadnienie wyboru;
- zmienne w modelu PS z uzasadnieniem (najlepiej graf przyczynowy w materiałach uzupełniających);
- metodę: algorytm dopasowania, proporcję, zwracanie, kaliper albo rodzaj wag i ewentualne przycinanie;
- diagnostykę: SMD i ilorazy wariancji przed korektą i po niej, wspólny zakres, liczbę odrzuconych osób, efektywną liczebność;
- model wyniku i metodę liczenia błędu standardowego;
- analizy wrażliwości: inną metodę PS, przycięte wagi, E-value.
W dyskusji nazwij wynik ostrożnie, np. „efekt oszacowany przy założeniu braku niezmierzonego zakłócenia”, i odnieś się do E-value. Jak odpowiadać recenzentom, którzy pytają o przyczynowość w danych obserwacyjnych, pokazujemy w poradniku zarzuty recenzentów do statystyki. Jeśli w doktoracie łączysz kilka takich analiz, zajrzyj też do poradnika analiza statystyczna w doktoracie.
Propensity score w R bez MatchIt i WeightIt
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Uruchom przepisy po kolei w jednej sesji R, bo każdy korzysta z obiektów z poprzedniego. Dopasowanie, wagi i diagnostyka równowagi są zaprogramowane funkcjami bazowego R. Pakiet sandwich liczy odporne błędy standardowe. Pierwszy przepis zapisuje plik CSV do pobrania. Bootstrap w przepisie 3 trwa kilka sekund.
1. Dane, równowaga przed korektą i model PS
R
# Przykład: program redukcji stresu dla personelu szpitali a wyczerpanie emocjonalne (dane symulowane, set.seed(9101)).
# 1200 osób (pielęgniarki, pielęgniarze, ratownicy); udział w 8-tygodniowym programie był dobrowolny.
# Wynik: wyczerpanie emocjonalne po 6 miesiącach (skala 9–45, wyżej = większe wyczerpanie).
# Pakiety MatchIt, WeightIt i cobalt nie są tu zainstalowane, dlatego dopasowanie, wagi i równowagę liczymy
# funkcjami bazowego R; pakiet sandwich (odporne błędy standardowe) jest zainstalowany.
set.seed(9101)
n <- 1200
wiek      <- round(pmin(64, pmax(23, rnorm(n, 41, 10))))
staz      <- round(pmax(0, wiek - 23 - abs(rnorm(n, 2, 3))))               # staż pracy w latach
kobieta   <- rbinom(n, 1, .82)
nocne     <- rbinom(n, 1, .55)                                             # praca w systemie zmianowym z nocami
godziny   <- round(pmin(60, pmax(24, rnorm(n, 40 + 4 * nocne, 6))))       # godziny pracy w tygodniu
wycz0     <- round(pmin(45, pmax(9, rnorm(n, 26 + 0.25 * (godziny - 40) + 1.5 * nocne, 6.5))))   # wyczerpanie na starcie
# Kto zgłasza się do programu? Bardziej wyczerpani, częściej kobiety, rzadziej osoby z nocnymi zmianami i starsze
logit_ps <- -1.5 + 0.11 * (wycz0 - 26) + 0.5 * kobieta - 0.6 * nocne - 0.025 * (wiek - 41) - 0.03 * (godziny - 40)
program  <- rbinom(n, 1, plogis(logit_ps))
# Wyniki potencjalne: efekt programu silniejszy u osób bardziej wyczerpanych na starcie (ATE ≠ ATT)
efekt_i <- -2.5 - 0.12 * (wycz0 - 26)
y0 <- 6 + 0.65 * wycz0 + 0.10 * godziny + 1.2 * nocne - 0.03 * wiek + rnorm(n, 0, 4)
y1 <- y0 + efekt_i
wycz6 <- round(pmin(45, pmax(9, ifelse(program == 1, y1, y0))))
dane <- data.frame(id = 1:n, program, wiek, staz, kobieta, nocne, godziny, wycz0, wycz6)
write.csv(dane, "../propensity-score-dane.csv", row.names = FALSE)    # plik do pobrania
cat("Prawdziwe efekty w tej próbie (znane tylko w symulacji):\n")
round(c(ATE = mean(efekt_i), ATT = mean(efekt_i[program == 1])), 2)

kow <- c("wiek", "staz", "kobieta", "nocne", "godziny", "wycz0")
binarne <- c("kobieta", "nocne")
table(program)

# Krok 1. Równowaga przed korektą: SMD i iloraz wariancji (mianownik SMD: SD z całej próby przed korektą)
smd <- function(x, t, w = rep(1, length(x)), bin = FALSE) {
  m1 <- weighted.mean(x[t == 1], w[t == 1]); m0 <- weighted.mean(x[t == 0], w[t == 0])
  if (bin) { p1 <- mean(x[t == 1]); p0 <- mean(x[t == 0]); s <- sqrt((p1 * (1 - p1) + p0 * (1 - p0)) / 2) }
  else s <- sqrt((var(x[t == 1]) + var(x[t == 0])) / 2)
  (m1 - m0) / s
}
wvar <- function(x, w) { m <- weighted.mean(x, w); sum(w * (x - m)^2) / sum(w) }
vr <- function(x, t, w = rep(1, length(x))) wvar(x[t == 1], w[t == 1]) / wvar(x[t == 0], w[t == 0])
rownowaga <- function(d, w = rep(1, nrow(d))) {
  t(sapply(kow, function(v) c(
    M_program  = weighted.mean(d[[v]][d$program == 1], w[d$program == 1]),
    M_kontrola = weighted.mean(d[[v]][d$program == 0], w[d$program == 0]),
    SMD = smd(d[[v]], d$program, w, v %in% binarne),
    VR  = if (v %in% binarne) NA else vr(d[[v]], d$program, w))))
}
round(rownowaga(dane), 2)
# Do tabeli 1: M (SD) dla zmiennych ilościowych i odsetek dla zmiennych 0/1 w każdej grupie
sapply(split(dane[kow], dane$program), function(d)
  sapply(kow, function(v) if (v %in% binarne) sprintf("%.1f%%", 100 * mean(d[[v]])) else sprintf("%.2f (%.2f)", mean(d[[v]]), sd(d[[v]]))))

# Krok 2. Model propensity score (regresja logistyczna, tylko cechy sprzed decyzji o udziale)
ps_model <- glm(program ~ wiek + staz + kobieta + nocne + godziny + wycz0, family = binomial, data = dane)
round(summary(ps_model)$coefficients, 3)
dane$ps <- fitted(ps_model)
dane$logit_ps <- qlogis(dane$ps)
round(sapply(split(dane$ps, dane$program), quantile, c(0, .05, .5, .95, 1)), 3)
# Wspólny zakres: osoby z programu spoza zakresu PS grupy kontrolnej i odwrotnie
zakres0 <- range(dane$ps[dane$program == 0]); zakres1 <- range(dane$ps[dane$program == 1])
c(program_poza = sum(dane$program == 1 & (dane$ps < zakres0[1] | dane$ps > zakres0[2])),
  kontrola_poza = sum(dane$program == 0 & (dane$ps < zakres1[1] | dane$ps > zakres1[2])))
Wynik w R
Prawdziwe efekty w tej próbie (znane tylko w symulacji):
  ATE   ATT
-2.68 -3.01
program
  0   1
923 277
        M_program M_kontrola   SMD   VR
wiek        39.11      41.51 -0.25 0.98
staz        13.46      16.00 -0.27 1.02
kobieta      0.88       0.82  0.19   NA
nocne        0.45       0.54 -0.19   NA
godziny     41.49      41.98 -0.08 1.08
wycz0       30.27      26.71  0.55 0.99
        0              1
wiek    "41.51 (9.51)" "39.11 (9.45)"
staz    "16.00 (9.35)" "13.46 (9.45)"
kobieta "81.6%"        "88.4%"
nocne   "54.4%"        "45.1%"
godziny "41.98 (6.27)" "41.49 (6.51)"
wycz0   "26.71 (6.48)" "30.27 (6.45)"
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   -3.943      1.052  -3.747    0.000
wiek           0.044      0.034   1.289    0.198
staz          -0.072      0.035  -2.060    0.039
kobieta        0.641      0.214   2.994    0.003
nocne         -0.464      0.152  -3.053    0.002
godziny       -0.030      0.012  -2.467    0.014
wycz0          0.104      0.012   8.494    0.000
         0     1
0%   0.019 0.039
5%   0.065 0.105
50%  0.185 0.286
95%  0.440 0.541
100% 0.812 0.727
 program_poza kontrola_poza
            0             9
2. Dopasowanie 1:1 z kaliprem i efekt ATT
R
# Krok 3. Dopasowanie 1:1 najbliższego sąsiada na logicie PS, bez zwracania, z kaliperem 0.2 SD logitu PS.
# Korzysta z obiektów z przepisu 1 (dane, rownowaga, kow).
kaliper <- 0.2 * sd(dane$logit_ps)
round(kaliper, 3)
dopasuj <- function(d, kaliper) {
  leczeni <- which(d$program == 1)
  leczeni <- leczeni[order(d$logit_ps[leczeni], decreasing = TRUE)]   # zaczynamy od najwyższych PS (najtrudniejszych)
  wolni <- which(d$program == 0)
  para <- rep(NA_integer_, nrow(d))
  for (i in seq_along(leczeni)) {
    j <- leczeni[i]
    odl <- abs(d$logit_ps[wolni] - d$logit_ps[j])
    if (length(odl) && min(odl) <= kaliper) {
      k <- wolni[which.min(odl)]
      para[c(j, k)] <- i
      wolni <- setdiff(wolni, k)
    }
  }
  para
}
dane$para <- dopasuj(dane, kaliper)
dop <- dane[!is.na(dane$para), ]
c(par = length(unique(dop$para)), odrzuceni_z_programu = sum(dane$program == 1) - length(unique(dop$para)))
round(rownowaga(dop), 2)

# Efekt w próbie dopasowanej (ATT): różnica średnich i regresja z kowariantami;
# błędy standardowe odporne, grupowane według par (pakiet sandwich)
library(sandwich)
se_cl <- function(m) sqrt(diag(vcovCL(m, cluster = ~ para)))["program"]
wynik_att <- function(m) { b <- coef(m)[["program"]]; s <- unname(se_cl(m))
  c(round(c(b = b, SE = s, CI_dolna = b - qnorm(.975) * s, CI_gorna = b + qnorm(.975) * s), 3),
    p = signif(2 * pnorm(-abs(b / s)), 2)) }
m_dop  <- lm(wycz6 ~ program, data = dop)
m_dop2 <- lm(wycz6 ~ program + wiek + staz + kobieta + nocne + godziny + wycz0, data = dop)
rbind(roznica_srednich = wynik_att(m_dop), z_kowariantami = wynik_att(m_dop2))
round(tapply(dop$wycz6, dop$program, mean), 2)
Wynik w R
[1] 0.156
                 par odrzuceni_z_programu
                 275                    2
        M_program M_kontrola   SMD   VR
wiek        39.16      39.61 -0.05 0.99
staz        13.52      14.04 -0.06 1.04
kobieta      0.88       0.88  0.02   NA
nocne        0.45       0.46 -0.01   NA
godziny     41.54      41.54  0.00 1.08
wycz0       30.23      30.33 -0.02 1.10
                      b    SE CI_dolna CI_gorna       p
roznica_srednich -3.156 0.436    -4.01   -2.303 4.3e-13
z_kowariantami   -3.088 0.338    -3.75   -2.426 5.9e-20
    0     1
29.01 25.86
3. IPTW, bootstrap, przycinanie wag i E-value
R
# Krok 4. Ważenie odwrotnością prawdopodobieństwa (IPTW). Korzysta z obiektów z przepisów 1–2.
t1 <- dane$program == 1
dane$w_ate <- ifelse(t1, 1 / dane$ps, 1 / (1 - dane$ps))                     # efekt w całej populacji (ATE)
p_t <- mean(t1)
dane$w_stab <- ifelse(t1, p_t / dane$ps, (1 - p_t) / (1 - dane$ps))         # wagi stabilizowane (ATE)
dane$w_att <- ifelse(t1, 1, dane$ps / (1 - dane$ps))                         # efekt u uczestników (ATT)
opis_wag <- function(w) round(c(min = min(w), mediana = median(w), max = max(w), suma = sum(w)), 2)
rbind(ATE_program = opis_wag(dane$w_ate[t1]), ATE_kontrola = opis_wag(dane$w_ate[!t1]),
      stab_program = opis_wag(dane$w_stab[t1]), stab_kontrola = opis_wag(dane$w_stab[!t1]),
      ATT_kontrola = opis_wag(dane$w_att[!t1]))
# Efektywna liczebność (Kish): (suma wag)^2 / suma kwadratów wag
ess <- function(w) sum(w)^2 / sum(w^2)
round(c(ATE_program = ess(dane$w_ate[t1]), ATE_kontrola = ess(dane$w_ate[!t1]),
        ATT_kontrola = ess(dane$w_att[!t1])), 1)

# Równowaga po ważeniu
round(rownowaga(dane, dane$w_stab), 2)
round(rownowaga(dane, dane$w_att), 2)

# Efekty: ważona regresja z odpornym SE (HC0) i bootstrap z ponownym szacowaniem PS
wynik_w <- function(m) { b <- coef(m)[["program"]]; s <- sqrt(vcovHC(m, type = "HC0")["program", "program"])
  c(round(c(b = b, SE = s, CI_dolna = b - qnorm(.975) * s, CI_gorna = b + qnorm(.975) * s), 3),
    p = signif(2 * pnorm(-abs(b / s)), 2)) }
m_ate <- lm(wycz6 ~ program, data = dane, weights = w_stab)
m_att <- lm(wycz6 ~ program, data = dane, weights = w_att)
rbind(IPTW_ATE = wynik_w(m_ate), IPTW_ATT = wynik_w(m_att))

set.seed(9102)
boot_ate <- replicate(1000, {
  d <- dane[sample(nrow(dane), replace = TRUE), ]
  ps <- fitted(glm(program ~ wiek + staz + kobieta + nocne + godziny + wycz0, binomial, d))
  w <- ifelse(d$program == 1, 1 / ps, 1 / (1 - ps))
  coef(lm(wycz6 ~ program, d, weights = w))[["program"]]
})
round(c(SE_boot = sd(boot_ate), quantile(boot_ate, c(.025, .975))), 3)

# Wrażliwość na skrajne wagi: przycięcie wag ATE na 1. i 99. percentylu
gr <- quantile(dane$w_stab, c(.01, .99))
dane$w_ciete <- pmin(pmax(dane$w_stab, gr[1]), gr[2])
rbind(przyciete = wynik_w(lm(wycz6 ~ program, data = dane, weights = w_ciete)))

# Dla porównania: surowa różnica i zwykła regresja z kowariantami
rbind(surowa = wynik_w(lm(wycz6 ~ program, data = dane)),
      regresja = wynik_w(lm(wycz6 ~ program + wiek + staz + kobieta + nocne + godziny + wycz0, data = dane)))

# Krok 5. Wynik dychotomiczny i analiza wrażliwości (E-value)
dane$wysokie6 <- as.integer(dane$wycz6 >= 30)                            # wysokie wyczerpanie po 6 miesiącach
ryzyko <- function(d, w) c(p1 = weighted.mean(d$wysokie6[d$program == 1], w[d$program == 1]),
                           p0 = weighted.mean(d$wysokie6[d$program == 0], w[d$program == 0]))
r_sur <- ryzyko(dane, rep(1, nrow(dane))); r_w <- ryzyko(dane, dane$w_ate)
round(rbind(surowe = c(r_sur, RR = r_sur[[1]] / r_sur[[2]]), IPTW = c(r_w, RR = r_w[[1]] / r_w[[2]])), 3)
set.seed(9103)
boot_rr <- replicate(1000, {
  d <- dane[sample(nrow(dane), replace = TRUE), ]
  ps <- fitted(glm(program ~ wiek + staz + kobieta + nocne + godziny + wycz0, binomial, d))
  r <- ryzyko(d, ifelse(d$program == 1, 1 / ps, 1 / (1 - ps))); r[[1]] / r[[2]]
})
ci_rr <- quantile(boot_rr, c(.025, .975)); round(ci_rr, 3)
# E-value (VanderWeele i Ding, 2017): dla RR < 1 bierzemy 1/RR; E = RR + sqrt(RR * (RR - 1))
e_value <- function(rr) { rr <- ifelse(rr < 1, 1 / rr, rr); rr + sqrt(rr * (rr - 1)) }
# dla granicy CI bliższej 1 (tu górnej); gdy CI obejmuje 1, E-value dla granicy wynosi 1
round(c(E_punkt = e_value(r_w[[1]] / r_w[[2]]), E_granica_CI = if (ci_rr[[2]] >= 1) 1 else e_value(ci_rr[[2]])), 2)
Wynik w R
               min mediana   max    suma
ATE_program   1.37    3.49 25.79 1201.27
ATE_kontrola  1.02    1.23  5.33 1202.06
stab_program  0.32    0.81  5.95  277.29
stab_kontrola 0.78    0.94  4.10  924.58
ATT_kontrola  0.02    0.23  4.33  279.06
 ATE_program ATE_kontrola ATT_kontrola
       186.6        883.3        503.5
        M_program M_kontrola   SMD   VR
wiek        41.15      40.98  0.02 1.01
staz        15.70      15.43  0.03 1.09
kobieta      0.85       0.83  0.04   NA
nocne        0.50       0.52 -0.03   NA
godziny     42.05      41.85  0.03 1.00
wycz0       27.44      27.57 -0.02 1.17
        M_program M_kontrola   SMD   VR
wiek        39.11      39.19 -0.01 1.03
staz        13.46      13.55 -0.01 1.10
kobieta      0.88       0.89 -0.01   NA
nocne        0.45       0.44  0.02   NA
godziny     41.49      41.41  0.01 0.97
wycz0       30.27      30.43 -0.03 1.01
              b    SE CI_dolna CI_gorna       p
IPTW_ATE -2.786 0.467   -3.701   -1.871 2.4e-09
IPTW_ATT -3.304 0.440   -4.166   -2.442 5.8e-14
SE_boot    2.5%   97.5%
  0.339  -3.419  -2.082
               b    SE CI_dolna CI_gorna       p
przyciete -2.557 0.449   -3.436   -1.677 1.2e-08
              b    SE CI_dolna CI_gorna       p
surowa   -1.058 0.388   -1.818   -0.298 6.4e-03
regresja -3.091 0.294   -3.668   -2.515 8.0e-26
          p1    p0    RR
surowe 0.292 0.327 0.894
IPTW   0.231 0.358 0.645
 2.5% 97.5%
 0.51  0.80
     E_punkt E_granica_CI
        2.48         1.81
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje glm(), lm() i quantile() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. Pakiety MatchIt, WeightIt i cobalt nie były używane. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Zmienne zmierzone po rozpoczęciu interwencji w modelu PS. Mediator albo skutek interwencji w modelu zniekształca efekt (Rohrer, 2018).
- Dobór zmiennych pod kątem trafności przewidywania udziału, np. selekcja krokowa albo pole pod krzywą ROC. Celem jest równowaga, a nie predykcja (Brookhart i in., 2006).
- Ocena równowagi testami t i chi-kwadrat. W dużej próbie małe różnice są istotne, w małej duże – nieistotne. Podawaj SMD i ilorazy wariancji.
- Brak diagnostyki po ważeniu. IPTW nie gwarantuje równowagi; sprawdź ważone SMD (Austin i Stuart, 2015).
- Zwykły błąd standardowy z ważonej regresji albo z próby dopasowanej, jakby pary były niezależnymi osobami.
- Mylenie ATE i ATT i porównywanie wyników dopasowania i IPTW tak, jakby odpowiadały na to samo pytanie.
- Przemilczenie osób bez pary albo osób spoza wspólnego zakresu. Zmienia to populację, do której odnosi się wynik.
- Ignorowanie skrajnych wag albo przycinanie ich dopiero wtedy, gdy wynik „nie wychodzi”.
- Język przyczynowy bez zastrzeżeń. Propensity score nie zastępuje randomizacji. Pisz o efekcie przy założeniu braku niezmierzonego zakłócenia i podaj analizę wrażliwości.
- PS jako lek na mały zbiór danych. Przy kilkudziesięciu uczestnikach i wielu cechach wyniki są niestabilne; rozważ prostszy model albo plan quasi-eksperymentalny, np. różnicę w różnicach, gdy masz pomiary przed interwencją w wielu jednostkach.
Jeśli przygotowujesz artykuł albo rozdział rozprawy na danych obserwacyjnych i chcesz, żeby ktoś sprawdził model PS, diagnostykę i opis, możesz skorzystać z oferty analizy statystyczne dla badaczy. Konsultacja obejmuje wyjaśnienie decyzji, tak żebyś mógł je obronić przed recenzentami.
Najczęstsze pytania
Czym różni się ATE od ATT w analizie propensity score?
ATE to średni efekt interwencji w całej populacji, a ATT – średni efekt u osób, które faktycznie ją otrzymały. Gdy uczestnicy różnią się od reszty i efekt zależy od ich cech, obie wartości się różnią. Dopasowanie uczestników do kontroli i wagi PS/(1 − PS) szacują ATT, a wagi 1/PS i 1/(1 − PS) – ATE.
Jaki kaliper wybrać przy dopasowaniu na propensity score?
Najczęściej stosuje się kaliper równy 0.2 odchylenia standardowego logitu propensity score. Austin (2011) w symulacjach pokazał, że taka szerokość usuwała co najmniej 98% obciążenia surowego oszacowania i dawała przedziały ufności o prawie poprawnym pokryciu. Zawsze podaj, ilu uczestników nie znalazło pary w granicach kalipra.
Jak policzyć błąd standardowy po ważeniu IPTW?
Nie używaj zwykłego błędu z ważonej regresji, bo traktuje on wagi jak liczbę obserwacji. Użyj odpornego błędu standardowego (np. HC0 w pakiecie sandwich) albo bootstrapu, w którym w każdej próbie od nowa szacujesz propensity score i wagi. Metodę wybierz przed analizą i opisz ją w artykule.
Co to jest E-value i jak je interpretować?
E-value to najmniejsza siła związku na skali ryzyka względnego, jaką niezmierzona zmienna zakłócająca musiałaby mieć zarówno z interwencją, jak i z wynikiem, by w pełni wyjaśnić obserwowany efekt (VanderWeele i Ding, 2017). Dla RR > 1 liczy się je ze wzoru RR + √(RR × (RR − 1)), a dla RR < 1 – z odwrotności RR. Podaj je dla oszacowania punktowego i dla granicy przedziału ufności bliższej 1.
Czy w R da się zrobić propensity score matching bez pakietu MatchIt?
Tak. Propensity score oszacujesz funkcją glm(), dopasowanie najbliższego sąsiada z kaliprem zaprogramujesz w kilkunastu wierszach, a standaryzowane różnice policzysz funkcją weighted.mean(). Odporny błąd grupowany według par da pakiet sandwich. Taki kod pokazujemy w tym wpisie; wynik powinien odpowiadać pakietom z tymi samymi ustawieniami.
Powiązane hasła
Przeczytaj też
Quasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →Analizujesz dane obserwacyjne do artykułu lub doktoratu?
Sprawdzimy model propensity score, równowagę grup i błędy standardowe, przygotujemy analizy wrażliwości i wyjaśnimy decyzje tak, żebyś mógł je obronić przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2009). Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine, 28(25), 3083–3107. https://doi.org/10.1002/sim.3697 ● Otwarty dostęp
- Austin, P. C. (2011). Optimal caliper widths for propensity-score matching when estimating differences in means and differences in proportions in observational studies. Pharmaceutical Statistics, 10(2), 150–161. https://doi.org/10.1002/pst.433 ● Otwarty dostęp
- Austin, P. C., & Stuart, E. A. (2015). Moving towards best practice when using inverse probability of treatment weighting (IPTW) using the propensity score to estimate causal treatment effects in observational studies. Statistics in Medicine, 34(28), 3661–3679. https://doi.org/10.1002/sim.6607 ● Otwarty dostęp
- Brookhart, M. A., Schneeweiss, S., Rothman, K. J., Glynn, R. J., Avorn, J., & Stürmer, T. (2006). Variable selection for propensity score models. American Journal of Epidemiology, 163(12), 1149–1156. https://doi.org/10.1093/aje/kwj149 ● Otwarty dostęp
- Cole, S. R., & Hernán, M. A. (2008). Constructing inverse probability weights for marginal structural models. American Journal of Epidemiology, 168(6), 656–664. https://doi.org/10.1093/aje/kwn164 ● Otwarty dostęp
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41 ● Otwarty dostęp
- Stuart, E. A. (2010). Matching methods for causal inference: A review and a look forward. Statistical Science, 25(1), 1–21. https://doi.org/10.1214/09-sts313 ● Otwarty dostęp: pełny tekst
- VanderWeele, T. J., & Ding, P. (2017). Sensitivity analysis in observational research: Introducing the E-value. Annals of Internal Medicine, 167(4), 268–274. https://doi.org/10.7326/m16-2607 ● Otwarty dostęp: pełny tekst
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
Cytowania BibTeX
@article{austin2009balance, author={Austin, Peter C.}, title={{Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={25}, pages={3083--3107}, doi={10.1002/sim.3697}}@article{austin2011optimal, author={Austin, Peter C.}, title={{Optimal caliper widths for propensity-score matching when estimating differences in means and differences in proportions in observational studies}}, journal={Pharmaceutical Statistics}, year={2011}, volume={10}, number={2}, pages={150--161}, doi={10.1002/pst.433}}@article{austin2015moving, author={Austin, Peter C. and Stuart, Elizabeth A.}, title={{Moving towards best practice when using inverse probability of treatment weighting (IPTW) using the propensity score to estimate causal treatment effects in observational studies}}, journal={Statistics in Medicine}, year={2015}, volume={34}, number={28}, pages={3661--3679}, doi={10.1002/sim.6607}}@article{brookhart2006variable, author={Brookhart, M. Alan and Schneeweiss, Sebastian and Rothman, Kenneth J. and Glynn, Robert J. and Avorn, Jerry and Stürmer, Til}, title={{Variable selection for propensity score models}}, journal={American Journal of Epidemiology}, year={2006}, volume={163}, number={12}, pages={1149--1156}, doi={10.1093/aje/kwj149}}@article{cole2008constructing, author={Cole, Stephen R. and Hernán, Miguel A.}, title={{Constructing inverse probability weights for marginal structural models}}, journal={American Journal of Epidemiology}, year={2008}, volume={168}, number={6}, pages={656--664}, doi={10.1093/aje/kwn164}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{rosenbaum1983central, author={Rosenbaum, Paul R. and Rubin, Donald B.}, title={{The central role of the propensity score in observational studies for causal effects}}, journal={Biometrika}, year={1983}, volume={70}, number={1}, pages={41--55}, doi={10.1093/biomet/70.1.41}}@article{stuart2010matching, author={Stuart, Elizabeth A.}, title={{Matching methods for causal inference: A review and a look forward}}, journal={Statistical Science}, year={2010}, volume={25}, number={1}, pages={1--21}, doi={10.1214/09-sts313}}@article{vanderweele2017sensitivity, author={VanderWeele, Tyler J. and Ding, Peng}, title={{Sensitivity analysis in observational research: Introducing the E-value}}, journal={Annals of Internal Medicine}, year={2017}, volume={167}, number={4}, pages={268--274}, doi={10.7326/m16-2607}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}