Gdy nie możesz losować: po co quasi-eksperyment
Program profilaktyczny trafia do szkół, które same się zgłosiły. Nowa procedura obowiązuje od września na jednym oddziale szpitala, a na innym nie. Ustawa zmienia zasady egzaminów w całym kraju. W żadnej z tych sytuacji nie decydujesz, kto dostanie interwencję, a mimo to ktoś pyta: czy to zadziałało? Eksperyment z randomizacją jest wykluczony, a proste porównanie „przed i po” albo „z programem i bez” prawie zawsze wprowadza w błąd.
Tu wchodzą schematy quasi-eksperymentalne: plany, w których interwencja jest wyraźnie określona w czasie i w grupach, ale przydział do niej nie jest losowy. Definicję i podstawowe odmiany opisuje hasło schemat quasi-eksperymentalny. Ten wpis jest praktyczny. Przechodzimy przez jeden z najczęściej używanych schematów, czyli metodę różnicy w różnicach (ang. difference-in-differences, DiD), od logiki i założeń po regresję, błędy standardowe, sprawdzenie trendów i wzór opisu w artykule. Wszystko na jednym przykładzie policzonym w R.
Wing i in. (2018) piszą wprost, że DiD nie zastępuje w pełni eksperymentu z randomizacją, ale często jest wykonalnym sposobem uczenia się o związkach przyczynowych tam, gdzie eksperyment byłby niewykonalny albo nieetyczny. Siła wniosku zależy od tego, jak starannie zaprojektujesz porównanie, a nie tylko od modelu statystycznego.
Rodzaje schematów quasi-eksperymentalnych
Harris i in. (2006) proponują hierarchię planów quasi-eksperymentalnych i zachęcają do wybierania planów z jej wyższych szczebli, bo dają mocniejsze dowody przyczynowe. W praktyce oznacza to zwykle dodanie grupy porównawczej i kilku pomiarów przed interwencją. Klasyczny podręcznik tej rodziny planów to praca Shadisha, Cooka i Campbella (2002). W praktyce badań psychologicznych i edukacyjnych spotkasz najczęściej cztery schematy.
| Schemat | Struktura danych | Kluczowe założenie | Przykład |
|---|---|---|---|
| Grupa nierównoważna z pretestem i posttestem | Dwie grupy, pomiar przed i po | Grupy zmieniałyby się tak samo bez interwencji | Klasy z programem i bez programu |
| Różnica w różnicach (DiD) | Grupy × okresy, często wiele okresów przed i po | Równoległe trendy przy braku interwencji | Szkoły, które wdrożyły program, i szkoły porównawcze |
| Przerwany szereg czasowy (ITS) | Długi szereg czasowy z wyraźnym momentem interwencji | Trend sprzed interwencji przedłużyłby się bez niej | Miesięczna liczba zgłoszeń do poradni przed i po kampanii |
| Regresja nieciągła (RD) | Przydział według progu zmiennej przydziału | Tuż przy progu grupy różnią się tylko interwencją | Zajęcia wyrównawcze dla osób poniżej progu punktowego |
Przerwany szereg czasowy to schemat, który pozwala ocenić efekt interwencji na podstawie danych podłużnych (Kontopantelis i in., 2015). Zbierasz wiele pomiarów przed i po, a efekt widać jako zmianę poziomu albo nachylenia trendu. Dodanie do szeregu grupy porównawczej zbliża go do DiD. Regresja nieciągła wykorzystuje regułę przydziału: interwencję dostaje się wtedy, gdy wartość obserwowanej zmiennej leży po jednej stronie ustalonego progu (Imbens i Lemieux, 2008). Wnioski z RD dotyczą przede wszystkim osób w pobliżu progu. W tym wpisie RD i ITS tylko sygnalizujemy, a dalej zajmujemy się DiD.
Jeśli masz jedną grupę z pomiarem przed i po, zacznij od wpisu ANCOVA i analiza badania interwencyjnego przed i po. Opisuje on także, czym różni się analiza zmian od ANCOVA w grupach nierandomizowanych.
Logika różnicy w różnicach
Pomysł jest prosty. W grupie z interwencją widzisz zmianę wyniku między okresem „przed” a „po”. Ta zmiana składa się z efektu interwencji i ze wszystkiego, co i tak by się wydarzyło: wspólnego trendu, zmian w szkołach, sezonu, zdarzeń zewnętrznych. Grupa porównawcza, która interwencji nie dostała, pokazuje, jak duża byłaby zmiana bez niej. Odejmujesz jedną zmianę od drugiej:
Tu I oznacza grupę z interwencją, a K – grupę porównawczą. Pierwszy nawias to zmiana w grupie z programem, drugi – zmiana, której spodziewalibyśmy się w tej grupie bez programu. Stałe różnice poziomu między grupami (np. szkoły z programem mają zawsze wyższy stres) znoszą się, bo każda grupa jest porównywana sama ze sobą. Nie znoszą się natomiast różnice w tempie zmian. Stąd najważniejsze założenie metody.
Założenie równoległych trendów: gdyby interwencji nie było, średnie w obu grupach zmieniałyby się równolegle. To założenie dotyczy sytuacji, której nie obserwujemy (kontrfaktu), więc nie da się go udowodnić. Można je uprawdopodobnić: argumentami merytorycznymi i danymi z kilku okresów sprzed interwencji. Kahn-Lang i Lang (2020) dodają dwa wymagania, które łatwo pominąć. Po pierwsze, wyjaśnij, dlaczego grupy różniły się na starcie i dlaczego ta różnica nie miałaby wpływać na trendy. Po drugie, uzasadnij skalę pomiaru: trendy równoległe w punktach surowych nie muszą być równoległe po logarytmowaniu i odwrotnie.
Jak dobrać grupę porównawczą
W DiD grupa porównawcza nie musi być podobna do grupy z interwencją pod względem poziomu wyniku. Musi być podobna pod względem tego, jak wynik zmieniałby się w czasie. To inne kryterium niż w zwykłym dopasowaniu grup i warto je mieć z tyłu głowy już przy planowaniu badania.
- Ten sam kontekst zewnętrzny. Szkoły z tego samego regionu i typu przechodzą przez te same terminy egzaminów, zmiany przepisów i sezonowe wahania. Szkoły z innego województwa mogą mieć własne zdarzenia, które złamią równoległość.
- Brak kontaktu z interwencją. Grupa porównawcza nie powinna dostać „kawałka” programu przez wspólnych nauczycieli, materiały czy szkolenia.
- Ten sam pomiar. To samo narzędzie, te same terminy i ta sama procedura w obu grupach. Zmiana narzędzia tylko w jednej grupie wygląda w danych dokładnie jak efekt.
- Uzasadnienie wyboru zapisane przed analizą. Jeśli masz kilka kandydatów na grupę porównawczą, wybierz ją według kryteriów merytorycznych, a nie według tego, która daje „ładniejszy” wynik.
Różnice w cechach sprzed interwencji (np. odsetek uczniów z dysleksją, wielkość szkoły) opisz w tabeli z standaryzowaną różnicą średnich. Same różnice poziomu nie przekreślają DiD, ale cechy, które mogą wpływać na tempo zmian, są potencjalnymi zmiennymi zakłócającymi. Można je uwzględnić w modelu jako zmienne kontrolne albo pokazać analizę w podgrupach podobnych szkół.
Często pada pytanie, czy zamiast DiD nie wystarczy ANCOVA z pomiarem wyjściowym jako kowariantem. Te dwie analizy opierają się na różnych założeniach. DiD zakłada, że bez interwencji różnica między grupami pozostałaby stała. ANCOVA zakłada, że po uwzględnieniu wyniku wyjściowego grupy byłyby porównywalne. W eksperymencie z randomizacją oba założenia są zwykle spełnione. Przy grupach dobranych nielosowo mogą dać różne odpowiedzi i wtedy wybór trzeba uzasadnić merytorycznie, a nie wynikiem.
Przykład: program profilaktyki stresu egzaminacyjnego w szkołach
W przykładzie 24 licea przez sześć semestrów mierzyły stres egzaminacyjny uczniów na skali 10–50. Dwanaście szkół wdrożyło od czwartego semestru program profilaktyczny, dwanaście nie. W każdej szkole w każdym semestrze ankietę wypełniało 25 innych uczniów, więc dane to powtarzane przekroje, a nie panel tych samych osób. Razem 3600 obserwacji. Dane są symulowane, ale z dwoma cechami typowymi dla prawdziwych wdrożeń:
- do programu zgłosiły się szkoły, w których stres był wyższy już na starcie (selekcja);
- w całej populacji stres rośnie z semestru na semestr, bo zbliża się matura (wspólny trend).
W symulacji znamy prawdę: program obniża stres o 2.5 punktu. Dzięki temu widać, która metoda trafia, a która nie. Plik CSV z danymi pobierzesz w sekcji z kodem.
Krok 1. Tabela 2 × 2 i trzy błędne odpowiedzi
Zacznij od średnich w czterech komórkach: grupa × okres (semestry 1–3 to „przed”, 4–6 to „po”).
| Grupa | Przed (sem. 1–3) | Po (sem. 4–6) | Zmiana |
|---|---|---|---|
| Szkoły z programem | 31.16 | 30.84 | −0.32 |
| Szkoły porównawcze | 26.35 | 28.20 | 1.86 |
| Różnica w różnicach | −2.18 |
Z tej samej tabeli można wyczytać trzy różne „efekty”, z których tylko jeden ma sens:
- Porównanie tylko po interwencji: w szkołach z programem stres jest o 2.64 punktu wyższy. Program wygląda na szkodliwy, bo porównanie miesza efekt programu z różnicą, z którą szkoły do niego weszły.
- Przed–po tylko w szkołach z programem: spadek o 0.32 punktu, czyli „prawie nic”. Ta liczba miesza efekt programu ze wspólnym wzrostem stresu przed maturą.
- Różnica w różnicach: w szkołach porównawczych stres wzrósł o 1.86 punktu, a w szkołach z programem spadł o 0.32. Różnica zmian to −2.18 punktu, blisko prawdziwego efektu −2.5.
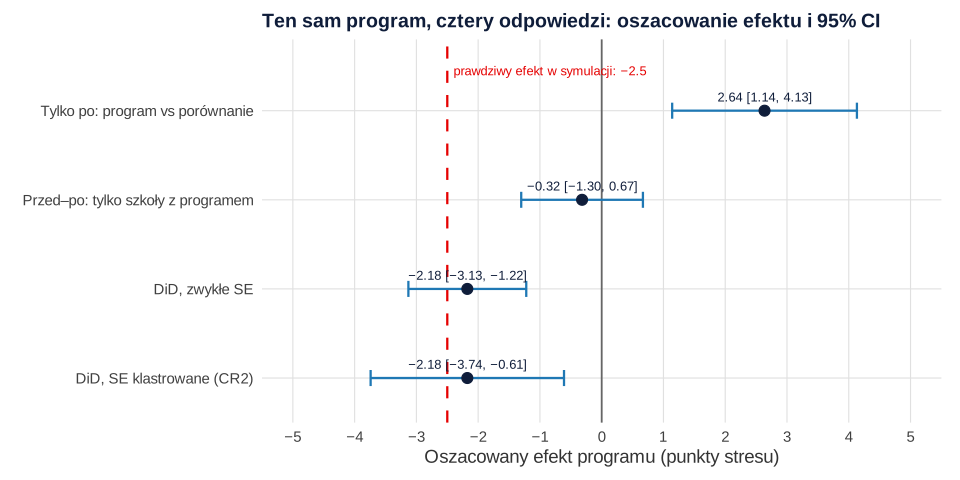
Rysunek 1 pokazuje też drugą lekcję: to samo oszacowanie DiD może mieć różne przedziały ufności. Do tego wrócimy w kroku 4. W jednostkach odchylenia standardowego wyniku sprzed programu (SD = 7.79) efekt wynosi −0.28. To użyteczna, choć przybliżona miara, którą możesz zestawić z innymi badaniami (zob. standaryzowana różnica średnich).
Krok 2. Sprawdź trendy przed interwencją na wykresie
Zanim policzysz jakikolwiek model, narysuj średnie w każdym okresie osobno dla obu grup. Wing i in. (2018) zalecają aktywne projektowanie badania DiD: dobór grupy porównawczej, analizy wrażliwości i sprawdziany odporności, które pomagają uzasadnić założenia. Wykres trendów to najprostszy z nich.
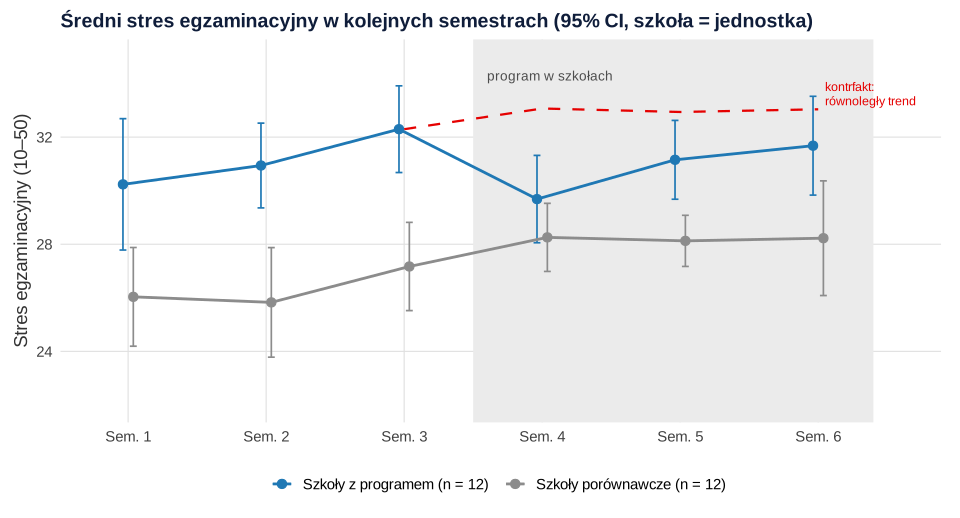
Przed programem obie linie biegną podobnie. W szkołach z programem średnie wynosiły 30.24, 30.94 i 32.30, a w porównawczych 26.04, 25.83 i 27.17. Różnica poziomów (średnio 4.81 punktu) jest duża, ale DiD jej nie potrzebuje znosić – wystarczy, że jest stała. Czerwona linia przerywana to kontrfakt: gdzie byłyby szkoły z programem, gdyby zmieniały się jak szkoły porównawcze. Odległość między nią a niebieską linią to efekt programu w kolejnych semestrach.
Z wykresem trendów wiążą się dwie pułapki. Po pierwsze, trzy punkty to mało, żeby ocenić równoległość, a przedziały ufności są szerokie. Po drugie, równoległe trendy przed interwencją są dla kontrfaktu tylko przesłanką: Kahn-Lang i Lang (2020) podkreślają, że nie są ani warunkiem koniecznym, ani wystarczającym. Coś, co wydarzyło się w szkołach z programem równocześnie z jego wdrożeniem (np. zmiana dyrekcji), złamie założenie, nawet jeśli wcześniejsze trendy były idealnie równoległe.
Krok 3. Regresja z interakcją: oszacowanie DiD
Tabelę 2 × 2 można zapisać jako regresję liniową z dwiema zmiennymi zero-jedynkowymi i ich interakcją:
- b0 = 26.35 – średnia w szkołach porównawczych przed programem;
- b1 = 4.81 – różnica między grupami przed programem (selekcja);
- b2 = 1.86 – zmiana w szkołach porównawczych (wspólny trend);
- b3 = −2.18 – oszacowanie DiD, czyli dodatkowa zmiana w szkołach z programem.
Regresja daje to samo co tabela, ale pozwala dodać zmienne kontrolne, policzyć poprawne błędy standardowe i rozszerzyć model na wiele okresów. Przy wielu okresach zwykle zastępuje się „program” i „po” efektami stałymi jednostek (tu: szkół) i okresów (tu: semestrów). To tzw. model z dwukierunkowymi efektami stałymi (ang. two-way fixed effects, TWFE). W naszych zrównoważonych danych daje on dokładnie to samo oszacowanie, −2.18.
Ostrożnie ze zmiennymi kontrolnymi. Dodawaj cechy zmierzone przed interwencją albo takie, na które program nie mógł wpłynąć. Kontrolowanie zmiennej, którą program zmienia (np. liczby godzin zajęć dodatkowych), może zabrać część efektu.
Uwaga na schematy, w których jednostki wchodzą do programu w różnych momentach. Goodman-Bacon (2021) pokazał, że wtedy estymator TWFE jest średnią ważoną wszystkich porównań „dwie grupy × dwa okresy”, także porównań jednostek leczonych wcześniej z leczonymi później, i jest obciążony, gdy efekt zmienia się w czasie. Roth i in. (2023) porządkują nowsze metody, które rozluźniają kanoniczne założenia DiD: dotyczące zróżnicowanego momentu wdrożenia, możliwych naruszeń równoległych trendów i wnioskowania. Przy wdrożeniu „falami” sięgnij po te metody zamiast prostego TWFE.
Krok 4. Błędy standardowe klastrowane po szkołach
Program przydzielono szkołom, nie uczniom. Uczniowie z tej samej szkoły dzielą nauczycieli, terminy sprawdzianów i lokalne zdarzenia, więc ich wyniki są skorelowane. Zwykła regresja tego nie wie i traktuje 3600 uczniów jak 3600 niezależnych informacji. Efekt: za małe błędy standardowe, za wąskie przedziały ufności i za dużo „istotnych” wyników. Cameron i Miller (2015) pokazują, że w danych pogrupowanych w klastry domyślne błędy standardowe mogą znacznie zawyżać precyzję, a przy dużej liczbie klastrów wnioskowanie powinno opierać się na błędach odpornych na klastrowanie.
Problem jest szczególnie poważny w DiD z wieloma okresami. Bertrand i in. (2004) w symulacji z fikcyjnymi ustawami na prawdziwych danych stanowych otrzymali „efekt” istotny na poziomie 5% aż dla 45% interwencji, które nie miały żadnego efektu. Przyczyną były błędy standardowe ignorujące korelację wyników w czasie.
| Błąd standardowy | SE | 95% CI | Test |
|---|---|---|---|
| Zwykły (zakłada niezależność uczniów) | 0.49 | [−3.13, −1.22] | t(3596) = −4.47, p < .001 |
| Klastrowany po szkołach (CR1) | 0.74 | [−3.62, −0.73] | p = .003 |
| Klastrowany CR2 z poprawką Satterthwaite’a | 0.76 | [−3.74, −0.61] | t(22) = −2.88, p = .009 |
Błąd klastrowany jest 1.52 raza większy od zwykłego. Wniosek się nie zmienia, ale przy słabszym efekcie mógłby. Przy 24 klastrach warto użyć poprawki dla małej liczby klastrów: wariantu CR2 z testem o stopniach swobody według Satterthwaite’a (pakiet clubSandwich). Liczba stopni swobody, 22, mówi wprost, że informację niesie 24 szkół, a nie 3600 uczniów. Gdy klastrów jest bardzo mało (np. kilka szkół), żadna poprawka nie uratuje wnioskowania. Wtedy zaplanuj więcej jednostek albo inny schemat. Ten sam problem przy planowaniu liczebności opisuje hasło efekt schematu, a modelowanie zagnieżdżenia – wpis model wielopoziomowy krok po kroku.
Krok 5. Model zdarzeń i test placebo
Wykres trendów warto uzupełnić formalnym sprawdzeniem. W modelu zdarzeń (ang. event study) zamiast jednej interakcji „program × po” szacujesz osobną różnicę dla każdego semestru, względem ostatniego semestru przed programem. Współczynniki dla semestrów przed programem powinny być bliskie zera. Współczynniki po programie pokazują, jak efekt rozkłada się w czasie.
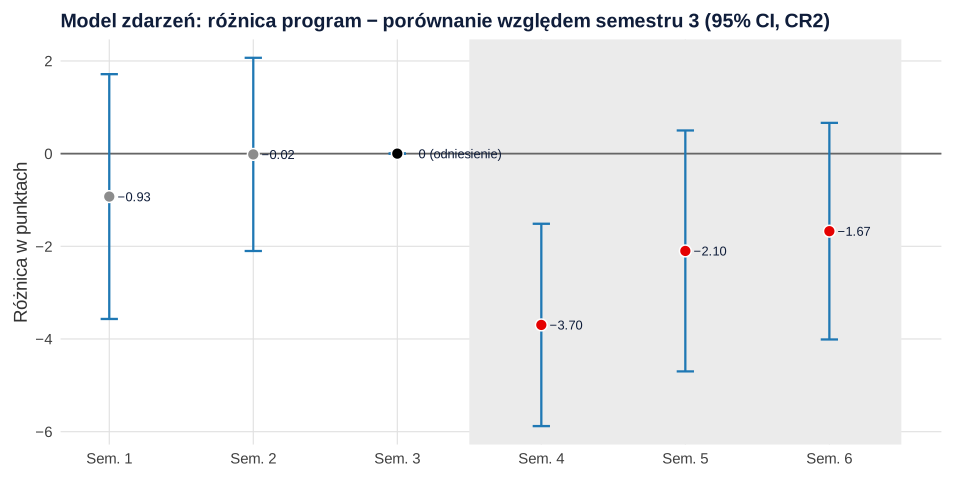
Przed programem różnice względem semestru 3 wynosiły −0.93, 95% CI [−3.57, 1.71], i −0.02, 95% CI [−2.10, 2.07]. Łączny test obu współczynników nie wskazał na różnicę trendów, F(2, 21) = 0.30, p = .742. Po wdrożeniu efekt wyniósł −3.70 w pierwszym semestrze, 95% CI [−5.88, −1.51], i −2.10 oraz −1.67 w kolejnych, z przedziałami obejmującymi zero. Pojedyncze semestry są oszacowane mniej precyzyjnie niż efekt uśredniony, dlatego nie wyciągaj wniosku, że program „przestał działać”.
Test placebo to drugi sprawdzian: bierzesz tylko dane sprzed programu i udajesz, że program zaczął się wcześniej (tu: w semestrze 3). Prawdziwego efektu tam nie ma, więc oszacowanie powinno być bliskie zera. W przykładzie wyniosło 0.47, SE = 0.97, t(22) = 0.49, p = .630.
Wynik nieistotny w teście trendów to jednak słaby argument. Kahn-Lang i Lang (2020) ostrzegają przed traktowaniem braku istotności różnicy trendów jako dowodu jej braku. Przy trzech semestrach i 24 szkołach test ma małą moc, a przedziały ufności dla współczynników sprzed programu są szerokie (od około −3.6 do 2.1). Lepiej pokazać te przedziały i zapytać, czy różnica trendów tej wielkości podważałaby wniosek. Formalne podejście do tego pytania to test równoważności albo analiza wrażliwości na naruszenia równoległych trendów.
Zagrożenia trafności wniosków z DiD
Campbell (1957) opisał zmienne uboczne, które zagrażają trafności wewnętrznej badań w warunkach naturalnych: historię, dojrzewanie, efekt testowania, zmianę narzędzia, regresję, selekcję i ubytek osób. DiD dobrze radzi sobie ze stałymi różnicami między grupami i z tym, co wspólne dla obu grup. Słabo radzi sobie z tym, co dotyczy tylko jednej z nich. Antonakis i in. (2010) wymieniają DiD wśród metod, które pozwalają testować hipotezy przyczynowe bez randomizacji. W ich przeglądzie artykułów o przywództwie badacze nie uwzględniali jednak od 66% do 90% warunków, od których zależy trafność wniosków przyczynowych.
| Zagrożenie | Jak wygląda w DiD | Co możesz zrobić |
|---|---|---|
| Historia specyficzna dla grupy | W szkołach z programem równocześnie zmieniono dyrekcję albo plan lekcji | Zbierz informacje o innych zmianach; analiza z wyłączeniem takich jednostek |
| Selekcja × dojrzewanie | Szkoły zgłosiły się, bo stres u nich rósł szybciej | Kilka okresów przed programem, model zdarzeń, test placebo |
| Regresja do średniej | Do programu weszły szkoły po wyjątkowo złym semestrze | Sprawdź, czy wybór zależał od ostatniego pomiaru; dłuższa linia bazowa |
| Zmiana składu grup | Po wdrożeniu programu zmienił się profil uczniów w szkołach | Porównaj cechy uczniów przed i po w obu grupach |
| Zmiana narzędzia lub sposobu pomiaru | W szkołach z programem ankietę prowadzą realizatorzy programu | Jednakowa procedura pomiaru we wszystkich szkołach |
| Przenikanie interwencji | Nauczyciele ze szkół porównawczych korzystają z materiałów programu | Wybierz grupę porównawczą oddaloną od szkół z programem |
| Zróżnicowany moment wdrożenia | Szkoły wchodzą do programu w różnych semestrach | Estymatory dla wdrożeń „falami” zamiast prostego TWFE (Roth i in., 2023) |
Do trafności wewnętrznej dochodzi trafność zewnętrzna. DiD szacuje efekt w grupie, która dostała interwencję. Szkoły, które same się zgłosiły, mogą reagować na program inaczej niż szkoły, którym zostałby narzucony. Dlatego pisz o „efekcie programu w szkołach, które go wdrożyły”, a nie o efekcie programu w ogóle. Przed zebraniem danych zapisz w planie analizy, które okresy są „przed” i „po”, jaką grupę porównawczą wybierasz i jakie testy trendów wykonasz. Wybór tych elementów po obejrzeniu wyników bardzo ułatwia znalezienie „efektu”.
Wzór opisu metody i wyników DiD
Opis powinien pozwolić czytelnikowi ocenić założenia, a nie tylko odczytać liczbę. Podaj: jak grupy trafiły do interwencji, okresy przed i po, model, sposób liczenia błędów standardowych, wynik testów trendów i ostrożny wniosek przyczynowy.
Do opisu dołącz rysunek trendów i wykres modelu zdarzeń, najlepiej jako jeden panel. Recenzenci prawie zawsze pytają o te dwa elementy. Jeśli potrzebujesz pomocy w doborze grupy porównawczej, w modelu z klastrami albo w odpowiedzi na uwagi recenzenta, zajrzyj do oferty analiz dla badaczy.
Różnica w różnicach w R: kod i wynik
Trzy przepisy uruchamiasz po kolei w jednej sesji R. Pierwszy generuje dane symulowane i liczy tabelę 2 × 2, drugi i trzeci korzystają z obiektu dane. Liczby w tekście, tabelach i na rysunkach pochodzą z tych obliczeń. Dane pobierzesz jako plik roznica-w-roznicach-dane.csv (3600 wierszy; kolumny: szkola, program, fala, po, stres). Podstawy regresji z interakcją znajdziesz we wpisie regresja wieloraka krok po kroku.
Dane i tabela 2 × 2
R
options(width = 110)

# Dane symulowane: program profilaktyki stresu egzaminacyjnego w liceach.
# 24 szkoły: 12 wdrożyło program od 4. semestru pomiaru (grupa programu), 12 nie (grupa porównawcza).
# W każdej szkole w każdym z 6 semestrów ankietę wypełnia inna próba 25 uczniów (przekroje powtarzane).
# Wynik: skala stresu egzaminacyjnego 10–50 (więcej = silniejszy stres).
# Szkoły same zgłosiły się do programu, bo stres był u nich wyższy (+3 pkt na starcie).
# Wspólny trend: stres rośnie o 0.6 pkt na semestr. Prawdziwy efekt programu: −2.5 pkt.
set.seed(5320)
szkoly <- data.frame(szkola = sprintf("S%02d", 1:24), program = rep(1:0, each = 12),
                     efekt_szkoly = rnorm(24, sd = 2))
siatka <- merge(szkoly, data.frame(fala = 1:6))
siatka$szok <- rnorm(nrow(siatka), sd = 1.5)                   # wspólne wahania szkoły w danym semestrze
dane <- siatka[rep(seq_len(nrow(siatka)), each = 25), ]
dane$po <- as.integer(dane$fala >= 4)                          # okres po wdrożeniu programu
dane$stres <- with(dane, 27 + 3 * program + 0.6 * (fala - 1) + efekt_szkoly + szok - 2.5 * program * po +
                     rnorm(nrow(dane), sd = 7))
dane$stres <- round(pmin(pmax(dane$stres, 10), 50))
dane <- dane[, c("szkola", "program", "fala", "po", "stres")]
rownames(dane) <- NULL
c(uczniowie = nrow(dane), szkoly = length(unique(dane$szkola)))

# 1. Tabela 2 × 2: średnie przed i po w obu grupach
srednie <- with(dane, tapply(stres, list(grupa = ifelse(program == 1, "program", "porownawcza"),
                                         okres = ifelse(po == 1, "po", "przed")), mean))
srednie <- srednie[c("program", "porownawcza"), c("przed", "po")]
round(srednie, 2)

# 2. Trzy proste oszacowania „efektu” – tylko jedno ma sens
zmiana_program     <- srednie["program", "po"] - srednie["program", "przed"]
zmiana_porownawcza <- srednie["porownawcza", "po"] - srednie["porownawcza", "przed"]
round(c(tylko_po_porownanie_grup = srednie["program", "po"] - srednie["porownawcza", "po"],
        przed_po_tylko_program   = zmiana_program,
        zmiana_w_grupie_porown   = zmiana_porownawcza,
        roznica_w_roznicach      = zmiana_program - zmiana_porownawcza), 2)

# 3. Odchylenie standardowe wyniku przed programem (do standaryzacji efektu)
sd_przed <- sd(dane$stres[dane$po == 0])
round(c(SD_przed = sd_przed, d_DiD = (zmiana_program - zmiana_porownawcza) / sd_przed), 2)
Wynik w R
uczniowie    szkoly
     3600        24
             okres
grupa         przed    po
  program     31.16 30.84
  porownawcza 26.35 28.20
tylko_po_porownanie_grup   przed_po_tylko_program   zmiana_w_grupie_porown      roznica_w_roznicach
                    2.64                    -0.32                     1.86                    -2.18
SD_przed    d_DiD
    7.79    -0.28
Regresja z interakcją i błędy standardowe klastrowane
R
# Regresja DiD z interakcją, zwykłe i klastrowane błędy standardowe
# Wymaga obiektu dane z b53-1-dane-2x2.R
suppressPackageStartupMessages({
  library(sandwich)       # vcovCL(): klastrowane błędy standardowe
  library(lmtest)         # coeftest(), coefci()
  library(clubSandwich)   # CR2 z poprawką małej liczby klastrów
})

# Model 1: stres = b0 + b1·program + b2·po + b3·(program × po); b3 = oszacowanie DiD
m1 <- lm(stres ~ program * po, data = dane)
coeftest(m1)                                               # zwykłe SE (błędnie zakładają niezależność uczniów)
coeftest(m1, vcov = vcovCL(m1, cluster = ~ szkola))        # SE klastrowane po szkołach (CR1)
coef_test(m1, vcov = "CR2", cluster = dane$szkola, test = "Satterthwaite")

# Porównanie błędów standardowych i 95% CI dla interakcji program × po
se_zwykle <- sqrt(diag(vcov(m1)))["program:po"]
se_klastr <- sqrt(diag(vcovCL(m1, cluster = ~ szkola)))["program:po"]
round(c(b3 = unname(coef(m1)["program:po"]), SE_zwykle = unname(se_zwykle), SE_klastrowane = unname(se_klastr),
        iloraz = unname(se_klastr / se_zwykle)), 3)
round(coefci(m1, parm = "program:po"), 2)                              # CI zwykłe
round(coefci(m1, parm = "program:po", vcov. = vcovCL(m1, cluster = ~ szkola)), 2)  # CI klastrowane
ci_cr2 <- conf_int(m1, vcov = "CR2", cluster = dane$szkola, coefs = "program:po")
ci_cr2

# Model 2: efekty stałe szkół i semestrów (two-way fixed effects)
m2 <- lm(stres ~ I(program * po) + factor(szkola) + factor(fala), data = dane)
coef_test(m2, vcov = "CR2", cluster = dane$szkola, test = "Satterthwaite", coefs = "I(program * po)")
conf_int(m2, vcov = "CR2", cluster = dane$szkola, coefs = "I(program * po)")
Wynik w R
t test of coefficients:

            Estimate Std. Error  t value  Pr(>|t|)
(Intercept) 26.34556    0.24335 108.2612 < 2.2e-16 ***
program      4.81222    0.34415  13.9829 < 2.2e-16 ***
po           1.85778    0.34415   5.3981 7.169e-08 ***
program:po  -2.17556    0.48670  -4.4700 8.064e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


t test of coefficients:

            Estimate Std. Error t value  Pr(>|t|)
(Intercept) 26.34556    0.75148 35.0584 < 2.2e-16 ***
program      4.81222    0.98389  4.8910 1.047e-06 ***
po           1.85778    0.59463  3.1242  0.001797 **
program:po  -2.17556    0.73854 -2.9457  0.003243 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Alternative hypothesis: two-sided
       Coef. Estimate    SE Null value t-stat d.f. (Satt) p-val (Satt) Sig.
 (Intercept)    26.35 0.768          0  34.30          11      < 0.001  ***
     program     4.81 1.006          0   4.79          22      < 0.001  ***
          po     1.86 0.608          0   3.06          11      0.01091    *
  program:po    -2.18 0.755          0  -2.88          22      0.00865   **
            b3      SE_zwykle SE_klastrowane         iloraz
        -2.176          0.487          0.739          1.517
           2.5 % 97.5 %
program:po -3.13  -1.22
           2.5 % 97.5 %
program:po -3.62  -0.73
      Coef. Estimate    SE d.f. Lower 95% CI Upper 95% CI
 program:po    -2.18 0.755   22        -3.74        -0.61
Alternative hypothesis: two-sided
           Coef. Estimate    SE Null value t-stat d.f. (Satt) p-val (Satt) Sig.
 I(program * po)    -2.18 0.755          0  -2.88          22      0.00865   **
           Coef. Estimate    SE d.f. Lower 95% CI Upper 95% CI
 I(program * po)    -2.18 0.755   22        -3.74        -0.61
Model zdarzeń, test trendów i test placebo
R
# Sprawdzenie trendów przed programem: model zdarzeń (event study) i test placebo
# Wymaga obiektu dane z b53-1-dane-2x2.R oraz pakietu clubSandwich

# Średnie w każdym semestrze i grupie
round(with(dane, tapply(stres, list(fala = fala, program = program), mean)), 2)

# Model zdarzeń: osobny efekt „program × semestr”, semestr 3 (ostatni przed programem) = odniesienie
for (k in c(1, 2, 4, 5, 6)) dane[[paste0("pf", k)]] <- as.integer(dane$program == 1 & dane$fala == k)
m3 <- lm(stres ~ pf1 + pf2 + pf4 + pf5 + pf6 + factor(szkola) + factor(fala), data = dane)
es <- conf_int(m3, vcov = "CR2", cluster = dane$szkola, coefs = c("pf1", "pf2", "pf4", "pf5", "pf6"))
es

# Łączny test: czy przed programem różnice trendów są zerowe? (pf1 = pf2 = 0)
Wald_test(m3, constraints = constrain_zero(c("pf1", "pf2")), vcov = "CR2", cluster = dane$szkola)

# Test placebo: tylko semestry 1–3, „fikcyjny program” od semestru 3
przed <- subset(dane, fala <= 3)
przed$po_placebo <- as.integer(przed$fala == 3)
m4 <- lm(stres ~ I(program * po_placebo) + factor(szkola) + factor(fala), data = przed)
coef_test(m4, vcov = "CR2", cluster = przed$szkola, test = "Satterthwaite", coefs = "I(program * po_placebo)")
Wynik w R
    program
fala     0     1
   1 26.04 30.24
   2 25.83 30.94
   3 27.17 32.30
   4 28.26 29.69
   5 28.13 31.15
   6 28.23 31.68
 Coef. Estimate   SE d.f. Lower 95% CI Upper 95% CI
   pf1  -0.9267 1.27   22        -3.57        1.714
   pf2  -0.0167 1.01   22        -2.10        2.068
   pf4  -3.6967 1.05   22        -5.88       -1.513
   pf5  -2.1000 1.25   22        -4.70        0.499
   pf6  -1.6733 1.13   22        -4.01        0.664
 test Fstat df_num df_denom p_val sig
  HTZ 0.303      2       21 0.742
Alternative hypothesis: two-sided
                   Coef. Estimate    SE Null value t-stat d.f. (Satt) p-val (Satt) Sig.
 I(program * po_placebo)    0.472 0.965          0  0.489          22         0.63
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2 (zapis SVG: svglite). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9-40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- clubSandwich (wersja 0.7.0): Pustejovsky, J. E. (2026). clubSandwich: Cluster-robust (sandwich) variance estimators with small-sample corrections [R package]. https://doi.org/10.32614/CRAN.package.clubSandwich
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizie quasi-eksperymentu
- Porównanie tylko po interwencji. Przy nielosowym przydziale miesza efekt z różnicami, z którymi grupy weszły do badania. W przykładzie dało przeciwny znak.
- Przed–po bez grupy porównawczej. Miesza efekt ze wspólnym trendem, sezonem i regresją do średniej.
- Uznanie nieistotnego testu trendów za dowód równoległości. Pokaż przedziały ufności i oceń, czy różnica w ich granicach podważałaby wniosek.
- Zwykłe błędy standardowe przy interwencji przydzielonej grupom. Klastruj na poziomie, na którym przydzielono interwencję, i pamiętaj, że liczy się liczba klastrów.
- Kontrolowanie zmiennych, na które wpływa program. Taka kontrola może zabrać część efektu, który chcesz oszacować.
- Prosty model TWFE przy wdrożeniu „falami”. Gdy efekt zmienia się w czasie, oszacowanie może być obciążone (Goodman-Bacon, 2021).
- Zbyt mocny język przyczynowy. Pisz, przy jakim założeniu wynik ma interpretację przyczynową, i nie uogólniaj na jednostki, które same nie wybrałyby interwencji. Więcej o tym w haśle korelacja a przyczynowość.
Najczęstsze pytania
Na czym polega metoda różnicy w różnicach?
Liczysz zmianę wyniku od okresu „przed” do „po” w grupie z interwencją i odejmujesz od niej taką samą zmianę w grupie porównawczej. Stałe różnice między grupami i wspólny trend się znoszą, a reszta jest oszacowaniem efektu. W regresji to współczynnik interakcji grupa × okres. Wynik ma interpretację przyczynową tylko przy założeniu równoległych trendów.
Jak sprawdzić założenie równoległych trendów?
Narysuj średnie obu grup w kilku okresach przed interwencją i oszacuj model zdarzeń, w którym współczynniki sprzed interwencji powinny być bliskie zera. Uzupełnij to testem placebo z fikcyjnym początkiem interwencji. Pamiętaj, że nieistotny test nie dowodzi równoległości – pokaż przedziały ufności i uzasadnij założenie merytorycznie (Kahn-Lang i Lang, 2020).
Dlaczego w DiD stosuje się błędy standardowe klastrowane?
Bo interwencję zwykle przydziela się grupom (szkołom, oddziałom, regionom), a wyniki osób z tej samej grupy są skorelowane w czasie. Zwykłe błędy standardowe zawyżają wtedy precyzję i dają za dużo fałszywie istotnych wyników (Bertrand i in., 2004). Klastruj po jednostce przydziału, a przy kilkudziesięciu klastrach użyj poprawki dla małej liczby klastrów, np. CR2.
Jak zinterpretować współczynnik interakcji w regresji DiD?
Współczynnik przy iloczynie grupa × okres „po” to dodatkowa zmiana wyniku w grupie z interwencją ponad zmianę w grupie porównawczej, w jednostkach zmiennej zależnej. Na przykład −2.18 oznacza, że po wdrożeniu programu stres w szkołach z programem był o 2.18 punktu niższy, niż wynikałoby z trendu w szkołach porównawczych.
Ile pomiarów przed interwencją potrzeba w metodzie DiD?
Formalnie wystarczy jeden okres przed i jeden po, ale wtedy nie da się sprawdzić trendów. Planuj co najmniej dwa–trzy okresy przed interwencją, a najlepiej więcej, bo dopiero one pozwalają narysować trendy, oszacować model zdarzeń i wykonać test placebo.
Powiązane hasła
Przeczytaj też
ANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Oceniasz program, którego nie dało się randomizować?
Pomożemy dobrać grupę porównawczą i model, policzymy DiD z błędami klastrowanymi i testami trendów oraz wyjaśnimy, jakie wnioski przyczynowe wolno z niego wyciągnąć.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Antonakis, J., Bendahan, S., Jacquart, P., & Lalive, R. (2010). On making causal claims: A review and recommendations. The Leadership Quarterly, 21(6), 1086–1120. https://doi.org/10.1016/j.leaqua.2010.10.010 ● Otwarty dostęp: pełny tekst
- Bertrand, M., Duflo, E., & Mullainathan, S. (2004). How much should we trust differences-in-differences estimates? The Quarterly Journal of Economics, 119(1), 249–275. https://doi.org/10.1162/003355304772839588 ● Otwarty dostęp: pełny tekst
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Campbell, D. T. (1957). Factors relevant to the validity of experiments in social settings. Psychological Bulletin, 54(4), 297–312. https://doi.org/10.1037/h0040950
- Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. Journal of Econometrics, 225(2), 254–277. https://doi.org/10.1016/j.jeconom.2021.03.014
- Harris, A. D., McGregor, J. C., Perencevich, E. N., Furuno, J. P., Zhu, J., Peterson, D. E., & Finkelstein, J. (2006). The use and interpretation of quasi-experimental studies in medical informatics. Journal of the American Medical Informatics Association, 13(1), 16–23. https://doi.org/10.1197/jamia.m1749 ● Otwarty dostęp
- Imbens, G. W., & Lemieux, T. (2008). Regression discontinuity designs: A guide to practice. Journal of Econometrics, 142(2), 615–635. https://doi.org/10.1016/j.jeconom.2007.05.001
- Kahn-Lang, A., & Lang, K. (2020). The promise and pitfalls of differences-in-differences: Reflections on 16 and Pregnant and other applications. Journal of Business & Economic Statistics, 38(3), 613–620. https://doi.org/10.1080/07350015.2018.1546591 ● Otwarty dostęp: pełny tekst
- Kontopantelis, E., Doran, T., Springate, D. A., Buchan, I., & Reeves, D. (2015). Regression based quasi-experimental approach when randomisation is not an option: Interrupted time series analysis. BMJ, 350, Article h2750. https://doi.org/10.1136/bmj.h2750 ● Otwarty dostęp
- Roth, J., Sant’Anna, P. H. C., Bilinski, A., & Poe, J. (2023). What’s trending in difference-in-differences? A synthesis of the recent econometrics literature. Journal of Econometrics, 235(2), 2218–2244. https://doi.org/10.1016/j.jeconom.2023.03.008 ● Otwarty dostęp: pełny tekst
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Wing, C., Simon, K., & Bello-Gomez, R. A. (2018). Designing difference in difference studies: Best practices for public health policy research. Annual Review of Public Health, 39(1), 453–469. https://doi.org/10.1146/annurev-publhealth-040617-013507 ● Otwarty dostęp
Cytowania BibTeX
@article{antonakis2010making, author={Antonakis, John and Bendahan, Samuel and Jacquart, Philippe and Lalive, Rafael}, title={{On making causal claims: A review and recommendations}}, journal={The Leadership Quarterly}, year={2010}, volume={21}, number={6}, pages={1086--1120}, doi={10.1016/j.leaqua.2010.10.010}}@article{bertrand2004how, author={Bertrand, Marianne and Duflo, Esther and Mullainathan, Sendhil}, title={{How much should we trust differences-in-differences estimates?}}, journal={The Quarterly Journal of Economics}, year={2004}, volume={119}, number={1}, pages={249--275}, doi={10.1162/003355304772839588}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{campbell1957factors, author={Campbell, Donald T.}, title={{Factors relevant to the validity of experiments in social settings}}, journal={Psychological Bulletin}, year={1957}, volume={54}, number={4}, pages={297--312}, doi={10.1037/h0040950}}@article{goodmanbacon2021difference, author={Goodman-Bacon, Andrew}, title={{Difference-in-differences with variation in treatment timing}}, journal={Journal of Econometrics}, year={2021}, volume={225}, number={2}, pages={254--277}, doi={10.1016/j.jeconom.2021.03.014}}@article{harris2006use, author={Harris, Anthony D. and McGregor, Jessina C. and Perencevich, Eli N. and Furuno, Jon P. and Zhu, Jingkun and Peterson, Dan E. and Finkelstein, Joseph}, title={{The use and interpretation of quasi-experimental studies in medical informatics}}, journal={Journal of the American Medical Informatics Association}, year={2006}, volume={13}, number={1}, pages={16--23}, doi={10.1197/jamia.m1749}}@article{imbens2008regression, author={Imbens, Guido W. and Lemieux, Thomas}, title={{Regression discontinuity designs: A guide to practice}}, journal={Journal of Econometrics}, year={2008}, volume={142}, number={2}, pages={615--635}, doi={10.1016/j.jeconom.2007.05.001}}@article{kahnlang2020promise, author={Kahn-Lang, Ariella and Lang, Kevin}, title={{The promise and pitfalls of differences-in-differences: Reflections on 16 and Pregnant and other applications}}, journal={Journal of Business \& Economic Statistics}, year={2020}, volume={38}, number={3}, pages={613--620}, doi={10.1080/07350015.2018.1546591}}@article{kontopantelis2015regression, author={Kontopantelis, E. and Doran, T. and Springate, D. A. and Buchan, I. and Reeves, D.}, title={{Regression based quasi-experimental approach when randomisation is not an option: Interrupted time series analysis}}, journal={BMJ}, year={2015}, volume={350}, eid={h2750}, doi={10.1136/bmj.h2750}}@article{roth2023whats, author={Roth, Jonathan and Sant’Anna, Pedro H. C. and Bilinski, Alyssa and Poe, John}, title={{What’s trending in difference-in-differences? A synthesis of the recent econometrics literature}}, journal={Journal of Econometrics}, year={2023}, volume={235}, number={2}, pages={2218--2244}, doi={10.1016/j.jeconom.2023.03.008}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{wing2018designing, author={Wing, Coady and Simon, Kosali and Bello-Gomez, Ricardo A.}, title={{Designing difference in difference studies: Best practices for public health policy research}}, journal={Annual Review of Public Health}, year={2018}, volume={39}, number={1}, pages={453--469}, doi={10.1146/annurev-publhealth-040617-013507}}