Przykład: sieć pizzerii i czwarty lokal w mieście
Fikcyjna sieć pizzerii ma w mieście A trzy lokale (L1, L2, L3) i w październiku 2025 r. otwiera czwarty – nowy lokal N. Po pół roku zarząd pyta: ile sprzedaży N naprawdę dołożył sieci, a ile zabrał starym lokalom? To pytanie o kanibalizację: klient, który zamawiał w L1, a teraz zamawia w N, nie jest dla sieci nowym klientem.
Potrzebny jest kontrfakt – ile sprzedałyby stare lokale, gdyby N nie powstał. Dostarcza go grupa porównawcza: lokale sieci w miastach B, C i D, gdzie nic nie otwierano. Tak działa różnica w różnicach (DiD). Nowe w tym wpisie są trzy rzeczy: efekt zależny od odległości, efekt zmieniający się w czasie (nowość) i bilans całej sieci.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Sieć zna adres dostawy każdego zamówienia, więc liczymy tygodniowe zamówienia z 72 osiedli: 24 w mieście A (po 8 na lokal) i 48 w miastach B–D. Mamy 78 tygodni: 39 przed otwarciem N (od 6.01.2025) i 39 po nim (od 6.10.2025). Ręcznie ustaliliśmy m.in.: ok. 95 zamówień na osiedle tygodniowo (więcej zimą), stare lokale 1.3, 2.6 i 4.2 km od N, prawdziwą utratę osiedla 30% × exp(−odległość / 1.5 km), w pierwszych tygodniach do 70% większą, oraz średnie zamówienie 64 zł (pełna lista – przy kodzie). Ziarno 653 ustalono raz i nie zmieniano. Dane pobierzesz jako kanibalizacja-pizzerie-osiedla.csv (wiersz = osiedle × tydzień) i kanibalizacja-pizzerie-nowy-lokal.csv.
Rysunek 1: sprzedaż lokali przed i po otwarciu
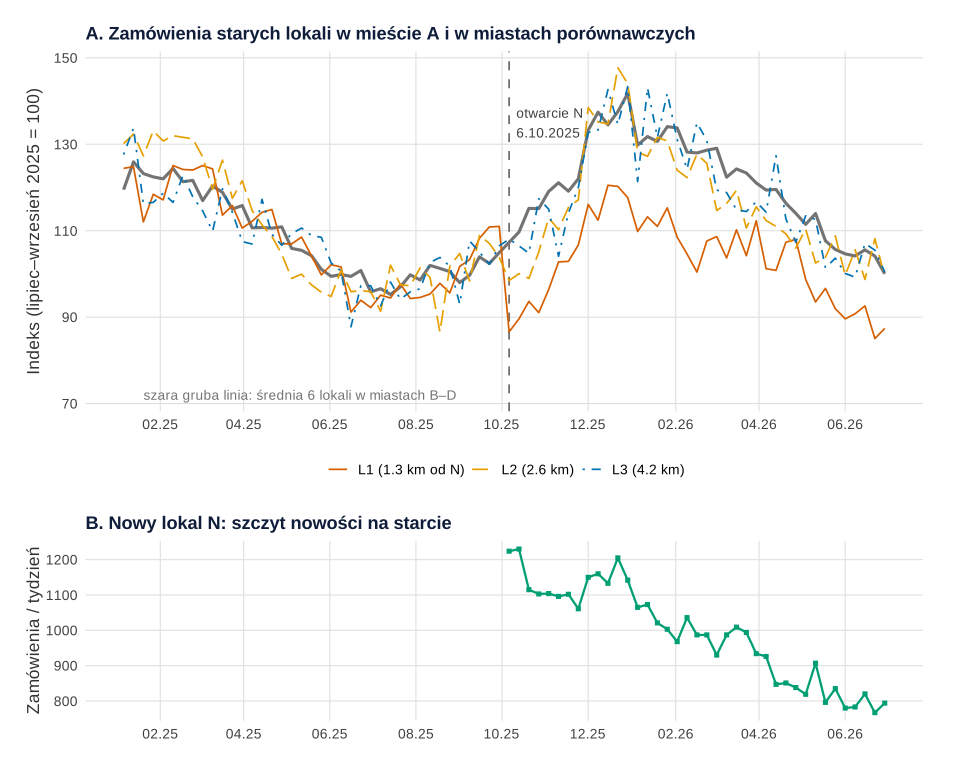
set.seed(653)).Co widać. Do października L1–L3 idą razem z szarą linią miast B–D (lato słabe, zima mocna), a po otwarciu N linia L1 zostaje pod nią. W miastach B–D średnia lokalu wzrosła z 847 do 944 zamówień tygodniowo, a w L1 spadła z 827 do 788. Nowy lokal startuje od 1168 zamówień tygodniowo (pierwsze 4 tygodnie), a w ostatnich 13 tygodniach ma 828.
Jak może zmylić. Naiwne porównanie „13 tygodni przed i 13 po” daje dla L1 wzrost o 4.4% (z 767 do 800 zamówień). To złudzenie: przed otwarciem było lato, a po nim jesień i grudzień – sezonowość. Ten sam błąd grozi analizie przerwanego szeregu czasowego bez modelu sezonu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: różnica w różnicach według odległości
Najprostsze DiD: zmiana lokalu po otwarciu podzielona przez zmianę w miastach B–D. Dla L1: (788 / 827) / (944 / 847) − 1 = −14.5%. Dla L2 wychodzi −5.0%, dla L3 −1.1%. Już widać wzór: im dalej od N, tym mniejsza strata.
Dokładniej zrobimy to na osiedlach. Zamówienia to zliczenia, stąd regresji Poissona z efektami stałymi osiedla i tygodnia (jak w estymatorze efektów stałych):
αi to poziom osiedla, λt – wspólny tydzień (sezon, grudzień, pogoda), a β – efekt otwarcia dla osiedli miasta A w danym pasie odległości. Zmiana w procentach to 100 × (exp(β) − 1). Wersja ciągła zastępuje pasy linią: β0 + β1 × odległość, czyli interakcją z odległością.
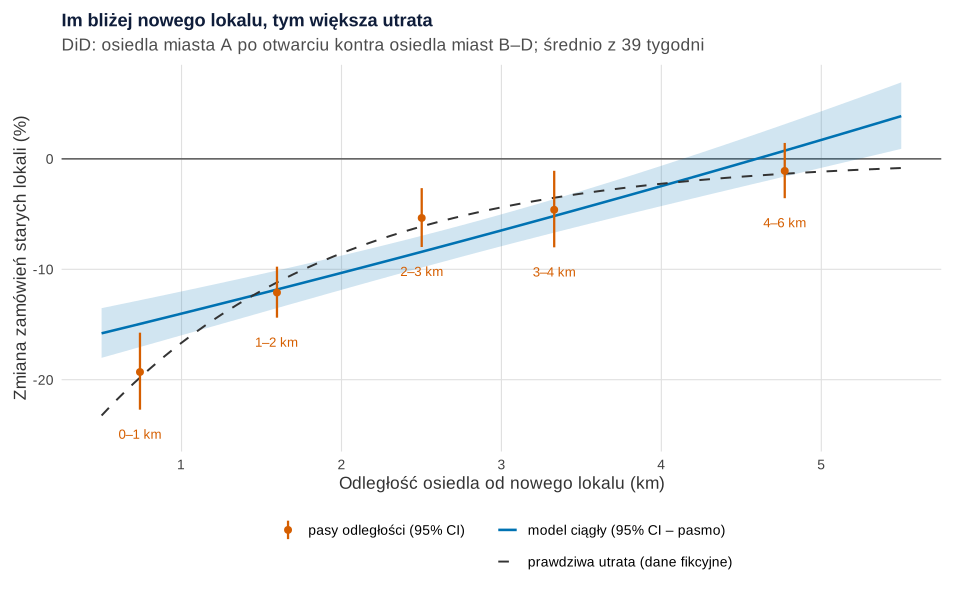
set.seed(653)).Co widać. W pasie 0–1 km (2 osiedla, średnio 0.74 km od N) zamówienia starych lokali spadły o 19.3% (95% CI [−22.7, −15.7]). W pasie 1–2 km o 12.1%, 2–3 km o 5.4%, 3–4 km o 4.6%. W pasie 4–6 km efekt jest bliski zera: −1.1% (95% CI [−3.6, 1.4]). Prosta z modelu ciągłego przecina zero ok. 4.15 km od N.
Jak może zmylić. Prosta jest za sztywna: przy 0.5 km daje −15.8%, a prawdziwa utrata to −23.2%. Strata maleje z odległością po krzywej, więc najpierw pokaż pasy, a dopiero potem model.
Błędy standardowe liczymy metodą Neweya–Westa dla panelu, która uwzględnia zależność kolejnych tygodni w obrębie osiedla. Bertrand i in. (2004) pokazali, że zwykłe błędy w DiD przy autokorelacji dają fałszywe „efekty”. Dlaczego nie typowe błędy odporne na klastrowanie? Bo osiedli leczonych jest mało – wyjaśnia to rysunek 5.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: tydzień po tygodniu – event study
Czy strata jest trwała, czy to chwilowa ciekawość nowego lokalu? Odpowiada badanie zdarzeń (event study): osobny współczynnik DiD dla każdego okresu względem otwarcia. Bierzemy 8 osiedli bliżej niż 2 km od N, a tygodnie łączymy w okresy 4-tygodniowe. Punktem odniesienia są 4 tygodnie tuż przed otwarciem.
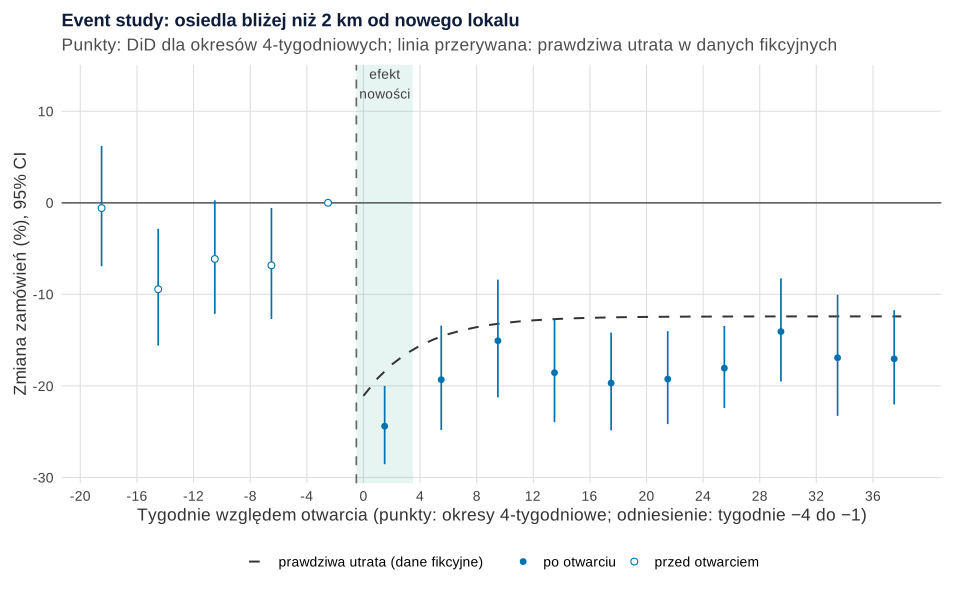
set.seed(653)).Co widać. W pierwszych 4 tygodniach zamówienia spadły o 24.4% (95% CI [−28.5, −20.0]), potem strata zmalała i ustabilizowała się między −14% a −20%. To efekt nowości.
Jak może zmylić. Współczynniki „przed” powinny leżeć wokół zera, a tu średnio wynoszą −5.7%. Test łączny czterech okresów przed otwarciem daje p = .028. A trendy w danych są równoległe – tak je zbudowaliśmy. Winny jest punkt odniesienia: 4 tygodnie z 8 osiedli wypadły przypadkiem wysoko, więc cały wykres zjechał w dół, a punkty „po” leżą średnio 4.9 punktu procentowego poniżej prawdy. Nie traktuj testu trendów przed jak wyroczni. Roth (2022) pokazuje, że testy wstępne mają często małą moc, a uzależnianie od nich analizy zniekształca wnioski. Kahn-Lang i Lang (2020) dodają, że równoległe trendy przed interwencją nie są ani konieczne, ani wystarczające.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ile nowy lokal zabiera, a ile dokłada
Dla każdego osiedla miasta A i tygodnia po otwarciu liczymy utracone zamówienia: obserwowane zamówienia × (exp(−β) − 1), gdzie β to efekt pasa odległości z rysunku 2. Suma tych strat to kanibalizacja. Odejmujemy ją od sprzedaży N i dostajemy przyrost netto sieci:
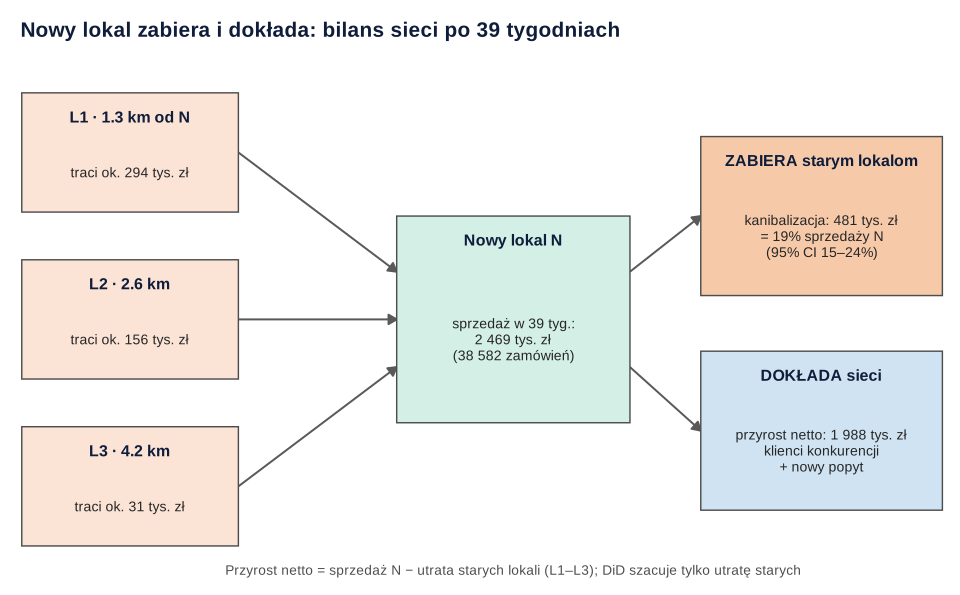
Co widać. N sprzedał w 39 tygodni 38 582 zamówienia, czyli ok. 2 469 tys. zł. Z tego ok. 7 514 zamówień (481 tys. zł) to klienci starych lokali: kanibalizacja wynosi 19.5% sprzedaży N (95% CI [15.3, 23.8]). Przyrost netto sieci to ok. 31 068 zamówień, czyli 1 988 tys. zł. Najwięcej traci L1 (294 tys. zł), potem L2 (156) i L3 (31). Prawdziwa kanibalizacja w danych to 19.6%.
Jak może zmylić. Przyrost netto to nie zysk – nowy lokal ma swoje koszty. Dane sieci nie rozdzielą też klientów zabranych konkurencji od nowego popytu. To zadanie dla modelu wyboru lokalizacji, np. modelu Huffa, który przewiduje kanibalizację przed otwarciem.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: symulacja – kiedy DiD myli
Na danych losowanych wiele razy tym samym generatorem (zob. jak zaplanować badanie symulacyjne) sprawdziliśmy, jak często test trendów przed otwarciem alarmuje fałszywie i co się dzieje, gdy sieć otwiera lokal tam, gdzie rośnie popyt (np. przy nowych blokach). Ustawiliśmy ręcznie, że osiedla blisko N rosną o 0.4% tygodniowo szybciej niż reszta – i przed otwarciem, i po nim.
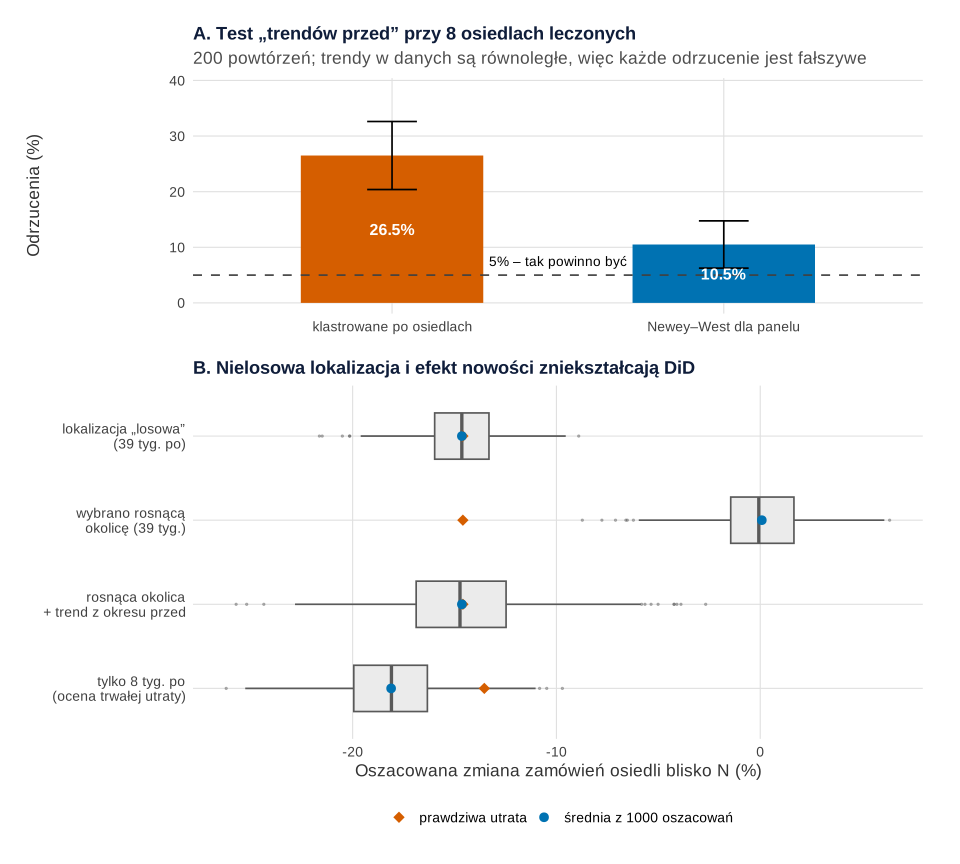
set.seed(653)).Co widać – panel A. Trendy są równoległe, więc test powinien alarmować w 5% powtórzeń. Z błędami klastrowanymi po osiedlach alarmuje w 26.5% (błąd Monte Carlo 3.1 pp), z błędami Neweya–Westa w 10.5% (2.2 pp). Przy 8 osiedlach leczonych żadna metoda nie jest idealna, a wynik p = .028 z rysunku 3 mieści się w tym, co zdarza się przypadkiem.
Co widać – panel B. Przy lokalizacji „losowej” DiD trafia: średnio −14.64% przy prawdzie −14.59%. Gdy sieć wybrała rosnącą okolicę, oszacowanie wynosi średnio 0.08% – kanibalizacja znika, bo wzrost osiedli ją przykrywa. Dodanie trendu miasta A dopasowanego do tygodni przed otwarciem przywraca średnią −14.64%, ale rozrzut rośnie (SD 3.37 zamiast 1.91). Ocena po 8 tygodniach daje −18.11%, a trwała utrata to −13.54%: efekt nowości zawyża stratę o 4.6 pp.
Jak może zmylić. Poprawka trendem działa tu, bo trend jest liniowy i trwa po otwarciu – w prawdziwych danych tego nie wiesz. Freyaldenhoven i in. (2019) opisują, jak czynniki związane jednocześnie z wynikiem i z interwencją wywołują trendy przed nią – to czynnik zakłócający, nie szum.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w firmie
- Licz efekt dla sieci, nie dla lokalu. W przykładzie co piąta złotówka N (19.5%) to pieniądze przesunięte z L1–L3.
- Planuj grupę porównawczą przed otwarciem. Zapisz, które miasta lub osiedla posłużą za kontrolę, i zbieraj ich dane z adresem dostawy. Inne sposoby budowy kontrfaktu, gdy porównawczych miast brak, opisuje wpis o syntetycznej kontroli.
- Nie oceniaj lokalu po pierwszym miesiącu. Szczyt nowości zawyża i sprzedaż N, i stratę starych lokali; decyzje o grafiku L1 podejmuj na danych z co najmniej kwartału.
- Wykorzystaj krzywą odległości przy kolejnych otwarciach. W przykładzie strata znika ok. 4 km od nowego lokalu. Taka krzywa to dane wejściowe do modelu Huffa i do prognozy sprzedaży starych lokali.
- Zapisz, dlaczego wybrano lokalizację. Jeśli powodem był szybki wzrost okolicy, DiD bez trendu przykryje kanibalizację (rysunek 5B).
Jak opisać w pracy
W Metodzie opisz schemat quasi-eksperymentalny: jednostki leczone i porównawcze, okres przed i po, model (Poisson z efektami stałymi), sposób ujęcia odległości, okres odniesienia event study i rodzaj błędów standardowych. W Wynikach – efekty w procentach z 95% CI, test trendów przed interwencją i bilans netto. Zob. też statystyka w pracy z zarządzania i ekonomii i jak napisać pracę z zarządzania i ekonomii.
Wing i in. (2018) zalecają, by w pracy z DiD uzasadnić dobór grupy porównawczej i pokazać analizy wrażliwości. Przegląd nowszych wariantów metody, m.in. przy różnych momentach interwencji, daje Roth i in. (2023). DiD dla programu szkoleniowego: efekt szkolenia pracowników – różnica w różnicach. Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Kod R: dane, DiD według odległości, event study, bilans i symulacja
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane i funkcję strata(), z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 4 (losowanie współczynników do przedziału bilansu) i 5 (symulacja); każdy zaczyna się od własnego set.seed(653). Ziarno 653 ustalono raz i nie zmieniano go. Ręcznie ustalono: 78 tygodni (otwarcie w 40.), 72 osiedla (24 w mieście A, 48 w miastach B–D), średnio 95 zamówień na osiedle (rozrzut SD 0.3 w skali logarytmu), sezon (amplituda 0.14 i +0.10 w grudniu w skali logarytmu), wzrost sieci 0.1% tygodniowo, autokorelację tygodni 0.5 (SD 0.06), położenie lokali (1.3, 2.6, 4.2 km od N), funkcję utraty (30%, skala odległości 1.5 km, nowość +70% wygasająca ze stałą czasu 4 tygodnie), sprzedaż N (820 zamówień, +50% na starcie), paragon 64 zł, a w symulacji – dodatkowy wzrost osiedli blisko N o 0.4% tygodniowo i okno 8 tygodni. Po pierwszym uruchomieniu usunięto z generatora wspólne wahania tygodniowe całego miasta (SD 0.02). Całość liczy się w kilkanaście sekund.
1. Paleta, dane i ich przegląd: Rysunek 1
R
# Rysunek 1. Fikcyjna sieć pizzerii: tygodniowe zamówienia 72 osiedli przed i po otwarciu nowego lokalu w mieście A
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(L1 = "#D55E00", L2 = "#E69F00", L3 = "#0072B2", nowy = "#009E73", fiolet = "#CC79A7",
         kontrola = "grey45", jasny = "grey75")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie. Miasto A: 3 stare lokale (L1, L2, L3) po 8 osiedli dowozu; nowy lokal N
# otwarty w tygodniu 40 (6.10.2025). Grupa porównawcza: miasta B, C, D – po 2 lokale i 16 osiedli, bez otwarcia.
set.seed(653)
tygodnie <- 78; otwarcie <- 40
data_tyg <- as.Date("2025-01-06") + 7 * (0:(tygodnie - 1))          # poniedziałki od 6.01.2025
os <- data.frame(miasto = rep(c("A", "B", "C", "D"), times = c(24, 16, 16, 16)),
                 lokal = c(rep(c("L1", "L2", "L3"), each = 8), rep(paste0(rep(c("B", "C", "D"), each = 2),
                                                                           1:2), each = 8)))
os$osiedle <- sprintf("%s-%02d", os$miasto, ave(seq_len(nrow(os)), os$miasto, FUN = seq_along))
# Odległość osiedla od nowego lokalu (km): stare lokale L1, L2, L3 stoją 1.3, 2.6 i 4.2 km od N,
# ich osiedla – w promieniu ok. 1.2 km od „swojego” lokalu. W miastach B–D odległości nie ma (NA).
kat <- runif(24, 0, 2 * pi); r <- 1.2 * sqrt(runif(24))
srodek <- rep(c(1.3, 2.6, 4.2), each = 8)
os$odl_km <- NA
os$odl_km[1:24] <- round(sqrt((srodek + r * cos(kat))^2 + (r * sin(kat))^2), 2)
os$baza <- exp(rnorm(nrow(os), log(95), 0.3))                       # przeciętne zamówienia na tydzień

# Wspólny rytm roku: więcej zamówień zimą, mniej latem, szczyt w grudniu; lekki wzrost sieci
dzien_roku <- as.numeric(format(data_tyg, "%j"))
sezon <- 0.14 * cos(2 * pi * (dzien_roku - 20) / 365) + 0.10 * (format(data_tyg, "%m") == "12")
trend <- 0.001 * (1:tygodnie)

# Prawdziwa kanibalizacja (znamy ją, bo dane są fikcyjne): utrata = 0.30 · exp(−odl / 1.5) · nowość,
# nowość = 1 + 0.7 · exp(−k / 4) – w pierwszych tygodniach ciekawość nowego lokalu zabiera więcej
strata <- function(odl, k) ifelse(k < 0, 0, 0.30 * exp(-odl / 1.5) * (1 + 0.7 * exp(-k / 4)))
dane <- do.call(rbind, lapply(seq_len(nrow(os)), function(i) {
  szum <- as.numeric(arima.sim(list(ar = 0.5), n = tygodnie, sd = 0.06))   # tygodnie zależne od siebie
  k <- (1:tygodnie) - otwarcie
  s <- if (os$miasto[i] == "A") strata(os$odl_km[i], k) else 0
  mu <- os$baza[i] * exp(sezon + trend + szum) * (1 - s)
  data.frame(os[i, c("miasto", "lokal", "osiedle", "odl_km")], tydzien = 1:tygodnie, data = data_tyg,
             k = k, zamowienia = rpois(tygodnie, mu), strata_prawdziwa = round(s, 4), row.names = NULL)
}))
dane$po <- as.integer(dane$k >= 0)
dane$miasto_A <- as.integer(dane$miasto == "A")
# Nowy lokal N: ok. 820 zamówień tygodniowo w sezonie przeciętnym, na starcie o połowę więcej (efekt nowości)
k_n <- (otwarcie:tygodnie) - otwarcie
nowy <- data.frame(tydzien = otwarcie:tygodnie, data = data_tyg[otwarcie:tygodnie], k = k_n,
                   zamowienia = rpois(length(k_n), 820 * (1 + 0.5 * exp(-k_n / 6)) *
                                        exp(sezon[otwarcie:tygodnie] + trend[otwarcie:tygodnie])))
paragon <- 64                                                       # średnia wartość zamówienia (zł)
write.csv(dane[, c("miasto", "lokal", "osiedle", "odl_km", "tydzien", "data", "k", "po", "zamowienia")],
          "kanibalizacja-pizzerie-osiedla.csv", row.names = FALSE)
write.csv(nowy, "kanibalizacja-pizzerie-nowy-lokal.csv", row.names = FALSE)

# Przegląd: osiedla, odległości i średnie zamówienia lokalu na tydzień przed otwarciem i po nim
c(osiedla = nrow(os), osiedla_miasto_A = sum(os$miasto == "A"), tygodnie_przed = otwarcie - 1,
  tygodnie_po = tygodnie - otwarcie + 1)
aggregate(odl_km ~ lokal, data = os[1:24, ], FUN = function(x) round(range(x), 2))
lok <- aggregate(zamowienia ~ lokal + tydzien + po + miasto, data = dane, FUN = sum)
lok$grupa <- ifelse(lok$miasto == "A", lok$lokal, "B–D (średnia lokalu)")
sr <- aggregate(zamowienia ~ grupa + po, data = lok, FUN = mean)
sr$zamowienia <- round(sr$zamowienia); sr
c(nowy_lokal_tydz_1_4 = round(mean(nowy$zamowienia[1:4])), nowy_lokal_tydz_27_39 = round(mean(nowy$zamowienia[27:39])))

# Naiwne „przed i po” dla L1: 13 tygodni przed otwarciem vs 13 tygodni po
l1 <- lok[lok$lokal == "L1", ]
przed <- mean(l1$zamowienia[l1$tydzien %in% (otwarcie - 13):(otwarcie - 1)])
po13 <- mean(l1$zamowienia[l1$tydzien %in% otwarcie:(otwarcie + 12)])
c(L1_przed = round(przed), L1_po = round(po13), zmiana_proc = round(100 * (po13 / przed - 1), 1))

# Rysunek 1: zamówienia lokali jako indeks (średnia 13 tygodni przed otwarciem = 100)
lok$indeks <- 100 * lok$zamowienia / ave(ifelse(lok$tydzien %in% 27:39, lok$zamowienia, NA), lok$lokal,
                                          FUN = function(x) mean(x, na.rm = TRUE))
lok$data <- data_tyg[lok$tydzien]
kontr <- aggregate(indeks ~ data, data = lok[lok$miasto != "A", ], FUN = mean)
pA <- ggplot(lok[lok$miasto == "A", ], aes(data, indeks, colour = lokal, linetype = lokal)) +
  geom_vline(xintercept = data_tyg[otwarcie], colour = "grey40", linetype = "dashed") +
  geom_line(data = kontr, aes(data, indeks), inherit.aes = FALSE, colour = kol[["kontrola"]], linewidth = 1.1) +
  geom_line(linewidth = 0.6) +
  annotate("text", x = data_tyg[otwarcie] + 5, y = 135, label = "otwarcie N\n6.10.2025", hjust = 0, size = 3.6,
           colour = "grey25") +
  annotate("text", x = data_tyg[3], y = 72, label = "szara gruba linia: średnia 6 lokali w miastach B–D",
           hjust = 0, size = 3.6, colour = kol[["kontrola"]]) +
  scale_colour_manual(values = kol[c("L1", "L2", "L3")], name = NULL,
                      labels = c("L1 (1.3 km od N)", "L2 (2.6 km)", "L3 (4.2 km)")) +
  scale_linetype_manual(values = c(L1 = "solid", L2 = "longdash", L3 = "dotdash"), name = NULL,
                        labels = c("L1 (1.3 km od N)", "L2 (2.6 km)", "L3 (4.2 km)")) +
  scale_x_date(date_labels = "%m.%y", date_breaks = "2 months") +
  labs(x = NULL, y = "Indeks (lipiec–wrzesień 2025 = 100)",
       title = "A. Zamówienia starych lokali w mieście A i w miastach porównawczych") + motyw
pB <- ggplot(nowy, aes(data, zamowienia)) +
  geom_line(colour = kol[["nowy"]], linewidth = 0.8) + geom_point(colour = kol[["nowy"]], shape = 15, size = 1.4) +
  scale_x_date(limits = range(data_tyg), date_labels = "%m.%y", date_breaks = "2 months") +
  labs(x = NULL, y = "Zamówienia / tydzień", title = "B. Nowy lokal N: szczyt nowości na starcie") + motyw
p1 <- pA / pB + plot_layout(heights = c(2, 1))
p1   # zapis: ggsave("kanibalizacja-dane-lokali.svg", p1, width = 10, height = 8)
Wynik w R
         osiedla osiedla_miasto_A   tygodnie_przed      tygodnie_po
              72               24               39               39
  lokal odl_km.1 odl_km.2
1    L1     0.64     2.16
2    L2     1.80     3.37
3    L3     3.55     5.26
                 grupa po zamowienia
1 B–D (średnia lokalu)  0        847
2                   L1  0        827
3                   L2  0        893
4                   L3  0        759
5 B–D (średnia lokalu)  1        944
6                   L1  1        788
7                   L2  1        946
8                   L3  1        836
  nowy_lokal_tydz_1_4 nowy_lokal_tydz_27_39
                 1168                   828
   L1_przed       L1_po zmiana_proc
      767.0       800.0         4.4
2. Różnica w różnicach według lokalu i odległości: Rysunek 2
R
# Rysunek 2. Różnica w różnicach: utrata zamówień starych lokali w zależności od odległości od nowego lokalu
library(fixest)
library(ggplot2)

# (a) Klasyczne 2 × 2 na poziomie lokalu: L1, L2, L3 kontra 6 lokali z miast B–D, przed i po otwarciu
lok <- aggregate(zamowienia ~ lokal + miasto + tydzien + po, data = dane, FUN = sum)
tab <- with(lok, tapply(zamowienia, list(ifelse(miasto == "A", lokal, "B–D"), ifelse(po == 1, "po", "przed")), mean))
round(tab[, c("przed", "po")])
did_proc <- 100 * ((tab[c("L1", "L2", "L3"), "po"] / tab[c("L1", "L2", "L3"), "przed"]) /
                     (tab["B–D", "po"] / tab["B–D", "przed"]) - 1)
round(did_proc, 1)                       # DiD w procentach: zmiana lokalu „ponad” zmianę w miastach B–D

# (b) Model Poissona z efektami stałymi osiedla i tygodnia (DiD dla zliczeń; efekt = exp(b) − 1);
#     efekt osobno dla pasów odległości od N. Błędy standardowe: Newey–West dla panelu (zależność kolejnych
#     tygodni w obrębie osiedla) – przy kilku osiedlach leczonych błędy klastrowane są zbyt wąskie (przepis 5)
dane$pas <- cut(dane$odl_km, c(0, 1, 2, 3, 4, 6), labels = c("0–1 km", "1–2 km", "2–3 km", "3–4 km", "4–6 km"))
dane$pas <- factor(ifelse(dane$miasto_A == 1, as.character(dane$pas), "kontrola"),
                   levels = c("kontrola", levels(dane$pas)))
table(dane$pas[dane$tydzien == 1])
m_pas <- fepois(zamowienia ~ i(pas, po, ref = "kontrola") | osiedle + tydzien, data = dane, panel.id = ~osiedle + tydzien, vcov = "NW")
wsp <- data.frame(pas = levels(dane$pas)[-1], b = coef(m_pas), se = se(m_pas))
wsp$efekt <- 100 * (exp(wsp$b) - 1)
wsp$ci_d <- 100 * (exp(wsp$b - 1.96 * wsp$se) - 1); wsp$ci_g <- 100 * (exp(wsp$b + 1.96 * wsp$se) - 1)
wsp$odl_sr <- tapply(dane$odl_km[dane$tydzien == 1], dane$pas[dane$tydzien == 1], mean)[wsp$pas]
print(data.frame(wsp[, "pas", drop = FALSE], round(wsp[, c("odl_sr", "efekt", "ci_d", "ci_g")], 2)), row.names = FALSE)

# (c) Ciągła wersja: log-efekt zmienia się liniowo z odległością (b0 + b1 · odl)
dane$po_A <- dane$po * dane$miasto_A
dane$po_A_odl <- dane$po_A * ifelse(is.na(dane$odl_km), 0, dane$odl_km)
m_odl <- fepois(zamowienia ~ po_A + po_A_odl | osiedle + tydzien, data = dane, panel.id = ~osiedle + tydzien, vcov = "NW")
round(coeftable(m_odl), 4)
siatka <- data.frame(odl = seq(0.5, 5.5, by = 0.05))
X <- cbind(1, siatka$odl); V <- vcov(m_odl)
siatka$b <- as.numeric(X %*% coef(m_odl)); siatka$se <- sqrt(rowSums((X %*% V) * X))
siatka$efekt <- 100 * (exp(siatka$b) - 1)
siatka$ci_d <- 100 * (exp(siatka$b - 1.96 * siatka$se) - 1); siatka$ci_g <- 100 * (exp(siatka$b + 1.96 * siatka$se) - 1)
# Prawdziwa średnia utrata w 39 tygodniach po otwarciu (znana z danych fikcyjnych) dla porównania
siatka$prawda <- -100 * sapply(siatka$odl, function(d) mean(strata(d, 0:38)))
zasieg <- min(siatka$odl[siatka$ci_g > 0])         # od tej odległości 95% CI obejmuje zero
round(siatka[siatka$odl %in% c(0.5, 1, 2, 3, 4, 5), c("odl", "efekt", "ci_d", "ci_g", "prawda")], 1)
c(zasieg_km = zasieg)

p2 <- ggplot(siatka, aes(odl)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_ribbon(aes(ymin = ci_d, ymax = ci_g), fill = kol[["L3"]], alpha = 0.18) +
  geom_line(aes(y = efekt, linetype = "model ciągły (95% CI – pasmo)"), colour = kol[["L3"]], linewidth = 0.9) +
  geom_line(aes(y = prawda, linetype = "prawdziwa utrata (dane fikcyjne)"), colour = "grey20", linewidth = 0.7) +
  geom_pointrange(data = wsp, aes(x = odl_sr, y = efekt, ymin = ci_d, ymax = ci_g, shape = "pasy odległości (95% CI)"),
                  colour = kol[["L1"]], size = 0.5, linewidth = 0.8) +
  geom_text(data = wsp, aes(x = odl_sr, y = ci_d - 2.2, label = pas), size = 3.5, colour = kol[["L1"]]) +
  scale_linetype_manual(values = c("model ciągły (95% CI – pasmo)" = "solid", "prawdziwa utrata (dane fikcyjne)" = "dashed"),
                        name = NULL) +
  scale_shape_manual(values = c("pasy odległości (95% CI)" = 16), name = NULL) +
  scale_x_continuous(breaks = 0:6) +
  labs(x = "Odległość osiedla od nowego lokalu (km)", y = "Zmiana zamówień starych lokali (%)",
       title = "Im bliżej nowego lokalu, tym większa utrata",
       subtitle = "DiD: osiedla miasta A po otwarciu kontra osiedla miast B–D; średnio z 39 tygodni") +
  motyw + guides(linetype = guide_legend(nrow = 2), shape = guide_legend(order = 1))
p2   # zapis: ggsave("kanibalizacja-did-odleglosc.svg", p2, width = 10, height = 6.2)
Wynik w R
    przed  po
B–D   847 944
L1    827 788
L2    893 946
L3    759 836
   L1    L2    L3
-14.5  -5.0  -1.1

kontrola   0–1 km   1–2 km   2–3 km   3–4 km   4–6 km
      48        2        6        6        3        7
    pas odl_sr  efekt   ci_d   ci_g
 0–1 km   0.74 -19.30 -22.71 -15.74
 1–2 km   1.60 -12.10 -14.38  -9.76
 2–3 km   2.50  -5.35  -7.98  -2.65
 3–4 km   3.33  -4.61  -8.01  -1.08
 4–6 km   4.77  -1.09  -3.56   1.44
         Estimate Std. Error  z value Pr(>|z|)
po_A      -0.1929     0.0156 -12.3499        0
po_A_odl   0.0420     0.0047   8.8675        0
attr(,"vcov_type")
[1] "Newey-West (L=2)"
   odl efekt  ci_d  ci_g prawda
1  0.5 -15.8 -18.0 -13.5  -23.2
11 1.0 -14.0 -16.0 -12.0  -16.7
31 2.0 -10.3 -11.9  -8.8   -8.5
51 3.0  -6.5  -7.9  -5.0   -4.4
71 4.0  -2.5  -4.3  -0.6   -2.3
91 5.0   1.7  -0.8   4.3   -1.2
zasieg_km
     4.15
3. Event study: Rysunek 3
R
# Rysunek 3. Event study: efekt tydzień po tygodniu względem otwarcia dla osiedli bliżej niż 2 km od N
library(fixest)
library(ggplot2)

# Osiedla miasta A bliżej niż 2 km od N (leczone) i wszystkie osiedla miast B–D (porównawcze).
# Tygodnie względem otwarcia k łączymy w okresy 4-tygodniowe (mniej szumu, mniej współczynników):
# okres −4 = tygodnie od −4 do −1 (punkt odniesienia), okres 0 = tygodnie 0–3 itd.; k ≤ −21 to jeden koszyk (−24).
es <- dane[dane$miasto != "A" | dane$odl_km < 2, ]
es$blisko <- as.integer(es$miasto == "A")
es$k_kosz <- pmax(floor(es$k / 4) * 4, -24)
c(osiedla_blisko = length(unique(es$osiedle[es$blisko == 1])), osiedla_kontrola = length(unique(es$osiedle[es$blisko == 0])))
m_es <- fepois(zamowienia ~ i(k_kosz, blisko, ref = -4) | osiedle + tydzien, data = es, panel.id = ~osiedle + tydzien, vcov = "NW")
ct <- as.data.frame(coeftable(m_es))
ct$k <- as.numeric(sub(".*::(-?[0-9]+):blisko", "\\1", rownames(ct)))
ct$efekt <- 100 * (exp(ct$Estimate) - 1)
ct$ci_d <- 100 * (exp(ct$Estimate - 1.96 * ct$`Std. Error`) - 1)
ct$ci_g <- 100 * (exp(ct$Estimate + 1.96 * ct$`Std. Error`) - 1)
ct <- rbind(ct[, c("k", "efekt", "ci_d", "ci_g")], data.frame(k = -4, efekt = 0, ci_d = 0, ci_g = 0))
ct <- ct[order(ct$k), ]
print(round(ct, 1), row.names = FALSE)
# Test łączny: czy 4 okresy „przed” (od −20 do −5 tygodnia) są razem równe zero? (sprawdzian trendów przed otwarciem)
round(unlist(wald(m_es, keep = "k_kosz::-(8|12|16|20):", print = FALSE)[c("stat", "p", "df1")]), 3)
# Dla porównania ten sam test z błędami klastrowanymi po osiedlach (tylko 8 klastrów leczonych)
round(unlist(wald(m_es, keep = "k_kosz::-(8|12|16|20):", print = FALSE, vcov = ~osiedle)[c("stat", "p")]), 4)
# Prawdziwa średnia utrata w tych osiedlach w tych samych okresach (dane fikcyjne)
prawda <- aggregate(strata_prawdziwa ~ k, data = es[es$blisko == 1 & es$k >= 0, ], FUN = mean)
prawda_okres <- -100 * tapply(prawda$strata_prawdziwa, floor(prawda$k / 4) * 4, mean)
round(prawda_okres, 1)
# Ile przesunięty jest cały wykres? Średnia współczynników „przed” i średnia różnica „po” względem prawdy
c(srednia_przed = round(mean(ct$efekt[ct$k < -4]), 1),
  srednia_po_minus_prawda = round(mean(ct$efekt[ct$k >= 0] - prawda_okres), 1))

p3 <- ggplot(ct[ct$k > -24, ], aes(k + 1.5, efekt)) +
  annotate("rect", xmin = -0.5, xmax = 3.5, ymin = -Inf, ymax = Inf, fill = kol[["nowy"]], alpha = 0.10) +
  annotate("text", x = 1.5, y = 13, label = "efekt\nnowości", size = 3.6, colour = "grey25") +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_vline(xintercept = -0.5, colour = "grey40", linetype = "dashed") +
  geom_line(data = transform(prawda, efekt = -100 * strata_prawdziwa), aes(x = k, linetype = "prawdziwa utrata (dane fikcyjne)"),
            colour = "grey20", linewidth = 0.7) +
  geom_errorbar(aes(ymin = ci_d, ymax = ci_g), colour = kol[["L3"]], width = 0, linewidth = 0.6) +
  geom_point(aes(shape = ifelse(k < 0, "przed otwarciem", "po otwarciu")), colour = kol[["L3"]], size = 2, fill = "white") +
  scale_shape_manual(values = c("przed otwarciem" = 21, "po otwarciu" = 16), name = NULL) +
  scale_linetype_manual(values = c("prawdziwa utrata (dane fikcyjne)" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = seq(-20, 36, by = 4)) +
  labs(x = "Tygodnie względem otwarcia (punkty: okresy 4-tygodniowe; odniesienie: tygodnie −4 do −1)",
       y = "Zmiana zamówień (%), 95% CI",
       title = "Event study: osiedla bliżej niż 2 km od nowego lokalu",
       subtitle = "Punkty: DiD dla okresów 4-tygodniowych; linia przerywana: prawdziwa utrata w danych fikcyjnych") +
  motyw
p3   # zapis: ggsave("kanibalizacja-event-study.svg", p3, width = 10, height = 6.2)
Wynik w R
  osiedla_blisko osiedla_kontrola
               8               48
   k efekt  ci_d  ci_g
 -24  -5.3 -10.0  -0.5
 -20  -0.6  -6.9   6.2
 -16  -9.4 -15.6  -2.8
 -12  -6.1 -12.1   0.3
  -8  -6.8 -12.7  -0.6
  -4   0.0   0.0   0.0
   0 -24.4 -28.5 -20.0
   4 -19.3 -24.8 -13.4
   8 -15.1 -21.3  -8.4
  12 -18.6 -24.0 -12.8
  16 -19.7 -24.8 -14.2
  20 -19.3 -24.2 -14.0
  24 -18.1 -22.4 -13.5
  28 -14.1 -19.5  -8.3
  32 -16.9 -23.3 -10.0
  36 -17.0 -22.0 -11.7
 stat     p   df1
2.888 0.028 4.000
  stat      p
4.3080 0.0042
    0     4     8    12    16    20    24    28    32    36
-18.6 -14.7 -13.2 -12.7 -12.5 -12.4 -12.4 -12.4 -12.4 -12.4
          srednia_przed srednia_po_minus_prawda
                   -5.7                    -4.9
4. Bilans sieci i grafika „zabiera / dokłada”: Rysunek 4
R
# Rysunek 4. Grafika z bilansem: ile sprzedaży nowy lokal zabrał starym, a ile dołożył sieci (39 tygodni)
library(ggplot2)

# Utracone zamówienie starego lokalu w tygodniu po otwarciu: y · (exp(−b) − 1), gdzie b – efekt DiD pasa
# odległości z przepisu 2 (y – zamówienia obserwowane, y · exp(−b) – zamówienia bez nowego lokalu).
po_A <- dane[dane$miasto_A == 1 & dane$po == 1, ]
b_pas <- setNames(coef(m_pas), levels(dane$pas)[-1])
utrata <- function(b) sum(po_A$zamowienia * (exp(-b[as.character(po_A$pas)]) - 1))
# Niepewność: 5000 losowań współczynników z ich rozkładu (średnie i macierz kowariancji Neweya–Westa)
set.seed(653)
losy <- MASS::mvrnorm(5000, coef(m_pas), vcov(m_pas)); colnames(losy) <- names(b_pas)
utr_los <- apply(losy, 1, utrata)
nowy_zam <- sum(nowy$zamowienia)
bilans <- data.frame(
  wielkosc = c("sprzedaż N", "zabrane starym (kanibalizacja)", "przyrost netto sieci", "odsetek kanibalizacji (%)"),
  zamowienia = c(nowy_zam, utrata(b_pas), nowy_zam - utrata(b_pas), 100 * utrata(b_pas) / nowy_zam),
  ci_d = c(NA, quantile(utr_los, .025), nowy_zam - quantile(utr_los, .975), 100 * quantile(utr_los, .025) / nowy_zam),
  ci_g = c(NA, quantile(utr_los, .975), nowy_zam - quantile(utr_los, .025), 100 * quantile(utr_los, .975) / nowy_zam))
bilans$tys_zl <- ifelse(grepl("%", bilans$wielkosc), NA, round(bilans$zamowienia * paragon / 1000))
print(transform(bilans, zamowienia = round(zamowienia, 1), ci_d = round(ci_d, 1), ci_g = round(ci_g, 1)), row.names = FALSE)
# Utrata według starych lokali (tys. zł) i prawdziwa utrata z danych fikcyjnych dla porównania
po_A$utr <- po_A$zamowienia * (exp(-b_pas[as.character(po_A$pas)]) - 1)
po_A$utr_prawda <- po_A$zamowienia * po_A$strata_prawdziwa / (1 - po_A$strata_prawdziwa)
round(rbind(model = tapply(po_A$utr, po_A$lokal, sum), prawda = tapply(po_A$utr_prawda, po_A$lokal, sum)) * paragon / 1000)
c(prawdziwy_odsetek_kanibalizacji = round(100 * sum(po_A$utr_prawda) / nowy_zam, 1))

# Grafika: nowy lokal „zabiera” starym (L1–L3) i „dokłada” sieci – liczby z bilansu powyżej
tz <- function(x) format(round(x * paragon / 1000), big.mark = " ")
u_lok <- tapply(po_A$utr, po_A$lokal, sum)
pola <- data.frame(
  x = c(1.6, 1.6, 1.6, 6.2, 9.9, 9.9),
  y = c(5.4, 3.3, 1.2, 3.3, 4.6, 1.9),
  w = c(2.6, 2.6, 2.6, 2.8, 2.9, 2.9), h = c(1.5, 1.5, 1.5, 2.6, 2.0, 2.0),
  typ = c("stary", "stary", "stary", "nowy", "zabiera", "dokłada"),
  tytul = c("L1 · 1.3 km od N", "L2 · 2.6 km", "L3 · 4.2 km", "Nowy lokal N",
            "ZABIERA starym lokalom", "DOKŁADA sieci"),
  opis = c(paste0("traci ok. ", tz(u_lok["L1"]), " tys. zł"), paste0("traci ok. ", tz(u_lok["L2"]), " tys. zł"),
           paste0("traci ok. ", tz(u_lok["L3"]), " tys. zł"),
           paste0("sprzedaż w 39 tyg.:\n", tz(nowy_zam), " tys. zł\n(", format(nowy_zam, big.mark = " "), " zamówień)"),
           paste0("kanibalizacja: ", tz(bilans$zamowienia[2]), " tys. zł\n= ", round(bilans$zamowienia[4]),
                  "% sprzedaży N\n(95% CI ", round(bilans$ci_d[4]), "–", round(bilans$ci_g[4]), "%)"),
           paste0("przyrost netto: ", tz(bilans$zamowienia[3]), " tys. zł\nklienci konkurencji\n+ nowy popyt")))
kolor_pola <- c(stary = "#FBE3D6", nowy = "#D3EFE6", zabiera = "#F6C9A9", dokłada = "#CFE3F2")
strz <- data.frame(x = c(2.9, 2.9, 2.9, 7.6, 7.6), y = c(5.4, 3.3, 1.2, 3.9, 2.7),
                   xend = c(4.8, 4.8, 4.8, 8.45, 8.45), yend = c(3.9, 3.3, 2.7, 4.6, 1.9))
p4 <- ggplot() +
  geom_segment(data = strz, aes(x, y, xend = xend, yend = yend), colour = "grey35", linewidth = 0.7,
               arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  geom_tile(data = pola, aes(x, y, width = w, height = h, fill = typ), colour = "grey30", linewidth = 0.5) +
  geom_text(data = pola, aes(x, y + h / 2 - 0.3, label = tytul), fontface = "bold", size = 4.2, colour = "#0f1d3a") +
  geom_text(data = pola, aes(x, y - 0.25, label = opis), size = 3.7, lineheight = 0.95, colour = "grey15") +
  annotate("text", x = 6.2, y = 0.15, size = 3.6, colour = "grey30",
           label = "Przyrost netto = sprzedaż N − utrata starych lokali (L1–L3); DiD szacuje tylko utratę starych") +
  scale_fill_manual(values = kolor_pola, guide = "none") +
  coord_cartesian(xlim = c(0.2, 11.4), ylim = c(0, 6.8), expand = FALSE) +
  labs(title = "Nowy lokal zabiera i dokłada: bilans sieci po 39 tygodniach") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", hjust = 0.02),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 10, 10, 10))
p4   # zapis: ggsave("kanibalizacja-schemat-bilans.svg", p4, width = 10, height = 6.2)
Wynik w R
                       wielkosc zamowienia    ci_d    ci_g tys_zl
                     sprzedaż N    38582.0      NA      NA   2469
 zabrane starym (kanibalizacja)     7514.2  5903.9  9199.3    481
           przyrost netto sieci    31067.8 29382.7 32678.1   1988
      odsetek kanibalizacji (%)       19.5    15.3    23.8     NA
        L1  L2 L3
model  294 156 31
prawda 301 149 34
prawdziwy_odsetek_kanibalizacji
                           19.6
5. Symulacja: Rysunek 5
R
# Rysunek 5. Symulacja: (A) fałszywe „trendy przed” przy 8 osiedlach leczonych, (B) lokalizacja wybrana nielosowo i efekt nowości
library(fixest)
library(ggplot2)
library(patchwork)

# Generator jak w przepisie 1 (korzysta z obiektów sezon, trend i strata): 8 osiedli miasta A bliżej niż 2 km od N
# i 48 osiedli miast B–D, 78 tygodni, otwarcie w tygodniu 40. wzrost = dodatkowy wzrost popytu w 8 osiedlach
# (log na tydzień) – np. nowe bloki, z powodu których sieć wybrała tę lokalizację.
gen_mu <- function() {
  odl <- c(runif(8, 0.5, 2), rep(NA, 48)); baza <- exp(rnorm(56, log(95), 0.3))
  szum <- apply(matrix(rnorm(56 * 78, 0, 0.06), 78), 2, function(e) as.numeric(stats::filter(e, 0.5, "recursive")))
  k <- (1:78) - 40
  s <- sapply(1:56, function(i) if (i <= 8) strata(odl[i], k) else rep(0, 78))      # macierz 78 × 56
  mu0 <- sweep(exp(sezon + trend + szum), 2, baza, "*")                                # bez nowego lokalu
  list(mu0 = mu0, s = s, k = k)
}
wzrost_tyg <- function(wzrost) outer((1:78) - 40, c(rep(wzrost, 8), rep(0, 48)))       # log-wzrost osiedli blisko N

# (A) 200 powtórzeń: test łączny 4 okresów „przed” w event study z przepisu 3, gdy trendy SĄ równoległe
set.seed(653)
pA_wyn <- t(replicate(200, {
  g <- gen_mu(); y <- matrix(rpois(78 * 56, g$mu0 * (1 - g$s)), 78)
  d <- data.frame(osiedle = rep(1:56, each = 78), tydzien = rep(1:78, 56), k = rep(g$k, 56),
                  blisko = rep(c(rep(1, 8), rep(0, 48)), each = 78), zamowienia = as.vector(y))
  d$k_kosz <- pmax(floor(d$k / 4) * 4, -24)
  m <- fepois(zamowienia ~ i(k_kosz, blisko, ref = -4) | osiedle + tydzien, data = d, panel.id = ~osiedle + tydzien)
  sapply(list(klastry = ~osiedle, NW = "NW"), function(v)
    wald(m, keep = "k_kosz::-(8|12|16|20):", print = FALSE, vcov = v)$p < .05)
}))
odrz <- data.frame(bledy = c("klastrowane po osiedlach", "Newey–West dla panelu"), odsetek = 100 * colMeans(pA_wyn))
odrz$blad_MC <- sqrt(odrz$odsetek * (100 - odrz$odsetek) / 200)
print(transform(odrz, odsetek = round(odsetek, 1), blad_MC = round(blad_MC, 1)), row.names = FALSE)

# (B) 1000 powtórzeń × 4 scenariusze; estymator: DiD 2 × 2 na sumach zamówień (8 osiedli blisko vs 48 kontrolnych)
did_22 <- function(y, okno) {
  T_ <- rowSums(y[, 1:8]); C_ <- rowSums(y[, 9:56]); przed <- 1:39; po <- 39 + okno
  100 * ((sum(T_[po]) / sum(T_[przed])) / (sum(C_[po]) / sum(C_[przed])) - 1)
}
did_trend <- function(y) {                       # DiD z trendem miasta A dopasowanym tylko do tygodni przed otwarciem
  r <- log(rowSums(y[, 1:8]) / rowSums(y[, 9:56])); t <- 1:78
  f <- lm(r ~ t, subset = t <= 39)
  100 * (exp(mean(r[40:78] - predict(f, data.frame(t = 40:78)))) - 1)
}
prawda <- function(g, okno) 100 * (sum(g$mu0[39 + okno, 1:8] * (1 - g$s[39 + okno, 1:8])) /
                                    sum(g$mu0[39 + okno, 1:8]) - 1)
set.seed(653)
sym <- t(replicate(1000, {
  g <- gen_mu()
  y1 <- matrix(rpois(78 * 56, g$mu0 * (1 - g$s)), 78)                         # lokalizacja „losowa”
  y2 <- matrix(rpois(78 * 56, g$mu0 * exp(wzrost_tyg(0.004)) * (1 - g$s)), 78)  # wybrano rosnącą okolicę
  c(losowa = did_22(y1, 1:39), rosnaca = did_22(y2, 1:39), rosnaca_trend = did_trend(y2),
    krotkie_okno = did_22(y1, 1:8), prawda_39 = prawda(g, 1:39), prawda_trwala = prawda(g, 27:39))
}))
scen <- c("losowa", "rosnaca", "rosnaca_trend", "krotkie_okno")
wyn <- data.frame(scenariusz = scen, srednia = colMeans(sym[, scen]), sd = apply(sym[, scen], 2, sd),
                  prawda = c(rep(mean(sym[, "prawda_39"]), 3), mean(sym[, "prawda_trwala"])))
wyn$obciazenie <- wyn$srednia - wyn$prawda; wyn$blad_MC <- wyn$sd / sqrt(1000)
print(data.frame(scenariusz = wyn$scenariusz, round(wyn[, -1], 2)), row.names = FALSE)

etyk <- c(losowa = "lokalizacja „losowa”\n(39 tyg. po)", rosnaca = "wybrano rosnącą\nokolicę (39 tyg.)",
          rosnaca_trend = "rosnąca okolica\n+ trend z okresu przed", krotkie_okno = "tylko 8 tyg. po\n(ocena trwałej utraty)")
dl <- data.frame(scenariusz = factor(rep(scen, each = 1000), levels = rev(scen)), est = as.vector(sym[, scen]))
wyn$scenariusz <- factor(wyn$scenariusz, levels = rev(scen))
gA <- ggplot(odrz, aes(bledy, odsetek)) +
  geom_col(fill = c(kol[["L1"]], kol[["L3"]]), width = 0.55) +
  geom_errorbar(aes(ymin = odsetek - 1.96 * blad_MC, ymax = odsetek + 1.96 * blad_MC), width = 0.15) +
  geom_hline(yintercept = 5, linetype = "dashed", colour = "grey25") +
  annotate("text", x = 1.5, y = 7.5, label = "5% – tak powinno być", size = 3.6) +
  geom_text(aes(y = odsetek / 2, label = paste0(round(odsetek, 1), "%")), colour = "white", fontface = "bold", size = 4.2) +
  scale_y_continuous(limits = c(0, max(odrz$odsetek) + 12)) +
  labs(x = NULL, y = "Odrzucenia (%)", title = "A. Test „trendów przed” przy 8 osiedlach leczonych",
       subtitle = "200 powtórzeń; trendy w danych są równoległe, więc każde odrzucenie jest fałszywe") + motyw
gB <- ggplot(dl, aes(est, scenariusz)) +
  geom_boxplot(fill = "grey92", colour = "grey35", outlier.size = 0.5, outlier.alpha = 0.4, width = 0.55) +
  geom_point(data = wyn, aes(x = prawda, y = scenariusz, shape = "prawdziwa utrata"), colour = kol[["L1"]], size = 3.6) +
  geom_point(data = wyn, aes(x = srednia, y = scenariusz, shape = "średnia z 1000 oszacowań"), colour = kol[["L3"]], size = 3) +
  scale_shape_manual(values = c("prawdziwa utrata" = 18, "średnia z 1000 oszacowań" = 16), name = NULL) +
  scale_y_discrete(labels = etyk) +
  labs(x = "Oszacowana zmiana zamówień osiedli blisko N (%)", y = NULL,
       title = "B. Nielosowa lokalizacja i efekt nowości zniekształcają DiD") + motyw
p5 <- gA / gB + plot_layout(heights = c(1, 1.5))
p5   # zapis: ggsave("kanibalizacja-symulacja.svg", p5, width = 10, height = 9)
Wynik w R
                    bledy odsetek blad_MC
 klastrowane po osiedlach    26.5     3.1
    Newey–West dla panelu    10.5     2.2
    scenariusz srednia   sd prawda obciazenie blad_MC
        losowa  -14.64 1.91 -14.59      -0.05    0.06
       rosnaca    0.08 2.31 -14.59      14.67    0.07
 rosnaca_trend  -14.64 3.37 -14.59      -0.05    0.11
  krotkie_okno  -18.11 2.68 -13.54      -4.57    0.08
6. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – pomarańczowy (L1 / L2 na rys. 1)" = c("#D55E00", "#E69F00"),
             "pomarańczowy – niebieski (L2 / L3 na rys. 1)" = c("#E69F00", "#0072B2"),
             "cynober – niebieski (pasy / model na rys. 2; słupki na rys. 5)" = c("#D55E00", "#0072B2"),
             "zielony – szary (nowy lokal / kontrola)" = c("#009E73", "#737373"),
             "jasnopomarańczowy – jasnoniebieski (zabiera / dokłada na rys. 4)" = c("#F6C9A9", "#CFE3F2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                 widzenie_typowe
cynober – pomarańczowy (L1 / L2 na rys. 1)                                  33.4
pomarańczowy – niebieski (L2 / L3 na rys. 1)                               120.2
cynober – niebieski (pasy / model na rys. 2; słupki na rys. 5)             114.6
zielony – szary (nowy lokal / kontrola)                                     48.4
jasnopomarańczowy – jasnoniebieski (zabiera / dokłada na rys. 4)            35.4
czerwony – zielony (do unikania)                                           121.7
                                                                 deuteranopia
cynober – pomarańczowy (L1 / L2 na rys. 1)                               18.4
pomarańczowy – niebieski (L2 / L3 na rys. 1)                            121.5
cynober – niebieski (pasy / model na rys. 2; słupki na rys. 5)          108.3
zielony – szary (nowy lokal / kontrola)                                  11.9
jasnopomarańczowy – jasnoniebieski (zabiera / dokłada na rys. 4)         34.6
czerwony – zielony (do unikania)                                         21.1
                                                                 protanopia
cynober – pomarańczowy (L1 / L2 na rys. 1)                             24.9
pomarańczowy – niebieski (L2 / L3 na rys. 1)                          109.3
cynober – niebieski (pasy / model na rys. 2; słupki na rys. 5)         91.9
zielony – szary (nowy lokal / kontrola)                                22.3
jasnopomarańczowy – jasnoniebieski (zabiera / dokłada na rys. 4)       29.9
czerwony – zielony (do unikania)                                       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie i regresja liniowa – pakiety base i stats; regresja Poissona z efektami stałymi, błędy Neweya–Westa i testy łączne – pakiet fixest; losowanie współczynników – pakiet MASS). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Przed i po” bez grupy porównawczej, lokalizacja wybrana pod wzrost i ocena po pierwszym miesiącu – zob. rysunki 1, 5B i 3.
- Za mało jednostek leczonych. Przy 8 osiedlach i jednym mieście błędy klastrowane są zbyt optymistyczne. Wspólne wahania całego miasta (np. lokalne wydarzenie) dzielą wszystkie osiedla A, a przy jednym mieście leczonym trudno je oddzielić od efektu otwarcia. Sprawdź to testem placebo: udawane otwarcie w mieście porównawczym.
- Zależność kolejnych tygodni. Autokorelacja sprawia, że zwykłe błędy standardowe są za wąskie (Bertrand i in., 2004).
- Skażona grupa porównawcza. Jeśli N zabiera klientów także z miasta porównawczego (np. sąsiedniego), DiD zaniża stratę.
Najczęstsze pytania
Jak policzyć kanibalizację sprzedaży po otwarciu nowego sklepu?
Oszacuj, ile straciły dotychczasowe sklepy względem kontrfaktu, np. różnicą w różnicach z grupą porównawczą sklepów, w pobliżu których nic nie otwarto. Kanibalizacja to suma tych strat podzielona przez sprzedaż nowego sklepu. W przykładzie wyniosła 19.5% (95% CI [15.3, 23.8]), a przyrost netto sieci – ok. 80% sprzedaży nowego lokalu.
Dlaczego porównanie sprzedaży przed i po otwarciu nowego lokalu nie wystarczy?
Bo w tym samym czasie zmienia się sezon, ceny i pogoda. W przykładzie najbliższy stary lokal miał po otwarciu o 4.4% więcej zamówień niż przed, bo otwarcie wypadło na początku sezonu jesienno-zimowego. Dopiero porównanie z miastami bez otwarcia pokazało spadek o 14.5%.
Jak sprawdzić, czy kanibalizacja zależy od odległości?
Oszacuj efekt różnicy w różnicach osobno dla pasów odległości (np. 0–1, 1–2, 2–3 km) albo dodaj interakcję efektu z odległością. Pokaż pasy z 95% CI przed modelem ciągłym – prosta zależność liniowa może zaniżyć stratę najbliższych osiedli, jak w przykładzie (−15.8% zamiast −23.2% przy 0.5 km).
Co to jest efekt nowości po otwarciu sklepu?
To chwilowo większa sprzedaż nowego lokalu i większa strata starych w pierwszych tygodniach – klienci sprawdzają nowe miejsce. W przykładzie strata pobliskich osiedli wynosiła 24.4% w pierwszych 4 tygodniach i ok. 14–20% później. Ocena po 8 tygodniach zawyżała trwałą stratę średnio o 4.6 punktu procentowego.
Czy test trendów równoległych w event study jest wiarygodny?
Traktuj go ostrożnie. Przy małej liczbie jednostek leczonych błędy klastrowane dawały w symulacji 26.5% fałszywych alarmów zamiast 5%, a nieistotny test nie dowodzi równoległości trendów (Roth, 2022; Kahn-Lang i Lang, 2020). Patrz na wielkość współczynników przed interwencją i uzasadnij wybór grupy porównawczej.
Powiązane hasła
Przeczytaj też
Quasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikEfekt szkolenia – różnica w różnicach
60 salonów, szkolenie w 20 wybranych po dobrym kwartale: regresja do średniej, DiD, model zdarzeń i błędy klastrowane – pięć rysunków z kodem R.
Czytaj →PoradnikGdzie otworzyć sklep – model Huffa
Sieć sklepów ogrodniczych i trzy działki: model Huffa z kart lojalnościowych, mapa udziałów, kanibalizacja, bootstrap i pułapka linii prostej – sześć rysunków z kodem R.
Czytaj →PoradnikGazetka promocyjna: efekt i dołek
Sieć 60 supermarketów: strona tytułowa i rabat osobno w modelu z efektami stałymi, dołek po promocji, kanibalizacja i błędy klastrowane – z kodem R.
Czytaj →Oceniasz skutki otwarcia sklepu w pracy z zarządzania?
Pomożemy dobrać grupę porównawczą, zbudować model różnicy w różnicach i event study, ocenić trendy przed interwencją i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bertrand, M., Duflo, E., & Mullainathan, S. (2004). How much should we trust differences-in-differences estimates? The Quarterly Journal of Economics, 119(1), 249–275. https://doi.org/10.1162/003355304772839588 ● Otwarty dostęp: pełny tekst
- Freyaldenhoven, S., Hansen, C., & Shapiro, J. M. (2019). Pre-event trends in the panel event-study design. American Economic Review, 109(9), 3307–3338. https://doi.org/10.1257/aer.20180609 ● Otwarty dostęp: pełny tekst
- Kahn-Lang, A., & Lang, K. (2020). The promise and pitfalls of differences-in-differences: Reflections on 16 and Pregnant and other applications. Journal of Business & Economic Statistics, 38(3), 613–620. https://doi.org/10.1080/07350015.2018.1546591 ● Otwarty dostęp: pełny tekst
- Roth, J. (2022). Pretest with caution: Event-study estimates after testing for parallel trends. American Economic Review: Insights, 4(3), 305–322. https://doi.org/10.1257/aeri.20210236
- Roth, J., Sant’Anna, P. H. C., Bilinski, A., & Poe, J. (2023). What’s trending in difference-in-differences? A synthesis of the recent econometrics literature. Journal of Econometrics, 235(2), 2218–2244. https://doi.org/10.1016/j.jeconom.2023.03.008 ● Otwarty dostęp: pełny tekst
- Wing, C., Simon, K., & Bello-Gomez, R. A. (2018). Designing difference in difference studies: Best practices for public health policy research. Annual Review of Public Health, 39(1), 453–469. https://doi.org/10.1146/annurev-publhealth-040617-013507 ● Otwarty dostęp
Cytowania BibTeX
@article{bertrand2004how, author={Bertrand, Marianne and Duflo, Esther and Mullainathan, Sendhil}, title={{How much should we trust differences-in-differences estimates?}}, journal={The Quarterly Journal of Economics}, year={2004}, volume={119}, number={1}, pages={249--275}, doi={10.1162/003355304772839588}}@article{freyaldenhoven2019pre, author={Freyaldenhoven, Simon and Hansen, Christian and Shapiro, Jesse M.}, title={{Pre-event trends in the panel event-study design}}, journal={American Economic Review}, year={2019}, volume={109}, number={9}, pages={3307--3338}, doi={10.1257/aer.20180609}}@article{kahnlang2020promise, author={Kahn-Lang, Ariella and Lang, Kevin}, title={{The promise and pitfalls of differences-in-differences: Reflections on 16 and Pregnant and other applications}}, journal={Journal of Business \& Economic Statistics}, year={2020}, volume={38}, number={3}, pages={613--620}, doi={10.1080/07350015.2018.1546591}}@article{roth2022pretest, author={Roth, Jonathan}, title={{Pretest with caution: Event-study estimates after testing for parallel trends}}, journal={American Economic Review: Insights}, year={2022}, volume={4}, number={3}, pages={305--322}, doi={10.1257/aeri.20210236}}@article{roth2023whats, author={Roth, Jonathan and Sant’Anna, Pedro H. C. and Bilinski, Alyssa and Poe, John}, title={{What’s trending in difference-in-differences? A synthesis of the recent econometrics literature}}, journal={Journal of Econometrics}, year={2023}, volume={235}, number={2}, pages={2218--2244}, doi={10.1016/j.jeconom.2023.03.008}}@article{wing2018designing, author={Wing, Coady and Simon, Kosali and Bello-Gomez, Ricardo A.}, title={{Designing difference in difference studies: Best practices for public health policy research}}, journal={Annual Review of Public Health}, year={2018}, volume={39}, number={1}, pages={453--469}, doi={10.1146/annurev-publhealth-040617-013507}}