Co to jest regresja Poissona?
Regresja Poissona (ang. Poisson regression) to model regresji dla liczebności – zmiennej zależnej, która liczy zdarzenia w określonym czasie: napady paniki w ciągu miesiąca, wypalone papierosy, błędy w zadaniu, wizyty w poradni. Należy do rodziny uogólnionych modeli liniowych (GLM), podobnie jak regresja logistyczna: predyktory działają liniowo nie na samą liczbę zdarzeń, lecz na jej logarytm.
Coxe, West i Aiken (2009) w przystępnym wprowadzeniu wskazują, że jest to właściwy model dla liczebności o niskiej średniej (zwykle poniżej 10), gdy zwykła regresja liniowa (MNK) może dawać obciążone wyniki, i omawiają jego warianty: nadmiernie rozproszony model Poissona, regresję ujemną dwumianową oraz modele dla nadmiaru zer. Praktyczne użycie regresji – od modelu liniowego po regresję logistyczną i inne uogólnione modele liniowe – omawiają też Gelman, Hill i Vehtari (2020).
Dlaczego nie regresja liniowa?
Liczebności mają cechy, z którymi model liniowy radzi sobie źle:
- są nieujemnymi liczbami całkowitymi, a prosta regresji może przewidywać wartości ujemne;
- ich rozkład jest zwykle prawostronnie skośny, z wieloma zerami (efekt podłogi);
- wariancja rośnie razem ze średnią, co narusza założenie homoskedastyczności.
Gardner, Mulvey i Shaw (1995) opisują problemy wynikające z analizowania liczebności zwykłą regresją liniową i porównują modele zaprojektowane dla takich danych – regresję Poissona, jej wersję z nadmiernym rozproszeniem i regresję ujemną dwumianową.
Model i ilorazy częstości (IRR)
- μi – oczekiwana liczba zdarzeń u osoby i; obserwowana liczba ma rozkład Poissona o średniej μi;
- β – zmiana logarytmu oczekiwanej liczby zdarzeń, gdy predyktor rośnie o 1;
- IRR (ang. incidence rate ratio, iloraz częstości) – ile razy zmienia się oczekiwana liczba zdarzeń przy wzroście predyktora o 1. IRR = 0.61 oznacza o 39% mniej zdarzeń, IRR = 1.38 – o 38% więcej. To nie jest iloraz szans.
Parametry szacuje się metodą największej wiarygodności. Gdy osoby były obserwowane przez różny czas (np. od 10 do 30 dni), do modelu dodaje się offset log(czas obserwacji) – model opisuje wtedy częstość zdarzeń na dzień, a nie surową liczbę.
Kluczowa właściwość rozkładu Poissona: wariancja równa się średniej. W danych psychologicznych to założenie rzadko jest spełnione, bo ludzie różnią się między sobą bardziej, niż przewiduje model.
Nadmierne rozproszenie i nadmiar zer
Gdy wariancja jest większa niż średnia, mówimy o nadmiernym rozproszeniu (ang. overdispersion). Współczynniki regresji Poissona pozostają wtedy zbliżone, ale jej błędy standardowe są zbyt małe, a wyniki zbyt często istotne – Gardner i in. (1995) podkreślają, że przy nadmiernie rozproszonych danych model Poissona wprowadza w błąd. Sprawdzisz to, dzieląc sumę kwadratów reszt Pearsona przez liczbę stopni swobody: wartość bliska 1 jest w porządku, wyraźnie większa wskazuje na problem. Rozwiązania:
- quasi-Poisson – te same współczynniki, błędy standardowe pomnożone przez pierwiastek ze współczynnika rozproszenia;
- regresja ujemna dwumianowa (NB) – dodaje parametr θ, dzięki któremu wariancja wynosi μ + μ²/θ; w R funkcja
glm.nb()z pakietu MASS; - modele dla nadmiaru zer – gdy zer jest więcej, niż przewiduje nawet model NB (np. część osób w ogóle nie ma napadów). Atkins i in. (2013) opisują modele z nadmiarem zer (zero-inflated) i modele hurdle, także w wersjach wielopoziomowych dla danych podłużnych (zob. model wielopoziomowy), a Zeileis, Kleiber i Jackman (2008) – funkcje
hurdle()izeroinfl()z pakietu pscl w R.
Zanim sięgniesz po model z nadmiarem zer, sprawdź, ile zer przewiduje zwykły model ujemny dwumianowy – często to wystarcza.
Przykład: napady paniki po terapii CBT
W badaniu (dane symulowane) 200 pacjentów z napadami paniki – 100 po terapii poznawczo-behawioralnej (CBT) i 100 z listy oczekujących – podało liczbę napadów w ciągu ostatnich 30 dni. Predyktorami były grupa i wrażliwość lękowa (ASI-3, 0–72; M = 33.24, SD = 11.26). Średnia liczba napadów wyniosła 3.32, mediana 2, a maksimum 21; 48 osób (24.0%) nie miało żadnego napadu. Średnia i wariancja wyraźnie się rozjeżdżają: w grupie oczekujących 4.06 i 19.98, w grupie CBT 2.58 i 9.01.
Krok 1. Model Poissona. Oba predyktory były „bardzo istotne” (z = 10.53 dla ASI-3 i z = −6.06 dla grupy), ale współczynnik rozproszenia wyniósł 3.37 – wariancja reszt była ponad trzy razy większa, niż zakłada model.
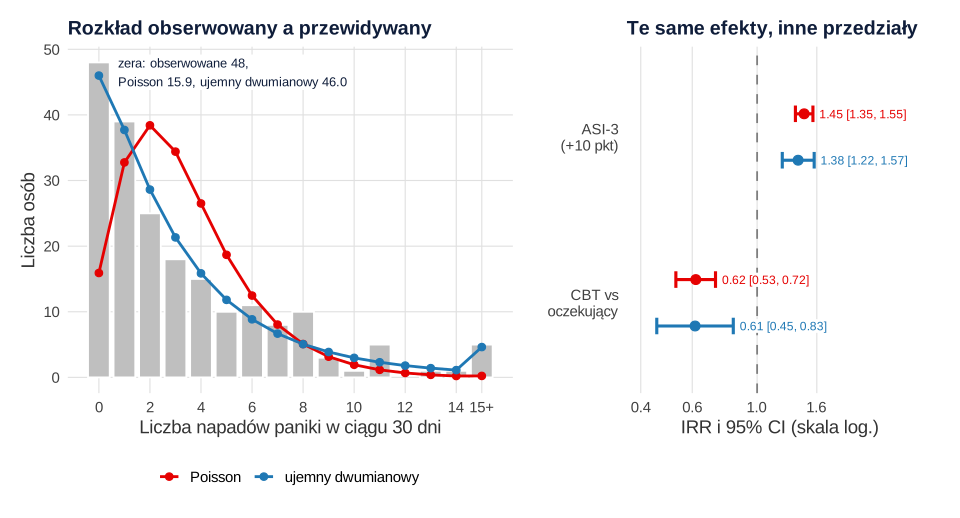
Krok 2. Model ujemny dwumianowy. Parametr θ = 1.21 (SE = 0.19), a dopasowanie znacznie się poprawiło: AIC spadło z 1120.1 do 911.1, test ilorazu wiarygodności χ²(1) = 210.97, p < .001. Współczynniki niewiele się zmieniły, ale błędy standardowe wzrosły mniej więcej dwukrotnie (rysunek 1).
| Wskaźnik | Regresja Poissona | Regresja ujemna dwumianowa |
|---|---|---|
| IRR dla ASI-3 (+10 pkt) [95% CI] | 1.45 [1.35, 1.55] | 1.38 [1.22, 1.57] |
| IRR dla CBT vs oczekujący [95% CI] | 0.62 [0.53, 0.72] | 0.61 [0.45, 0.83] |
| z dla grupy | −6.06 | −3.18 |
| AIC | 1120.1 | 911.1 |
| Przewidywana liczba osób bez napadów (obserwowana: 48) | 15.9 | 46.0 |
| Przewidywana liczba osób z ≥ 10 napadami (obserwowana: 13) | 4.6 | 14.2 |
Krok 3. Interpretacja. Przy tej samej wrażliwości lękowej pacjenci po CBT mieli o 39% mniej napadów niż osoby z listy oczekujących, IRR = 0.61, 95% CI [0.45, 0.83], p = .001 – przy ASI-3 równym 34 model przewiduje średnio 2.41 napadu wobec 3.93. Wzrost wrażliwości lękowej o 10 punktów wiązał się z liczbą napadów większą o 38%, IRR = 1.38, 95% CI [1.22, 1.57], p < .001. Model Poissona dawał podobne IRR, ale zbyt wąskie przedziały ufności. Model NB przewidział też prawie tyle zer, ile zaobserwowano (46.0 wobec 48), więc model z nadmiarem zer nie był potrzebny.
Jak opisać wynik w pracy (APA)
Uzasadnij wybór modelu (rozkład liczebności, rozproszenie, porównanie modeli), podaj IRR z 95% CI i przełóż je na procenty lub przewidywane liczby zdarzeń. Przykładowy opis:
Tabelę możesz zbudować jak w haśle tabela regresji w APA, zastępując B i β kolumnami b, SE, IRR i 95% CI. Więcej gotowych zdań znajdziesz w poradniku jak opisać wyniki w stylu APA.
Przykład w R
Kod generuje dane z przykładu, dopasowuje regresję Poissona, sprawdza nadmierne rozproszenie, dopasowuje regresję ujemną dwumianową (MASS::glm.nb), liczy IRR z 95% CI i porównuje liczbę zer przewidywaną przez oba modele. Liczby w tekście i na rysunku pochodzą z tego kodu (test ilorazu wiarygodności i model quasi-Poissona – w pełnym skrypcie strony).
Regresja Poissona i ujemna dwumianowa
R
library(MASS)
options(show.signif.stars = FALSE)
set.seed(229)
n <- 200
grupa <- factor(rep(c("oczekujący", "CBT"), each = n / 2), levels = c("oczekujący", "CBT"))
asi <- round(pmin(pmax(rnorm(n, 34, 11), 0), 72))                 # wrażliwość lękowa ASI-3 (0–72)
mu <- exp(log(4) + 0.03 * (asi - 34) - 0.6 * (grupa == "CBT"))    # średnia liczba napadów
napady <- rnbinom(n, size = 1.2, mu = mu)                          # napady paniki w ciągu 30 dni
dane <- data.frame(napady, grupa, asi)

# 1. Regresja Poissona i sprawdzenie nadmiernego rozproszenia
m_pois <- glm(napady ~ asi + grupa, family = poisson, data = dane)
summary(m_pois)
sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois)   # wyraźnie > 1 = nadmierne rozproszenie

# 2. Regresja ujemna dwumianowa
m_nb <- glm.nb(napady ~ asi + grupa, data = dane)
summary(m_nb)
c(AIC_Poisson = AIC(m_pois), AIC_NB = AIC(m_nb))

# 3. Ilorazy częstości (IRR) z 95% CI
round(exp(cbind(IRR = coef(m_nb), confint(m_nb))), 3)

# 4. Liczba zer: obserwowana i oczekiwana w obu modelach
c(obserwowane = sum(dane$napady == 0),
  Poisson = sum(dpois(0, fitted(m_pois))),
  NB = sum(dnbinom(0, size = m_nb$theta, mu = fitted(m_nb))))
Wynik w R
Call:
glm(formula = napady ~ asi + grupa, family = poisson, data = dane)

Coefficients:
             Estimate Std. Error z value Pr(>|z|)
(Intercept)  0.099826   0.141305   0.706     0.48
asi          0.037037   0.003516  10.532  < 2e-16
grupaCBT    -0.482835   0.079627  -6.064 1.33e-09

(Dispersion parameter for poisson family taken to be 1)

    Null deviance: 799.96  on 199  degrees of freedom
Residual deviance: 652.93  on 197  degrees of freedom
AIC: 1120.1

Number of Fisher Scoring iterations: 5

[1] 3.373146

Call:
glm.nb(formula = napady ~ asi + grupa, data = dane, init.theta = 1.214850632,
    link = log)

Coefficients:
             Estimate Std. Error z value Pr(>|z|)
(Intercept)  0.270859   0.254687   1.063  0.28756
asi          0.032276   0.006885   4.688 2.76e-06
grupaCBT    -0.488390   0.153456  -3.183  0.00146

(Dispersion parameter for Negative Binomial(1.2149) family taken to be 1)

    Null deviance: 260.76  on 199  degrees of freedom
Residual deviance: 225.61  on 197  degrees of freedom
AIC: 911.14

Number of Fisher Scoring iterations: 1


              Theta:  1.215
          Std. Err.:  0.192

 2 x log-likelihood:  -903.140
AIC_Poisson      AIC_NB
  1120.1069    911.1402
Waiting for profiling to be done...
              IRR 2.5 % 97.5 %
(Intercept) 1.311 0.819  2.104
asi         1.033 1.020  1.046
grupaCBT    0.614 0.454  0.829
obserwowane     Poisson          NB
   48.00000    15.91108    45.99282
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Regresja liniowa dla liczebności o niskiej średniej – może dawać obciążone wyniki i ujemne przewidywania (Coxe i in., 2009).
- Model Poissona bez sprawdzenia rozproszenia – przy nadmiernym rozproszeniu przedziały ufności są zbyt wąskie (w przykładzie dla CBT [0.53, 0.72] zamiast [0.45, 0.83]).
- Interpretowanie β jak zmiany liczby zdarzeń – współczynnik działa na skali logarytmu; interpretuj IRR = exp(β) jako zmianę procentową albo podaj przewidywane średnie.
- Nazywanie IRR ilorazem szans – IRR porównuje oczekiwane liczby zdarzeń, a nie szanse.
- Pominięcie offsetu przy różnym czasie obserwacji – osoba obserwowana dłużej ma więcej okazji do zdarzeń; dodaj log(czas) jako offset.
- Model z nadmiarem zer „na wszelki wypadek” – stosuj go, gdy zwykły model NB wyraźnie nie odtwarza liczby zer i gdy masz teoretyczne uzasadnienie dla dwóch procesów (np. osoby, które nigdy nie mają napadów).
Liczebności to tylko jeden z typów zmiennych wymagających specjalnego modelu – dla danych porządkowych zob. regresja porządkowa, a dla wyników dwukategorialnych poradnik o regresji logistycznej.
Najczęstsze pytania
Kiedy stosować regresję Poissona?
Gdy zmienna zależna jest liczebnością – liczbą zdarzeń w określonym czasie lub przestrzeni (napady paniki w miesiącu, liczba błędów, liczba wizyt) – zwłaszcza o niskiej średniej i z wieloma zerami. Dla takich danych regresja liniowa może dawać obciążone wyniki i ujemne przewidywania.
Jak interpretować IRR w regresji Poissona?
IRR = exp(β) mówi, ile razy zmienia się oczekiwana liczba zdarzeń, gdy predyktor rośnie o 1. IRR = 0.61 oznacza o 39% mniej zdarzeń, a IRR = 1.38 – o 38% więcej. IRR nie jest ilorazem szans; najlepiej uzupełnić go przewidywanymi średnimi liczbami zdarzeń.
Co to jest nadmierne rozproszenie i jak je sprawdzić?
To sytuacja, w której wariancja liczebności jest większa niż średnia, choć model Poissona zakłada ich równość. Sprawdzisz to, dzieląc sumę kwadratów reszt Pearsona przez liczbę stopni swobody – wartość wyraźnie większa od 1 (w przykładzie na tej stronie 3.37) oznacza, że błędy standardowe modelu Poissona są zaniżone.
Regresja Poissona czy ujemna dwumianowa?
Zacznij od modelu Poissona i sprawdź rozproszenie. Jeśli wariancja wyraźnie przewyższa średnią, użyj regresji ujemnej dwumianowej (w R MASS::glm.nb) i porównaj modele przez AIC lub test ilorazu wiarygodności. Współczynniki zwykle są podobne, ale przedziały ufności modelu ujemnego dwumianowego są szersze i wiarygodniejsze.
Co zrobić, gdy w danych jest bardzo dużo zer?
Najpierw sprawdź, ile zer przewiduje model ujemny dwumianowy – często wystarcza. Jeśli wyraźnie ich brakuje i masz teoretyczne uzasadnienie (np. część osób nigdy nie doświadcza zdarzenia), rozważ model z nadmiarem zer (zero-inflated) albo model hurdle, np. funkcje zeroinfl() i hurdle() z pakietu pscl w R.
Jak zrobić regresję Poissona w SPSS?
Wybierz Analiza → Uogólnione modele liniowe → Uogólnione modele liniowe. W zakładce typu modelu wybierz model Poissona (log-liniowy) albo ujemny dwumianowy z logarytmiczną funkcją łączącą, w zakładkach Odpowiedź i Predyktory wskaż zmienne, a w Statystykach zaznacz wykładnicze oszacowania parametrów – to będą IRR.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikStatystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Atkins, D. C., Baldwin, S. A., Zheng, C., Gallop, R. J., & Neighbors, C. (2013). A tutorial on count regression and zero-altered count models for longitudinal substance use data. Psychology of Addictive Behaviors, 27(1), 166–177. https://doi.org/10.1037/a0029508 ● Otwarty dostęp: pełny tekst
- Coxe, S., West, S. G., & Aiken, L. S. (2009). The analysis of count data: A gentle introduction to Poisson regression and its alternatives. Journal of Personality Assessment, 91(2), 121–136. https://doi.org/10.1080/00223890802634175
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Gelman, A., Hill, J., & Vehtari, A. (2020). Regression and other stories. Cambridge University Press. https://doi.org/10.1017/9781139161879
- Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8), 1–25. https://doi.org/10.18637/jss.v027.i08 ● Otwarty dostęp
Cytowania BibTeX
@article{atkins2013tutorial, author={Atkins, David C. and Baldwin, Scott A. and Zheng, Cheng and Gallop, Robert J. and Neighbors, Clayton}, title={{A tutorial on count regression and zero-altered count models for longitudinal substance use data}}, journal={Psychology of Addictive Behaviors}, year={2013}, volume={27}, number={1}, pages={166--177}, doi={10.1037/a0029508}}@article{coxe2009analysis, author={Coxe, Stefany and West, Stephen G. and Aiken, Leona S.}, title={{The analysis of count data: A gentle introduction to Poisson regression and its alternatives}}, journal={Journal of Personality Assessment}, year={2009}, volume={91}, number={2}, pages={121--136}, doi={10.1080/00223890802634175}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@book{gelman2020regression, author={Gelman, Andrew and Hill, Jennifer and Vehtari, Aki}, title={{Regression and other stories}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781139161879}}@article{zeileis2008regression, author={Zeileis, Achim and Kleiber, Christian and Jackman, Simon}, title={{Regression models for count data in R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={8}, pages={1--25}, doi={10.18637/jss.v027.i08}}