Pięć obrazków o danych zliczeniowych
Definicje są w hasłach regresja Poissona, rozkład Poissona i regresja ujemna dwumianowa. Pełną procedurę z offsetem, modelami z nadmiarem zer i tabelą APA opisuje wpis regresja dla zliczeń krok po kroku, a okna programów – wpisy o regresji Poissona w SPSS i w jamovi. Ten wpis z serii „wizualizacja na obrazkach” pokazuje mechanizm: czym zliczenia różnią się od wyników skali, co nadmierna dyspersja robi z przedziałami ufności w 1000 badaniach i jak narysować IRR.
Przykład jest fikcyjny: roczna liczba wizyt u lekarza rodzinnego u 400 dorosłych w wieku 18–85 lat. Predyktory to wiek, choroba przewlekła (tak/nie) i odległość do przychodni w kilometrach. Dane wylosowaliśmy z modelu ujemnego dwumianowego. Parametry ustawiono ręcznie: logarytm średniej = 0.9 + 0.4 × (wiek − 50)/10 + 0.6 × choroba − 0.06 × odległość, a parametr rozproszenia theta = 2. Ziarno 600 ustalono raz i nie zmieniano go. Dane pobierzesz jako regresja-poissona-wizyty.csv.
Rysunek 1: jak wyglądają zliczenia
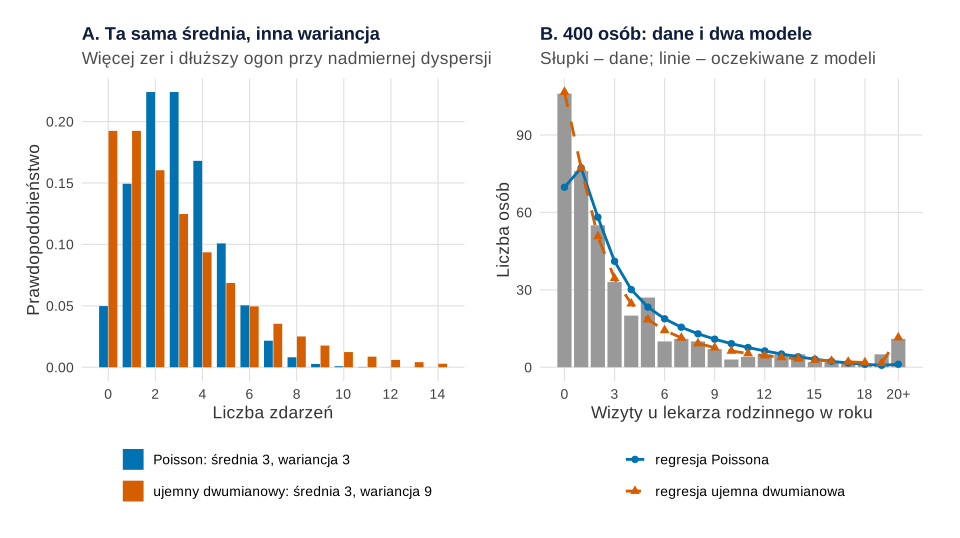
set.seed(600)).Co widać. Panel A to dwa rozkłady o średniej 3. W rozkładzie Poissona wariancja też wynosi 3. Prawdopodobieństwo zera to tam .050, a dziesięciu lub więcej zdarzeń – .001. Rozkład ujemny dwumianowy o wariancji 9 ma zero z prawdopodobieństwem .192 i dziesięć lub więcej zdarzeń z prawdopodobieństwem .040. Tak wygląda nadmierna dyspersja: więcej zer i dłuższy prawy ogon. W panelu B są nasze dane. Średnia liczba wizyt to 3.80, wariancja 28.21, a 106 z 400 osób nie było u lekarza ani razu. Model Poissona przewiduje 69.7 osób bez wizyty i 1.1 osoby z 20 lub więcej wizytami. Model ujemny dwumianowy przewiduje odpowiednio 106.6 i 11.5 osoby, a w danych było 106 i 11.
Czego ten wykres nie pokazuje. Panel A nie ocenia modelu. Duża wariancja całej zmiennej bywa skutkiem predyktorów (starsi i chorzy chodzą do lekarza częściej), dlatego w panelu B liczyliśmy z modeli z predyktorami. Nawet po ich uwzględnieniu współczynnik dyspersji modelu Poissona (suma kwadratów reszt Pearsona przez liczbę stopni swobody) wyniósł 2.94. Model ujemny dwumianowy oszacował theta = 1.81 (SE = 0.22). Jak wykryć nadmierną dyspersję i skąd się bierze, opisuje hasło. Dokładniejszym narzędziem niż słupki jest rootogram (Kleiber i Zeileis, 2016), pokazany we wpisie o regresji dla zliczeń.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: prosta na zliczeniach
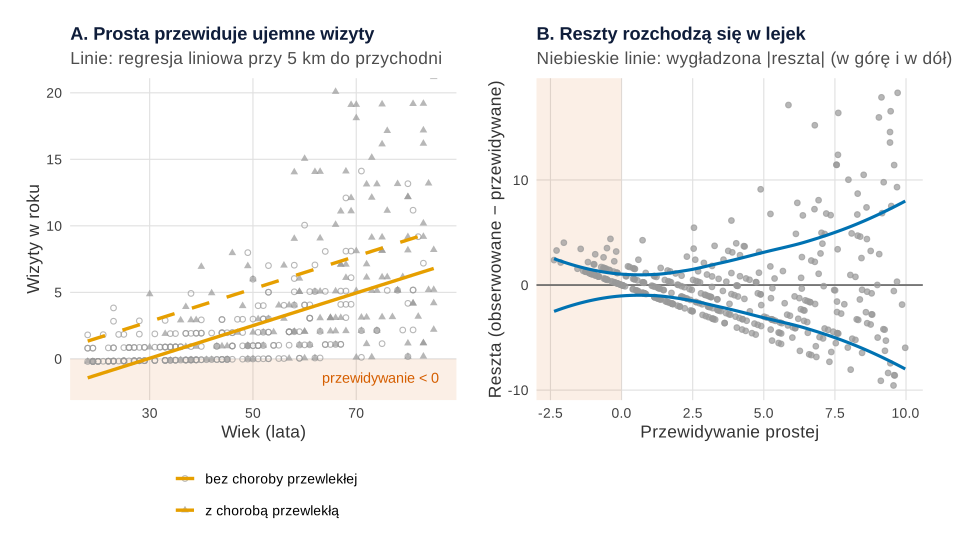
Co widać. Zwykła regresja liniowa z tymi samymi predyktorami mówi: każda dekada wieku to +1.23 wizyty, choroba przewlekła to +2.76 wizyty, a każdy kilometr do przychodni to −0.11 wizyty. Prosta nie wie jednak, że liczba wizyt nie może być ujemna. Dla 59 z 400 osób (14.8%) przewiduje wartość poniżej zera, najniżej −2.37. Zdrowy 18-latek mieszkający 15 km od przychodni dostaje −2.54 wizyty. Drugi problem (panel B): rozrzut reszt rośnie z przewidywaniem. W najniższej piątce przewidywań odchylenie standardowe reszt wynosi 1.05, a w najwyższej 7.42. Przy zliczeniach to reguła, bo wariancja rośnie ze średnią. Por. galeria wykresów reszt.
Czego ten wykres nie pokazuje i jak może zmylić. Ukośny pas punktów w lewym dolnym rogu panelu B to nie błąd rysunku. Tworzą go osoby z zerem wizyt: dla nich reszta = −przewidywanie, więc leżą na jednej linii. Przy dużych średnich prosta bywa przybliżeniem do przyjęcia, ale przy niskich średnich, zwykle poniżej 10, zwykła regresja metodą najmniejszych kwadratów może dawać obciążone wyniki (Coxe i in., 2009). Logarytmowanie wyniku też nie pomaga, bo zera trzeba wtedy „naprawiać” dodaniem stałej. W symulacjach O’Hary i Kotzego (2010) transformacje działały słabo, a modele quasi-Poissona i ujemny dwumianowy dla surowych zliczeń – dobrze. Szerzej o tym w haśle transformacja logarytmiczna.
Podpis do pracy (np. w rozdziale uzasadniającym wybór metody):
Zdanie do Metody:
Rysunek 3: krzywa w skali wizyt, prosta w skali logarytmu
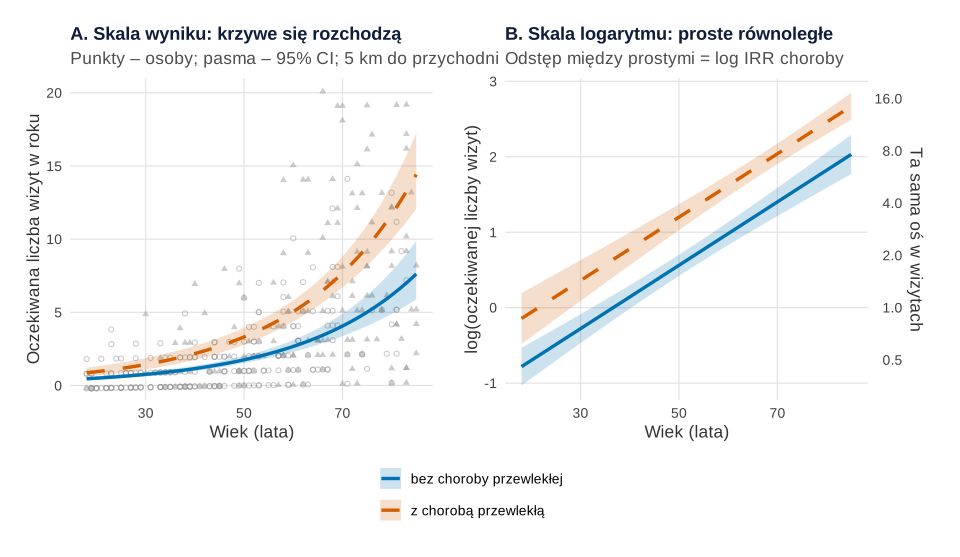
Co widać. Model dla zliczeń jest liniowy w skali logarytmu oczekiwanej liczby zdarzeń. W panelu B wiek i choroba dają więc dwie równoległe proste. Funkcja wykładnicza zamienia je w panelu A w krzywe zawsze powyżej zera. Krzywe się rozchodzą, choć w modelu nie ma interakcji. Przy 5 km do przychodni osoba bez choroby przewlekłej ma oczekiwane 0.50 wizyty w wieku 20 lat, 1.75 w wieku 50 i 6.18 w wieku 80. Osoba z chorobą ma odpowiednio 0.94, 3.32 i 11.69 wizyty. Różnica rośnie z 0.44 do 5.51 wizyty, a iloraz przez cały czas wynosi 1.89. Tak samo działa wiek: dziesięć lat między 20. a 30. rokiem życia dodaje 0.26 wizyty, a między 70. a 80. – 2.12 wizyty. Efekt jest stały jako mnożnik, a nie jako liczba wizyt.
Czego ten wykres nie pokazuje i jak może zmylić. Na panelu A rozchodzące się krzywe łatwo wziąć za interakcję wieku z chorobą. To ten sam efekt skali co w regresji logistycznej w obrazkach. Interakcję ocenia się zawsze w konkretnej skali – zob. moderacja – wizualizacja na obrazkach. Rysunek pokazuje model ujemny dwumianowy. Model Poissona dał niemal te same współczynniki (dla choroby 0.649 wobec 0.638 w skali logarytmu), ale wyraźnie mniejsze błędy standardowe (0.064 wobec 0.113). Pasma z modelu Poissona byłyby więc węższe, niż uzasadniają dane. Pasma to przedziały ufności średniej, a nie zakres wyników osób.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: nadmierna dyspersja w 1000 badaniach
Czy model Poissona przy nadmiernej dyspersji jest groźny? Sprawdziliśmy to symulacją. Jedno badanie to dwie grupy po 100 osób. Grupa porównawcza ma średnio 2 zdarzenia, a prawdziwy iloraz częstości (IRR) wynosi 1.5. Dane losowaliśmy z rozkładu Poissona albo z rozkładu ujemnego dwumianowego o malejącym theta (5, 2, 1 i 0.5). Przy średniej 2.5 daje to wariancję 1.5, 2.25, 3.5 i 6 razy większą od średniej. Każdy scenariusz powtórzyliśmy 1000 razy. Za każdym razem liczyliśmy 95% przedział Walda dla IRR z trzech modeli: Poissona, quasi-Poissona (błąd standardowy pomnożony przez pierwiastek ze współczynnika dyspersji) i ujemnego dwumianowego. Parametry dobraliśmy ręcznie.
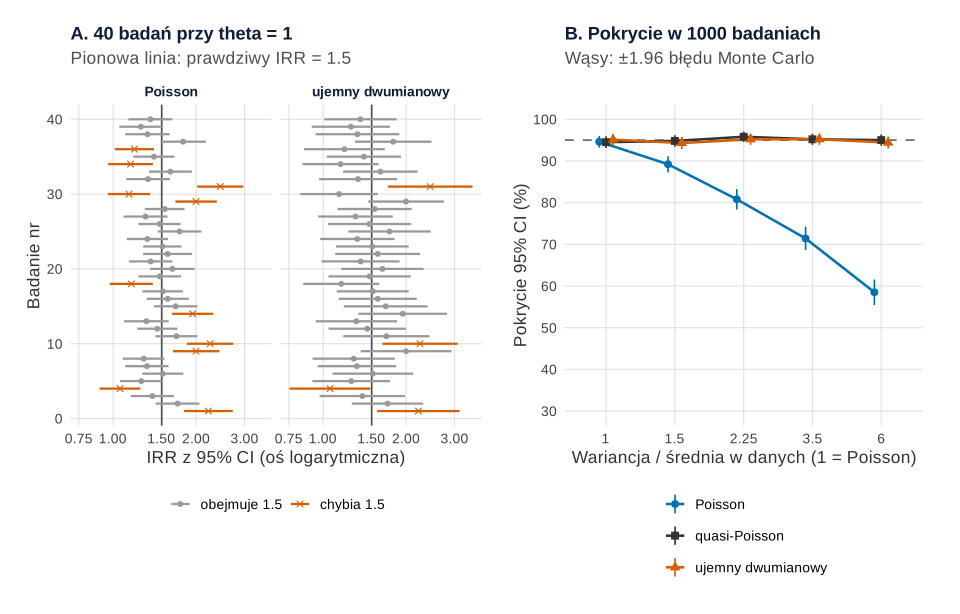
set.seed(600)).Co widać. Gdy dane naprawdę pochodzą z rozkładu Poissona, wszystkie trzy modele trafiają w nominalne 95%. Pokrycie wynosi 94.6% dla Poissona, 94.5% dla quasi-Poissona i 95.1% dla modelu ujemnego dwumianowego (błąd Monte Carlo ≈ 0.7 pp). Wraz z dyspersją przedziały Poissona coraz częściej chybiają. Przy wariancji 1.5 razy większej od średniej pokrycie spada do 89.2%, przy 2.25 razy – do 80.8%, przy 3.5 razy – do 71.4%, a przy 6 razy – do 58.5% (błąd MC ≈ 1.6 pp). Quasi-Poisson (od 94.5% do 95.8%) i model ujemny dwumianowy (od 94.3% do 95.2%) trzymają się 95%. Panel A pokazuje mechanizm: środki przedziałów obu modeli leżą podobnie, ale przedziały Poissona są za krótkie. Spośród 40 pierwszych badań przy theta = 1 chybiło 11 przedziałów Poissona i 4 przedziały modelu ujemnego dwumianowego. Mediana współczynnika dyspersji rosła od 0.99 w danych Poissona do 5.74 przy theta = 0.5.
Czego ten wykres nie pokazuje i jak może zmylić. Że model ujemny dwumianowy zawsze naprawia problem. Tu wygrywa, bo dane pochodziły dokładnie z jego rozkładu. Quasi-Poisson zakłada wariancję proporcjonalną do średniej, a model ujemny dwumianowy – wariancję rosnącą z kwadratem średniej. Przy wielu predyktorach oba mogą więc ważyć małe i duże zliczenia inaczej i dawać wyraźnie różne efekty (Ver Hoef i Boveng, 2007). Symulacja nie obejmuje też nadmiaru zer, zależności obserwacji (np. kilka pomiarów tej samej osoby – wtedy GLMM) ani pominiętych predyktorów. Czym jest pokrycie, pokazuje wpis przedział ufności w obrazkach.
Podpis do pracy (np. w aneksie, gdy uzasadniasz wybór modelu):
Zdanie do Metody:
Rysunek 5: IRR na wykresie
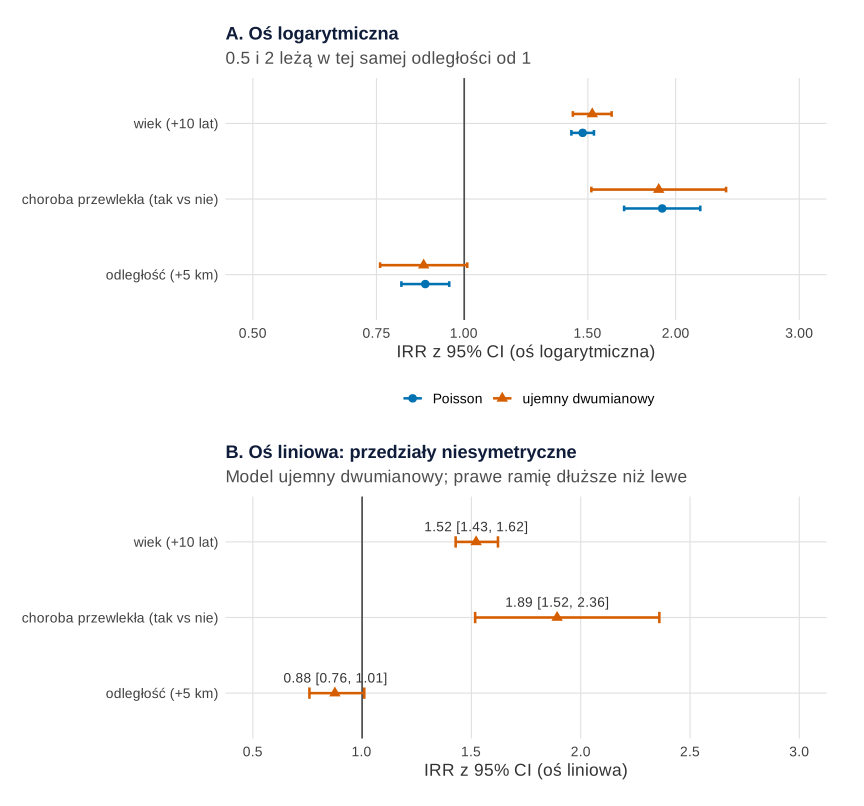
Co widać. IRR to exp(b), czyli mnożnik oczekiwanej liczby zdarzeń. W modelu ujemnym dwumianowym dekada wieku daje IRR = 1.52, 95% CI [1.43, 1.62], czyli o 52.2% więcej wizyt. Choroba przewlekła daje IRR = 1.89, 95% CI [1.52, 2.36], czyli o 89.2% więcej. Odległość większa o 5 km daje IRR = 0.88, 95% CI [0.76, 1.01], p = .068, czyli o 12.5% mniej wizyt. Na osi logarytmicznej (A) przedziały są symetryczne wokół punktu, a IRR = 0.5 i IRR = 2 leżą w tej samej odległości od 1. Na osi liniowej (B) prawe ramię jest dłuższe: dla choroby lewe ramię ma długość 0.375, a prawe 0.468. Zmienia się też wniosek dla odległości: model Poissona daje IRR = 0.88, 95% CI [0.81, 0.95], p = .001. Ten sam efekt w modelu ujemnym dwumianowym nie jest istotny, bo jego przedział jest prawie dwa razy szerszy.
Czego ten wykres nie pokazuje i jak może zmylić. IRR nie mówi, ile wizyt przybywa. Ten sam mnożnik 1.89 to 0.44 wizyty u 20-latka i 5.51 wizyty u 80-latka (rysunek 3). Do pracy podaj więc obok IRR przewidywane liczby dla kilku typowych profili, jak we wpisie wynik regresji na wykresie. IRR zależy też od jednostki (odległość przeliczyliśmy na 5 km), więc jednostki opisz na wykresie. Przedziały są przedziałami Walda. Alternatywą są przedziały z profilu wiarygodności.
Offset krótko. Gdy osoby obserwowano przez różny czas, do modelu dodaje się logarytm czasu obserwacji ze współczynnikiem 1, a IRR dotyczy wtedy częstości na jednostkę czasu – zob. hasło offset w regresji Poissona. Gdy wynik jest binarny, a chcesz ryzyka względnego zamiast ilorazu szans, zajrzyj do hasła zmodyfikowana regresja Poissona.
Podpis do pracy:
Zdanie do Wyników:
Co z tego wziąć do pracy dyplomowej
- Najpierw narysuj rozkład wyniku – słupek dla każdej wartości (rysunek 1) – i podaj średnią, wariancję i odsetek zer.
- Policz współczynnik dyspersji modelu Poissona z predyktorami, a nie samą wariancję zmiennej. Wartość wyraźnie powyżej 1 to sygnał do modelu ujemnego dwumianowego albo quasi-Poissona (rysunek 4).
- Raportuj IRR z przedziałami i przewidywane liczby dla kilku profili (rysunki 3 i 5). Wykres IRR rysuj na osi logarytmicznej.
- Do Metody wpisz rodzaj modelu, funkcję łączącą (logarytm), sposób sprawdzenia dyspersji i ewentualny offset.
- Na obronę przyda się rysunek 4: pokazuje, dlaczego „istotny” wynik z modelu Poissona przy nadmiernej dyspersji może być złudzeniem. Ogólne zasady rysunków w pracy są we wpisie wykresy w pracy dyplomowej.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R. Przepis 1 tworzy paletę, motyw, dane i dwa modele (m_pois, m_nb), z których korzystają przepisy 2, 3 i 5. Przepis 4 (symulacja) potrzebuje z przepisu 1 tylko palety i motywu. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Przepisy, które losują (1 i 4), zaczynają się od własnego set.seed(600). Rozsunięcie punktów w pionie na rysunkach 2 i 3 ma ziarno w position_jitter(seed = 600). Przepisy 2, 3, 5 i 6 niczego innego nie losują. Ziarno 600 ustalono raz i nie zmieniano go. Ręcznie ustalono: współczynniki modelu generującego dane (0.9; 0.4 na dekadę wieku; 0.6 dla choroby przewlekłej; −0.06 na kilometr), theta = 2, liczebność 400, a w symulacji: 2 × 100 osób, średnią 2, IRR = 1.5, wartości theta (∞, 5, 2, 1, 0.5) i 1000 powtórzeń. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Symulacja liczy się około 20 sekund.
1. Paleta, dane i dwa modele: Rysunek 1
R
# Rysunek 1. Jak wyglądają zliczenia: rozkład Poissona a ujemny dwumianowy (dane fikcyjne, symulowane)
library(ggplot2)
library(patchwork)
library(MASS)                                   # glm.nb(): regresja ujemna dwumianowa

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(poisson = "#0072B2", nb = "#D55E00", liniowa = "#E69F00", dane = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# A. Ta sama średnia (3 zdarzenia), różna wariancja: Poisson (wariancja = 3) i ujemny dwumianowy (theta = 1.5)
k <- 0:14
teoria <- rbind(data.frame(k, p = dpois(k, 3), rozklad = "Poisson: średnia 3, wariancja 3"),
                data.frame(k, p = dnbinom(k, mu = 3, size = 1.5), rozklad = "ujemny dwumianowy: średnia 3, wariancja 9"))
round(c(P0_poisson = dpois(0, 3), P0_nb = dnbinom(0, mu = 3, size = 1.5),
        P10plus_poisson = 1 - ppois(9, 3), P10plus_nb = 1 - pnbinom(9, mu = 3, size = 1.5)), 3)

# B. Fikcyjne badanie: roczna liczba wizyt u lekarza rodzinnego u 400 dorosłych.
# Parametry ustalone ręcznie: log(średnia) = 0.9 + 0.4 × (wiek − 50)/10 + 0.6 × choroba przewlekła
#                                            − 0.06 × odległość do przychodni (km); theta = 2.
set.seed(600)                                   # ziarno ustalone raz, bez dobierania pod wynik
n <- 400
wiek <- round(runif(n, 18, 85))
przewlekla <- rbinom(n, 1, plogis(-2 + 0.06 * (wiek - 30)))      # choroba przewlekła częstsza u starszych
odleglosc <- round(rgamma(n, shape = 2, scale = 2.5), 1)          # km do przychodni
mu <- exp(0.9 + 0.4 * (wiek - 50) / 10 + 0.6 * przewlekla - 0.06 * odleglosc)
wizyty <- rnbinom(n, mu = mu, size = 2)
dane <- data.frame(wiek, przewlekla, odleglosc, wizyty)
write.csv(dane, "regresja-poissona-wizyty.csv", row.names = FALSE)
round(c(srednia = mean(wizyty), wariancja = var(wizyty), zera = sum(wizyty == 0), zera_proc = 100 * mean(wizyty == 0),
        maks = max(wizyty), przewlekla_proc = 100 * mean(przewlekla)), 2)

# Dwa modele z tymi samymi predyktorami; wiek w dekadach, wyśrodkowany na 50 latach
dane$wiek10 <- (dane$wiek - 50) / 10
m_pois <- glm(wizyty ~ wiek10 + przewlekla + odleglosc, family = poisson, data = dane)
m_nb <- glm.nb(wizyty ~ wiek10 + przewlekla + odleglosc, data = dane)
c(dyspersja_Poisson = round(sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois), 2),
  theta_NB = round(m_nb$theta, 2), SE_theta = round(m_nb$SE.theta, 2))

# Ile osób z daną liczbą wizyt przewiduje każdy model (suma prawdopodobieństw po osobach)
kk <- 0:20
obs <- table(factor(pmin(dane$wizyty, 20), levels = kk))
oczek <- data.frame(k = kk, obserwowane = as.vector(obs),
                    Poisson = sapply(kk, function(j) sum(dpois(j, fitted(m_pois)))),
                    NB = sapply(kk, function(j) sum(dnbinom(j, mu = fitted(m_nb), size = m_nb$theta))))
oczek[21, 3:4] <- c(sum(1 - ppois(19, fitted(m_pois))), sum(1 - pnbinom(19, mu = fitted(m_nb), size = m_nb$theta)))
round(oczek[c(1:6, 11, 16, 21), ], 1)          # wiersz k = 20 to „20 i więcej”

p1a <- ggplot(teoria, aes(k, p, fill = rozklad)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  scale_fill_manual(values = c(kol[["poisson"]], kol[["nb"]]), name = NULL) +
  scale_x_continuous(breaks = seq(0, 14, 2)) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(x = "Liczba zdarzeń", y = "Prawdopodobieństwo", title = "A. Ta sama średnia, inna wariancja",
       subtitle = "Więcej zer i dłuższy ogon przy nadmiernej dyspersji") + motyw
dl <- rbind(data.frame(k = kk, oczekiwane = oczek$Poisson, model = "regresja Poissona"),
            data.frame(k = kk, oczekiwane = oczek$NB, model = "regresja ujemna dwumianowa"))
p1b <- ggplot(oczek, aes(k, obserwowane)) +
  geom_col(fill = kol[["dane"]], width = 0.85) +
  geom_line(data = dl, aes(k, oczekiwane, colour = model, linetype = model), linewidth = 1) +
  geom_point(data = dl, aes(k, oczekiwane, colour = model, shape = model), size = 2.2) +
  scale_colour_manual(values = c(kol[["poisson"]], kol[["nb"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = c(seq(0, 18, 3), 20), labels = c(seq(0, 18, 3), "20+")) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = "Wizyty u lekarza rodzinnego w roku", y = "Liczba osób", title = "B. 400 osób: dane i dwa modele",
       subtitle = "Słupki – dane; linie – oczekiwane z modeli") + motyw
p1 <- p1a + p1b
p1   # zapis: ggsave("regresja-poissona-dwa-rozklady.svg", p1, width = 10, height = 5.6)
Wynik w R
     P0_poisson           P0_nb P10plus_poisson      P10plus_nb
          0.050           0.192           0.001           0.040
        srednia       wariancja            zera       zera_proc            maks
           3.80           28.21          106.00           26.50           28.00
przewlekla_proc
          38.50
dyspersja_Poisson          theta_NB          SE_theta
             2.94              1.81              0.22
    k obserwowane Poisson    NB
1   0         106    69.7 106.6
2   1          76    77.2  77.2
3   2          55    58.1  50.7
4   3          33    41.1  34.4
5   4          20    30.1  24.7
6   5          27    23.3  18.5
11 10           3     9.1   6.3
16 15           2     3.1   2.8
21 20          11     1.1  11.5
2. Regresja liniowa na zliczeniach: Rysunek 2
R
# Rysunek 2. Regresja liniowa na zliczeniach: ujemne przewidywania i lejek reszt (kontynuacja: dane, kol, motyw)
library(ggplot2)
library(patchwork)

m_lin <- lm(wizyty ~ wiek10 + przewlekla + odleglosc, data = dane)
round(coef(m_lin), 3)
dane$przew_lin <- fitted(m_lin)
dane$reszta_lin <- residuals(m_lin)
c(ujemne_przewidywania = sum(dane$przew_lin < 0), proc = round(100 * mean(dane$przew_lin < 0), 1),
  najnizsze = round(min(dane$przew_lin), 2))

# Rozrzut reszt w pięciu grupach przewidywań (kwintyle): przy zliczeniach rośnie razem ze średnią
dane$kwintyl <- cut(dane$przew_lin, quantile(dane$przew_lin, 0:5 / 5), include.lowest = TRUE, labels = 1:5)
round(do.call(rbind, lapply(split(dane, dane$kwintyl), function(d)
  c(sr_przewidywanie = mean(d$przew_lin), SD_reszt = sd(d$reszta_lin)))), 2)

# Przewidywania prostej dla osoby z przychodnią 5 km od domu: bez i z chorobą przewlekłą
siatka <- expand.grid(wiek = 18:85, przewlekla = 0:1, odleglosc = 5)
siatka$wiek10 <- (siatka$wiek - 50) / 10
siatka$przew <- predict(m_lin, siatka)
setNames(round(predict(m_lin, data.frame(wiek10 = (c(18, 25) - 50) / 10, przewlekla = 0, odleglosc = 15)), 2),
         c("wiek_18_15km", "wiek_25_15km"))   # przewidywania prostej dla osób bez choroby przewlekłej

dane$choroba <- factor(dane$przewlekla, 0:1, c("bez choroby przewlekłej", "z chorobą przewlekłą"))
siatka$choroba <- factor(siatka$przewlekla, 0:1, levels(dane$choroba))
p2a <- ggplot(dane, aes(wiek, wizyty)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = -Inf, ymax = 0, fill = kol[["nb"]], alpha = 0.1) +
  geom_point(aes(shape = choroba), position = position_jitter(width = 0, height = 0.2, seed = 600), colour = kol[["dane"]], alpha = 0.7, size = 1.6) +
  geom_line(data = siatka, aes(y = przew, linetype = choroba), colour = kol[["liniowa"]], linewidth = 1.2) +
  annotate("text", x = 86, y = -1.4, label = "przewidywanie < 0", hjust = 1, colour = kol[["nb"]], size = 3.8) +
  scale_shape_manual(values = c(1, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  coord_cartesian(ylim = c(-2, 20)) +
  guides(shape = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(x = "Wiek (lata)", y = "Wizyty w roku", title = "A. Prosta przewiduje ujemne wizyty",
       subtitle = "Linie: regresja liniowa przy 5 km do przychodni") + motyw
p2b <- ggplot(dane, aes(przew_lin, reszta_lin)) +
  annotate("rect", xmin = -Inf, xmax = 0, ymin = -Inf, ymax = Inf, fill = kol[["nb"]], alpha = 0.1) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_point(colour = kol[["dane"]], alpha = 0.7, size = 1.6) +
  geom_smooth(aes(y = abs(reszta_lin)), method = "loess", formula = y ~ x, se = FALSE,
              colour = kol[["poisson"]], linewidth = 1.1) +
  geom_smooth(aes(y = -abs(reszta_lin)), method = "loess", formula = y ~ x, se = FALSE,
              colour = kol[["poisson"]], linewidth = 1.1) +
  labs(x = "Przewidywanie prostej", y = "Reszta (obserwowane − przewidywane)",
       title = "B. Reszty rozchodzą się w lejek",
       subtitle = "Niebieskie linie: wygładzona |reszta| (w górę i w dół)") + motyw
p2 <- p2a + p2b
p2   # zapis: ggsave("regresja-poissona-prosta-i-lejek.svg", p2, width = 10, height = 5.8)
Wynik w R
(Intercept)      wiek10  przewlekla   odleglosc
      3.057       1.228       2.763      -0.111
ujemne_przewidywania                 proc            najnizsze
               59.00                14.80                -2.37
  sr_przewidywanie SD_reszt
1            -0.48     1.05
2             1.56     1.32
3             3.52     2.41
4             5.92     4.64
5             8.49     7.42
wiek_18_15km wiek_25_15km
       -2.54        -1.68
3. Krzywa w dwóch skalach: Rysunek 3
R
# Rysunek 3. Krzywa przewidywań na skali liczby wizyt i na skali logarytmu (kontynuacja: dane, m_pois, m_nb, kol, motyw)
library(ggplot2)
library(patchwork)

# Współczynniki obu modeli w skali logarytmu: te same punkty, inne błędy standardowe
round(cbind(b_Poisson = coef(m_pois), SE_Poisson = sqrt(diag(vcov(m_pois))),
            b_NB = coef(m_nb), SE_NB = sqrt(diag(vcov(m_nb)))), 3)

# Przewidywania modelu ujemnego dwumianowego z 95% CI (liczone w skali logarytmu i przekształcone exp())
siatka <- expand.grid(wiek = 18:85, przewlekla = 0:1, odleglosc = 5)
siatka$wiek10 <- (siatka$wiek - 50) / 10
pr <- predict(m_nb, siatka, type = "link", se.fit = TRUE)
siatka$log_mu <- pr$fit
siatka$dolna <- pr$fit - 1.96 * pr$se.fit
siatka$gorna <- pr$fit + 1.96 * pr$se.fit
siatka$choroba <- factor(siatka$przewlekla, 0:1, c("bez choroby przewlekłej", "z chorobą przewlekłą"))

# Przy 20, 50 i 80 latach: iloraz grup stały, różnica w liczbie wizyt rośnie
w <- siatka[siatka$wiek %in% c(20, 50, 80), ]
tab <- data.frame(wiek = c(20, 50, 80), bez = exp(w$log_mu[w$przewlekla == 0]), z = exp(w$log_mu[w$przewlekla == 1]))
tab$roznica <- tab$z - tab$bez
tab$iloraz <- tab$z / tab$bez
round(tab, 2)
nb5 <- function(w10) exp(predict(m_nb, data.frame(wiek10 = w10, przewlekla = 0, odleglosc = 5)))[[1]]
round(c(krok_20_30 = nb5(-2) - nb5(-3), krok_70_80 = nb5(3) - nb5(2)), 2)   # +10 lat: zmiana w wizytach

p3a <- ggplot(siatka, aes(wiek, exp(log_mu))) +
  geom_point(data = dane, aes(wiek, wizyty, shape = choroba), position = position_jitter(width = 0, height = 0.2, seed = 600),
              colour = kol[["dane"]], alpha = 0.5, size = 1.4, inherit.aes = FALSE) +
  geom_ribbon(aes(ymin = exp(dolna), ymax = exp(gorna), fill = choroba), alpha = 0.2) +
  geom_line(aes(colour = choroba, linetype = choroba), linewidth = 1.2) +
  scale_colour_manual(values = c(kol[["poisson"]], kol[["nb"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["poisson"]], kol[["nb"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_shape_manual(values = c(1, 17), name = NULL) +
  coord_cartesian(ylim = c(0, 20)) +
  guides(colour = guide_legend(ncol = 1), shape = "none") +
  labs(x = "Wiek (lata)", y = "Oczekiwana liczba wizyt w roku", title = "A. Skala wyniku: krzywe się rozchodzą",
       subtitle = "Punkty – osoby; pasma – 95% CI; 5 km do przychodni") + motyw
p3b <- ggplot(siatka, aes(wiek, log_mu)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna, fill = choroba), alpha = 0.2) +
  geom_line(aes(colour = choroba, linetype = choroba), linewidth = 1.2) +
  scale_colour_manual(values = c(kol[["poisson"]], kol[["nb"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["poisson"]], kol[["nb"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_y_continuous(sec.axis = sec_axis(~ exp(.), breaks = c(0.5, 1, 2, 4, 8, 16), name = "Ta sama oś w wizytach")) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = "Wiek (lata)", y = "log(oczekiwanej liczby wizyt)", title = "B. Skala logarytmu: proste równoległe",
       subtitle = "Odstęp między prostymi = log IRR choroby") + motyw
p3 <- (p3a + p3b) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3   # zapis: ggsave("regresja-poissona-krzywa-i-log.svg", p3, width = 10, height = 5.8)
Wynik w R
            b_Poisson SE_Poisson   b_NB SE_NB
(Intercept)     0.718      0.062  0.694 0.101
wiek10          0.388      0.019  0.420 0.032
przewlekla      0.649      0.064  0.638 0.113
odleglosc      -0.026      0.008 -0.027 0.015
  wiek  bez     z roznica iloraz
1   20 0.50  0.94    0.44   1.89
2   50 1.75  3.32    1.56   1.89
3   80 6.18 11.69    5.51   1.89
krok_20_30 krok_70_80
      0.26       2.12
4. Symulacja 1000 badań: Rysunek 4
R
# Rysunek 4. 1000 badań: pokrycie 95% przedziałów dla IRR przy rosnącej nadmiernej dyspersji (kontynuacja: kol, motyw)
library(ggplot2)
library(patchwork)
library(MASS)

# Jedno badanie: dwie grupy po 100 osób, w grupie porównawczej średnio 2 zdarzenia, prawdziwy IRR = 1.5.
# theta = Inf to dane z rozkładu Poissona; im mniejsze theta, tym większa nadmierna dyspersja.
# Parametry (n, średnia, IRR, wartości theta) ustalone ręcznie.
IRR <- 1.5
badanie <- function(theta, n = 100) {
  grupa <- rep(0:1, each = n)
  mu <- 2 * IRR^grupa
  y <- if (is.infinite(theta)) rpois(2 * n, mu) else rnbinom(2 * n, mu = mu, size = theta)
  mp <- glm(y ~ grupa, family = poisson)
  phi <- sum(residuals(mp, type = "pearson")^2) / df.residual(mp)          # współczynnik dyspersji
  mn <- suppressWarnings(glm.nb(y ~ grupa))      # przy danych Poissona theta dąży do nieskończoności
  b <- c(coef(mp)[["grupa"]], coef(mp)[["grupa"]], coef(mn)[["grupa"]])
  se <- c(sqrt(vcov(mp)["grupa", "grupa"]), sqrt(phi * vcov(mp)["grupa", "grupa"]), sqrt(vcov(mn)["grupa", "grupa"]))
  data.frame(model = c("Poisson", "quasi-Poisson", "ujemny dwumianowy"), theta, phi,
             dolna = exp(b - 1.96 * se), gorna = exp(b + 1.96 * se))
}
set.seed(600)                                   # ziarno ustalone raz, bez dobierania pod wynik
R <- 1000
thety <- c(Inf, 5, 2, 1, 0.5)
sym <- do.call(rbind, lapply(thety, function(th)
  do.call(rbind, lapply(1:R, function(r) cbind(badanie(th), nr = r)))))
sym$trafia <- sym$dolna <= IRR & sym$gorna >= IRR

# Pokrycie (odsetek przedziałów zawierających 1.5) z błędem Monte Carlo
pokrycie <- aggregate(trafia ~ model + theta, data = sym, FUN = mean)
pokrycie$proc <- 100 * pokrycie$trafia
pokrycie$blad_MC <- 100 * sqrt(pokrycie$trafia * (1 - pokrycie$trafia) / R)
pokrycie$wariancja_do_sredniej <- with(pokrycie, ifelse(is.infinite(theta), 1, 1 + 2.5 / theta))  # przy średniej 2.5
print(pokrycie[order(pokrycie$model, -pokrycie$theta), c("model", "theta", "wariancja_do_sredniej", "proc", "blad_MC")],
      row.names = FALSE, digits = 3)
round(tapply(sym$phi[sym$model == "Poisson"], sym$theta[sym$model == "Poisson"], median), 2)  # mediana phi

# A. Pierwsze 40 badań przy theta = 1: przedziały Poissona i ujemnego dwumianowego
a <- subset(sym, theta == 1 & nr <= 40 & model != "quasi-Poisson")
a$wynik <- factor(ifelse(a$trafia, "obejmuje 1.5", "chybia 1.5"), c("obejmuje 1.5", "chybia 1.5"))
table(a$model, a$wynik)
p4a <- ggplot(a, aes(y = nr, xmin = dolna, xmax = gorna, colour = wynik)) +
  geom_vline(xintercept = IRR, colour = "grey30") +
  geom_errorbar(width = 0, linewidth = 0.8, orientation = "y") +
  geom_point(aes(x = sqrt(dolna * gorna), shape = wynik), size = 1.7) +
  facet_wrap(~ model, ncol = 2) +
  scale_colour_manual(values = c(kol[["dane"]], kol[["nb"]]), name = NULL, drop = FALSE) +
  scale_shape_manual(values = c(16, 4), name = NULL, drop = FALSE) +
  scale_x_log10(breaks = c(0.75, 1, 1.5, 2, 3)) +
  labs(x = "IRR z 95% CI (oś logarytmiczna)", y = "Badanie nr",
       title = "A. 40 badań przy theta = 1", subtitle = "Pionowa linia: prawdziwy IRR = 1.5") + motyw
p4b <- ggplot(pokrycie, aes(factor(wariancja_do_sredniej), proc, colour = model, shape = model, group = model)) +
  geom_hline(yintercept = 95, linetype = "dashed", colour = "grey40") +
  geom_line(linewidth = 0.9, position = position_dodge(width = 0.3)) +
  geom_pointrange(aes(ymin = proc - 1.96 * blad_MC, ymax = proc + 1.96 * blad_MC),
                  position = position_dodge(width = 0.3), size = 0.5) +
  scale_colour_manual(values = c(kol[["poisson"]], kol[["ciemny"]], kol[["nb"]]), name = NULL) +
  scale_shape_manual(values = c(16, 15, 17), name = NULL) +
  scale_y_continuous(limits = c(30, 100), breaks = seq(30, 100, 10)) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = "Wariancja / średnia w danych (1 = Poisson)", y = "Pokrycie 95% CI (%)",
       title = "B. Pokrycie w 1000 badaniach", subtitle = "Wąsy: ±1.96 błędu Monte Carlo") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1.15, 1))
p4   # zapis: ggsave("regresja-poissona-tysiac-badan.svg", p4, width = 10, height = 6.4)
Wynik w R
             model theta wariancja_do_sredniej proc blad_MC
           Poisson   Inf                  1.00 94.6   0.715
           Poisson   5.0                  1.50 89.2   0.982
           Poisson   2.0                  2.25 80.8   1.246
           Poisson   1.0                  3.50 71.4   1.429
           Poisson   0.5                  6.00 58.5   1.558
     quasi-Poisson   Inf                  1.00 94.5   0.721
     quasi-Poisson   5.0                  1.50 94.8   0.702
     quasi-Poisson   2.0                  2.25 95.8   0.634
     quasi-Poisson   1.0                  3.50 95.2   0.676
     quasi-Poisson   0.5                  6.00 95.0   0.689
 ujemny dwumianowy   Inf                  1.00 95.1   0.683
 ujemny dwumianowy   5.0                  1.50 94.3   0.733
 ujemny dwumianowy   2.0                  2.25 95.2   0.676
 ujemny dwumianowy   1.0                  3.50 95.2   0.676
 ujemny dwumianowy   0.5                  6.00 94.4   0.727
 0.5    1    2    5  Inf
5.74 3.41 2.22 1.48 0.99

                    obejmuje 1.5 chybia 1.5
  Poisson                     29         11
  ujemny dwumianowy           36          4
5. IRR na osi logarytmicznej i liniowej: Rysunek 5
R
# Rysunek 5. IRR na wykresie: oś logarytmiczna a liniowa (kontynuacja: m_pois, m_nb, kol, motyw)
library(ggplot2)
library(patchwork)

# IRR = exp(b) z 95% przedziałem Walda; odległość przeliczona na 5 km (exp(5 × b))
skala <- c(wiek10 = 1, przewlekla = 1, odleglosc = 5)
irr <- function(m, nazwa) {
  b <- coef(m)[names(skala)] * skala
  se <- sqrt(diag(vcov(m)))[names(skala)] * skala
  data.frame(model = nazwa, predyktor = c("wiek (+10 lat)", "choroba przewlekła (tak vs nie)", "odległość (+5 km)"),
             IRR = exp(b), dolna = exp(b - 1.96 * se), gorna = exp(b + 1.96 * se), p = 2 * pnorm(-abs(b / se)))
}
tab <- rbind(irr(m_pois, "Poisson"), irr(m_nb, "ujemny dwumianowy"))
print(cbind(tab[, 1:2], round(tab[, 3:6], 3)), row.names = FALSE)
# Zmiana procentowa (IRR − 1) × 100 i długość ramion przedziału na osi liniowej (model ujemny dwumianowy)
nb <- subset(tab, model == "ujemny dwumianowy")
data.frame(predyktor = nb$predyktor, zmiana_proc = round(100 * (nb$IRR - 1), 1),
           ramie_lewe = round(nb$IRR - nb$dolna, 3), ramie_prawe = round(nb$gorna - nb$IRR, 3))

tab$predyktor <- factor(tab$predyktor, rev(unique(tab$predyktor)))
p5a <- ggplot(tab, aes(IRR, predyktor, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey30") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, linewidth = 0.9, orientation = "y",
                position = position_dodge(width = 0.5)) +
  geom_point(size = 2.6, position = position_dodge(width = 0.5)) +
  scale_x_log10(breaks = c(0.5, 0.75, 1, 1.5, 2, 3), limits = c(0.5, 3)) +
  scale_colour_manual(values = c(kol[["poisson"]], kol[["nb"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "IRR z 95% CI (oś logarytmiczna)", y = NULL, title = "A. Oś logarytmiczna",
       subtitle = "0.5 i 2 leżą w tej samej odległości od 1") + motyw
nb$predyktor <- factor(nb$predyktor, levels(tab$predyktor))
p5b <- ggplot(nb, aes(IRR, predyktor)) +
  geom_vline(xintercept = 1, colour = "grey30") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, linewidth = 0.9, orientation = "y", colour = kol[["nb"]]) +
  geom_point(size = 2.6, shape = 17, colour = kol[["nb"]]) +
  geom_text(aes(label = sprintf("%.2f [%.2f, %.2f]", IRR, dolna, gorna)), vjust = -1.1, size = 3.6, colour = "grey20") +
  scale_x_continuous(breaks = seq(0.5, 3, 0.5), limits = c(0.5, 3)) +
  labs(x = "IRR z 95% CI (oś liniowa)", y = NULL, title = "B. Oś liniowa: przedziały niesymetryczne",
       subtitle = "Model ujemny dwumianowy; prawe ramię dłuższe niż lewe") + motyw
p5 <- p5a / p5b
p5   # zapis: ggsave("regresja-poissona-irr-na-osi.svg", p5, width = 9, height = 8.4)
Wynik w R
             model                       predyktor   IRR dolna gorna     p
           Poisson                  wiek (+10 lat) 1.474 1.421 1.530 0.000
           Poisson choroba przewlekła (tak vs nie) 1.914 1.689 2.168 0.000
           Poisson               odległość (+5 km) 0.880 0.814 0.952 0.001
 ujemny dwumianowy                  wiek (+10 lat) 1.522 1.428 1.622 0.000
 ujemny dwumianowy choroba przewlekła (tak vs nie) 1.892 1.517 2.360 0.000
 ujemny dwumianowy               odległość (+5 km) 0.875 0.759 1.010 0.068
                        predyktor zmiana_proc ramie_lewe ramie_prawe
1                  wiek (+10 lat)        52.2      0.094       0.100
2 choroba przewlekła (tak vs nie)        89.2      0.375       0.468
3               odległość (+5 km)       -12.5      0.117       0.134
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (Poisson / ujemny dwumianowy; bez / z chorobą)" = c("#0072B2", "#D55E00"),
             "niebieski – ciemnoszary (Poisson / quasi-Poisson)" = c("#0072B2", "#333333"),
             "ciemnoszary – cynober (quasi-Poisson / ujemny dwumianowy)" = c("#333333", "#D55E00"),
             "szary – cynober (obejmuje / chybia; słupki / model)" = c("#999999", "#D55E00"),
             "pomarańczowy – niebieski (prosta MNK / wygładzone reszty)" = c("#E69F00", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                   widzenie_typowe
niebieski – cynober (Poisson / ujemny dwumianowy; bez / z chorobą)           114.6
niebieski – ciemnoszary (Poisson / quasi-Poisson)                             48.3
ciemnoszary – cynober (quasi-Poisson / ujemny dwumianowy)                     83.4
szary – cynober (obejmuje / chybia; słupki / model)                           77.2
pomarańczowy – niebieski (prosta MNK / wygładzone reszty)                    120.2
czerwony – zielony (do unikania)                                             121.7
                                                                   deuteranopia
niebieski – cynober (Poisson / ujemny dwumianowy; bez / z chorobą)        108.3
niebieski – ciemnoszary (Poisson / quasi-Poisson)                          50.3
ciemnoszary – cynober (quasi-Poisson / ujemny dwumianowy)                  72.7
szary – cynober (obejmuje / chybia; słupki / model)                        62.9
pomarańczowy – niebieski (prosta MNK / wygładzone reszty)                 121.5
czerwony – zielony (do unikania)                                           21.1
                                                                   protanopia
niebieski – cynober (Poisson / ujemny dwumianowy; bez / z chorobą)       91.9
niebieski – ciemnoszary (Poisson / quasi-Poisson)                        47.4
ciemnoszary – cynober (quasi-Poisson / ujemny dwumianowy)                59.9
szary – cynober (obejmuje / chybia; słupki / model)                      56.0
pomarańczowy – niebieski (prosta MNK / wygładzone reszty)               109.3
czerwony – zielony (do unikania)                                         31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, modele lm() i glm() – pakiet stats). Regresję ujemną dwumianową oszacowano funkcją glm.nb() z pakietu MASS. Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Regresja liniowa na liczbie zdarzeń bez sprawdzenia, ile przewidywań jest ujemnych i czy reszty tworzą lejek (rysunek 2).
- Logarytmowanie wyniku z dodaniem 1 zamiast modelu dla zliczeń (O’Hara i Kotze, 2010).
- Model Poissona bez sprawdzenia dyspersji. Przy wariancji 3.5 razy większej od średniej pokrycie 95% przedziałów spadło do 71.4% (rysunek 4).
- „IRR = 1.89, czyli o 1.89 wizyty więcej”. IRR to mnożnik, a nie różnica (rysunki 3 i 5).
- Rozchodzące się krzywe opisane jako interakcja, choć w modelu jej nie ma (rysunek 3).
Modele z nadmiarem zer opisuje wpis o regresji dla zliczeń, a przedział dla IRR można też policzyć metodą bootstrap – zob. bootstrap – wizualizacja na obrazkach.
Najczęstsze pytania
Dlaczego regresja liniowa nie pasuje do liczby zdarzeń?
Prosta nie zna dolnej granicy zera i zakłada stały rozrzut. W przykładzie z liczbą wizyt u lekarza przewidziała wartość ujemną dla 59 z 400 osób (14.8%), a odchylenie standardowe reszt rosło od 1.05 do 7.42 wraz z przewidywaniem. Przy niskich średnich, zwykle poniżej 10, zwykła regresja może dawać obciążone wyniki (Coxe i in., 2009).
Co się dzieje z przedziałami ufności w regresji Poissona przy nadmiernej dyspersji?
Są za wąskie. W symulacji 1000 badań na prawdziwy IRR = 1.5 trafiało 94.6% przedziałów Poissona, gdy dane pochodziły z rozkładu Poissona. Przy wariancji 3.5 razy większej od średniej było to już 71.4%, a przy 6 razy większej – 58.5%. Quasi-Poisson i model ujemny dwumianowy dawały pokrycie od 94.3% do 95.8%.
Dlaczego krzywe regresji Poissona dla dwóch grup się rozchodzą, choć nie ma interakcji?
Bo model jest liniowy w skali logarytmu, a efekt działa jako mnożnik. W przykładzie choroba przewlekła mnożyła liczbę wizyt przez 1.89 w każdym wieku. Różnica w wizytach rosła jednak z 0.44 u 20-latków do 5.51 u 80-latków. W skali logarytmu te same przewidywania tworzą równoległe proste.
Jak narysować IRR z regresji Poissona?
Na osi logarytmicznej z linią przy IRR = 1. Wtedy przedziały są symetryczne, a IRR = 0.5 i IRR = 2 leżą w tej samej odległości od 1. Na osi liniowej prawe ramię przedziału jest dłuższe: dla IRR = 1.89, 95% CI [1.52, 2.36] lewe ramię ma 0.375, a prawe 0.468. Obok IRR podaj przewidywane liczby zdarzeń dla kilku profili.
Czy wybrać quasi-Poissona czy regresję ujemną dwumianową?
Oba modele poprawiają przedziały przy nadmiernej dyspersji, ale inaczej wiążą wariancję ze średnią: quasi-Poisson liniowo, model ujemny dwumianowy kwadratowo. Dlatego przy wielu predyktorach mogą dawać wyraźnie różne efekty (Ver Hoef i Boveng, 2007). Wybór uzasadnij dopasowaniem rozkładu, np. liczbą przewidywanych zer, i wpisz do planu analizy.
Powiązane hasła
Przeczytaj też
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikRegresja Poissona i ujemna dwumianowa w SPSS
Generalized Linear Models od pliku .sav po opis APA: offset, Value/df i nadmierna dyspersja, IRR z exp(B), szacowany parametr k i składnia GENLIN – na fikcyjnych danych o nieobecnościach.
Czytaj →PoradnikRegresja Poissona i ujemna dwumianowa w jamovi (GAMLj)
Moduł GAMLj w jamovi: modele dla zliczeń, Chi-squared/DF jako sygnał nadmiernej dyspersji, Exp(B) jako IRR, średnie brzegowe, offset i różnice wobec SPSS.
Czytaj →PoradnikRegresja logistyczna w obrazkach
Prosta MNK na 0/1, krzywa S, logit a prawdopodobieństwo, interakcja w dwóch skalach i separacja – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikLiczba zakupów: zliczenia z zerami
2000 kont sklepu dla zwierząt: Poisson, NB, ZINB i hurdle, rootogram, wagi Akaikego, offset i co naprawdę zmienia karta stałego klienta – z kodem R.
Czytaj →Masz w pracy liczbę zdarzeń jako wynik?
Pomożemy dobrać model dla zliczeń, sprawdzić nadmierną dyspersję, przygotować wykresy IRR i przewidywanych liczb oraz opisać wyniki tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Coxe, S., West, S. G., & Aiken, L. S. (2009). The analysis of count data: A gentle introduction to Poisson regression and its alternatives. Journal of Personality Assessment, 91(2), 121–136. https://doi.org/10.1080/00223890802634175
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Kleiber, C., & Zeileis, A. (2016). Visualizing count data regressions using rootograms. The American Statistician, 70(3), 296–303. https://doi.org/10.1080/00031305.2016.1173590 ● Otwarty dostęp: pełny tekst
- O’Hara, R. B., & Kotze, D. J. (2010). Do not log-transform count data. Methods in Ecology and Evolution, 1(2), 118–122. https://doi.org/10.1111/j.2041-210x.2010.00021.x
- Ver Hoef, J. M., & Boveng, P. L. (2007). Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data? Ecology, 88(11), 2766–2772. https://doi.org/10.1890/07-0043.1
Cytowania BibTeX
@article{coxe2009analysis, author={Coxe, Stefany and West, Stephen G. and Aiken, Leona S.}, title={{The analysis of count data: A gentle introduction to Poisson regression and its alternatives}}, journal={Journal of Personality Assessment}, year={2009}, volume={91}, number={2}, pages={121--136}, doi={10.1080/00223890802634175}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{kleiber2016visualizing, author={Kleiber, Christian and Zeileis, Achim}, title={{Visualizing count data regressions using rootograms}}, journal={The American Statistician}, year={2016}, volume={70}, number={3}, pages={296--303}, doi={10.1080/00031305.2016.1173590}}@article{ohara2010do, author={O'Hara, Robert B. and Kotze, D. Johan}, title={{Do not log-transform count data}}, journal={Methods in Ecology and Evolution}, year={2010}, volume={1}, number={2}, pages={118--122}, doi={10.1111/j.2041-210x.2010.00021.x}}@article{verhoef2007quasi, author={Ver Hoef, Jay M. and Boveng, Peter L.}, title={{Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data?}}, journal={Ecology}, year={2007}, volume={88}, number={11}, pages={2766--2772}, doi={10.1890/07-0043.1}}