Regresja Poissona w jamovi: moduł GAMLj
Liczba wizyt, nieobecności czy błędów to zliczenia. Przy niskiej średniej zwykła regresja liniowa może dawać dla nich obciążone wyniki (Coxe i in., 2009). Do ich analizy służy regresja Poissona, a przy nadmiernym rozrzucie regresja ujemna dwumianowa. Teorię, offset i modele z nadmiarem zer omawia poradnik regresja dla zliczeń krok po kroku. Tutaj zajmujemy się tylko tym, gdzie te modele są w jamovi i jak czytać tabele.
Podstawowe menu jamovi nie ma modeli dla zliczeń. Daje je moduł GAMLj, który w bibliotece modułów nazywa się General Analyses for Linear Models (v3). Instalujesz go przyciskiem Modules → jamovi library i jest dostępny od razu, bez ponownego uruchamiania programu (The jamovi project, b.d.). Ten sam moduł opisujemy we wpisie model mieszany w jamovi, a pierwsze kroki w programie – we wpisie jamovi krok po kroku.
Opisujemy wersję 3.7.2 modułu (Gallucci, b.d.-b). Strony pomocy GAMLj dotyczą starszych wersji: strona modułu podaje 1.6.0, a strona techniczna 2.5.0 (Gallucci, b.d.-a). Dlatego nazwy menu, opcji i tabel wzięliśmy z plików definicji analizy i kodu modułu w repozytorium. W polskiej wersji interfejsu mogą brzmieć inaczej. Samego modułu nie uruchamialiśmy. Liczby policzyliśmy w R tymi samymi funkcjami, których GAMLj używa wewnętrznie.
Przykład i pliki do pobrania
Dane są fikcyjne. 240 osób studiujących (po 80 z pierwszego, drugiego i trzeciego roku) podało, ile razy w semestrze przyszło na konsultacje do prowadzących i ile godzin tygodniowo pracuje zarobkowo. Pytanie: czy liczba wizyt zależy od roku studiów i pracy? Semestr trwał dla wszystkich tyle samo, więc offset nie jest potrzebny. Do offsetu wrócimy niżej, bo w GAMLj ma on swoją pułapkę.
Pobierz plik CSV albo plik .sav z etykietami. Kolumny to id, rok (1–3), praca (godziny w tygodniu) i konsultacje. Ziarno losowania wybraliśmy spośród kilku tysięcy tak, żeby przykład dobrze pokazywał skutki nadmiernej dyspersji.
Średnia liczba wizyt wynosi 1.48, a wariancja 3.97. Bez żadnej wizyty jest 94 osoby (39.2%), maksimum to 14. Średnie maleją z rokiem studiów: 1.975, 1.413 i 1.062. W jamovi ustaw rok jako Nominal, a praca i konsultacje jako Continuous (zob. przygotowanie danych w jamovi). Zmienna zależna musi zawierać liczby całkowite nieujemne.
Okno Generalized Linear Model krok po kroku
- Linear Models → GAMLj3 → Generalized Linear Model (Gallucci, b.d.-b). Na górze okna, w grupie Frequencies, są trzy modele: Poisson, Poisson (overdispersion) i Negative Binomial. Zacznij od Poisson.
konsultacjeprzeciągnij do Dependent Variable,rokdo Factors, apracado Covariates. Sprawdź, czy w polu Model Terms są oba predyktory (Gallucci, b.d.-b).- Factors Coding – zostaw domyślne simple. Każdy poziom jest porównywany z pierwszym, a kody są wyśrodkowane (Gallucci, b.d.-a). Kategorią odniesienia jest więc pierwszy rok, czyli pierwszy poziom zmiennej.
- Covariates Scaling – domyślnie Centered. Godziny pracy są mierzone od średniej (11.43 h). Nachylenie się nie zmienia, zmienia się tylko znaczenie wyrazu wolnego.
- Przedziały ufności – opcja For exp(B) jest w definicji modułu domyślnie zaznaczona, a For estimates nie. CI Method to domyślnie Standard, czyli przedziały Walda (Gallucci, b.d.-a, b.d.-b).
- Estimated Marginal Means – przenieś
rok.
Liczby policzono w R tymi samymi funkcjami co GAMLj; układ kolumn jak w definicji tabel GAMLj. Model Poisson to glm z rodziną poisson, a Negative Binomial to MASS::glm.nb (Gallucci, b.d.-b).
Model Fit i Additional indices: najpierw dyspersja
W grupie Model Results GAMLj pokazuje dwie tabele dopasowania. Model Fit zawiera R², poprawione R² i test modelu wobec modelu z samym wyrazem wolnym. Additional indices to kolumny Info, Model Value i Comment (Gallucci, b.d.-b).
| Info | Model Value | Comment |
|---|---|---|
| LogLikelihood | −433.689 | |
| AIC | 875.377 | Less is better |
| BIC | 889.300 | Less is better |
| Deviance | 490.346 | Less is better |
| Residual DF | 236 | |
| Chi-squared/DF | 2.231 | Overdispersion indicator |
Najważniejszy jest ostatni wiersz. To suma kwadratów reszt Pearsona podzielona przez resztowe stopnie swobody (Gallucci, b.d.-b). W modelu Poissona powinna być bliska 1. Tu wynosi 2.23: zliczenia rozrzucają się ponad dwa razy bardziej, niż zakłada model. To nadmierna dyspersja. Błędy standardowe są wtedy za małe, a wartości p za niskie (Gardner i in., 1995).
Strona techniczna GAMLj podaje, że nadmierną dyspersję sygnalizują wartości „zwykle > 3” (Gallucci, b.d.-a). Nie traktuj tego jak progu. Już 2.23 oznacza błędy standardowe zaniżone mniej więcej 1.49 raza (√2.231). Rysunek 1 pokazuje ten sam problem na rozkładzie: model Poissona przewiduje 63 osoby bez wizyty, a było ich 94.
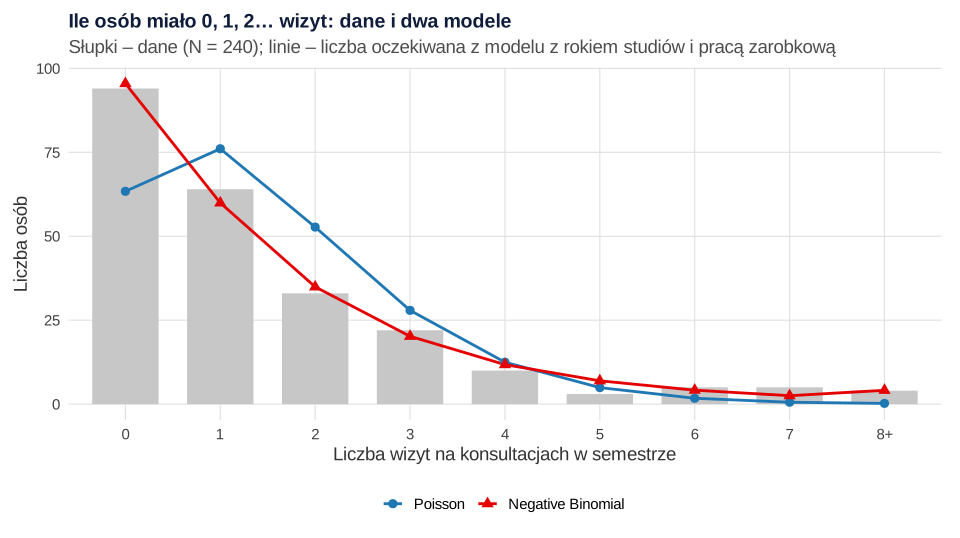
Tabela Model Fit modelu Poissona: R² = .100, Adj. R² = .095, X²(3) = 54.60, p < .001. GAMLj liczy R² jako 1 − dewiancja modelu / dewiancja modelu zerowego i nazywa go R² McFaddena (Gallucci, b.d.-a). To jedna z miar pseudo-R², a nie odsetek wyjaśnionej wariancji. X² to test ilorazu wiarygodności. Przy nadmiernej dyspersji też jest zbyt optymistyczny.
Omnibus tests i Parameter Estimates w modelu Poissona
Tabela Omnibus tests testuje każdy predyktor jako całość, np. rok studiów z dwoma stopniami swobody. GAMLj liczy ją funkcją car::Anova jako test ilorazu wiarygodności typu III (Gallucci, b.d.-b). W modelu Poissona: rok X²(2) = 19.98, p < .001; praca X²(1) = 31.92, p < .001.
| Efekt | Estimate | SE | Exp(B) | Lower | Upper | z | p |
|---|---|---|---|---|---|---|---|
| (Intercept) | 0.315 | 0.057 | 1.370 | 1.224 | 1.532 | 5.493 | < .001 |
| rok: 2. rok − 1. rok | −0.326 | 0.123 | 0.722 | 0.567 | 0.919 | −2.647 | .008 |
| rok: 3. rok − 1. rok | −0.580 | 0.135 | 0.560 | 0.430 | 0.729 | −4.311 | < .001 |
| praca | −0.030 | 0.005 | 0.970 | 0.960 | 0.981 | −5.491 | < .001 |
Estimate jest w skali logarytmu liczby wizyt. Do pracy przepisz Exp(B), czyli iloraz częstości (IRR). Model z rodziną Poissona GAMLj opisuje w Model Info jako Poisson Model z łączem log i dopiskiem, że współczynniki są w skali log(y) (Gallucci, b.d.-b). Lower i Upper obok Exp(B) to przedział Walda dla IRR. Przy kodowaniu simple i modelu bez interakcji IRR dla roku jest taki sam jak przy zwykłym kodowaniu zero-jedynkowym. Inny jest tylko wyraz wolny: exp(0.315) = 1.37 to średnia geometryczna oczekiwanych liczb wizyt trzech roczników przy średniej liczbie godzin pracy.
Na pierwszy rzut oka wszystko jest istotne. Osoby z drugiego roku przychodzą rzadziej niż z pierwszego (IRR = 0.72, p = .008). Każda godzina pracy obniża oczekiwaną liczbę wizyt o 3%. Przy dyspersji 2.23 te p są jednak za małe. Wyróżniony wiersz to pułapka.
Poisson (overdispersion) czy Negative Binomial?
GAMLj daje dwie poprawki – w tym samym oknie zmień tylko model:
- Poisson (overdispersion) to model quasi-Poissona (estymacja quasi-największej wiarygodności) (Gallucci, b.d.-a). Współczynniki zostają te same, a błędy standardowe mnożą się przez √2.231 = 1.494. SE dla drugiego roku rośnie z 0.123 do 0.184, a p w R – z .008 do .078. Quasi-Poisson nie ma funkcji wiarygodności, więc nie porównasz go z innymi modelami przez AIC.
- Negative Binomial szacuje dodatkowy parametr rozrzutu metodą największej wiarygodności (
MASS::glm.nb). Model dodaje składnik losowy, który odpowiada za niewyjaśnione różnice między osobami (Gardner i in., 1995). W R θ = 1.258 (SE = 0.249). Wiersza z θ nie znaleźliśmy w definicjach tabel GAMLj.
Oba modele często dają podobne wnioski. Mogą się jednak różnić, bo quasi-Poisson zakłada wariancję liniowo zależną od średniej, a model ujemny dwumianowy – kwadratowo. Inaczej ważą więc małe i duże zliczenia (Ver Hoef i Boveng, 2007). Model ujemny dwumianowy ma funkcję wiarygodności, więc go porównasz. W Additional indices AIC spada z 875.4 do 791.2. Podwojona różnica log-wiarygodności to 86.20. Chi-squared/DF wynosi teraz 1.026, a model dobrze odtwarza rozkład (rysunek 1).
| Efekt | Estimate | SE | Exp(B) | Lower | Upper | z | p |
|---|---|---|---|---|---|---|---|
| (Intercept) | 0.319 | 0.081 | 1.376 | 1.174 | 1.612 | 3.936 | < .001 |
| rok: 2. rok − 1. rok | −0.282 | 0.189 | 0.755 | 0.521 | 1.093 | −1.489 | .136 |
| rok: 3. rok − 1. rok | −0.559 | 0.197 | 0.572 | 0.389 | 0.842 | −2.831 | .005 |
| praca | −0.028 | 0.008 | 0.972 | 0.957 | 0.987 | −3.603 | < .001 |
Błędy standardowe wzrosły około 1.5 raza. Różnica między pierwszym a drugim rokiem przestała być istotna (IRR = 0.76, 95% CI [0.52, 1.09], p = .136). Trzeci rok przychodzi o około 43% rzadziej niż pierwszy (IRR = 0.57, 95% CI [0.39, 0.84]). Test omnibus roku: X²(2) = 8.14, p = .017, a pracy: X²(1) = 13.47, p < .001. IRR dla jednej godziny (0.972) jest mało czytelne. W opisie przelicz go na 10 godzin: exp(10 × B) = 0.754, 95% CI [0.647, 0.879], czyli o około 25% mniej wizyt. Model Fit: R² = .087, X²(3) = 22.33, p < .001.
Jeśli zer jest więcej, niż przewiduje nawet model ujemny dwumianowy, potrzebny jest model z nadmiarem zer. Takiego modelu nie ma na liście modeli w oknie Generalized Linear Model (Gallucci, b.d.-b) – wtedy przejdź do R, jak w poradniku o regresji dla zliczeń.
Średnie brzegowe: oczekiwana liczba wizyt
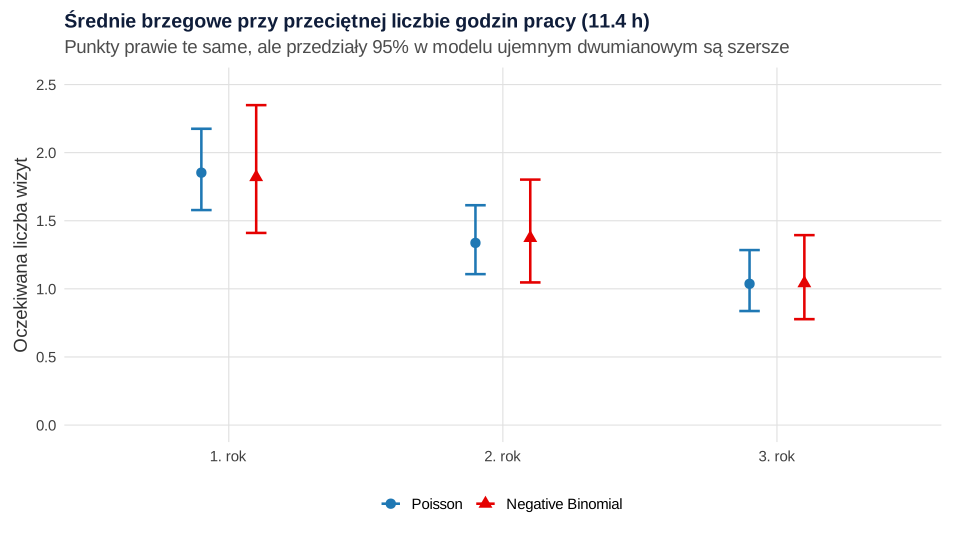
Średnie brzegowe w GAMLj liczy pakiet emmeans w skali odpowiedzi, czyli jako oczekiwaną liczbę zdarzeń (Gallucci, b.d.-b). Tabela Estimate Marginal Means – rok ma kolumny Mean, SE, Lower i Upper. Godziny pracy są ustawione na średniej, bo kowarianta jest wyśrodkowana.
| rok | Mean | SE | Lower | Upper |
|---|---|---|---|---|
| 1. rok | 1.820 | 0.237 | 1.411 | 2.349 |
| 2. rok | 1.374 | 0.190 | 1.047 | 1.802 |
| 3. rok | 1.041 | 0.155 | 0.777 | 1.394 |
Przedziały są niesymetryczne, bo emmeans liczy je w skali logarytmu i przelicza na liczby wizyt. Iloraz średnich daje IRR z tabeli współczynników: 1.041 / 1.820 = 0.572. Rysunek 2 porównuje średnie z obu modeli. Punkty są prawie takie same, a różnią się szerokością przedziałów. Podobny wykres dają opcje wykresu z rok na Horizontal axis.
Offset w GAMLj: sprawdź swoją wersję
Gdy osoby były obserwowane przez różny czas, model potrzebuje offsetu. Strona pomocy GAMLj opisuje pole Offset: zmienna wchodzi do modelu ze współczynnikiem ustalonym na 1 (Gallucci, b.d.-a). W kodzie wersji 3.7.2 są jednak dwa szczegóły (Gallucci, b.d.-b):
- Pole Offset jest aktywne tylko przy modelu Logistic. Tak jest w definicji okna w wersjach 3.3.8, 3.6.7, 3.7.0 i 3.7.2. Przy Poisson i Negative Binomial pole jest więc nieaktywne. Nie wiemy, czy to zamierzone.
- Zmienna offsetu nie jest logarytmowana. GAMLj dodaje do formuły
offset(zmienna)bez przekształcenia. Przy łączu logarytmicznym trzeba więc podać logarytm czasu obserwacji, np. utworzony przez Compute.
Jeśli w Twojej wersji pole przy modelu Poisson jest nieaktywne, model z offsetem policz w R albo w SPSS – oba warianty pokazują poradniki podlinkowane wyżej. Nie zastępuj offsetu predyktorem z log(czasu). Wtedy jego współczynnik jest szacowany, a nie ustalony na 1, i model opisuje co innego.
GAMLj a Generalized Linear Models w SPSS
Te same modele w SPSS opisuje wpis regresja Poissona i ujemna dwumianowa w SPSS. Różnice:
- Kategoria odniesienia. SPSS domyślnie porównuje z ostatnią kategorią, GAMLj z pierwszą. IRR dla tej samej pary kategorii będzie w jednym programie odwrotnością drugiego.
- Model ujemny dwumianowy. W SPSS opcja Negative binomial with log link ustala parametr dyspersji na 1 i trzeba go szacować przez Custom. GAMLj zawsze go szacuje.
- Dyspersja. SPSS pokazuje Value/df dla dewiancji i statystyki Pearsona. GAMLj pokazuje tylko wersję Pearsona (Chi-squared/DF). Wersję z dewiancji policzysz z wierszy Deviance i Residual DF: 490.346 / 236 = 2.08.
- Testy predyktorów. We wpisie o SPSS tabela Tests of Model Effects podaje test Walda. GAMLj w Omnibus tests stosuje test ilorazu wiarygodności, więc liczby nieco się różnią.
- Offset. W SPSS działa przy rozkładzie Poissona. W GAMLj 3.7.2 tylko przy modelu logistycznym (zob. wyżej).
- Błędy odporne. Oba programy je mają: w GAMLj to SE Method → Robust (HC0–HC3) (Gallucci, b.d.-b).
Zapis wyników w stylu APA
W Metodzie podaj program i moduł z wersją, model, sposób sprawdzenia dyspersji i kategorię odniesienia. IRR raportuj z 95% CI. Wzór do dostosowania:
Zdania do innych analiz przygotuje generator opisu wyników APA.
Te same liczby w R (glm, MASS, car, emmeans)
GAMLj nie ma odpowiednika pakietu jmv, więc liczby odtwarzamy funkcjami, których moduł używa wewnętrznie: glm z rodziną poisson albo quasipoisson, MASS::glm.nb, car::Anova z testem ilorazu wiarygodności typu III i emmeans w skali odpowiedzi (Gallucci, b.d.-b). Kodowanie simple i centrowanie kowarianty ustawiamy ręcznie. Przepis 1 tworzy pliki do pobrania, przepis 2 liczy wszystkie tabele. Uruchom je po kolei w jednym folderze.
1. Dane i pliki CSV oraz .sav
R
# B550 – regresja Poissona i ujemna dwumianowa w jamovi (GAMLj): dane do pobrania
# Dane symulowane, set.seed(591) – ziarno wybrane spośród kilku tysięcy tak, żeby model Poissona
# pokazywał wyraźną nadmierną dyspersję, a jeden z efektów „znikał” po przejściu na model ujemny dwumianowy.
# 240 osób studiujących (po 80 na roku 1, 2 i 3) – liczba wizyt na konsultacjach u prowadzących
# w jednym semestrze. Predyktory: rok studiów i liczba godzin pracy zarobkowej w tygodniu.
# Semestr był dla wszystkich tak samo długi, więc offset nie jest potrzebny.
suppressPackageStartupMessages(library(haven))
set.seed(591)
n <- 240
rok <- rep(1:3, each = n / 3)
praca <- ifelse(runif(n) < .4, 0, round(runif(n, 8, 30)))
mu <- exp(log(2.4) + c(0, -0.25, -0.5)[rok] - 0.03 * praca)
konsultacje <- rnbinom(n, mu = mu, size = 1.5)          # zliczenia z nadmierną dyspersją
d <- data.frame(id = 1:n, rok = rok, praca = praca, konsultacje = konsultacje)

write.csv(d, "regresja-poissona-w-jamovi-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
sav <- d
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$rok <- labelled(sav$rok, labels = c("1. rok" = 1, "2. rok" = 2, "3. rok" = 3), label = "Rok studiów")
sav$praca <- labelled(sav$praca, label = "Praca zarobkowa (godziny w tygodniu)")
sav$konsultacje <- labelled(sav$konsultacje, label = "Liczba wizyt na konsultacjach w semestrze")
write_sav(sav, "regresja-poissona-w-jamovi-dane.sav")

print(head(d, 5), row.names = FALSE)
cat(sprintf("N = %d; średnia = %.2f; wariancja = %.2f; zera = %d (%.1f%%); maks. = %d\n",
            nrow(d), mean(d$konsultacje), var(d$konsultacje), sum(d$konsultacje == 0),
            100 * mean(d$konsultacje == 0), max(d$konsultacje)))
print(table(konsultacje = d$konsultacje))
opis <- aggregate(konsultacje ~ rok, data = d, FUN = function(x) c(N = length(x), M = mean(x), Var = var(x)))
print(do.call(data.frame, opis), digits = 4, row.names = FALSE)
cat(sprintf("praca: średnia = %.2f; osoby bez pracy = %d\n", mean(d$praca), sum(d$praca == 0)))
Wynik:
 id rok praca konsultacje
  1   1    17           0
  2   1    24           0
  3   1    26           0
  4   1     0           3
  5   1    27           1
N = 240; średnia = 1.48; wariancja = 3.97; zera = 94 (39.2%); maks. = 14
konsultacje
 0  1  2  3  4  5  6  7  8  9 14
94 64 33 22 10  3  5  5  1  2  1
 rok konsultacje.N konsultacje.M konsultacje.Var
   1            80         1.975           6.582
   2            80         1.413           2.271
   3            80         1.062           2.718
praca: średnia = 11.43; osoby bez pracy = 94
2. Tabele GAMLj: Poisson, Poisson (overdispersion) i Negative Binomial
R
# B550 – liczby do tabel GAMLj (Generalized Linear Model) policzone w R
# Ustawienia jak domyślne w GAMLj: kodowanie czynników "simple" (pierwszy poziom = odniesienie,
# kody wyśrodkowane), kowarianty wyśrodkowane, przedziały Walda, testy omnibus car::Anova(type = 3, test = "LR"),
# Poisson: stats::glm(family = poisson), Poisson (overdispersion): quasipoisson, Negative Binomial: MASS::glm.nb.
suppressPackageStartupMessages({ library(MASS); library(car); library(emmeans) })
emm_options(msg.interaction = FALSE)
d <- read.csv("regresja-poissona-w-jamovi-dane.csv")
d$rok <- factor(d$rok, levels = 1:3, labels = c("1. rok", "2. rok", "3. rok"))
contrasts(d$rok) <- contr.treatment(3) - 1 / 3         # kodowanie "simple" z GAMLj
d$praca_c <- d$praca - mean(d$praca)                    # Covariates Scaling: Centered

# Tabele jak w GAMLj: Model Fit, Additional indices, Omnibus tests, Parameter Estimates
tabele <- function(m) {
  m0 <- update(m, . ~ 1)                                # model z samym wyrazem wolnym (test X2)
  k <- length(coef(m))
  # R2 jak w GAMLj: 1 - dewiancja / dewiancja zerowa zapisana w dopasowanym modelu
  cat(sprintf("Model Fit: R2 = %.3f; Adj. R2 = %.3f; df = %d; X2 = %.3f; p = %.3g\n",
              1 - m$deviance / m$null.deviance, max(0, 1 - (m$deviance + (k - 1)) / m$null.deviance),
              k - 1, 2 * (logLik(m) - logLik(m0)), pchisq(2 * (logLik(m) - logLik(m0)), k - 1, lower.tail = FALSE)))
  cat(sprintf("Additional indices: LogLikelihood = %.3f; AIC = %.3f; BIC = %.3f; Deviance = %.3f; Residual DF = %d; Chi-squared/DF = %.3f\n",
              as.numeric(logLik(m)), AIC(m), BIC(m), deviance(m), df.residual(m),
              sum(residuals(m, type = "pearson")^2) / df.residual(m)))
  cat(sprintf("(do porównania z SPSS: Deviance / Residual DF = %.3f)\n", deviance(m) / df.residual(m)))
  print(Anova(m, type = 3, test = "LR"), digits = 5)
  w <- coef(summary(m))
  print(round(cbind(Estimate = w[, 1], SE = w[, 2], `Exp(B)` = exp(w[, 1]),
                    Lower = exp(w[, 1] - qnorm(.975) * w[, 2]), Upper = exp(w[, 1] + qnorm(.975) * w[, 2]),
                    z = w[, 3], p = w[, 4]), 3))
}

# 1. Poisson
mp <- glm(konsultacje ~ rok + praca_c, family = poisson, data = d)
tabele(mp)

# 2. Poisson (overdispersion) – quasi-Poisson: te same współczynniki, SE razy pierwiastek z dyspersji
mq <- glm(konsultacje ~ rok + praca_c, family = quasipoisson, data = d)
cat(sprintf("dyspersja = %.3f; pierwiastek = %.3f\n", summary(mq)$dispersion, sqrt(summary(mq)$dispersion)))
print(round(cbind(SE_Poisson = coef(summary(mp))[, 2], SE_quasi = coef(summary(mq))[, 2],
                  p_quasi = coef(summary(mq))[, 4]), 3))

# 3. Negative Binomial
mn <- glm.nb(konsultacje ~ rok + praca_c, data = d)
cat(sprintf("theta = %.3f (SE = %.3f); 1/theta = %.3f\n", mn$theta, mn$SE.theta, 1 / mn$theta))
tabele(mn)
cat(sprintf("IRR dla 10 godzin pracy: %.3f, 95%% CI [%.3f, %.3f]\n",
            exp(10 * coef(mn)["praca_c"]),
            exp(10 * (coef(mn)["praca_c"] - qnorm(.975) * coef(summary(mn))["praca_c", 2])),
            exp(10 * (coef(mn)["praca_c"] + qnorm(.975) * coef(summary(mn))["praca_c", 2]))))

# Iloraz wiarygodności NB wobec Poissona z wierszy LogLikelihood obu modeli
cat(sprintf("2 * (logLik NB - logLik Poisson) = %.2f\n", 2 * (as.numeric(logLik(mn)) - as.numeric(logLik(mp)))))

# Estimated Marginal Means – rok (oczekiwana liczba wizyt przy średniej liczbie godzin pracy)
print(summary(emmeans(mp, ~ rok, type = "response")), digits = 4)
print(summary(emmeans(mn, ~ rok, type = "response")), digits = 4)
Wynik:
Model Fit: R2 = 0.100; Adj. R2 = 0.095; df = 3; X2 = 54.601; p = 8.35e-12
Additional indices: LogLikelihood = -433.689; AIC = 875.377; BIC = 889.300; Deviance = 490.346; Residual DF = 236; Chi-squared/DF = 2.231
(do porównania z SPSS: Deviance / Residual DF = 2.078)
Analysis of Deviance Table (Type III tests)

Response: konsultacje
        LR Chisq Df Pr(>Chisq)
rok       19.982  2  4.580e-05 ***
praca_c   31.920  1  1.607e-08 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Estimate    SE Exp(B) Lower Upper      z     p
(Intercept)    0.315 0.057  1.370 1.224 1.532  5.493 0.000
rok2          -0.326 0.123  0.722 0.567 0.919 -2.647 0.008
rok3          -0.580 0.135  0.560 0.430 0.729 -4.311 0.000
praca_c       -0.030 0.005  0.970 0.960 0.981 -5.491 0.000
dyspersja = 2.231; pierwiastek = 1.494
            SE_Poisson SE_quasi p_quasi
(Intercept)      0.057    0.086   0.000
rok2             0.123    0.184   0.078
rok3             0.135    0.201   0.004
praca_c          0.005    0.008   0.000
theta = 1.258 (SE = 0.249); 1/theta = 0.795
Model Fit: R2 = 0.087; Adj. R2 = 0.076; df = 3; X2 = 22.328; p = 5.57e-05
Additional indices: LogLikelihood = -390.591; AIC = 791.181; BIC = 808.584; Deviance = 251.459; Residual DF = 236; Chi-squared/DF = 1.026
(do porównania z SPSS: Deviance / Residual DF = 1.066)
Analysis of Deviance Table (Type III tests)

Response: konsultacje
        LR Chisq Df Pr(>Chisq)
rok       8.1384  2  0.0170908 *
praca_c  13.4696  1  0.0002425 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Estimate    SE Exp(B) Lower Upper      z     p
(Intercept)    0.319 0.081  1.376 1.174 1.612  3.936 0.000
rok2          -0.282 0.189  0.755 0.521 1.093 -1.489 0.136
rok3          -0.559 0.197  0.572 0.389 0.842 -2.831 0.005
praca_c       -0.028 0.008  0.972 0.957 0.987 -3.603 0.000
IRR dla 10 godzin pracy: 0.754, 95% CI [0.647, 0.879]
2 * (logLik NB - logLik Poisson) = 86.20
 rok     rate     SE  df asymp.LCL asymp.UCL
 1. rok 1.853 0.1516 Inf    1.5784     2.175
 2. rok 1.337 0.1282 Inf    1.1082     1.614
 3. rok 1.037 0.1133 Inf    0.8372     1.285

Confidence level used: 0.95
Intervals are back-transformed from the log scale
 rok    response     SE  df asymp.LCL asymp.UCL
 1. rok    1.820 0.2368 Inf    1.4106     2.349
 2. rok    1.374 0.1903 Inf    1.0471     1.802
 3. rok    1.041 0.1552 Inf    0.7774     1.394

Confidence level used: 0.95
Intervals are back-transformed from the log scale
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i svglite (kodu rysunków nie pokazujemy). Moduł GAMLj i jamovi nie były uruchamiane. W pracy podaj wersję jamovi i GAMLj albo R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Raport z modelu Poissona bez sprawdzenia Chi-squared/DF. W przykładzie dałoby to „istotną” różnicę między pierwszym a drugim rokiem.
- Czekanie na wartość powyżej 3. Już 2.23 zaniża błędy standardowe mniej więcej 1.5 raza.
- Estimate zamiast Exp(B). Współczynnik −0.559 to różnica logarytmów, a nie liczby wizyt.
- Offset bez logarytmu albo jako zwykła kowarianta. GAMLj nie logarytmuje offsetu, a kowarianta ma szacowany współczynnik.
- Wyraz wolny czytany jak w SPSS. Przy kodowaniu simple i wyśrodkowanej kowariancie to nie jest wartość w kategorii odniesienia.
Model dla wyniku dwuwartościowego w jamovi opisuje wpis regresja logistyczna w jamovi, a interakcje w GAMLj – wpis moderacja w jamovi. Analizę do innego typu danych dobierzesz w kreatorze doboru testu.
Najczęstsze pytania
Gdzie w jamovi jest regresja Poissona?
Podstawowe jamovi jej nie ma. W bibliotece modułów (Modules → jamovi library) zainstaluj General Analyses for Linear Models (v3), czyli GAMLj (The jamovi project, b.d.). Analiza pojawi się jako Linear Models → GAMLj3 → Generalized Linear Model, a model wybierasz w grupie Frequencies: Poisson, Poisson (overdispersion) albo Negative Binomial (Gallucci, b.d.-b).
Jak sprawdzić nadmierną dyspersję w GAMLj?
Spójrz na wiersz Chi-squared/DF w tabeli Additional indices. To suma kwadratów reszt Pearsona podzielona przez resztowe stopnie swobody (Gallucci, b.d.-b). W modelu Poissona powinna być bliska 1. W przykładzie wyniosła 2.23, więc błędy standardowe były zaniżone mniej więcej 1.5 raza.
Poisson (overdispersion) czy Negative Binomial?
Oba modele poprawiają błędy standardowe. Poisson (overdispersion) to quasi-Poisson: współczynniki zostają te same, ale nie ma AIC. Negative Binomial szacuje parametr rozrzutu i ma funkcję wiarygodności, więc porównasz go z modelem Poissona. Modele mogą dawać różne wyniki, bo inaczej ważą małe i duże zliczenia (Ver Hoef i Boveng, 2007).
Czy w GAMLj można dodać offset do regresji Poissona?
Strona pomocy opisuje pole Offset (Gallucci, b.d.-a). W definicji okna wersji 3.7.2 jest ono jednak aktywne tylko przy modelu Logistic, a zmienna nie jest logarytmowana (Gallucci, b.d.-b). Sprawdź swoją wersję. Jeśli pole jest nieaktywne, model z offsetem policz w R albo w SPSS.
Dlaczego wyraz wolny z GAMLj różni się od tego z SPSS?
GAMLj domyślnie stosuje kodowanie simple z wyśrodkowanymi kodami i centruje kowarianty (Gallucci, b.d.-a). Wyraz wolny nie dotyczy więc kategorii odniesienia przy zerze kowarianty. IRR dla porównania z pierwszą kategorią w modelu bez interakcji są takie same jak przy kodowaniu zero-jedynkowym.
Powiązane hasła
Przeczytaj też
Regresja Poissona i ujemna dwumianowa w SPSS
Generalized Linear Models od pliku .sav po opis APA: offset, Value/df i nadmierna dyspersja, IRR z exp(B), szacowany parametr k i składnia GENLIN – na fikcyjnych danych o nieobecnościach.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikModel mieszany w jamovi (GAMLj) krok po kroku
Moduł GAMLj w jamovi: format długi, klaster, losowy wyraz wolny i nachylenie, ICC w Random Components, średnie brzegowe, simple effects i różnice wobec MIXED w SPSS.
Czytaj →PoradnikRegresja logistyczna w jamovi
2 Outcomes krok po kroku: Factors i Covariates, poziom referencyjny, bloki, ilorazy szans z CI, pseudo-R², tabela klasyfikacji, AUC i zapis APA.
Czytaj →Masz zliczenia w jamovi i nie wiesz, który model wybrać?
Sprawdzimy Twój plik .omv, dyspersję, wybór modelu, kategorie odniesienia i średnie brzegowe i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Coxe, S., West, S. G., & Aiken, L. S. (2009). The analysis of count data: A gentle introduction to Poisson regression and its alternatives. Journal of Personality Assessment, 91(2), 121–136. https://doi.org/10.1080/00223890802634175
- Gallucci, M. (b.d.-a). GAMLj: Generalized linear models (Generalized linear model module technical details; Frequencies analysis with overdispersed models). GAMLj documentation. https://gamlj.github.io/gzlm.html ● Otwarty dostęp
- Gallucci, M. (b.d.-b). GAMLj3: General analyses for linear models (v3) – pliki analizy Generalized Linear Model (wersja 3.7.2). GitHub. https://github.com/gamlj/gamlj/tree/master/jamovi ● Otwarty dostęp
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- The jamovi project. (b.d.). Library modules. https://www.jamovi.org/modules.html ● Otwarty dostęp
- Ver Hoef, J. M., & Boveng, P. L. (2007). Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data? Ecology, 88(11), 2766–2772. https://doi.org/10.1890/07-0043.1
Cytowania BibTeX
@article{coxe2009analysis, author={Coxe, Stefany and West, Stephen G. and Aiken, Leona S.}, title={{The analysis of count data: A gentle introduction to Poisson regression and its alternatives}}, journal={Journal of Personality Assessment}, year={2009}, volume={91}, number={2}, pages={121--136}, doi={10.1080/00223890802634175}}@misc{galluccindgamljglm, author={Gallucci, Marcello}, title={{GAMLj: Generalized linear models (Generalized linear model module technical details; Frequencies analysis with overdispersed models)}}, howpublished={GAMLj documentation}, year={b.d.-a}, url={https://gamlj.github.io/gzlm.html}}@misc{galluccindgamljglmrepo, author={Gallucci, Marcello}, title={{GAMLj3: General analyses for linear models (v3) – pliki analizy Generalized Linear Model (wersja 3.7.2)}}, howpublished={GitHub}, year={b.d.-b}, url={https://github.com/gamlj/gamlj/tree/master/jamovi}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@misc{jamovindmodules, author={{The jamovi project}}, title={{Library modules}}, howpublished={jamovi}, year={b.d.}, url={https://www.jamovi.org/modules.html}}@article{verhoef2007quasi, author={Ver Hoef, Jay M. and Boveng, Peter L.}, title={{Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data?}}, journal={Ecology}, year={2007}, volume={88}, number={11}, pages={2766--2772}, doi={10.1890/07-0043.1}}