Co to jest rozkład Poissona?
Rozkład Poissona (ang. Poisson distribution) to rozkład dyskretny liczby zdarzeń w ustalonym czasie lub przestrzeni, gdy zdarzenia zachodzą niezależnie i ze stałą średnią intensywnością: liczby napadów paniki w miesiącu, błędów w zadaniu, wizyt w poradni. Ma jeden parametr λ (lambda), czyli oczekiwaną liczbę zdarzeń. Prawdopodobieństwo k zdarzeń wynosi P(X = k) = λke−λ/k!, dla k = 0, 1, 2, …
Własności
- Średnia równa wariancji. Obie wynoszą λ, więc wariancja rośnie razem ze średnią. To założenie najczęściej łamane w praktyce.
- Kształt. Przy małym λ rozkład jest prawostronnie skośny i ma wiele zer; gdy λ rośnie, zbliża się do rozkładu normalnego.
- Związek z rozkładem dwumianowym. To granica rozkładu dwumianowego przy wielu próbach i małym prawdopodobieństwie sukcesu, gdy np = λ.
- Sumowanie. Suma niezależnych zmiennych Poissona ma rozkład Poissona z λ równym sumie parametrów.
Przykład w R
Przy λ = 2.5 funkcja dpois() daje P(0) = .082, P(1) = .205, P(2) = .257 i P(3) = .214, a więcej niż 5 zdarzeń ma prawdopodobieństwo .042. W 10 000 symulowanych obserwacjach średnia wyniosła 2.52, a wariancja 2.46, czyli prawie tyle samo.
Rozkład Poissona jest punktem wyjścia regresji Poissona. Coxe, West i Aiken (2009) polecają ją dla liczebności o niskiej średniej (zwykle poniżej 10), gdy zwykła regresja liniowa może dawać obciążone wyniki. Gardner, Mulvey i Shaw (1995) ostrzegają, że liczebności w psychologii są zwykle bardziej zmienne, niż zakłada model. Taką nadmierną dyspersję uwzględnia regresja ujemna dwumianowa.
Na rysunku
Rysunki pokazują, jak kształt zależy od λ i co w praktyce znaczy „wariancja równa średniej”. Modelowanie zliczeń pokazuje wpis Regresja Poissona – wizualizacja.
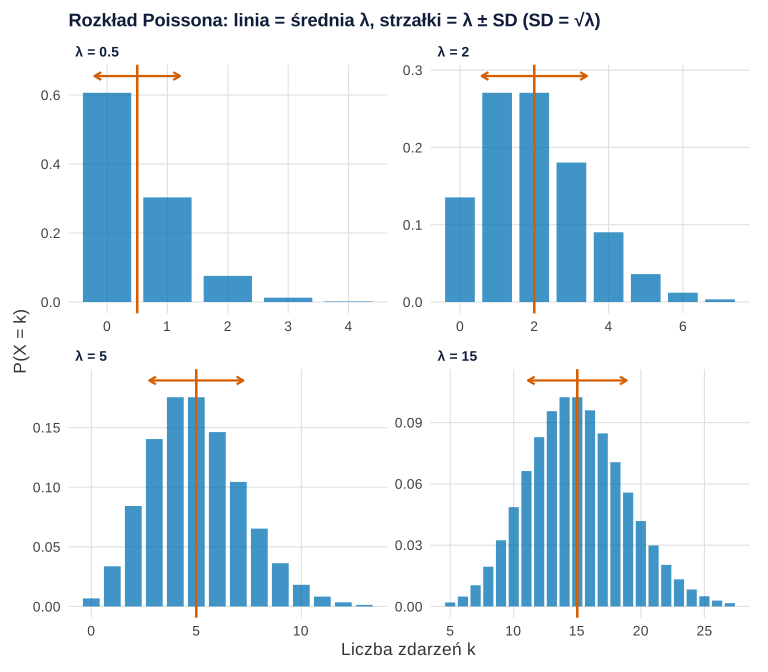
Co widać. Przy λ = 0.5 aż 60.7% obserwacji to zera, przy λ = 2 – 13.5%, przy λ = 5 – 0.7%. Strzałki rosną razem ze średnią, bo SD = √λ: od 0.71 przy λ = 0.5 do 3.87 przy λ = 15. Skośność (1/√λ) spada z 1.41 do 0.26, więc przy dużym λ rozkład wygląda prawie jak normalny.
Na co uważać. Panele mają różne skale osi. Rysunek pokazuje model, a nie dane – nie powie, czy Twoje zliczenia mają tyle zer, ile przewiduje model.
Podpis do pracy:
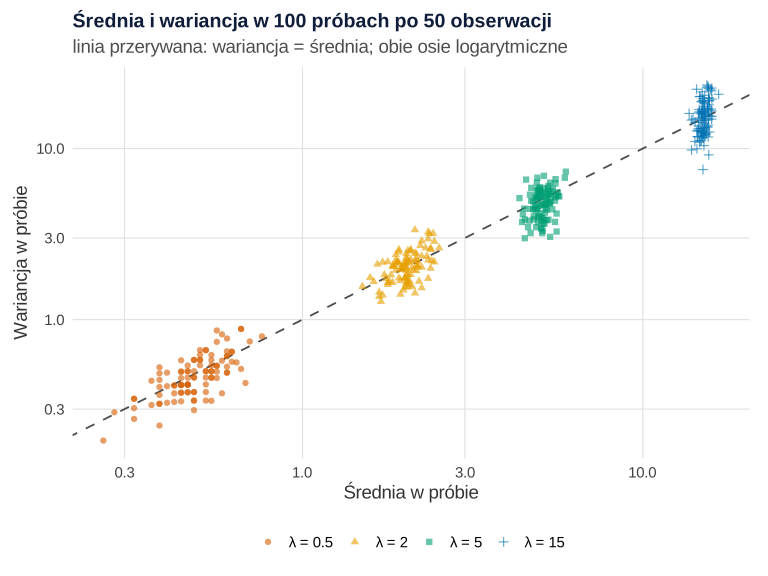
set.seed(4772)).Co widać. Dla każdego λ wylosowaliśmy 1000 prób po 50 obserwacji (na wykresie pierwsze 100). Średnio wariancja jest równa średniej: na przykład 15.03 i 15.07 przy λ = 15. W pojedynczej próbie stosunek wariancji do średniej waha się jednak mniej więcej od 0.65 do 1.45 (2.5. i 97.5. centyl, podobnie dla każdego λ). Wartości λ, wielkość próby 50 i liczbę 1000 prób ustawiliśmy ręcznie; ziarno 4772 ustalono raz i nie zmieniano go.
Na co uważać. Stosunek wariancji do średniej równy 1.3 przy 50 osobach nie dowodzi nadmiernej dyspersji, a 0.9 nie dowodzi jej braku. W modelu regresji dyspersję ocenia się na resztach.
Podpis do pracy:
Kod poniżej odtwarza oba rysunki i liczby z tej sekcji. Jest samowystarczalny: kolory Okabe–Ito i prosty motyw definiuje sam, a część losująca zaczyna się od własnego set.seed(4772). Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunków 1 i 2
# Rysunki 1–2. Rozkład Poissona dla λ = 0.5, 2, 5, 15 i równość średniej z wariancją
library(ggplot2)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))
lambdy <- c(0.5, 2, 5, 15)
etyk <- paste("λ =", lambdy)

# Rysunek 1: słupki P(X = k); pionowa linia = średnia λ, odcinek ze strzałkami = średnia ± SD (SD = √λ)
slupki <- do.call(rbind, lapply(lambdy, function(l) {
  k <- 0:30; data.frame(lambda = l, k, P = dpois(k, l))[dpois(k, l) >= 0.001, ]
}))
slupki$panel <- factor(paste("λ =", slupki$lambda), etyk)
opis <- data.frame(lambda = lambdy, panel = factor(etyk, etyk), sd = sqrt(lambdy),
                   y = tapply(slupki$P, slupki$panel, max) * 1.08)
round(data.frame(lambda = lambdy, P0 = dpois(0, lambdy), wariancja = lambdy, SD = sqrt(lambdy),
                 skosnosc = 1 / sqrt(lambdy)), 3)
p1 <- ggplot(slupki, aes(k, P)) +
  geom_col(fill = "#0072B2", alpha = 0.75, width = 0.8) +
  geom_vline(data = opis, aes(xintercept = lambda), colour = "#D55E00", linewidth = 0.9) +
  geom_segment(data = opis, aes(x = lambda - sd, xend = lambda + sd, y = y, yend = y),
               colour = "#D55E00", linewidth = 0.8, arrow = arrow(ends = "both", length = unit(0.08, "in"))) +
  facet_wrap(~ panel, ncol = 2, scales = "free") +
  scale_x_continuous(breaks = function(l) { b <- pretty(l); b[b == round(b) & b >= 0] }) +
  labs(title = "Rozkład Poissona: linia = średnia λ, strzałki = λ ± SD (SD = √λ)",
       x = "Liczba zdarzeń k", y = "P(X = k)") + motyw
p1   # zapis: ggsave("rozklad-poissona-cztery-lambdy.svg", p1, width = 8, height = 7)

# Rysunek 2: 1000 prób po 50 obserwacji dla każdego λ – średnia i wariancja z próby (na wykresie pierwsze 100)
set.seed(4772)
sym <- do.call(rbind, lapply(lambdy, function(l) {
  t(replicate(1000, { x <- rpois(50, l); c(lambda = l, M = mean(x), V = var(x)) }))
}))
sym <- as.data.frame(sym)
sym$rozklad <- factor(paste("λ =", sym$lambda), etyk)
# Wskaźnik dyspersji V/M: średnio około 1, ale w pojedynczej próbie n = 50 sporo się waha
do.call(rbind, lapply(split(sym, sym$lambda), function(s)
  round(c(lambda = s$lambda[1], sr_M = mean(s$M), sr_V = mean(s$V),
          VM_2.5 = unname(quantile(s$V / s$M, .025, na.rm = TRUE)),
          VM_97.5 = unname(quantile(s$V / s$M, .975, na.rm = TRUE))), 2)))
p2 <- ggplot(sym[ave(sym$lambda, sym$lambda, FUN = seq_along) <= 100, ], aes(M, V, colour = rozklad, shape = rozklad)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey30") +
  geom_point(alpha = 0.6, size = 1.8) +
  scale_x_log10() + scale_y_log10() +
  scale_colour_manual(values = c("#D55E00", "#E69F00", "#009E73", "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15, 3), name = NULL) +
  labs(title = "Średnia i wariancja w 100 próbach po 50 obserwacji",
       subtitle = "linia przerywana: wariancja = średnia; obie osie logarytmiczne",
       x = "Średnia w próbie", y = "Wariancja w próbie") + motyw
p2   # zapis: ggsave("rozklad-poissona-srednia-a-wariancja.svg", p2, width = 8, height = 6)
Wynik w R
  lambda    P0 wariancja    SD skosnosc
1    0.5 0.607       0.5 0.707    1.414
2    2.0 0.135       2.0 1.414    0.707
3    5.0 0.007       5.0 2.236    0.447
4   15.0 0.000      15.0 3.873    0.258
    lambda  sr_M  sr_V VM_2.5 VM_97.5
0.5    0.5  0.50  0.51   0.66    1.43
2      2.0  2.00  2.00   0.67    1.45
5      5.0  5.01  4.97   0.65    1.45
15    15.0 15.03 15.07   0.64    1.48
Jak opisać w pracy
Na co uważać
- Nadmiar zer. Jeśli zer jest dużo więcej niż P(0) z modelu, część osób może w ogóle nie przejawiać zachowania (Coxe i in., 2009).
- Różne okresy obserwacji. Gdy osoby obserwowano różnie długo, porównuj częstości, a w modelu użyj offsetu.
- Analiza krok po kroku. Wybór między modelami opisuje poradnik regresja dla zliczeń.
Rozkład Poissona w R
Kod liczy prawdopodobieństwa rozkładu Poissona dla λ = 2.5, prawdopodobieństwo ogona i porównuje średnią z wariancją w symulowanej próbie.
Prawdopodobieństwa i równość średniej z wariancją
R
lambda <- 2.5                          # średnio 2.5 zdarzenia w okresie
round(data.frame(k = 0:6, P = dpois(0:6, lambda)), 3)
round(ppois(5, lambda, lower.tail = FALSE), 3)  # P(X > 5)
set.seed(4771)
x <- rpois(10000, lambda)
round(c(srednia = mean(x), wariancja = var(x)), 2)
Wynik w R
  k     P
1 0 0.082
2 1 0.205
3 2 0.257
4 3 0.214
5 4 0.134
6 5 0.067
7 6 0.028
[1] 0.042
  srednia wariancja
     2.52      2.46
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w tej sekcji nie wymagają dodatkowych pakietów; rysunki 1 i 2 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Skąd wiadomo, że liczebności mają rozkład Poissona?
Porównaj średnią z wariancją oraz obserwowane częstości z częstościami z dpois(). Wariancja wyraźnie większa od średniej albo dużo więcej zer niż w modelu oznacza, że rozkład Poissona nie pasuje.
Czy zmienna o rozkładzie Poissona może przyjmować wartości ułamkowe?
Nie. Przyjmuje tylko nieujemne liczby całkowite 0, 1, 2 itd. Ułamkiem może być natomiast parametr λ, np. średnio 2.5 zdarzenia na miesiąc.
Czym rozkład Poissona różni się od rozkładu dwumianowego?
Dwumianowy liczy sukcesy w ustalonej liczbie n prób, więc nie przekracza n. Poisson liczy zdarzenia bez górnej granicy i przybliża rozkład dwumianowy, gdy n jest duże, a p małe.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikPrawdopodobieństwo i rozkłady – zadania
Dziesięć zadań jak na kolokwium: prawdopodobieństwo warunkowe, wartość oczekiwana, rozkład dwumianowy, Poissona i normalny, CTG – z rozwiązaniami krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Coxe, S., West, S. G., & Aiken, L. S. (2009). The analysis of count data: A gentle introduction to Poisson regression and its alternatives. Journal of Personality Assessment, 91(2), 121–136. https://doi.org/10.1080/00223890802634175
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
Cytowania BibTeX
@article{coxe2009analysis, author={Coxe, Stefany and West, Stephen G. and Aiken, Leona S.}, title={{The analysis of count data: A gentle introduction to Poisson regression and its alternatives}}, journal={Journal of Personality Assessment}, year={2009}, volume={91}, number={2}, pages={121--136}, doi={10.1080/00223890802634175}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}