Co to jest rozkład dwumianowy?
Rozkład dwumianowy (ang. binomial distribution) to rozkład liczby sukcesów k w n niezależnych próbach, gdy w każdej sukces ma to samo prawdopodobieństwo p: liczby osób, które zgodziły się wziąć udział w badaniu, poprawnych odpowiedzi w teście wyboru albo pacjentów z poprawą. Prawdopodobieństwo wynosi P(X = k) = C(n, k) · pk(1 − p)n − k, gdzie C(n, k) = n!/[k!(n − k)!] to liczba sposobów wyboru k prób spośród n.
Własności i założenia
- Średnia np, wariancja np(1 − p). Wariancja jest największa, gdy p wynosi 0.5. Odsetek k/n ma błąd standardowy √[p(1 − p)/n].
- Założenia. Stała liczba prób, dwa wyniki, stałe p i niezależność prób.
- Przybliżenia. Przy dużym n rozkład zbliża się do normalnego, a przy dużym n i małym p – do rozkładu Poissona.
Przykład w R
Dla n = 10 i prawdopodobieństwa sukcesu 0.3 najbardziej prawdopodobne są 3 sukcesy: P(3) = .267. Zero sukcesów ma prawdopodobieństwo .028, a co najmniej pięć – .150. Średnia wynosi 3, a wariancja 2.1; w 10 000 symulacjach wyszło 3.00 i 2.09. Dokładny test dwumianowy dla 9 sukcesów na 20 przy hipotezie, że p wynosi 0.25, dał p = .065, odsetek .45, 95% CI [.23, .68].
Na tym rozkładzie opiera się test znaków (prawdopodobieństwo 0.5), regresja logistyczna i przedział ufności dla proporcji. Agresti i Coull (1998) pokazują, że „dokładne” przedziały mają za wysokie pokrycie, a przedział Walda za niskie. Brown, Cai i DasGupta (2001) zalecają przy małym n przedział Wilsona lub Jeffreysa.
Na rysunku
Kształt rozkładu dwumianowego zależy od obu parametrów naraz. Rysunek zestawia sześć kombinacji: liczbę prób n = 10, 30 i 100 oraz prawdopodobieństwo sukcesu .1 i .5. Na każde słupki nałożono krzywą normalną o tej samej średniej np i odchyleniu standardowym √[np(1 − p)].
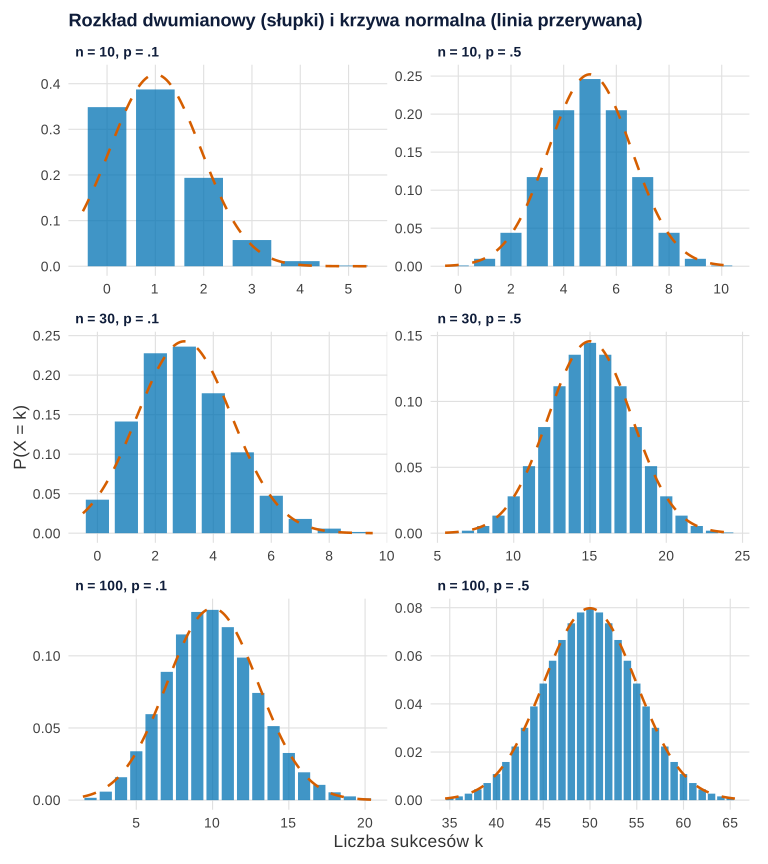
Co widać. Przy p = .5 rozkład jest symetryczny i krzywa normalna dobrze go opisuje już przy 10 próbach: największy błąd dystrybuanty (z poprawką na ciągłość) wynosi .0027. Przy p = .1 i n = 10 oczekujemy tylko jednego sukcesu, rozkład jest prawoskośny (skośność 0.84), a krzywa normalna przypisuje część prawdopodobieństwa wartościom ujemnym. Błąd dystrybuanty sięga wtedy .0496, czyli prawie 5 punktów procentowych. Przy n = 30 spada do .0309, a przy n = 100 (np = 10) do .0175. O jakości przybliżenia decyduje więc nie samo n, lecz liczba oczekiwanych sukcesów i porażek: np i n(1 − p).
Na co uważać. Każdy panel ma własną skalę obu osi, więc wysokości słupków nie porównuj między panelami. Rysunek zakłada stałe p i niezależne próby. Nie pokazuje, co się dzieje, gdy prawdopodobieństwo różni się między osobami – wtedy rozrzut jest większy niż w rozkładzie dwumianowym.
Podpis do pracy:
Kod poniżej odtwarza rysunek i tabelę błędów przybliżenia. Jest samowystarczalny: kolory i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Kod nic nie losuje.
Kod R rysunku 1
# Rysunek 1. Rozkład dwumianowy dla n = 10, 30, 100 i p = .1, .5 z przybliżeniem normalnym
library(ggplot2)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

ust <- expand.grid(p = c(0.1, 0.5), n = c(10, 30, 100))
# Słupki: P(X = k) tam, gdzie prawdopodobieństwo jest widoczne (≥ .0005)
slupki <- do.call(rbind, Map(function(n, p) {
  k <- 0:n; pk <- dbinom(k, n, p)
  data.frame(n, p, k, P = pk)[pk >= 0.0005, ]
}, ust$n, ust$p))
# Krzywa normalna o tej samej średniej np i SD √(np(1 − p))
krzywe <- do.call(rbind, Map(function(n, p) {
  zak <- range(slupki$k[slupki$n == n & slupki$p == p])
  x <- seq(zak[1] - 0.5, zak[2] + 0.5, length.out = 150)
  data.frame(n, p, x, y = dnorm(x, n * p, sqrt(n * p * (1 - p))))
}, ust$n, ust$p))
for (d in c("slupki", "krzywe")) {
  z <- get(d)
  z$panel_n <- factor(paste("n =", z$n), paste("n =", c(10, 30, 100)))
  z$panel_p <- factor(paste("p =", sub("^0", "", z$p)), c("p = .1", "p = .5"))
  assign(d, z)
}

# Jak dobre jest przybliżenie? Największy błąd dystrybuanty (z poprawką na ciągłość) i skośność
blad <- do.call(rbind, Map(function(n, p) {
  k <- 0:n; s <- sqrt(n * p * (1 - p))
  data.frame(n, p, np = n * p, n_1_p = n * (1 - p), skosnosc = round((1 - 2 * p) / s, 3),
             max_blad_dystr = round(max(abs(pbinom(k, n, p) - pnorm(k + 0.5, n * p, s))), 4))
}, ust$n, ust$p))
blad

p1 <- ggplot(slupki, aes(k, P)) +
  geom_col(fill = "#0072B2", alpha = 0.75, width = 0.8) +
  geom_line(data = krzywe, aes(x, y), colour = "#D55E00", linewidth = 0.9, linetype = "dashed") +
  facet_wrap(~ panel_n + panel_p, ncol = 2, scales = "free",
             labeller = label_wrap_gen(multi_line = FALSE)) +
  scale_x_continuous(breaks = function(l) { b <- pretty(l); b[b == round(b)] }) +   # tylko liczby całkowite
  labs(title = "Rozkład dwumianowy (słupki) i krzywa normalna (linia przerywana)",
       x = "Liczba sukcesów k", y = "P(X = k)") + motyw
p1   # zapis: ggsave("rozklad-dwumianowy-szesc-ksztaltow.svg", p1, width = 8, height = 9)
Wynik w R
    n   p np n_1_p skosnosc max_blad_dystr
1  10 0.1  1     9    0.843         0.0496
2  10 0.5  5     5    0.000         0.0027
3  30 0.1  3    27    0.487         0.0309
4  30 0.5 15    15    0.000         0.0009
5 100 0.1 10    90    0.267         0.0175
6 100 0.5 50    50    0.000         0.0003
Jak opisać w pracy
Na co uważać
- Zależne próby. Odpowiedzi tej samej osoby na wiele pozycji albo uczniów z jednej klasy nie są niezależne, więc zmienność jest większa niż np(1 − p).
- Zmienne p. Gdy prawdopodobieństwo różni się między osobami, rozkład dwumianowy nie pasuje.
- Nazwy. Rozkład ujemny dwumianowy nie jest jego odmianą dla proporcji, lecz modelem dla zliczeń z nadmierną dyspersją.
Rozkład dwumianowy w R
Kod liczy prawdopodobieństwa rozkładu dwumianowego dla n = 10 i prawdopodobieństwa sukcesu 0.3, jego średnią i wariancję, porównuje je z symulacją i wykonuje dokładny test dwumianowy.
Prawdopodobieństwa, średnia, wariancja i test dwumianowy
R
n <- 10; p <- 0.3                      # 10 prób, P(sukcesu) = 0.3
round(data.frame(k = 0:10, P = dbinom(0:10, n, p)), 3)
round(c(srednia = n * p, wariancja = n * p * (1 - p),
        P_co_najmniej_5 = pbinom(4, n, p, lower.tail = FALSE)), 3)
set.seed(4781)
x <- rbinom(10000, n, p)
round(c(srednia_sym = mean(x), wariancja_sym = var(x)), 2)
binom.test(9, 20, 0.25)          # x, n, hipotetyczne p
Wynik w R
    k     P
1   0 0.028
2   1 0.121
3   2 0.233
4   3 0.267
5   4 0.200
6   5 0.103
7   6 0.037
8   7 0.009
9   8 0.001
10  9 0.000
11 10 0.000
        srednia       wariancja P_co_najmniej_5
           3.00            2.10            0.15
  srednia_sym wariancja_sym
         3.00          2.09

	Exact binomial test

data:  9 and 20
number of successes = 9, number of trials = 20, p-value = 0.06524
alternative hypothesis: true probability of success is not equal to 0.25
95 percent confidence interval:
 0.2305779 0.6847219
sample estimates:
probability of success
                  0.45
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w tej sekcji nie wymagają dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy rozkład dwumianowy można przybliżyć rozkładem normalnym?
Podręczniki podają reguły typu np ≥ 5, ale Brown i in. (2001) pokazują, że takie reguły bywają zawodne. W R łatwo liczyć dokładnie, funkcjami dbinom() i binom.test(), więc przybliżenie rzadko jest potrzebne.
Czym rozkład dwumianowy różni się od rozkładu Bernoulliego?
Rozkład Bernoulliego opisuje jedną próbę z wynikiem 0 albo 1. Rozkład dwumianowy to suma n niezależnych prób Bernoulliego z tym samym prawdopodobieństwem p.
Jak w R policzyć prawdopodobieństwo z rozkładu dwumianowego?
dbinom(3, 10, 0.3) daje .267, czyli prawdopodobieństwo dokładnie 3 sukcesów w 10 próbach. pbinom(4, 10, 0.3, lower.tail = FALSE) daje .150, czyli co najmniej 5 sukcesów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Prawdopodobieństwo i rozkłady – zadania
Dziesięć zadań jak na kolokwium: prawdopodobieństwo warunkowe, wartość oczekiwana, rozkład dwumianowy, Poissona i normalny, CTG – z rozwiązaniami krok po kroku.
Czytaj →PoradnikTest smaku – trójkątny i Bradley–Terry
Producent hummusu: test trójkątny z p₀ = 1/3 i mocą, preferencja parami w modelu Bradleya–Terry’ego i oceny 1–9 w modelu mieszanym – kod R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A., & Coull, B. A. (1998). Approximate is better than “exact” for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
Cytowania BibTeX
@article{agresti1998approximate, author={Agresti, Alan and Coull, Brent A.}, title={{Approximate is better than “exact” for interval estimation of binomial proportions}}, journal={The American Statistician}, year={1998}, volume={52}, number={2}, pages={119--126}, doi={10.1080/00031305.1998.10480550}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}