Co to jest rozkład beta-dwumianowy?
Rozkład beta-dwumianowy opisuje liczbę sukcesów w n próbach, gdy prawdopodobieństwo sukcesu nie jest stałe, lecz zmienia się między zestawami prób. W zwykłym rozkładzie dwumianowym każda klasa, szpital czy miot ma to samo p. Tutaj p losuje się z rozkładu beta o parametrach α i β, a dopiero potem liczy sukcesy. Taki rozkład opisał Skellam (1948), traktując prawdopodobieństwo sukcesu jako zmienne między seriami prób.
Średnia wynosi nμ, gdzie μ = α / (α + β). Wariancja to nμ(1 − μ)[1 + (n − 1)ρ], gdzie ρ = 1 / (α + β + 1) jest korelacją wyników w obrębie zestawu – odpowiednikiem ICC. Gdy ρ = 0, rozkład sprowadza się do dwumianowego. Gdy ρ > 0, wariancja jest większa niż dwumianowa, czyli występuje nadmierna dyspersja.
Przykład w R
W 40 klasach po 20 uczniów średnio zalicza 12.5 osoby. Wariancja liczby zaliczeń wynosi 8.62, a rozkład dwumianowy przewiduje tylko 4.69. Model beta-dwumianowy, dopasowany metodą największej wiarygodności, daje μ = 0.625 i ρ = 0.040, a z nich wariancję 8.24 – bliską obserwowanej. Log-wiarygodność rośnie z −102.7 do −98.4.
Gdzie się przydaje
Williams (1975) użył tego podejścia w toksykologii: odpowiedzi w obrębie miotu traktował jak próby Bernoulliego, a prawdopodobieństwo sukcesu zmieniało się między miotami zgodnie z rozkładem beta. Parametry szacował metodą największej wiarygodności, a różnice między grupami testował ilorazem wiarygodności. Ten sam schemat pasuje do odsetka poprawnych odpowiedzi w teście o stałej liczbie pozycji, odsetka zaliczeń w klasach czy zgodności oceniających. Jeśli modelujesz proporcję ciągłą, a nie liczbę sukcesów z n prób, sięgnij po regresję beta. Odpowiednikiem dla zliczeń bez górnej granicy jest regresja ujemna dwumianowa.
Na rysunku
Rysunek pokazuje dane z przykładu – liczbę zaliczeń w 40 klasach po 20 uczniów (set.seed(563), jak wyżej) – i dwa dopasowane modele o tej samej średniej 12.5. Drugi panel pokazuje wzór, a nie dane: ile razy nadmierna dyspersja powiększa wariancję przy różnej liczbie prób w zestawie.
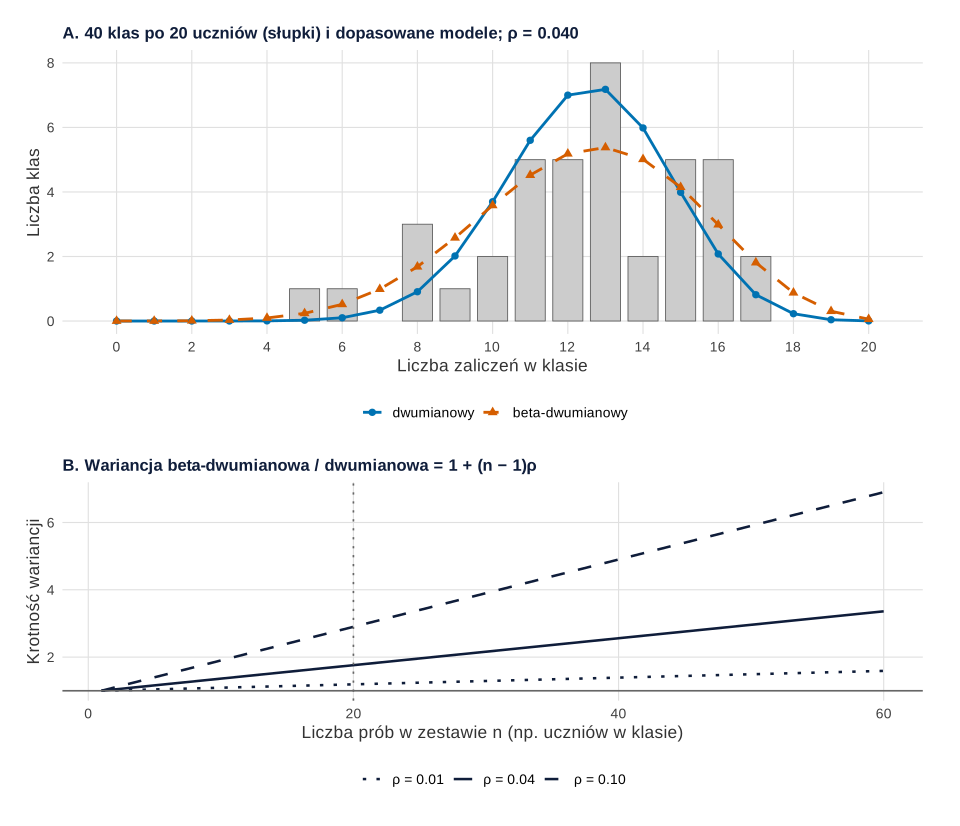
set.seed(563)).Co widać. Oba modele mają ten sam środek, ale rozkład dwumianowy jest za wąski. Klas skrajnych – z co najwyżej 9 albo co najmniej 16 zaliczeniami – jest w danych 13, a model dwumianowy oczekuje ich tylko 6.5. Model beta-dwumianowy, z tą samą średnią i ρ = 0.040, przewiduje 12.2 takich klas, czyli prawie dokładnie tyle, ile ich jest. Panel B wyjaśnia, dlaczego tak mała korelacja wystarcza. Przy 20 uczniach w klasie wariancja rośnie 1.76 raza, a przy 60 uczniach to samo ρ = 0.04 daje już 3.36 raza. Przy ρ = 0.10 i 20 uczniach byłoby to 2.90 raza. To ten sam mechanizm co efekt schematu w doborze grupowym.
Na co uważać. Czterdzieści klas to mało, żeby precyzyjnie oszacować ρ. Dane wygenerowano z rozkładu beta(6, 4), dla którego ρ = 1/11 = 0.091, a model oszacował 0.040. Słupki w panelu A są też poszarpane: przy 40 klasach pojedyncze dołki (np. 2 klasy z 14 zaliczeniami obok 8 klas z 13) to zwykła losowość, a nie cecha rozkładu. Rysunek nie pokazuje też, skąd bierze się zróżnicowanie między klasami (nauczyciel, poziom uczniów). Jeśli masz takie zmienne, lepszy będzie model wielopoziomowy z predyktorami niż sam rozkład beta-dwumianowy.
Podpis do pracy:
Kod rysunku liczy też, ile klas skrajnych przewiduje każdy model, i krotność wariancji dla wybranych wartości. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Liczba zaliczeń w 40 klasach: rozkład dwumianowy a beta-dwumianowy o tej samej średniej
suppressPackageStartupMessages(library(VGAM))
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("dwumianowy" = "#0072B2", "beta-dwumianowy" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Te same dane co w przykładzie: 40 klas po 20 uczniów, p w klasie z rozkładu beta(6, 4)
set.seed(563)
k <- 40; n <- 20
p <- rbeta(k, 6, 4)
y <- rbinom(k, n, p)
fit <- vglm(cbind(y, n - y) ~ 1, betabinomial)
est <- Coef(fit)                                     # mu i rho z modelu beta-dwumianowego
mu <- unname(est["mu"]); rho <- unname(est["rho"])

# Oczekiwana liczba klas z danym wynikiem 0–20 w obu modelach (ta sama średnia 20 · mu)
x <- 0:n
oczek <- rbind(
  data.frame(model = "dwumianowy", x = x, klasy = k * dbinom(x, n, mean(y) / n)),
  data.frame(model = "beta-dwumianowy", x = x, klasy = k * dbetabinom(x, n, prob = mu, rho = rho)))
oczek$model <- factor(oczek$model, levels = names(kol))
obs <- as.data.frame(table(factor(y, levels = x)))
names(obs) <- c("x", "klasy"); obs$x <- as.numeric(as.character(obs$x))
table(y)                                             # ile klas miało daną liczbę zaliczeń

# Ile klas ma skrajne wyniki (≤ 9 lub ≥ 16 zaliczeń): obserwowane vs oczekiwane
skrajne <- function(v, xx) sum(v[xx <= 9 | xx >= 16])
round(c(obserwowane = skrajne(obs$klasy, obs$x),
        dwumianowy = skrajne(oczek$klasy[oczek$model == "dwumianowy"], x),
        beta_dwumianowy = skrajne(oczek$klasy[oczek$model == "beta-dwumianowy"], x)), 1)

pA <- ggplot() +
  geom_col(data = obs, aes(x, klasy), fill = "grey80", colour = "grey35", width = 0.8, linewidth = 0.3) +
  geom_line(data = oczek, aes(x, klasy, colour = model, linetype = model), linewidth = 1) +
  geom_point(data = oczek, aes(x, klasy, colour = model, shape = model), size = 2.2) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = seq(0, 20, 2)) +
  labs(title = sprintf("A. 40 klas po 20 uczniów (słupki) i dopasowane modele; ρ = %.3f", rho),
       x = "Liczba zaliczeń w klasie", y = "Liczba klas") + motyw

# Ile razy wariancja beta-dwumianowa przewyższa dwumianową: 1 + (n − 1)ρ
kraw <- expand.grid(n = 1:60, rho = c(0.01, 0.04, 0.10))
kraw$inflacja <- 1 + (kraw$n - 1) * kraw$rho
kraw$rho_lab <- factor(sprintf("ρ = %.2f", kraw$rho))
round(c(n20_dopasowane = 1 + 19 * rho, n20_rho10 = 1 + 19 * 0.10, n60_rho04 = 1 + 59 * 0.04), 2)
round(c(rho_dopasowane = rho, rho_w_symulacji = 1 / (6 + 4 + 1)), 3)   # beta(6, 4): ρ = 1 / (α + β + 1)

pB <- ggplot(kraw, aes(n, inflacja, linetype = rho_lab)) +
  geom_line(linewidth = 0.9, colour = "#0f1d3a") +
  geom_hline(yintercept = 1, colour = "grey40") +
  geom_vline(xintercept = 20, linetype = "dotted", colour = "grey40") +
  scale_linetype_manual(values = c("dotted", "solid", "dashed"), name = NULL) +
  labs(title = "B. Wariancja beta-dwumianowa / dwumianowa = 1 + (n − 1)ρ",
       x = "Liczba prób w zestawie n (np. uczniów w klasie)", y = "Krotność wariancji") + motyw

p <- pA / pB + plot_layout(heights = c(1.3, 1))
p
Wynik w R
y
 5  6  8  9 10 11 12 13 14 15 16 17
 1  1  3  1  2  5  5  8  2  5  5  2
    obserwowane      dwumianowy beta_dwumianowy
           13.0             6.5            12.2
n20_dopasowane      n20_rho10      n60_rho04
          1.76           2.90           3.36
 rho_dopasowane rho_w_symulacji
          0.040           0.091
Jak opisać w pracy
Rozkład beta-dwumianowy w R
Kod symuluje liczbę zaliczeń w 40 klasach, porównuje wariancję obserwowaną z dwumianową i dopasowuje model beta-dwumianowy funkcją vglm() z rodziną betabinomial z pakietu VGAM.
Nadmierna dyspersja w danych o zaliczeniach
R
# Rozkład beta-dwumianowy: zaliczenia w 40 klasach po 20 uczniów
suppressPackageStartupMessages(library(VGAM))
set.seed(563)
k <- 40; n <- 20
p <- rbeta(k, 6, 4)                    # odsetek zaliczeń różni się między klasami
y <- rbinom(k, n, p)
m <- mean(y) / n
round(c(sr = mean(y), war_obs = var(y), war_dwumian = n * m * (1 - m)), 2)
fit <- vglm(cbind(y, n - y) ~ 1, betabinomial)
est <- Coef(fit)                        # mu = średnie p, rho = korelacja w klasie
round(est, 3)
war_bb <- n * est["mu"] * (1 - est["mu"]) * (1 + (n - 1) * est["rho"])
round(unname(war_bb), 2)                # wariancja beta-dwumianowa
fit_b <- glm(cbind(y, n - y) ~ 1, family = binomial)
round(c(logLik_dwumian = as.numeric(logLik(fit_b)),
        logLik_BB = as.numeric(logLik(fit))), 1)
Wynik w R
         sr     war_obs war_dwumian
      12.50        8.62        4.69
   mu   rho
0.625 0.040
[1] 8.24
logLik_dwumian      logLik_BB
        -102.7          -98.4
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem VGAM 1.1-14. Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- VGAM (wersja 1.1-14): Yee, T. W. (2015). Vector generalized linear and additive models: With an implementation in R. Springer. https://doi.org/10.1007/978-1-4939-2818-7
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak sprawdzić, czy potrzebny jest rozkład beta-dwumianowy?
Porównaj wariancję liczby sukcesów z wariancją dwumianową np(1 − p). W przykładzie było to 8.62 wobec 4.69, czyli wyraźna nadmierna dyspersja. Można też porównać log-wiarygodność obu modeli (tu −102.7 i −98.4).
Co oznacza parametr ρ w rozkładzie beta-dwumianowym?
To korelacja wyników osób z tej samej grupy, np. klasy. Przy ρ = 0 rozkład jest zwykłym dwumianowym. Już małe ρ ma duży wpływ przy dużym n: przy ρ = 0.040 i n = 20 wariancja rośnie o 76%.
Czym model beta-dwumianowy różni się od quasi-dwumianowego?
Model quasi-dwumianowy tylko mnoży wariancję przez stały czynnik i nie ma pełnej funkcji wiarygodności. Model beta-dwumianowy zakłada konkretny rozkład p między grupami, więc pozwala liczyć log-wiarygodność, AIC i testy ilorazu wiarygodności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikZasięg i częstotliwość kampanii
Herbatniki w TV i internecie: zasięg, GRP, rozkład beta-dwumianowy zamiast Poissona, prognoza przy większym budżecie i łączenie kanałów – z kodem R.
Czytaj →PoradnikPozycja w wynikach a CTR – efekt pozycji
Noclegi w agroturystykach: krzywa CTR z logów, błąd selekcji, eksperyment z zamianą pozycji i regresja beta-dwumianowa – sześć rysunków z kodem R.
Czytaj →PoradnikWskaźnik zaangażowania postów
Reakcje / zasięg przy małych i dużych postach: wykres lejkowy, model beta-dwumianowy, wygładzony ranking i formaty – na fikcyjnej sieci restauracji, z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Skellam, J. G. (1948). A probability distribution derived from the binomial distribution by regarding the probability of success as variable between the sets of trials. Journal of the Royal Statistical Society: Series B (Methodological), 10(2), 257–261. https://doi.org/10.1111/j.2517-6161.1948.tb00014.x
- Williams, D. A. (1975). The analysis of binary responses from toxicological experiments involving reproduction and teratogenicity. Biometrics, 31(4), 949. https://doi.org/10.2307/2529820
Cytowania BibTeX
@article{skellam1948probability, author={Skellam, J. G.}, title={{A probability distribution derived from the binomial distribution by regarding the probability of success as variable between the sets of trials}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1948}, volume={10}, number={2}, pages={257--261}, doi={10.1111/j.2517-6161.1948.tb00014.x}}@article{williams1975analysis, author={Williams, D. A.}, title={{The analysis of binary responses from toxicological experiments involving reproduction and teratogenicity}}, journal={Biometrics}, year={1975}, volume={31}, number={4}, pages={949}, doi={10.2307/2529820}}