Przykład: sieć restauracji i pytanie „który post zadziałał najlepiej?”
Fikcyjna sieć restauracji z kuchnią azjatycką prowadzi firmowe konto w serwisie społecznościowym. Przez dwa lata opublikowała 500 postów: 258 zdjęć, 131 filmów wideo i 111 karuzel. Przy każdym poście panel konta podaje zasięg (ile kont zobaczyło post) i reakcje (polubienia, komentarze, udostępnienia). Dział marketingu liczy:
i co miesiąc pokazuje „najlepsze posty”. Pytania brzmią: które posty naprawdę angażują najbardziej i który format wybierać częściej?
Zasięg postów jest bardzo różny: od 30 do 26 952 osób, mediana 756.5. To sedno problemu. Wskaźnik 5% z 40 osób to dwie reakcje – jedna więcej i wychodzi 7.5%. Wśród 119 postów z zasięgiem poniżej 300 surowe wskaźniki rozciągają się od 0% do 11.40% (SD = 2.13 pp), choć prawdziwe zaangażowanie tych postów różni się prawie dwa razy mniej (SD = 1.16 pp). Wśród 36 postów z zasięgiem 5000+ oba rozrzuty są równe (1.21 i 1.20 pp). Ten sam problem przy ocenach gwiazdkowych opisuje wpis o ocenach gwiazdkowych i rankingu produktów, a przy konwersji kampanii – wpis kampania miesiąca i regresja do średniej. Tu mamy odsetki, a nie oceny, i model, który opisuje różnice między postami wprost.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Każdy post ma prawdziwy wskaźnik z rozkładu beta o średniej 4.0% dla zdjęć, 5.0% dla wideo i 4.6% dla karuzel. Reakcje losujemy z rozkładu dwumianowego. Zasięg zależy częściowo od prawdziwego zaangażowania, tak jak przy algorytmie, który podsuwa chętniej posty z reakcjami. 54 posty promowano płatnie. Ziarna 739 nie zmienialiśmy. Parametry zmieniliśmy po pierwszym uruchomieniu w dwóch krokach: różnice między postami zmniejszyliśmy (precyzja rozkładu beta 300 zamiast 100), a postów o małym zasięgu dodaliśmy (mediana zasięgu 700 zamiast 1400, większy rozrzut, minimum 30 zamiast 60). Przy pierwszych ustawieniach różnice prawdziwe zagłuszały przypadek i problem małych postów był ledwo widoczny. Pełna lista – przy kodzie. Dane: wskaznik-zaangazowania-posty-restauracje.csv (kolumna wskaznik_prawdziwy – prawda, w firmie nieznana).
Rysunek 1: wykres lejkowy – skrajne wskaźniki mają małe posty
Zamiast tabeli „najlepszych postów” narysuj wykres lejkowy: wskaźnik względem zasięgu, z granicami, w których post przeciętny może wylądować przez sam przypadek (Spiegelhalter, 2005a). Szare granice liczymy z rozkładu dwumianowego. Zakładają one, że wszystkie posty mają ten sam prawdziwy wskaźnik.
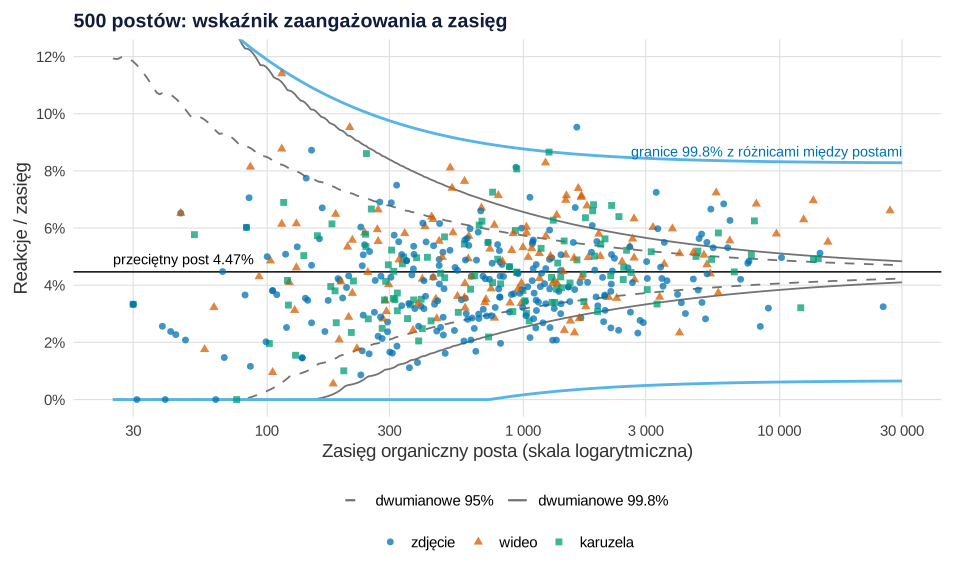
set.seed(739)).Co widać. Lejek jest szeroki po lewej: najwyższy wskaźnik (11.40%) ma film P378 z zasięgiem 114, a 0% – zdjęcie P120 z zasięgiem 40. Ale poza szare granice 95% wychodzi 165 postów, choć przy samym przypadku byłoby ich około 25, a poza 99.8% – 84 zamiast jednego. Posty naprawdę się różnią. To nadmierna dyspersja: rozrzut większy, niż daje rozkład dwumianowy (Spiegelhalter, 2005b). Niebieskie granice uwzględniają różnice między postami. Poza nimi leżą 22 posty (95%) i 1 post (99.8%) – tyle, ile dałby przypadek.
Jak może zmylić. Wąskie granice dwumianowe przy dużym zasięgu każą „wyróżniać” połowę dużych postów. Z poszerzonymi granicami żaden post nie odstaje wyraźnie, co nie znaczy, że wszystkie są takie same – tylko że różnice mieszczą się w typowym rozrzucie.
Podpis do pracy:
Rysunek 2: model beta-dwumianowy i ważenie z przeciętnym postem
Model łączy dwa źródła zmienności. Każdy post ma własny prawdziwy wskaźnik p, a te wskaźniki pochodzą z rozkładu beta o parametrach α i β. Reakcje to wynik losowania z p wśród osób z zasięgu. Razem daje to rozkład beta-dwumianowy – ten sam, którym Williams (1975) opisywał odpowiedzi w miotach o różnym ryzyku. Parametry szacujemy metodą największej wiarygodności: w R wystarczy funkcja log-wiarygodności i optim, wynik sprawdzamy w pakiecie VGAM.
Przeciętny post ma wskaźnik μ = 4.47%, 95% CI [4.34, 4.60], a prawdziwe wskaźniki postów różnią się o SD = 1.23 pp. α = 12.6 i β = 268.6, więc α + β = 281. Model beta-dwumianowy pasuje znacznie lepiej niż dwumianowy: log-wiarygodność −1912.2 wobec −2967.6, LR = 2110.8, p < .001 (test ilorazu wiarygodności).
Z tego modelu wynika prosta reguła ważenia z przeciętnym postem: do reakcji posta dodaj α „pozornych reakcji”, a do zasięgu α + β „pozornych osób”.
To średnia ważona surowego wskaźnika i średniej μ. Waga danych posta wynosi zasięg / (zasięg + α + β): .26 przy zasięgu 100, .52 przy 300, .78 przy 1000 i .97 przy 10 000. To samo „ściąganie do średniej” Efron i Morris (1975) pokazali na średnich skuteczności zawodników baseballu: takie oszacowania myliły się średnio mniej niż surowe.
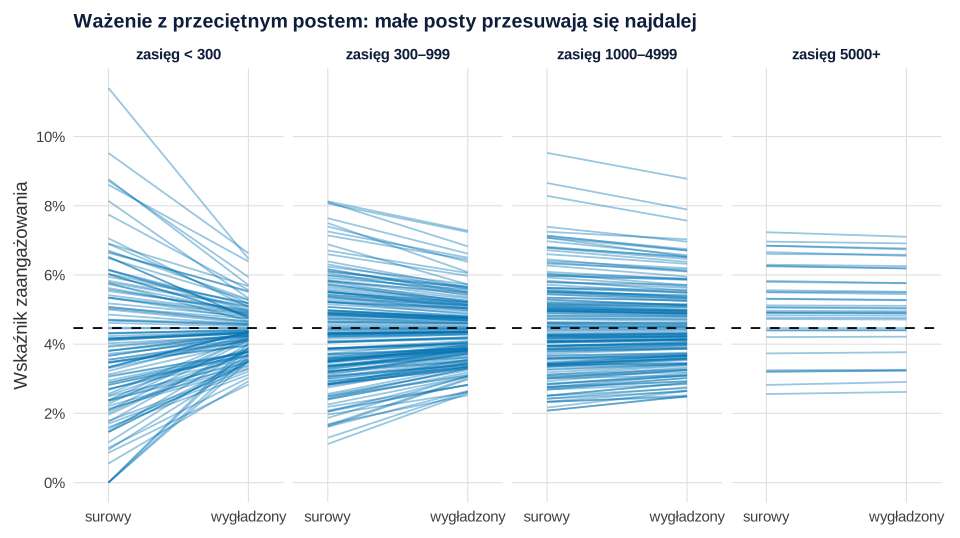
Co widać. Posty o małym zasięgu przesuwają się najdalej. P378 (13 reakcji na 114 osób, 11.40%) po wygładzeniu ma 6.47%, a jego prawdziwy wskaźnik to 5.41%. P120 (0 na 40) dostaje 3.91% (prawdziwy: 1.92%). Wygładzone wskaźniki mieszczą się między 2.47% a 8.78%, bliżej prawdziwych (1.20–8.82%) niż surowe (0–11.40%). Średni błąd względem prawdy (pierwiastek z błędu średniokwadratowego) spada z 0.98 do 0.68 pp.
Jak może zmylić. Wygładzanie zaniża naprawdę wyjątkowe małe posty – P120 jest gorszy, niż mówi 3.91%. To cena mniejszego średniego błędu.
Zdanie do Wyników:
Rysunek 3: karta „ten sam wskaźnik, różny zasięg”
Do rozmowy z zespołem przyda się karta z trzema postami o tym samym wskaźniku 7.5%.
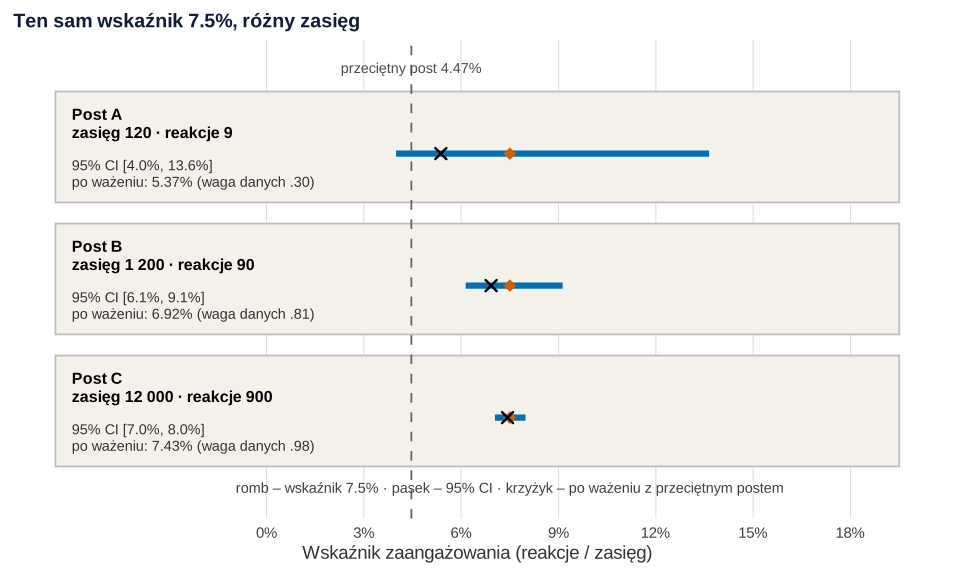
Co widać. Przy zasięgu 120 przedział ufności Wilsona (Brown i in., 2001) obejmuje wartości od 4.0% do 13.6%, a po ważeniu zostaje 5.37%. Przy zasięgu 12 000 przedział ma szerokość niecałego 1 pp, a wygładzony wskaźnik (7.43%) prawie nie różni się od surowego.
Jak może zmylić. Karta pokazuje niepewność losowania osób z zasięgu, nie to, czy post „zadziałał” dzięki treści, porze czy algorytmowi.
Rysunek 4: trzy rankingi – surowy, wygładzony i dolna granica przedziału
Ułożyliśmy dziesiątkę najlepszych postów trzema sposobami: według surowego wskaźnika, wskaźnika wygładzonego i dolnej granicy 95% przedziału Wilsona. Dane są fikcyjne, więc wiemy, które posty są naprawdę w pierwszej dziesiątce.
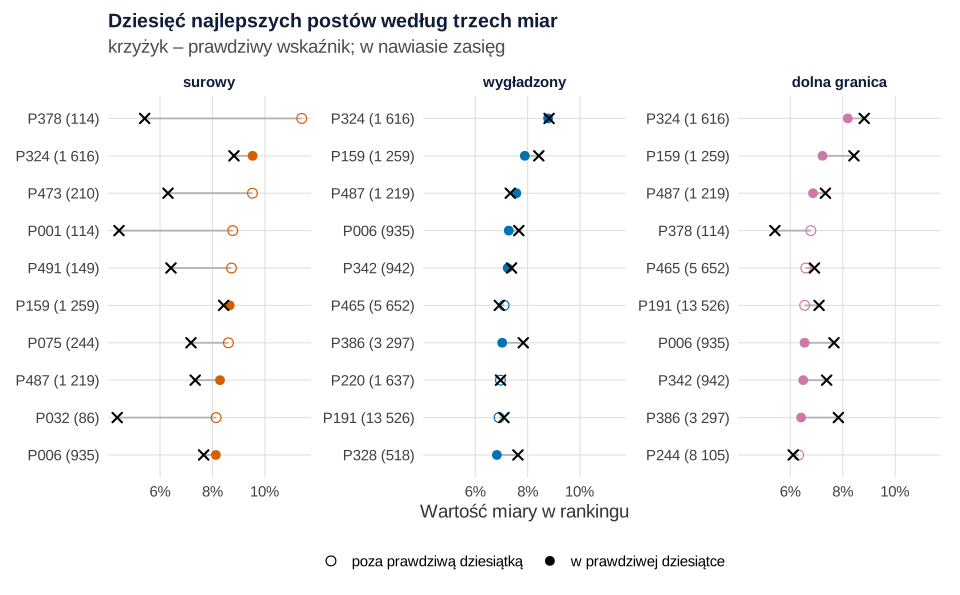
Co widać. Surowy ranking to w większości małe posty: 6 z 10 ma zasięg poniżej 300 (mediana 227), w prawdziwej dziesiątce są tylko 4, a ich prawdziwy wskaźnik wynosi średnio 6.64%. Ranking wygładzony trafia 7 postów (średnio 7.61%; prawdziwa dziesiątka ma 7.82%), dolna granica – 6 (7.30%). W 300 nowych zestawach danych z tymi samymi parametrami (set.seed(7391)) surowy ranking trafiał średnio 4.08 posta z prawdziwej dziesiątki, wygładzony 6.18, a dolna granica 6.02 (błąd Monte Carlo 0.08).
Jak może zmylić. Dolna granica karze małe posty podwójnie – za niepewność i za niski wynik – i zaniża wartości wszystkich (fioletowe punkty leżą zwykle na lewo od krzyżyków). Wygładzony wskaźnik da się czytać jak zwykły odsetek. Pozycje 5–10 i tak są niepewne, a wybranie zwycięzców zawyża ich wynik – to klątwa zwycięzcy.
Zdanie do Wyników:
Rysunek 5: zdjęcie, wideo czy karuzela?
Drugie pytanie dotyczy formatów. Porównaliśmy trzy podejścia: średnią surowych wskaźników postów, regresję logistyczną na reakcjach (każda osoba z zasięgu jak niezależna próba) i regresję beta-dwumianową z formatem (VGAM, funkcja vglm).
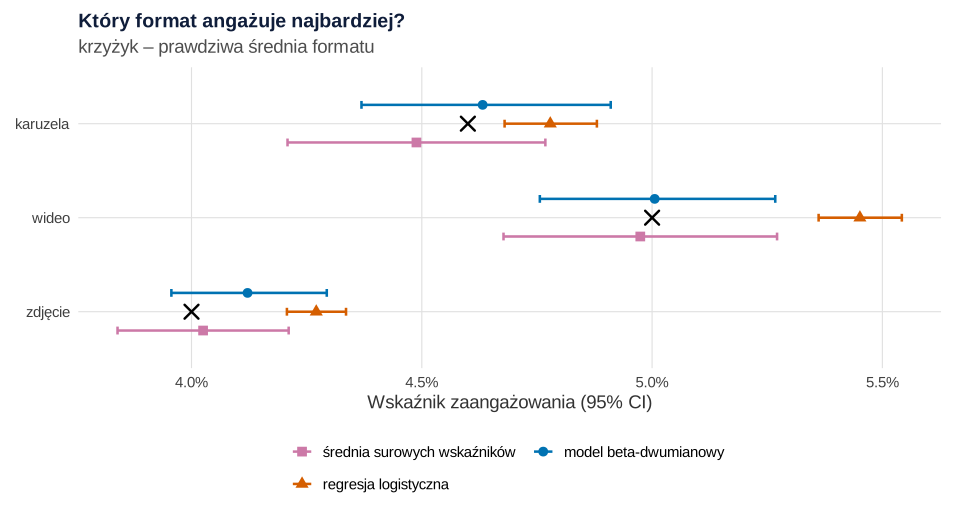
Co widać. Model beta-dwumianowy daje 4.12% dla zdjęć, 5.01% dla wideo i 4.63% dla karuzel – blisko prawdy (4.0, 5.0 i 4.6%). Wideo ma 1.23 raza większe szanse reakcji niż zdjęcie (iloraz szans OR = 1.23, 95% CI [1.15, 1.31], p < .001), karuzela 1.13 raza (95% CI [1.05, 1.22], p = .001); format jako całość: LR(2) = 33.59, p < .001. Regresja logistyczna zawyża wszystkie trzy wskaźniki, bo duże posty mają w niej największą wagę, a przy tych danych duże posty to częściej posty lepsze. Jej przedziały są średnio 2.7 raza węższe (0.17 wobec 0.46 pp) i żaden nie obejmuje prawdy. Średnia surowych wskaźników jest tu bliska prawdy, ale ma najszersze przedziały, bo każdy mały post liczy się tak samo jak duży.
Jak może zmylić. Formatu nie losowano. Jeśli filmy powstawały do ciekawszych tematów (nowe danie, otwarcie lokalu), część „efektu wideo” jest efektem tematu. Pewność daje dopiero eksperyment: losowy format dla podobnych treści, analizowany jak test A/B.
Zdanie do Metody:
Rysunek 6: pułapki – algorytm, reklama płatna i definicja zasięgu
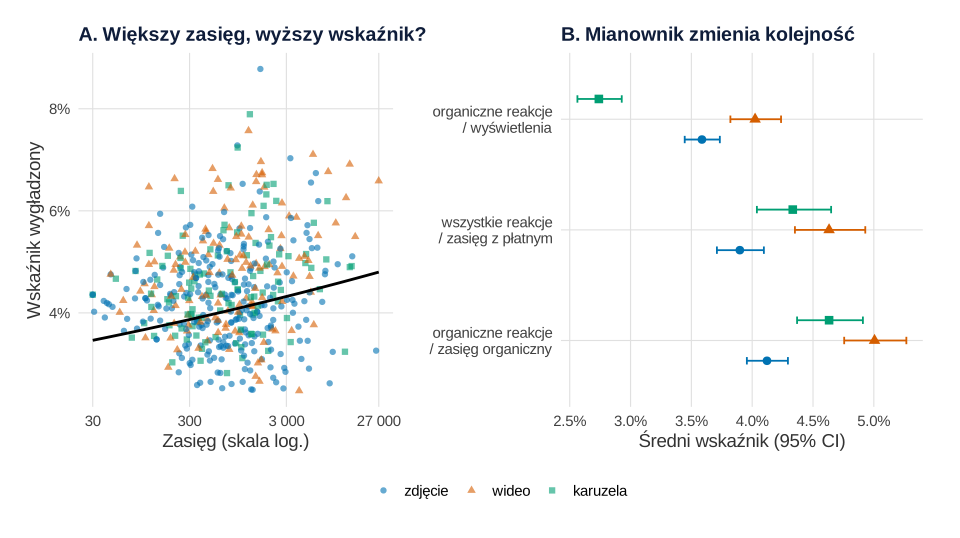
- Zasięg zależy od reakcji – zależność biegnie w obie strony. Wskaźnik rośnie z zasięgiem: każde dziesięciokrotne zwiększenie zasięgu to OR = 1.12 (b = 0.115, SE = 0.030). Nie znaczy to, że większy zasięg „powoduje” zaangażowanie. W danych jest odwrotnie: algorytm daje większy zasięg postom, na które ludzie reagują (korelacja log zasięgu z prawdziwym wskaźnikiem r = .27). Zob. korelacja a przyczynowość. Skoro duże posty są średnio lepsze, sprawdziliśmy ważenie ze średnią zależną od zasięgu i formatu. Tu dziesiątka się nie zmieniła, ale przy silniejszym sprzężeniu może. Co zwiększa sam zasięg, opisuje wpis co zwiększa zasięg posta.
- Reakcje płatne i organiczne. W 54 postach promowanych mediana wskaźnika organicznego wynosi 4.04%, a liczonego ze wszystkimi reakcjami i zasięgiem płatnym – 2.14%. Odbiorcy reklamy reagują rzadziej. Mieszanie obu obniża średnie formatów (panel B) i karze posty promowane w rankingu.
- Różne definicje zasięgu. Zasięg liczy osoby, wyświetlenia – kontakty. Karuzelę przegląda się kilka razy, więc w przeliczeniu na wyświetlenia spada z 4.63% na 2.74% i z drugiego miejsca na ostatnie. Wybierz jedną definicję przed analizą i podaj ją w opisie. Różnicę między zasięgiem a częstotliwością omawia wpis zasięg i częstotliwość kampanii.
- Reakcje to nie osoby. Jedna osoba może polubić i skomentować. Wtedy wskaźnik nie jest już odsetkiem osób, a model dwumianowy pasuje gorzej. Licz osoby z reakcją albo jeden typ reakcji.
Podpis do pracy:
Co z tym zrobić w marketingu
- Zamień miesięczną listę „najlepszych postów” na wykres lejkowy z granicami uwzględniającymi różnice między postami. Raz na kwartał przelicz α i β.
- Ranking układaj według wskaźnika wygładzonego, a nie surowego. Post z zasięgiem 120 i wskaźnikiem 7.5% to dla raportu post z ok. 5.4%.
- Nie wyciągaj wniosków z pojedynczych hitów. Wzór do powtórzenia buduj z grupy postów (format, temat, pora), a nie z jednego posta z czoła rankingu.
- Wideo publikuj częściej, ale sprawdź to testem. Różnica 0.9 pp między wideo a zdjęciem jest wyraźna w modelu, ale format mieszał się z tematem.
- Raportuj organiczne i płatne osobno i zapisz w raporcie, czy mianownik to zasięg, czy wyświetlenia. Więcej przykładów w zestawieniu statystyka w pracy z marketingu.
Jak opisać w pracy
Podaj, skąd pochodzą zasięg i reakcje (organiczne czy z płatnymi), jak zdefiniowano wskaźnik, rozkład zasięgu, model i sposób rankingu. Gdy porównujesz grupy postów, nie traktuj każdego wyświetlenia jak osobnej obserwacji – podobny problem opisuje wpis o wskaźnikach ilorazowych w testach A/B.
| Format | n | Średnia surowych wskaźników [95% CI] | Regresja logistyczna [95% CI] | Model beta-dwumianowy [95% CI] |
|---|---|---|---|---|
| Zdjęcie | 258 | 4.03% [3.84, 4.21] | 4.27% [4.21, 4.34] | 4.12% [3.96, 4.29] |
| Wideo | 131 | 4.97% [4.68, 5.27] | 5.45% [5.36, 5.54] | 5.01% [4.76, 5.27] |
| Karuzela | 111 | 4.49% [4.21, 4.77] | 4.78% [4.68, 4.88] | 4.63% [4.37, 4.91] |
Jeśli porównujesz wiele postów lub formatów naraz, pamiętaj o problemie wielokrotnych porównań, a wyjaśnienie, czemu zwycięzcy w kolejnym okresie wypadają gorzej, znajdziesz w haśle regresja do średniej.
Kod R: wskaźnik zaangażowania, model beta-dwumianowy i rankingi
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę kol, motyw motyw i funkcje pomocnicze, z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(739)) i 5 (set.seed(7391), 300 powtórzeń); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 500 postów z dwóch lat; udziały formatów 50/25/25%; prawdziwe średnie wskaźnika 4.0% (zdjęcie), 5.0% (wideo) i 4.6% (karuzela) oraz precyzję rozkładu beta α + β = 300; zasięg organiczny z rozkładu log-normalnego (mediana 700, odchylenie logarytmu 1.2, minimum 30) pomnożony przez exp(0.4 × standaryzowany logit prawdziwego wskaźnika) – to sprzężenie z algorytmem; 12% postów promowanych z płatnym zasięgiem 2–6 razy większym od organicznego i wskaźnikiem odbiorców płatnych równym 0.4 wskaźnika organicznego; liczbę wyświetleń na osobę 1.15 (zdjęcie), 1.25 (wideo) i 1.70 (karuzela). Zmiany po pierwszym uruchomieniu: precyzja beta 100 → 300, mediana zasięgu 1400 → 900 → 700, odchylenie logarytmu zasięgu 0.9 → 1.0 → 1.2, minimum zasięgu 60 → 30 – przy pierwszych ustawieniach różnice prawdziwe zagłuszały przypadek, a postów z zasięgiem poniżej 100 prawie nie było. Poza tym poprawiano tylko wygląd rysunków (położenie etykiet, rezygnacja z punktów na Rysunku 2, żeby plik był mniejszy, kolor dolnej granicy). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilkanaście sekund.
1. Dane: 500 postów, zasięg i reakcje
R
# Przepis 1. Fikcyjna sieć restauracji z kuchnią azjatycką: 500 postów z 2 lat, zasięg i reakcje
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("zdjęcie" = "#0072B2", "wideo" = "#D55E00", "karuzela" = "#009E73",
         "surowy" = "#D55E00", "wygładzony" = "#0072B2", "dolna granica" = "#CC79A7",
         "prawda" = "#000000", "granica" = "grey45")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))
minus <- function(x) gsub("-", "−", x)          # znak minus (U+2212) w etykietach
proc <- function(x, d = 1) minus(sprintf(paste0("%.", d, "f%%"), 100 * x))

set.seed(739)
n <- 500
format <- factor(sample(c("zdjęcie", "wideo", "karuzela"), n, replace = TRUE, prob = c(.50, .25, .25)),
                 levels = c("zdjęcie", "wideo", "karuzela"))
data <- sort(as.Date("2024-11-01") + sample(0:729, n, replace = TRUE))

# Prawdziwy wskaźnik zaangażowania posta (odsetek osób z zasięgu, które zareagowały):
# rozkład beta ze średnią zależną od formatu i „precyzją” phi = alfa + beta = 300
mu_prawdziwe <- c("zdjęcie" = 0.040, "wideo" = 0.050, "karuzela" = 0.046)
phi <- 300
p <- rbeta(n, mu_prawdziwe[format] * phi, (1 - mu_prawdziwe[format]) * phi)

# Zasięg organiczny: rozkład log-normalny (mediana 700) i sprzężenie z algorytmem serwisu –
# post z większym zaangażowaniem dostaje większy zasięg (exp(0.4 × standaryzowany logit p))
z <- (qlogis(p) - mean(qlogis(p))) / sd(qlogis(p))
zasieg <- pmax(30, round(700 * exp(rnorm(n, 0, 1.2)) * exp(0.4 * z)))
reakcje <- rbinom(n, zasieg, p)                      # reakcje organiczne (osoby z zasięgu)

# Część postów promowano płatnie: płatny zasięg 2–6 razy większy od organicznego, odbiorcy reagują rzadziej
promowany <- rbinom(n, 1, 0.12)
zasieg_platny <- ifelse(promowany == 1, round(zasieg * runif(n, 2, 6)), 0)
reakcje_platne <- rbinom(n, zasieg_platny, 0.4 * p)
# Wyświetlenia (ten sam odbiorca może zobaczyć post kilka razy): średnio 1.15, 1.25 i 1.70 razy
krotnosc <- c("zdjęcie" = 1.15, "wideo" = 1.25, "karuzela" = 1.70)
wyswietlenia <- round(zasieg * krotnosc[format] * exp(rnorm(n, 0, 0.05)))

posty <- data.frame(id = sprintf("P%03d", 1:n), data, format, zasieg, reakcje, wyswietlenia,
                    promowany, zasieg_platny, reakcje_platne, wskaznik_prawdziwy = round(p, 5))
write.csv(posty, "wskaznik-zaangazowania-posty-restauracje.csv", row.names = FALSE, fileEncoding = "UTF-8")

posty$wskaznik <- posty$reakcje / posty$zasieg      # surowy wskaźnik zaangażowania
print(table(posty$format))
round(c(mediana_zasiegu = median(posty$zasieg), min_zasieg = min(posty$zasieg), max_zasieg = max(posty$zasieg),
        reakcje_razem = sum(posty$reakcje), wskaznik_laczny = sum(posty$reakcje) / sum(posty$zasieg),
        sredni_wskaznik = mean(posty$wskaznik), promowane = sum(posty$promowany)), 4)
# Rozrzut surowego wskaźnika w małych i dużych postach
posty$klasa <- cut(posty$zasieg, c(0, 300, 1000, 5000, Inf), labels = c("< 300", "300–999", "1000–4999", "5000+"),
                   right = FALSE)
do.call(rbind, lapply(split(posty, posty$klasa), function(d)
  round(c(posty = nrow(d), min = min(d$wskaznik), max = max(d$wskaznik), sd = sd(d$wskaznik),
          sd_prawdziwego = sd(d$wskaznik_prawdziwy)), 4)))
Wynik w R
 zdjęcie    wideo karuzela
     258      131      111
mediana_zasiegu      min_zasieg      max_zasieg   reakcje_razem wskaznik_laczny sredni_wskaznik       promowane
       756.5000         30.0000      26952.0000      37845.0000          0.0474          0.0438         54.0000
          posty    min    max     sd sd_prawdziwego
< 300       119 0.0000 0.1140 0.0213         0.0116
300–999     174 0.0111 0.0813 0.0143         0.0117
1000–4999   171 0.0208 0.0953 0.0137         0.0127
5000+        36 0.0256 0.0724 0.0121         0.0120
2. Model beta-dwumianowy przez optim i wykres lejkowy: Rysunek 1
R
# Przepis 2. Model beta-dwumianowy liczony ręcznie (optim) i wykres lejkowy: Rysunek 1
# Ujemna log-wiarygodność rozkładu beta-dwumianowego; parametry: logit średniej i log(alfa + beta)
nll <- function(th, y, n) {
  m <- plogis(th[1]); s <- exp(th[2])
  -sum(lchoose(n, y) + lbeta(y + m * s, n - y + (1 - m) * s) - lbeta(m * s, (1 - m) * s))
}
fit <- optim(c(qlogis(0.05), log(100)), nll, y = posty$reakcje, n = posty$zasieg, control = list(reltol = 1e-12), hessian = TRUE)
se <- sqrt(diag(solve(fit$hessian)))
mu <- plogis(fit$par[1]); s <- exp(fit$par[2])           # średnia „przeciętnego posta” i alfa + beta
a <- mu * s; b <- (1 - mu) * s; rho <- 1 / (s + 1)
round(c(mu = mu, mu_dolna = plogis(fit$par[1] - 1.96 * se[1]), mu_gorna = plogis(fit$par[1] + 1.96 * se[1]),
        alfa = a, beta = b, alfa_plus_beta = s, rho = rho, sd_prawdziwych = sqrt(mu * (1 - mu) / (s + 1))), 4)
# Porównanie z rozkładem dwumianowym (jeden wskaźnik dla wszystkich postów)
p0 <- sum(posty$reakcje) / sum(posty$zasieg)
ll_dwum <- sum(dbinom(posty$reakcje, posty$zasieg, p0, log = TRUE))
round(c(logLik_dwumianowy = ll_dwum, logLik_beta_dwumianowy = -fit$value, LR = 2 * (-fit$value - ll_dwum)), 1)
# Kontrola: ten sam model w pakiecie VGAM (parametry mu i rho)
suppressPackageStartupMessages(library(VGAM))
m0 <- vglm(cbind(reakcje, zasieg - reakcje) ~ 1, betabinomial, data = posty)
round(Coef(m0), 4)

# Granice lejka wokół przeciętnego posta: dwumianowe (dokładne, z interpolacją) i poszerzone o różnice między postami
granica_dwum <- function(n, q, p) {
  r <- qbinom(q, n, p)
  pmax(0, (r - (pbinom(r, n, p) - q) / (pbinom(r, n, p) - pbinom(r - 1, n, p))) / n)
}
siatka <- data.frame(n = round(10^seq(log10(25), log10(30000), length.out = 300)))
for (q in c(.001, .025, .975, .999)) siatka[[paste0("d", q)]] <- granica_dwum(siatka$n, q, mu)
sd_bb <- function(n) sqrt(mu * (1 - mu) * (rho + (1 - rho) / n))   # SD wskaźnika w modelu beta-dwumianowym
siatka$b_dol95 <- pmax(0, mu - 1.96 * sd_bb(siatka$n)); siatka$b_gora95 <- mu + 1.96 * sd_bb(siatka$n)
siatka$b_dol998 <- pmax(0, mu - 3.09 * sd_bb(siatka$n)); siatka$b_gora998 <- mu + 3.09 * sd_bb(siatka$n)

poza <- function(lo, hi) sum(posty$wskaznik < lo | posty$wskaznik > hi)
posty$d_lo95 <- granica_dwum(posty$zasieg, .025, mu); posty$d_hi95 <- granica_dwum(posty$zasieg, .975, mu)
posty$d_lo998 <- granica_dwum(posty$zasieg, .001, mu); posty$d_hi998 <- granica_dwum(posty$zasieg, .999, mu)
c(poza_dwum_95 = poza(posty$d_lo95, posty$d_hi95), poza_dwum_998 = poza(posty$d_lo998, posty$d_hi998),
  poza_beta_95 = poza(mu - 1.96 * sd_bb(posty$zasieg), mu + 1.96 * sd_bb(posty$zasieg)),
  poza_beta_998 = poza(mu - 3.09 * sd_bb(posty$zasieg), mu + 3.09 * sd_bb(posty$zasieg)),
  oczekiwane_95 = 0.05 * nrow(posty), oczekiwane_998 = 0.002 * nrow(posty))
# Najwyższy i najniższy surowy wskaźnik
posty[c(which.max(posty$wskaznik), which.min(posty$wskaznik)), c("id", "format", "zasieg", "reakcje", "wskaznik")]

p1 <- ggplot(posty, aes(zasieg, wskaznik)) +
  geom_line(data = siatka, aes(n, d0.025, linetype = "dwumianowe 95%"), colour = "grey45") +
  geom_line(data = siatka, aes(n, d0.975, linetype = "dwumianowe 95%"), colour = "grey45") +
  geom_line(data = siatka, aes(n, d0.001, linetype = "dwumianowe 99.8%"), colour = "grey45") +
  geom_line(data = siatka, aes(n, d0.999, linetype = "dwumianowe 99.8%"), colour = "grey45") +
  geom_line(data = siatka, aes(n, b_dol998), colour = "#56B4E9", linewidth = 1) +
  geom_line(data = siatka, aes(n, b_gora998), colour = "#56B4E9", linewidth = 1) +
  geom_hline(yintercept = mu, colour = "black", linewidth = 0.5) +
  geom_point(aes(colour = format, shape = format), size = 2, alpha = 0.75) +
  annotate("text", x = 30000, y = mu + 3.09 * sd_bb(30000) + 0.004, hjust = 1, size = 3.8, colour = "#0072B2",
           label = "granice 99.8% z różnicami między postami") +
  annotate("text", x = 25, y = mu + 0.0045, hjust = 0, size = 3.8,
           label = paste0("przeciętny post ", proc(mu, 2))) +
  scale_x_log10(breaks = c(30, 100, 300, 1000, 3000, 10000, 30000),
                labels = function(x) format(x, big.mark = " ", scientific = FALSE)) +
  scale_y_continuous(labels = function(x) proc(x, 0), breaks = seq(0, 0.12, 0.02)) +
  coord_cartesian(ylim = c(0, 0.12)) +
  scale_colour_manual(values = kol[c("zdjęcie", "wideo", "karuzela")], name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_linetype_manual(values = c("dwumianowe 95%" = "dashed", "dwumianowe 99.8%" = "solid"), name = NULL) +
  labs(title = "500 postów: wskaźnik zaangażowania a zasięg",
       x = "Zasięg organiczny posta (skala logarytmiczna)", y = "Reakcje / zasięg") +
  motyw + theme(legend.box = "vertical", legend.spacing.y = unit(0, "pt"))
p1   # ggsave("wskaznik-zaangazowania-lejek.svg", p1, width = 10, height = 6)
Wynik w R
            mu       mu_dolna       mu_gorna           alfa           beta alfa_plus_beta            rho sd_prawdziwych
        0.0447         0.0434         0.0460        12.5580       268.5878       281.1457         0.0035         0.0123
     logLik_dwumianowy logLik_beta_dwumianowy                     LR
               -2967.6                -1912.2                 2110.8
    mu    rho
0.0447 0.0035
  poza_dwum_95  poza_dwum_998   poza_beta_95  poza_beta_998  oczekiwane_95 oczekiwane_998
           165             84             22              1             25              1
      id  format zasieg reakcje  wskaznik
378 P378   wideo    114      13 0.1140351
120 P120 zdjęcie     40       0 0.0000000
3. Ważenie z przeciętnym postem: Rysunek 2
R
# Przepis 3. Ważenie z przeciętnym postem: wskaźnik wygładzony i waga własnych danych posta: Rysunek 2
# Wskaźnik wygładzony = (reakcje + alfa) / (zasięg + alfa + beta); waga danych posta = zasięg / (zasięg + alfa + beta)
posty$wygladzony <- (posty$reakcje + a) / (posty$zasieg + a + b)
posty$waga <- posty$zasieg / (posty$zasieg + a + b)
round(c(waga_100 = 100 / (100 + s), waga_300 = 300 / (300 + s), waga_1000 = 1000 / (1000 + s),
        waga_10000 = 10000 / (10000 + s)), 3)
# Rozrzut i błąd względem prawdy (prawdę znamy, bo dane są fikcyjne)
blad <- function(x) sqrt(mean((x - posty$wskaznik_prawdziwy)^2))
round(rbind(surowy = c(min = min(posty$wskaznik), max = max(posty$wskaznik), sd = sd(posty$wskaznik),
                       blad_sredniokwadratowy = blad(posty$wskaznik)),
            wygladzony = c(min(posty$wygladzony), max(posty$wygladzony), sd(posty$wygladzony), blad(posty$wygladzony)),
            prawdziwy = c(min(posty$wskaznik_prawdziwy), max(posty$wskaznik_prawdziwy), sd(posty$wskaznik_prawdziwy), 0)), 4)
# Dwa skrajne posty z przepisu 2 po wygładzeniu
posty[c(which.max(posty$wskaznik), which.min(posty$wskaznik)),
      c("id", "zasieg", "reakcje", "wskaznik", "wygladzony", "waga", "wskaznik_prawdziwy")]

p2 <- ggplot(posty) +
  geom_segment(aes(x = 1, xend = 2, y = wskaznik, yend = wygladzony), alpha = 0.4, colour = kol[["wygładzony"]]) +
  geom_hline(yintercept = mu, linetype = "dashed") +
  facet_wrap(~ klasa, nrow = 1, labeller = labeller(klasa = function(x) paste("zasięg", x))) +
  scale_x_continuous(breaks = 1:2, labels = c("surowy", "wygładzony"), expand = expansion(add = 0.25)) +
  scale_y_continuous(labels = function(x) proc(x, 0), breaks = seq(0, 0.12, 0.02)) +
  labs(title = "Ważenie z przeciętnym postem: małe posty przesuwają się najdalej",
       x = NULL, y = "Wskaźnik zaangażowania") +
  motyw
p2   # ggsave("wskaznik-zaangazowania-wazenie.svg", p2, width = 10, height = 5.6)
Wynik w R
  waga_100   waga_300  waga_1000 waga_10000
     0.262      0.516      0.781      0.973
              min    max     sd blad_sredniokwadratowy
surowy     0.0000 0.1140 0.0161                 0.0098
wygladzony 0.0247 0.0878 0.0102                 0.0068
prawdziwy  0.0120 0.0882 0.0124                 0.0000
      id zasieg reakcje  wskaznik wygladzony      waga wskaznik_prawdziwy
378 P378    114      13 0.1140351 0.06467982 0.2885011            0.05413
120 P120     40       0 0.0000000 0.03910360 0.1245540            0.01917
4. Karta „ten sam wskaźnik, różny zasięg”: Rysunek 3
R
# Przepis 4. Karta „ten sam wskaźnik, różny zasięg”: Rysunek 3
wilson <- function(y, n, z = 1.96) {                 # przedział Wilsona dla odsetka
  ph <- y / n; srodek <- (ph + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(ph * (1 - ph) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  cbind(dolna = srodek - pol, gorna = srodek + pol)
}
karta <- data.frame(post = c("Post A", "Post B", "Post C"), zasieg = c(120, 1200, 12000), reakcje = c(9, 90, 900))
karta <- cbind(karta, wskaznik = karta$reakcje / karta$zasieg, wilson(karta$reakcje, karta$zasieg),
               wygladzony = (karta$reakcje + a) / (karta$zasieg + a + b), waga = karta$zasieg / (karta$zasieg + a + b))
print(karta, digits = 3)

karta$y <- 3:1
karta$opis <- sprintf("%s\nzasięg %s · reakcje %s", karta$post, formatC(karta$zasieg, big.mark = " ", format = "d"),
                      formatC(karta$reakcje, big.mark = " ", format = "d"))
karta$tekst <- sprintf("95%% CI [%s, %s]\npo ważeniu: %s (waga danych %s)", proc(karta$dolna), proc(karta$gorna),
                       proc(karta$wygladzony, 2), sub("^0", "", sprintf("%.2f", karta$waga)))
p3 <- ggplot(karta) +
  geom_rect(aes(xmin = -0.065, xmax = 0.195, ymin = y - 0.42, ymax = y + 0.42), fill = "#F4F1EA", colour = "grey75") +
  geom_text(aes(x = -0.06, y = y + 0.18, label = opis), hjust = 0, size = 4.2, fontface = "bold", lineheight = 0.95) +
  geom_text(aes(x = -0.06, y = y - 0.2, label = tekst), hjust = 0, size = 3.8, lineheight = 0.95, colour = "grey20") +
  geom_segment(aes(x = dolna, xend = gorna, y = y - 0.05, yend = y - 0.05), linewidth = 2.2, colour = "#0072B2") +
  geom_point(aes(x = wskaznik, y = y - 0.05), size = 4, colour = "#D55E00", shape = 18) +
  geom_point(aes(x = wygladzony, y = y - 0.05), size = 3, colour = "black", shape = 4, stroke = 1.3) +
  geom_vline(xintercept = mu, linetype = "dashed", colour = "grey40") +
  annotate("text", x = mu, y = 3.6, label = paste0("przeciętny post ", proc(mu, 2)), size = 3.8, colour = "grey30") +
  annotate("text", x = 0.075, y = 0.42, size = 3.8, colour = "grey25",
           label = "romb – wskaźnik 7.5%  ·  pasek – 95% CI  ·  krzyżyk – po ważeniu z przeciętnym postem") +
  scale_x_continuous(limits = c(-0.065, 0.195), breaks = seq(0, 0.18, 0.03), labels = function(x) proc(x, 0)) +
  scale_y_continuous(limits = c(0.35, 3.65)) +
  labs(title = "Ten sam wskaźnik 7.5%, różny zasięg", x = "Wskaźnik zaangażowania (reakcje / zasięg)", y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p3   # ggsave("wskaznik-zaangazowania-karta.svg", p3, width = 10, height = 6)
Wynik w R
    post zasieg reakcje wskaznik  dolna  gorna wygladzony  waga
1 Post A    120       9    0.075 0.0400 0.1364     0.0537 0.299
2 Post B   1200      90    0.075 0.0614 0.0913     0.0692 0.810
3 Post C  12000     900    0.075 0.0704 0.0798     0.0743 0.977
5. Trzy rankingi i ich powtórzenie na 300 zestawach danych: Rysunek 4
R
# Przepis 5. Trzy rankingi: surowy wskaźnik, wskaźnik wygładzony i dolna granica przedziału Wilsona: Rysunek 4
posty$dolna <- wilson(posty$reakcje, posty$zasieg)[, "dolna"]
prawdziwa_10 <- order(-posty$wskaznik_prawdziwy)[1:10]
metody <- c(surowy = "wskaznik", "wygładzony" = "wygladzony", "dolna granica" = "dolna")
top <- do.call(rbind, lapply(names(metody), function(m) {
  o <- order(-posty[[metody[m]]])[1:10]
  data.frame(metoda = m, miejsce = 1:10, id = posty$id[o], zasieg = posty$zasieg[o], wartosc = posty[[metody[m]]][o],
             prawdziwy = posty$wskaznik_prawdziwy[o], w_prawdziwej_10 = o %in% prawdziwa_10)
}))
print(subset(top, metoda == "surowy"), digits = 3, row.names = FALSE)
do.call(rbind, lapply(split(top, top$metoda), function(d)
  round(c(w_prawdziwej_10 = sum(d$w_prawdziwej_10), sredni_prawdziwy = mean(d$prawdziwy),
          mediana_zasiegu = median(d$zasieg), zasieg_ponizej_300 = sum(d$zasieg < 300)), 4)))
tapply(sprintf("%s (%d)", top$id, top$zasieg), top$metoda, paste, collapse = ", ")   # posty i zasięg w każdej dziesiątce
round(c(sredni_prawdziwy_prawdziwej_10 = mean(posty$wskaznik_prawdziwy[prawdziwa_10])), 4)

# Powtórzenie: 300 nowych zestawów 500 postów z tymi samymi parametrami (bez postów płatnych i wyświetleń)
set.seed(7391)
jeden_zestaw <- function() {
  f <- sample(names(mu_prawdziwe), 500, replace = TRUE, prob = c(.50, .25, .25))
  pp <- rbeta(500, mu_prawdziwe[f] * phi, (1 - mu_prawdziwe[f]) * phi)
  zz <- (qlogis(pp) - mean(qlogis(pp))) / sd(qlogis(pp))
  nn <- pmax(30, round(700 * exp(rnorm(500, 0, 1.2)) * exp(0.4 * zz)))
  yy <- rbinom(500, nn, pp)
  th <- optim(c(qlogis(0.05), log(100)), nll, y = yy, n = nn, control = list(reltol = 1e-10))$par
  m <- plogis(th[1]); ss <- exp(th[2])
  oceny <- list(surowy = yy / nn, "wygładzony" = (yy + m * ss) / (nn + ss), "dolna granica" = wilson(yy, nn)[, "dolna"])
  prawda <- order(-pp)[1:10]
  sapply(oceny, function(x) c(trafienia = sum(order(-x)[1:10] %in% prawda), sredni = mean(pp[order(-x)[1:10]])))
}
wyniki <- replicate(300, jeden_zestaw())
round(rbind(trafienia_srednio = apply(wyniki["trafienia", , ], 1, mean),
            blad_MC = apply(wyniki["trafienia", , ], 1, sd) / sqrt(300),
            sredni_prawdziwy_top10 = apply(wyniki["sredni", , ], 1, mean)), 4)

top$metoda <- factor(top$metoda, levels = names(metody))
top$etykieta <- sprintf("%s (%s)", top$id, formatC(top$zasieg, big.mark = " ", format = "d"))
p4 <- ggplot(top, aes(y = reorder(interaction(etykieta, metoda, sep = "|"), -miejsce))) +
  geom_segment(aes(x = prawdziwy, xend = wartosc, yend = reorder(interaction(etykieta, metoda, sep = "|"), -miejsce)),
               colour = "grey70") +
  geom_point(aes(x = wartosc, colour = metoda, shape = w_prawdziwej_10), size = 3) +
  geom_point(aes(x = prawdziwy), shape = 4, size = 2.6, stroke = 1.1) +
  facet_wrap(~ metoda, scales = "free_y", nrow = 1) +
  scale_y_discrete(labels = function(x) sub("\\|.*$", "", x)) +
  scale_x_continuous(labels = function(x) proc(x, 0), breaks = seq(0.02, 0.12, 0.02)) +
  scale_colour_manual(values = kol[names(metody)], guide = "none") +
  scale_shape_manual(values = c("TRUE" = 16, "FALSE" = 1), labels = c("TRUE" = "w prawdziwej dziesiątce",
                     "FALSE" = "poza prawdziwą dziesiątką"), name = NULL) +
  labs(title = "Dziesięć najlepszych postów według trzech miar",
       subtitle = "krzyżyk – prawdziwy wskaźnik; w nawiasie zasięg",
       x = "Wartość miary w rankingu", y = NULL) +
  motyw
p4   # ggsave("wskaznik-zaangazowania-ranking.svg", p4, width = 10, height = 6.2)
Wynik w R
 metoda miejsce   id zasieg wartosc prawdziwy w_prawdziwej_10
 surowy       1 P378    114  0.1140    0.0541           FALSE
 surowy       2 P324   1616  0.0953    0.0882            TRUE
 surowy       3 P473    210  0.0952    0.0630           FALSE
 surowy       4 P001    114  0.0877    0.0444           FALSE
 surowy       5 P491    149  0.0872    0.0642           FALSE
 surowy       6 P159   1259  0.0866    0.0843            TRUE
 surowy       7 P075    244  0.0861    0.0718           FALSE
 surowy       8 P487   1219  0.0829    0.0734            TRUE
 surowy       9 P032     86  0.0814    0.0437           FALSE
 surowy      10 P006    935  0.0813    0.0766            TRUE
              w_prawdziwej_10 sredni_prawdziwy mediana_zasiegu zasieg_ponizej_300
dolna granica               6           0.0730          1437.5                  1
surowy                      4           0.0664           227.0                  6
wygładzony                  7           0.0761          1437.5                  0
                                                                                                                   dolna granica
"P324 (1616), P159 (1259), P487 (1219), P378 (114), P465 (5652), P191 (13526), P006 (935), P342 (942), P386 (3297), P244 (8105)"
                                                                                                                          surowy
      "P378 (114), P324 (1616), P473 (210), P001 (114), P491 (149), P159 (1259), P075 (244), P487 (1219), P032 (86), P006 (935)"
                                                                                                                      wygładzony
"P324 (1616), P159 (1259), P487 (1219), P006 (935), P342 (942), P465 (5652), P386 (3297), P220 (1637), P191 (13526), P328 (518)"
sredni_prawdziwy_prawdziwej_10
                        0.0782
                       surowy wygładzony dolna granica
trafienia_srednio      4.0833     6.1800        6.0167
blad_MC                0.0812     0.0790        0.0781
sredni_prawdziwy_top10 0.0668     0.0759        0.0756
6. Porównanie formatów: Rysunek 5
R
# Przepis 6. Porównanie formatów: średnia surowych wskaźników, zwykła regresja logistyczna i model beta-dwumianowy: Rysunek 5
# a) średnia surowych wskaźników postów z przedziałem t
sr <- do.call(rbind, lapply(split(posty$wskaznik, posty$format), function(x)
  c(est = mean(x), dolna = mean(x) - qt(.975, length(x) - 1) * sd(x) / sqrt(length(x)),
    gorna = mean(x) + qt(.975, length(x) - 1) * sd(x) / sqrt(length(x)))))
# b) regresja logistyczna na zsumowanych reakcjach (każda osoba z zasięgu jak niezależna próba)
m_glm <- glm(cbind(reakcje, zasieg - reakcje) ~ format, family = binomial, data = posty)
# c) regresja beta-dwumianowa: średnia zależy od formatu, rho wspólne
m_bb <- vglm(cbind(reakcje, zasieg - reakcje) ~ format, betabinomial, data = posty)
m_bb0 <- vglm(cbind(reakcje, zasieg - reakcje) ~ 1, betabinomial, data = posty)
nowe <- data.frame(format = factor(levels(posty$format), levels = levels(posty$format)))
X <- model.matrix(~ format, nowe)
prognoza <- function(beta, V) {                      # średnia na skali odsetka z 95% CI (logit ± 1.96 SE)
  eta <- drop(X %*% beta); se <- sqrt(diag(X %*% V %*% t(X)))
  cbind(est = plogis(eta), dolna = plogis(eta - 1.96 * se), gorna = plogis(eta + 1.96 * se))
}
idx <- c(1, 3, 4)                                    # w vglm: (Intercept):1, (Intercept):2 = rho, formatwideo, formatkaruzela
formaty <- rbind(data.frame(metoda = "średnia surowych wskaźników", format = nowe$format, sr),
                 data.frame(metoda = "regresja logistyczna", format = nowe$format, prognoza(coef(m_glm), vcov(m_glm))),
                 data.frame(metoda = "model beta-dwumianowy", format = nowe$format,
                            prognoza(coef(m_bb)[idx], vcov(m_bb)[idx, idx])))
print(cbind(formaty[, 1:2], round(formaty[, 3:5], 4)), row.names = FALSE)
# Szerokość przedziału: regresja logistyczna vs model beta-dwumianowy
round(tapply(formaty$gorna - formaty$dolna, formaty$metoda, mean), 4)
# Ilorazy szans względem zdjęć (model beta-dwumianowy) i test ilorazu wiarygodności dla formatu
b_bb <- coef(m_bb)[3:4]; se_bb <- sqrt(diag(vcov(m_bb)))[3:4]
round(cbind(OR = exp(b_bb), dolna = exp(b_bb - 1.96 * se_bb), gorna = exp(b_bb + 1.96 * se_bb),
            p = 2 * pnorm(-abs(b_bb / se_bb))), 3)
LR <- 2 * (logLik(m_bb) - logLik(m_bb0))
round(c(LR = LR, df = 2, p = pchisq(LR, 2, lower.tail = FALSE), rho = plogis(coef(m_bb)[2])), 4)
round(mu_prawdziwe, 3)                               # prawdziwe średnie formatów (parametry danych)

formaty$metoda <- factor(formaty$metoda, levels = c("średnia surowych wskaźników", "regresja logistyczna",
                                                    "model beta-dwumianowy"))
prawda <- data.frame(format = nowe$format, est = mu_prawdziwe)
p5 <- ggplot(formaty, aes(est, format)) +
  geom_point(data = prawda, aes(est, format), shape = 4, size = 4, stroke = 1.3, inherit.aes = FALSE) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna, colour = metoda), width = 0.25, linewidth = 0.9, orientation = "y",
                 position = position_dodge(width = 0.6)) +
  geom_point(aes(colour = metoda, shape = metoda), size = 3, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = c("#CC79A7", "#D55E00", "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(15, 17, 16), name = NULL) +
  scale_x_continuous(labels = function(x) proc(x, 1)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "Który format angażuje najbardziej?", subtitle = "krzyżyk – prawdziwa średnia formatu",
       x = "Wskaźnik zaangażowania (95% CI)", y = NULL) +
  motyw
p5   # ggsave("wskaznik-zaangazowania-formaty.svg", p5, width = 10, height = 5.4)
Wynik w R
                      metoda   format    est  dolna  gorna
 średnia surowych wskaźników  zdjęcie 0.0403 0.0384 0.0421
 średnia surowych wskaźników    wideo 0.0497 0.0468 0.0527
 średnia surowych wskaźników karuzela 0.0449 0.0421 0.0477
        regresja logistyczna  zdjęcie 0.0427 0.0421 0.0434
        regresja logistyczna    wideo 0.0545 0.0536 0.0554
        regresja logistyczna karuzela 0.0478 0.0468 0.0488
       model beta-dwumianowy  zdjęcie 0.0412 0.0396 0.0429
       model beta-dwumianowy    wideo 0.0501 0.0476 0.0527
       model beta-dwumianowy karuzela 0.0463 0.0437 0.0491
      model beta-dwumianowy        regresja logistyczna średnia surowych wskaźników
                     0.0046                      0.0017                      0.0051
                  OR dolna gorna     p
formatwideo    1.226 1.145 1.312 0.000
formatkaruzela 1.130 1.049 1.217 0.001
               LR                df                 p rho.(Intercept):2
          33.5861            2.0000            0.0000            0.0032
 zdjęcie    wideo karuzela
   0.040    0.050    0.046
7. Pułapki: zasięg, posty płatne i definicja zasięgu: Rysunek 6
R
# Przepis 7. Pułapki: zasięg zależy od reakcji, posty płatne i definicja zasięgu: Rysunek 6
library(patchwork)
# a) Wskaźnik a log(zasięgu) – model beta-dwumianowy z formatem i log10(zasięgu)
m_z <- vglm(cbind(reakcje, zasieg - reakcje) ~ format + log10(zasieg), betabinomial, data = posty)
round(c(b_log10_zasiegu = coef(m_z)[5], se = sqrt(vcov(m_z)[5, 5]), OR_10x_zasiegu = exp(coef(m_z)[5])), 3)
round(c(kor_log_zasieg_prawdziwy = cor(log10(posty$zasieg), posty$wskaznik_prawdziwy)), 3)
# Wygładzanie do średniej zależnej od zasięgu i formatu: czy dziesiątka się zmienia?
eta <- predict(m_z)                                  # kolumna 1: logit średniej, kolumna 2: logit rho
m_i <- plogis(eta[, 1]); s_i <- 1 / plogis(eta[, 2]) - 1
posty$wygladzony_z <- (posty$reakcje + m_i * s_i) / (posty$zasieg + s_i)
top_z <- order(-posty$wygladzony_z)[1:10]
c(wspolne_z_wygladzonym = sum(top_z %in% order(-posty$wygladzony)[1:10]),
  w_prawdziwej_10 = sum(top_z %in% prawdziwa_10))
siatka_z <- expand.grid(format = factor("zdjęcie", levels = levels(posty$format)),
                        zasieg = round(10^seq(log10(30), log10(27000), length.out = 100)))
siatka_z$mu <- plogis(predict(m_z, newdata = siatka_z)[, 1])
round(c(zdjecie_zasieg_30 = siatka_z$mu[1], zdjecie_zasieg_27000 = siatka_z$mu[100]), 4)
pA <- ggplot(posty, aes(zasieg, wygladzony)) +
  geom_point(aes(colour = format, shape = format), alpha = 0.6, size = 1.8) +
  geom_line(data = siatka_z, aes(zasieg, mu), colour = "black", linewidth = 1) +
  scale_x_log10(breaks = c(30, 300, 3000, 27000), labels = function(x) format(x, big.mark = " ")) +
  scale_y_continuous(labels = function(x) proc(x, 0)) +
  scale_colour_manual(values = kol[c("zdjęcie", "wideo", "karuzela")], name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  labs(title = "A. Większy zasięg, wyższy wskaźnik?", x = "Zasięg (skala log.)", y = "Wskaźnik wygładzony") +
  motyw

# b) Ten sam model formatów przy trzech definicjach mianownika
definicje <- list("organiczne reakcje / zasięg organiczny" = with(posty, cbind(reakcje, zasieg - reakcje)),
                  "wszystkie reakcje / zasięg z płatnym" = with(posty, cbind(reakcje + reakcje_platne,
                                                       zasieg + zasieg_platny - reakcje - reakcje_platne)),
                  "organiczne reakcje / wyświetlenia" = with(posty, cbind(reakcje, wyswietlenia - reakcje)))
defs <- do.call(rbind, lapply(names(definicje), function(d) {
  yy <- definicje[[d]]
  mm <- vglm(yy ~ format, betabinomial, data = posty)
  data.frame(definicja = d, format = nowe$format, prognoza(coef(mm)[idx], vcov(mm)[idx, idx]))
}))
print(cbind(defs[, 1:2], round(defs[, 3:5], 4)), row.names = FALSE)
# Posty promowane: wskaźnik organiczny a wskaźnik liczony z płatnym zasięgiem
pr <- subset(posty, promowany == 1)
round(c(promowane = nrow(pr), mediana_organiczny = median(pr$reakcje / pr$zasieg),
        mediana_z_platnym = median((pr$reakcje + pr$reakcje_platne) / (pr$zasieg + pr$zasieg_platny))), 4)

defs$definicja <- factor(defs$definicja, levels = names(definicje))
pB <- ggplot(defs, aes(est, definicja, colour = format, shape = format)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", position = position_dodge(width = 0.55)) +
  geom_point(size = 2.6, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = kol[c("zdjęcie", "wideo", "karuzela")], guide = "none") +
  scale_shape_manual(values = c(16, 17, 15), guide = "none") +
  scale_y_discrete(labels = function(x) sub(" / ", "\n/ ", x)) +
  scale_x_continuous(labels = function(x) proc(x, 1)) +
  labs(title = "B. Mianownik zmienia kolejność", x = "Średni wskaźnik (95% CI)", y = NULL) +
  motyw
p6 <- pA + pB + plot_layout(widths = c(1, 1.15), guides = "collect") & theme(legend.position = "bottom")
p6   # ggsave("wskaznik-zaangazowania-pulapki.svg", p6, width = 10, height = 5.4)
Wynik w R
b_log10_zasiegu.log10(zasieg)                            se  OR_10x_zasiegu.log10(zasieg)
                        0.115                         0.030                         1.122
kor_log_zasieg_prawdziwy
                   0.266
wspolne_z_wygladzonym       w_prawdziwej_10
                   10                     7
   zdjecie_zasieg_30 zdjecie_zasieg_27000
              0.0346               0.0480
                              definicja   format    est  dolna  gorna
 organiczne reakcje / zasięg organiczny  zdjęcie 0.0412 0.0396 0.0429
 organiczne reakcje / zasięg organiczny    wideo 0.0501 0.0476 0.0527
 organiczne reakcje / zasięg organiczny karuzela 0.0463 0.0437 0.0491
   wszystkie reakcje / zasięg z płatnym  zdjęcie 0.0390 0.0371 0.0410
   wszystkie reakcje / zasięg z płatnym    wideo 0.0463 0.0435 0.0493
   wszystkie reakcje / zasięg z płatnym karuzela 0.0433 0.0404 0.0465
      organiczne reakcje / wyświetlenia  zdjęcie 0.0359 0.0345 0.0373
      organiczne reakcje / wyświetlenia    wideo 0.0402 0.0382 0.0424
      organiczne reakcje / wyświetlenia karuzela 0.0274 0.0256 0.0293
         promowane mediana_organiczny  mediana_z_platnym
           54.0000             0.0404             0.0214
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("zdjęcie – wideo" = c("#0072B2", "#D55E00"), "zdjęcie – karuzela" = c("#0072B2", "#009E73"),
             "wideo – karuzela" = c("#D55E00", "#009E73"), "surowy – dolna granica" = c("#D55E00", "#CC79A7"),
             "wygładzony – dolna granica" = c("#0072B2", "#CC79A7"),
             "czerwony – zielony (do unikania)" = c("#FF0000", "#00A000"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB"))
  sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                    protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
zdjęcie – wideo                            114.6        108.3       91.9
zdjęcie – karuzela                          70.1         55.4       58.0
wideo – karuzela                           102.4         53.5       37.3
surowy – dolna granica                      74.3         70.2       71.9
wygładzony – dolna granica                  53.6         42.0       22.5
czerwony – zielony (do unikania)           141.2         12.3       25.1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Model beta-dwumianowy liczono funkcją optim z podstawowej instalacji R i pakietem VGAM (kontrola i regresja z formatem), regresję logistyczną – funkcją glm. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- VGAM (wersja 1.1.14): Yee, T. W. (2015). Vector generalized linear and additive models: With an implementation in R. Springer. https://doi.org/10.1007/978-1-4939-2818-7
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć wskaźnik zaangażowania posta?
Podziel liczbę reakcji (polubień, komentarzy, udostępnień) przez zasięg posta, czyli liczbę osób, które go zobaczyły. Ustal jedną definicję: reakcje organiczne czy wszystkie, zasięg czy wyświetlenia. W przykładzie karuzela miała 4.63% w przeliczeniu na zasięg i tylko 2.74% w przeliczeniu na wyświetlenia.
Dlaczego posty z małym zasięgiem mają skrajne wskaźniki?
Bo przy kilkudziesięciu osobach jedna reakcja zmienia wskaźnik o kilka punktów procentowych. W przykładzie wśród postów z zasięgiem poniżej 300 surowe wskaźniki miały SD = 2.13 pp, choć prawdziwe różnice wynosiły tylko 1.16 pp. Pokaż to na wykresie lejkowym albo podaj przedział ufności dla każdego posta.
Co to jest wygładzony wskaźnik zaangażowania?
To średnia ważona wskaźnika posta i wskaźnika przeciętnego posta: (reakcje + α) / (zasięg + α + β), gdzie α i β pochodzą z modelu beta-dwumianowego. Waga danych posta rośnie z zasięgiem: w przykładzie wynosiła .26 przy zasięgu 100 i .97 przy 10 000. Post z 9 reakcjami na 120 osób (7.5%) dostał 5.37%.
Jak zrobić ranking postów, żeby nie wygrywały małe posty?
Sortuj według wskaźnika wygładzonego albo dolnej granicy przedziału Wilsona, a nie według surowego wskaźnika. W 300 symulacjach ranking surowy trafiał średnio 4.08 posta z prawdziwej dziesiątki, wygładzony 6.18, a dolna granica 6.02. Dolna granica zaniża jednak wartości, więc do raportu lepszy jest wskaźnik wygładzony.
Jak porównać zaangażowanie zdjęć, wideo i karuzel?
Użyj regresji beta-dwumianowej z formatem (np. funkcja vglm w pakiecie VGAM). Zwykła regresja logistyczna traktuje każdą osobę z zasięgu jako niezależną próbę i daje za wąskie przedziały. Pamiętaj, że format nie był losowany – różnica może wynikać z tematów postów, więc wnioski potwierdź eksperymentem.
Powiązane hasła
Przeczytaj też
Co zwiększa zasięg posta
Producent mebli na wymiar: regresja ujemna dwumianowa z efektem konta, IRR w procentach, zmiana algorytmu i eksperyment z porą – z kodem R.
Czytaj →PoradnikOceny gwiazdkowe i ranking produktów
Sklep z artykułami kuchennymi: rozkład J, wykres lejkowy, przedział Wilsona, średnia wygładzona i symulacja 1000 sklepów z kodem R.
Czytaj →PoradnikKampania miesiąca i regresja do średniej
Sieć szkół jazdy i 60 kampanii: wykres lejkowy, spadek zwycięzcy w następnym miesiącu, ściąganie w modelu mieszanym i symulacja – z kodem R.
Czytaj →Analizujesz dane z mediów społecznościowych albo piszesz o nich pracę?
Pomożemy zdefiniować wskaźniki, dobrać model dla odsetków z różnych zasięgów, porównać formaty i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Efron, B., & Morris, C. (1975). Data analysis using Stein's estimator and its generalizations. Journal of the American Statistical Association, 70(350), 311–319. https://doi.org/10.1080/01621459.1975.10479864
- Spiegelhalter, D. J. (2005). Funnel plots for comparing institutional performance. Statistics in Medicine, 24(8), 1185–1202. https://doi.org/10.1002/sim.1970
- Spiegelhalter, D. J. (2005). Handling over-dispersion of performance indicators. Quality and Safety in Health Care, 14(5), 347–351. https://doi.org/10.1136/qshc.2005.013755 ● Otwarty dostęp
- Williams, D. A. (1975). The analysis of binary responses from toxicological experiments involving reproduction and teratogenicity. Biometrics, 31(4), 949. https://doi.org/10.2307/2529820
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{efron1975data, author={Efron, Bradley and Morris, Carl}, title={{Data analysis using Stein's estimator and its generalizations}}, journal={Journal of the American Statistical Association}, year={1975}, volume={70}, number={350}, pages={311--319}, doi={10.1080/01621459.1975.10479864}}@article{spiegelhalter2005funnel, author={Spiegelhalter, David J.}, title={{Funnel plots for comparing institutional performance}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={8}, pages={1185--1202}, doi={10.1002/sim.1970}}@article{spiegelhalter2005handling, author={Spiegelhalter, D. J.}, title={{Handling over-dispersion of performance indicators}}, journal={Quality and Safety in Health Care}, year={2005}, volume={14}, number={5}, pages={347--351}, doi={10.1136/qshc.2005.013755}}@article{williams1975analysis, author={Williams, D. A.}, title={{The analysis of binary responses from toxicological experiments involving reproduction and teratogenicity}}, journal={Biometrics}, year={1975}, volume={31}, number={4}, pages={949}, doi={10.2307/2529820}}