Przykład: herbatniki w telewizji i w internecie
Fikcyjny producent herbatników prowadzi czterotygodniową kampanię: 24 emisje spotu w telewizji i reklamę wideo w internecie z limitem 12 wyświetleń na osobę. Dom mediowy przysyła raport z panelu 2000 osób z grupy docelowej (dorośli robiący zakupy spożywcze). Zarząd pyta o trzy rzeczy: do ilu osób reklama dotarła, ile razy każdą z nich „dotknęła” i co da dwa razy większy budżet na TV?
Za trzema wskaźnikami planowania mediów – zasięgiem, średnią częstotliwością i GRP – stoi jeden rozkład liczby kontaktów na osobę. Pokażemy, dlaczego dobrze opisuje go rozkład beta-dwumianowy, a źle rozkład Poissona, jak z niego prognozować zasięg, jak łączyć dwa kanały i ile niepewności wnosi sam panel.
Dane są fikcyjne i znamy prawdę. Każdy panelista ma własną skłonność do oglądania bloku reklamowego, wylosowaną z rozkładu beta Beta(0.6, 2.4) – średnio 20%, ale u wielu osób blisko zera, a u części bardzo wysoką. W internecie skłonność pochodzi z Beta(0.35, 1.4). Skłonności w obu kanałach są ujemnie skorelowane (korelacja −0.3 na skali normalnej): kto dużo ogląda telewizji, rzadziej widzi reklamy w internecie. Parametry ustawiliśmy ręcznie przed symulacją tak, by średnia oglądalność bloku wynosiła 20% (480 GRP przy 24 emisjach). Ziarno 668 ustalono raz i nie zmieniano go. Dane pobierzesz jako zasieg-panel-herbatniki.csv (id, liczba kontaktów z TV, liczba kontaktów w internecie).
Czy kolejne kontakty coś dają, opisuje wpis o częstotliwości kontaktu z reklamą i zmęczeniu, a ile sprzedaży dała kampania – marketing mix modeling.
Rysunek 1: GRP = zasięg × częstotliwość
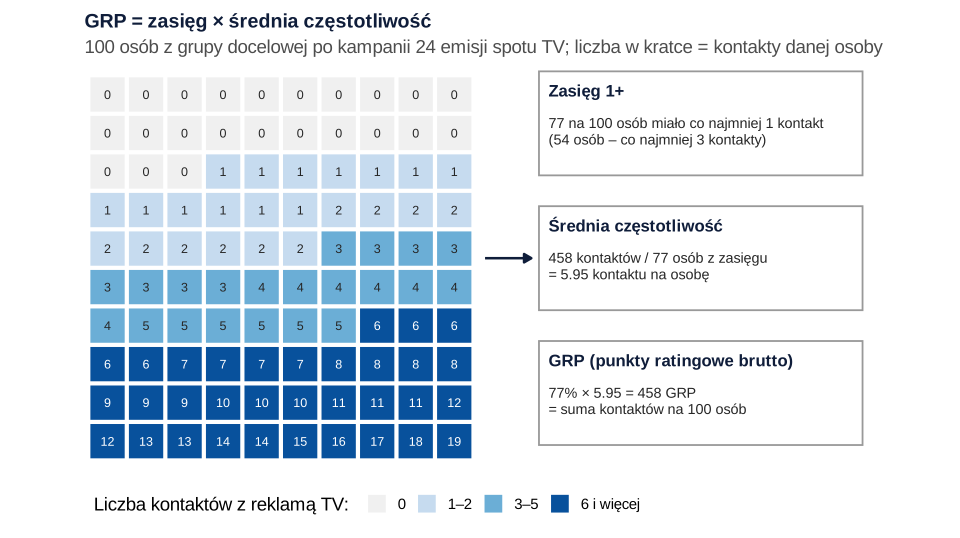
Co widać. Każda kratka to jedna osoba, a liczba w środku – ile razy zobaczyła spot. Rozkład 100 osób odpowiada prawdziwemu modelowi z naszej symulacji. Z tej siatki liczymy trzy wskaźniki:
- Zasięg 1+ – odsetek osób z co najmniej jednym kontaktem: 77 na 100. Zasięg 3+ (co najmniej trzy kontakty) to 54 osoby.
- Średnia częstotliwość – średnia liczba kontaktów wśród osób, do których reklama dotarła: 458 / 77 = 5.95.
- GRP (gross rating points, punkty ratingowe brutto) – suma kontaktów na 100 osób, czyli suma oglądalności wszystkich emisji: 458.
Jak może zmylić. GRP liczy kontakty, nie osoby. Około 460 GRP to zarówno 92% zasięgu × 5 kontaktów, jak i 42% × 11 kontaktów. Dwie kampanie o równym GRP mogą więc dotrzeć do zupełnie innej liczby klientów – dlatego potrzebny jest rozkład kontaktów, a nie tylko suma.
Podpis do pracy:
Rysunek 2: beta-dwumianowy czy Poisson?
Najprostszy pomysł to założyć, że każda osoba ma tę samą szansę zobaczyć każdą emisję. Wtedy liczba kontaktów ma rozkład dwumianowy, a przy wielu emisjach i małej szansie – praktycznie rozkład Poissona. Ludzie oglądają jednak telewizję bardzo różnie. Jeśli szansa kontaktu p zmienia się między osobami zgodnie z rozkładem beta, liczba kontaktów ma rozkład beta-dwumianowy – opisany już przez Skellama (1948) jako rozkład dwumianowy ze zmiennym prawdopodobieństwem sukcesu:
gdzie n to liczba emisji, B – funkcja beta, a a i b opisują, jak różnie ludzie oglądają. W reklamie telewizyjnej to klasyczny model rozkładu częstotliwości kontaktów; Rust i Klompmaker (1981) zaproponowali dla niego lepszą metodę estymacji, uwzględniającą cechy telewizji ogólnokrajowej. Parametry szacujemy metodą największej wiarygodności (optim, kontrolnie pakiet VGAM – wynik identyczny).
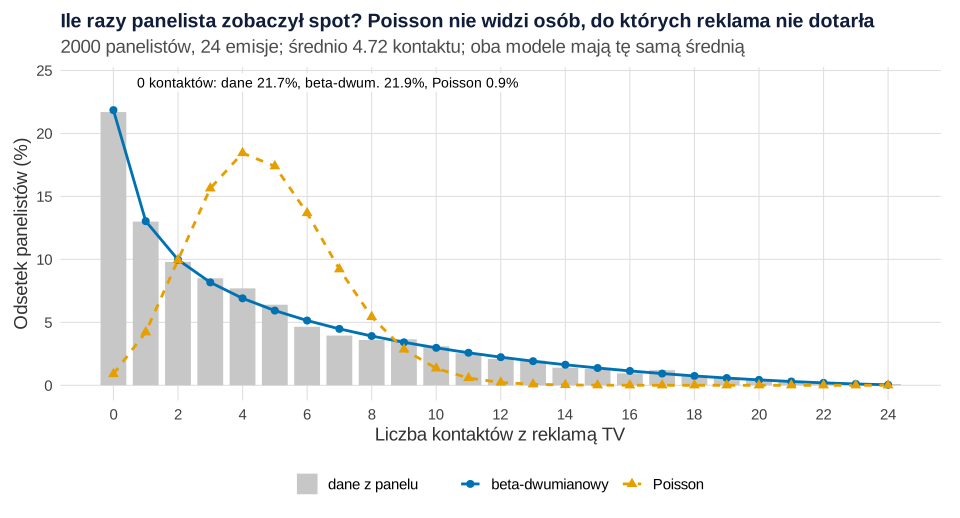
set.seed(668)).Co widać. Średnio panelista miał 4.72 kontaktu (GRP = 471.7), ale 21.7% osób nie zobaczyło spotu ani razu, a 11.4% widziało go 12 razy lub więcej. Model beta-dwumianowy (a = 0.636, 95% CI [0.591, 0.685]; b = 2.588 [2.379, 2.816]) odtwarza ten kształt: przewiduje 21.9% osób bez kontaktu i zasięg 1+ równy 78.1% wobec 78.3% w danych. Poisson o tej samej średniej przewiduje tylko 0.9% osób bez kontaktu i zasięg 99.1%. Log-wiarygodność rośnie z −7769.9 (Poisson) do −5257.4 (beta-dwumianowy), a AIC spada z 15541.9 do 10518.8.
W parametryzacji VGAM ten sam model ma średnią μ = .197 i korelację ρ = .237. To ρ działa jak korelacja wewnątrzklasowa: mierzy, jak bardzo kontakty tej samej osoby „trzymają się razem”. Duże ρ to silna nadmierna dyspersja – i właśnie ona decyduje o zasięgu.
Jak może zmylić. Dobre dopasowanie przy 24 emisjach nie dowodzi, że model jest „prawdziwy”. Jeśli część osób w ogóle nie ma telewizora, sprawdź, czy model nie zaniża liczby zer.
Podpis do pracy:
Zdanie do Wyników: „Rozkład liczby kontaktów był silnie prawostronnie skośny; rozkład beta-dwumianowy opisywał go znacznie lepiej niż rozkład Poissona (AIC = 10518.8 vs 15541.9) i odtwarzał zasięg 1+ (78.1% wobec 78.3% w danych)”.
Rysunek 3: co da większy budżet?
Jeśli nowe emisje trafią w te same pasma i do tej samej widowni, każda osoba zachowa swoją skłonność p, a zasięg przy s emisjach liczymy z tego samego rozkładu: 1 − P(X = 0). Takie modele łączące plan emisji z rozkładem kontaktów testowano na dużych próbach już w latach 70. (Headen i in., 1977).
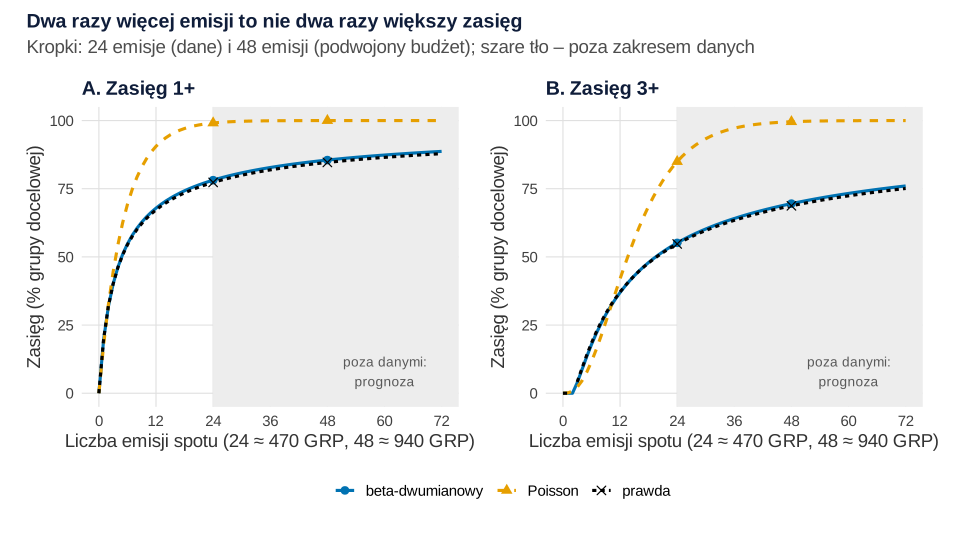
set.seed(668)).Co widać. Podwojenie budżetu (48 emisji zamiast 24) podnosi zasięg 1+ tylko z 78.1% do 85.5%, a GRP z 473 do 947. Prawie cały dodatkowy budżet idzie w częstotliwość: średnia rośnie z 6.1 do 11.1 kontaktu na osobę. Zasięg 3+ rośnie mocniej – z 55.1% do 69.5%. Krzywa beta-dwumianowa leży blisko prawdziwej (prawda przy 48 emisjach: 84.6% i 68.7%). Poisson twierdzi, że już obecna kampania dotarła do 99.1% grupy – to błąd.
Jak może zmylić. Szare pole to prognoza poza danymi. Model zakłada, że nowe emisje są „takie jak dotąd”. Jeśli nowe spoty trafią w inne pasma (np. poranne zamiast wieczornych), dotrą do innych ludzi i zasięg wzrośnie bardziej, niż pokazuje krzywa. Tu prognoza trafia, bo dane pochodzą z tego samego modelu.
Podpis do pracy:
Zdanie do Wyników: „Według modelu beta-dwumianowego podwojenie liczby emisji do 48 zwiększyłoby zasięg 1+ z 78.1% do 85.5%, a średnią częstotliwość z 6.1 do 11.1 kontaktu”.
Rysunek 4: telewizja + internet – razem czy osobno?
Telewizja dotarła do 78.3% grupy, internet do 58.8%. Gdyby kontakty w obu kanałach były niezależne, wystarczyłby wzór:
Wzór ma oparcie w obserwacji Goodhardta i Ehrenberga (1969): dla dwóch programów na różnych kanałach telewizyjnych odsetek widzów jednego, którzy oglądają też drugi, był w przybliżeniu równy oglądalności drugiego – czyli tak, jak przy niezależności. Między telewizją a internetem nie ma takiej gwarancji. Danaher (1992) wskazuje właśnie korelacje między mediami i wewnątrz mediów jako główną trudność w modelowaniu rozkładów kontaktów.
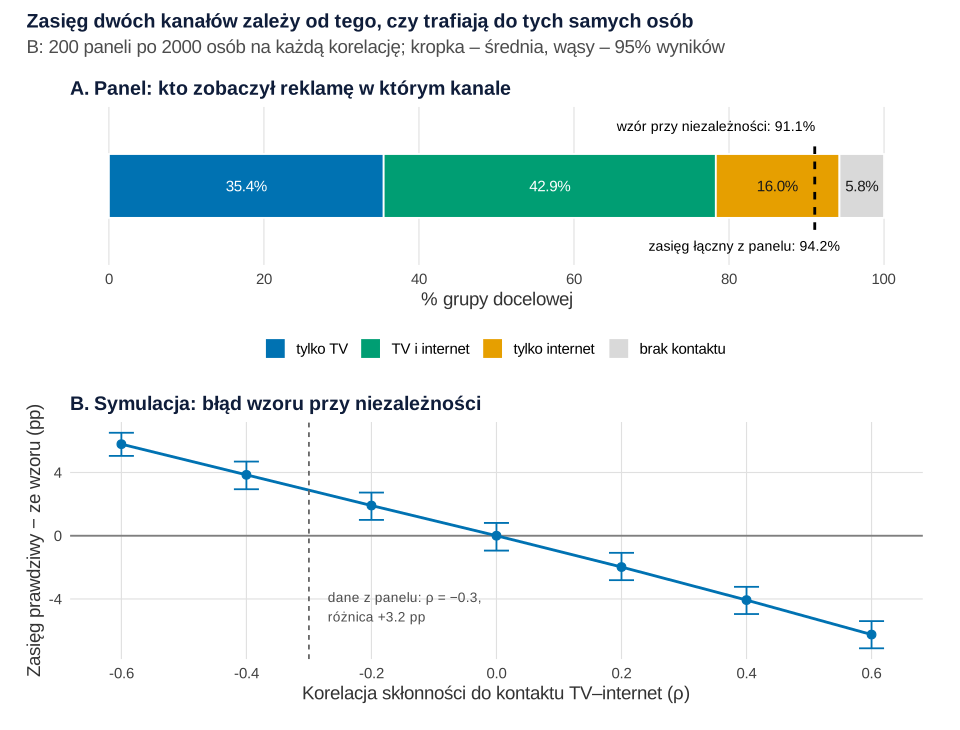
set.seed(668); B – 200 paneli po 2000 osób na każdą korelację).Co widać. W panelu zasięg łączny wynosi 94.2%, czyli o 3.2 pp więcej niż ze wzoru. Powód: osoby, do których dotarł internet, rzadziej widziały spot TV (72.9% wobec 78.3% w całej grupie). Jeszcze wyraźniej widać to na zasięgu 3+: w panelu 79.2%, a przy niezależności (splot dwóch rozkładów beta-dwumianowych) 74.4%.
Panel B to symulacja: zmienia się tylko korelacja skłonności. Przy korelacji 0 wzór jest trafny (średni błąd 0.00 pp, 95% wyników od −0.94 do 0.81). Przy korelacji ujemnej −0.6 zaniża zasięg średnio o 5.79 pp, a przy dodatniej +0.6 – gdy oba kanały trafiają do tych samych „łowców mediów” – zawyża go o 6.25 pp. Błąd Monte Carlo średnich wynosi 0.03 pp.
Jak może zmylić. Korelację skłonności znamy tu z konstrukcji danych. W realnej kampanii potrzebujesz panelu, który mierzy oba kanały u tych samych osób (single-source). Bez niego wybór „niezależność czy nie” jest założeniem – pokaż wtedy oba warianty. Podobną logikę zasięgu bez powtórzeń zastosowano do linii produktów w analizie TURF.
Podpis do pracy:
Zdanie do Wyników: „Łączny zasięg kampanii wyniósł 94.2% i był o 3.2 pp wyższy niż przy założeniu niezależności kanałów, ponieważ osoby z kontaktem w internecie rzadziej miały kontakt z reklamą telewizyjną (72.9% wobec 78.3%)”.
Rysunek 5: ile niepewności wnosi panel?
Zasięg 78.3% to wynik z 2000 osób, a nie z całej populacji. Najprościej oszacować jego niepewność bootstrapem (Efron, 1979): losujemy ze zwracaniem 2000 panelistów, liczymy wszystkie wskaźniki od nowa – także dopasowanie modelu i prognozę – i powtarzamy 1000 razy. Mechanikę pokazuje wpis bootstrap – wizualizacja na obrazkach.
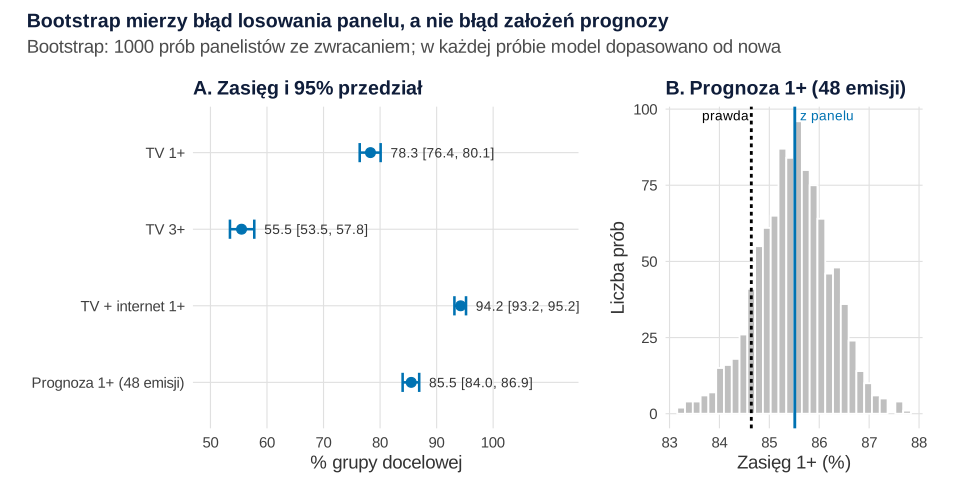
set.seed(668), 1000 prób).Co widać. Zasięg 1+ TV: 78.3%, 95% CI [76.4, 80.1]; zasięg 3+: 55.5% [53.5, 57.8]; zasięg łączny: 94.2% [93.2, 95.2]. GRP wynosi 471.7 [449.6, 493.1], a średnia częstotliwość 6.02 [5.78, 6.27]. Przy 2000 panelistach przedział ufności zasięgu ma więc od około 2 pp szerokości (zasięg łączny) do 4.3 pp (zasięg 3+); dla TV 1+ to 3.7 pp.
Jak może zmylić. Prognoza przy 48 emisjach ma przedział [84.0, 86.9] – węższy niż sam zasięg 1+ (2.9 wobec 3.7 pp). To nie znaczy, że prognoza jest pewniejsza. Bootstrap mierzy tylko losowanie panelistów; nie widzi założenia, że nowe emisje będą „takie jak dotąd”. Prawda (84.6%) mieści się w przedziale tylko dlatego, że to założenie jest tu spełnione.
Podpis do pracy:
Zdanie do Wyników: „Zasięg 1+ kampanii telewizyjnej wyniósł 78.3%, 95% CI [76.4, 80.1], przy GRP = 471.7 i średniej częstotliwości 6.02 kontaktu”.
Co z tym zrobić w marketingu
- Proś o rozkład kontaktów, nie tylko o GRP. Tabela „ile osób miało 0, 1, 2… kontaktów” wystarczy, by dopasować model i porównać plany.
- Nie licz zasięgu z Poissona. Tu dał 99.1% zamiast 78.3%.
- Dodatkowe emisje w tych samych pasmach kupują głównie częstotliwość. 24 dodatkowe emisje dały w modelu +7.4 pp zasięgu 1+ i +14.4 pp zasięgu 3+. Jeśli celem jest zasięg, przesuń część budżetu do innych pasm lub kanałów.
- Drugi kanał opłaca się najbardziej, gdy trafia do innych ludzi. Internet dołożył tu 16.0 pp osób, których TV nie dosięgła. Sprawdź korelację widowni w panelu single-source, zanim użyjesz wzoru przy niezależności. Danaher i in. (2010) do internetu stosują osobny model rozkładu kontaktów i dobierają serwisy optymalizacją nieliniową.
- Raportuj zasięg z przedziałem. Panel 2000 osób daje błąd rzędu ±2 pp; ważenie panelu go poszerza (wagi poststratyfikacyjne).
- Zasięg to nie efekt. Czy kontakt coś zmienił, sprawdzisz w badaniu brand lift albo teście wyłączenia reklamy, a zmiany świadomości w czasie – w badaniu trackingowym marki.
Jak opisać w pracy
W pracy z marketingu (zob. też statystyka w pracy z marketingu) opisz źródło danych (panel, liczebność, definicja kontaktu), wskaźniki i model. Wzór dla Metody i Wyników:
W ograniczeniach napisz, że prognoza zakłada niezmienioną strukturę emisji, a bootstrap nie uwzględnia wag panelu.
Kod R: zasięg, rozkład beta-dwumianowy i bootstrap
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje paletę, motyw i funkcję dbb(), przepis 2 tworzy dane, a przepis 3 – funkcję dopasuj_bb() i dopasowane modele. Przepisy z rysunkami kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 2, 5 i 6), zaczyna od własnego set.seed(668); ziarno ustalono raz i nie zmieniano go. Ręcznie ustalono: liczebność panelu (2000), liczbę emisji (24) i limit wyświetleń w internecie (12), rozkłady skłonności Beta(0.6, 2.4) dla TV i Beta(0.35, 1.4) dla internetu, korelację skłonności −0.3, siatkę korelacji w symulacji (od −0.6 do 0.6 co 0.2) i liczbę paneli (200 na korelację), liczbę prób bootstrapowych (1000) oraz wariant budżetu (48 emisji). Parametrów danych ani ziarna nie zmienialiśmy po pierwszym uruchomieniu. Zmieniliśmy tylko metodę optymalizacji w dopasuj_bb(): domyślnie użyty najpierw BFGS „uciekał” do ogromnych wartości a i b i kończył się osobliwym hesjanem, więc przeszliśmy na metodę Neldera–Meada (wynik zgodny z VGAM), oraz układ etykiet na rysunkach 4 i 5.
1. Schemat GRP = zasięg × częstotliwość: Rysunek 1
R
# Rysunek 1. GRP = zasięg × średnia częstotliwość na 100 osobach z grupy docelowej (grafika z prostokątów i tekstu)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii), skala liczby kontaktów i prosty motyw
kol <- c("obserwowane" = "#9E9E9E", "beta-dwumianowy" = "#0072B2", "Poisson" = "#E69F00", "prawda" = "#000000",
         "tylko TV" = "#0072B2", "TV i internet" = "#009E73", "tylko internet" = "#E69F00", "brak kontaktu" = "#D9D9D9")
kol_kontakty <- c("0" = "#F0F0F0", "1–2" = "#C6DBEF", "3–5" = "#6BAED6", "6 i więcej" = "#08519C")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Rozkład beta-dwumianowy: P(X = k) przy n emisjach, gdy szansa kontaktu osoby p ~ Beta(a, b)
dbb <- function(k, n, a, b) exp(lchoose(n, k) + lbeta(k + a, n - k + b) - lbeta(a, b))

# 100 „typowych” osób: liczebności z rozkładu Beta-dwumianowego(24 emisje; a = 0.6, b = 2.4), zaokrąglone do 100
pr <- dbb(0:24, 24, 0.6, 2.4)
ile <- floor(100 * pr); reszta <- 100 - sum(ile)
ile[order(100 * pr - ile, decreasing = TRUE)[seq_len(reszta)]] <- ile[order(100 * pr - ile, decreasing = TRUE)[seq_len(reszta)]] + 1
kontakty <- rep(0:24, ile)                           # 100 osób uporządkowanych od 0 kontaktów w górę
osoby <- data.frame(x = (seq_along(kontakty) - 1) %% 10, y = 9 - (seq_along(kontakty) - 1) %/% 10, k = kontakty)
osoby$klasa <- cut(osoby$k, c(-1, 0, 2, 5, Inf), labels = names(kol_kontakty))

zasieg <- sum(kontakty >= 1); zasieg3 <- sum(kontakty >= 3)
grp <- sum(kontakty)                                 # suma kontaktów na 100 osób = GRP
czest <- grp / zasieg                                # średnio wśród osób, do których reklama dotarła
c(zasieg_1plus = zasieg, zasieg_3plus = zasieg3, GRP = grp, srednia_czestotliwosc = round(czest, 2))

pola <- data.frame(xmin = 11.2, xmax = 19.6, ymin = c(6.9, 3.4, -0.1), ymax = c(9.6, 6.1, 2.6),
                   tytul = c("Zasięg 1+", "Średnia częstotliwość", "GRP (punkty ratingowe brutto)"),
                   tekst = c(sprintf("%d na 100 osób miało co najmniej 1 kontakt\n(%d osób – co najmniej 3 kontakty)", zasieg, zasieg3),
                             sprintf("%d kontaktów / %d osób z zasięgu\n= %.2f kontaktu na osobę", grp, zasieg, czest),
                             sprintf("%d%% × %.2f = %d GRP\n= suma kontaktów na 100 osób", zasieg, czest, grp)))
p1 <- ggplot() +
  geom_tile(data = osoby, aes(x, y, fill = klasa), colour = "white", linewidth = 0.8, width = 0.95, height = 0.95) +
  geom_text(data = osoby, aes(x, y, label = k, colour = k >= 6), size = 3.3, show.legend = FALSE) +
  scale_colour_manual(values = c("FALSE" = "grey15", "TRUE" = "white")) +
  scale_fill_manual(values = kol_kontakty, name = "Liczba kontaktów z reklamą TV:") +
  geom_rect(data = pola, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax), fill = "white", colour = "grey60") +
  geom_text(data = pola, aes(x = xmin + 0.25, y = ymax - 0.5, label = tytul), hjust = 0, fontface = "bold",
            size = 4.4, colour = "#0f1d3a") +
  geom_text(data = pola, aes(x = xmin + 0.25, y = ymax - 1.55, label = tekst), hjust = 0, size = 3.8,
            lineheight = 0.95, colour = "grey15") +
  annotate("segment", x = 9.8, xend = 11.0, y = 4.75, yend = 4.75, colour = "#0f1d3a", linewidth = 0.9,
           arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  coord_equal(xlim = c(-0.6, 19.8), ylim = c(-0.6, 9.7), expand = FALSE) +
  labs(title = "GRP = zasięg × średnia częstotliwość",
       subtitle = "100 osób z grupy docelowej po kampanii 24 emisji spotu TV; liczba w kratce = kontakty danej osoby",
       x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank(), legend.justification = "left")
p1
# ggsave("zasieg-schemat-grp.svg", p1, width = 10, height = 5.6)
Wynik w R
         zasieg_1plus          zasieg_3plus                   GRP
                77.00                 54.00                458.00
srednia_czestotliwosc
                 5.95
2. Dane: panel 2000 osób i wskaźniki planowania mediów
R
# Dane: fikcyjny panel 2000 osób z grupy docelowej i kampania herbatników w TV (24 emisje) i w internecie (12 okazji)
# (korzysta z kol i motyw z przepisu 1)
set.seed(668)                                        # ziarno ustalone raz, bez dobierania pod wynik
N <- 2000                                            # panelistów (grupa docelowa: dorośli robiący zakupy spożywcze)
n_tv <- 24                                           # emisji spotu w 4 tygodnie
n_int <- 12                                          # okazji do wyświetlenia reklamy wideo (limit 12 na osobę)
# Prawda (parametry ustawione ręcznie; znamy je tylko dlatego, że dane są fikcyjne):
# skłonność do oglądania bloku reklamowego p ~ Beta(0.6, 2.4), średnio 0.20; w internecie q ~ Beta(0.35, 1.4)
prawda <- c(a_tv = 0.6, b_tv = 2.4, a_int = 0.35, b_int = 1.4, rho = -0.3)
# Kopuła normalna: osoby oglądające dużo TV rzadziej widzą reklamy w internecie (korelacja −0.3 na skali z)
z1 <- rnorm(N)
z2 <- prawda[["rho"]] * z1 + sqrt(1 - prawda[["rho"]]^2) * rnorm(N)
p_tv <- qbeta(pnorm(z1), prawda[["a_tv"]], prawda[["b_tv"]])
q_int <- qbeta(pnorm(z2), prawda[["a_int"]], prawda[["b_int"]])
panel <- data.frame(id = 1:N, kontakty_tv = rbinom(N, n_tv, p_tv), kontakty_int = rbinom(N, n_int, q_int))
write.csv(panel, "zasieg-panel-herbatniki.csv", row.names = FALSE)

# Wskaźniki planowania mediów: zasięg k+, średnia częstotliwość wśród dotartych, GRP
wskazniki <- function(x) c(zasieg_1plus = 100 * mean(x >= 1), zasieg_3plus = 100 * mean(x >= 3),
                           srednia_czest = mean(x[x >= 1]), GRP = 100 * mean(x))
round(rbind(TV = wskazniki(panel$kontakty_tv), internet = wskazniki(panel$kontakty_int),
            razem = wskazniki(panel$kontakty_tv + panel$kontakty_int)), 2)
table(kontakty_tv = cut(panel$kontakty_tv, c(-1, 0, 2, 5, 11, 24)))
Wynik w R
         zasieg_1plus zasieg_3plus srednia_czest   GRP
TV              78.30        55.50          6.02 471.7
internet        58.80        35.85          4.12 242.1
razem           94.25        79.25          7.57 713.8
kontakty_tv
 (-1,0]   (0,2]   (2,5]  (5,11] (11,24]
    434     456     452     430     228
3. Rozkład beta-dwumianowy i Poissona: Rysunek 2
R
# Rysunek 2. Rozkład liczby kontaktów z reklamą TV: dane, rozkład beta-dwumianowy i Poissona
# (korzysta z kol, motyw, dbb() z przepisu 1 i panel z przepisu 2)
library(ggplot2)
suppressPackageStartupMessages(library(VGAM))

# Dopasowanie metodą największej wiarygodności „ręcznie”: optim na log a i log b, liczebności 0–n
dopasuj_bb <- function(x, n) {
  f <- tabulate(x + 1, nbins = n + 1)                # ile osób miało 0, 1, …, n kontaktów
  nll <- function(th) -sum(f * log(dbb(0:n, n, exp(th[1]), exp(th[2]))))
  m <- mean(x) / n
  o <- optim(log(c(m, 1 - m)), nll, control = list(reltol = 1e-12), hessian = TRUE)  # Nelder–Mead
  list(a = exp(o$par[1]), b = exp(o$par[2]), logLik = -o$value, vcov = solve(o$hessian))
}
bb_tv <- dopasuj_bb(panel$kontakty_tv, n_tv)
bb_int <- dopasuj_bb(panel$kontakty_int, n_int)
c(a_tv = bb_tv$a, b_tv = bb_tv$b, a_int = bb_int$a, b_int = bb_int$b) |> round(3)
# 95% CI dla a i b z hesjanu (na skali log, potem exp)
se <- sqrt(diag(bb_tv$vcov))
ci <- exp(log(c(a = bb_tv$a, b = bb_tv$b)) + outer(se, c(-1.96, 1.96)))
dimnames(ci) <- list(c("a_tv", "b_tv"), c("dolna_95", "gorna_95")); round(ci, 3)
# Kontrola w pakiecie VGAM: ten sam model w parametryzacji mu = a/(a+b), rho = 1/(a+b+1)
fit_vgam <- vglm(cbind(kontakty_tv, n_tv - kontakty_tv) ~ 1, betabinomial, data = panel)
round(rbind(VGAM = Coef(fit_vgam), optim = c(bb_tv$a / (bb_tv$a + bb_tv$b), 1 / (bb_tv$a + bb_tv$b + 1))), 4)

# Model Poissona o tej samej średniej i porównanie dopasowania
lam <- mean(panel$kontakty_tv)
ll_pois <- sum(dpois(panel$kontakty_tv, lam, log = TRUE))
round(lam, 2)                                       # średnia liczba kontaktów = λ Poissona
round(c(logLik_bb = bb_tv$logLik, logLik_poisson = ll_pois,
        AIC_bb = -2 * bb_tv$logLik + 4, AIC_poisson = -2 * ll_pois + 2), 1)

# Zasięg z danych i z obu modeli
x <- 0:n_tv
pr_bb <- dbb(x, n_tv, bb_tv$a, bb_tv$b); pr_po <- dpois(x, lam)
round(rbind(dane = c(zasieg_1plus = mean(panel$kontakty_tv >= 1), zasieg_3plus = mean(panel$kontakty_tv >= 3),
                     zero = mean(panel$kontakty_tv == 0), "12plus" = mean(panel$kontakty_tv >= 12)),
            beta_dwumianowy = c(1 - pr_bb[1], 1 - sum(pr_bb[1:3]), pr_bb[1], sum(pr_bb[x >= 12])),
            Poisson = c(1 - pr_po[1], 1 - sum(pr_po[1:3]), pr_po[1], ppois(11, lam, lower.tail = FALSE))) * 100, 1)

obs <- data.frame(x = x, proc = 100 * tabulate(panel$kontakty_tv + 1, nbins = n_tv + 1) / N)
mod <- rbind(data.frame(model = "beta-dwumianowy", x = x, proc = 100 * pr_bb),
             data.frame(model = "Poisson", x = x, proc = 100 * pr_po))
mod$model <- factor(mod$model, levels = c("beta-dwumianowy", "Poisson"))
p2 <- ggplot() +
  geom_col(data = obs, aes(x, proc, fill = "dane z panelu"), width = 0.8) +
  geom_line(data = mod, aes(x, proc, colour = model, linetype = model), linewidth = 1) +
  geom_point(data = mod, aes(x, proc, colour = model, shape = model), size = 2.4) +
  scale_fill_manual(values = c("dane z panelu" = "grey78"), name = NULL) +
  scale_colour_manual(values = kol[c("beta-dwumianowy", "Poisson")], name = NULL) +
  scale_linetype_manual(values = c("beta-dwumianowy" = "solid", "Poisson" = "22"), name = NULL) +
  scale_shape_manual(values = c("beta-dwumianowy" = 16, "Poisson" = 17), name = NULL) +
  annotate("label", x = 0.6, y = 100 * pr_bb[1] + 2.2, hjust = 0, size = 3.7, linewidth = 0, fill = "white",
           label = sprintf("0 kontaktów: dane %.1f%%, beta-dwum. %.1f%%, Poisson %.1f%%",
                           obs$proc[1], 100 * pr_bb[1], 100 * pr_po[1])) +
  scale_x_continuous(breaks = seq(0, 24, 2)) +
  labs(title = "Ile razy panelista zobaczył spot? Poisson nie widzi osób, do których reklama nie dotarła",
       subtitle = sprintf("2000 panelistów, 24 emisje; średnio %.2f kontaktu; oba modele mają tę samą średnią", lam),
       x = "Liczba kontaktów z reklamą TV", y = "Odsetek panelistów (%)") +
  motyw + guides(fill = guide_legend(order = 1))
p2
# ggsave("zasieg-rozklad-kontaktow-beta-dwumianowy.svg", p2, width = 10, height = 5.4)
Wynik w R
 a_tv  b_tv a_int b_int
0.636 2.588 0.363 1.428
     dolna_95 gorna_95
a_tv    0.591    0.685
b_tv    2.379    2.816
          mu    rho
VGAM  0.1972 0.2367
optim 0.1972 0.2367
[1] 4.72
     logLik_bb logLik_poisson         AIC_bb    AIC_poisson
       -5257.4        -7769.9        10518.8        15541.9
                zasieg_1plus zasieg_3plus zero 12plus
dane                    78.3         55.5 21.7   11.4
beta_dwumianowy         78.1         55.1 21.9   11.6
Poisson                 99.1         84.9  0.9    0.3
4. Prognoza zasięgu przy większej liczbie emisji: Rysunek 3
R
# Rysunek 3. Prognoza zasięgu przy większej liczbie emisji: beta-dwumianowy, Poisson i prawda z symulacji
# (korzysta z kol, motyw, dbb() z przepisu 1, prawda i n_tv z przepisu 2 oraz bb_tv i lam z przepisu 3)
library(ggplot2)
library(patchwork)

# Zasięg k+ przy s emisjach; zakładamy, że nowe emisje są „takie jak dotąd” (te same pasma, ta sama widownia)
zasieg_bb <- function(s, a, b, k = 1) sapply(s, function(si) 100 * (1 - sum(dbb(0:(k - 1), si, a, b))))
zasieg_po <- function(s, k = 1) 100 * ppois(k - 1, s * lam / n_tv, lower.tail = FALSE)
s <- 0:72
krzywe <- rbind(
  data.frame(model = "beta-dwumianowy", s = s, z1 = zasieg_bb(s, bb_tv$a, bb_tv$b), z3 = zasieg_bb(s, bb_tv$a, bb_tv$b, 3)),
  data.frame(model = "Poisson", s = s, z1 = zasieg_po(s), z3 = zasieg_po(s, 3)),
  data.frame(model = "prawda", s = s, z1 = zasieg_bb(s, prawda[["a_tv"]], prawda[["b_tv"]]),
             z3 = zasieg_bb(s, prawda[["a_tv"]], prawda[["b_tv"]], 3)))
srednia <- c("beta-dwumianowy" = bb_tv$a / (bb_tv$a + bb_tv$b), "Poisson" = lam / n_tv,
             "prawda" = prawda[["a_tv"]] / (prawda[["a_tv"]] + prawda[["b_tv"]]))
krzywe$GRP <- krzywe$s * srednia[krzywe$model] * 100  # GRP = emisje × średnia oglądalność bloku × 100
krzywe$model <- factor(krzywe$model, levels = c("beta-dwumianowy", "Poisson", "prawda"))
# Tabela dla 24, 36 i 48 emisji (budżet × 1, × 1.5, × 2)
tab <- subset(krzywe, s %in% c(24, 36, 48))
tab$czest <- tab$GRP / tab$z1                       # średnia częstotliwość = GRP / zasięg 1+
tab[, c("z1", "z3", "GRP", "czest")] <- round(tab[, c("z1", "z3", "GRP", "czest")], 1)
tab[order(tab$model, tab$s), ]

rysuj <- function(kol_y, tytul) {
  ggplot(krzywe, aes(s, .data[[kol_y]], colour = model, linetype = model)) +
    annotate("rect", xmin = n_tv, xmax = Inf, ymin = -Inf, ymax = Inf,
             fill = "grey93") +
    annotate("text", x = 60, y = 8, label = "poza danymi:\nprognoza", size = 3.6, colour = "grey35") +
    geom_line(linewidth = 1.1) +
    geom_point(data = subset(krzywe, s %in% c(24, 48)), aes(shape = model), size = 2.6) +
    scale_colour_manual(values = kol[c("beta-dwumianowy", "Poisson", "prawda")], name = NULL) +
    scale_linetype_manual(values = c("beta-dwumianowy" = "solid", "Poisson" = "22", "prawda" = "11"), name = NULL) +
    scale_shape_manual(values = c("beta-dwumianowy" = 16, "Poisson" = 17, "prawda" = 4), name = NULL) +
    scale_y_continuous(limits = c(0, 100)) + scale_x_continuous(breaks = seq(0, 72, 12)) +
    labs(title = tytul, x = "Liczba emisji spotu (24 ≈ 470 GRP, 48 ≈ 940 GRP)", y = "Zasięg (% grupy docelowej)") + motyw
}
p3 <- rysuj("z1", "A. Zasięg 1+") + rysuj("z3", "B. Zasięg 3+") +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3 <- p3 + plot_annotation(title = "Dwa razy więcej emisji to nie dwa razy większy zasięg",
                           subtitle = "Kropki: 24 emisje (dane) i 48 emisji (podwojony budżet); szare tło – poza zakresem danych",
                           theme = motyw)
p3
# ggsave("zasieg-prognoza-wiekszy-budzet.svg", p3, width = 10, height = 5.6)
Wynik w R
              model  s    z1   z3   GRP czest
25  beta-dwumianowy 24  78.1 55.1 473.4   6.1
37  beta-dwumianowy 36  82.8 64.1 710.1   8.6
49  beta-dwumianowy 48  85.5 69.5 946.8  11.1
98          Poisson 24  99.1 84.9 471.7   4.8
110         Poisson 36  99.9 97.2 707.5   7.1
122         Poisson 48 100.0 99.6 943.4   9.4
171          prawda 24  77.3 54.7 480.0   6.2
183          prawda 36  81.9 63.4 720.0   8.8
195          prawda 48  84.6 68.7 960.0  11.3
5. Łączenie TV i internetu oraz symulacja korelacji widowni: Rysunek 4
R
# Rysunek 4. Łączenie TV i internetu: wzór przy niezależności a nakładanie się widowni (dane + symulacja)
# (korzysta z kol, motyw, dbb() z przepisu 1, panel, N, n_tv, n_int, prawda z przepisu 2 oraz bb_tv, bb_int z przepisu 3)
library(ggplot2)
library(patchwork)

tv1 <- panel$kontakty_tv >= 1; int1 <- panel$kontakty_int >= 1
udzialy <- 100 * c("tylko TV" = mean(tv1 & !int1), "TV i internet" = mean(tv1 & int1),
                   "tylko internet" = mean(!tv1 & int1), "brak kontaktu" = mean(!tv1 & !int1))
round(udzialy, 1)
# Zasięg łączny 1+ z panelu a wzór przy niezależności: 1 − (1 − R_TV)(1 − R_int)
r_tv <- mean(tv1); r_int <- mean(int1)
niezal <- 1 - (1 - r_tv) * (1 - r_int)
round(100 * c(R_TV = r_tv, R_int = r_int, laczny_panel = mean(tv1 | int1), laczny_niezaleznosc = niezal), 1)
# Duplikacja: jaki odsetek osób z kontaktem w internecie miał też kontakt z TV (przy niezależności = R_TV)
round(100 * c(TV_wsrod_internetu = mean(tv1[int1]), R_TV = r_tv), 1)
# Zasięg 3+ łącznie: splot dwóch dopasowanych rozkładów beta-dwumianowych (niezależność) a panel
splot <- convolve(dbb(0:n_tv, n_tv, bb_tv$a, bb_tv$b), rev(dbb(0:n_int, n_int, bb_int$a, bb_int$b)), type = "open")
round(100 * c(laczny_3plus_panel = mean(panel$kontakty_tv + panel$kontakty_int >= 3),
              laczny_3plus_niezaleznosc = 1 - sum(splot[1:3])), 1)

# Symulacja: 200 paneli po 2000 osób dla siedmiu korelacji skłonności TV–internet (rozkłady brzegowe jak w danych)
set.seed(668)
rho_siatka <- round(seq(-0.6, 0.6, by = 0.2), 1)
sym <- do.call(rbind, lapply(rho_siatka, function(r) {
  t(replicate(200, {
    z1 <- rnorm(N); z2 <- r * z1 + sqrt(1 - r^2) * rnorm(N)
    a <- rbinom(N, n_tv, qbeta(pnorm(z1), prawda[["a_tv"]], prawda[["b_tv"]])) >= 1
    b <- rbinom(N, n_int, qbeta(pnorm(z2), prawda[["a_int"]], prawda[["b_int"]])) >= 1
    c(rho = r, roznica = 100 * (mean(a | b) - (1 - (1 - mean(a)) * (1 - mean(b)))))
  }))
}))
sym <- as.data.frame(sym)
podsum <- aggregate(roznica ~ rho, sym, function(x) c(srednia = mean(x), blad_MC = sd(x) / sqrt(length(x)),
                                                     q025 = unname(quantile(x, .025)), q975 = unname(quantile(x, .975))))
podsum <- data.frame(rho = podsum$rho, round(podsum$roznica, 2))
podsum

slupek <- data.frame(grupa = factor(names(udzialy), levels = rev(names(udzialy))), proc = udzialy)
slupek$koniec <- cumsum(udzialy)[match(slupek$grupa, names(udzialy))]; slupek$start <- slupek$koniec - slupek$proc
pA <- ggplot(slupek) +
  geom_rect(aes(xmin = start, xmax = koniec, ymin = 0.6, ymax = 1.4, fill = grupa), colour = "white") +
  geom_text(aes(x = (start + koniec) / 2, y = 1, label = sprintf("%.1f%%", proc),
                colour = grupa %in% c("tylko TV", "TV i internet")), size = 4, show.legend = FALSE) +
  scale_colour_manual(values = c("TRUE" = "white", "FALSE" = "grey10")) +
  annotate("segment", x = 100 * niezal, xend = 100 * niezal, y = 0.45, yend = 1.55, linewidth = 1, linetype = "22") +
  annotate("text", x = 100 * niezal, y = 1.75, size = 3.7, hjust = 1,
           label = sprintf("wzór przy niezależności: %.1f%%", 100 * niezal)) +
  annotate("text", x = 100 * mean(tv1 | int1), y = 0.25, size = 3.7, hjust = 1,
           label = sprintf("zasięg łączny z panelu: %.1f%%", 100 * mean(tv1 | int1))) +
  scale_fill_manual(values = kol[names(udzialy)], breaks = names(udzialy), name = NULL) +
  scale_x_continuous(limits = c(0, 100), breaks = seq(0, 100, 20)) + scale_y_continuous(limits = c(0.1, 1.9)) +
  labs(title = "A. Panel: kto zobaczył reklamę w którym kanale", x = "% grupy docelowej", y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
pB <- ggplot(podsum, aes(rho, srednia)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_errorbar(aes(ymin = q025, ymax = q975), width = 0.04, colour = kol[["beta-dwumianowy"]]) +
  geom_line(colour = kol[["beta-dwumianowy"]], linewidth = 1) +
  geom_point(size = 2.6, colour = kol[["beta-dwumianowy"]]) +
  geom_vline(xintercept = prawda[["rho"]], linetype = "22", colour = "grey40") +
  annotate("text", x = prawda[["rho"]] + 0.03, y = -4.5, hjust = 0, size = 3.6, colour = "grey30",
           label = sprintf("dane z panelu: ρ = −0.3,\nróżnica %+.1f pp", 100 * (mean(tv1 | int1) - niezal))) +
  scale_x_continuous(breaks = rho_siatka) +
  labs(title = "B. Symulacja: błąd wzoru przy niezależności",
       x = "Korelacja skłonności do kontaktu TV–internet (ρ)", y = "Zasięg prawdziwy − ze wzoru (pp)") + motyw
p4 <- pA / pB + plot_layout(heights = c(1, 1.5)) +
  plot_annotation(title = "Zasięg dwóch kanałów zależy od tego, czy trafiają do tych samych osób",
                  subtitle = "B: 200 paneli po 2000 osób na każdą korelację; kropka – średnia, wąsy – 95% wyników",
                  theme = motyw)
p4
# ggsave("zasieg-laczenie-kanalow-tv-internet.svg", p4, width = 10, height = 7.6)
Wynik w R
      tylko TV  TV i internet tylko internet  brak kontaktu
          35.4           42.9           16.0            5.8
               R_TV               R_int        laczny_panel laczny_niezaleznosc
               78.3                58.8                94.2                91.1
TV_wsrod_internetu               R_TV
              72.9               78.3
       laczny_3plus_panel laczny_3plus_niezaleznosc
                     79.2                      74.4
   rho srednia blad_MC  q025  q975
1 -0.6    5.79    0.03  5.05  6.51
2 -0.4    3.85    0.03  2.94  4.69
3 -0.2    1.91    0.03  1.00  2.73
4  0.0    0.00    0.03 -0.94  0.81
5  0.2   -1.98    0.03 -2.81 -1.08
6  0.4   -4.07    0.03 -4.95 -3.23
7  0.6   -6.25    0.03 -7.12 -5.40
6. Bootstrap panelistów: Rysunek 5
R
# Rysunek 5. Niepewność wskaźników z panelu: bootstrap panelistów (1000 prób), z ponownym dopasowaniem modelu
# (korzysta z kol, motyw, dbb() z przepisu 1, panel, N, n_tv, prawda z przepisu 2 oraz dopasuj_bb() z przepisu 3)
library(ggplot2)
library(patchwork)

statystyki <- function(d) {
  bb <- dopasuj_bb(d$kontakty_tv, n_tv)
  c("TV 1+" = 100 * mean(d$kontakty_tv >= 1), "TV 3+" = 100 * mean(d$kontakty_tv >= 3),
    "TV + internet 1+" = 100 * mean(d$kontakty_tv + d$kontakty_int >= 1),
    "Prognoza 1+ (48 emisji)" = 100 * (1 - dbb(0, 48, bb$a, bb$b)),
    GRP = 100 * mean(d$kontakty_tv), czestotliwosc = mean(d$kontakty_tv[d$kontakty_tv >= 1]))
}
set.seed(668)
B <- 1000
boot <- t(replicate(B, statystyki(panel[sample.int(N, N, replace = TRUE), ])))
wynik <- data.frame(wskaznik = colnames(boot), oszacowanie = statystyki(panel),
                    dolna = apply(boot, 2, quantile, .025), gorna = apply(boot, 2, quantile, .975), row.names = NULL)
wynik[, -1] <- round(wynik[, -1], 2)
wynik
# Prawdziwy zasięg 1+ przy 48 emisjach (znany tylko w symulacji) i szerokość przedziałów w punktach procentowych
round(c(prawda_48 = 100 * (1 - dbb(0, 48, prawda[["a_tv"]], prawda[["b_tv"]])),
        szer_TV1 = wynik$gorna[1] - wynik$dolna[1], szer_prognozy = wynik$gorna[4] - wynik$dolna[4]), 2)

dA <- wynik[1:4, ]; dA$wskaznik <- factor(dA$wskaznik, levels = rev(dA$wskaznik))
pA <- ggplot(dA, aes(oszacowanie, wskaznik)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", colour = kol[["beta-dwumianowy"]], linewidth = 0.9) +
  geom_point(size = 3, colour = kol[["beta-dwumianowy"]]) +
  geom_text(aes(x = gorna, label = sprintf("%.1f [%.1f, %.1f]", oszacowanie, dolna, gorna)),
            hjust = -0.1, size = 3.6, colour = "grey20") +
  scale_x_continuous(limits = c(50, 112), breaks = seq(50, 100, 10)) +
  labs(title = "A. Zasięg i 95% przedział", x = "% grupy docelowej", y = NULL) + motyw
dB <- data.frame(prognoza = boot[, 4])
pB <- ggplot(dB, aes(prognoza)) +
  geom_histogram(bins = 30, fill = "grey75", colour = "white") +
  geom_vline(xintercept = wynik$oszacowanie[4], colour = kol[["beta-dwumianowy"]], linewidth = 1) +
  geom_vline(xintercept = 100 * (1 - dbb(0, 48, prawda[["a_tv"]], prawda[["b_tv"]])), linetype = "11", linewidth = 1) +
  annotate("text", x = 100 * (1 - dbb(0, 48, prawda[["a_tv"]], prawda[["b_tv"]])), y = Inf, vjust = 1.4, hjust = 1.05,
           label = "prawda", size = 3.6) +
  annotate("text", x = wynik$oszacowanie[4], y = Inf, vjust = 1.4, hjust = -0.1, label = "z panelu", size = 3.6,
           colour = kol[["beta-dwumianowy"]]) +
  labs(title = "B. Prognoza 1+ (48 emisji)", x = "Zasięg 1+ (%)", y = "Liczba prób") + motyw
p5 <- pA + pB + plot_layout(widths = c(1.5, 1)) +
  plot_annotation(title = "Bootstrap mierzy błąd losowania panelu, a nie błąd założeń prognozy",
                  subtitle = "Bootstrap: 1000 prób panelistów ze zwracaniem; w każdej próbie model dopasowano od nowa",
                  theme = motyw)
p5
# ggsave("zasieg-bootstrap-niepewnosc-panelu.svg", p5, width = 10, height = 5.2)
Wynik w R
                 wskaznik oszacowanie  dolna  gorna
1                   TV 1+       78.30  76.40  80.10
2                   TV 3+       55.50  53.45  57.75
3        TV + internet 1+       94.25  93.15  95.20
4 Prognoza 1+ (48 emisji)       85.51  83.99  86.92
5                     GRP      471.70 449.60 493.06
6           czestotliwosc        6.02   5.78   6.27
    prawda_48      szer_TV1 szer_prognozy
        84.64          3.70          2.93
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace (korzysta z kol z przepisu 1)
library(colorspace)
pary <- list("beta-dwumianowy – Poisson" = kol[c("beta-dwumianowy", "Poisson")],
             "beta-dwumianowy – obserwowane" = kol[c("beta-dwumianowy", "obserwowane")],
             "Poisson – obserwowane" = kol[c("Poisson", "obserwowane")],
             "tylko TV – TV i internet" = kol[c("tylko TV", "TV i internet")],
             "TV i internet – tylko internet" = kol[c("TV i internet", "tylko internet")],
             "tylko internet – brak kontaktu" = kol[c("tylko internet", "brak kontaktu")],
             "kontakty 1–2 – 3–5" = kol_kontakty[c("1–2", "3–5")],
             "kontakty 3–5 – 6 i więcej" = kol_kontakty[c("3–5", "6 i więcej")],
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
beta-dwumianowy – Poisson                  120.2        121.5      109.3
beta-dwumianowy – obserwowane               45.7         49.6       41.3
Poisson – obserwowane                       76.7         73.7       69.9
tylko TV – TV i internet                    70.1         55.4       58.0
TV i internet – tylko internet              88.7         66.3       51.5
tylko internet – brak kontaktu              78.1         74.5       72.7
kontakty 1–2 – 3–5                          24.6         25.0       20.9
kontakty 3–5 – 6 i więcej                   43.8         39.5       39.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, funkcje rozkładów i optymalizacja (optim(), convolve()) – pakiet stats z podstawowej instalacji R. Kontrolne dopasowanie rozkładu beta-dwumianowego – pakiet VGAM. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- VGAM (wersja 1.1.14): Yee, T. W. (2015). Vector generalized linear and additive models: With an implementation in R. Springer. https://doi.org/10.1007/978-1-4939-2818-7
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- GRP jako miara dotarcia. Ten sam GRP daje szeroki zasięg z małą częstotliwością albo wąski z dużą (rysunek 1).
- Poisson przy zróżnicowanej widowni. Zawyża zasięg i zaniża liczbę osób bez kontaktu (rysunek 2).
- Prognoza daleko poza danymi. Krzywa zasięgu przy 72 emisjach z kampanii 24 emisji to założenie o widowni, a nie wynik (rysunek 3).
- Wzór przy niezależności bez sprawdzenia. Przy korelacji widowni ±0.6 myli się o około 6 pp w jedną lub drugą stronę (rysunek 4B).
- Zasięg bez przedziału. Różnica 1–2 pp między planami z panelu 2000 osób mieści się w błędzie losowania (rysunek 5).
- Bootstrap pojedynczych osób w panelu gospodarstw. Losuj całe gospodarstwa – inaczej przedziały będą za wąskie.
- Kontakt to nie zobaczenie. Panel rejestruje, że ktoś był przed telewizorem lub że reklama się wyświetliła, a nie że ją zauważył.
Najczęstsze pytania
Co to jest GRP i jak je policzyć?
GRP (gross rating points, punkty ratingowe brutto) to suma kontaktów z reklamą na 100 osób z grupy docelowej, czyli suma oglądalności wszystkich emisji. Równa się zasięgowi 1+ (w %) pomnożonemu przez średnią częstotliwość. W przykładzie 24 emisje dały 471.7 GRP: zasięg 78.3% × 6.02 kontaktu. GRP nie mówi, do ilu osób dotarła reklama.
Czym różni się zasięg 1+ od zasięgu 3+?
Zasięg 1+ to odsetek osób z co najmniej jednym kontaktem z reklamą, a 3+ – z co najmniej trzema. Zasięg 3+ opisuje, do ilu osób reklama dotarła wielokrotnie. W przykładzie wynosiły 78.3% i 55.5%. Próg 3+ to konwencja planowania, a nie reguła; to, czy kolejne kontakty działają, trzeba sprawdzić osobno.
Dlaczego do liczby kontaktów z reklamą stosuje się rozkład beta-dwumianowy?
Bo szansa zobaczenia emisji jest różna u różnych osób: jedni oglądają dużo, inni prawie wcale. Rozkład beta-dwumianowy zakłada, że ta szansa pochodzi z rozkładu beta, więc dopuszcza wiele zer i długi ogon. Rust i Klompmaker (1981) opisują go jako model rozkładu częstotliwości kontaktów w telewizji. Poisson tego nie uwzględnia i zawyża zasięg.
Jak policzyć łączny zasięg dwóch kanałów reklamy?
Przy niezależności kanałów: 1 − (1 − R1) × (1 − R2). Wzór jest trafny tylko wtedy, gdy kontakt w jednym kanale nie zależy od kontaktu w drugim. W przykładzie dał 91.1%, a panel pokazał 94.2%, bo internet częściej docierał do osób oglądających mało telewizji. Najlepiej policz zasięg łączny bezpośrednio z panelu mierzącego oba kanały u tych samych osób.
Jak podać niepewność zasięgu z panelu?
Oszacuj przedział ufności bootstrapem: losuj panelistów ze zwracaniem, licz zasięg od nowa i weź 2.5 i 97.5 percentyl z 1000 prób. W panelu 2000 osób zasięg 1+ wyniósł 78.3%, 95% CI [76.4, 80.1]. Gdy panel jest ważony albo dobierany gospodarstwami, uwzględnij wagi i losuj całe gospodarstwa.
Powiązane hasła
Przeczytaj też
Częstotliwość kontaktu z reklamą
Serwis VOD: krzywa odpowiedzi z GAM, nasycenie i zmęczenie reklamą, pułapka aktywnych użytkowników, losowy limit wyświetleń i zysk – z kodem R.
Czytaj →PoradnikMarketing mix modeling (MMM)
Producent soków, 156 tygodni i dwa kanały reklamy: adstock, nasycenie, rozkład sprzedaży, ROI z bootstrapem blokowym i pułapki – sześć rysunków z kodem R.
Czytaj →PoradnikAnaliza TURF
Który zestaw smaków dotrze do największej liczby klientów: zasięg, częstość, przegląd 495 zestawów i bootstrap zwycięzcy z kodem R.
Czytaj →Analizujesz zasięg kampanii w pracy z marketingu?
Pomożemy przygotować dane z panelu, dopasować rozkład kontaktów, policzyć zasięg z przedziałami ufności i opisać ograniczenia – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Danaher, P. J. (1992). Some statistical modeling problems in the advertising industry: A look at media exposure distributions. The American Statistician, 46(4), 254–260. https://doi.org/10.1080/00031305.1992.10475899
- Danaher, P. J., Lee, J., & Kerbache, L. (2010). Optimal internet media selection. Marketing Science, 29(2), 336–347. https://doi.org/10.1287/mksc.1090.0507
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Goodhardt, G. J., & Ehrenberg, A. S. C. (1969). Duplication of television viewing between and within channels. Journal of Marketing Research, 6(2), 169–178. https://doi.org/10.1177/002224376900600205
- Headen, R. S., Klompmaker, J. E., & Teel, J. E. (1977). Predicting audience exposure to spot TV advertising schedules. Journal of Marketing Research, 14(1), 1–9. https://doi.org/10.1177/002224377701400101
- Rust, R. T., & Klompmaker, J. E. (1981). Improving the estimation procedure for the beta binomial TV exposure model. Journal of Marketing Research, 18(4), 442–448. https://doi.org/10.1177/002224378101800405
- Skellam, J. G. (1948). A probability distribution derived from the binomial distribution by regarding the probability of success as variable between the sets of trials. Journal of the Royal Statistical Society: Series B (Methodological), 10(2), 257–261. https://doi.org/10.1111/j.2517-6161.1948.tb00014.x
Cytowania BibTeX
@article{danaher1992some, author={Danaher, Peter J.}, title={{Some statistical modeling problems in the advertising industry: A look at media exposure distributions}}, journal={The American Statistician}, year={1992}, volume={46}, number={4}, pages={254--260}, doi={10.1080/00031305.1992.10475899}}@article{danaher2010optimal, author={Danaher, Peter J. and Lee, Janghyuk and Kerbache, Laoucine}, title={{Optimal internet media selection}}, journal={Marketing Science}, year={2010}, volume={29}, number={2}, pages={336--347}, doi={10.1287/mksc.1090.0507}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{goodhardt1969duplication, author={Goodhardt, G. J. and Ehrenberg, A. S. C.}, title={{Duplication of television viewing between and within channels}}, journal={Journal of Marketing Research}, year={1969}, volume={6}, number={2}, pages={169--178}, doi={10.1177/002224376900600205}}@article{headen1977predicting, author={Headen, Robert S. and Klompmaker, Jay E. and Teel, Jesse E.}, title={{Predicting audience exposure to spot TV advertising schedules}}, journal={Journal of Marketing Research}, year={1977}, volume={14}, number={1}, pages={1--9}, doi={10.1177/002224377701400101}}@article{rust1981improving, author={Rust, Roland T. and Klompmaker, Jay E.}, title={{Improving the estimation procedure for the beta binomial TV exposure model}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={4}, pages={442--448}, doi={10.1177/002224378101800405}}@article{skellam1948probability, author={Skellam, J. G.}, title={{A probability distribution derived from the binomial distribution by regarding the probability of success as variable between the sets of trials}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1948}, volume={10}, number={2}, pages={257--261}, doi={10.1111/j.2517-6161.1948.tb00014.x}}