Przykład: sklep z odzieżą i reklama w sieci reklamowej
Fikcyjny sklep internetowy z odzieżą przez 4 tygodnie pokazuje swoim klientom (osobom z kontem w sklepie) reklamy graficzne w sieci reklamowej, czyli na portalach i w aplikacjach partnerów. Panel reklamowy raportuje 6391 zakupów „po wyświetleniu reklamy” przy koszcie 40 672 zł, czyli 6.4 zł za zakup. Dyrektor marketingu pyta: ile z tych zakupów i tak by się wydarzyło? Klient, który często bywa w sieci i w sklepie, częściej widzi reklamę i częściej kupuje – z reklamą czy bez niej.
Odpowiedź daje test wyłączenia reklamy (ang. holdout test, test inkrementalności). Przed kampanią losujemy 10% klientów z listy i wyłączamy im reklamę. To zwykły test A/B, w którym wersja B to „bez reklamy”. Różnica w sprzedaży między grupami to przyrost (inkrementalność): sprzedaż, której bez reklamy by nie było. Ten sam pomysł z ankietą zamiast sprzedaży opisuje wpis brand lift – efekt kampanii reklamowej; tu mierzymy zakupy i złotówki.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: 250 000 klientów, w tym 25 000 w holdoucie; ukrytą aktywność klienta, od której zależy i to, czy reklama do niego dotrze, i szansa zakupu (średnio 4.4% w 4 tygodnie bez reklamy); efekt kontaktu z reklamą +0.12 w skali logitu; 25 zł za 1000 wyświetleń; marżę brutto 45%; panel, który przypisuje reklamie 75% zakupów osób, które ją widziały. Dodaliśmy też trzy zamówienia firmowe (22 800, 27 300 i 41 500 zł): jedno w holdoucie, dwa w grupie reklamowej. Ziarno 666 ustaliliśmy raz; po pierwszym uruchomieniu poprawialiśmy tylko wygląd rysunków, nie dane. Dane pobierzesz jako holdout-reklamy-sklep-odziezowy.csv (wiersz = klient: grupa R – reklamowa, H – holdout; czy widział reklamę, zakup, przychód w zł, zakup przypisany reklamie w panelu).
Rysunek 1: losowanie, kontakt z reklamą, porównanie
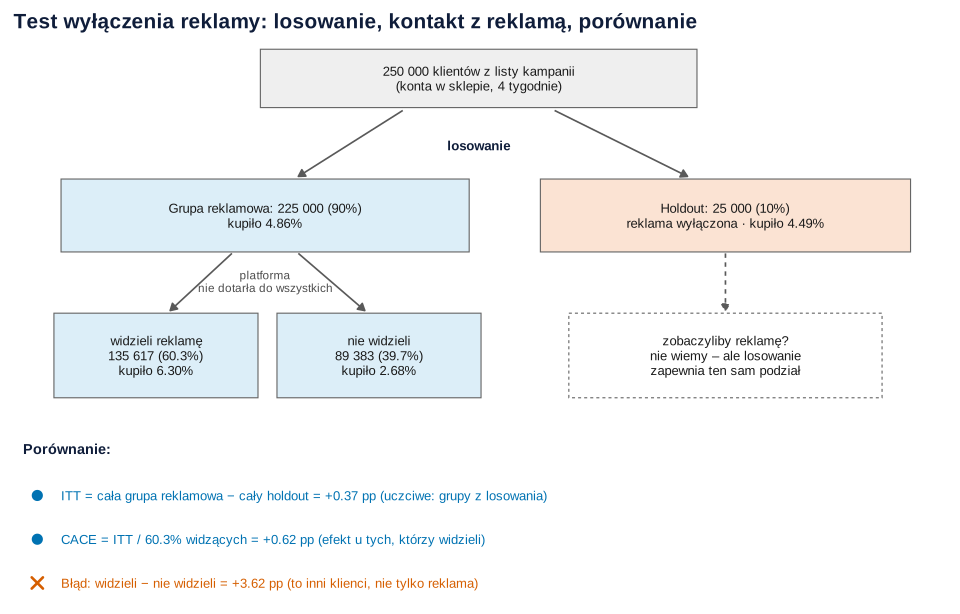
set.seed(666)).Co widać. Randomizacja dzieli 250 000 klientów na grupę reklamową (225 000) i holdout (25 000). Platforma nie dociera jednak do wszystkich: reklamę zobaczyło 135 617 osób, czyli 60.3% grupy reklamowej. W holdoucie też są osoby, do których reklama by dotarła, ale nie wiemy które. Losowanie zapewnia, że jest ich tam średnio tyle samo (w proporcji) i są tak samo aktywni.
Jak może zmylić. Kusi porównanie widzących z niewidzącymi w grupie reklamowej. To nie jest porównanie z losowania: reklama trafia głównie do aktywnych klientów, którzy i tak kupują częściej (błąd selekcji).
Zdanie do Metody:
Rysunek 2: przyrost sprzedaży (ITT) i efekt u widzących (CACE)
Uczciwe porównanie zestawia całe grupy z losowania, bez względu na to, kto reklamę zobaczył. To analiza ITT (intention-to-treat). Drugi krok przelicza ją na efekt u osób, które reklamę widziały (CACE, ang. complier average causal effect):
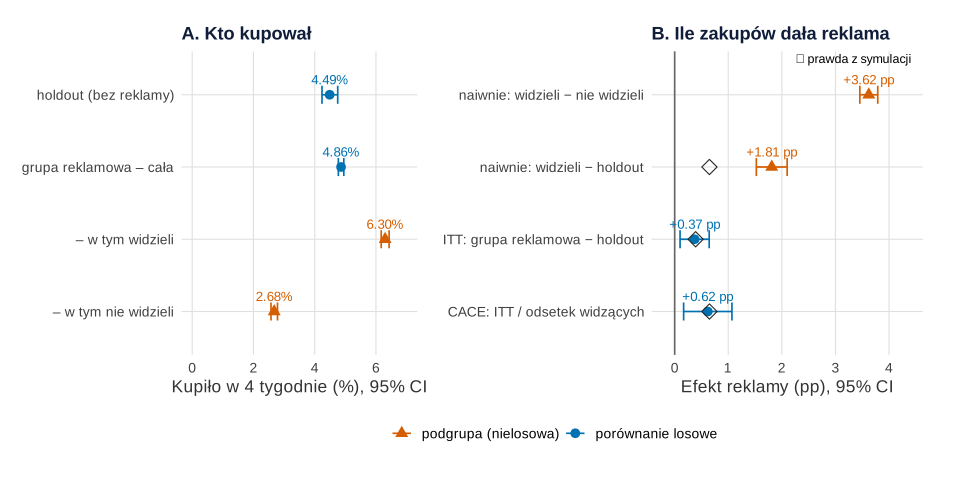
set.seed(666)).Co widać. W holdoucie kupiło 4.49% klientów, 95% CI [4.24, 4.75], a w grupie reklamowej 4.86% [4.77, 4.95] (przedziały Wilsona). ITT wynosi +0.37 pp, 95% CI [0.10, 0.64], p = .009, czyli +8.3% względem holdoutu i około 838 dodatkowych kupujących w grupie reklamowej. Prawda z symulacji to 0.39 pp. Porównanie naiwne daje +3.62 pp (6.30% wobec 2.68%), prawie dziesięć razy więcej. Nawet „widzieli kontra holdout” (+1.81 pp) zawyża efekt, bo holdout miesza osoby, do których reklama by dotarła, z pozostałymi.
CACE. Dzielimy ITT przez 0.603 i dostajemy +0.62 pp, 95% CI [0.17, 1.07] (prawda: 0.65 pp; przedział z metody delta). To estymator zmiennej instrumentalnej, w którym instrumentem jest losowanie (RDD i zmienne instrumentalne). Angrist i in. (1996) pokazali, że przy losowym przydziale i niepełnym stosowaniu się do niego taki iloraz jest średnim efektem u osób stosujących się do przydziału. Tu są to klienci, do których reklama dociera. Hasło LATE opisuje założenia, m.in. to, że reklama nie działa na osoby, które jej nie zobaczyły.
Jak może zmylić. CACE dotyczy aktywniejszych klientów, więc nie przenoś go na całą listę. Do budżetu potrzebny jest ITT: płacimy za kampanię puszczoną na grupę, a nie za wybranych widzów. Gdy platforma potrafi wskazać w holdoucie osoby, którym reklama zostałaby pokazana (metoda „reklam-duchów”), efekt u widzących mierzy się precyzyjniej i taniej niż przez ITT (Johnson i in., 2017).
Zdanie do Wyników:
Rysunek 3: iCPA a CPA z panelu reklamowego
Koszt pozyskania zakupu (CPA) w panelu to koszt podzielony przez zakupy przypisane reklamie. Koszt dodatkowego zakupu (iCPA, ang. incremental cost per acquisition) dzieli ten sam koszt przez zakupy, których bez reklamy by nie było:
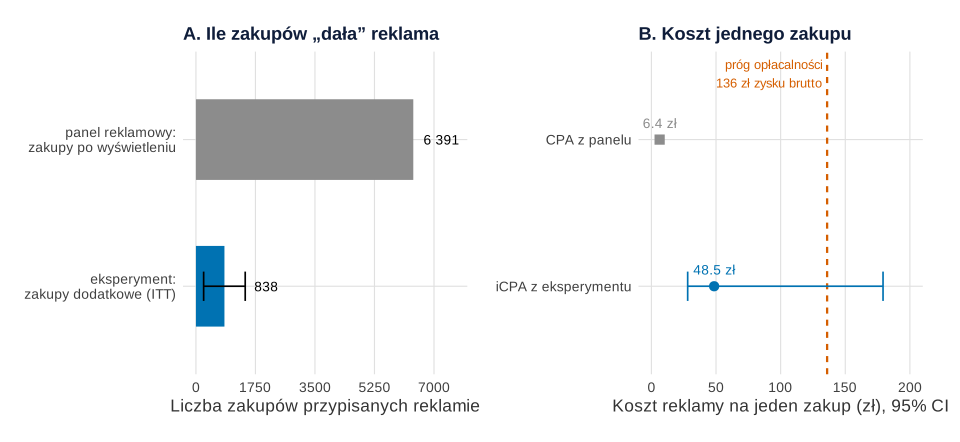
Co widać. Panel przypisuje reklamie 6391 zakupów, eksperyment pokazuje 838 dodatkowych [227, 1449] – panel zawyża 7.6 raza. CPA z panelu to 6.4 zł, a iCPA 48.5 zł, 95% CI [28.1, 179.2]. Granice dostajemy, dzieląc koszt przez górną i dolną granicę liczby dodatkowych zakupów, dlatego przedział jest niesymetryczny. Próg opłacalności to 136 zł zysku brutto z kupującego (45% średniej wartości zakupów po winsoryzacji, zob. rysunek 4). Zysk netto kampanii wynosi 73 268 zł, ale 95% CI [−9 819, 156 354] – straty nie da się wykluczyć.
Jak może zmylić. Panel liczy zakupy osób, które widziały reklamę, a nie zakupy spowodowane reklamą – to ten sam problem co w atrybucji kanałów. W eksperymentach z reklamą w wyszukiwarce zwrot okazał się ułamkiem oszacowań nieeksperymentalnych, bo kliknięcia są skorelowane z zamiarem zakupu (Blake i in., 2015). Metody obserwacyjne często nie odtwarzały też wyników dużych eksperymentów reklamowych (Gordon i in., 2019). Gdy przedział ITT obejmuje zero, górna granica iCPA jest nieskończona.
Zdanie do Wyników:
Rysunek 4: przychód i trzy zamówienia firmowe
Zarząd pyta też o złotówki: o ile wzrósł przychód na klienta? Tu wchodzą wartości skrajne. Próg winsoryzacji to 99.9. centyl wartości zakupów kupujących z 4 tygodni przed testem (2827 zł), ustalony przed odczytem wyników.
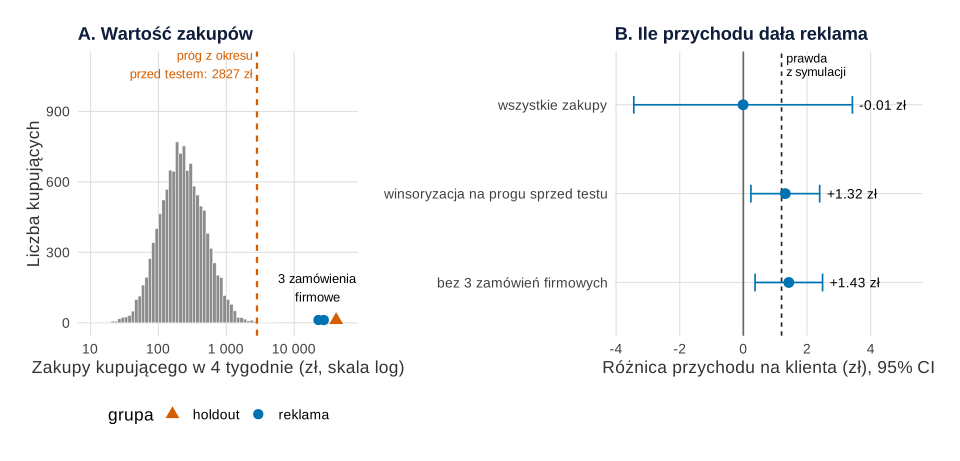
Co widać. Powyżej progu jest 10 kupujących, w tym trzy zamówienia firmowe. Jedno (41 500 zł) trafiło do holdoutu, który liczy tylko 25 000 osób, więc odchylenie standardowe przychodu wynosi tam 274.36 zł, a w grupie reklamowej 116.74 zł. Średni przychód na klienta jest prawie równy (14.94 i 14.93 zł): różnica −0.01 zł, 95% CI [−3.44, 3.43], p = .996 (test Welcha). Po winsoryzacji reklama daje +1.32 zł na klienta [0.24, 2.40], p = .017, blisko prawdy z symulacji (1.20 zł).
Jak może zmylić. Jedno zamówienie zmieniło wniosek z „reklama działa” na „brak efektu”. Kusi, by je po prostu usunąć, ale próg wybrany po obejrzeniu wyników to ukryta furtka: procedura wykluczeń, która nie jest ślepa na hipotezę, może zawyżać odsetek fałszywych alarmów (André, 2022). Ustal próg przed testem, wspólny dla obu grup; wybór miary dla skośnych metryk opisuje wpis czas na stronie i inne skośne metryki. Przychód jest też dużo bardziej zmienny niż odsetek kupujących, więc jego przedział jest szerszy.
Zdanie do Wyników:
Rysunek 5: ile procent klientów wyłączyć
Przedział ITT [0.10, 0.64] jest szeroki, bo holdout ma tylko 25 000 osób. Większy holdout to większa precyzja, ale też więcej klientów bez reklamy, czyli utracony zysk. Symulujemy po 1000 kampanii dla holdoutów od 1% do 50% przy prawdziwym efekcie z danych.
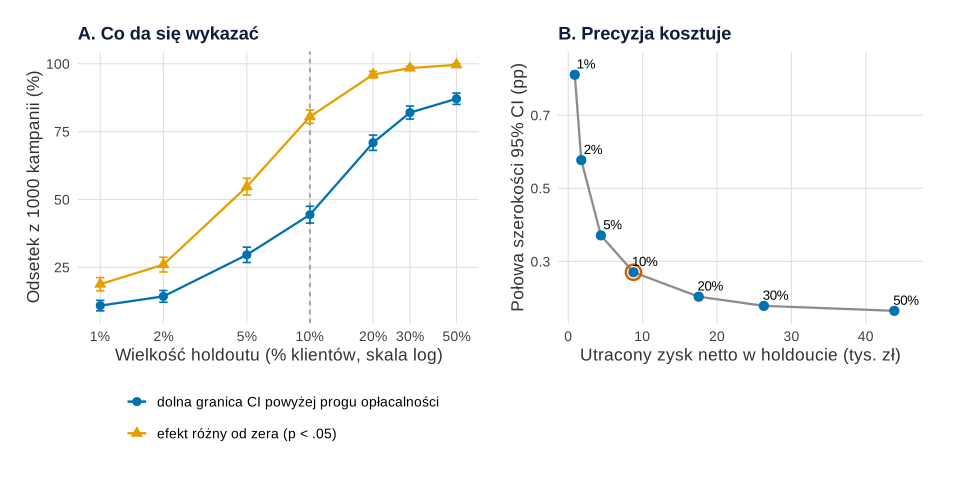
set.seed(666)).Co widać. Przy holdoucie 10% test wykrywa efekt (p < .05) w 80.5% kampanii (błąd Monte Carlo 1.3 pp), ale opłacalność – dolną granicę przedziału powyżej progu 0.133 pp, przy którym kampania wychodzi na zero – potwierdza tylko w 44.4%. Przy 1% to 18.8% i 10.9%, przy 50% – 99.6% i 87.1%. Połowa szerokości przedziału spada z .811 pp (1%) do .270 pp (10%) i .165 pp (50%), a utracony zysk netto rośnie z 877 zł do 8766 i 43 829 zł. Powyżej 20–30% precyzja rośnie już wolno, bo kurczy się grupa reklamowa.
Jak może zmylić. Rysunek liczy moc przy prawdziwym efekcie, którego przed testem nie znasz – planuj na najmniejszym efekcie, który się opłaca. Lewis i Rao (2015) w 25 dużych eksperymentach reklamowych mieli medianę szerokości przedziału dla ROI powyżej 100 pp, a informatywny eksperyment mógł wymagać ponad 10 mln osobotygodni. Zamiast większego holdoutu można wydłużyć test albo losować regiony, jak we wpisie geo-eksperyment.
Zdanie do Metody:
Co z tym zrobić w marketingu
- Raportuj iCPA, nie CPA z panelu. Tu panel zawyżał efekt 7.6 raza; ten mnożnik dotyczy jednej kampanii i trzeba go sprawdzać testem.
- Kampanię kontynuuj, ale powtórz test. Najlepsze oszacowanie to 73 268 zł zysku netto, lecz przedział obejmuje stratę. Następny test zrób z holdoutem 20–30% albo dłuższy.
- Zapisz plan przed startem: metryka główna (odsetek kupujących), próg winsoryzacji przychodu, czas trwania i najmniejszy opłacalny efekt.
- Wynik testu wykorzystaj dalej – do sprawdzenia modelu marketing mix modeling i do testu limitu wyświetleń (częstotliwość kontaktu z reklamą).
Jak opisać w pracy
W Metodzie podaj jednostkę losowania (klient), udział holdoutu, czas, metrykę główną, próg winsoryzacji i jego źródło; w Wynikach – ITT z 95% CI, potem CACE i iCPA. Inne tematy prac z danymi marketingowymi zebraliśmy we wpisie statystyka w pracy z marketingu.
Kod R: dane, ITT, CACE, iCPA, przychód i wielkość holdoutu
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne przepisy. Wszystko liczymy w bazowym R (prop.test(), t.test(), rbinom()). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 i 5; każdy zaczyna od własnego set.seed(666). Ziarno 666 ustalono raz i nie zmieniano go. Ręcznie ustalono: 250 000 klientów i holdout 25 000 (10%), rozkład ukrytej aktywności klientów, model zasięgu reklamy (logit 0.55 + 1.3 × aktywność), szansę zakupu bez reklamy (logit −3.35 + 0.8 × aktywność), efekt kontaktu z reklamą (+0.12 w skali logitu), liczbę wyświetleń (1 + Poisson ze średnią 11), 25 zł za 1000 wyświetleń, marżę brutto 45%, odsetek zakupów przypisywanych w panelu (75%), wartość zakupów (lognormalna z medianą 190 zł × liczba zamówień) i trzy zamówienia firmowe (22 800, 27 300 i 41 500 zł; ręcznie 1 w holdoucie i 2 w grupie reklamowej). Po pierwszym uruchomieniu zmieniono tylko wygląd rysunków (położenie etykiet, tytuły), nie dane. Powtórzenia: symulacja 1000 kampanii dla każdego z 7 udziałów holdoutu. Całość liczy się w kilka sekund.
1. Paleta, motyw i dane klientów
R
# Dane. Fikcyjny sklep internetowy z odzieżą: reklama w sieci reklamowej wyłączona dla losowych 10% klientów
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie ---------------------------------------------------------------
N          <- 250000   # klienci z listy kampanii (konta w sklepie), kampania trwa 4 tygodnie
n_holdout  <- 25000    # 10% losowo wyłączonych z reklamy (holdout)
koszt_1000 <- 25       # zł za 1000 wyświetleń reklamy
marza      <- 0.45     # marża brutto jako udział w wartości zakupów
okno_panel <- 0.75     # odsetek zakupów osób, które widziały reklamę, przypisanych reklamie przez panel

set.seed(666)
aktywnosc <- rnorm(N)                                         # ukryta aktywność klienta (analityk jej nie zna)
grupa <- sample(rep(c("reklama", "holdout"), c(N - n_holdout, n_holdout)))
osiagalny <- rbinom(N, 1, plogis(0.55 + 1.3 * aktywnosc))     # czy reklama w ogóle dotarłaby do klienta
widzial <- ifelse(grupa == "reklama", osiagalny, 0)           # w holdoucie reklamy nie ma
wyswietlenia <- ifelse(widzial == 1, 1 + rpois(N, 11), 0)
p0 <- plogis(-3.35 + 0.8 * aktywnosc)                         # szansa zakupu w 4 tygodnie bez reklamy
p1 <- plogis(qlogis(p0) + 0.12)                               # po kontakcie z reklamą: +0.12 w skali logitu
u <- runif(N)
zakup0 <- as.integer(u < p0); zakup1 <- as.integer(u < p1)    # wynik bez reklamy i z reklamą (ta sama osoba)
zakup <- ifelse(widzial == 1, zakup1, zakup0)
wartosc <- round(rlnorm(N, log(190), 0.7) * (1 + rpois(N, 0.25)))  # wartość zakupów w 4 tygodnie (zł), gdy kupi
# Trzy zamówienia firmowe (stroje dla pracowników): ręcznie 1 w holdoucie i 2 w grupie reklamowej
firmowe <- c(sample(which(grupa == "holdout"), 1), sample(which(grupa == "reklama"), 2))
zakup0[firmowe] <- 1; zakup1[firmowe] <- 1; zakup[firmowe] <- 1
wartosc[firmowe] <- c(41500, 22800, 27300)
przychod <- zakup * wartosc
panel <- as.integer(widzial == 1 & zakup == 1 & runif(N) < okno_panel)  # „konwersje po wyświetleniu” w panelu
# 4 tygodnie przed testem (bez reklamy): stąd próg winsoryzacji ustalony przed wynikami
przed <- as.integer(runif(N) < p0) * round(rlnorm(N, log(190), 0.7) * (1 + rpois(N, 0.25)))

sklep <- data.frame(grupa, widzial, zakup, przychod, panel)
# Plik CSV (2.5 MB): grupa R = reklama, H = holdout; wiersz = klient
write.csv(transform(sklep, grupa = ifelse(grupa == "reklama", "R", "H")), "holdout-reklamy-sklep-odziezowy.csv",
          row.names = FALSE, quote = FALSE)

# Opis grup
koszt <- sum(wyswietlenia) / 1000 * koszt_1000
round(c(klienci = N, reklama = sum(grupa == "reklama"), holdout = sum(grupa == "holdout"),
        widzialo_proc = 100 * mean(widzial[grupa == "reklama"]), wyswietlen_tys = sum(wyswietlenia) / 1000,
        koszt_zl = koszt, przypisane_panel = sum(panel)), 2)
round(sapply(split(sklep, grupa), function(d) c(n = nrow(d), zakup_proc = 100 * mean(d$zakup),
      kupujacych = sum(d$zakup), przychod_na_klienta = mean(d$przychod))), 3)
# Prawda znana z symulacji (w realnych danych nieznana)
prawda <- c(ITT_pp = 100 * mean(osiagalny * (p1 - p0)), CACE_pp = 100 * mean((p1 - p0)[osiagalny == 1]),
            dodatkowi_kupujacy = sum((grupa == "reklama") * osiagalny * (zakup1 - zakup0)),
            ITT_przychod_zl = mean(osiagalny * (zakup1 - zakup0) * wartosc))
round(prawda, 3)
Wynik w R
         klienci          reklama          holdout    widzialo_proc
       250000.00        225000.00         25000.00            60.27
  wyswietlen_tys         koszt_zl przypisane_panel
         1626.88         40672.00          6391.00
                      holdout   reklama
n                   25000.000 225000.00
zakup_proc              4.488      4.86
kupujacych           1122.000  10936.00
przychod_na_klienta    14.938     14.93
            ITT_pp            CACE_pp dodatkowi_kupujacy    ITT_przychod_zl
             0.391              0.649            887.000              1.201
2. ITT, CACE i porównania naiwne: Rysunek 2
R
# Rysunek 2. Ile zakupów dała reklama: porównanie naiwne, ITT (cała grupa reklamowa vs holdout) i CACE
# Korzysta z obiektów przepisu 1: sklep, prawda, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

R <- sklep[sklep$grupa == "reklama", ]; H <- sklep[sklep$grupa == "holdout", ]
wilson <- function(x, n) { t <- prop.test(x, n, correct = FALSE); 100 * c(t$estimate, t$conf.int) }
odsetki <- rbind("holdout (bez reklamy)"   = wilson(sum(H$zakup), nrow(H)),
                 "grupa reklamowa – cała"  = wilson(sum(R$zakup), nrow(R)),
                 "– w tym widzieli"        = wilson(sum(R$zakup[R$widzial == 1]), sum(R$widzial == 1)),
                 "– w tym nie widzieli"    = wilson(sum(R$zakup[R$widzial == 0]), sum(R$widzial == 0)))
colnames(odsetki) <- c("zakup_proc", "dolna", "gorna")
round(odsetki, 2)

roznica <- function(a, b) {   # różnica odsetków a − b (pp) z 95% CI (Wald) i p
  t <- prop.test(c(sum(a), sum(b)), c(length(a), length(b)), correct = FALSE)
  c(pp = 100 * unname(-diff(t$estimate)), dolna = 100 * t$conf.int[1], gorna = 100 * t$conf.int[2], p = t$p.value)
}
itt <- roznica(R$zakup, H$zakup)                                    # intention-to-treat
c_widz <- mean(R$widzial)                                           # odsetek grupy reklamowej, który widział reklamę
se_itt <- (itt[["gorna"]] - itt[["dolna"]]) / (2 * 1.96)
se_c <- sqrt(c_widz * (1 - c_widz) / nrow(R))
cace <- itt[["pp"]] / c_widz                                         # estymator Walda: ITT / odsetek widzących
se_cace <- sqrt(se_itt^2 / c_widz^2 + itt[["pp"]]^2 * se_c^2 / c_widz^4)   # metoda delta
efekty <- rbind("naiwnie: widzieli − nie widzieli" = roznica(R$zakup[R$widzial == 1], R$zakup[R$widzial == 0]),
                "naiwnie: widzieli − holdout"      = roznica(R$zakup[R$widzial == 1], H$zakup),
                "ITT: grupa reklamowa − holdout"   = itt,
                "CACE: ITT / odsetek widzących"    = c(cace, cace - 1.96 * se_cace, cace + 1.96 * se_cace,
                                                       2 * pnorm(-abs(cace / se_cace))))
round(cbind(efekty[, 1:3], p = round(efekty[, 4], 4)), 3)
c(odsetek_widzacych = round(100 * c_widz, 2), dodatkowi_kupujacy = round(itt[["pp"]] / 100 * nrow(R)),
  wzgledny_przyrost_proc = round(100 * itt[["pp"]] / odsetki[1, 1], 1))
round(prawda[c("ITT_pp", "CACE_pp")], 3)

# Rysunek 2A: odsetek kupujących w grupach z 95% przedziałem Wilsona
d1 <- data.frame(grupa = factor(rownames(odsetki), levels = rev(rownames(odsetki))), odsetki,
                 rodzaj = c("porównanie losowe", "porównanie losowe", "podgrupa (nielosowa)", "podgrupa (nielosowa)"))
pA <- ggplot(d1, aes(zakup_proc, grupa, colour = rodzaj, shape = rodzaj)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y") +
  geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.2f%%", zakup_proc)), vjust = -1.1, size = 3.5, show.legend = FALSE) +
  scale_colour_manual(values = c("porównanie losowe" = kol[["niebieski"]], "podgrupa (nielosowa)" = kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c("porównanie losowe" = 16, "podgrupa (nielosowa)" = 17), name = NULL) +
  scale_x_continuous(limits = c(0, 7)) +
  labs(x = "Kupiło w 4 tygodnie (%), 95% CI", y = NULL, title = "A. Kto kupował") + motyw
# Rysunek 2B: oszacowania efektu reklamy (pp) i prawda z symulacji
d2 <- data.frame(analiza = factor(rownames(efekty), levels = rev(rownames(efekty))), efekty[, 1:3],
                 prawda = c(NA, prawda[["CACE_pp"]], prawda[["ITT_pp"]], prawda[["CACE_pp"]]),
                 rodzaj = c("podgrupa (nielosowa)", "podgrupa (nielosowa)", "porównanie losowe", "porównanie losowe"))
pB <- ggplot(d2, aes(pp, analiza, colour = rodzaj, shape = rodzaj)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y") +
  geom_point(size = 3) +
  geom_point(aes(x = prawda), shape = 5, size = 3.4, colour = "grey15", na.rm = TRUE) +
  geom_text(aes(label = sprintf("%+.2f pp", pp)), vjust = -1.1, size = 3.5, show.legend = FALSE) +
  scale_colour_manual(values = c("porównanie losowe" = kol[["niebieski"]], "podgrupa (nielosowa)" = kol[["cynober"]]), guide = "none") +
  scale_shape_manual(values = c("porównanie losowe" = 16, "podgrupa (nielosowa)" = 17), guide = "none") +
  scale_x_continuous(limits = c(-0.2, 4.4), breaks = 0:4) +
  annotate("text", x = 4.4, y = 4.5, hjust = 1, size = 3.3, label = "◇ prawda z symulacji") +
  labs(x = "Efekt reklamy (pp), 95% CI", y = NULL, title = "B. Ile zakupów dała reklama") + motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.15)) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("holdout-przyrost-itt-cace.svg", p2, width = 10, height = 5)
Wynik w R
                       zakup_proc dolna gorna
holdout (bez reklamy)        4.49  4.24  4.75
grupa reklamowa – cała       4.86  4.77  4.95
– w tym widzieli             6.30  6.17  6.43
– w tym nie widzieli         2.68  2.57  2.79
                                    pp dolna gorna     p
naiwnie: widzieli − nie widzieli 3.622 3.455 3.789 0.000
naiwnie: widzieli − holdout      1.811 1.524 2.099 0.000
ITT: grupa reklamowa − holdout   0.372 0.101 0.644 0.009
CACE: ITT / odsetek widzących    0.618 0.167 1.069 0.007
     odsetek_widzacych     dodatkowi_kupujacy wzgledny_przyrost_proc
                 60.27                 838.00                   8.30
 ITT_pp CACE_pp
  0.391   0.649
3. iCPA a CPA z panelu: Rysunek 3
R
# Rysunek 3. Koszt dodatkowego zakupu (iCPA) z eksperymentu a CPA z panelu reklamowego
# Korzysta z obiektów przepisów 1–2: sklep, koszt, marza, przed, itt, R, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

prog <- unname(quantile(przed[przed > 0], 0.999))       # próg winsoryzacji: 99.9. centyl sprzed testu
zysk_na_kupujacego <- marza * mean(pmin(sklep$przychod[sklep$zakup == 1], prog))   # zysk brutto z jednego kupującego
dodatkowi <- itt[c("pp", "dolna", "gorna")] / 100 * nrow(R)  # dodatkowi kupujący w grupie reklamowej z 95% CI
wynik <- c(koszt_zl = koszt, przypisane_panel = sum(sklep$panel), CPA_panel = koszt / sum(sklep$panel),
           dodatkowi = dodatkowi[["pp"]], dodatkowi_dolna = dodatkowi[["dolna"]], dodatkowi_gorna = dodatkowi[["gorna"]],
           iCPA = koszt / dodatkowi[["pp"]], iCPA_dolna = koszt / dodatkowi[["gorna"]], iCPA_gorna = koszt / dodatkowi[["dolna"]],
           prog_oplacalnosci = zysk_na_kupujacego, panel_zawyza_razy = sum(sklep$panel) / dodatkowi[["pp"]])
round(wynik, 1)
# Zysk brutto z dodatkowych kupujących minus koszt kampanii (zł) z 95% CI
round(zysk_na_kupujacego * dodatkowi - koszt)

# Rysunek 3A: zakupy przypisane reklamie w panelu a zakupy dodatkowe z eksperymentu
d1 <- data.frame(zrodlo = factor(c("panel reklamowy:\nzakupy po wyświetleniu", "eksperyment:\nzakupy dodatkowe (ITT)"),
                                 levels = c("eksperyment:\nzakupy dodatkowe (ITT)", "panel reklamowy:\nzakupy po wyświetleniu")),
                 liczba = c(sum(sklep$panel), dodatkowi[["pp"]]), dolna = c(NA, dodatkowi[["dolna"]]), gorna = c(NA, dodatkowi[["gorna"]]))
pA <- ggplot(d1, aes(liczba, zrodlo, fill = zrodlo)) +
  geom_col(width = 0.55) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", na.rm = TRUE) +
  geom_text(aes(x = pmax(liczba, gorna, na.rm = TRUE), label = format(round(liczba), big.mark = " ")), hjust = -0.3, size = 3.6) +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["szary"]]), guide = "none") +
  scale_x_continuous(limits = c(0, 7600), breaks = seq(0, 7000, 1750)) +
  labs(x = "Liczba zakupów przypisanych reklamie", y = NULL, title = "A. Ile zakupów „dała” reklama") + motyw
# Rysunek 3B: koszt jednego zakupu przypisanego (CPA) i dodatkowego (iCPA) wobec progu opłacalności
d2 <- data.frame(miara = factor(c("CPA z panelu", "iCPA z eksperymentu"), levels = c("iCPA z eksperymentu", "CPA z panelu")),
                 zl = c(wynik[["CPA_panel"]], wynik[["iCPA"]]), dolna = c(NA, wynik[["iCPA_dolna"]]), gorna = c(NA, wynik[["iCPA_gorna"]]))
pB <- ggplot(d2, aes(zl, miara, colour = miara, shape = miara)) +
  geom_vline(xintercept = zysk_na_kupujacego, colour = kol[["cynober"]], linetype = "22", linewidth = 0.8) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", na.rm = TRUE) +
  geom_point(size = 3.2) +
  geom_text(aes(label = sprintf("%.1f zł", zl)), vjust = -1.2, size = 3.6, show.legend = FALSE) +
  annotate("text", x = zysk_na_kupujacego - 4, y = 2.45, hjust = 1, size = 3.4, colour = kol[["cynober"]],
           label = sprintf("próg opłacalności\n%.0f zł zysku brutto", zysk_na_kupujacego)) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["szary"]]), guide = "none") +
  scale_shape_manual(values = c(16, 15), guide = "none") +
  scale_x_continuous(limits = c(0, 200)) +
  labs(x = "Koszt reklamy na jeden zakup (zł), 95% CI", y = NULL, title = "B. Koszt jednego zakupu") + motyw
p3 <- pA + pB + plot_layout(widths = c(1, 1))
p3   # zapis: ggsave("holdout-icpa-a-cpa-z-panelu.svg", p3, width = 10, height = 4.6)
Wynik w R
         koszt_zl  przypisane_panel         CPA_panel         dodatkowi
          40672.0            6391.0               6.4             838.0
  dodatkowi_dolna   dodatkowi_gorna              iCPA        iCPA_dolna
            226.9            1449.1              48.5              28.1
       iCPA_gorna prog_oplacalnosci panel_zawyza_razy
            179.2             136.0               7.6
    pp  dolna  gorna
 73268  -9819 156354
4. Przychód, wartości skrajne i winsoryzacja: Rysunek 4
R
# Rysunek 4. Przychód na klienta: trzy zamówienia firmowe i winsoryzacja z progiem ustalonym przed testem
# Korzysta z obiektów przepisów 1 i 3: sklep, prawda, prog, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

welch <- function(y, g) { t <- t.test(y[g == "reklama"], y[g == "holdout"])
  c(roznica = unname(diff(rev(t$estimate))), dolna = t$conf.int[1], gorna = t$conf.int[2], p = t$p.value) }
duze <- sklep$przychod > 10000                                       # trzy zamówienia firmowe (powyżej 10 000 zł)
warianty <- rbind("wszystkie zakupy"                     = welch(sklep$przychod, sklep$grupa),
                  "winsoryzacja na progu sprzed testu"   = welch(pmin(sklep$przychod, prog), sklep$grupa),
                  "bez 3 zamówień firmowych"             = welch(sklep$przychod[!duze], sklep$grupa[!duze]))
c(prog_zl = round(prog, 1), zamowien_ponad_prog = sum(sklep$przychod > prog))
table(grupa = sklep$grupa[duze], wartosc = sklep$przychod[duze])
round(sapply(split(sklep$przychod, sklep$grupa), function(x) c(srednia = mean(x), sd = sd(x),
      srednia_winsor = mean(pmin(x, prog)))), 2)
data.frame(round(warianty[, 1:3], 2), p = round(warianty[, 4], 3))
c(prawdziwe_ITT_zl = round(prawda[["ITT_przychod_zl"]], 2))

# Rysunek 4A: wartość zakupów kupujących (skala logarytmiczna), z progiem winsoryzacji
kup <- sklep[sklep$zakup == 1, ]
pA <- ggplot(kup, aes(przychod)) +
  geom_histogram(breaks = 10^seq(1, 4.75, by = 0.05), fill = kol[["szary"]], colour = "white", linewidth = 0.15) +
  geom_vline(xintercept = prog, colour = kol[["cynober"]], linetype = "22", linewidth = 0.8) +
  geom_point(data = kup[kup$przychod > 10000, ], aes(przychod, 12, shape = grupa, colour = grupa), size = 3.2) +
  annotate("text", x = prog / 1.15, y = 1100, hjust = 1, size = 3.4, colour = kol[["cynober"]],
           label = sprintf("próg z okresu\nprzed testem: %.0f zł", prog)) +
  annotate("text", x = 22000, y = 150, size = 3.4, label = "3 zamówienia\nfirmowe") +
  scale_x_log10(breaks = c(10, 100, 1000, 10000), labels = c("10", "100", "1 000", "10 000")) +
  scale_colour_manual(values = c(holdout = kol[["cynober"]], reklama = kol[["niebieski"]]), name = "grupa") +
  scale_shape_manual(values = c(holdout = 17, reklama = 16), name = "grupa") +
  labs(x = "Zakupy kupującego w 4 tygodnie (zł, skala log)", y = "Liczba kupujących",
       title = "A. Wartość zakupów") + motyw
# Rysunek 4B: różnica przychodu na klienta (grupa reklamowa − holdout) z 95% CI
d <- data.frame(wariant = factor(rownames(warianty), levels = rev(rownames(warianty))), warianty)
pB <- ggplot(d, aes(roznica, wariant)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_vline(xintercept = prawda[["ITT_przychod_zl"]], colour = "grey15", linetype = "22") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 3, colour = kol[["niebieski"]]) +
  geom_text(aes(x = gorna, label = sprintf("%+.2f zł", roznica)), hjust = -0.15, size = 3.6) +
  annotate("text", x = prawda[["ITT_przychod_zl"]] + 0.15, y = 3.45, hjust = 0, size = 3.3, label = "prawda\nz symulacji", lineheight = 0.9) +
  scale_x_continuous(limits = c(-3.6, 5.2)) +
  labs(x = "Różnica przychodu na klienta (zł), 95% CI", y = NULL, title = "B. Ile przychodu dała reklama") + motyw
p4 <- pA + pB + plot_layout(widths = c(1, 1.1))
p4   # zapis: ggsave("holdout-przychod-wartosci-skrajne.svg", p4, width = 10, height = 4.8)
Wynik w R
            prog_zl zamowien_ponad_prog
             2826.9                10.0
         wartosc
grupa     22800 27300 41500
  holdout     0     0     1
  reklama     1     1     0
               holdout reklama
srednia          14.94   14.93
sd              274.36  116.74
srednia_winsor   13.39   14.70
                                   roznica dolna gorna     p
wszystkie zakupy                     -0.01 -3.44  3.43 0.996
winsoryzacja na progu sprzed testu    1.32  0.24  2.40 0.017
bez 3 zamówień firmowych              1.43  0.37  2.49 0.008
prawdziwe_ITT_zl
             1.2
5. Wielkość holdoutu – symulacja mocy i kosztu: Rysunek 5
R
# Rysunek 5. Jak duży holdout? Moc i szerokość przedziału a koszt utraconej sprzedaży (1000 symulacji na wariant)
# Korzysta z obiektów przepisów 1–3: N, p0, p1, osiagalny, koszt, R, zysk_na_kupujacego, kol, motyw. Losuje – własne ziarno.
library(ggplot2)
library(patchwork)

pH <- mean(p0)                                    # prawdziwy odsetek kupujących bez reklamy
pR <- mean(p0 + osiagalny * (p1 - p0))            # prawdziwy odsetek w grupie reklamowej
koszt_na_osobe <- koszt / nrow(R)                 # koszt reklamy na klienta grupy reklamowej (zł)
itt_oplacalny <- koszt_na_osobe / zysk_na_kupujacego   # ITT, przy którym kampania wychodzi na zero
round(c(pH_proc = 100 * pH, pR_proc = 100 * pR, ITT_pp = 100 * (pR - pH), ITT_oplacalny_pp = 100 * itt_oplacalny), 3)

set.seed(666)
udzialy <- c(0.01, 0.02, 0.05, 0.10, 0.20, 0.30, 0.50)
sym <- do.call(rbind, lapply(udzialy, function(h) {
  nH <- round(N * h); nR <- N - nH
  xH <- rbinom(1000, nH, pH); xR <- rbinom(1000, nR, pR)        # 1000 kampanii z holdoutem h
  d <- xR / nR - xH / nH
  se <- sqrt((xR / nR) * (1 - xR / nR) / nR + (xH / nH) * (1 - xH / nH) / nH)
  data.frame(holdout_proc = 100 * h, moc = mean(abs(d / se) > qnorm(0.975)),
             oplacalnosc_potwierdzona = mean(d - qnorm(0.975) * se > itt_oplacalny),
             polowa_CI_pp = 100 * mean(qnorm(0.975) * se),
             koszt_holdoutu_zl = nH * ((pR - pH) * zysk_na_kupujacego - koszt_na_osobe))   # utracony zysk netto
}))
sym$blad_mc_moc <- sqrt(sym$moc * (1 - sym$moc) / 1000)
transform(sym, moc = round(100 * moc, 1), oplacalnosc_potwierdzona = round(100 * oplacalnosc_potwierdzona, 1),
          polowa_CI_pp = round(polowa_CI_pp, 3), koszt_holdoutu_zl = round(koszt_holdoutu_zl), blad_mc_moc = round(100 * blad_mc_moc, 1))

# Rysunek 5A: odsetek kampanii, w których test wykrył efekt i potwierdził opłacalność
d1 <- rbind(data.frame(h = sym$holdout_proc, odsetek = sym$moc, co = "efekt różny od zera (p < .05)"),
            data.frame(h = sym$holdout_proc, odsetek = sym$oplacalnosc_potwierdzona, co = "dolna granica CI powyżej progu opłacalności"))
d1$se <- sqrt(d1$odsetek * (1 - d1$odsetek) / 1000)
pA <- ggplot(d1, aes(h, 100 * odsetek, colour = co, shape = co)) +
  geom_vline(xintercept = 10, colour = "grey60", linetype = "22") +
  geom_errorbar(aes(ymin = 100 * (odsetek - 1.96 * se), ymax = 100 * (odsetek + 1.96 * se)), width = 0.04) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  scale_x_log10(breaks = udzialy * 100, labels = paste0(udzialy * 100, "%")) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomarancz"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "Wielkość holdoutu (% klientów, skala log)", y = "Odsetek z 1000 kampanii (%)", title = "A. Co da się wykazać") + motyw
# Rysunek 5B: kompromis – połowa szerokości 95% CI dla ITT a utracony zysk w holdoucie
pB <- ggplot(sym, aes(koszt_holdoutu_zl / 1000, polowa_CI_pp)) +
  geom_line(colour = kol[["szary"]], linewidth = 0.8) +
  geom_point(size = 2.8, colour = kol[["niebieski"]]) +
  geom_point(data = sym[sym$holdout_proc == 10, ], size = 4.5, shape = 21, colour = kol[["cynober"]], stroke = 1.3) +
  geom_text(aes(label = paste0(holdout_proc, "%")), nudge_x = 1.6, nudge_y = 0.03, size = 3.5) +
  labs(x = "Utracony zysk netto w holdoucie (tys. zł)", y = "Połowa szerokości 95% CI (pp)",
       title = "B. Precyzja kosztuje") + motyw
p5 <- pA + pB + plot_layout(widths = c(1.1, 1))
p5   # zapis: ggsave("holdout-wielkosc-moc-a-koszt.svg", p5, width = 10, height = 5)
Wynik w R
         pH_proc          pR_proc           ITT_pp ITT_oplacalny_pp
           4.446            4.836            0.391            0.133
  holdout_proc  moc oplacalnosc_potwierdzona polowa_CI_pp koszt_holdoutu_zl
1            1 18.8                     10.9        0.811               877
2            2 26.0                     14.3        0.577              1753
3            5 54.7                     29.6        0.371              4383
4           10 80.5                     44.4        0.270              8766
5           20 96.0                     70.9        0.204             17532
6           30 98.4                     82.0        0.178             26297
7           50 99.6                     87.1        0.165             43829
  blad_mc_moc
1         1.2
2         1.4
3         1.6
4         1.3
5         0.6
6         0.4
7         0.2
6. Grafika: schemat badania – Rysunek 1
R
# Rysunek 1. Grafika: losowanie → kto zobaczył reklamę → które porównanie jest uczciwe
# Korzysta z obiektów przepisów 1–2: sklep, odsetki, efekty, c_widz. Niczego nie losuje.
library(ggplot2)

R <- sklep[sklep$grupa == "reklama", ]; H <- sklep[sklep$grupa == "holdout", ]
tys <- function(x) format(x, big.mark = " ")
proc <- function(x) sprintf("%.2f%%", x)
pola <- data.frame(
  x = c(5, 2.75, 7.6, 1.6, 3.95, 7.6), y = c(9.1, 6.75, 6.75, 4.35, 4.35, 4.35),
  w = c(4.6, 4.3, 3.9, 2.15, 2.15, 3.3), h = c(1.0, 1.25, 1.25, 1.45, 1.45, 1.45),
  tlo = c("#EFEFEF", "#DCEEF8", "#FBE3D3", "#DCEEF8", "#DCEEF8", "white"),
  linia = c("solid", "solid", "solid", "solid", "solid", "22"),
  tekst = c(sprintf("%s klientów z listy kampanii\n(konta w sklepie, 4 tygodnie)", tys(nrow(sklep))),
            sprintf("Grupa reklamowa: %s (90%%)\nkupiło %s", tys(nrow(R)), proc(odsetki[2, 1])),
            sprintf("Holdout: %s (10%%)\nreklama wyłączona · kupiło %s", tys(nrow(H)), proc(odsetki[1, 1])),
            sprintf("widzieli reklamę\n%s (%.1f%%)\nkupiło %s", tys(sum(R$widzial)), 100 * c_widz, proc(odsetki[3, 1])),
            sprintf("nie widzieli\n%s (%.1f%%)\nkupiło %s", tys(sum(R$widzial == 0)), 100 * (1 - c_widz), proc(odsetki[4, 1])),
            "zobaczyliby reklamę?\nnie wiemy – ale losowanie\nzapewnia ten sam podział"))
porownania <- data.frame(
  y = c(1.95, 1.2, 0.45), kolor = c("#0072B2", "#0072B2", "#D55E00"),
  tekst = c(sprintf("ITT = cała grupa reklamowa − cały holdout = %+.2f pp   (uczciwe: grupy z losowania)", efekty[3, 1]),
            sprintf("CACE = ITT / %.1f%% widzących = %+.2f pp   (efekt u tych, którzy widzieli)", 100 * c_widz, efekty[4, 1]),
            sprintf("Błąd: widzieli − nie widzieli = %+.2f pp   (to inni klienci, nie tylko reklama)", efekty[1, 1])))
strzalka <- arrow(length = unit(0.2, "cm"), type = "closed")
p1 <- ggplot() +
  geom_tile(data = pola, aes(x, y, width = w, height = h, fill = tlo, linetype = linia), colour = "grey40", linewidth = 0.4) +
  geom_text(data = pola, aes(x, y, label = tekst), size = 3.45, lineheight = 0.95, colour = "grey10") +
  annotate("segment", x = c(4.2, 5.8), xend = c(3.1, 7.2), y = 8.55, yend = 7.42, arrow = strzalka, colour = "grey35") +
  annotate("label", x = 5, y = 7.95, label = "losowanie", size = 3.5, fontface = "bold", linewidth = 0, fill = "white", colour = "#0f1d3a") +
  annotate("segment", x = c(2.4, 3.1), xend = c(1.75, 3.8), y = 6.1, yend = 5.12, arrow = strzalka, colour = "grey35") +
  annotate("segment", x = 7.6, xend = 7.6, y = 6.1, yend = 5.12, arrow = strzalka, colour = "grey35", linetype = "22") +
  annotate("text", x = 2.75, y = 5.62, label = "platforma\nnie dotarła do wszystkich", size = 3.1, colour = "grey30", lineheight = 0.9, hjust = 0.5, vjust = 0.5) +
  annotate("text", x = 0.2, y = 2.75, label = "Porównanie:", hjust = 0, fontface = "bold", size = 3.8, colour = "#0f1d3a") +
  geom_point(data = porownania, aes(0.35, y), shape = c(16, 16, 4), size = 3, colour = porownania$kolor, stroke = 1.4) +
  geom_text(data = porownania, aes(0.6, y, label = tekst), hjust = 0, size = 3.45, colour = porownania$kolor) +
  scale_fill_identity() + scale_linetype_identity() +
  coord_cartesian(xlim = c(0.1, 9.9), ylim = c(0.1, 9.75), expand = FALSE) +
  labs(title = "Test wyłączenia reklamy: losowanie, kontakt z reklamą, porównanie") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 12, 8, 10))
p1   # zapis: ggsave("holdout-schemat-losowanie-kontakt-porownanie.svg", p1, width = 10, height = 6.4)
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (porównanie losowe / podgrupa)" = c("#0072B2", "#D55E00"),
             "niebieski – szary (eksperyment / panel)" = c("#0072B2", "#8C8C8C"),
             "niebieski – pomarańczowy (moc / opłacalność)" = c("#0072B2", "#E69F00"),
             "cynober – szary (próg / histogram)" = c("#D55E00", "#8C8C8C"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                   widzenie_typowe deuteranopia
niebieski – cynober (porównanie losowe / podgrupa)           114.6        108.3
niebieski – szary (eksperyment / panel)                       43.2         47.1
niebieski – pomarańczowy (moc / opłacalność)                 120.2        121.5
cynober – szary (próg / histogram)                            76.8         62.6
czerwony – zielony (do unikania)                             121.7         21.1
                                                   protanopia
niebieski – cynober (porównanie losowe / podgrupa)       91.9
niebieski – szary (eksperyment / panel)                  39.2
niebieski – pomarańczowy (moc / opłacalność)            109.3
cynober – szary (próg / histogram)                       54.8
czerwony – zielony (do unikania)                         31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test różnicy odsetków, przedziały Wilsona i testy t Welcha – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Porównanie widzących z niewidzącymi. Daje +3.62 pp zamiast +0.37 pp, bo reklama trafia do aktywnych klientów. Porównuj grupy z losowania.
- Holdout wybrany ręcznie (np. klienci z jednego miasta albo najmniej aktywni) – to już nie eksperyment. Losuj z całej listy i sprawdź, czy liczebności zgadzają się z planem 90/10.
- Reklama „przecieka” do holdoutu, gdy klient loguje się na innym urządzeniu albo platforma nie zna jego konta. Wtedy ITT jest zaniżony.
- Usuwanie dużych zamówień po wynikach. Próg winsoryzacji ustal przed testem, wspólny dla obu grup.
- „Brak istotności = reklama nie działa”. Przy holdoucie 1% efekt z tego przykładu wykrywa tylko co piąty test. Podawaj przedział, nie samo p.
Najczęstsze pytania
Co to jest test holdout w reklamie?
To eksperyment, w którym przed kampanią losowo wyłącza się reklamę części odbiorców (np. 10%) i porównuje sprzedaż w obu grupach. Różnica to przyrost (inkrementalność): sprzedaż, której bez reklamy by nie było. W przykładzie reklama zwiększyła odsetek kupujących o 0.37 pp, 95% CI [0.10, 0.64].
Czym iCPA różni się od CPA z panelu reklamowego?
CPA dzieli koszt przez zakupy przypisane reklamie, np. zakupy osób, które ją widziały. iCPA dzieli koszt tylko przez zakupy dodatkowe z eksperymentu. W przykładzie CPA wynosiło 6.4 zł, a iCPA 48.5 zł, 95% CI [28.1, 179.2], bo reklama trafiała do klientów, którzy i tak częściej kupują (Blake i in., 2015).
Jak duża powinna być grupa holdout?
Tak duża, by przedział dla przyrostu pozwolił podjąć decyzję – zwykle przy najmniejszym opłacalnym efekcie. W symulacji 250 000 klientów holdout 10% wykrywał efekt w 80.5% kampanii, a opłacalność potwierdzał w 44.4%; holdout 30% – w 98.4% i 82.0%, kosztem 26 297 zł utraconego zysku. Pomóc może też dłuższy test.
Co zrobić, gdy nie wszyscy w grupie reklamowej zobaczyli reklamę?
Analizę główną zrób dla całych grup z losowania (ITT). Efekt u osób, które reklamę zobaczyły (CACE), dostaniesz, dzieląc ITT przez odsetek widzących; to estymator zmiennej instrumentalnej (Angrist i in., 1996). W przykładzie 0.37 pp / 0.603 = 0.62 pp. Nie porównuj widzących z niewidzącymi – to daje +3.62 pp.
Jak traktować bardzo duże zamówienia w teście reklamy?
Ustal przed testem próg winsoryzacji, np. 99.9. centyl wartości zakupów z okresu przed testem, wspólny dla obu grup. W przykładzie jedno zamówienie firmowe za 41 500 zł w holdoucie sprowadziło przyrost przychodu do −0.01 zł na klienta; po winsoryzacji wyniósł +1.32 zł, 95% CI [0.24, 2.40]. Próg dobrany po wynikach zawyża ryzyko fałszywych alarmów (André, 2022).
Powiązane hasła
Przeczytaj też
Brand lift – efekt kampanii reklamowej
Grupa kontrolna z losowania, różnica odsetków z przedziałem Newcombe’a, liczebność próby i braki odpowiedzi na przykładzie biura podróży – z kodem R.
Czytaj →PoradnikGeo-eksperyment – plan testu w regionach
40 regionów, pary z historii sprzedaży, losowanie w parach, analiza z poziomem sprzed testu i krzywe mocy – sześć rysunków z kodem R.
Czytaj →PoradnikCzęstotliwość kontaktu z reklamą
Serwis VOD: krzywa odpowiedzi z GAM, nasycenie i zmęczenie reklamą, pułapka aktywnych użytkowników, losowy limit wyświetleń i zysk – z kodem R.
Czytaj →PoradnikProgram poleceń i współczynnik wiralowy
Aplikacja z zakupami i 18 miesięcy poleceń: K z przedziałem, rozkład ujemny dwumianowy, kaskady, K bliskie 1 i wartość poleconych – z kodem R.
Czytaj →PoradnikOdzyskiwanie klientów (win-back)
Serwis treningowy: eksperyment 3 grup, przyrost powrotów, Kaplan–Meier i Cox, pułapka selekcji wśród powracających i wartość na osobę – kod R.
Czytaj →Oceniasz skuteczność reklamy w pracy z marketingu?
Pomożemy zaplanować test z grupą wyłączoną z reklamy, dobrać jej wielkość, policzyć przyrost sprzedaży z przedziałem i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- André, Q. (2022). Outlier exclusion procedures must be blind to the researcher’s hypothesis. Journal of Experimental Psychology: General, 151(1), 213–223. https://doi.org/10.1037/xge0001069 ● Otwarty dostęp: pełny tekst
- Angrist, J. D., Imbens, G. W., & Rubin, D. B. (1996). Identification of causal effects using instrumental variables. Journal of the American Statistical Association, 91(434), 444–455. https://doi.org/10.1080/01621459.1996.10476902
- Blake, T., Nosko, C., & Tadelis, S. (2015). Consumer heterogeneity and paid search effectiveness: A large-scale field experiment. Econometrica, 83(1), 155–174. https://doi.org/10.3982/ecta12423 ● Otwarty dostęp: pełny tekst
- Gordon, B. R., Zettelmeyer, F., Bhargava, N., & Chapsky, D. (2019). A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook. Marketing Science, 38(2), 193–225. https://doi.org/10.1287/mksc.2018.1135
- Johnson, G. A., Lewis, R. A., & Nubbemeyer, E. I. (2017). Ghost ads: Improving the economics of measuring online ad effectiveness. Journal of Marketing Research, 54(6), 867–884. https://doi.org/10.1509/jmr.15.0297 ● Otwarty dostęp: pełny tekst
- Lewis, R. A., & Rao, J. M. (2015). The unfavorable economics of measuring the returns to advertising. The Quarterly Journal of Economics, 130(4), 1941–1973. https://doi.org/10.1093/qje/qjv023
Cytowania BibTeX
@article{andre2022outlier, author={André, Quentin}, title={{Outlier exclusion procedures must be blind to the researcher’s hypothesis}}, journal={Journal of Experimental Psychology: General}, year={2022}, volume={151}, number={1}, pages={213--223}, doi={10.1037/xge0001069}}@article{angrist1996identification, author={Angrist, Joshua D. and Imbens, Guido W. and Rubin, Donald B.}, title={{Identification of causal effects using instrumental variables}}, journal={Journal of the American Statistical Association}, year={1996}, volume={91}, number={434}, pages={444--455}, doi={10.1080/01621459.1996.10476902}}@article{blake2015consumer, author={Blake, Thomas and Nosko, Chris and Tadelis, Steven}, title={{Consumer heterogeneity and paid search effectiveness: A large-scale field experiment}}, journal={Econometrica}, year={2015}, volume={83}, number={1}, pages={155--174}, doi={10.3982/ecta12423}}@article{gordon2019comparison, author={Gordon, Brett R. and Zettelmeyer, Florian and Bhargava, Neha and Chapsky, Dan}, title={{A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook}}, journal={Marketing Science}, year={2019}, volume={38}, number={2}, pages={193--225}, doi={10.1287/mksc.2018.1135}}@article{johnson2017ghost, author={Johnson, Garrett A. and Lewis, Randall A. and Nubbemeyer, Elmar I.}, title={{Ghost ads: Improving the economics of measuring online ad effectiveness}}, journal={Journal of Marketing Research}, year={2017}, volume={54}, number={6}, pages={867--884}, doi={10.1509/jmr.15.0297}}@article{lewis2015unfavorable, author={Lewis, Randall A. and Rao, Justin M.}, title={{The unfavorable economics of measuring the returns to advertising}}, journal={The Quarterly Journal of Economics}, year={2015}, volume={130}, number={4}, pages={1941--1973}, doi={10.1093/qje/qjv023}}