Przykład: sieć marketów z farbami i 40 regionów
Fikcyjna sieć marketów z farbami i artykułami do remontu sprzedaje w 40 regionach. Dział marketingu przygotował wiosenną kampanię „Odnów mieszkanie” (lokalne radio, billboardy, gazetki) i może ją puścić tylko w części kraju. Zarząd pyta: o ile procent kampania podnosi sprzedaż i ile regionów oraz tygodni potrzeba, żeby to zobaczyć? Trzeba to zaplanować przed kampanią; po fakcie zostaje analiza bez losowania, jak w poradniku o syntetycznej kontroli.
Mamy tygodniową sprzedaż każdego regionu z 52 tygodni (od marca do lutego). Kampania ma trwać 6 tygodni (tygodnie 53–58, marzec i początek kwietnia). Przeciętny region sprzedaje 119 tys. zł tygodniowo, najmniejszy 52, a region R20 z dużym miastem 668 tys. zł. Sam R20 to 12.0% sprzedaży sieci.
Dane są fikcyjne i znamy prawdę: kampania podnosi sprzedaż o 5%. Ręcznie ustaliliśmy wielkość regionów, ich tempo wzrostu, sezon remontowy ze szczytem w czerwcu oraz wahania wspólne i regionalne (pełna lista przy kodzie). Ziarna 665 nie zmienialiśmy. Dane pobierzesz jako geo-eksperyment-sprzedaz-regionow.csv.
Dlaczego losujemy regiony, a nie klientów
W zwykłym teście A/B losujemy osoby. Reklamy w radiu i na billboardzie nie da się jednak pokazać co drugiemu klientowi: słyszą ją wszyscy w zasięgu nadajnika. Sprzedaż sieci też jest zapisana dla sklepów, a nie dla osób. Jednostką losowania i analizy jest więc region. Taki plan to randomizacja klastrowa, w marketingu nazywana geo-eksperymentem.
Cena jest wysoka: 40 obserwacji zamiast tysięcy klientów, a najmniejszy region sprzedaje 13 razy mniej niż R20. Różnice między klastrami zwiększają niepewność (efekt schematu). Dlatego najwięcej zyskuje się na planie: doborze par i wykorzystaniu historii.
Rysunek 1: plan testu na mapie regionów
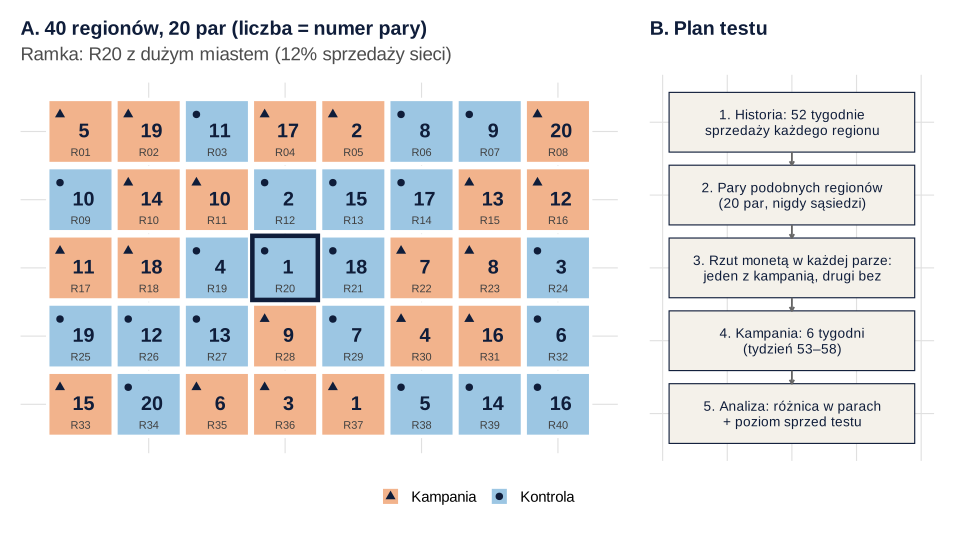
set.seed(665) i set.seed(6650)).Co widać. Każdy prostokąt to region, liczba w nim to numer pary. W każdej parze jeden region dostał kampanię (pomarańczowy, trójkąt), a drugi nie (niebieski, kółko). O tym, który, zdecydował rzut monetą. Żadna para nie składa się z sąsiadów, bo kampania w radiu przechodzi przez granice regionów. Para 1 to R20 i R37, które na mapie są daleko od siebie.
Jak może zmylić. Prostokąty mają równą wielkość, a regiony nie: R20 sprzedaje tyle, co ponad pięć przeciętnych regionów. Mapa nie pokazuje też zasięgu stacji radiowych.
Podpis do pracy:
Rysunek 2: pary z 52 tygodni historii
Pary tworzymy z danych, które już są. Dla każdych dwóch regionów liczymy odległość między ich szeregami (logarytm sprzedaży tydzień po tygodniu przez 52 tygodnie). Zaczynamy od regionu najbardziej odstającego, bo dla niego najtrudniej o partnera, i dajemy mu najbliższy wolny region, który nie jest sąsiadem. Potem następny. To prosta wersja randomizacji blokowej z blokami po dwa.
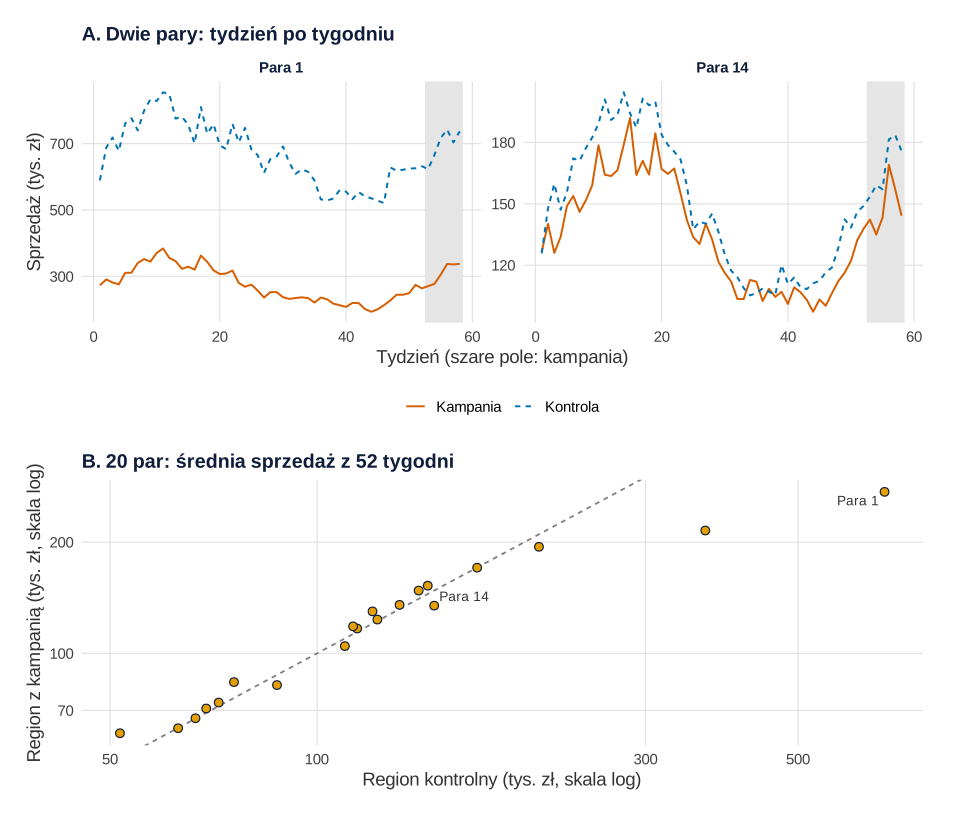
set.seed(665) i set.seed(6650)).Co widać. W typowej parze poziom sprzedaży różni się o 5.1% (mediana), a tygodniowe szeregi są skorelowane na poziomie r = .89 (od .79 do .96). Para 14 to wzór: dwie linie idą razem przez cały rok. Para 1 pokazuje problem dużego regionu. R37 sprzedaje o 59.0% mniej niż R20 (274 wobec 668 tys. zł tygodniowo), choć był najbliższym wolnym regionem spoza sąsiedztwa. Bliższy wielkością R12 graniczy z R20.
Jak może zmylić. Dobra para z historii może się rozjechać w czasie kampanii, np. gdy w jednym regionie otworzy się konkurent. Bruhn i McKenzie (2009) pokazali w symulacjach, że dobór w pary i warstwowanie dają najwięcej przy małych próbach i wynikach silnie powiązanych w czasie. Tu poziom z historii koreluje z poziomem w teście na r = .995.
Podpis do pracy:
Rysunek 3: analiza jednego testu
Wynikiem regionu jest logarytm średniej sprzedaży w 6 tygodniach kampanii, poziomem sprzed testu – logarytm średniej z 52 tygodni. Porównujemy trzy analizy tych samych danych.
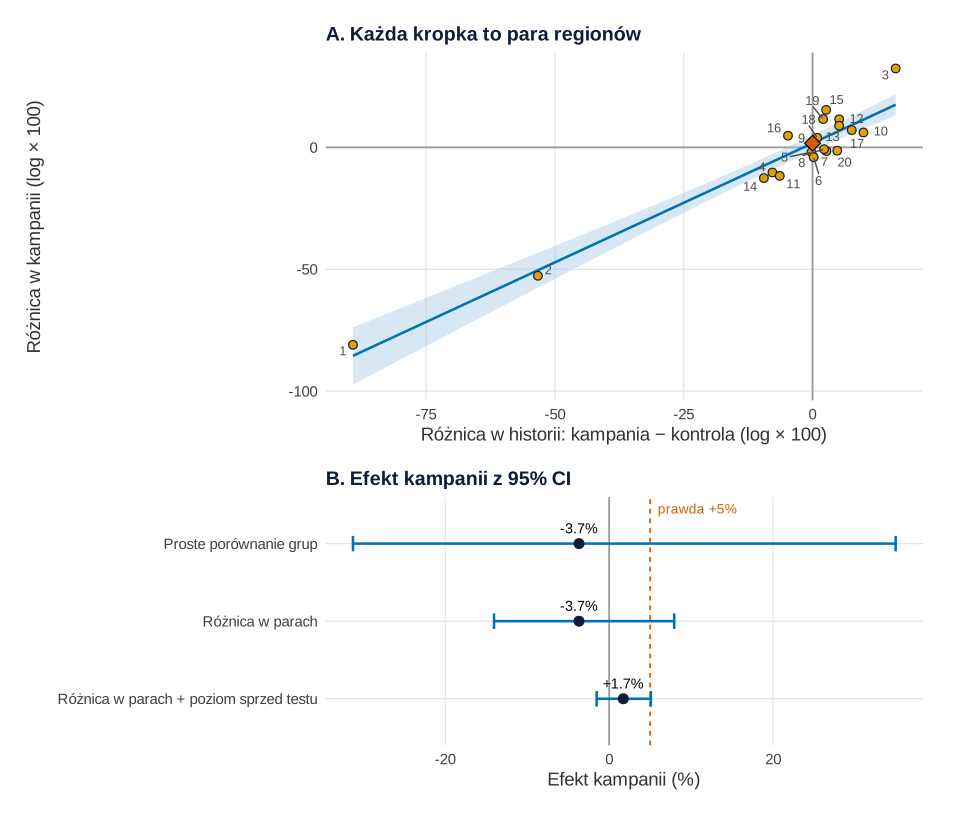
set.seed(665) i set.seed(6650)).Co widać. Proste porównanie grup i różnica w parach dają ten sam wynik, −3.7%. To nie przypadek: w każdej parze jest jeden region z kampanią i jeden bez. Różni je przedział. Bez par 95% przedział ufności to [−31.3, 34.9], a z parami [−14.1, 7.9]. Panel A wyjaśnia, skąd tak duży rozrzut: różnica w kampanii prawie w całości powtarza różnicę z historii (nachylenie 0.98, SE 0.06). Para 1 była o 89 punktów logarytmu „na minusie” już przed testem.
Dlatego trzecia analiza to regresja różnicy w parach w tygodniach kampanii na różnicy w historii. Wyraz wolny, czyli przewidywana różnica dla pary bez różnicy w historii, jest efektem kampanii. To ta sama logika co ANCOVA i CUPED: część rozrzutu, którą przewiduje historia, odejmujemy. Odchylenie standardowe różnic spada z 24.3% do 6.7%. Wynik: +1.7%, 95% CI [−1.5, 5.1]. Przelicza się to na 287 tys. zł dodatkowej sprzedaży w 6 tygodniach, 95% CI [−262, 819].
Jak może zmylić. Prawdziwy efekt to +5%, a wyszło +1.7% z przedziałem obejmującym zero. To jedno losowanie z szumem. Przedział zawiera prawdę, ale nie wyklucza braku efektu. Przy 90% mocy mniej więcej co dziesiąty test nie wykaże efektu (rysunek 5); nie dopisuj wtedy tygodni, aż wyjdzie istotnie. Van Breukelen (2006) pokazał, że w badaniu z losowaniem ANCOVA i analiza zmian są nieobciążone, a ANCOVA ma większą moc.
Podpis do pracy:
Rysunek 4: pary czy proste losowanie – 2000 testów
Jeden test niczego nie rozstrzyga. Symulacja powtarza cały geo-eksperyment 2000 razy na tych samych 40 regionach, z nowymi wahaniami i nowym losowaniem. Porównujemy cztery plany: proste losowanie 20 z 40 regionów albo losowanie w parach, każde z analizą bez poziomu sprzed testu i z nim.
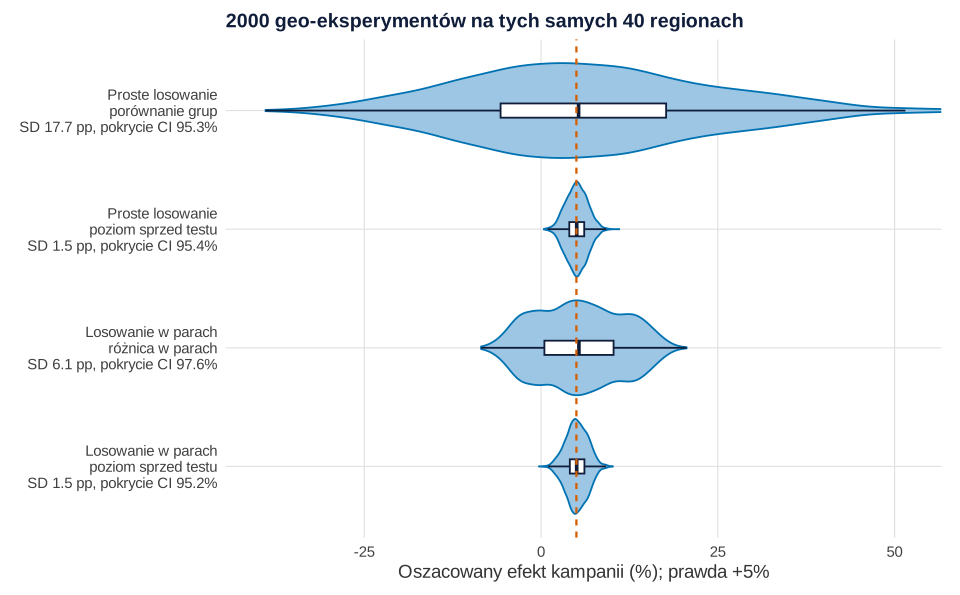
set.seed(6651)).Co widać. Na skali logarytmu obciążenie żadnego planu nie przekracza 0.3 punktu procentowego; plany różnią się precyzją. Proste losowanie z porównaniem grup ma SD 17.7 punktu procentowego, a przedział ±36.5. Wykrywa efekt +5% w 4.4% powtórzeń. Losowanie w parach zawęża rozrzut prawie trzykrotnie (SD 6.1). Dodanie poziomu sprzed testu zawęża go jeszcze cztery razy (SD 1.5, przedział ±3.2, moc 89.8%). Pokrycie przedziałów wynosi od 95.2% do 97.6% (błąd Monte Carlo do 0.5 punktu procentowego).
Jak może zmylić. Z rysunku wynika, że przy dobrej analizie pary nic nie dodają: proste losowanie z poziomem sprzed testu ma tę samą precyzję (SD 1.49 wobec 1.52). Tak jest tu, bo jeden poziom sprzed testu przewiduje prawie wszystko. Pary i tak warto mieć: chronią każde pojedyncze losowanie przed złym podziałem (np. R20 i inne duże regiony po jednej stronie). Imai i in. (2009) piszą, że przy losowaniu klastrów dobór w pary należy stosować wszędzie, gdzie to możliwe. Średnia prostego porównania w procentach (6.65 przy medianie 5.31) jest zawyżona tylko przez przeliczanie logarytmów na procenty.
Podpis do pracy:
Rysunek 5: ile regionów i ile tygodni
Czy wystarczy połowa sieci i czy dłuższa kampania pomoże? Dla 12, 20, 28 i 40 regionów oraz testu od 2 do 12 tygodni powtarzamy plan z parami i poziomem sprzed testu po 500 razy. Moc to odsetek testów, w których dolna granica 95% przedziału jest powyżej zera. Tak wygląda symulacyjna analiza mocy, gdy wzoru na liczebność nie ma.
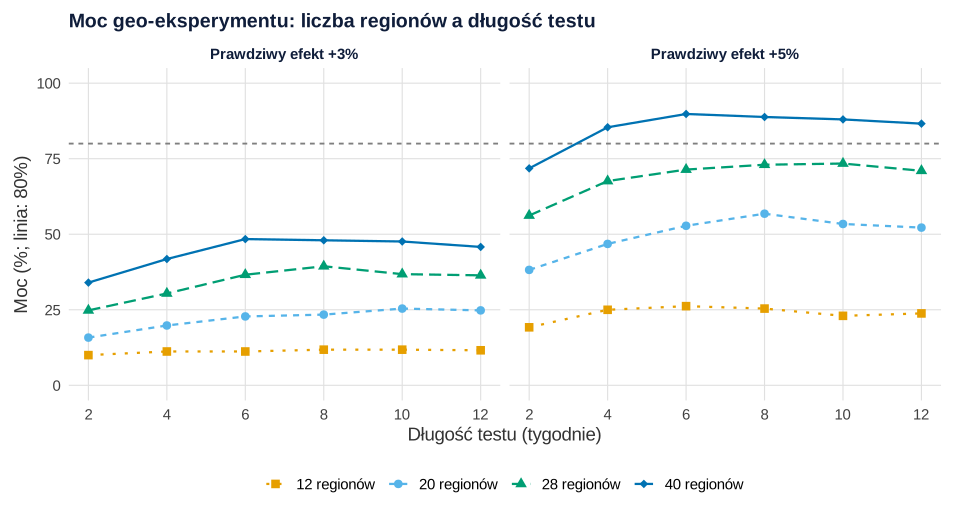
set.seed(6652), 500 powtórzeń w komórce, błąd Monte Carlo do 2.2 punktu procentowego).Co widać. Liczba regionów działa mocniej niż długość testu. Przy efekcie +5% 40 regionów daje 85% mocy po 4 tygodniach i 90% po 6. Połowa sieci (20 regionów) nie przekracza 57% nawet po 12 tygodniach. Krzywe po 6–8 tygodniach są płaskie. Każdy region ma bowiem własny trend i wahania, które trwają tygodniami, a im dalej od historii, tym słabiej historia przewiduje sprzedaż. Efektu +3% ta sieć nie wykryje wiarygodnie: nawet 40 regionów daje najwyżej 48% mocy.
Jak może zmylić. Krzywa obowiązuje dla tych danych; w innej sieci policz ją na własnej historii. Leyrat i in. (2018) pokazali, że przy mniej niż 20 klastrach moc wielu analiz badań klastrowych jest niska, a analizy bez poprawek dla małych prób zawyżają błąd I rodzaju. Analiza na poziomie par, jak tu, jest jedną z bezpiecznych opcji.
Podpis do pracy:
Rysunek 6: sezon i przeciek do sąsiadów
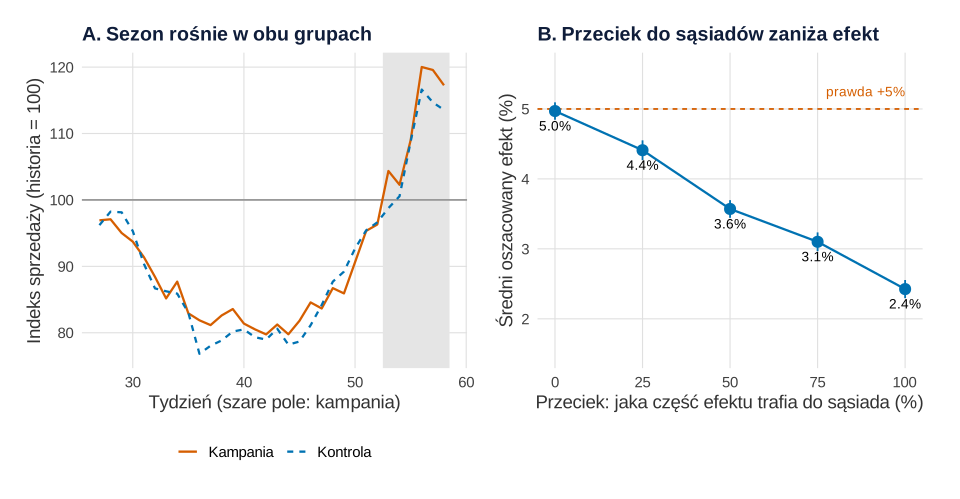
set.seed(665), set.seed(6650) i set.seed(6653), 500 symulacji w każdym punkcie).Co widać. Panel A: kampania wypada w środku wiosennego wzrostu. Regiony z kampanią sprzedają w jej trakcie o 24.9% więcej niż w 6 tygodniach przed nią, ale kontrolne też o 19.6%. Porównanie „przed i po” w samych regionach z kampanią (+11.9% wobec średniej z całego roku, +24.9% wobec ostatnich tygodni) mierzy głównie sezonowość. Regiony kontrolne odpowiadają na pytanie z modelu potencjalnych wyników: ile sprzedałby region bez kampanii w tych samych tygodniach.
Panel B: region kontrolny dostaje część efektu proporcjonalną do odsetka sąsiadów z kampanią (średnio połowy). Przy pełnym przecieku średnie oszacowanie spada z 5.0% do 2.4%. To kontaminacja: grupa kontrolna przestaje być czysta. Torgerson (2001) przypomina, że kontaminacja zaniża efekt i zwiększa ryzyko błędu II rodzaju. Hudgens i Halloran (2008) opisują brak interferencji jako założenie, które w wielu sytuacjach nie jest spełnione. Więcej o tym zjawisku piszemy w poradniku o efekcie sieciowym i testach switchback.
Jak może zmylić. Przeciek w panelu B to założenie symulacji, nie pomiar; w praktyce klienci dojeżdżają też do sklepów dalej niż do sąsiedniego regionu.
Podpis do pracy:
Co z tym zrobić w marketingu
- Zacznij od efektu, który ma sens finansowo. Jeśli kampania zwraca się dopiero przy +5% sprzedaży, plan ma wykryć +5%. Przy 40 regionach i 6 tygodniach moc to 90%. Jeśli zwraca się już przy +3%, ta sieć tego nie rozstrzygnie i lepiej to wiedzieć przed wydaniem budżetu.
- Zapisz pary, ziarno i regułę „bez sąsiadów” przed losowaniem.
- Analizuj z poziomem sprzed testu. Regresja różnicy w parach na różnicy z historii dawała w symulacji przedział średnio ±3.2 zamiast ±12.4 punktu procentowego.
- Zdecyduj z góry, co zrobić z R20. Przy analizie w złotych (iloraz sprzedaży grup) R20 zwiększa rozrzut wyniku prostego losowania z 17.5 do 26.6 punktu procentowego. Licz efekt w procentach na skali logarytmu albo wyłącz R20 z testu i oceń go osobno.
- Granice regionów ustal według zasięgu mediów; gdzie zasięg się nakłada, zostaw region buforowy.
- Przed analizą sprawdź przydział i dane. Czy kampania ruszyła tylko tam, gdzie wylosowano? Kohavi i in. (2020) nazywają to testami wiarygodności eksperymentu.
- Pamiętaj, że 6 tygodni to efekt krótkoterminowy. Wynik geo-eksperymentu przyda się jako punkt kontrolny dla marketing mix modeling. Jak wyłączyć reklamę internetową dla części użytkowników, pokazuje wpis o teście holdout.
Jak opisać w pracy
W Metodzie opisz jednostkę losowania i jej powód, tworzenie par, losowanie, okresy i analizę mocy; w ograniczeniach – przeciek i krótki horyzont. Ogólne wskazówki znajdziesz we wpisie statystyka w pracy z marketingu, a ocenę kampanii ankietą – we wpisie o brand lift.
Metoda:
Wyniki:
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, regiony i generator sprzedaży, przepis 2 – funkcje łączenia w pary i losowania, a przepis 3 – funkcję oszacuj(), z których korzystają symulacje w przepisach 4–6. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1, 2, 4, 5 i 6; każdy zaczyna od własnego ziarna: set.seed(665) w przepisie 1, set.seed(6650) w przepisie 2, set.seed(6651) w przepisie 4, set.seed(6652) w przepisie 5 i set.seed(6653) w przepisie 6. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): 40 regionów na mapie 8 × 5, przeciętną sprzedaż regionu (rozkład logarytmicznie normalny z medianą 110 tys. zł i SD logarytmu 0.4; R20 = 650 tys. zł), roczne tempo wzrostu (średnio 3%, SD 4%), siłę sezonu (0.20, SD 0.05), wspólne wahania tygodniowe (AR(1), φ = 0.6, SD 0.03), własne wahania regionu (AR(1), φ = 0.5, SD 0.05), 52 tygodnie historii, 6 tygodni kampanii i efekt +5%; ponadto 2000 powtórzeń (przepis 4), 500 powtórzeń w komórce (przepis 5) i siłę przecieku 0–100% (przepis 6). Po pierwszym uruchomieniu zmieniliśmy kolejność łączenia w pary: wersja „najpierw najbliższa para” zostawiała na koniec R20 i jeden z najmniejszych regionów (różnica 92%), więc parowanie zaczyna się teraz od regionu najbardziej odstającego. Parametrów danych nie zmienialiśmy. Cały kod liczy się w mniej niż minutę.
1. Dane: 40 regionów i generator sprzedaży tygodniowej
R
# Przepis 1. Fikcyjna sieć marketów z farbami i artykułami do remontu: 40 regionów, 52 tygodnie historii
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("Kampania" = "#D55E00", "Kontrola" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Regiony na schematycznej mapie 8 × 5 (kolumna, wiersz); sąsiedzi = wspólny bok prostokąta
R <- 40
reg <- data.frame(region = sprintf("R%02d", 1:R), kol = (0:(R - 1)) %% 8 + 1, wiersz = (0:(R - 1)) %/% 8 + 1)
sasiad <- outer(1:R, 1:R, function(i, j) abs(reg$kol[i] - reg$kol[j]) + abs(reg$wiersz[i] - reg$wiersz[j]) == 1)

# Parametry ustalone ręcznie: tydzień 1 = pierwszy tydzień marca poprzedniego roku, kampania w tygodniach
# 53–58 (marzec–połowa kwietnia), sezon remontowy ze szczytem w czerwcu, wspólne wahania tygodniowe
# (pogoda, święta; AR(1), φ = 0.6), własne wahania regionu (AR(1), φ = 0.5), prawdziwy efekt +5%.
HIST <- 1:52; TEST <- 53:58; tau <- 0.05

set.seed(665)                                      # ziarno ustalone raz, bez dobierania pod wynik
reg$baza <- round(rlnorm(R, log(110), 0.4))        # przeciętna sprzedaż tygodniowa regionu (tys. zł)
reg$baza[20] <- 650                                # region R20 z dużym miastem (ustalony ręcznie)
reg$wzrost <- rnorm(R, 0.03, 0.04)                 # roczne tempo wzrostu (skala logarytmu)
reg$sezon <- rnorm(R, 0.20, 0.05)                  # siła sezonu remontowego

# Generator sprzedaży: macierz region × tydzień (tys. zł), bez kampanii
sprzedaz <- function(W = 64, sd_reg = 0.05) {
  t <- 1:W
  wspolne <- as.numeric(arima.sim(list(ar = 0.6), W, sd = 0.03))
  wlasne <- t(stats::filter(matrix(rnorm((W + 30) * R, 0, sd_reg), W + 30, R), 0.5, "recursive")[-(1:30), ])
  exp(log(reg$baza) + outer(reg$sezon, sin(2 * pi * (t - 1) / 52)) + outer(reg$wzrost, t / 52) +
        rep(wspolne, each = R) + wlasne)
}
S0 <- sprzedaz()                                   # jedna „historia” sieci: 52 tygodnie + 12 kolejnych

cat("Regiony:", R, " tygodnie historii:", length(HIST), " tygodnie kampanii:", length(TEST), "\n")
cat("Sprzedaż tygodniowa w historii (tys. zł): mediana regionu", round(median(rowMeans(S0[, HIST]))),
    " zakres", paste(round(range(rowMeans(S0[, HIST]))), collapse = "–"), "\n")
cat(sprintf("Udział R20 w sprzedaży sieci: %.1f%%\n", 100 * sum(S0[20, HIST]) / sum(S0[, HIST])))
cat(sprintf("Wzrost sieci: tygodnie 53–58 wobec średniej z 52 tygodni historii bez kampanii: %+.1f%%\n",
            100 * (sum(S0[, TEST]) / length(TEST) / (sum(S0[, HIST]) / 52) - 1)))
Wynik w R
Regiony: 40  tygodnie historii: 52  tygodnie kampanii: 6
Sprzedaż tygodniowa w historii (tys. zł): mediana regionu 119  zakres 52–668
Udział R20 w sprzedaży sieci: 12.0%
Wzrost sieci: tygodnie 53–58 wobec średniej z 52 tygodni historii bez kampanii: +7.9%
2. Pary z 52 tygodni i losowanie w parach: Rysunek 2
R
# Przepis 2. Pary regionów podobnych w 52 tygodniach historii i losowanie w parach: Rysunek 2
library(patchwork)

# Podobieństwo = odległość euklidesowa między szeregami logarytmu sprzedaży z 52 tygodni.
# Łączenie zachłanne „najtrudniejszy najpierw”: regiony od najbardziej odstającego (największa średnia
# odległość od innych); każdy dostaje najbliższy wolny region. Sąsiedzi na mapie nie mogą być parą
# (kampania przecieka przez granicę) – chyba że nic innego nie zostało.
paruj <- function(H, sasiad) {
  d <- as.matrix(dist(log(H))); kolejka <- order(-rowMeans(d)); d[sasiad] <- d[sasiad] + 1e6; diag(d) <- Inf
  para <- integer(nrow(H)); k <- 0
  for (i in kolejka) if (para[i] == 0) {
    wolne <- which(para == 0 & seq_along(para) != i)
    j <- wolne[which.min(d[i, wolne])]; k <- k + 1; para[c(i, j)] <- k
  }
  para
}
losuj_w_parach <- function(para) {                 # w każdej parze jeden region (losowo) dostaje kampanię
  T <- logical(length(para))
  for (p in unique(para)) { ii <- which(para == p); T[ii[sample.int(2, 1)]] <- TRUE }
  T
}

reg$para <- paruj(S0[, HIST], sasiad)
set.seed(6650)                                     # ziarno losowania w parach
reg$kampania <- losuj_w_parach(reg$para)
reg$grupa <- ifelse(reg$kampania, "Kampania", "Kontrola")

# Sprzedaż obserwowana: w regionach z kampanią +5% w tygodniach 53–58
S <- S0; S[reg$kampania, TEST] <- S0[reg$kampania, TEST] * (1 + tau)
reg$x <- log(rowMeans(S[, HIST])); reg$y <- log(rowMeans(S[, TEST]))

pr <- do.call(rbind, lapply(split(reg, reg$para), function(d) {
  d <- d[order(!d$kampania), ]
  data.frame(para = d$para[1], kamp = d$region[1], kontr = d$region[2], xT = d$x[1], xK = d$x[2],
             yT = d$y[1], yK = d$y[2], kor = cor(log(S[match(d$region[1], reg$region), HIST]), log(S[match(d$region[2], reg$region), HIST])))
}))
cat("Pary:", nrow(pr), " pary sąsiadów:", sum(sasiad[cbind(match(pr$kamp, reg$region), match(pr$kontr, reg$region))]), "\n")
cat(sprintf("Różnica poziomu sprzedaży w parze (historia): mediana %.1f%%, największa %.1f%% (para z R20)\n",
            100 * median(abs(exp(pr$xT - pr$xK) - 1)), 100 * max(abs(exp(pr$xT - pr$xK) - 1))))
cat(sprintf("Korelacja tygodniowych szeregów w parze: mediana %.2f (zakres %.2f–%.2f)\n",
            median(pr$kor), min(pr$kor), max(pr$kor)))
cat("Para z R20:", unlist(pr[pr$kamp == "R20" | pr$kontr == "R20", c("para", "kamp", "kontr")]), "\n")
cat(sprintf("Korelacja poziomu z historii z poziomem w teście (40 regionów): %.3f\n", cor(reg$x, reg$y)))
W <- 58                                            # do pliku: historia i tygodnie kampanii
write.csv(data.frame(region = rep(reg$region, each = W), tydzien = rep(1:W, R),
                     okres = rep(ifelse(1:W <= 52, "historia", "kampania"), R),
                     sprzedaz_tys_zl = round(as.vector(t(S[, 1:W])), 2), para = rep(reg$para, each = W),
                     grupa = rep(reg$grupa, each = W)),
          "geo-eksperyment-sprzedaz-regionow.csv", row.names = FALSE)

# Rysunek 2: A – dwie pary w 58 tygodniach; B – poziom regionu z kampanią i kontrolnego w każdej parze
wyb <- c(pr$para[which.max(pr$kor)], pr$para[pr$kamp == "R20" | pr$kontr == "R20"])
dl <- do.call(rbind, lapply(wyb, function(p) {
  ii <- which(reg$para == p)
  data.frame(tydzien = rep(1:58, 2), sprzedaz = as.vector(t(S[ii, 1:58])), region = rep(reg$region[ii], each = 58),
             grupa = rep(reg$grupa[ii], each = 58), para = paste("Para", p))
}))
pa <- ggplot(dl, aes(tydzien, sprzedaz, colour = grupa, linetype = grupa)) +
  annotate("rect", xmin = 52.5, xmax = 58.5, ymin = -Inf, ymax = Inf, fill = "grey90") +
  geom_line(linewidth = 0.7) + facet_wrap(~para, scales = "free_y") +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c(Kampania = "solid", Kontrola = "22"), name = NULL) +
  labs(title = "A. Dwie pary: tydzień po tygodniu", x = "Tydzień (szare pole: kampania)", y = "Sprzedaż (tys. zł)") + motyw
pb <- ggplot(pr, aes(exp(xK), exp(xT))) + geom_abline(colour = "grey50", linetype = "22") +
  geom_point(size = 2.6, colour = "#0f1d3a", shape = 21, fill = "#E69F00") +
  ggrepel::geom_text_repel(data = pr[pr$para %in% wyb, ], aes(label = paste("Para", para)), size = 3.6, colour = "grey20", seed = 1) +
  scale_x_log10() + scale_y_log10() +
  labs(title = "B. 20 par: średnia sprzedaż z 52 tygodni", x = "Region kontrolny (tys. zł, skala log)",
       y = "Region z kampanią (tys. zł, skala log)") + motyw
p2 <- pa / pb + plot_layout(heights = c(1, 1.1))
p2   # zapis: ggsave("geo-eksperyment-pary-historia.svg", p2, width = 10, height = 8.5)
Wynik w R
Pary: 20  pary sąsiadów: 0
Różnica poziomu sprzedaży w parze (historia): mediana 5.1%, największa 59.0% (para z R20)
Korelacja tygodniowych szeregów w parze: mediana 0.89 (zakres 0.79–0.96)
Para z R20: 1 R37 R20
Korelacja poziomu z historii z poziomem w teście (40 regionów): 0.995
3. Analiza: różnica w parach z poziomem sprzed testu: Rysunek 3
R
# Przepis 3. Analiza jednego geo-eksperymentu: różnica w parach z poziomem sprzed testu: Rysunek 3
proc <- function(b) 100 * (exp(b) - 1)             # różnica logarytmów → procent

# Estymatory (wynik y = log średniej sprzedaży w tygodniach kampanii, x = log średniej z 52 tygodni):
# (1) proste porównanie grup; (2) różnica w parach; (3) różnica w parach z poziomem sprzed testu:
#     regresja różnicy y w parach na różnicy x w parach – wyraz wolny to efekt kampanii.
oszacuj <- function(y, x, T, para) {
  t1 <- t.test(y[T], y[!T])
  o <- order(para, !T); dy <- y[o][c(TRUE, FALSE)] - y[o][c(FALSE, TRUE)]
  dx <- x[o][c(TRUE, FALSE)] - x[o][c(FALSE, TRUE)]
  t2 <- t.test(dy); m3 <- lm(dy ~ dx)
  rbind(proste = c(unname(diff(rev(t1$estimate))), t1$conf.int),
        pary = c(unname(t2$estimate), t2$conf.int),
        pary_przed = c(coef(m3)[1], confint(m3)[1, ]))
}
wyn <- oszacuj(reg$y, reg$x, reg$kampania, reg$para)
tab <- data.frame(analiza = c("Proste porównanie grup", "Różnica w parach", "Różnica w parach + poziom sprzed testu"),
                  efekt = proc(wyn[, 1]), dolna = proc(wyn[, 2]), gorna = proc(wyn[, 3]))
print(format(tab, digits = 3), row.names = FALSE)
m3 <- lm(I(yT - yK) ~ I(xT - xK), data = pr)
cat(sprintf("Nachylenie różnicy w teście względem różnicy w historii: %.2f (SE %.2f)\n", coef(m3)[2], sqrt(vcov(m3)[2, 2])))
cat(sprintf("Odchylenie standardowe różnic w parach: w teście %.1f%%, po odjęciu części z historii %.1f%%\n",
            100 * sd(pr$yT - pr$yK), 100 * sigma(m3)))
cat(sprintf("Naiwne „przed i po” w regionach z kampanią: %+.1f%% (prawdziwy efekt +%.0f%%)\n",
            proc(mean(reg$y[reg$kampania] - reg$x[reg$kampania])), 100 * tau))

# Ile sprzedaży dała kampania w zł: efekt × sprzedaż regionów z kampanią, jakiej należałoby oczekiwać bez niej
sT <- sum(S[reg$kampania, TEST]); b <- wyn["pary_przed", ]
cat(sprintf("Dodatkowa sprzedaż w 6 tygodniach: %.0f tys. zł, 95%% CI [%.0f, %.0f]\n",
            sT - sT / exp(b[1]), sT - sT / exp(b[2]), sT - sT / exp(b[3])))

# Rysunek 3: A – różnica w teście a różnica w historii (każda kropka to para; skala log × 100 ≈ %); B – trzy analizy
pa <- ggplot(pr, aes(100 * (xT - xK), 100 * (yT - yK))) +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  geom_smooth(method = "lm", formula = y ~ x, colour = "#0072B2", fill = "#9CC6E3", linewidth = 0.9) +
  geom_point(size = 2.6, shape = 21, fill = "#E69F00", colour = "#0f1d3a") +
  ggrepel::geom_text_repel(aes(label = para), size = 3.4, colour = "grey30", seed = 1) +
  annotate("point", x = 0, y = 100 * coef(m3)[1], shape = 23, size = 4, fill = "#D55E00") +
  labs(title = "A. Każda kropka to para regionów", x = "Różnica w historii: kampania − kontrola (log × 100)",
       y = "Różnica w kampanii (log × 100)") + motyw
tab$analiza <- factor(tab$analiza, levels = rev(tab$analiza))
pb <- ggplot(tab, aes(efekt, analiza)) + geom_vline(xintercept = 100 * tau, colour = "#D55E00", linetype = "22") +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = "#0072B2", linewidth = 0.9) +
  geom_point(size = 3, colour = "#0f1d3a") +
  geom_text(aes(label = sprintf("%+.1f%%", efekt)), vjust = -1, size = 3.8) +
  annotate("text", x = 100 * tau, y = 3.45, label = "prawda +5%", colour = "#D55E00", hjust = -0.1, size = 3.6) +
  labs(title = "B. Efekt kampanii z 95% CI", x = "Efekt kampanii (%)", y = NULL) + motyw
p3 <- pa / pb + plot_layout(heights = c(1.4, 1))
p3   # zapis: ggsave("geo-eksperyment-analiza-par.svg", p3, width = 10, height = 8.5)
Wynik w R
                                analiza efekt  dolna gorna
                 Proste porównanie grup -3.68 -31.25 34.94
                       Różnica w parach -3.68 -14.05  7.93
 Różnica w parach + poziom sprzed testu  1.72  -1.53  5.08
Nachylenie różnicy w teście względem różnicy w historii: 0.98 (SE 0.06)
Odchylenie standardowe różnic w parach: w teście 24.3%, po odjęciu części z historii 6.7%
Naiwne „przed i po” w regionach z kampanią: +11.9% (prawdziwy efekt +5%)
Dodatkowa sprzedaż w 6 tygodniach: 287 tys. zł, 95% CI [-262, 819]
4. 2000 geo-eksperymentów: cztery plany: Rysunek 4
R
# Przepis 4. 2000 geo-eksperymentów: proste losowanie a losowanie w parach, z poziomem sprzed testu i bez: Rysunek 4
set.seed(6651)                                     # ziarno symulacji
B <- 2000
sym <- replicate(B, {
  H <- sprzedaz()                                  # nowa historia i nowe tygodnie kampanii
  para <- paruj(H[, HIST], sasiad)
  Tp <- losuj_w_parach(para)                       # losowanie w parach
  Tl <- seq_len(R) %in% sample.int(R, R / 2)       # proste losowanie 20 z 40
  x <- log(rowMeans(H[, HIST]))
  zl <- function(T) { s <- rowMeans(H[, TEST]) * (1 + tau * T); mean(s[T]) / mean(s[!T]) - 1 }
  yl <- log(rowMeans(H[, TEST])) + log(1 + tau) * Tl; yp <- log(rowMeans(H[, TEST])) + log(1 + tau) * Tp
  m <- lm(yl ~ Tl + x)
  c(proste = oszacuj(yl, x, Tl, para)["proste", ], ancova = c(coef(m)[2], confint(m)[2, ]),
    oszacuj(yp, x, Tp, para)["pary", ], oszacuj(yp, x, Tp, para)["pary_przed", ],
    zl_40 = zl(Tl), zl_bez_R20 = { T <- Tl; T[20] <- NA; s <- rowMeans(H[-20, TEST]) * (1 + tau * T[-20]); mean(s[T[-20]]) / mean(s[!T[-20]]) - 1 })
})
nazwy <- c("Proste losowanie, porównanie grup", "Proste losowanie + poziom sprzed testu",
           "Losowanie w parach, różnica w parach", "Losowanie w parach + poziom sprzed testu")
pod <- do.call(rbind, lapply(1:4, function(k) {
  e <- sym[3 * k - 2, ]; lo <- sym[3 * k - 1, ]; hi <- sym[3 * k, ]; pok <- mean(lo < log(1 + tau) & hi > log(1 + tau))
  data.frame(analiza = nazwy[k], srednia = mean(proc(e)), mediana = median(proc(e)), obciazenie = mean(proc(e)) - 100 * tau, obc_log = proc(mean(e)) - 100 * tau,
             mc = sd(proc(e)) / sqrt(B), sd = sd(proc(e)), szerokosc = mean(proc(hi) - proc(lo)),
             pokrycie = 100 * pok, mc_pok = 100 * sqrt(pok * (1 - pok) / B), moc = 100 * mean(lo > 0))
}))
cat("Prawdziwy efekt: +5%; powtórzeń:", B, "\n")
print(format(pod, digits = 3), row.names = FALSE)
cat(sprintf("Skala zł (iloraz średnich), proste losowanie: SD %.1f pp z R20, %.1f pp bez R20\n",
            100 * sd(sym["zl_40", ]), 100 * sd(sym["zl_bez_R20", ])))

# Rysunek 4: rozkład oszacowań w 2000 eksperymentach dla czterech analiz
de <- data.frame(analiza = factor(rep(nazwy, each = B), levels = rev(nazwy)), efekt = proc(c(sym[1, ], sym[4, ], sym[7, ], sym[10, ])))
pod$analiza <- factor(pod$analiza, levels = rev(nazwy))
p4 <- ggplot(de, aes(efekt, analiza)) +
  geom_violin(fill = "#9CC6E3", colour = "#0072B2", scale = "width", width = 0.8) +
  geom_boxplot(width = 0.12, outlier.shape = NA, fill = "white", colour = "#0f1d3a") +
  geom_vline(xintercept = 100 * tau, colour = "#D55E00", linetype = "22", linewidth = 0.8) +
  coord_cartesian(xlim = c(-40, 52)) +
  scale_y_discrete(labels = setNames(sprintf("%s\nSD %.1f pp, pokrycie CI %.1f%%", gsub(", | \\+ ", "\n", nazwy), pod$sd[match(nazwy, pod$analiza)],
                                             pod$pokrycie[match(nazwy, pod$analiza)]), nazwy)) +
  labs(title = "2000 geo-eksperymentów na tych samych 40 regionach", x = "Oszacowany efekt kampanii (%); prawda +5%", y = NULL) + motyw
p4   # zapis: ggsave("geo-eksperyment-symulacja-schematow.svg", p4, width = 10, height = 6.2)
Wynik w R
Prawdziwy efekt: +5%; powtórzeń: 2000
                                  analiza srednia mediana obciazenie obc_log
        Proste losowanie, porównanie grup    6.65    5.31     1.6452  0.1831
   Proste losowanie + poziom sprzed testu    5.05    5.05     0.0481  0.0375
     Losowanie w parach, różnica w parach    5.47    5.36     0.4675  0.2919
 Losowanie w parach + poziom sprzed testu    5.07    5.04     0.0728  0.0618
     mc    sd szerokosc pokrycie mc_pok  moc
 0.3963 17.72     73.08     95.3  0.471  4.4
 0.0334  1.49      6.10     95.4  0.468 91.3
 0.1361  6.09     24.87     97.6  0.342 16.5
 0.0341  1.52      6.31     95.2  0.478 89.8
Skala zł (iloraz średnich), proste losowanie: SD 26.6 pp z R20, 17.5 pp bez R20
5. Moc: liczba regionów a długość testu: Rysunek 5
R
# Przepis 5. Moc a liczba regionów i długość testu (losowanie w parach + poziom sprzed testu): Rysunek 5
set.seed(6652)                                     # ziarno symulacji mocy
LICZBY <- c(12, 20, 28, 40); DLUG <- c(2, 4, 6, 8, 10, 12); EFEKTY <- c(0.03, 0.05); B2 <- 500
moc <- do.call(rbind, lapply(LICZBY, function(n) {
  wyn <- replicate(B2, {
    H <- sprzedaz(W = 64); sub <- sort(sample.int(R, n)); H <- H[sub, ]
    para <- paruj(H[, HIST], sasiad[sub, sub]); T <- losuj_w_parach(para); x <- log(rowMeans(H[, HIST]))
    sapply(DLUG, function(L) sapply(EFEKTY, function(ef) {
      y <- log(rowMeans(H[, 52 + 1:L, drop = FALSE])) + log(1 + ef) * T
      oszacuj(y, x, T, para)["pary_przed", 2] > 0   # dolna granica 95% CI powyżej zera
    }))
  })                                               # tablica: efekt × długość × powtórzenie
  expand.grid(efekt = EFEKTY, tygodnie = DLUG, regiony = n) |>
    transform(moc = as.vector(apply(wyn, 1:2, mean)))
}))
moc$mc <- sqrt(moc$moc * (1 - moc$moc) / B2)
cat("Powtórzeń w każdej komórce:", B2, " (błąd MC mocy najwyżej", round(100 * max(moc$mc), 1), "pp)\n")
print(reshape(transform(moc[, c("efekt", "tygodnie", "regiony", "moc")], moc = round(100 * moc)),
              idvar = c("efekt", "regiony"), timevar = "tygodnie", direction = "wide"), row.names = FALSE)

moc$panel <- factor(sprintf("Prawdziwy efekt +%d%%", 100 * moc$efekt))
moc$Regiony <- factor(moc$regiony, labels = paste(LICZBY, "regionów"))
p5 <- ggplot(moc, aes(tygodnie, 100 * moc, colour = Regiony, shape = Regiony, linetype = Regiony)) +
  geom_hline(yintercept = 80, colour = "grey50", linetype = "22") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.6) + facet_wrap(~panel) +
  scale_colour_manual(values = c("#E69F00", "#56B4E9", "#009E73", "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(15, 16, 17, 18), name = NULL) + scale_linetype_manual(values = c("13", "22", "42", "solid"), name = NULL) +
  scale_x_continuous(breaks = DLUG) + scale_y_continuous(limits = c(0, 100)) +
  labs(title = "Moc geo-eksperymentu: liczba regionów a długość testu",
       x = "Długość testu (tygodnie)", y = "Moc (%; linia: 80%)") + motyw
p5   # zapis: ggsave("geo-eksperyment-moc-regiony-tygodnie.svg", p5, width = 10, height = 5.4)
Wynik w R
Powtórzeń w każdej komórce: 500  (błąd MC mocy najwyżej 2.2 pp)
 efekt regiony moc.2 moc.4 moc.6 moc.8 moc.10 moc.12
  0.03      12    10    11    11    12     12     12
  0.05      12    19    25    26    25     23     24
  0.03      20    16    20    23    23     25     25
  0.05      20    38    47    53    57     53     52
  0.03      28    25    30    37    39     37     36
  0.05      28    56    68    71    73     73     71
  0.03      40    34    42    48    48     48     46
  0.05      40    72    85    90    89     88     87
6. Pułapki: sezon i przeciek do sąsiadów: Rysunek 6
R
# Przepis 6. Dwie pułapki: sezon remontowy i przeciek kampanii do sąsiednich regionów: Rysunek 6
# A. Sezon: indeks sprzedaży grup (średnia z 52 tygodni historii = 100), tygodnie 27–58
ind <- function(T) 100 * colSums(S[T, 27:58]) / (sum(S[T, HIST]) / 52)
ds <- data.frame(tydzien = rep(27:58, 2), indeks = c(ind(reg$kampania), ind(!reg$kampania)),
                 grupa = rep(c("Kampania", "Kontrola"), each = 32))
ost <- function(T) sum(S[T, TEST]) / sum(S[T, 47:52]) - 1
cat(sprintf("Regiony z kampanią: tygodnie kampanii wobec 6 tygodni tuż przed: %+.1f%%; kontrola: %+.1f%%\n",
            100 * ost(reg$kampania), 100 * ost(!reg$kampania)))
pa <- ggplot(ds, aes(tydzien, indeks, colour = grupa, linetype = grupa)) +
  annotate("rect", xmin = 52.5, xmax = 58.5, ymin = -Inf, ymax = Inf, fill = "grey90") +
  geom_hline(yintercept = 100, colour = "grey60") + geom_line(linewidth = 0.8) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c(Kampania = "solid", Kontrola = "22"), name = NULL) +
  labs(title = "A. Sezon rośnie w obu grupach", x = "Tydzień (szare pole: kampania)", y = "Indeks sprzedaży (historia = 100)") + motyw

# B. Przeciek: region kontrolny dostaje s × 5% × (udział sąsiadów z kampanią) – symulacja
set.seed(6653)                                     # ziarno symulacji przecieku
PRZECIEK <- c(0, 0.25, 0.5, 0.75, 1); B3 <- 500
prz <- do.call(rbind, lapply(PRZECIEK, function(s) {
  e <- replicate(B3, {
    H <- sprzedaz(); para <- paruj(H[, HIST], sasiad); T <- losuj_w_parach(para)
    udz <- as.vector(sasiad %*% T) / rowSums(sasiad)            # udział sąsiadów z kampanią
    y <- log(rowMeans(H[, TEST])) + log(1 + tau * ifelse(T, 1, s * udz))
    c(oszacuj(y, log(rowMeans(H[, HIST])), T, para)["pary_przed", 1], mean(udz[!T]))
  })
  data.frame(przeciek = s, efekt = mean(proc(e[1, ])), mc = sd(proc(e[1, ])) / sqrt(B3), udzial = mean(e[2, ]))
}))
cat("Średni udział sąsiadów z kampanią wśród regionów kontrolnych:", round(mean(prz$udzial), 2), "\n")
print(format(prz[, 1:3], digits = 3), row.names = FALSE)
pb <- ggplot(prz, aes(100 * przeciek, efekt)) + geom_hline(yintercept = 100 * tau, colour = "#D55E00", linetype = "22") +
  geom_line(colour = "#0072B2", linewidth = 0.8) +
  geom_pointrange(aes(ymin = efekt - 1.96 * mc, ymax = efekt + 1.96 * mc), colour = "#0072B2") +
  geom_text(aes(label = sprintf("%.1f%%", efekt)), vjust = 2, size = 3.6) +
  annotate("text", x = 100, y = 100 * tau + 0.25, label = "prawda +5%", colour = "#D55E00", hjust = 1, size = 3.6) +
  scale_y_continuous(limits = c(1.5, 5.6)) +
  labs(title = "B. Przeciek do sąsiadów zaniża efekt", x = "Przeciek: jaka część efektu trafia do sąsiada (%)",
       y = "Średni oszacowany efekt (%)") + motyw
p6 <- pa + pb
p6   # zapis: ggsave("geo-eksperyment-pulapki-sezon-przeciek.svg", p6, width = 10, height = 5.2)
Wynik w R
Regiony z kampanią: tygodnie kampanii wobec 6 tygodni tuż przed: +24.9%; kontrola: +19.6%
Średni udział sąsiadów z kampanią wśród regionów kontrolnych: 0.5
 przeciek efekt     mc
     0.00  4.97 0.0633
     0.25  4.41 0.0724
     0.50  3.57 0.0646
     0.75  3.10 0.0685
     1.00  2.42 0.0661
7. Grafika: mapa par i plan testu: Rysunek 1
R
# Przepis 7. Grafika: mapa-schemat 40 regionów w 20 parach i plan testu (Rysunek 1)
mp <- transform(reg, x = kol, y = 6 - wiersz)
pa <- ggplot(mp) +
  geom_tile(aes(x, y, fill = grupa), colour = "white", linewidth = 1.2, width = 0.96, height = 0.94) +
  geom_tile(data = mp[20, ], aes(x, y), fill = NA, colour = "#0f1d3a", linewidth = 1.6, width = 0.96, height = 0.94) +
  geom_point(aes(x - 0.3, y + 0.25, shape = grupa), size = 2.2, colour = "#0f1d3a") +
  geom_text(aes(x + 0.05, y + 0.02, label = para), size = 5.2, fontface = "bold", colour = "#0f1d3a") +
  geom_text(aes(x, y - 0.3, label = region), size = 2.9, colour = "grey25") +
  scale_fill_manual(values = c(Kampania = "#F2B38C", Kontrola = "#9CC6E3"), name = NULL) +
  scale_shape_manual(values = c(Kampania = 17, Kontrola = 16), name = NULL) +
  coord_equal() + labs(title = "A. 40 regionów, 20 par (liczba = numer pary)",
                       subtitle = "Ramka: R20 z dużym miastem (12% sprzedaży sieci)") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
kroki <- data.frame(y = 5:1, txt = c("1. Historia: 52 tygodnie\nsprzedaży każdego regionu",
                                    sprintf("2. Pary podobnych regionów\n(%d par, nigdy sąsiedzi)", max(reg$para)),
                                    "3. Rzut monetą w każdej parze:\njeden z kampanią, drugi bez",
                                    sprintf("4. Kampania: %d tygodni\n(tydzień %d–%d)", length(TEST), min(TEST), max(TEST)),
                                    "5. Analiza: różnica w parach\n+ poziom sprzed testu"))
pb <- ggplot(kroki) +
  geom_tile(aes(1, y), width = 1.9, height = 0.82, fill = "#F4F1EA", colour = "#0f1d3a", linewidth = 0.4) +
  geom_text(aes(1, y, label = txt), size = 3.6, lineheight = 0.95, colour = "#0f1d3a") +
  geom_segment(data = kroki[-5, ], aes(x = 1, xend = 1, y = y - 0.41, yend = y - 0.59),
               arrow = arrow(length = unit(0.12, "cm")), colour = "grey40") +
  scale_x_continuous(limits = c(0, 2)) + labs(title = "B. Plan testu") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
p1 <- pa + pb + plot_layout(widths = c(2.1, 1), guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("geo-eksperyment-mapa-par.svg", p1, width = 10, height = 5.6)
8. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 8. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("kampania – kontrola (linie)" = c("#D55E00", "#0072B2"), "kampania – kontrola (mapa)" = c("#F2B38C", "#9CC6E3"),
             "12 – 20 regionów" = c("#E69F00", "#56B4E9"), "28 – 40 regionów" = c("#009E73", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  k <- rgb(t(col2rgb(k)), maxColorValue = 255)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
kampania – kontrola (linie)                114.6        108.3       91.9
kampania – kontrola (mapa)                  54.0         51.8       42.9
12 – 20 regionów                           113.1        111.4      101.5
28 – 40 regionów                            70.1         55.4       58.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresję liniową, test t i przedziały ufności policzono pakietem stats wbudowanym w R. Rysunki wykonano w pakietach ggplot2, ggrepel i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Porównanie „przed i po” bez kontroli. Wiosną sprzedaż farb rośnie sama: +11.9% zamiast 5%.
- Jeden duży region. R20 nie ma podobnego partnera i w analizie w złotych dominuje wynik. Zdecyduj o nim przed losowaniem, nie po zobaczeniu wyniku.
- Pary sąsiadów. Najbardziej podobny region często leży obok – to największe ryzyko przecieku.
- Przedłużanie testu, „aż wyjdzie”. Kolejne tygodnie prawie nie zwiększają mocy, a zaglądanie do wyniku zawyża odsetek fałszywych alarmów, jak w pułapkach testów A/B.
- Tygodnie jako niezależne obserwacje. 240 wierszy (40 × 6) daje za wąskie przedziały; jednostką jest region albo para.
Najczęstsze pytania
Co to jest geo-eksperyment w marketingu?
To eksperyment, w którym kampanię przydziela się losowo regionom (miastom, obszarom zasięgu mediów), a nie pojedynczym klientom, i porównuje sprzedaż regionów z kampanią i bez niej. Stosuje się go, gdy reklamy nie da się pokazać wybranym osobom, np. w radiu, telewizji lokalnej albo na billboardach. Statystycznie to randomizacja klastrowa z małą liczbą dużych klastrów.
Jak dobrać regiony w pary do testu kampanii?
Weź sprzedaż tygodniową z co najmniej roku przed testem, policz odległość między szeregami (np. logarytmów sprzedaży) dla każdej pary regionów i łącz najbardziej podobne, zaczynając od regionu najbardziej odstającego. Nie łącz sąsiadów, bo kampania przecieka przez granice. Potem w każdej parze rzutem monetą wybierz region z kampanią i zapisz listę par przed startem.
Ile regionów i ile tygodni potrzeba w geo-eksperymencie?
Policz to symulacją na własnej historii sprzedaży. W przykładzie 40 regionów i 6 tygodni dawało 90% mocy dla wzrostu o 5%, a 20 regionów najwyżej 57% nawet po 12 tygodniach. Liczba regionów działa mocniej niż długość testu, bo kolejne tygodnie tego samego regionu niosą mało nowej informacji.
Jak analizować wynik geo-eksperymentu z parami regionów?
Policz w każdej parze różnicę logarytmu sprzedaży (region z kampanią minus kontrolny) w czasie testu i tę samą różnicę z okresu przed testem, a następnie dopasuj regresję pierwszej na drugiej. Wyraz wolny to efekt kampanii; po przeliczeniu exp(b) − 1 daje procent. W przykładzie zawęziło to 95% przedział z ±11 do ±3.3 punktu procentowego.
Czym różni się geo-eksperyment od syntetycznej kontroli?
W geo-eksperymencie losujesz regiony przed kampanią, więc grupy są porównywalne z założenia. Syntetyczna kontrola służy do oceny po fakcie, gdy kampanię dostał jeden region wybrany bez losowania – wtedy bliźniaka buduje się z wag innych regionów i trzeba wierzyć, że dopasowanie z przeszłości przenosi się na okres kampanii.
Powiązane hasła
Przeczytaj też
Kampania w jednym regionie – syntetyczna kontrola
16 regionów i kampania tylko w jednym: wagi bliźniaka, luka, testy placebo i porównanie z DiD – pięć rysunków z kodem R.
Czytaj →PoradnikRandomizacja klastrowa – plan i analiza
ICC z przedziałem ufności, efekt schematu przy nierównych oddziałach, cztery analizy tych samych danych, poprawki df i raport CONSORT – z kodem R.
Czytaj →PoradnikTest wyłączenia reklamy (holdout)
Sklep z odzieżą: przyrost sprzedaży z holdoutu, ITT i CACE, iCPA wobec CPA z panelu, duże zamówienia i wielkość holdoutu – kod R.
Czytaj →Planujesz test kampanii w regionach?
Pomożemy dobrać regiony w pary, policzyć moc na Twojej historii sprzedaży, przeanalizować wynik i opisać ograniczenia tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bruhn, M., & McKenzie, D. (2009). In pursuit of balance: Randomization in practice in development field experiments. American Economic Journal: Applied Economics, 1(4), 200–232. https://doi.org/10.1257/app.1.4.200 ● Otwarty dostęp: pełny tekst
- Hudgens, M. G., & Halloran, M. E. (2008). Toward causal inference with interference. Journal of the American Statistical Association, 103(482), 832–842. https://doi.org/10.1198/016214508000000292 ● Otwarty dostęp: pełny tekst
- Imai, K., King, G., & Nall, C. (2009). The essential role of pair matching in cluster-randomized experiments, with application to the Mexican Universal Health Insurance Evaluation. Statistical Science, 24(1), 29–53. https://doi.org/10.1214/08-sts274 ● Otwarty dostęp
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Leyrat, C., Morgan, K. E., Leurent, B., & Kahan, B. C. (2018). Cluster randomized trials with a small number of clusters: Which analyses should be used? International Journal of Epidemiology, 47(1), 321–331. https://doi.org/10.1093/ije/dyx169
- Torgerson, D. J. (2001). Contamination in trials: Is cluster randomisation the answer? BMJ, 322(7282), 355–357. https://doi.org/10.1136/bmj.322.7282.355 ● Otwarty dostęp
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@article{bruhn2009pursuit, author={Bruhn, Miriam and McKenzie, David}, title={{In pursuit of balance: Randomization in practice in development field experiments}}, journal={American Economic Journal: Applied Economics}, year={2009}, volume={1}, number={4}, pages={200--232}, doi={10.1257/app.1.4.200}}@article{hudgens2008toward, author={Hudgens, Michael G. and Halloran, M. Elizabeth}, title={{Toward causal inference with interference}}, journal={Journal of the American Statistical Association}, year={2008}, volume={103}, number={482}, pages={832--842}, doi={10.1198/016214508000000292}}@article{imai2009essential, author={Imai, Kosuke and King, Gary and Nall, Clayton}, title={{The essential role of pair matching in cluster-randomized experiments, with application to the Mexican Universal Health Insurance Evaluation}}, journal={Statistical Science}, year={2009}, volume={24}, number={1}, pages={29--53}, doi={10.1214/08-sts274}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{leyrat2018cluster, author={Leyrat, Clémence and Morgan, Katy E. and Leurent, Baptiste and Kahan, Brennan C.}, title={{Cluster randomized trials with a small number of clusters: Which analyses should be used?}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={1}, pages={321--331}, doi={10.1093/ije/dyx169}}@article{torgerson2001contamination, author={Torgerson, David J.}, title={{Contamination in trials: Is cluster randomisation the answer?}}, journal={BMJ}, year={2001}, volume={322}, number={7282}, pages={355--357}, doi={10.1136/bmj.322.7282.355}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}