Przykład: kupon na dostawę w mieście z 12 dzielnicami
Fikcyjna platforma dostaw jedzenia działa w jednym mieście. Ma 25 000 aktywnych klientów w 12 dzielnicach (od 1100 do 3200 klientów w dzielnicy) i jedną flotę kurierów. Dział wzrostu chce sprawdzić kupon „dostawa za 0 zł”. Pytanie zarządu brzmi: o ile wzrośnie liczba zrealizowanych zamówień w całym mieście, jeśli kupon dostaną wszyscy?
Odruchowa odpowiedź to test A/B: kupon dla losowej połowy klientów i porównanie grup, jak w poradniku test A/B – plan i analiza. Tutaj to nie działa. Klienci z kuponem i bez korzystają z tych samych kurierów. Gdy klienci z kuponem zamawiają więcej, w godzinach szczytu kurierów brakuje dla wszystkich. Wynik jednej osoby zależy więc od tego, kogo jeszcze wylosowano. To interferencja, nazywana też efektem sieciowym albo efektem rozlania.
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy: 14 dni po 12 godzin (10:00–22:00), szczyty w porze obiadu i kolacji, weekend o 15% mocniejszy, 0.012 zamówienia na klienta na godzinę i kupon zwiększający skłonność do zamówienia o 25%. Kurierów jest mniej, niż trzeba w szczytach. 20% z nich jeździ tam, gdzie akurat jest najwięcej zamówień. Przeciążenie w jednej godzinie zmniejsza przepustowość w następnej. Liczbę kurierów i siłę przeniesienia zwiększyliśmy po pierwszych próbach, żeby odsetek zrealizowanych zamówień był realistyczny (ponad 80%). Ziarna 659 nie zmienialiśmy. Dane godzinowe dla dzielnic pobierzesz jako efekt-sieciowy-dostawy-dzielnice-godziny.csv.
Symulacja pozwala na coś, czego firma nie zrobi: te same dwa tygodnie „odgrywamy” pięć razy, z tą samą pogodą i tymi samymi kurierami. Raz nikt nie ma kuponu, raz mają go wszyscy, a trzy razy przydzielamy go według jednego ze schematów eksperymentu. Bez kuponu platforma realizuje 11.41 zamówienia na 1000 klientów na godzinę, z kuponem dla wszystkich 12.55. Prawdziwy efekt globalny to 1.14 zamówienia (+10.0%). Odsetek zamówień zrealizowanych spada przy tym z 83.1% do 72.9%. To liczba, którą powinien odtworzyć dobry eksperyment.
Rysunek 1: trzy sposoby przydziału kuponu
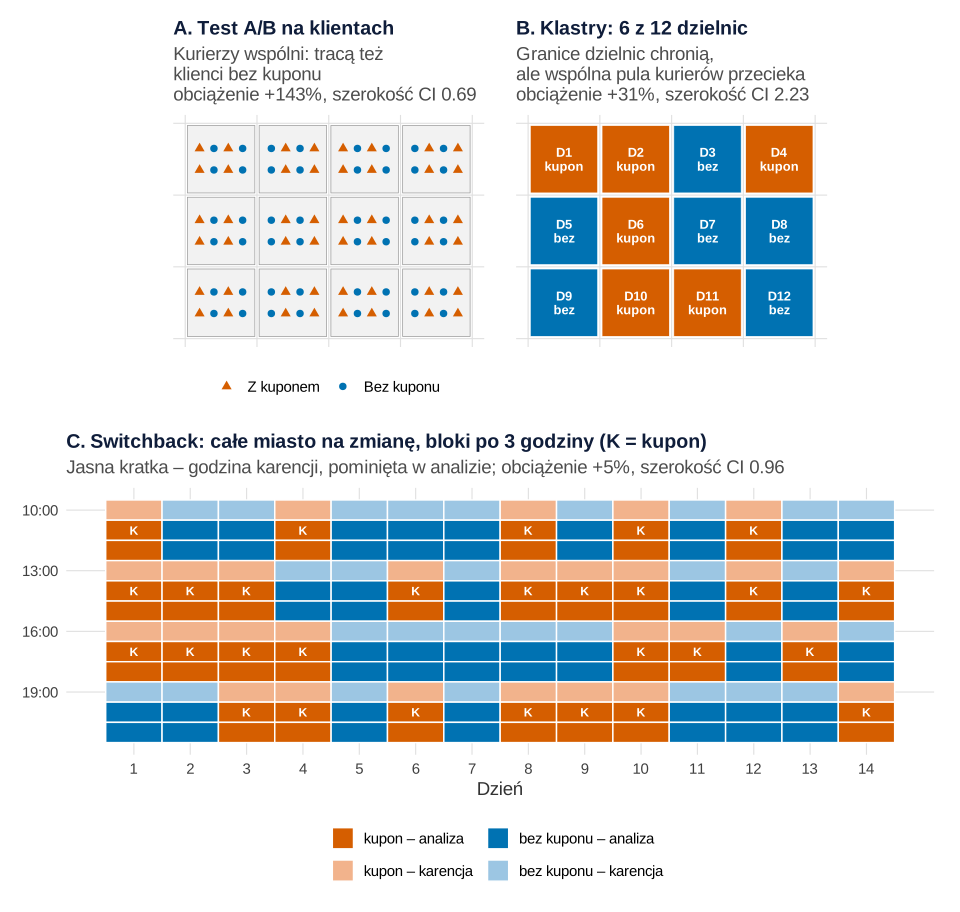
set.seed(659) i set.seed(6591)).Co widać. Trzy schematy różnią się tym, co losujemy. W teście A/B losujemy klientów, więc grupa z kuponem i grupa bez mieszkają obok siebie i dzielą kurierów. W randomizacji klastrowej losujemy dzielnice: kupon dostaje cała dzielnica albo nikt w niej. W schemacie switchback (przełączanym) losujemy okresy: przez trzy godziny kupon ma całe miasto, potem może go nie mieć nikt. Grupy nie konkurują wtedy o kurierów w tej samej chwili.
Jak może zmylić. Nie jest tak, że im większa jednostka losowania, tym lepiej. Każdy schemat płaci inną cenę: A/B – obciążeniem, klastry – szerokim przedziałem, switchback – przeniesieniem efektu między okresami.
Podpis do pracy:
Rysunek 2: dlaczego zwykły test A/B zawyża efekt
Zwykła analiza eksperymentu zakłada, że wynik klienta zależy tylko od jego własnego przydziału, a nie od przydziału innych. To założenie braku interferencji, część modelu potencjalnych wyników. W wielu sytuacjach jest ono oczywiście fałszywe (Hudgens i Halloran, 2008). Na platformie z kurierami jest fałszywe z definicji.
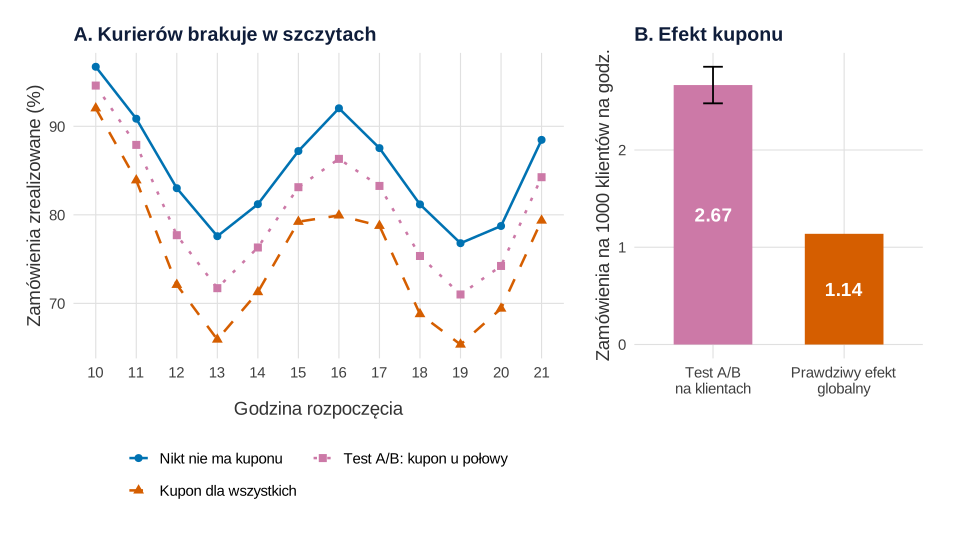
set.seed(659)).Co widać. Test A/B na klientach daje 2.67 zamówienia na 1000 klientów na godzinę, 95% przedział ufności [2.48, 2.86]. Prawdziwy efekt globalny to 1.14. Test zawyża efekt 2.3 raza, a wąski przedział nie zawiera prawdy. Panel A pokazuje mechanizm. W szczytach (13:00, 19:00) kurierów brakuje już bez kuponu. W teście A/B klienci z kuponem zabierają część kurierów klientom bez kuponu: grupa kontrolna realizuje 10.73 zamówienia zamiast 11.41. Porównanie grup liczy więc dwa zjawiska naraz: wzrost u klientów z kuponem i spadek u klientów bez kuponu, którego bez eksperymentu by nie było.
Jak może zmylić. Wąski przedział wygląda jak dobra wiadomość. Mierzy jednak tylko losowy rozrzut, nie obciążenie schematu. Podobny błąd opisali Blake i Coey (2014) w kampanii e-mailowej na platformie handlowej: pominięcie interferencji zawyżyło efekt mniej więcej dwukrotnie, tym silniej, im mniej elastyczna podaż. Johari i in. (2022) pokazują, że to, czy obciążone jest losowanie klientów, czy losowanie strony podaży, zależy od równowagi rynku – od tego, której strony brakuje. Tu brakuje kurierów. Inne pułapki opisuje wpis pułapki testów A/B na obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: randomizacja klastrowa – dzielnice zamiast klientów
Skoro klienci z obu grup nie mogą dzielić kurierów, rozdziel ich przestrzennie. Losujemy 6 z 12 dzielnic, w których kupon dostają wszyscy. To ta sama logika co w badaniu z randomizacją klastrową oddziałów szpitalnych, tylko klastrem jest dzielnica.
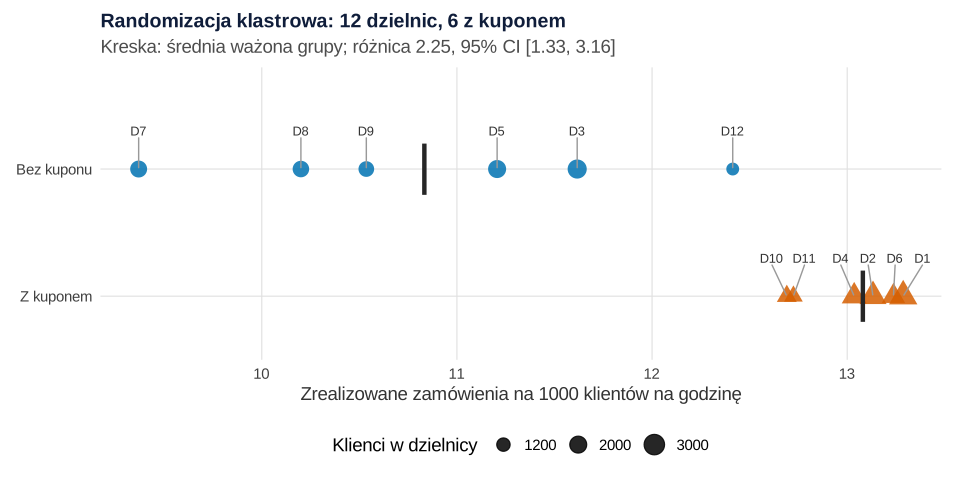
set.seed(659)).Co widać. Dzielnice z kuponem realizowały średnio 13.08 zamówienia na 1000 klientów na godzinę, dzielnice bez kuponu 10.83. Różnica wynosi 2.25, 95% CI [1.33, 3.16]. Analiza traktuje dzielnicę jako jednostkę, więc przedział opiera się na 12 obserwacjach, a nie na 25 000 klientów. Jest 4.9 raza szerszy niż w teście A/B.
Dlaczego tak szeroki? Dzielnice różnią się skłonnością do zamawiania: bez kuponu od 9.37 do 12.41. Ta różnica ginie w zmienności pojedynczych klientów: ICC liczby zamówień klienta w 14 dniach wynosi tylko .0035. Ale w dzielnicy jest średnio 2083 klientów, więc efekt schematu to DEFF = 1 + (2083 − 1) × .0035 = 8.2. 25 000 klientów niesie tyle informacji co około 3040 niezależnych osób. Przy dużych klastrach nawet znikome ICC mnoży wariancję.
Jak może zmylić. W tym przykładzie przedział nie objął prawdziwego 1.14. Złożyły się na to dwie rzeczy. Po pierwsze, przypadek: kupon wylosowały dzielnice duże i chętnie zamawiające. Po drugie, interferencja nie znika całkiem. Wspólna pula kurierów przesuwa się do dzielnic z kuponem, więc dzielnice bez kuponu realizują 10.83 zamiast 10.97 zamówienia. Granice klastrów zmniejszają przeciek, ale go nie usuwają. W 1000 symulacjach (rysunek 5) schemat klastrowy zawyżał efekt średnio o 31%.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: switchback – całe miasto na zmianę
Trzecie rozwiązanie losuje czas. Dzielimy 14 dni na 56 bloków po 3 godziny i losujemy 28 z nich, w których kupon ma całe miasto. W danej chwili wszyscy klienci są w tym samym warunku, więc nie konkurują o kurierów z drugą grupą. Takie eksperymenty są powszechne na platformach przewozowych i handlowych (Bojinov i in., 2023).
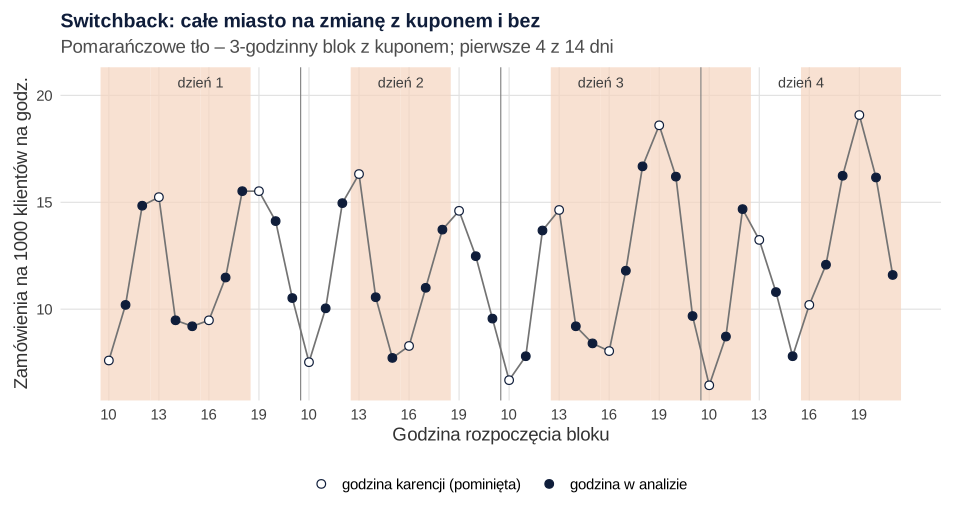
set.seed(659)).Co widać. Wynik miasta skacze między szczytami bardziej niż między blokami z kuponem i bez. Dlatego analizujemy go regresją z efektami godziny dnia i dnia: kupon porównujemy z brakiem kuponu o tej samej porze. Na wszystkich godzinach wychodzi 1.24, 95% CI [0.80, 1.67].
Jak może zmylić: przeniesienie. Kurierzy przeciążeni pod koniec bloku z kuponem wciąż kończą kursy na początku następnego bloku. Ten efekt przeniesienia znamy z badań naprzemiennych. Przewodnik po eksperymentach online także wymienia go wśród pułapek (Kohavi i in., 2020). Pierwsza godzina bloku bez kuponu jest przez to gorsza, a bloku z kuponem lepsza (po spokojnej godzinie). Rozwiązaniem jest okres karencji: pomijamy pierwszą godzinę każdego bloku (puste kółka). Wtedy oszacowanie spada do 0.99.
Jak może zmylić: zależne godziny. Godziny w jednym bloku dzielą pogodę i kurierów. Korelacja reszt sąsiednich godzin to .19 (autokorelacja reszt). Zwykłe błędy standardowe traktują każdą godzinę jak niezależną obserwację. Dlatego liczymy błędy standardowe odporne na klastrowanie z blokiem jako klastrem (Cameron i Miller, 2015). Przedział rośnie z [0.49, 1.48] do [0.41, 1.57]. Alternatywą są błędy HAC (Newey i West, 1987). Bojinov i in. (2023) proponują też wnioskowanie oparte na samym losowaniu bloków (wnioskowanie randomizacyjne).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: trzy schematy w 1000 eksperymentów
Żeby porównać schematy uczciwie, powtórzyliśmy dwa tygodnie 1000 razy z nową pogodą, nowymi kurierami i nowym losowaniem. W każdym powtórzeniu policzyliśmy też prawdę: efekt globalny w tych samych dwóch tygodniach. Średnio wynosił 1.10, a w 90% powtórzeń mieścił się między 0.94 a 1.26.
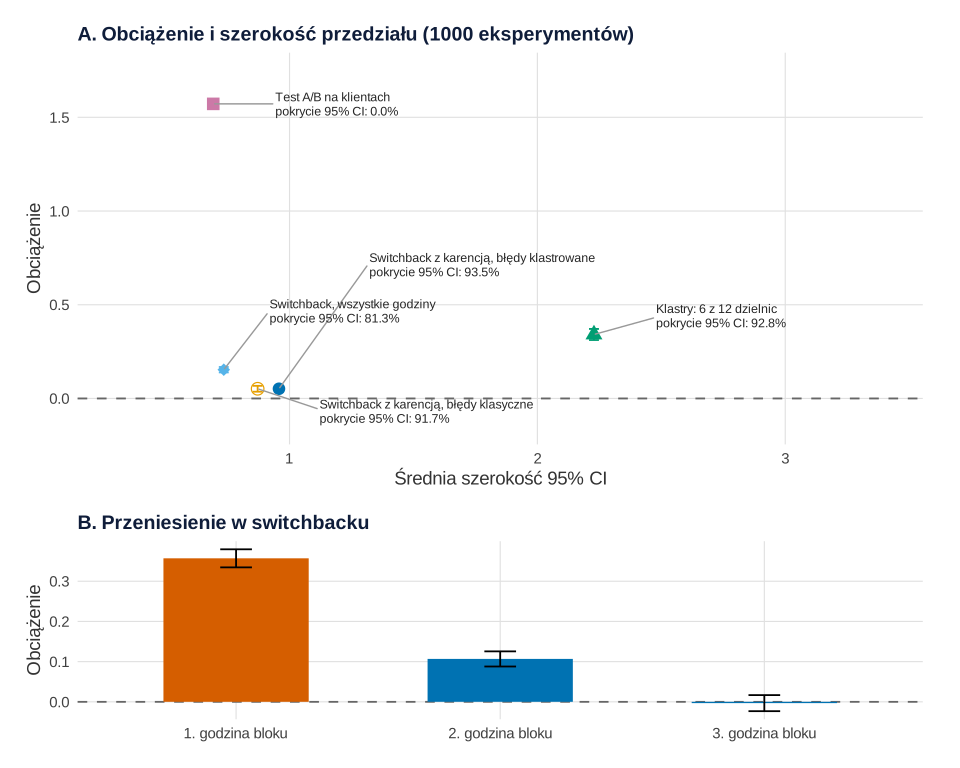
set.seed(6591)).Co widać. Najlepiej jest blisko lewego dolnego rogu: małe obciążenie i wąski przedział.
- Test A/B na klientach zawyża efekt o 143% (obciążenie 1.57, błąd MC 0.005). Przedział ma szerokość 0.69 i nie objął prawdy ani razu na 1000 prób.
- Klastry zmniejszają obciążenie do 31% (0.34), ale przedział ma szerokość 2.23. Pokrycie wynosi 92.8% (błąd MC 0.8 pp) – trochę poniżej 95%, bo przedział jest przesunięty.
- Switchback na wszystkich godzinach zawyża o 14%; pokrycie 81.3%.
- Switchback z karencją ma obciążenie 5% (0.05) i szerokość 0.96 z błędami klastrowanymi. Pokrycie wynosi 93.5% (błąd MC 0.8 pp), a z błędami klasycznymi 91.7%.
Jak może zmylić. Ranking dotyczy tego rynku i tego kuponu. Panel B pokazuje, że przeniesienie trwa dłużej niż godzinę. Pierwsza godzina bloku zawyża efekt o 0.36, druga jeszcze o 0.11, dopiero trzecia jest wolna od przeniesienia. Jednogodzinna karencja to kompromis. Dłuższe bloki zmniejszyłyby obciążenie, ale dałyby mniej bloków i szerszy przedział. Bojinov i in. (2023) pokazują, jak dobrać długość bloków do rzędu przeniesienia.
Podpis do pracy:
Co z tym zrobić w firmie
- Zanim wybierzesz schemat, nazwij wspólny zasób. Kurierzy, kierowcy, stoliki, magazyn, budżet reklamowy w aukcji. Jeśli interwencja zmienia popyt na zasób, którego jest mało, test A/B na klientach przeszacuje efekt. Zmiany, które nie ruszają zasobu, testuj zwykłym A/B.
- Decyzję podejmij na efekcie globalnym. Tu kupon dał +10.0% zamówień, a nie +23.4% z testu A/B. Przy tym odsetek zamówień zrealizowanych spadł z 83.1% do 72.9%. Wdrożenie kuponu bez dodatkowych kurierów oznacza więcej klientów, którzy czekają za długo i rezygnują. Liczbę kurierów w szczytach zaplanujesz modelem kolejki, jak w poradniku o obsadzie infolinii.
- Do efektów szybkich wybierz switchback, do powolnych – klastry. Switchback mierzy reakcję w ciągu godzin. Nie pokaże, czy klienci przyzwyczają się do darmowej dostawy w ciągu miesięcy. Wtedy losuj dzielnice, w parach podobnej wielkości (randomizacja warstwowa), i uwzględnij wynik dzielnicy sprzed testu, tak jak w CUPED.
- Ustal karencję i długość bloku przed startem. Sprawdź na danych historycznych, jak długo trwa przeciążenie kurierów. Karencja ma być co najmniej tak długa.
- Jeśli efekt ma się zmieniać w czasie, a firma chce szybko wybrać najlepszy wariant, zobacz wielorękie bandyty a test A/B. Bandyta też nie usuwa interferencji.
Jak opisać w pracy
W Metodzie uzasadnij jednostkę losowania mechanizmem interferencji (wspólni kurierzy), opisz schemat (liczbę klastrów albo bloków, długość bloku, karencję) i sposób liczenia błędów standardowych. W Wynikach podaj efekt z przedziałem i, jeśli masz kilka analiz, ich porównanie. W ograniczeniach napisz, czego schemat nie mierzy (np. efektów długoterminowych). Ogólne wskazówki znajdziesz we wpisach statystyka w pracy z logistyki i statystyka w pracy z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy parametry, generator rynku, dane, paletę i motyw, a przepisy 2–4 – funkcje oceny trzech schematów, z których korzysta symulacja w przepisie 5. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1, 3 i 5; każdy zaczyna od własnego ziarna: set.seed(659) w przepisie 1, set.seed(6592) w przepisie 3 i set.seed(6591) w przepisie 5. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): liczbę klientów w 12 dzielnicach (1100–3200), 14 dni po 12 godzin, profil godzinowy ze szczytami obiadu i kolacji, weekend +15%, 0.012 zamówienia na klienta na godzinę, zróżnicowanie dzielnic (SD logarytmu 0.15) i klientów (rozkład gamma o kształcie 2), zakłócenia dzienne, godzinowe i pogodowe (AR(1), φ = 0.8), efekt kuponu (+25% skłonności), przepustowość kurierów (0.6 + 0.8 × profil popytu), wspólną pulę kurierów (20%) i siłę przeniesienia (0.5); ponadto 6 z 12 dzielnic w schemacie klastrowym, bloki 3-godzinne z jedną godziną karencji i 1000 powtórzeń (przepis 5). Przepustowość kurierów i siłę przeniesienia zmieniono po pierwszych próbach, żeby odsetek zrealizowanych zamówień był realistyczny. Cały kod liczy się w mniej niż minutę.
1. Dane: rynek z kurierami i te same dwa tygodnie w pięciu wersjach
R
# Przepis 1. Fikcyjna platforma dostaw jedzenia: 12 dzielnic, 25 000 klientów, kurierzy wspólni dla wszystkich
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("Z kuponem" = "#D55E00", "Bez kuponu" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie: liczba klientów w dzielnicach, 14 dni po 12 godzin (10:00–22:00),
# szczyty w porze obiadu i kolacji, weekend +15%, 0.012 zamówienia na klienta na godzinę,
# kupon „dostawa za 0 zł” zwiększa skłonność do zamówienia o 25%.
N <- c(3200, 2900, 2600, 2400, 2300, 2100, 2000, 1900, 1700, 1500, 1300, 1100)
D <- length(N); H <- 12; DNI <- 14; TT <- H * DNI
godz <- rep(1:H, DNI); dzien <- rep(1:DNI, each = H)
prof <- c(0.5, 0.8, 1.4, 1.6, 1.0, 0.7, 0.7, 1.0, 1.6, 1.9, 1.5, 0.9); prof <- prof / mean(prof)
weekend <- ifelse(dzien %in% c(6, 7, 13, 14), 1.15, 1)
lam <- 0.012; tau <- 0.25
# Kurierzy (ręcznie): przepustowość dzielnicy rośnie w szczytach wolniej niż popyt; 20% kurierów jeździ
# tam, gdzie akurat jest najwięcej zamówień (wspólna pula miasta); przeciążenie w poprzedniej godzinie
# zmniejsza przepustowość w następnej (kurierzy wracają z dalekich kursów) – siła przeniesienia 0.5.
pula <- 0.2; kappa <- 0.5
kurierzy <- outer(N * lam, 0.6 + 0.8 * prof[godz])

set.seed(659)                                     # ziarno ustalone raz, bez dobierania pod wynik
skl <- exp(rnorm(D, 0, 0.15))                     # stała skłonność dzielnicy do zamawiania
klienci <- data.frame(dzielnica = rep(1:D, N))
klienci$lambda <- rgamma(sum(N), shape = 2, rate = 2 / lam) * skl[klienci$dzielnica]   # skłonność klienta

# Losowe zakłócenia jednego eksperymentu: pogoda (AR(1) godzina po godzinie), dzień, dzielnica, kurierzy
szoki <- function() {
  pogoda <- rep(as.numeric(arima.sim(list(ar = 0.8), TT, sd = 0.07)), each = D)
  list(m = outer(rep(1, D), prof[godz] * weekend) *
         exp(matrix(rnorm(D * DNI, 0, 0.10), D, DNI)[, dzien] + rep(rnorm(DNI, 0, 0.08)[dzien], each = D) +
             matrix(rnorm(D * TT, 0, 0.05), D, TT) + pogoda),
       kur = kurierzy * exp(matrix(rnorm(D * TT, 0, 0.05), D, TT) +
                              rep(as.numeric(arima.sim(list(ar = 0.8), TT, sd = 0.06)), each = D)),
       u = array(runif(4 * D * TT), c(4, D, TT)))
}
# Rynek: LT, LC – suma skłonności klientów z kuponem i bez w każdej dzielnicy i godzinie (macierze D × TT).
# Zamówienia z kuponem i bez obsługują ci sami kurierzy, więc w danej godzinie mają ten sam odsetek realizacji.
rynek <- function(LT, LC, s) {
  zT <- qpois(s$u[1, , ], LT * (1 + tau) * s$m); zC <- qpois(s$u[2, , ], LC * s$m)
  rT <- rC <- matrix(0, D, TT); obc <- rep(0.6, D)
  for (t in 1:TT) {
    if (godz[t] == 1) obc <- rep(0.6, D)            # nowy dzień: kurierzy wypoczęci
    zam <- zT[, t] + zC[, t]
    C <- (1 - pula) * s$kur[, t] + pula * sum(s$kur[, t]) * (zam + 1e-9) / sum(zam + 1e-9)
    C <- C * (1 - kappa * (obc - 0.6))              # przeniesienie z poprzedniej godziny
    f <- ifelse(zam > 0, 1 / (1 + (zam / C)^4)^(1 / 4), 1)   # odsetek zamówień zrealizowanych
    rT[, t] <- qbinom(s$u[3, , t], zT[, t], f); rC[, t] <- qbinom(s$u[4, , t], zC[, t], f)
    obc <- pmin(1, (rT[, t] + rC[, t]) / C)
  }
  list(zT = zT, zC = zC, rT = rT, rC = rC)
}
Lsum <- function(z) as.numeric(tapply(klienci$lambda * z, klienci$dzielnica, sum))   # suma skłonności wg dzielnicy
na_godziny <- function(x) matrix(x, D, TT)

# Te same dwa tygodnie „odegrane” pięć razy: bez kuponu, kupon dla wszystkich i trzy schematy eksperymentu
s0 <- szoki()
z_ab <- rbinom(nrow(klienci), 1, 0.5)                       # A/B: los dla każdego klienta
kl_tr <- seq_len(D) %in% sample(D, 6)                       # klastry: 6 z 12 dzielnic dostaje kupon
blok <- rep(1:(TT / 3), each = 3); sw_tr <- sample(rep(0:1, each = TT / 6))[blok]   # switchback: bloki 3 h
Lall <- Lsum(1)
swiaty <- list(
  nikt      = rynek(na_godziny(0), na_godziny(Lall), s0),
  wszyscy   = rynek(na_godziny(Lall), na_godziny(0), s0),
  ab        = rynek(na_godziny(Lsum(z_ab)), na_godziny(Lsum(1 - z_ab)), s0),
  klastry   = rynek(na_godziny(Lall * kl_tr), na_godziny(Lall * !kl_tr), s0),
  switchback = rynek(outer(Lall, sw_tr), outer(Lall, 1 - sw_tr), s0))
nT_ab <- as.numeric(table(factor(klienci$dzielnica[z_ab == 1], levels = 1:D)))

dane <- do.call(rbind, lapply(names(swiaty), function(n) {
  w <- swiaty[[n]]
  kup <- switch(n, nikt = rep(0, D * TT), wszyscy = rep(N, TT), ab = rep(nT_ab, TT),
                klastry = rep(N * kl_tr, TT), switchback = as.vector(outer(N, sw_tr)))
  data.frame(schemat = n, dzielnica = rep(1:D, TT), dzien = rep(dzien, each = D), godzina = rep(godz + 9, each = D),
             klienci_kupon = kup, klienci_bez = rep(N, TT) - kup,
             zamowienia_kupon = as.vector(w$zT), zamowienia_bez = as.vector(w$zC),
             zrealizowane_kupon = as.vector(w$rT), zrealizowane_bez = as.vector(w$rC))
}))
write.csv(dane, "efekt-sieciowy-dostawy-dzielnice-godziny.csv", row.names = FALSE)

na1000 <- function(r, n) r / (n * TT) * 1000       # zamówienia na 1000 klientów na godzinę
prawda <- na1000(sum(swiaty$wszyscy$rT), sum(N)) - na1000(sum(swiaty$nikt$rC), sum(N))
cat("Klienci:", sum(N), " dzielnice:", D, " godziny eksperymentu:", TT, "\n")
cat(sprintf("Zrealizowane zamówienia na 1000 klientów na godzinę: bez kuponu %.2f, kupon dla wszystkich %.2f\n",
            na1000(sum(swiaty$nikt$rC), sum(N)), na1000(sum(swiaty$wszyscy$rT), sum(N))))
cat(sprintf("Odsetek zamówień zrealizowanych: bez kuponu %.1f%%, kupon dla wszystkich %.1f%%\n",
            100 * sum(swiaty$nikt$rC) / sum(swiaty$nikt$zC), 100 * sum(swiaty$wszyscy$rT) / sum(swiaty$wszyscy$zT)))
cat(sprintf("Prawdziwy efekt globalny kuponu: %.2f zamówienia na 1000 klientów na godzinę (%.1f%%)\n",
            prawda, 100 * prawda / na1000(sum(swiaty$nikt$rC), sum(N))))
Wynik w R
Klienci: 25000  dzielnice: 12  godziny eksperymentu: 168
Zrealizowane zamówienia na 1000 klientów na godzinę: bez kuponu 11.41, kupon dla wszystkich 12.55
Odsetek zamówień zrealizowanych: bez kuponu 83.1%, kupon dla wszystkich 72.9%
Prawdziwy efekt globalny kuponu: 1.14 zamówienia na 1000 klientów na godzinę (10.0%)
2. Test A/B na klientach i interferencja: Rysunek 2
R
# Przepis 2. Naiwny test A/B na klientach a prawdziwy efekt globalny: Rysunek 2
# (korzysta z swiaty, N, nT_ab, TT, godz, prawda, na1000, kol i motyw z przepisu 1)
library(ggplot2); library(patchwork)

# Ocena testu A/B: w każdej dzielnicy różnica między klientami z kuponem i bez, potem średnia ważona
ocen_ab <- function(w, nT) {
  roznica <- na1000(rowSums(w$rT), nT) - na1000(rowSums(w$rC), N - nT)
  m <- lm(roznica ~ 1, weights = N)
  c(oszacowanie = unname(coef(m)), confint(m)[1, ])
}
ab <- ocen_ab(swiaty$ab, nT_ab)
cat(sprintf("Test A/B na klientach: %.2f, 95%% CI [%.2f, %.2f]\n", ab[1], ab[2], ab[3]))
cat(sprintf("Prawdziwy efekt globalny: %.2f  -> test A/B zawyża %.1f razy\n", prawda, ab[1] / prawda))
cat(sprintf("Względem świata bez kuponu: test A/B %+.1f%%, efekt globalny %+.1f%%\n",
            100 * ab[1] / na1000(sum(swiaty$nikt$rC), sum(N)), 100 * prawda / na1000(sum(swiaty$nikt$rC), sum(N))))
bez_kuponu_ab <- na1000(sum(swiaty$ab$rC), sum(N - nT_ab)); bez_kuponu_nikt <- na1000(sum(swiaty$nikt$rC), sum(N))
cat(sprintf("Klienci bez kuponu: w świecie bez kuponu %.2f, w teście A/B %.2f (tracą %.2f)\n",
            bez_kuponu_nikt, bez_kuponu_ab, bez_kuponu_nikt - bez_kuponu_ab))

# Odsetek zamówień zrealizowanych według godziny dnia w trzech światach
odsetek <- function(w) { r <- w$rT + w$rC; z <- w$zT + w$zC
  tapply(colSums(r), godz, sum) / tapply(colSums(z), godz, sum) * 100 }
pora <- data.frame(godzina = rep(10:21, 3),
                   swiat = factor(rep(c("Nikt nie ma kuponu", "Test A/B: kupon u połowy", "Kupon dla wszystkich"), each = 12),
                                  levels = c("Nikt nie ma kuponu", "Test A/B: kupon u połowy", "Kupon dla wszystkich")),
                   odsetek = c(odsetek(swiaty$nikt), odsetek(swiaty$ab), odsetek(swiaty$wszyscy)))
kol3 <- c("Nikt nie ma kuponu" = "#0072B2", "Test A/B: kupon u połowy" = "#CC79A7", "Kupon dla wszystkich" = "#D55E00")
pa <- ggplot(pora, aes(godzina, odsetek, colour = swiat, shape = swiat, linetype = swiat)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.4) +
  scale_colour_manual(values = kol3, name = NULL) + scale_shape_manual(values = c(16, 15, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dotted", "dashed"), name = NULL) +
  scale_x_continuous(breaks = seq(10, 21, 1)) + guides(colour = guide_legend(nrow = 2, byrow = TRUE)) +
  labs(title = "A. Kurierów brakuje w szczytach", x = "Godzina rozpoczęcia", y = "Zamówienia zrealizowane (%)") + motyw
slupki <- data.frame(co = factor(c("Test A/B\nna klientach", "Prawdziwy efekt\nglobalny"),
                                 levels = c("Test A/B\nna klientach", "Prawdziwy efekt\nglobalny")),
                     efekt = c(ab[1], prawda), dol = c(ab[2], NA), gora = c(ab[3], NA))
pb <- ggplot(slupki, aes(co, efekt)) +
  geom_col(fill = c("#CC79A7", "#D55E00"), width = 0.6) +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0.15, na.rm = TRUE) +
  geom_text(aes(label = sprintf("%.2f", efekt), y = efekt / 2), colour = "white", fontface = "bold", size = 5) +
  labs(title = "B. Efekt kuponu", x = NULL, y = "Zamówienia na 1000 klientów na godz.") + motyw
p2 <- pa + pb + plot_layout(widths = c(1.7, 1))
p2   # zapis: ggsave("efekt-sieciowy-interferencja.svg", p2, width = 10, height = 5.6)
Wynik w R
Test A/B na klientach: 2.67, 95% CI [2.48, 2.86]
Prawdziwy efekt globalny: 1.14  -> test A/B zawyża 2.3 razy
Względem świata bez kuponu: test A/B +23.4%, efekt globalny +10.0%
Klienci bez kuponu: w świecie bez kuponu 11.41, w teście A/B 10.73 (tracą 0.68)
3. Randomizacja klastrowa, ICC i efekt schematu: Rysunek 3
R
# Przepis 3. Randomizacja klastrowa: 6 z 12 dzielnic z kuponem, ICC i efekt schematu: Rysunek 3
# (korzysta z swiaty, klienci, kl_tr, N, D, TT, prawda, na1000, kol i motyw z przepisu 1 oraz ab z przepisu 2)
library(ggplot2); library(ggrepel); library(lme4)

# Ocena: średnia ważona dzielnic z kuponem minus bez kuponu; 12 dzielnic = 12 niezależnych jednostek
ocen_kl <- function(w, tr) {
  y <- na1000(rowSums(w$rT + w$rC), N)
  m <- lm(y ~ tr, weights = N)
  c(oszacowanie = unname(coef(m)[2]), confint(m)[2, ])
}
kl <- ocen_kl(swiaty$klastry, kl_tr)
cat(sprintf("Randomizacja klastrowa: %.2f, 95%% CI [%.2f, %.2f], szerokość %.2f\n", kl[1], kl[2], kl[3], kl[3] - kl[2]))
cat(sprintf("Prawdziwy efekt globalny: %.2f; przedział %.1f raza szerszy niż w teście A/B\n", prawda, (kl[3] - kl[2]) / (ab[3] - ab[2])))
kontrola_kl <- na1000(sum(swiaty$klastry$rC), sum(N[!kl_tr])); kontrola_nikt <- na1000(sum(swiaty$nikt$rC[!kl_tr, ]), sum(N[!kl_tr]))
cat(sprintf("Dzielnice bez kuponu: %.2f w eksperymencie, %.2f w świecie bez kuponu (wspólna pula kurierów zabiera %.2f)\n",
            kontrola_kl, kontrola_nikt, kontrola_nikt - kontrola_kl))

# ICC: zrealizowane zamówienia klienta w 14 dniach. Zamówienia dzielnicy przypisujemy klientom
# proporcjonalnie do ich skłonności (losowanie wielomianowe).
set.seed(6592)
razem <- rowSums(swiaty$klastry$rT + swiaty$klastry$rC)
klienci$zamowienia <- unlist(lapply(1:D, function(d) {
  l <- klienci$lambda[klienci$dzielnica == d]; as.vector(rmultinom(1, razem[d], l)) }))
klienci$kupon <- as.numeric(kl_tr[klienci$dzielnica])
m_icc <- lmer(zamowienia ~ kupon + (1 | dzielnica), data = klienci)
vc <- as.data.frame(VarCorr(m_icc))$vcov
icc <- vc[1] / sum(vc); m_sr <- mean(N); deff <- 1 + (m_sr - 1) * icc
cat(sprintf("Średnio %.1f zamówienia na klienta; ICC = %.4f; średnio %.0f klientów w dzielnicy\n", mean(klienci$zamowienia), icc, m_sr))
cat(sprintf("Efekt schematu DEFF = 1 + (%.0f - 1) × %.4f = %.1f; efektywna liczebność %d klientów zamiast %d\n",
            m_sr, icc, deff, round(sum(N) / deff), sum(N)))

# Rysunek 3: wynik każdej dzielnicy (wielkość punktu = liczba klientów)
dz <- data.frame(dzielnica = factor(paste0("D", 1:D), levels = paste0("D", 1:D)), klienci = N,
                 grupa = factor(ifelse(kl_tr, "Z kuponem", "Bez kuponu"), levels = names(kol)),
                 wynik = na1000(rowSums(swiaty$klastry$rT + swiaty$klastry$rC), N))
srednie <- tapply(dz$wynik * dz$klienci, dz$grupa, sum) / tapply(dz$klienci, dz$grupa, sum)
p3 <- ggplot(dz, aes(wynik, grupa, colour = grupa, shape = grupa)) +
  geom_point(aes(size = klienci), alpha = 0.85) +
  geom_text_repel(aes(label = dzielnica), colour = "grey20", size = 3.4, nudge_y = 0.3, direction = "x",
                  min.segment.length = 0, segment.colour = "grey60", seed = 659) +
  geom_point(data = data.frame(grupa = factor(names(srednie), levels = names(kol)), wynik = as.numeric(srednie)),
             shape = "|", size = 14, colour = "grey15") +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = c(17, 16), guide = "none") +
  scale_size_area(max_size = 7, name = "Klienci w dzielnicy", breaks = c(1200, 2000, 3000)) +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.8))) +
  labs(title = "Randomizacja klastrowa: 12 dzielnic, 6 z kuponem",
       subtitle = sprintf("Kreska: średnia ważona grupy; różnica %.2f, 95%% CI [%.2f, %.2f]", kl[1], kl[2], kl[3]),
       x = "Zrealizowane zamówienia na 1000 klientów na godzinę", y = NULL) + motyw
p3   # zapis: ggsave("efekt-sieciowy-klastry-dzielnice.svg", p3, width = 10, height = 5)
Wynik w R
Randomizacja klastrowa: 2.25, 95% CI [1.33, 3.16], szerokość 1.83
Prawdziwy efekt globalny: 1.14; przedział 4.9 raza szerszy niż w teście A/B
Dzielnice bez kuponu: 10.83 w eksperymencie, 10.97 w świecie bez kuponu (wspólna pula kurierów zabiera 0.14)
Średnio 2.0 zamówienia na klienta; ICC = 0.0035; średnio 2083 klientów w dzielnicy
Efekt schematu DEFF = 1 + (2083 - 1) × 0.0035 = 8.2; efektywna liczebność 3040 klientów zamiast 25000
4. Switchback: karencja i błędy klastrowane po blokach: Rysunek 4
R
# Przepis 4. Switchback: całe miasto na zmianę z kuponem i bez, bloki po 3 godziny: Rysunek 4
# (korzysta z swiaty, sw_tr, blok, godz, dzien, N, TT, prawda, kol i motyw z przepisu 1)
library(ggplot2); library(sandwich)

# Ocena: regresja godzinowego wyniku miasta na kupon z efektami godziny dnia i dnia;
# karencja = pominięcie pierwszej godziny każdego bloku; błędy klasyczne albo klastrowane po blokach
ocen_sw <- function(w, z, karencja = TRUE, bledy = c("bloki", "klasyczne")) {
  bledy <- match.arg(bledy)
  dd <- data.frame(y = colSums(w$rT + w$rC) / sum(N) * 1000, z, g = factor(godz), d = factor(dzien), blok,
                   pierwsza = rep(c(TRUE, FALSE, FALSE), TT / 3))
  if (karencja) dd <- dd[!dd$pierwsza, ]
  m <- lm(y ~ z + g + d, data = dd)
  V <- if (bledy == "bloki") vcovCL(m, cluster = ~blok) else vcov(m)
  se <- sqrt(V["z", "z"]); b <- unname(coef(m)["z"])
  c(oszacowanie = b, b + c(-1, 1) * qt(.975, m$df.residual) * se)
}
wyn_sw <- rbind("wszystkie godziny, błędy klasyczne" = ocen_sw(swiaty$switchback, sw_tr, FALSE, "klasyczne"),
                "karencja 1 h, błędy klasyczne"       = ocen_sw(swiaty$switchback, sw_tr, TRUE, "klasyczne"),
                "karencja 1 h, błędy klastrowane"     = ocen_sw(swiaty$switchback, sw_tr, TRUE, "bloki"))
cat("Bloki:", max(blok), " z kuponem:", sum(sw_tr) / 3, " prawdziwy efekt globalny:", round(prawda, 2), "\n")
print(round(cbind(wyn_sw, szerokosc = wyn_sw[, 3] - wyn_sw[, 2]), 2))

# Autokorelacja reszt godzinowych (bez pierwszych godzin bloków)
dd <- data.frame(y = colSums(swiaty$switchback$rT + swiaty$switchback$rC) / sum(N) * 1000, z = sw_tr,
                 g = factor(godz), d = factor(dzien))[rep(c(FALSE, TRUE, TRUE), TT / 3), ]
r <- resid(lm(y ~ z + g + d, dd))
cat("Korelacja reszt sąsiednich godzin w bloku:", round(cor(r[seq(1, length(r), 2)], r[seq(2, length(r), 2)]), 2), "\n")

# Rysunek 4: pierwsze 4 dni; tło – blok z kuponem; puste kółka – godziny karencji (pominięte)
pierwsze <- 1:48
os <- data.frame(t = pierwsze, y = colSums(swiaty$switchback$rT + swiaty$switchback$rC)[pierwsze] / sum(N) * 1000,
                 karencja = rep(c("godzina karencji (pominięta)", "godzina w analizie", "godzina w analizie"), 16))
tlo <- data.frame(xmin = which(sw_tr[pierwsze] == 1 & rep(c(TRUE, FALSE, FALSE), 16)) - 0.5)
p4 <- ggplot(os, aes(t, y)) +
  geom_rect(data = tlo, aes(xmin = xmin, xmax = xmin + 3, ymin = -Inf, ymax = Inf), inherit.aes = FALSE,
            fill = "#F5D5C0", alpha = 0.7) +
  geom_vline(xintercept = c(12.5, 24.5, 36.5), colour = "grey50", linewidth = 0.4) +
  geom_line(colour = "grey45", linewidth = 0.6) +
  geom_point(aes(shape = karencja, fill = karencja), size = 2.6, colour = "#0f1d3a") +
  scale_shape_manual(values = c(21, 21), name = NULL) +
  scale_fill_manual(values = c("godzina karencji (pominięta)" = "white", "godzina w analizie" = "#0f1d3a"), name = NULL) +
  annotate("text", x = c(6.5, 18.5, 30.5, 42.5), y = max(os$y) * 1.08, label = paste("dzień", 1:4), size = 3.8, colour = "grey25") +
  scale_x_continuous(breaks = seq(1, 48, 3), labels = rep(c("10", "13", "16", "19"), 4)) +
  labs(title = "Switchback: całe miasto na zmianę z kuponem i bez",
       subtitle = "Pomarańczowe tło – 3-godzinny blok z kuponem; pierwsze 4 z 14 dni",
       x = "Godzina rozpoczęcia bloku", y = "Zamówienia na 1000 klientów na godz.") + motyw
p4   # zapis: ggsave("efekt-sieciowy-switchback-bloki.svg", p4, width = 10, height = 5.4)
Wynik w R
Bloki: 56  z kuponem: 28  prawdziwy efekt globalny: 1.14
                                   oszacowanie           szerokosc
wszystkie godziny, błędy klasyczne        1.24 0.80 1.67      0.87
karencja 1 h, błędy klasyczne             0.99 0.49 1.48      0.99
karencja 1 h, błędy klastrowane           0.99 0.41 1.57      1.16
Korelacja reszt sąsiednich godzin w bloku: 0.19
5. 1000 eksperymentów: obciążenie, szerokość i pokrycie: Rysunek 5
R
# Przepis 5. 1000 symulowanych eksperymentów: obciążenie, szerokość przedziału i pokrycie trzech schematów: Rysunek 5
# (korzysta z szoki(), rynek(), Lsum(), na_godziny(), klienci, N, D, TT, blok, godz, dzien, kol i motyw z przepisu 1
#  oraz z ocen_ab(), ocen_kl(), ocen_sw() z przepisów 2–4)
library(ggplot2); library(ggrepel); library(patchwork); library(sandwich)

jeden <- function() {
  s <- szoki(); Lall <- Lsum(1)
  z <- rbinom(nrow(klienci), 1, 0.5); nT <- as.numeric(table(factor(klienci$dzielnica[z == 1], levels = 1:D)))
  tr <- seq_len(D) %in% sample(D, 6)
  zs <- sample(rep(0:1, each = TT / 6))[blok]
  P <- na1000(sum(rynek(na_godziny(Lall), na_godziny(0), s)$rT), sum(N)) -
       na1000(sum(rynek(na_godziny(0), na_godziny(Lall), s)$rC), sum(N))   # prawda w tych samych dwóch tygodniach
  w_sw <- rynek(outer(Lall, zs), outer(Lall, 1 - zs), s)
  y <- colSums(w_sw$rT + w_sw$rC) / sum(N) * 1000; poz <- rep(1:3, TT / 3)
  wg_pozycji <- sapply(1:3, function(k) coef(lm(y ~ zs + factor(godz) + factor(dzien), subset = poz == k))["zs"])
  rbind(prawda = c(P, NA, NA),
        ab = ocen_ab(rynek(na_godziny(Lsum(z)), na_godziny(Lsum(1 - z)), s), nT),
        klastry = ocen_kl(rynek(na_godziny(Lall * tr), na_godziny(Lall * !tr), s), tr),
        sw_wszystkie = ocen_sw(w_sw, zs, FALSE, "klasyczne"),
        sw_karencja_klas = ocen_sw(w_sw, zs, TRUE, "klasyczne"),
        sw_karencja_bloki = ocen_sw(w_sw, zs, TRUE, "bloki"),
        pozycja = wg_pozycji)
}

set.seed(6591)                                     # osobne ziarno symulacji, ustalone raz
R <- 1000
sym <- replicate(R, jeden())                       # tablica 7 × 3 × R
P <- sym["prawda", 1, ]
nazwy <- c(ab = "Test A/B na klientach", klastry = "Klastry: 6 z 12 dzielnic",
           sw_wszystkie = "Switchback, wszystkie godziny", sw_karencja_klas = "Switchback z karencją, błędy klasyczne",
           sw_karencja_bloki = "Switchback z karencją, błędy klastrowane")
wyn <- do.call(rbind, lapply(names(nazwy), function(k) {
  b <- sym[k, 1, ] - P; pokr <- mean(sym[k, 2, ] < P & sym[k, 3, ] > P)
  data.frame(schemat = nazwy[[k]], srednia = mean(sym[k, 1, ]), obciazenie = mean(b), blad_mc = sd(b) / sqrt(R),
             sd = sd(sym[k, 1, ]), szerokosc = mean(sym[k, 3, ] - sym[k, 2, ]), pokrycie = 100 * pokr,
             pokrycie_mc = 100 * sqrt(pokr * (1 - pokr) / R))
}))
cat(sprintf("Prawdziwy efekt globalny: średnio %.2f (5.–95. centyl: %.2f–%.2f); %d powtórzeń\n",
            mean(P), quantile(P, .05), quantile(P, .95), R))
with(wyn, cat(sprintf("%-41s średnia %5.2f  obciążenie %5.2f (MC %.3f)  SD %.2f  szer. CI %.2f  pokrycie %5.1f%% (MC %.1f)\n",
                      schemat, srednia, obciazenie, blad_mc, sd, szerokosc, pokrycie, pokrycie_mc), sep = ""))
cat(sprintf("Względne obciążenie: A/B %+.0f%%, klastry %+.0f%%, switchback bez karencji %+.0f%%, z karencją %+.0f%%\n",
            100 * wyn$obciazenie[1] / mean(P), 100 * wyn$obciazenie[2] / mean(P), 100 * wyn$obciazenie[3] / mean(P),
            100 * wyn$obciazenie[4] / mean(P)))
poz <- data.frame(pozycja = factor(paste0(1:3, ". godzina bloku")),
                  obciazenie = sapply(1:3, function(k) mean(sym["pozycja", k, ] - P)),
                  blad_mc = sapply(1:3, function(k) sd(sym["pozycja", k, ] - P) / sqrt(R)))
cat("\nObciążenie oszacowania z jednej godziny bloku (przeniesienie):\n")
with(poz, cat(sprintf("  %s: %5.2f (MC %.3f)\n", pozycja, obciazenie, blad_mc), sep = ""))

# Rysunek 5A: obciążenie × szerokość przedziału; 5B: obciążenie według godziny bloku
wyn$schemat <- factor(wyn$schemat, levels = nazwy)
wyn$etykieta <- sprintf("%s\npokrycie 95%% CI: %.1f%%", wyn$schemat, wyn$pokrycie)
kol5 <- c("#CC79A7", "#009E73", "#56B4E9", "#E69F00", "#0072B2"); names(kol5) <- nazwy
pa <- ggplot(wyn, aes(szerokosc, obciazenie, colour = schemat, shape = schemat)) +
  geom_hline(yintercept = 0, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(ymin = obciazenie - 1.96 * blad_mc, ymax = obciazenie + 1.96 * blad_mc), width = 0.04) +
  geom_point(size = 4) +
  geom_text_repel(aes(label = etykieta), size = 3.3, hjust = 0, lineheight = 0.95, colour = "grey15", box.padding = 0.6,
                  nudge_x = 0.25, nudge_y = c(0, 0.1, 0.35, -0.12, 0.6), min.segment.length = 0, segment.colour = "grey60", seed = 659) +
  scale_colour_manual(values = kol5, guide = "none") + scale_shape_manual(values = c(15, 17, 18, 1, 16), guide = "none") +
  scale_x_continuous(limits = c(0.3, 3.4)) + scale_y_continuous(limits = c(-0.15, 1.75)) +
  labs(title = "A. Obciążenie i szerokość przedziału (1000 eksperymentów)",
       x = "Średnia szerokość 95% CI", y = "Obciążenie") + motyw
pb <- ggplot(poz, aes(pozycja, obciazenie)) +
  geom_hline(yintercept = 0, linetype = "dashed", colour = "grey40") +
  geom_col(fill = c("#D55E00", "#0072B2", "#0072B2"), width = 0.55) +
  geom_errorbar(aes(ymin = obciazenie - 1.96 * blad_mc, ymax = obciazenie + 1.96 * blad_mc), width = 0.12) +
  labs(title = "B. Przeniesienie w switchbacku", x = NULL, y = "Obciążenie") + motyw
p5 <- pa / pb + plot_layout(heights = c(2.2, 1))
p5   # zapis: ggsave("efekt-sieciowy-symulacja-schematow.svg", p5, width = 10, height = 8)
Wynik w R
Prawdziwy efekt globalny: średnio 1.10 (5.–95. centyl: 0.94–1.26); 1000 powtórzeń
Test A/B na klientach                     średnia  2.67  obciążenie  1.57 (MC 0.005)  SD 0.17  szer. CI 0.69  pokrycie   0.0% (MC 0.0)
Klastry: 6 z 12 dzielnic                  średnia  1.44  obciążenie  0.34 (MC 0.015)  SD 0.48  szer. CI 2.23  pokrycie  92.8% (MC 0.8)
Switchback, wszystkie godziny             średnia  1.26  obciążenie  0.15 (MC 0.007)  SD 0.26  szer. CI 0.73  pokrycie  81.3% (MC 1.2)
Switchback z karencją, błędy klasyczne średnia  1.15  obciążenie  0.05 (MC 0.008)  SD 0.27  szer. CI 0.87  pokrycie  91.7% (MC 0.9)
Switchback z karencją, błędy klastrowane średnia  1.15  obciążenie  0.05 (MC 0.008)  SD 0.27  szer. CI 0.96  pokrycie  93.5% (MC 0.8)
Względne obciążenie: A/B +143%, klastry +31%, switchback bez karencji +14%, z karencją +5%

Obciążenie oszacowania z jednej godziny bloku (przeniesienie):
  1. godzina bloku:  0.36 (MC 0.011)
  2. godzina bloku:  0.11 (MC 0.010)
  3. godzina bloku: -0.00 (MC 0.010)
6. Grafika trzech schematów: Rysunek 1
R
# Przepis 6. Grafika: trzy schematy przydziału kuponu z wynikami symulacji (Rysunek 1)
# (korzysta z kl_tr, sw_tr, D, DNI i motyw z przepisu 1 oraz wyn z przepisu 5)
library(ggplot2); library(patchwork)

f2 <- function(x) formatC(x, format = "f", digits = 2)
podpis <- function(i) sprintf("obciążenie %+.0f%%, szerokość CI %s", 100 * wyn$obciazenie[i] / mean(P), f2(wyn$szerokosc[i]))
pusty <- motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
siatka <- data.frame(d = 1:D, x = (0:(D - 1)) %% 4, y = -((0:(D - 1)) %/% 4))

# A. Test A/B: w każdej dzielnicy połowa klientów z kuponem (trójkąty), połowa bez (kółka)
klient <- merge(siatka, expand.grid(d = 1:D, i = 1:8))
klient$kx <- klient$x + 0.2 + 0.2 * ((klient$i - 1) %% 4); klient$ky <- klient$y + 0.35 + 0.3 * ((klient$i - 1) %/% 4)
klient$kupon <- factor(ifelse((klient$i + klient$d) %% 2 == 0, "Z kuponem", "Bez kuponu"), levels = c("Z kuponem", "Bez kuponu"))
pa <- ggplot() +
  geom_tile(data = siatka, aes(x + 0.5, y + 0.5), width = 0.94, height = 0.94, fill = "grey95", colour = "grey60") +
  geom_point(data = klient, aes(kx, ky, colour = kupon, shape = kupon), size = 2.2) +
  scale_colour_manual(values = c("Z kuponem" = "#D55E00", "Bez kuponu" = "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(title = "A. Test A/B na klientach", subtitle = paste0("Kurierzy wspólni: tracą też\nklienci bez kuponu\n", podpis(1))) +
  coord_equal() + pusty
# B. Klastry: cała dzielnica z kuponem albo bez
siatka$grupa <- factor(ifelse(kl_tr, "Z kuponem", "Bez kuponu"), levels = c("Z kuponem", "Bez kuponu"))
pb <- ggplot(siatka, aes(x + 0.5, y + 0.5, fill = grupa)) +
  geom_tile(width = 0.94, height = 0.94, colour = "white") +
  geom_text(aes(label = paste0("D", d, "\n", ifelse(grupa == "Z kuponem", "kupon", "bez"))), colour = "white",
            size = 3.4, fontface = "bold", lineheight = 0.9) +
  scale_fill_manual(values = c("Z kuponem" = "#D55E00", "Bez kuponu" = "#0072B2"), guide = "none") +
  labs(title = "B. Klastry: 6 z 12 dzielnic", subtitle = paste0("Granice dzielnic chronią,\nale wspólna pula kurierów przecieka\n", podpis(2))) +
  coord_equal() + pusty
# C. Switchback: całe miasto w 3-godzinnych blokach; pierwsza godzina bloku to karencja
godziny <- expand.grid(h = 1:12, dz = 1:DNI)
godziny$z <- sw_tr; godziny$karencja <- (godziny$h - 1) %% 3 == 0
godziny$stan <- factor(paste(ifelse(godziny$z == 1, "kupon", "bez kuponu"), ifelse(godziny$karencja, "– karencja", "– analiza")),
                       levels = c("kupon – analiza", "kupon – karencja", "bez kuponu – analiza", "bez kuponu – karencja"))
bloki_k <- subset(godziny, z == 1 & (h - 2) %% 3 == 0)
pc <- ggplot(godziny, aes(dz, -h, fill = stan)) +
  geom_tile(colour = "white", linewidth = 0.5) +
  geom_text(data = bloki_k, aes(label = "K"), colour = "white", size = 3.2, fontface = "bold") +
  scale_fill_manual(values = c("kupon – analiza" = "#D55E00", "kupon – karencja" = "#F2B38C",
                               "bez kuponu – analiza" = "#0072B2", "bez kuponu – karencja" = "#9CC6E3"), name = NULL) +
  scale_x_continuous(breaks = 1:DNI, name = "Dzień") +
  scale_y_continuous(breaks = -c(1, 4, 7, 10), labels = c("10:00", "13:00", "16:00", "19:00"), name = NULL) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(title = "C. Switchback: całe miasto na zmianę, bloki po 3 godziny (K = kupon)",
       subtitle = paste0("Jasna kratka – godzina karencji, pominięta w analizie; ", podpis(5))) +
  motyw + theme(panel.grid = element_blank())
p1 <- (pa + pb) / pc + plot_layout(heights = c(1, 1.15))
p1   # zapis: ggsave("efekt-sieciowy-trzy-schematy.svg", p1, width = 10, height = 9.5)
7. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("z kuponem – bez kuponu" = c("#D55E00", "#0072B2"), "test A/B – kupon dla wszystkich" = c("#CC79A7", "#D55E00"),
             "karencja: kupon – bez kuponu" = c("#F2B38C", "#9CC6E3"), "klastry – switchback" = c("#009E73", "#56B4E9"),
             "błędy klasyczne – klastrowane" = c("#E69F00", "#0072B2"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  k <- rgb(t(col2rgb(k)), maxColorValue = 255)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
z kuponem – bez kuponu                     114.6        108.3       91.9
test A/B – kupon dla wszystkich             74.3         70.2       71.9
karencja: kupon – bez kuponu                54.0         51.8       42.9
klastry – switchback                        59.5         48.8       51.9
błędy klasyczne – klastrowane              120.2        121.5      109.3
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresję liniową i przedziały ufności policzono pakietem stats wbudowanym w R. Błędy standardowe klastrowane po blokach – pakietem sandwich, ICC z modelu z losowym efektem dzielnicy – pakietem lme4. Rysunki wykonano w pakietach ggplot2, ggrepel i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Wąski przedział z testu A/B jako dowód. Przy interferencji przedział jest wąski i przesunięty. Pokrycie 0%.
- Klastry analizowane na klientach. 25 000 wierszy to nie 25 000 niezależnych obserwacji. Jednostką analizy jest dzielnica (12), a przy tak małej liczbie klastrów przyda się poprawka stopni swobody.
- Przeciek między klastrami. Kurierzy, klienci pracujący w innej dzielnicy, restauracje obsługujące kilka dzielnic. Granice klastrów rzadko są szczelne.
- Bloki krótsze niż przeniesienie. Bez karencji switchback zawyżał efekt o 14%.
- Klienci, którzy uczą się rytmu. Jeśli klienci zauważą, że kupon pojawia się co kilka godzin, przesuną zamówienia. Losuj bloki i nie ogłaszaj harmonogramu.
- Godziny jako niezależne obserwacje. Klastruj po blokach albo licz błędy HAC.
Najczęstsze pytania
Co to jest interferencja w eksperymencie?
Interferencja zachodzi, gdy wynik jednej jednostki zależy od przydziału innych, np. klienci z kuponem zabierają kurierów klientom bez kuponu. Narusza to założenie zwykłej analizy eksperymentu, że każdy reaguje tylko na swój warunek. W przykładzie klienci bez kuponu realizowali w teście A/B 10.73 zamówienia na 1000 klientów na godzinę zamiast 11.41, a test zawyżył efekt 2.3 raza.
Co to jest test switchback?
To eksperyment, w którym losuje się okresy, a nie osoby: przez kilka godzin interwencję dostaje całe miasto, potem nikt, w losowej kolejności. Grupy nie konkurują wtedy o wspólny zasób w tej samej chwili. Analizuje się różnicę między okresami z interwencją i bez, z kontrolą pory dnia, pomijając początek każdego bloku i licząc błędy odporne na zależność godzin w bloku.
Po co okres karencji w eksperymencie switchback?
Bo efekt poprzedniego okresu przenosi się na następny: kurierzy przeciążeni w bloku z kuponem kończą kursy na początku kolejnego bloku. W symulacji pierwsza godzina bloku zawyżała efekt o 0.36, druga o 0.11, trzecia wcale. Pominięcie pierwszej godziny zmniejszyło obciążenie z 14% do 5%. Karencja powinna trwać co najmniej tyle, ile przeniesienie.
Kiedy randomizacja klastrowa zamiast testu A/B?
Gdy interwencja może przenosić się między osobami, które mają wspólny zasób albo kontakt, np. klienci jednej dzielnicy dzielą kurierów. Losowanie dzielnic zmniejszyło obciążenie z 143% do 31%, ale średnia szerokość przedziału wzrosła z 0.69 do 2.23, bo jednostek jest 12, a nie 25 000. Nawet ICC = .0035 przy 2083 klientach w dzielnicy daje efekt schematu 8.2.
Jak liczyć błędy standardowe w teście switchback?
Godziny z jednego bloku dzielą pogodę i kurierów, więc nie są niezależne. Użyj błędów standardowych klastrowanych po blokach albo błędów HAC Newey–Westa, ewentualnie analizy średnich bloków. W symulacji przedziały z błędami klastrowanymi obejmowały prawdziwy efekt w 93.5% przypadków, a z klasycznymi w 91.7%.
Powiązane hasła
Przeczytaj też
Randomizacja klastrowa – plan i analiza
ICC z przedziałem ufności, efekt schematu przy nierównych oddziałach, cztery analizy tych samych danych, poprawki df i raport CONSORT – z kodem R.
Czytaj →PoradnikPułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikWielorękie bandyty a test A/B
Portal z przepisami i cztery nagłówki: test A/B, strategia epsilon-zachłanna i UCB1 w 1000 symulacjach – utracone kliknięcia, trafność i obciążone średnie.
Czytaj →Analizujesz eksperyment na platformie albo w sieci placówek?
Pomożemy wybrać jednostkę losowania, zaplanować bloki i okres karencji, policzyć efekt z błędami klastrowanymi i opisać ograniczenia tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Blake, T., & Coey, D. (2014). Why marketplace experimentation is harder than it seems: The role of test-control interference. In Proceedings of the Fifteenth ACM Conference on Economics and Computation (pp. 567–582). ACM. https://doi.org/10.1145/2600057.2602837
- Bojinov, I., Simchi-Levi, D., & Zhao, J. (2023). Design and analysis of switchback experiments. Management Science, 69(7), 3759–3777. https://doi.org/10.1287/mnsc.2022.4583
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Hudgens, M. G., & Halloran, M. E. (2008). Toward causal inference with interference. Journal of the American Statistical Association, 103(482), 832–842. https://doi.org/10.1198/016214508000000292 ● Otwarty dostęp: pełny tekst
- Johari, R., Li, H., Liskovich, I., & Weintraub, G. Y. (2022). Experimental design in two-sided platforms: An analysis of bias. Management Science, 68(10), 7069–7089. https://doi.org/10.1287/mnsc.2021.4247 ● Otwarty dostęp: pełny tekst
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703–708. https://doi.org/10.2307/1913610
Cytowania BibTeX
@inproceedings{blake2014why, author={Blake, Thomas and Coey, Dominic}, title={{Why marketplace experimentation is harder than it seems: The role of test-control interference}}, booktitle={Proceedings of the Fifteenth ACM Conference on Economics and Computation}, year={2014}, pages={567--582}, publisher={ACM}, doi={10.1145/2600057.2602837}}@article{bojinov2023design, author={Bojinov, Iavor and Simchi-Levi, David and Zhao, Jinglong}, title={{Design and analysis of switchback experiments}}, journal={Management Science}, year={2023}, volume={69}, number={7}, pages={3759--3777}, doi={10.1287/mnsc.2022.4583}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{hudgens2008toward, author={Hudgens, Michael G. and Halloran, M. Elizabeth}, title={{Toward causal inference with interference}}, journal={Journal of the American Statistical Association}, year={2008}, volume={103}, number={482}, pages={832--842}, doi={10.1198/016214508000000292}}@article{johari2022experimental, author={Johari, Ramesh and Li, Hannah and Liskovich, Inessa and Weintraub, Gabriel Y.}, title={{Experimental design in two-sided platforms: An analysis of bias}}, journal={Management Science}, year={2022}, volume={68}, number={10}, pages={7069--7089}, doi={10.1287/mnsc.2021.4247}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{newey1987simple, author={Newey, Whitney K. and West, Kenneth D.}, title={{A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix}}, journal={Econometrica}, year={1987}, volume={55}, number={3}, pages={703--708}, doi={10.2307/1913610}}