Co to jest wnioskowanie randomizacyjne?
Wnioskowanie randomizacyjne (ang. randomization inference, test randomizacyjny) to sposób liczenia wartości p i przedziałów ufności, w którym jedynym źródłem losowości jest sam przydział do grup. Rozkład statystyki przy hipotezie zerowej powstaje przez powtórzenie randomizacji dokładnie według planu badania. Ernst (2004) przypomina, że takie metody sięgają prac Fishera z 1935 roku i w wielu sytuacjach dają wnioskowanie dokładne, bez założeń o rozkładzie.
Testuje się ostrą hipotezę zerową Fishera: interwencja nie zmienia wyniku u żadnej osoby. Wtedy znamy wynik każdej osoby w obu warunkach i możemy policzyć statystykę dla każdego możliwego przydziału.
Czym różni się od testu permutacyjnego?
Rachunek jest ten sam co w teście permutacyjnym, ale uzasadnienie inne. Test permutacyjny opiera się na wymienialności obserwacji z populacji, a wnioskowanie randomizacyjne – na mechanizmie przydziału. Dlatego przetasowania muszą odtwarzać plan: przy randomizacji blokowej losuje się w blokach, a przy klastrowej – całe klastry. Wniosek dotyczy osób z badania, a nie populacji. W odróżnieniu od bootstrapu nic nie losujemy ze zwracaniem.
Przykład
Dwanaście osób, z których 6 wylosowano do treningu (dane symulowane). Różnica średnich wyniku testu wiedzy wyniosła 6.17 punktu. Możliwych przydziałów 6 z 12 jest 924; w 28 z nich różnica była co najmniej tak duża co do wartości bezwzględnej, więc p = 28/924 = .030 (test t: p = .020). Odwracając test dla stałego efektu τ (odejmujemy τ od wyników grupy treningowej i sprawdzamy, czy p > .05), otrzymujemy 95% przedział [1.0, 11.3].
Young (2019) zastosował testy randomizacyjne do 53 artykułów eksperymentalnych z ekonomii: w przeciętnym artykule istotnych efektów było o 13–22% mniej niż przy metodach autorów.
Na rysunku
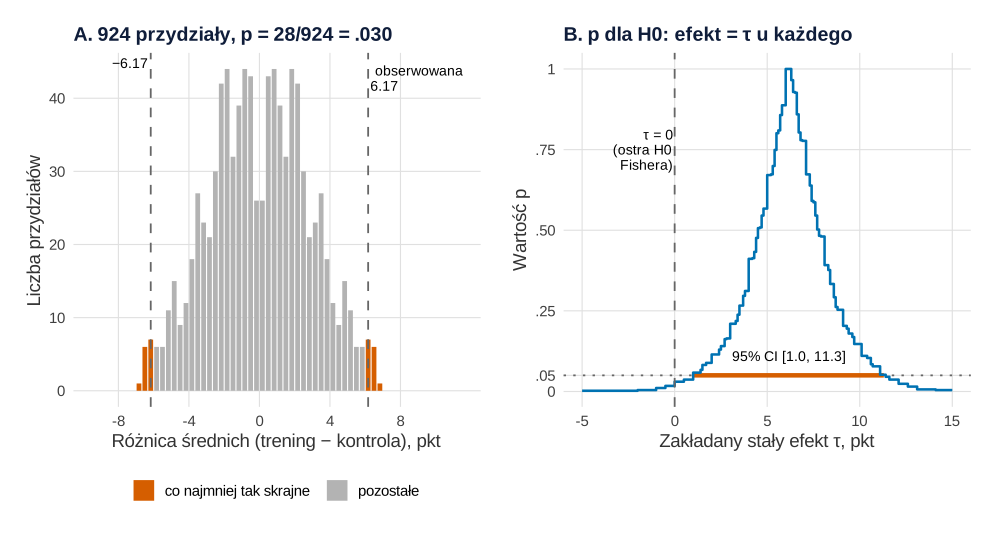
Co widać. Panel A to cały rozkład odniesienia testu: przy ostrej hipotezie zerowej wyniki osób się nie zmieniają, więc dla każdego z 924 przydziałów można policzyć różnicę średnich. Rozkład jest symetryczny wokół zera, bo w każdym przydziale można zamienić grupy miejscami. Pomarańczowe słupki to 28 przydziałów, w których różnica była co najmniej tak duża jak obserwowana 6.17 punktu (w obu kierunkach), stąd p = 28/924 = .030. Panel B powtarza ten rachunek dla hipotez „efekt = τ u każdej osoby”. Krzywa ma szczyt przy obserwowanej różnicy, a wartości τ, dla których p > .05, tworzą przedział ufności [1.0, 11.3]. To funkcja wartości p zbudowana z samego planu losowania. Punkt τ = 0 na tej krzywej to p z panelu A.
Na co uważać. Rozkład w panelu A wynika wyłącznie z tego, kogo można było wylosować. Przy randomizacji w blokach lub klastrach zbiór możliwych przydziałów jest mniejszy i rozkład wygląda inaczej. Przedział z panelu B zakłada stały efekt u wszystkich osób: przy efektach różnych u różnych osób nie mówi, jak duży jest efekt średni. Schodki wynikają z małej próby, a p przyjmuje tylko wielokrotności 1/924. Siatkę τ co 0.1 dobrano ręcznie, więc granice przedziału są podane z tą dokładnością. Podobny rozkład dla przetasowań etykiet, ale bez odwracania testu, pokazuje hasło test permutacyjny. Jak losowy przydział równoważy grupy, pokazuje wpis losowy przydział w obrazkach.
Podpis do pracy:
Kod rysunku odtwarza dane z przykładu tym samym ziarnem (set.seed(569)) i nie losuje niczego więcej: oba panele powstają z pełnej listy przydziałów. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rozkład randomizacyjny różnicy średnich (A) i funkcja wartości p z odwrócenia testu (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c(skrajne = "#D55E00", pozostale = "grey70", linia = "#0072B2", szary = "grey40")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Te same dane co w przykładzie: 12 osób, 6 wylosowanych do treningu
set.seed(569)
y <- round(rnorm(12, 20, 3))                 # wynik testu wiedzy (dane symulowane)
z <- sample(rep(0:1, 6))                     # faktyczny przydział
y[z == 1] <- y[z == 1] + 6                   # trening podnosi wynik o 6 punktów
roznica <- function(y, z) mean(y[z == 1]) - mean(y[z == 0])
obs <- roznica(y, z)
przydzialy <- combn(12, 6)                   # wszystkie 924 możliwe przydziały
Z <- apply(przydzialy, 2, function(i) as.integer(1:12 %in% i))   # macierz 12 × 924

# A: ostra H0 (τ = 0) – wyniki się nie zmieniają, losujemy tylko etykiety grup
t0 <- apply(Z, 2, function(zz) roznica(y, zz))
skrajne <- abs(t0) >= abs(obs) - 1e-9
cat(sprintf("Różnica obserwowana: %.3f; przydziały co najmniej tak skrajne: %d z %d; p = %s\n",
            obs, sum(skrajne), ncol(Z), sub("^0", "", sprintf("%.3f", mean(skrajne)))))
dA <- data.frame(t = round(t0, 4), grupa = ifelse(skrajne, "co najmniej tak skrajne", "pozostałe"))
pA <- ggplot(dA, aes(t, fill = grupa)) +
  geom_bar(width = 0.27) +                   # różnice przyjmują wartości co 1/3 punktu
  geom_vline(xintercept = c(-obs, obs), linetype = "dashed", colour = kol[["szary"]]) +
  annotate("text", x = obs, y = Inf, vjust = 1.5, hjust = -0.08, size = 3.7,
           label = sprintf("obserwowana\n%.2f", obs), lineheight = 0.9) +
  annotate("text", x = -obs, y = Inf, vjust = 1.5, hjust = 1.08, size = 3.7,
           label = sprintf("−%.2f", obs)) +
  scale_x_continuous(limits = c(-9.5, 11.5), breaks = seq(-8, 8, 4)) +
  scale_fill_manual(values = c("co najmniej tak skrajne" = kol[["skrajne"]], "pozostałe" = kol[["pozostale"]]),
                    name = NULL) +
  labs(title = sprintf("A. 924 przydziały, p = %d/924 = %s", sum(skrajne),
                       sub("^0", "", sprintf("%.3f", mean(skrajne)))),
       x = "Różnica średnich (trening − kontrola), pkt", y = "Liczba przydziałów") +
  motyw

# B: funkcja wartości p – H0: efekt = τ u każdej osoby, dla τ od −5 do 15 co 0.1
p_ri <- function(tau) {
  y0 <- y - tau * z                          # wyniki bez treningu przy H0
  t <- apply(Z, 2, function(zz) roznica(y0 + tau * zz, zz))
  mean(abs(t - tau) >= abs(obs - tau) - 1e-9)
}
dB <- data.frame(tau = seq(-5, 15, by = 0.1))
dB$p <- sapply(dB$tau, p_ri)
ufn <- range(dB$tau[dB$p > .05])            # odwrócenie testu = 95% przedział ufności
cat(sprintf("95%% przedział z odwrócenia testu: [%.1f, %.1f]; p przy τ = 0: %s\n",
            ufn[1], ufn[2], sub("^0", "", sprintf("%.3f", dB$p[abs(dB$tau) < 1e-9]))))
pB <- ggplot(dB, aes(tau, p)) +
  geom_hline(yintercept = 0.05, linetype = "dotted", colour = kol[["szary"]]) +
  annotate("segment", x = ufn[1], xend = ufn[2], y = 0.05, yend = 0.05, colour = kol[["skrajne"]], linewidth = 1.6) +
  geom_step(colour = kol[["linia"]], linewidth = 0.9) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = kol[["szary"]]) +
  annotate("text", x = mean(ufn), y = 0.11, size = 3.7,
           label = sprintf("95%% CI [%.1f, %.1f]", ufn[1], ufn[2])) +
  annotate("text", x = 0, y = 0.75, hjust = 1.05, size = 3.7, label = "τ = 0\n(ostra H0\nFishera)", lineheight = 0.9) +
  scale_y_continuous(breaks = c(0, 0.05, 0.25, 0.5, 0.75, 1), labels = c("0", ".05", ".25", ".50", ".75", "1")) +
  labs(title = "B. p dla H0: efekt = τ u każdego", x = "Zakładany stały efekt τ, pkt", y = "Wartość p") +
  motyw

p <- pA + pB
p
Wynik w R
Różnica obserwowana: 6.167; przydziały co najmniej tak skrajne: 28 z 924; p = .030
95% przedział z odwrócenia testu: [1.0, 11.3]; p przy τ = 0: .030
Jak opisać w pracy
Na co uważać
- Odtwórz faktyczny schemat losowania. Tasowanie bez bloków lub klastrów daje błędną p.
- Ostra hipoteza to nie hipoteza o średniej. Odrzucenie mówi, że efekt wystąpił u kogoś, a nie, jak duży jest średnio.
- Przy dużych próbach używa się losowej próby przydziałów; liczbę i ziarno podaj w pracy.
Praktyczne schematy losowania opisuje wpis randomizacja w praktyce, a jak interpretować wynik – hasło wartość p.
Wnioskowanie randomizacyjne w R
Kod wylicza różnicę średnich dla wszystkich 924 przydziałów 6 z 12 osób, dokładne p przy ostrej hipotezie zerowej i przedział ufności z odwrócenia testu (siatka τ co 0.1).
Dokładny test randomizacyjny i przedział z odwrócenia testu
R
# Wnioskowanie randomizacyjne: dokładny rozkład przy ostrej hipotezie zerowej
set.seed(569)
y <- round(rnorm(12, 20, 3))                 # wynik testu wiedzy (dane symulowane)
z <- sample(rep(0:1, 6))                     # faktyczny przydział: 6 osób do treningu
y[z == 1] <- y[z == 1] + 6                   # trening podnosi wynik o 6 punktów
roznica <- function(y, z) mean(y[z == 1]) - mean(y[z == 0])
obs <- roznica(y, z)
przydzialy <- combn(12, 6)                   # wszystkie 924 możliwe przydziały
p_ri <- function(tau) {                      # H0: efekt = tau u każdej osoby
  y0 <- y - tau * z                          # wyniki bez treningu przy H0
  t <- apply(przydzialy, 2, function(i) { zz <- as.integer(1:12 %in% i)
    roznica(y0 + tau * zz, zz) })
  mean(abs(t - tau) >= abs(obs - tau) - 1e-9)
}
siatka <- seq(-5, 15, by = 0.1)
ufn <- siatka[sapply(siatka, p_ri) > 0.05]   # odwrócenie testu = przedział ufności
round(c(roznica = obs, b = p_ri(0) * 924, przydzialy = ncol(przydzialy), p_RI = p_ri(0),
        p_t = t.test(y[z == 1], y[z == 0], var.equal = TRUE)$p.value,
        CI_dol = min(ufn), CI_gora = max(ufn)), 3)
Wynik w R
   roznica          b przydzialy       p_RI        p_t     CI_dol    CI_gora
     6.167     28.000    924.000      0.030      0.020      1.000     11.300
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy wnioskowanie randomizacyjne wymaga rozkładu normalnego?
Nie. Rozkład statystyki wynika z samego planu losowania, więc normalność nie jest potrzebna. Wymagane jest za to rzeczywiste losowe przydzielenie osób i odtworzenie jego schematu w obliczeniach.
Czy z testu randomizacyjnego można uogólniać na populację?
Wprost nie. Losowość pochodzi z przydziału, więc wniosek dotyczy efektu u osób w badaniu. Uogólnienie wymaga dodatkowo losowego doboru próby albo argumentu merytorycznego.
Jak uzyskać przedział ufności z wnioskowania randomizacyjnego?
Odwracając test: dla kolejnych wartości stałego efektu τ sprawdza się hipotezę „efekt = τ u każdego”. Przedział 95% to wartości τ, dla których p > .05; w przykładzie [1.0, 11.3].
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ernst, M. D. (2004). Permutation methods: A basis for exact inference. Statistical Science, 19(4), 676–685. https://doi.org/10.1214/088342304000000396 ● Otwarty dostęp
- Young, A. (2019). Channeling Fisher: Randomization tests and the statistical insignificance of seemingly significant experimental results. The Quarterly Journal of Economics, 134(2), 557–598. https://doi.org/10.1093/qje/qjy029 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{ernst2004permutation, author={Ernst, Michael D.}, title={{Permutation methods: A basis for exact inference}}, journal={Statistical Science}, year={2004}, volume={19}, number={4}, pages={676--685}, doi={10.1214/088342304000000396}}@article{young2019channeling, author={Young, Alwyn}, title={{Channeling Fisher: Randomization tests and the statistical insignificance of seemingly significant experimental results}}, journal={The Quarterly Journal of Economics}, year={2019}, volume={134}, number={2}, pages={557--598}, doi={10.1093/qje/qjy029}}