Dwa kroki: sekwencja i jej ukrycie
Hasło randomizacja wyjaśnia, czym losowy przydział różni się od losowego doboru próby i jak w prostym eksperymencie wylosować grupy. Ten wpis jest dla zespołu, który przygotowuje badanie z randomizacją: z kilkoma ośrodkami, czynnikami prognostycznymi i recenzentem, który zapyta o punkt CONSORT dotyczący przydziału. Pokazujemy, jak wygenerować listę przydziału w bazowym R, kiedy wybrać bloki, warstwy albo minimalizację i jak zorganizować ukrycie przydziału.
Udana randomizacja wymaga dwóch rzeczy: nieprzewidywalnej sekwencji przydziałów i ukrycia tej sekwencji przed osobami, które włączają uczestników (Hopewell i in., 2025). Pierwszy krok chroni przed odgadnięciem kolejnego przydziału na podstawie poprzednich. Drugi sprawia, że nikt nie zna przydziału, zanim osoba zostanie włączona. Bez ukrycia nawet poprawnie wylosowaną listę da się obejść, a takie badania średnio zawyżają efekt interwencji (Schulz i Grimes, 2002).
Przykład w całym wpisie: badanie z dwoma ramionami (A – program ćwiczeń, B – zwykła opieka), przydział 1:1, planowane N = 120 w trzech ośrodkach. Czynniki prognostyczne to ośrodek, nasilenie bólu na starcie (umiarkowany albo silny), wiek (poniżej 60 lat albo 60+) i płeć. Wszystkie liczby pochodzą z kodu R na końcu strony.
Randomizacja prosta: punkt odniesienia
W randomizacji prostej każdą osobę przydzielasz niezależnie, jak rzutem monetą, w praktyce liczbami losowymi z komputera (Altman i Bland, 1999). Jest najmniej przewidywalna, dlatego żadna bardziej złożona metoda nie chroni lepiej przed błędem selekcji (Hopewell i in., 2025). Ceną są nierówne grupy. W naszym losowaniu 120 osób dało podział 57:63, a w trakcie rekrutacji różnica dochodziła do 6 osób.
Według tych samych objaśnień CONSORT 2025 w badaniach liczących kilkaset osób randomizacja prosta zwykle wystarcza. W badaniach mniejszych niż około 200 osób może się przydać randomizacja ograniczona: bloki, warstwy albo minimalizacja (Hopewell i in., 2025). Nasza symulacja (tabela niżej) pokazuje dlaczego. Przy N = 40 różnica liczebności co najmniej 4 osób zdarzyła się w 63% badań, a przy N = 120 różnica co najmniej 12 osób – w 30%.
Bloki permutowane o losowej długości
W randomizacji blokowej sekwencję składasz z bloków, w których każde ramię występuje tyle samo razy, a kolejność w bloku jest losowa. Po każdym zamkniętym bloku grupy są równe. W naszej liście z blokami 4 i 6 różnica w trakcie rekrutacji nie przekroczyła 3 osób, a końcowy podział wyniósł 60:60.
Słabym punktem jest przewidywalność. Kto zna długość bloku i widzi wcześniejsze przydziały, ten wie, jaki będzie ostatni przydział w bloku. Objaśnienia CONSORT zalecają więc dłuższe bloki i losowo zmienianą ich długość, bo w badaniu niezaślepionym długość bloku łatwo odkryć (Hopewell i in., 2025). Jak losować długość bloków, pokazuje Efird (2011). W naszej symulacji przy stałych blokach po 4 osoba znająca tę długość mogła być pewna co trzeciego przydziału (33%). Przy blokach losowo 4 albo 6 – tylko 5%.
| Nr | Blok | Długość bloku | Ramię |
|---|---|---|---|
| 1–4 | 1 | 4 | A, A, B, B |
| 5–8 | 2 | 4 | B, A, B, A |
| 9–12 | 3 | 4 | A, A, B, B |
Długości bloków nie umieszczaj w protokole dostępnym dla osób rekrutujących. W raporcie końcowym trzeba ją podać (Hopewell i in., 2025).
Randomizacja warstwowa: mało warstw
Randomizacja warstwowa to osobna lista bloków dla każdej warstwy, czyli kombinacji poziomów czynników. Warstwy bez bloków nic nie dają, bo w każdej warstwie i tak losujesz prosto (Hopewell i in., 2025). W przykładzie warstwujemy według ośrodka i nasilenia bólu, co daje 6 warstw. Każda dostaje listę z blokami 2 albo 4 i zapasem 40 miejsc (plik lista-przydzialu-warstwowa.csv, 240 wierszy z kodem przydziału).
Według przeglądu Kernana i in. (1999) warstwowanie pomaga głównie w badaniach poniżej 400 osób i tylko wtedy, gdy czynnik silnie wpływa na rokowanie. Problem pojawia się, gdy warstw jest dużo. Każda warstwa kończy się zwykle niedomkniętym blokiem, więc niewielkie nierówności sumują się. Pocock i Simon (1975) pokazali, że permutowane bloki w warstwach zawodzą, gdy liczba warstw zbliża się do liczebności próby. Cztery nasze czynniki dałyby 3 × 2 × 2 × 2 = 24 warstwy, czyli przy N = 40 mniej niż dwie osoby na warstwę. Nawet przy 6 warstwach i N = 40 różnica liczebności grup wynosiła średnio 1.5 osoby, a w 14% badań co najmniej 4 osoby.
Ośrodek jest typowym czynnikiem warstwującym w badaniach wieloośrodkowych. Dobierz jeszcze najwyżej jeden lub dwa czynniki o udokumentowanym wpływie na wynik. Progi kategorii (np. silny ból od 7 pkt) ustal przed rekrutacją i podaj w raporcie.
Minimalizacja Pococka–Simona
Minimalizacja nie tworzy listy z góry. Przydział kolejnej osoby zależy od cech osób już włączonych (Altman i Bland, 2005). Dla nowej osoby sprawdzasz, jak duża byłaby nierównowaga, gdyby trafiła do A, a jak duża, gdyby trafiła do B. Patrzysz przy tym tylko na poziomy czynników, które ta osoba ma. Pocock i Simon (1975) mierzą nierównowagę w każdym czynniku osobno i sumują wyniki. Dzięki temu zamiast 24 warstw równoważysz 9 poziomów czterech czynników.
Druga osoba w przykładzie pochodziła z ośrodka 1, miała umiarkowany ból, mniej niż 60 lat i była kobietą. Pierwsza osoba (ośrodek 3, umiarkowany ból, poniżej 60 lat, mężczyzna) trafiła do B. Przydział do A dawał GA = 2, a przydział do B – GB = 6. Wybieramy ramię o mniejszym G, ale nie zawsze: z prawdopodobieństwem 0.8. Przy remisie losujemy 1:1. Objaśnienia CONSORT uznają element losowy za zwykle lepszy i traktują badania z minimalizacją jako metodologicznie równoważne randomizowanym (Hopewell i in., 2025).
Na tych samych 120 osobach minimalizacja dała podział 60:60. Największa różnica w poziomie czynnika wyniosła 4 osoby (ośrodek, ból) i 1 osobę (wiek, płeć). Randomizacja prosta tych samych osób dała w płci różnicę 17 osób, a w nasileniu bólu 14.
Ceną jest przewidywalność. Kto zna algorytm i cechy wcześniejszych uczestników, w 75% przypadków odgadnie kolejny przydział. Bez elementu losowego (prawdopodobieństwo 1) przydział poza remisami byłby z góry znany. Na tę słabość zwraca uwagę przegląd Scotta i in. (2002). Minimalizacja wymaga więc centralnego systemu, którego algorytm nie jest dostępny dla rekrutujących.
Porównanie metod w symulacji
Każdą metodę zastosowaliśmy w 1000 symulowanych badaniach z N = 40 i N = 120. Mierzyliśmy różnicę liczebności grup, największą nierównowagę w poziomie któregoś z czterech czynników oraz przewidywalność. Przewidywalność to odsetek trafnych odgadnięć osoby, która zna wcześniejsze przydziały i stawia na ramię „zaległe”, oraz odsetek przydziałów znanych na pewno.
| Metoda | |nA − nB| (N = 40 / 120) | Największa nierównowaga w czynniku (N = 40 / 120) | Trafne odgadnięcia (N = 120) | Przydziały pewne (N = 120) |
|---|---|---|---|---|
| Prosta | 5.0 / 8.6 | 7.1 / 12.1 | 50% | 0% |
| Bloki stałe (4) | 0.0 / 0.0 | 4.9 / 8.5 | 71% | 33% |
| Bloki losowe (4, 6) | 0.4 / 0.4 | 5.0 / 8.7 | 69% | 5% |
| Warstwowa (6 warstw) | 1.5 / 1.5 | 4.4 / 6.8 | 71% | 10% |
| Minimalizacja (80%) | 1.0 / 1.1 | 3.0 / 3.4 | 75% | 0% |
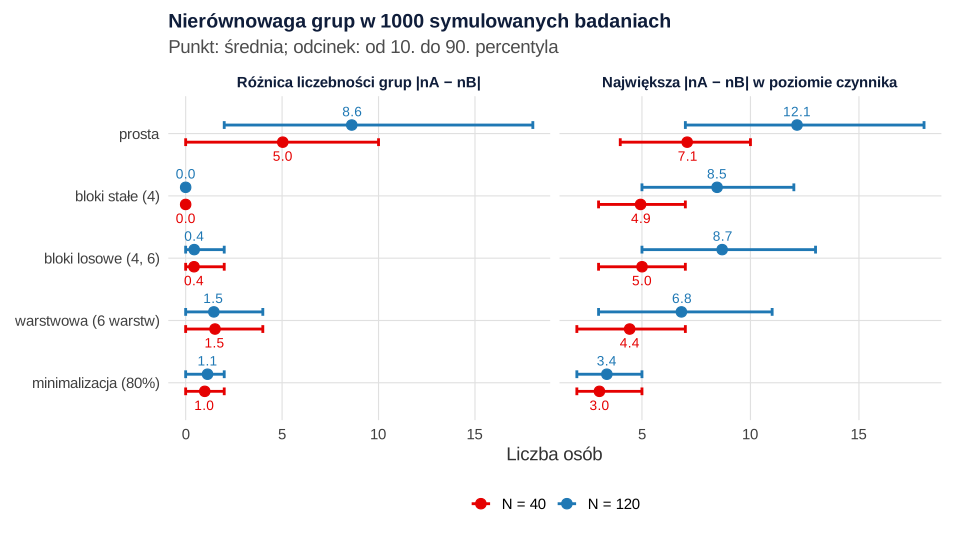
Bloki wyrównują liczebność grup, ale nierównowaga w czynnikach prognostycznych zostaje duża: przy N = 120 średnio 8.5 osoby wobec 12.1 w randomizacji prostej. Warstwy zmniejszają ją do 6.8, bo równoważą tylko dwa czynniki z czterech. Minimalizacja jako jedyna trzyma wszystkie cztery czynniki blisko równowagi i przy N = 40, i przy N = 120.
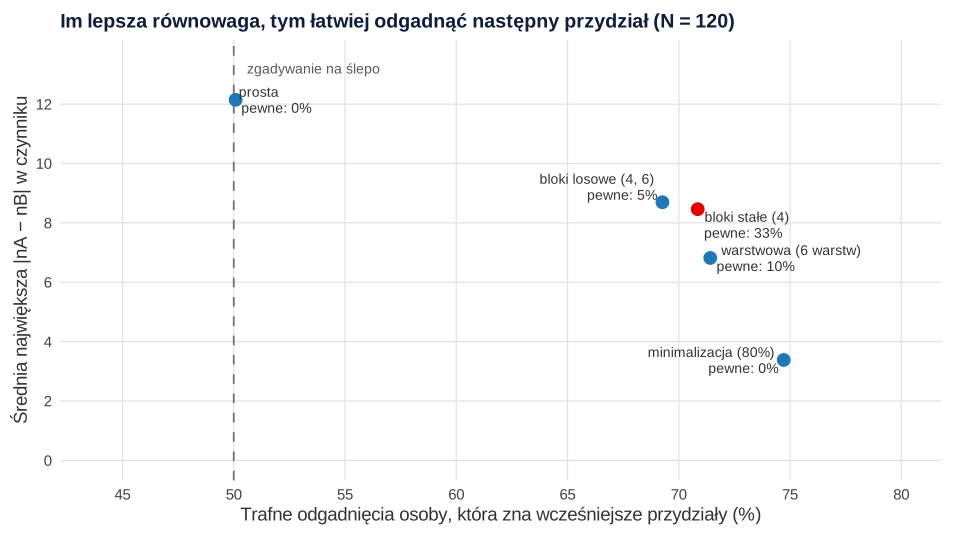
Rysunek 2 pokazuje, że każda metoda poprawiająca równowagę płaci przewidywalnością. Dlatego wybór metody i ukrycie przydziału trzeba planować razem.
Ukrycie przydziału w praktyce
Ukrycie przydziału chroni sekwencję do chwili przydziału. Decyzję o włączeniu i zgodę uczestnika trzeba uzyskać, nie znając kolejnego przydziału. Nie myl go z zaślepieniem, które chroni po przydziale i nie zawsze jest możliwe. Ukrycie przydziału da się zorganizować zawsze (Hopewell i in., 2025). Schulz i Grimes (2002) przestrzegają, że osoby prowadzące badanie bywają pomysłowe w odgadywaniu sekwencji, więc system musi być równie przemyślany.
- Rozdziel role. Listę generuje osoba niezwiązana z rekrutacją, np. statystyk spoza zespołu klinicznego. Plik z listą i ziarnem losowania przechowuje poza zasięgiem rekrutujących.
- Przydział centralny. Szczególnie pożądany jest przydział przez stronę trzecią: system internetowy, telefon do niezależnej osoby albo apteka. Gdy to niemożliwe, dobrym rozwiązaniem są identyczne, kolejno numerowane opakowania interwencji. Przy minimalizacji system centralny jest praktycznie konieczny.
- Koperty tylko starannie. Kolejno numerowane, nieprzezroczyste, zaklejone koperty mogą wystarczyć, ale łatwo je obejść. Muszą być nieprzezroczyste pod światło i otwierane po kolei. Dane uczestnika wpisz na kopertę, zanim ją otworzysz (Hopewell i in., 2025).
- Kolejność czynności. Najpierw kwalifikacja, zgoda i pomiar wyjściowy, potem przydział. Zapisuj datę i godzinę przydziału.
Stała długość bloku, przydział według dnia tygodnia czy numeru karty to nie są drobne uchybienia. Tworzą przewidywalną sekwencję, którą osoba włączająca może wykorzystać, świadomie lub nie. Proces randomizacji jest też osobną domeną oceny ryzyka błędu (zob. RoB 2 i ROBINS-I).
Analiza zgodna ze schematem przydziału
Czynniki, według których warstwowano albo minimalizowano, uwzględnij w analizie głównej, np. jako kowarianty w regresji albo ANCOVA. Kahan i Morris (2012) pokazali, że równoważenie grup wprowadza zależność, której analiza bez korekty nie widzi. Błędy standardowe są wtedy zawyżone, przedziały ufności za szerokie, a moc mniejsza. W ich przeglądzie tylko 14 z 41 badań tak robiło. Scott i in. (2002) zalecają to samo przy minimalizacji. Zapisz te kowarianty w planie analizy i w rejestracji badania. Jak taki model zbudować przy pomiarze przed i po, opisuje wpis ANCOVA w badaniu przed i po.
Analizuj uczestników według przydzielonego ramienia (ITT). Nie testuj istotności różnic wyjściowych między grupami. Przy prawidłowej randomizacji wszystkie różnice są przypadkowe, a takie testy uznaje się za zbędne (Schulz i Grimes, 2002). Jak pokazać cechy grup bez wartości p, opisuje wpis Tabela 1. Gdy losujesz oddziały lub szkoły, a nie osoby, przeczytaj wpis o randomizacji klastrowej.
Jak opisać randomizację według CONSORT
Lista CONSORT 2025 ma cztery punkty o przydziale: kto i jak wygenerował sekwencję (17a), rodzaj randomizacji i ograniczenia (17b), mechanizm ukrycia (18) oraz kto miał dostęp do sekwencji (19). Objaśnienia wymagają podania długości bloków i tego, czy była stała, czy losowa. Trzeba też podać czynniki warstwujące z progami kategorii, a przy minimalizacji – czynniki i to, czy był element losowy (Hopewell i in., 2025). Opis powinien być w głównym tekście, a nie tylko w załączniku. Wybór listy i rozszerzeń omawia wpis wytyczne raportowania.
Przy minimalizacji zmień trzecie zdanie, np.: „Zastosowano minimalizację Pococka i Simona (1975) według ośrodka, nasilenia bólu, wieku (< 60 / 60+) i płci, z równymi wagami. Ramię minimalizujące nierównowagę przydzielano z prawdopodobieństwem 0.8”. Cały proces badania od planu do raportu porządkuje przewodnik po badaniach klinicznych. Jeśli przygotowujesz protokół i chcesz sprawdzić schemat przydziału, możemy pomóc w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji, tylko w bazowym R. Pierwszy tworzy listy przydziału i zapisuje listę warstwową (możesz ją pobrać tutaj). Drugi przeprowadza minimalizację, trzeci porównuje metody w symulacji. W prawdziwym badaniu ziarno losowania i listę przechowuje osoba niezwiązana z rekrutacją.
1. Listy przydziału: prosta, blokowa i warstwowa
R
# Listy przydziału dla badania z dwoma ramionami: A = program ćwiczeń, B = zwykła opieka (1:1)
# Planowane N = 120 w trzech ośrodkach; warstwy: ośrodek (1–3) × ból na starcie (umiarkowany / silny)
set.seed(2741)
ramiona <- c("A", "B")

# 1. Randomizacja prosta: każda osoba niezależnie, jak rzut monetą
prosta <- sample(ramiona, 120, replace = TRUE)
table(prosta)

# 2. Bloki permutowane o losowej długości (4 albo 6); w każdym bloku tyle samo A i B
bloki_losowe <- function(n, dlugosci = c(4, 6)) {
  wynik <- data.frame(blok = integer(0), dlugosc_bloku = integer(0), grupa = character(0))
  b <- 0
  while (nrow(wynik) < n) {
    b <- b + 1
    k <- dlugosci[sample.int(length(dlugosci), 1)]
    wynik <- rbind(wynik, data.frame(blok = b, dlugosc_bloku = k, grupa = sample(rep(ramiona, k / 2))))
  }
  wynik$nr <- seq_len(nrow(wynik))
  wynik[, c("nr", "blok", "dlugosc_bloku", "grupa")]
}
blokowa <- bloki_losowe(120)
head(blokowa, 12)
table(blokowa$grupa[1:120])
# Różnica liczebności A − B po każdej kolejnej osobie: przy blokach nigdy nie przekracza połowy najdłuższego bloku
range(cumsum(ifelse(blokowa$grupa[1:120] == "A", 1, -1)))
range(cumsum(ifelse(prosta == "A", 1, -1)))

# 3. Randomizacja warstwowa: osobna lista bloków dla każdej z 6 warstw, z zapasem 40 miejsc na warstwę
warstwy <- expand.grid(bol = c("umiarkowany", "silny"), osrodek = 1:3)
lista <- do.call(rbind, lapply(seq_len(nrow(warstwy)), function(i) {
  w <- bloki_losowe(40, dlugosci = c(2, 4))[1:40, ]
  data.frame(osrodek = warstwy$osrodek[i], bol = warstwy$bol[i], nr_w_warstwie = w$nr,
             blok = w$blok, dlugosc_bloku = w$dlugosc_bloku, grupa = w$grupa)
}))
lista$kod_przydzialu <- sprintf("O%d-%s-%03d", lista$osrodek, substr(lista$bol, 1, 1), lista$nr_w_warstwie)
write.csv(lista, "lista-przydzialu-warstwowa.csv", row.names = FALSE)
head(lista, 6)
nrow(lista)

# Rekrutacja: 120 osób w kolejności zgłoszeń; ośrodki 50 / 40 / 30, ból silny u około 40%
osoby <- data.frame(osrodek = sample(rep(1:3, c(50, 40, 30))),
                    bol = ifelse(runif(120) < .4, "silny", "umiarkowany"))
osoby$nr_w_warstwie <- ave(seq_len(120), osoby$osrodek, osoby$bol, FUN = seq_along)
osoby <- merge(osoby, lista[, c("osrodek", "bol", "nr_w_warstwie", "grupa")], sort = FALSE)
table(warstwa = paste0("O", osoby$osrodek, "-", osoby$bol), grupa = osoby$grupa)
table(osoby$grupa)
Wynik w R
prosta
 A  B
57 63
   nr blok dlugosc_bloku grupa
1   1    1             4     A
2   2    1             4     A
3   3    1             4     B
4   4    1             4     B
5   5    2             4     B
6   6    2             4     A
7   7    2             4     B
8   8    2             4     A
9   9    3             4     A
10 10    3             4     A
11 11    3             4     B
12 12    3             4     B

 A  B
60 60
[1] -3  2
[1] -6  5
  osrodek         bol nr_w_warstwie blok dlugosc_bloku grupa kod_przydzialu
1       1 umiarkowany             1    1             4     A       O1-u-001
2       1 umiarkowany             2    1             4     B       O1-u-002
3       1 umiarkowany             3    1             4     B       O1-u-003
4       1 umiarkowany             4    1             4     A       O1-u-004
5       1 umiarkowany             5    2             2     A       O1-u-005
6       1 umiarkowany             6    2             2     B       O1-u-006
[1] 240
                grupa
warstwa           A  B
  O1-silny        6  6
  O1-umiarkowany 19 19
  O2-silny        8  8
  O2-umiarkowany 12 12
  O3-silny        6  6
  O3-umiarkowany  9  9

 A  B
60 60
2. Minimalizacja Pococka–Simona
R
# Minimalizacja Pococka–Simona: cztery czynniki, miara nierównowagi = rozstęp liczebności ramion w poziomie czynnika,
# suma po czynnikach (równe wagi), ramię minimalizujące nierównowagę wybierane z prawdopodobieństwem 0.8
set.seed(2742)
ramiona <- c("A", "B")
n <- 120
uczestnicy <- data.frame(osrodek = sample(c("1", "2", "3"), n, replace = TRUE, prob = c(.42, .33, .25)),
                         bol = ifelse(runif(n) < .4, "silny", "umiarkowany"),
                         wiek = ifelse(runif(n) < .45, "60+", "<60"),
                         plec = ifelse(runif(n) < .6, "K", "M"))
czynniki <- names(uczestnicy)

minimalizacja <- function(dane, czynniki, prawd = 0.8, wagi = rep(1, length(czynniki)), slad = 0) {
  grupa <- character(nrow(dane))
  preferowane <- rep(NA_character_, nrow(dane))                                 # ramię o mniejszym G (NA przy remisie)
  for (i in seq_len(nrow(dane))) {
    G <- sapply(ramiona, function(k) {
      sum(sapply(seq_along(czynniki), function(j) {
        f <- czynniki[j]
        ten_sam <- seq_len(i - 1)[dane[[f]][seq_len(i - 1)] == dane[[f]][i]]   # wcześniejsze osoby z tym samym poziomem
        liczby <- table(factor(grupa[ten_sam], levels = ramiona))
        liczby[k] <- liczby[k] + 1                                             # gdyby nowa osoba trafiła do k
        wagi[j] * diff(range(liczby))
      }))
    })
    if (G[1] == G[2]) {
      grupa[i] <- sample(ramiona, 1)                                         # remis: losowanie 1:1
    } else {
      lepsze <- ramiona[which.min(G)]
      preferowane[i] <- lepsze
      grupa[i] <- if (runif(1) < prawd) lepsze else setdiff(ramiona, lepsze)
    }
    if (i <= slad) cat(sprintf("osoba %2d (%s): G_A = %d, G_B = %d -> %s\n", i,
                               paste(unlist(dane[i, czynniki]), collapse = "/"), G[1], G[2], grupa[i]))
  }
  structure(grupa, preferowane = preferowane)
}

uczestnicy$grupa <- as.vector(minimalizacja(uczestnicy, czynniki, slad = 8))
table(uczestnicy$grupa)
for (cz in czynniki) print(table(uczestnicy[[cz]], uczestnicy$grupa, dnn = c(cz, "grupa")))

# Dla porównania: randomizacja prosta tych samych osób
set.seed(2743)
prosta <- sample(ramiona, n, replace = TRUE)
nierownowaga <- function(gr) sapply(czynniki, function(f) max(abs(tapply(gr == "A", uczestnicy[[f]], sum) -
                                                                  tapply(gr == "B", uczestnicy[[f]], sum))))
rbind(minimalizacja = nierownowaga(uczestnicy$grupa), prosta = nierownowaga(prosta))
Wynik w R
osoba  1 (3/umiarkowany/<60/M): G_A = 4, G_B = 4 -> B
osoba  2 (1/umiarkowany/<60/K): G_A = 2, G_B = 6 -> A
osoba  3 (2/silny/<60/K): G_A = 5, G_B = 3 -> B
osoba  4 (3/umiarkowany/60+/M): G_A = 2, G_B = 6 -> A
osoba  5 (2/umiarkowany/<60/M): G_A = 3, G_B = 5 -> A
osoba  6 (2/silny/60+/K): G_A = 4, G_B = 4 -> A
osoba  7 (3/umiarkowany/<60/M): G_A = 7, G_B = 3 -> B
osoba  8 (3/umiarkowany/60+/K): G_A = 7, G_B = 3 -> B

 A  B
60 60
       grupa
osrodek  A  B
      1 24 21
      2 21 25
      3 15 14
             grupa
bol            A  B
  silny       28 24
  umiarkowany 32 36
     grupa
wiek   A  B
  <60 37 38
  60+ 23 22
    grupa
plec  A  B
   K 36 37
   M 24 23
              osrodek bol wiek plec
minimalizacja       4   4    1    1
prosta              7  14    7   17
3. Symulacja: nierównowaga i przewidywalność
R
# Symulacja: 1000 badań z N = 40 i N = 120 dla pięciu metod przydziału (funkcje z przepisów 1 i 2)
# Miary: |nA − nB|, największa nierównowaga |nA − nB| w poziomie któregoś z czterech czynników,
# odsetek trafnych odgadnięć osoby rekrutującej, która zna wcześniejsze przydziały i stawia na ramię „zaległe”,
# oraz odsetek przydziałów, które ta osoba zna na pewno, jeśli wie, jakie długości bloków są możliwe
set.seed(2744)
nowi <- function(n) data.frame(osrodek = sample(c("1", "2", "3"), n, replace = TRUE, prob = c(.42, .33, .25)),
                               bol = ifelse(runif(n) < .4, "silny", "umiarkowany"),
                               wiek = ifelse(runif(n) < .45, "60+", "<60"),
                               plec = ifelse(runif(n) < .6, "K", "M"))
zgadnij <- function(gr, warstwa = rep(1, length(gr))) {      # strategia „ramię z mniejszą liczbą przydziałów”
  trafy <- numeric(length(gr))
  for (i in seq_along(gr)) {
    wczesniej <- gr[seq_len(i - 1)][warstwa[seq_len(i - 1)] == warstwa[i]]
    nA <- sum(wczesniej == "A"); nB <- sum(wczesniej == "B")
    trafy[i] <- if (nA == nB) 0.5 else as.numeric(gr[i] == if (nA < nB) "A" else "B")
  }
  mean(trafy)
}
pewne <- function(gr, dlugosci, warstwa = rep(1, length(gr))) {   # czy następny przydział wynika z historii?
  wynik <- logical(length(gr))
  for (s in unique(warstwa)) {
    idx <- which(warstwa == s)
    stany <- list(c(0, 0, 0))                                        # (długość bieżącego bloku, liczba A, liczba B); 0 = nowy blok
    for (i in idx) {
      rozwin <- unique(do.call(rbind, lapply(stany, function(st) if (st[1] == 0) cbind(dlugosci, 0, 0) else rbind(st))))
      mozliwe <- unique(c(if (any(rozwin[, 2] < rozwin[, 1] / 2)) "A", if (any(rozwin[, 3] < rozwin[, 1] / 2)) "B"))
      wynik[i] <- length(mozliwe) == 1
      kol <- if (gr[i] == "A") 2 else 3
      rozwin <- rozwin[rozwin[, kol] < rozwin[, 1] / 2, , drop = FALSE]
      rozwin[, kol] <- rozwin[, kol] + 1
      rozwin[rozwin[, 2] + rozwin[, 3] == rozwin[, 1], ] <- 0          # blok zamknięty: następny zaczyna się od nowa
      stany <- split(rozwin, row(rozwin))
    }
  }
  mean(wynik)
}
jedno_badanie <- function(n) {
  d <- nowi(n); w <- paste(d$osrodek, d$bol)
  gr <- list(prosta = sample(ramiona, n, replace = TRUE),
             `bloki stałe (4)` = bloki_losowe(n, dlugosci = 4)$grupa[1:n],
             `bloki losowe (4, 6)` = bloki_losowe(n)$grupa[1:n])
  gr$`warstwowa (6 warstw)` <- character(n)
  for (s in unique(w)) gr$`warstwowa (6 warstw)`[w == s] <- bloki_losowe(sum(w == s), dlugosci = c(2, 4))$grupa[1:sum(w == s)]
  m <- minimalizacja(d, czynniki)
  gr$`minimalizacja (80%)` <- as.vector(m)
  pref <- attr(m, "preferowane")
  odg <- c(zgadnij(gr[[1]]), zgadnij(gr[[2]]), zgadnij(gr[[3]]), zgadnij(gr[[4]], w),
           mean(ifelse(is.na(pref), 0.5, gr[[5]] == pref)))
  pew <- c(0, pewne(gr[[2]], 4), pewne(gr[[3]], c(4, 6)), pewne(gr[[4]], c(2, 4), w), 0)
  do.call(rbind, lapply(seq_along(gr), function(k) data.frame(
    N = n, metoda = names(gr)[k], roznica = abs(sum(gr[[k]] == "A") - sum(gr[[k]] == "B")),
    czynnik_max = max(sapply(czynniki, function(f) max(abs(tapply(gr[[k]] == "A", d[[f]], sum) - tapply(gr[[k]] == "B", d[[f]], sum))))),
    odgadniete = odg[k], pewne = pew[k])))
}
sym <- do.call(rbind, lapply(c(40, 120), function(n) do.call(rbind, replicate(1000, jedno_badanie(n), simplify = FALSE))))
sym$metoda <- factor(sym$metoda, levels = unique(sym$metoda))
podsum <- aggregate(cbind(roznica, czynnik_max, odgadniete, pewne) ~ metoda + N, data = sym, FUN = mean)
podsum$p_roznica_10proc <- aggregate(roznica >= 0.1 * N ~ metoda + N, data = sym, FUN = mean)[[3]]
podsum$p_czynnik_4plus <- aggregate(czynnik_max >= 4 ~ metoda + N, data = sym, FUN = mean)[[3]]
print(cbind(podsum[1:2], round(podsum[3:8], 3)), row.names = FALSE)
Wynik w R
               metoda   N roznica czynnik_max odgadniete pewne p_roznica_10proc
               prosta  40   5.034       7.084      0.498 0.000            0.634
      bloki stałe (4)  40   0.000       4.937      0.707 0.335            0.000
  bloki losowe (4, 6)  40   0.434       5.004      0.688 0.055            0.000
 warstwowa (6 warstw)  40   1.522       4.433      0.699 0.088            0.141
  minimalizacja (80%)  40   0.990       3.040      0.744 0.000            0.046
               prosta 120   8.610      12.147      0.501 0.000            0.304
      bloki stałe (4) 120   0.000       8.462      0.709 0.333            0.000
  bloki losowe (4, 6) 120   0.444       8.696      0.693 0.054            0.000
 warstwowa (6 warstw) 120   1.462       6.818      0.714 0.104            0.000
  minimalizacja (80%) 120   1.134       3.382      0.747 0.000            0.000
 p_czynnik_4plus
           0.949
           0.805
           0.817
           0.654
           0.325
           0.996
           0.971
           0.985
           0.849
           0.394
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats, m.in. sample()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Randomizacja” bez szczegółów. Samo słowo nie pozwala ocenić metody. Podaj sposób generowania, bloki, warstwy i mechanizm ukrycia.
- Stałe, krótkie bloki w badaniu bez zaślepienia. Przy blokach po 4 co trzeci przydział jest znany z góry.
- Za dużo warstw. Niedomknięte bloki w wielu warstwach psują równowagę. Przy kilku czynnikach wybierz minimalizację.
- Lista przydziału w rękach osoby rekrutującej albo koperty, które można prześwietlić lub otworzyć poza kolejnością.
- Analiza bez czynników warstwowania lub minimalizacji. Daje za szerokie przedziały ufności i mniejszą moc.
- Testy istotności różnic wyjściowych zamiast opisu grup i zaplanowanej korekty o ważne kowarianty.
Najczęstsze pytania
Dlaczego długość bloków powinna być losowa?
Bo przy stałej długości osoba, która ją zna i widzi wcześniejsze przydziały, wie, jaki będzie ostatni przydział w bloku. W naszej symulacji przy blokach po 4 dotyczyło to co trzeciego przydziału, a przy blokach losowo 4 albo 6 – 5%. Objaśnienia CONSORT 2025 zalecają dłuższe i losowo zmieniane bloki, zwłaszcza w badaniu niezaślepionym (Hopewell i in., 2025).
Kiedy zamiast randomizacji warstwowej wybrać minimalizację?
Gdy chcesz zrównoważyć więcej niż dwa–trzy czynniki albo próba jest mała. Każda warstwa kończy się niedomkniętym blokiem, a warstwowanie pomaga głównie w badaniach poniżej 400 osób i przy silnych czynnikach (Kernan i in., 1999). Minimalizacja równoważy każdy czynnik osobno, więc nie mnoży warstw (Pocock i Simon, 1975).
Czy badanie z minimalizacją można opisać jako randomizowane?
Objaśnienia CONSORT 2025 traktują badania z minimalizacją jako metodologicznie równoważne randomizowanym, choć sama metoda nie jest w pełni losowa. W opisie nazwij ją wprost, podaj czynniki i to, czy był element losowy, np. przydział ramienia minimalizującego z prawdopodobieństwem 0.8 (Hopewell i in., 2025).
Kto powinien przygotować listę przydziału i gdzie ją przechowywać?
Osoba niezwiązana z rekrutacją, np. statystyk spoza zespołu klinicznego. Listę i ziarno losowania trzyma poza zasięgiem osób włączających uczestników, a przydział odbywa się przez system centralny, telefon do niezależnej osoby lub aptekę. Bez tego nawet poprawną sekwencję można obejść (Schulz i Grimes, 2002).
Jak uwzględnić czynniki warstwowania i minimalizacji w analizie?
Jako kowarianty w modelu analizy głównej, np. w regresji lub ANCOVA. Pominięcie ich daje zawyżone błędy standardowe, za szerokie przedziały ufności i mniejszą moc (Kahan i Morris, 2012). Wpisz je do planu analizy przed zebraniem danych.
Powiązane hasła
Przeczytaj też
Badania kliniczne i pomiar przed i po – przewodnik
Osiem etapów badania z interwencją: schemat, etyka, błąd pomiaru, liczebność, ITT, ANCOVA, RCI i MCID oraz CONSORT – z linkami do każdego etapu.
Czytaj →PoradnikRandomizacja klastrowa – plan i analiza
ICC z przedziałem ufności, efekt schematu przy nierównych oddziałach, cztery analizy tych samych danych, poprawki df i raport CONSORT – z kodem R.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →Przygotowujesz protokół badania z randomizacją?
Pomożemy dobrać metodę przydziału, przygotować listę randomizacyjną i plan ukrycia przydziału, zaplanować analizę z czynnikami warstwowania i opisać wszystko zgodnie z CONSORT.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (1999). Statistics notes: How to randomise. BMJ, 319(7211), 703–704. https://doi.org/10.1136/bmj.319.7211.703 ● Otwarty dostęp
- Altman, D. G., & Bland, J. M. (2005). Treatment allocation by minimisation. BMJ, 330(7495), 843. https://doi.org/10.1136/bmj.330.7495.843 ● Otwarty dostęp
- Efird, J. (2011). Blocked randomization with randomly selected block sizes. International Journal of Environmental Research and Public Health, 8(1), 15–20. https://doi.org/10.3390/ijerph8010015 ● Otwarty dostęp
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials. BMJ, 389, Article e081124. https://doi.org/10.1136/bmj-2024-081124 ● Otwarty dostęp
- Kahan, B. C., & Morris, T. P. (2012). Improper analysis of trials randomised using stratified blocks or minimisation. Statistics in Medicine, 31(4), 328–340. https://doi.org/10.1002/sim.4431
- Kernan, W. N., Viscoli, C. M., Makuch, R. W., Brass, L. M., & Horwitz, R. I. (1999). Stratified randomization for clinical trials. Journal of Clinical Epidemiology, 52(1), 19–26. https://doi.org/10.1016/S0895-4356(98)00138-3 ● Otwarty dostęp
- Pocock, S. J., & Simon, R. (1975). Sequential treatment assignment with balancing for prognostic factors in the controlled clinical trial. Biometrics, 31(1), 103–115. https://doi.org/10.2307/2529712
- Schulz, K. F., & Grimes, D. A. (2002). Allocation concealment in randomised trials: Defending against deciphering. The Lancet, 359(9306), 614–618. https://doi.org/10.1016/s0140-6736(02)07750-4
- Scott, N. W., McPherson, G. C., Ramsay, C. R., & Campbell, M. K. (2002). The method of minimization for allocation to clinical trials: A review. Controlled Clinical Trials, 23(6), 662–674. https://doi.org/10.1016/s0197-2456(02)00242-8
Cytowania BibTeX
@article{altman1999how, author={Altman, Douglas G. and Bland, J. Martin}, title={{Statistics notes: How to randomise}}, journal={BMJ}, year={1999}, volume={319}, number={7211}, pages={703--704}, doi={10.1136/bmj.319.7211.703}}@article{altman2005treatment, author={Altman, Douglas G. and Bland, J. Martin}, title={{Treatment allocation by minimisation}}, journal={BMJ}, year={2005}, volume={330}, number={7495}, pages={843}, doi={10.1136/bmj.330.7495.843}}@article{efird2011blocked, author={Efird, Jimmy}, title={{Blocked randomization with randomly selected block sizes}}, journal={International Journal of Environmental Research and Public Health}, year={2011}, volume={8}, number={1}, pages={15--20}, doi={10.3390/ijerph8010015}}@article{hopewell2025consort, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081124}, doi={10.1136/bmj-2024-081124}}@article{kahan2012improper, author={Kahan, Brennan C. and Morris, Tim P.}, title={{Improper analysis of trials randomised using stratified blocks or minimisation}}, journal={Statistics in Medicine}, year={2012}, volume={31}, number={4}, pages={328--340}, doi={10.1002/sim.4431}}@article{kernan1999stratified, author={Kernan, Walter N. and Viscoli, Catherine M. and Makuch, Robert W. and Brass, Lawrence M. and Horwitz, Ralph I.}, title={{Stratified randomization for clinical trials}}, journal={Journal of Clinical Epidemiology}, year={1999}, volume={52}, number={1}, pages={19--26}, doi={10.1016/s0895-4356(98)00138-3}}@article{pocock1975sequential, author={Pocock, Stuart J. and Simon, Richard}, title={{Sequential treatment assignment with balancing for prognostic factors in the controlled clinical trial}}, journal={Biometrics}, year={1975}, volume={31}, number={1}, pages={103--115}, doi={10.2307/2529712}}@article{schulz2002allocation, author={Schulz, Kenneth F. and Grimes, David A.}, title={{Allocation concealment in randomised trials: Defending against deciphering}}, journal={The Lancet}, year={2002}, volume={359}, number={9306}, pages={614--618}, doi={10.1016/s0140-6736(02)07750-4}}@article{scott2002method, author={Scott, Neil W. and McPherson, Gladys C. and Ramsay, Craig R. and Campbell, Marion K.}, title={{The method of minimization for allocation to clinical trials: A review}}, journal={Controlled Clinical Trials}, year={2002}, volume={23}, number={6}, pages={662--674}, doi={10.1016/s0197-2456(02)00242-8}}