Co to jest analiza ITT?
Analiza zgodna z zamiarem leczenia (ang. intention-to-treat, ITT) obejmuje każdą zrandomizowaną osobę w grupie, do której ją przydzielono, niezależnie od tego, czy ukończyła interwencję, przestrzegała zaleceń albo wycofała się z badania (Gupta, 2011). Analiza per protocol (PP) obejmuje tylko osoby, które przeszły interwencję zgodnie z protokołem.
Dlaczego ITT jest analizą główną
Randomizacja tworzy grupy porównywalne na starcie. Osoby, które przerywają interwencję, zwykle różnią się od tych, które ją kończą, więc po ich usunięciu grupy przestają być porównywalne. ITT zachowuje równowagę z losowania i daje zwykle ostrożniejszą ocenę efektu (Gupta, 2011). Odpowiada na pytanie praktyczne: co daje zaproponowanie programu ludziom, a nie tylko tym, którzy wytrwali (Hollis i Campbell, 1999).
Przykład
200 osób z lękiem losowo przydzielono do 8-tygodniowego programu online albo na listę oczekujących, po 100 osób. Program przerwało 18 osób, a lęk po 8 tygodniach (0–21 pkt) zmierzono u wszystkich (dane symulowane). Według ITT grupa programu miała wynik niższy o 2.72 pkt, 95% CI [1.69, 3.75], t(198) = 5.21, p < .001. Analiza PP bez 18 osób dała 3.59 pkt, 95% CI [2.56, 4.61]. Różnica bierze się stąd, że program przerywały osoby z wyższym lękiem na starcie (13.58 wobec 11.30 pkt), więc PP przecenia efekt.
Jak opisać w pracy
Lista CONSORT wymaga, by dla każdej grupy podać liczbę osób w każdej analizie i to, czy analizowano je według pierwotnego przydziału (Schulz i in., 2010). Więcej o raportowaniu badań interwencji piszemy w poradnikach statystyka dla fizjoterapeuty i statystyka dla lekarza.
Na rysunku
Scenariusz z przykładu powtórzono 1000 razy. Każde badanie ma 100 osób w ramieniu, program obniża lęk o 3 pkt u osób, które go ukończyły, a przerywają go częściej osoby z silniejszym lękiem na starcie. Ziarno 12121 ustalono raz.
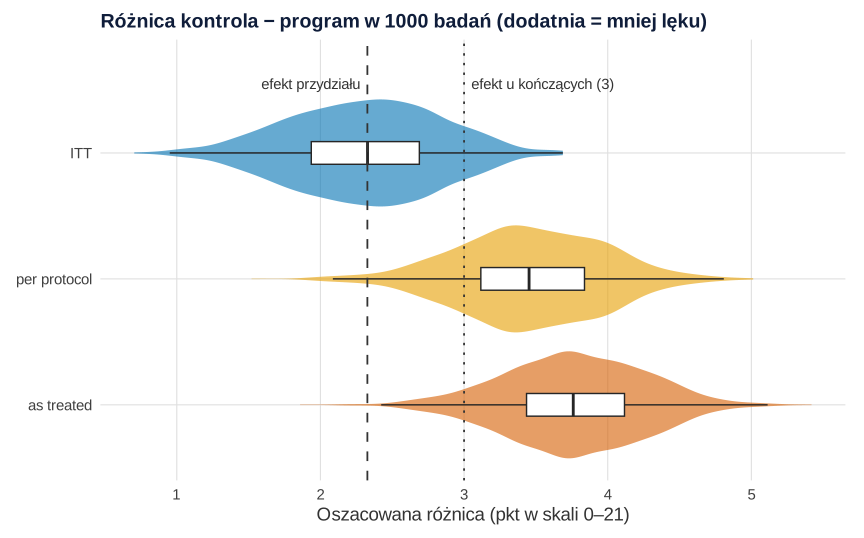
set.seed(12121)).Co widać. Program ukończyło średnio 77.6% osób, więc efekt samego przydziału do programu wynosi 3 × 0.776 = 2.33 pkt. ITT trafia w tę wartość: średnie oszacowanie to 2.31 pkt (błąd Monte Carlo 0.017). Per protocol (3.46 pkt) i as treated (3.77 pkt) przeceniają efekt. Zawyżają nawet efekt u osób, które program ukończyły (3 pkt), bo porównują te osoby, mające niższy lęk na starcie, z całą grupą kontrolną. Rozrzut oszacowań jest we wszystkich trzech analizach podobny (SD około 0.5), więc PP nie zyskuje precyzji, a traci trafność.
Na co uważać. ITT odpowiada na pytanie, co daje zaproponowanie programu. Efekt u osób, które go przyjęły, wymaga innych metod niż proste wykluczenie przerywających (zob. analiza per protocol). Symulacja zakłada, że wynik zmierzono u wszystkich. Gdy brakuje danych osób, które przerwały, ITT też może być obciążona. Jak czytać kształt rozkładu, wyjaśnia hasło wykres skrzypcowy.
Podpis do pracy:
Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Oszacowania efektu programu w 1000 symulowanych badaniach: ITT, per protocol i as treated
# (scenariusz jak w przykładzie w haśle: 100 osób w ramieniu, program skraca lęk o 3 pkt u osób, które go ukończyły,
#  a przerywają go częściej osoby z silniejszym lękiem na starcie)
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c("ITT" = "#0072B2", "per protocol" = "#E69F00", "as treated" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

n <- 100; R <- 1000
jedno <- function() {
  grupa <- rep(c("program", "kontrola"), each = n)
  start <- rnorm(2 * n, 12, 3)
  ukonczyl <- ifelse(grupa == "program", rbinom(2 * n, 1, 1 - plogis(-1.5 + 0.35 * (start - 12))), 1)
  wynik <- 2 + 0.8 * start - 3 * (grupa == "program" & ukonczyl == 1) + rnorm(2 * n, 0, 2.5)
  przerwal <- grupa == "program" & ukonczyl == 0
  otrzymal <- ifelse(grupa == "program" & !przerwal, "program", "kontrola")
  roz <- function(w, g) mean(w[g == "kontrola"]) - mean(w[g == "program"])   # kontrola − program (dodatnia = korzyść)
  c("ITT" = roz(wynik, grupa), "per protocol" = roz(wynik[!przerwal], grupa[!przerwal]),
    "as treated" = roz(wynik, otrzymal), ukonczylo = mean(ukonczyl[grupa == "program"]))
}
set.seed(12121)                                      # ziarno ustalone raz
sym <- t(replicate(R, jedno()))

# Dwie „prawdziwe” wartości: efekt przydziału (to szacuje ITT) i efekt u osób, które ukończyły program (3 pkt)
efekt_przydzialu <- 3 * mean(sym[, "ukonczylo"])
round(c(odsetek_ukonczenia = mean(sym[, "ukonczylo"]), efekt_przydzialu = efekt_przydzialu, efekt_u_konczacych = 3), 3)
tab <- data.frame(analiza = names(kol), srednia = colMeans(sym[, 1:3]), SD = apply(sym[, 1:3], 2, sd))
tab$bladMC <- tab$SD / sqrt(R)
print(transform(tab, srednia = round(srednia, 2), SD = round(SD, 2), bladMC = round(bladMC, 3)), row.names = FALSE)

dl <- data.frame(analiza = factor(rep(names(kol), each = R), rev(names(kol))), oszacowanie = c(sym[, 1:3]))
p <- ggplot(dl, aes(oszacowanie, analiza, fill = analiza)) +
  geom_violin(colour = NA, alpha = 0.6, scale = "width", width = 0.85) +
  geom_boxplot(width = 0.18, fill = "white", colour = "grey15", outlier.shape = NA, linewidth = 0.5) +
  geom_vline(xintercept = efekt_przydzialu, linetype = "dashed", colour = "grey20") +
  geom_vline(xintercept = 3, linetype = "dotted", colour = "grey20") +
  annotate("text", x = efekt_przydzialu - 0.05, y = 3.55, label = "efekt przydziału", hjust = 1, size = 3.9, colour = "grey20") +
  annotate("text", x = 3.05, y = 3.55, label = "efekt u kończących (3)", hjust = 0, size = 3.9, colour = "grey20") +
  scale_fill_manual(values = kol, guide = "none") +
  scale_y_discrete(expand = expansion(add = c(0.6, 0.9))) +
  labs(title = "Różnica kontrola − program w 1000 badań (dodatnia = mniej lęku)",
       x = "Oszacowana różnica (pkt w skali 0–21)", y = NULL) +
  motyw
p
Wynik w R
odsetek_ukonczenia   efekt_przydzialu efekt_u_konczacych
             0.776              2.327              3.000
      analiza srednia   SD bladMC
          ITT    2.31 0.53  0.017
 per protocol    3.46 0.52  0.016
   as treated    3.77 0.50  0.016
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats). Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Na co uważać
- ITT tylko z nazwy. Hollis i Campbell (1999) znaleźli raporty, które deklarowały ITT, a wykluczały osoby, które nie zaczęły interwencji.
- Braki danych. Pełna ITT wymaga wyniku od wszystkich. Mierz wynik także u osób, które przerwały, a brakujące wartości uzupełniaj przemyślaną metodą (zob. braki danych i imputacja wielokrotna w R).
- Per protocol pokaż jako analizę dodatkową, nie zamiast ITT.
Najczęstsze pytania
Czym różni się analiza ITT od per protocol?
ITT analizuje wszystkich zrandomizowanych w grupach z losowania. Per protocol obejmuje tylko osoby, które przeszły interwencję zgodnie z planem, więc grupy mogą przestać być porównywalne.
Dlaczego analiza per protocol często pokazuje większy efekt?
Bo interwencję częściej przerywają osoby z gorszym rokowaniem. Po ich usunięciu w grupie interwencji zostają ci, którym i tak szło lepiej, a grupa kontrolna pozostaje kompletna.
Co zrobić w analizie ITT, gdy brakuje wyników osób, które odpadły?
Najpierw postaraj się zmierzyć wynik u wszystkich. Pozostałe braki uzupełnij metodą dopasowaną do mechanizmu braków, np. imputacją wielokrotną, i opisz to w pracy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wykluczanie respondentów w eksperymencie
Pytania kontrolne przed i po bodźcu, czas wypełniania, przerwania i granice Lee: które wykluczenia zachowują losowe porównanie.
Czytaj →PoradnikEstymanda w badaniu klinicznym (ICH E9)
Leczenie ratunkowe i inne zdarzenia współwystępujące: pięć strategii, MMRM, imputacja i wynik złożony w R oraz opis estymandy w protokole.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikStatystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →PoradnikStatystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Gupta, S. K. (2011). Intention-to-treat concept: A review. Perspectives in Clinical Research, 2(3), 109–112. https://doi.org/10.4103/2229-3485.83221 ● Otwarty dostęp
- Hollis, S., & Campbell, F. (1999). What is meant by intention to treat analysis? Survey of published randomised controlled trials. BMJ, 319(7211), 670–674. https://doi.org/10.1136/bmj.319.7211.670 ● Otwarty dostęp
- Schulz, K. F., Altman, D. G., Moher, D., & CONSORT Group. (2010). CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, Article c332. https://doi.org/10.1136/bmj.c332 ● Otwarty dostęp
Cytowania BibTeX
@article{gupta2011intention, author={Gupta, Sandeep K.}, title={{Intention-to-treat concept: A review}}, journal={Perspectives in Clinical Research}, year={2011}, volume={2}, number={3}, pages={109--112}, doi={10.4103/2229-3485.83221}}@article{hollis1999what, author={Hollis, S. and Campbell, F.}, title={{What is meant by intention to treat analysis? Survey of published randomised controlled trials}}, journal={BMJ}, year={1999}, volume={319}, number={7211}, pages={670--674}, doi={10.1136/bmj.319.7211.670}}@article{schulz2010consort, author={Schulz, Kenneth F. and Altman, Douglas G. and Moher, David and {CONSORT Group}}, title={{CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials}}, journal={BMJ}, year={2010}, volume={340}, eid={c332}, doi={10.1136/bmj.c332}}