Badanie przed i po z grupą kontrolną: jedno pytanie, kilka analiz
Najczęstszy plan badania interwencyjnego w psychologii, pedagogice i naukach o zdrowiu wygląda tak samo: dwie grupy, pomiar przed interwencją (pretest, pomiar wyjściowy) i pomiar po niej (posttest). Jedna grupa dostaje program, druga trafia na listę oczekujących albo dostaje standardową opiekę. To klasyczny schemat eksperymentalny z grupą kontrolną, a jeśli o przydziale decyduje losowanie – randomizowane badanie kontrolowane (RCT).
Pytanie badawcze jest proste: o ile wynik po interwencji różni się między grupami u osób, które na starcie były takie same? Kłopot polega na tym, że to samo pytanie można przełożyć na co najmniej cztery analizy: ANOVA w schemacie mieszanym z interakcją czas × grupa, test na różnicach wyników (ang. change scores), ANCOVA z pomiarem wyjściowym jako kowariantem albo model mieszany na danych długich. W recenzjach artykułów wybór między nimi wraca bardzo często, a odpowiedź „wszystkie są dobre” jest tylko częściowo prawdziwa.
W tym wpisie liczymy wszystkie cztery strategie na jednym zbiorze danych i pokazujemy, skąd biorą się różnice w wynikach. Wyjaśniamy, dlaczego w badaniu randomizowanym ANCOVA ma zwykle największą moc i dlaczego w grupach nierandomizowanych ta sama ANCOVA może wprowadzić w błąd (paradoks Lorda). Potem sprawdzamy założenia, liczymy średnie skorygowane z przedziałami ufności i wielkość efektu, a na końcu dajemy wzór opisu wyników. Jeśli Twoje badanie ma jedną grupę albo dotyczy skal bólu w fizjoterapii, zacznij od wpisu statystyka w pracy z fizjoterapii. Tam jest prostszy przykład z testem dla prób zależnych. Tutaj zakładamy dwie grupy i perspektywę autora artykułu, który musi obronić wybór analizy przed recenzentem.
Przykład: program redukcji lęku egzaminacyjnego
Studenci zgłaszający wysoki lęk przed sesją (N = 128) zostali losowo przydzieleni do sześciotygodniowego programu grupowego (n = 64) albo na listę oczekujących (n = 64). Lęk egzaminacyjny mierzono kwestionariuszem z 10 pozycjami ocenianymi na skali 1–5 (wynik 10–50, wyższy oznacza silniejszy lęk), tydzień przed rozpoczęciem programu i tydzień po jego zakończeniu. Dane są symulowane (set.seed(5050)), a w populacji program obniża lęk średnio o 4 pkt. Zbiór możesz pobrać jako plik CSV (128 wierszy, kolumny id, grupa, pre, post) i powtórzyć wszystkie analizy z kodem z sekcji Przykład w R.
| Grupa | n | Przed: M (SD) | Po: M (SD) | Zmiana: M (SD) |
|---|---|---|---|---|
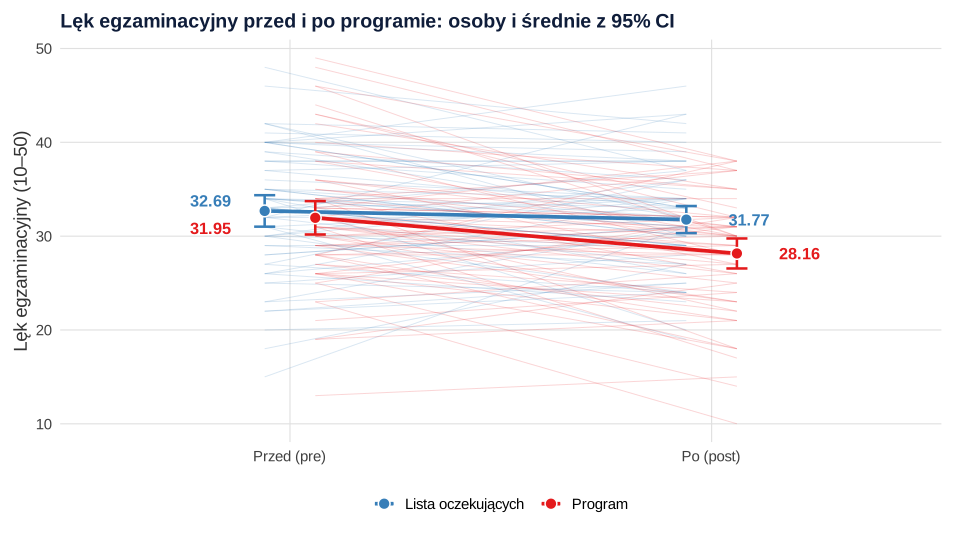
| Lista oczekujących | 64 | 32.69 (6.71) | 31.77 (5.78) | −0.92 (5.65) |
| Program | 64 | 31.95 (7.12) | 28.16 (6.40) | −3.80 (5.88) |
Korelacja pomiaru przed i po wynosi w całej próbie r = .60 (w grupach .60 i .63). Ta jedna liczba zdecyduje za chwilę o tym, która analiza ma największą moc. Zwróć też uwagę na drobny szczegół: mimo losowego przydziału grupa kontrolna zaczęła z lękiem wyższym o niespełna 1 pkt (32.69 wobec 31.95). Taka przypadkowa nierównowaga zdarza się w każdym RCT i – jak zobaczysz – różne analizy traktują ją inaczej.
Cztery strategie na tych samych danych
Strategia 0: same wyniki po interwencji
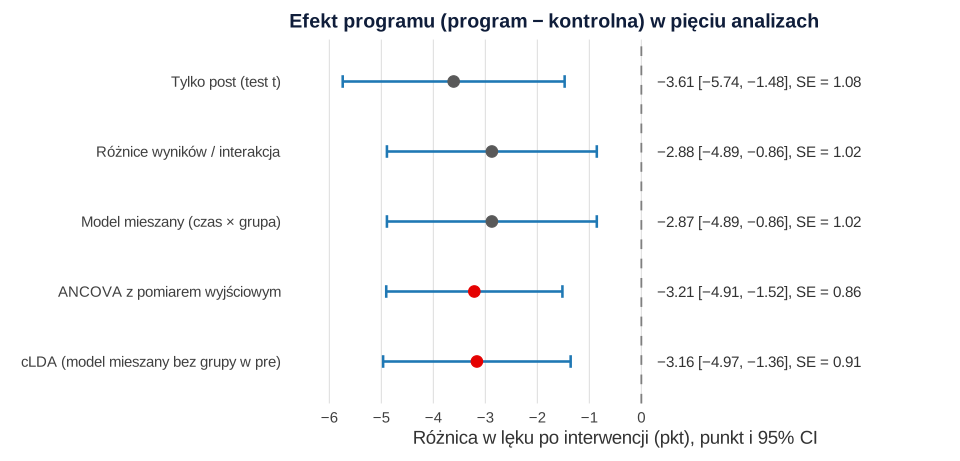
Punkt odniesienia to zwykły test t dla prób niezależnych na wynikach po interwencji, który pomija pomiar wyjściowy. Różnica średnich (program − kontrolna) wynosi −3.61 pkt, 95% CI [−5.74, −1.48], t(126) = 3.35, p = .001. W RCT to oszacowanie jest nieobciążone, bo losowanie wyrównuje grupy w oczekiwaniu. Jest jednak mało precyzyjne, a w tej konkretnej próbie część różnicy wynika z tego, że grupa kontrolna zaczynała wyżej.
Strategia 1: ANOVA mieszana i interakcja czas × grupa
W dwuczynnikowej ANOVA z jednym czynnikiem międzyobiektowym (grupa) i jednym wewnątrzobiektowym (czas) efekt programu to interakcja: czy zmiana od pre do post różni się między grupami. Wynik: F(1, 126) = 7.95, p = .006, η²p = .06. Efekt główny czasu (F(1, 126) = 21.41, p < .001) mówi tylko, że lęk spadł średnio w całej próbie. Efekt główny grupy (F(1, 126) = 4.41, p = .038) uśrednia pomiar przed i po, więc nie jest efektem programu i nie należy go tak interpretować. Szczegóły tej analizy, w tym sferyczność przy więcej niż dwóch pomiarach, opisuje hasło ANOVA z powtarzanymi pomiarami.
Strategia 2: różnice wyników (change scores)
Dla każdej osoby liczysz zmianę post − pre i porównujesz średnie zmiany testem t. Różnica średnich zmian wynosi −2.88 pkt, 95% CI [−4.89, −0.86], t(126) = 2.82, p = .006. Zwróć uwagę na p: jest identyczne jak dla interakcji w ANOVA mieszanej, bo przy dwóch pomiarach to ta sama analiza (2.82² = 7.95, czyli F = t²). Interakcja czas × grupa w schemacie 2 × 2 to test na różnicach wyników – raportowanie obu jako „dwóch niezależnych potwierdzeń” jest błędem.
Strategia 3: ANCOVA z pomiarem wyjściowym
ANCOVA modeluje wynik po interwencji, a pomiar wyjściowy traktuje jak predyktor w regresji liniowej: post ~ pre + grupa. Współczynnik przy pre wynosi b = 0.54, 95% CI [0.42, 0.66], a skorygowana różnica między grupami −3.21 pkt, 95% CI [−4.91, −1.52], t(125) = −3.75, p < .001. Przedział jest węższy niż w obu poprzednich analizach (błąd standardowy 0.86 wobec 1.02 i 1.08).
Ten wzór porządkuje wszystkie trzy wyniki. Różnica w pretescie (program − kontrolna) wynosi −0.73 pkt. Sam posttest jej nie koryguje: −3.61. Analiza zmian odejmuje ją w całości: −3.61 − (−0.73) = −2.88. ANCOVA odejmuje tylko tyle, ile wynika z rzeczywistego związku pre z post w danych: −3.61 − 0.54 × (−0.73) = −3.21. Analiza zmian zakłada więc, że nachylenie wynosi 1, czyli że każdy punkt przewagi na starcie przenosi się w całości na wynik końcowy. Przy korelacji .60 tak nie jest – część różnicy wyjściowej „rozpływa się” przez regresję do średniej – i dlatego Clifton i Clifton (2019) pokazują, że analiza zmian nie rozwiązuje ani problemu regresji do średniej, ani nierównowagi wyjściowej.
Strategia 4: model mieszany na danych długich
Model mieszany wymaga danych w formacie długim (dwa wiersze na osobę) i losowego wyrazu wolnego dla osoby (zob. efekty stałe i losowe). Model lek ~ czas * grupa + (1 | id) daje dla interakcji −2.87 pkt, SE = 1.02, p = .006 – przy kompletnych danych to znowu analiza zmian w innym opakowaniu. Lepszy w RCT jest wariant, który pomija efekt główny grupy, a zostawia czas i interakcję czas × grupa. Taki model narzuca równość średnich wyjściowych w obu grupach, co w RCT wynika z losowania. To ograniczona analiza podłużna (ang. constrained longitudinal data analysis, cLDA), zaproponowana przez Lianga i Zegera, której efektywność względem podłużnej ANCOVA analizował Lu (2010). W przykładzie daje −3.16 pkt, 95% CI [−4.97, −1.36], p = .001, czyli prawie to samo co ANCOVA. Lu (2010) pokazał, że przewaga cLDA rośnie wraz z liczbą osób, którym brakuje pomiaru wyjściowego albo wszystkich pomiarów po randomizacji: takie osoby nadal wnoszą do modelu informację, której ANCOVA nie wykorzysta. Porównanie ANOVA z modelem mieszanym przy wielu pomiarach i odpadaniu z badania znajdziesz we wpisie ANOVA z powtarzanymi pomiarami czy model mieszany.
| Analiza | Różnica (pkt) | SE | 95% CI | p |
|---|---|---|---|---|
| Tylko post (test t) | −3.61 | 1.08 | [−5.74, −1.48] | .001 |
| Różnice wyników = interakcja w ANOVA mieszanej | −2.88 | 1.02 | [−4.89, −0.86] | .006 |
| Model mieszany (czas × grupa) | −2.87 | 1.02 | [−4.89, −0.86] | .006 |
| ANCOVA z pomiarem wyjściowym | −3.21 | 0.86 | [−4.91, −1.52] | < .001 |
| cLDA (model mieszany bez efektu grupy w pretescie) | −3.16 | 0.91 | [−4.97, −1.36] | .001 |
Dlaczego ANCOVA ma zwykle największą moc w RCT
Wszystkie trzy podstawowe analizy szacują w RCT ten sam efekt bez obciążenia. Różnią się precyzją. Jeśli pretest i posttest mają podobne odchylenie standardowe σ i korelację ρ, wariancja wyniku, który porównujesz między grupami, wynosi:
- tylko post: σ²;
- różnice wyników: 2σ²(1 − ρ);
- ANCOVA (wariancja reszt): σ²(1 − ρ²).
Analiza zmian jest więc lepsza od samego posttestu tylko wtedy, gdy ρ > .50. Przy słabszej korelacji odejmowanie pretestu dodaje więcej szumu, niż usuwa. Vickers i Altman (2001) zwracają uwagę właśnie na to, że wybór między tymi dwiema prostymi analizami zależy od korelacji pomiarów. ANCOVA nigdy nie przegrywa z żadną z nich (pomijając jeden stopień swobody), bo sama szacuje optymalną wagę pretestu. Van Breukelen (2006) potwierdza, że w badaniach randomizowanych obie metody są nieobciążone, ale ANCOVA ma większą moc. Egbewale i in. (2014) pokazali w symulacji, że przy przypadkowej nierównowadze wyjściowej ANCOVA daje też bardziej precyzyjne oszacowania niż ANOVA wyników końcowych i analiza zmian.
Na moc testu przekłada się to wprost. W symulacji (64 + 64 osoby, prawdziwy efekt −3 pkt przy SD = 7, czyli d ≈ 0.43, po 2000 powtórzeń) przy korelacji .60 ANCOVA wykrywała efekt w 84.6% badań, analiza zmian w 76.0%, a sam posttest w 66.3%. Przy korelacji 0 analiza zmian traci prawie połowę mocy (37.8% wobec 64.9% w ANCOVA).
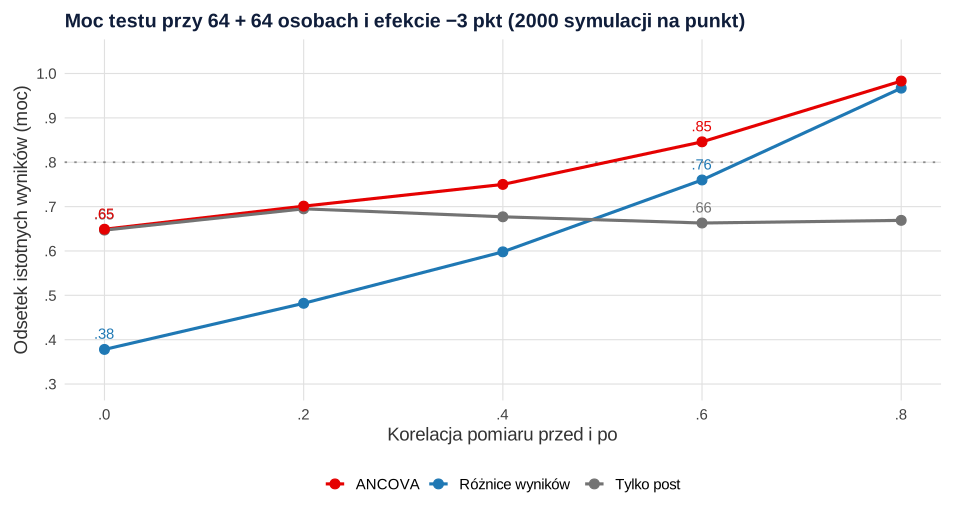
Ma to konsekwencje już na etapie planowania. Jeśli z pilotażu albo literatury znasz korelację pre–post, wpisz do analizy liczebności próby wariancję reszt z ANCOVA, a nie wariancję posttestu. Przy ρ = .60 potrzebujesz wtedy mniej więcej o jedną trzecią mniej osób niż do samego porównania wyników końcowych (1 − .60² = .64). Analizę główną zapisz z góry w planie analizy statystycznej: wybór między ANCOVA a analizą zmian po obejrzeniu wyników to klasyczna furtka dla p-hackingu.
Jeszcze jedna uwaga o nierównowadze wyjściowej. Nie testuj istotności różnic między grupami w pretescie, żeby zdecydować, czy „trzeba” użyć ANCOVA. W RCT każda różnica wyjściowa jest z definicji przypadkowa, a wytyczne CONSORT 2010 opisują tabelę charakterystyk wyjściowych jako opis grup, nie jako zestaw testów (Schulz i in., 2010). Pretest uwzględniasz w modelu, bo zwiększa precyzję, a nie dlatego, że różnica okazała się istotna.
Grupy nierandomizowane: paradoks Lorda
Wszystko, co powyżej, dotyczy losowego przydziału. W schemacie quasi-eksperymentalnym grupy często różnią się na starcie nie przez przypadek, lecz systematycznie: program wdrożono w jednej szkole, na jednym oddziale, na jednym wydziale. Lord (1967) opisał paradoks, który wtedy powstaje. Analiza zmian i ANCOVA, zastosowane do tych samych danych, mogą dać sprzeczne wnioski i żadna statystyka nie rozstrzygnie, która ma rację.
Symulacja pokazuje to wprost. Na dwóch wydziałach (po 150 osób) poziom lęku jest stały, a pomiar przed i po różni się tylko błędem pomiaru. Nikt się nie zmienia i program nie działa. Wydział A ma jednak średnio wyższy lęk (pre: M = 35.07) niż wydział B (pre: M = 28.07), na którym wdrożono program. Analiza zmian daje poprawny wynik: różnica średnich zmian wynosi 0.02 pkt, t(298) = −0.03, p = .975. ANCOVA „znajduje” natomiast efekt programu: −3.02 pkt, 95% CI [−4.46, −1.58], p < .001.
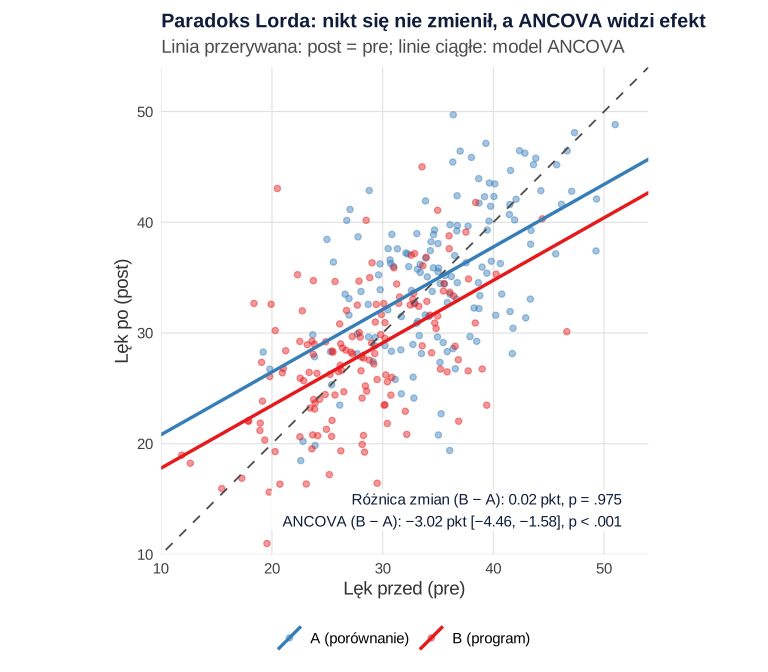
Skąd ta rozbieżność? ANCOVA porównuje osoby o tym samym wyniku wyjściowym. Osoba z wydziału B, która w pretescie uzyskała 35 pkt, ma wynik wyższy niż typowy dla swojego wydziału, więc w posttescie „wraca” w stronę średniej wydziału B. Osoba z wydziału A z tym samym wynikiem jest blisko średniej swojej grupy i zostaje na miejscu. ANCOVA odczytuje tę różnicę w regresji do średniej jako efekt grupy. Zakłada bowiem, że po wyrównaniu pretestu grupy nie różnią się niczym innym, a tu różnią się prawdziwym poziomem lęku, który pretest mierzy z błędem. Van Breukelen (2006) ujmuje to tak: w badaniach nierandomizowanych ANCOVA zakłada brak różnic wyjściowych, a obie metody mogą dawać sprzeczne wyniki.
Odwrotny przypadek też istnieje. Wright (2006) pokazuje w symulacjach, że ANCOVA jest właściwa, gdy przydział do grup zależy od samego wyniku wyjściowego (np. do programu kwalifikuje się każdy z wynikiem powyżej progu). Analiza zmian bywa właściwa, gdy przydział jest z wynikiem wyjściowym związany, ale nie przyczynowo. Często żadna z nich nie wystarcza. Senn (2006) dodaje, że trudno wskazać realistyczną sytuację, w której ANCOVA byłaby obciążona, a prosta analiza zmian nie i dawała podstawę do wniosku przyczynowego. Miller i Chapman (2001) przestrzegają przed traktowaniem ANCOVA jako sposobu na „wyrównanie” grup, które naprawdę różnią się kowariantem.
Wniosek praktyczny: w quasi-eksperymencie wybór analizy wynika z założeń o tym, jak powstały grupy, a nie z danych. Opisz mechanizm przydziału, pokaż wykres rozrzutu pre–post dla obu grup, raportuj obie analizy jako analizę wrażliwości i ostrożnie formułuj wnioski przyczynowe (zob. zmienna zakłócająca i trafność wewnętrzna). Gdy masz kilka pomiarów przed interwencją albo dane z wielu jednostek, lepszym narzędziem bywa metoda opisana we wpisie quasi-eksperyment i różnica w różnicach (DiD).
Założenia ANCOVA i jak je sprawdzić
ANCOVA to model liniowy, więc obowiązują założenia regresji. Dochodzą do nich dwa warunki dotyczące kowariantu. W przykładzie żadne z założeń nie budzi zastrzeżeń:
- Niezależność obserwacji. Wynika z planu badania. Jeśli program prowadzono w grupach terapeutycznych albo w klasach, osoby z jednej grupy nie są niezależne i potrzebny jest model wielopoziomowy (zob. model wielopoziomowy krok po kroku).
- Kowariant zmierzony przed interwencją. Pomiar wyjściowy nie może zależeć od przydziału. Kowariant zmierzony po interwencji (np. motywacja na końcu programu) może sam być skutkiem programu i jego kontrolowanie zniekształca efekt.
- Liniowość związku pre–post. Obejrzyj wykres rozrzutu albo dodaj do modelu człon kwadratowy. W przykładzie nie poprawia on dopasowania: F(1, 124) = 0.03, p = .854.
- Homogeniczność nachyleń regresji. Związek pre z post powinien być podobny w obu grupach. Sprawdzasz to, dodając interakcję pre × grupa: F(1, 124) = 0.14, p = .710; nachylenia wynoszą 0.52 w grupie kontrolnej i 0.56 w grupie programu.
- Równość wariancji reszt w grupach. Test Levene’a na resztach: F(1, 126) = 0.07, p = .788; SD reszt 4.63 i 4.99 (zob. homogeniczność wariancji).
- Rozkład reszt zbliżony do normalnego. Oceń go na wykresie Q-Q reszt. Test Shapiro–Wilka daje tu W = .99, p = .192, ale przy dużych próbach nie traktuj go jak wyroczni.
Co, jeśli nachylenia się różnią? Wtedy efekt programu zależy od poziomu wyjściowego i jedna liczba go nie opisuje. Zostaw interakcję w modelu, wycentruj pretest i opisz efekt programu dla kilku wartości wyjściowych, tak jak w analizie moderacji. Pamiętaj przy tym, że test interakcji ma zwykle małą moc. Jego nieistotność nie dowodzi równości nachyleń, a założenie warto przemyśleć na podstawie teorii, zanim zobaczysz dane. Na koniec rzetelność: błąd pomiaru kowariantu osłabia korektę. W RCT obniża to tylko precyzję, ale w grupach nierandomizowanych to źródło paradoksu Lorda.
Średnie skorygowane z CI i wielkość efektu
Średnie skorygowane (ang. estimated marginal means) to przewidywane wyniki po interwencji dla obu grup przy tej samej wartości pretestu, zwykle przy średniej z całej próby (tu 32.32). W przykładzie wynoszą 31.57, 95% CI [30.37, 32.76] na liście oczekujących i 28.35, 95% CI [27.16, 29.55] w grupie programu. Ich różnica to dokładnie współczynnik grupy z ANCOVA: −3.21 pkt. W tabeli wyników pokaż zarówno surowe średnie przed i po, jak i średnie skorygowane, bo czytelnik musi widzieć, skąd się wzięła korekta.
Wielkość efektu możesz podać na trzy sposoby; wybierz jeden jako główny i nazwij go dokładnie:
- Cząstkowe η² dla grupy z ANCOVA: η²p = .10, 90% CI [.03, .19]. To udział wariancji wyjaśnionej przez grupę po odjęciu wariancji związanej z pretestem, więc nie porównuj go wprost z η² z badań bez kowariantu (zob. eta kwadrat).
- Standaryzowana różnica skorygowana: różnica średnich skorygowanych podzielona przez zbiorcze SD wyników po interwencji (6.10). Daje d = −0.53, przybliżony 95% CI [−0.80, −0.25] (granice przedziału dla różnicy podzielone przez to samo SD). W mianowniku użyj SD wyniku, a nie SD reszt z ANCOVA, bo ta druga sztucznie zawyża efekt, im wyższa korelacja pre–post (zob. d Cohena).
- dppc2 Morrisa: różnica średnich zmian podzielona przez zbiorcze SD pretestu (6.92), z poprawką na małą próbę. Daje −0.41. Morris (2008) porównał trzy miary dla schematu z pretestem, posttestem i grupą kontrolną i ta wypadła najlepiej pod względem obciążenia i precyzji, więc warto ją podać z myślą o przyszłych metaanalizach.
Różnica między −0.53 a −0.41 nie jest błędem. Pierwsza miara opiera się na korekcie z ANCOVA (−3.21 pkt), druga na różnicy zmian (−2.88 pkt) i innym mianowniku. Dlatego w raporcie zawsze podaj, co jest w liczniku i w mianowniku. Ogólne zasady opisu efektów zebraliśmy w haśle standaryzowana różnica średnich.
Wzór raportu
W części „Metoda” podaj, jak przydzielano osoby do grup, który pomiar jest wynikiem głównym, jaką analizę zaplanowano jako główną i jak postąpiono z brakami danych (zob. analiza ITT). Wytyczne CONSORT 2010 opisują pełną listę elementów raportu randomizowanego badania w grupach równoległych (Schulz i in., 2010).
Tabela 1
Lęk egzaminacyjny przed i po interwencji oraz średnie skorygowane w ANCOVA
| Grupa | n | Przed M (SD) | Po M (SD) | Po Mskor [95% CI] |
|---|---|---|---|---|
| Lista oczekujących | 64 | 32.69 (6.71) | 31.77 (5.78) | 31.57 [30.37, 32.76] |
| Program | 64 | 31.95 (7.12) | 28.16 (6.40) | 28.35 [27.16, 29.55] |
Uwaga. N = 128. Lęk egzaminacyjny: wynik 10–50, wyższy oznacza silniejszy lęk. Mskor = średnia skorygowana przy średnim wyniku wyjściowym (32.32). ANCOVA: F(1, 125) = 14.08, p < .001, η²p = .10; skorygowana różnica = −3.21, 95% CI [−4.91, −1.52]. CI = przedział ufności. Dane symulowane.
Więcej wzorów zdań do innych analiz znajdziesz we wpisie jak opisać wyniki w stylu APA. Jeśli recenzent pyta, dlaczego nie użyto ANOVA mieszanej, odpowiedź masz w sekcji o mocy: przy dwóch pomiarach interakcja to analiza zmian, a ANCOVA jest w RCT co najmniej tak samo nieobciążona i bardziej precyzyjna. Gdy potrzebujesz kogoś, kto sprawdzi plan analizy albo przygotuje odpowiedź na takie uwagi, zobacz, jak wygląda współpraca przy analizach dla badaczy.
ANCOVA i ANOVA mieszana w SPSS
Według dokumentacji IBM SPSS Statistics (IBM, b.d.) ANCOVA uruchomisz w oknie Analyze > General Linear Model > Univariate: wynik po interwencji wpisz jako zmienną zależną, grupę jako czynnik stały, a wynik wyjściowy jako kowariant. ANOVA w schemacie mieszanym to Analyze > General Linear Model > Repeated Measures z czynnikiem wewnątrzobiektowym czas (dwa poziomy) i grupą jako czynnikiem międzyobiektowym. W tej procedurze efekt programu odczytujesz z wiersza interakcji, a nie z efektu głównego grupy. Ogólne wskazówki, jak przepisać wydruk do tekstu, są we wpisie jak czytać wyniki z SPSS.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji (drugi korzysta z obiektów pierwszego). Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z pokazanych wyników. Pierwszy przepis zapisuje też plik ancova-przed-po-dane.csv, który możesz pobrać tutaj.
1. Dane i cztery strategie analizy
R
# Dane symulowane: randomizowane badanie interwencyjne (RCT), 6-tygodniowy program redukcji lęku egzaminacyjnego
# w porównaniu z listą oczekujących; lęk egzaminacyjny (10 pozycji 1–5, wynik 10–50) przed (pre) i po (post); N = 128
library(afex)       # aov_ez(): ANOVA w schemacie mieszanym
library(emmeans)    # średnie skorygowane i kontrasty
library(lmerTest)   # lmer(): model mieszany z testami (Satterthwaite)

set.seed(5050)
n_gr <- 64
grupa <- factor(rep(c("kontrolna", "program"), each = n_gr), levels = c("kontrolna", "program"))
pre_ciagly <- rnorm(2 * n_gr, mean = 32, sd = 7)
# post zależy od pre (nachylenie 0.6), program obniża lęk średnio o 4 pkt, w grupie kontrolnej lekki spadek
post_ciagly <- 13 + 0.6 * pre_ciagly - 4 * (grupa == "program") + rnorm(2 * n_gr, sd = 5)
ogr <- function(x) pmin(pmax(round(x), 10), 50)
dane <- data.frame(id = sprintf("os%03d", 1:(2 * n_gr)), grupa = grupa,
                   pre = ogr(pre_ciagly), post = ogr(post_ciagly))
dane$zmiana <- dane$post - dane$pre
head(dane, 4)
write.csv(dane[, c("id", "grupa", "pre", "post")], "ancova-przed-po-dane.csv", row.names = FALSE)

# Statystyki opisowe w grupach i korelacja pre–post
opis <- aggregate(cbind(pre, post, zmiana) ~ grupa, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
print(do.call(data.frame, opis), row.names = FALSE)
round(c(r_pre_post = cor(dane$pre, dane$post),
        r_w_kontrolnej = cor(dane$pre[grupa == "kontrolna"], dane$post[grupa == "kontrolna"]),
        r_w_programie = cor(dane$pre[grupa == "program"], dane$post[grupa == "program"])), 3)

# Strategia 0: same wyniki po interwencji (test t, bez uwzględnienia pomiaru wyjściowego)
t_post <- t.test(post ~ grupa, data = dane, var.equal = TRUE)
t_post

# Strategia 1: ANOVA mieszana 2 (grupa) × 2 (czas) – liczy się interakcja
dlugie <- reshape(dane[, c("id", "grupa", "pre", "post")], direction = "long", varying = c("pre", "post"),
                  v.names = "lek", timevar = "czas", times = c("pre", "post"), idvar = "id")
dlugie$czas <- factor(dlugie$czas, levels = c("pre", "post"))
anova_mix <- aov_ez(id = "id", dv = "lek", data = dlugie, between = "grupa", within = "czas")
nice(anova_mix, es = "pes")

# Strategia 2: różnice wyników (change scores) – test t dla wskaźników zmiany
t_zmiana <- t.test(zmiana ~ grupa, data = dane, var.equal = TRUE)
t_zmiana

# Strategia 3: ANCOVA – post z pomiarem wyjściowym jako kowariantem
ancova <- lm(post ~ pre + grupa, data = dane)
summary(ancova)$coefficients
confint(ancova)
emm <- emmeans(ancova, ~ grupa)      # średnie skorygowane (przy średnim pre)
mean(dane$pre)
print(as.data.frame(emm), digits = 4)
summary(pairs(emm, reverse = TRUE), infer = TRUE)

# Strategia 4a: model mieszany na danych długich (czas × grupa, losowy wyraz wolny)
m_lmm <- lmer(lek ~ czas * grupa + (1 | id), data = dlugie)
round(summary(m_lmm)$coefficients, 3)
# Strategia 4b: ograniczona analiza podłużna (cLDA): bez efektu głównego grupy, bo w RCT średnie wyjściowe są równe w populacji
dlugie$program_po <- as.numeric(dlugie$czas == "post" & dlugie$grupa == "program")
m_clda <- lmer(lek ~ czas + program_po + (1 | id), data = dlugie)
round(summary(m_clda)$coefficients, 3)

# Zestawienie: ta sama różnica (program − kontrolna) w pięciu analizach
oszac <- function(nazwa, est, se, df) data.frame(analiza = nazwa, roznica = est, SE = se,
                                                 dolny = est - qt(.975, df) * se, gorny = est + qt(.975, df) * se,
                                                 p = 2 * pt(-abs(est / se), df))
c_lmm  <- summary(m_lmm)$coefficients["czaspost:grupaprogram", ]
c_clda <- summary(m_clda)$coefficients["program_po", ]
zestaw <- rbind(
  oszac("Tylko post (test t)", unname(t_post$estimate[2] - t_post$estimate[1]), t_post$stderr, t_post$parameter),
  oszac("Różnice wyników / interakcja", unname(t_zmiana$estimate[2] - t_zmiana$estimate[1]), t_zmiana$stderr, t_zmiana$parameter),
  oszac("Model mieszany (czas × grupa)", c_lmm[["Estimate"]], c_lmm[["Std. Error"]], c_lmm[["df"]]),
  oszac("ANCOVA z pomiarem wyjściowym", coef(ancova)[["grupaprogram"]], summary(ancova)$coefficients["grupaprogram", 2], df.residual(ancova)),
  oszac("cLDA (model mieszany bez grupy w pre)", c_clda[["Estimate"]], c_clda[["Std. Error"]], c_clda[["df"]]))
zestaw$p <- signif(zestaw$p, 3)
print(cbind(zestaw[1], round(zestaw[2:5], 2), p = zestaw$p), row.names = FALSE)
Wynik w R
     id     grupa pre post zmiana
1 os001 kontrolna  30   34      4
2 os002 kontrolna  31   19    -12
3 os003 kontrolna  30   24     -6
4 os004 kontrolna  38   35     -3
     grupa pre.M pre.SD post.M post.SD zmiana.M zmiana.SD
 kontrolna 32.69   6.71  31.77    5.78    -0.92      5.65
   program 31.95   7.12  28.16    6.40    -3.80      5.88
    r_pre_post r_w_kontrolnej  r_w_programie
         0.603          0.599          0.626

	Two Sample t-test

data:  post by grupa
t = 3.3474, df = 126, p-value = 0.001076
alternative hypothesis: true difference in means between group kontrolna and group program is not equal to 0
95 percent confidence interval:
 1.475499 5.743251
sample estimates:
mean in group kontrolna   mean in group program
               31.76562                28.15625

Contrasts set to contr.sum for the following variables: grupa
Anova Table (Type 3 tests)

Response: lek
      Effect     df   MSE         F  pes p.value
1      grupa 1, 126 68.44    4.41 * .034    .038
2       czas 1, 126 16.64 21.41 *** .145   <.001
3 grupa:czas 1, 126 16.64   7.95 ** .059    .006
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

	Two Sample t-test

data:  zmiana by grupa
t = 2.8193, df = 126, p-value = 0.005592
alternative hypothesis: true difference in means between group kontrolna and group program is not equal to 0
95 percent confidence interval:
 0.856913 4.893087
sample estimates:
mean in group kontrolna   mean in group program
              -0.921875               -3.796875

               Estimate Std. Error   t value     Pr(>|t|)
(Intercept)  14.0809312 2.12267155  6.633589 8.888319e-10
pre           0.5410231 0.06225052  8.691063 1.695107e-14
grupaprogram -3.2120611 0.85593519 -3.752692 2.666015e-04
                  2.5 %     97.5 %
(Intercept)   9.8799008 18.2819616
pre           0.4178216  0.6642246
grupaprogram -4.9060631 -1.5180592
[1] 32.32031
 grupa       emmean        SE  df lower.CL upper.CL
 kontrolna 31.56697 0.6048058 125 30.36998 32.76395
 program   28.35491 0.6048058 125 27.15792 29.55189

Confidence level used: 0.95
 contrast            estimate    SE  df lower.CL upper.CL t.ratio p.value
 program - kontrolna    -3.21 0.856 125    -4.91    -1.52  -3.753  0.0003

Confidence level used: 0.95
                      Estimate Std. Error      df t value Pr(>|t|)
(Intercept)             32.688      0.815 183.842  40.093    0.000
czaspost                -0.922      0.721 126.000  -1.278    0.203
grupaprogram            -0.734      1.153 183.842  -0.637    0.525
czaspost:grupaprogram   -2.875      1.020 126.000  -2.819    0.006
            Estimate Std. Error      df t value Pr(>|t|)
(Intercept)   32.320      0.576 185.136  56.153    0.000
czaspost      -0.778      0.685 150.170  -1.136    0.258
program_po    -3.163      0.914 184.348  -3.461    0.001
                               analiza roznica   SE dolny gorny        p
                   Tylko post (test t)   -3.61 1.08 -5.74 -1.48 0.001080
          Różnice wyników / interakcja   -2.88 1.02 -4.89 -0.86 0.005590
         Model mieszany (czas × grupa)   -2.87 1.02 -4.89 -0.86 0.005590
          ANCOVA z pomiarem wyjściowym   -3.21 0.86 -4.91 -1.52 0.000267
 cLDA (model mieszany bez grupy w pre)   -3.16 0.91 -4.97 -1.36 0.000670
2. Założenia ANCOVA i wielkość efektu
R
# Założenia ANCOVA i wielkość efektu (ramka dane i model ancova z przepisu 1)
library(car)          # Anova(), leveneTest()
library(effectsize)   # eta_squared()

# 1. Homogeniczność nachyleń: czy związek pre–post jest taki sam w obu grupach?
m_nachylenia <- lm(post ~ pre * grupa, data = dane)
Anova(m_nachylenia, type = 2)
coef(lm(post ~ pre, data = subset(dane, grupa == "kontrolna")))[["pre"]]
coef(lm(post ~ pre, data = subset(dane, grupa == "program")))[["pre"]]

# 2. Liniowość: czy człon kwadratowy pre poprawia model?
anova(ancova, lm(post ~ pre + I(pre^2) + grupa, data = dane))

# 3. Równość wariancji reszt w grupach i rozkład reszt
leveneTest(resid(ancova) ~ dane$grupa, center = median)
round(tapply(resid(ancova), dane$grupa, sd), 2)
shapiro.test(resid(ancova))

# 4. Tabela ANCOVA (sumy kwadratów typu II) i cząstkowe η² z dwustronnym 90% CI
tab <- Anova(ancova, type = 2)
tab
eta_squared(tab, partial = TRUE, ci = .90, alternative = "two.sided")

# 5. Standaryzowana różnica: skorygowana różnica średnich / zbiorcze SD wyników post
sd_post <- sqrt(((n_gr - 1) * var(dane$post[dane$grupa == "kontrolna"]) +
                 (n_gr - 1) * var(dane$post[dane$grupa == "program"])) / (2 * n_gr - 2))
roznica_skor <- coef(ancova)[["grupaprogram"]]
ci_skor <- confint(ancova)["grupaprogram", ]
round(c(SD_post_zbiorcze = sd_post, d_skorygowane = roznica_skor / sd_post,
        d_dolny = ci_skor[[1]] / sd_post, d_gorny = ci_skor[[2]] / sd_post), 2)

# 6. d_ppc2 (Morris, 2008): różnica średnich zmian / zbiorcze SD pomiaru wyjściowego, z poprawką na małą próbę
sd_pre <- sqrt(((n_gr - 1) * var(dane$pre[dane$grupa == "kontrolna"]) +
                (n_gr - 1) * var(dane$pre[dane$grupa == "program"])) / (2 * n_gr - 2))
c_p <- 1 - 3 / (4 * (2 * n_gr - 2) - 1)
zm <- tapply(dane$zmiana, dane$grupa, mean)
round(c(SD_pre_zbiorcze = sd_pre, d_ppc2 = c_p * (zm[["program"]] - zm[["kontrolna"]]) / sd_pre), 2)
Wynik w R
Anova Table (Type II tests)

Response: post
           Sum Sq  Df F value    Pr(>F)
pre       1765.78   1 75.0141 2.099e-14 ***
grupa      329.21   1 13.9857 0.0002801 ***
pre:grupa    3.27   1  0.1387 0.7101840
Residuals 2918.88 124
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] 0.5163527
[1] 0.5629652
Analysis of Variance Table

Model 1: post ~ pre + grupa
Model 2: post ~ pre + I(pre^2) + grupa
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1    125 2922.1
2    124 2921.3  1   0.79712 0.0338 0.8544
Levene's Test for Homogeneity of Variance (center = median)
       Df F value Pr(>F)
group   1  0.0728 0.7877
      126
kontrolna   program
     4.63      4.99

	Shapiro-Wilk normality test

data:  resid(ancova)
W = 0.98551, p-value = 0.1919

Anova Table (Type II tests)

Response: post
           Sum Sq  Df F value    Pr(>F)
pre       1765.78   1  75.535 1.695e-14 ***
grupa      329.21   1  14.083 0.0002666 ***
Residuals 2922.14 125
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type II)

Parameter | Eta2 (partial) |       90% CI
-----------------------------------------
pre       |           0.38 | [0.27, 0.47]
grupa     |           0.10 | [0.03, 0.19]
SD_post_zbiorcze    d_skorygowane          d_dolny          d_gorny
            6.10            -0.53            -0.80            -0.25
SD_pre_zbiorcze          d_ppc2
           6.92           -0.41
3. Paradoks Lorda: dwa wydziały bez randomizacji
R
# Paradoks Lorda: grupy NIErandomizowane, różne na starcie, i żadnego efektu programu
# Dwa wydziały: program wdrożono na wydziale B (niższy lęk), wydział A to porównanie. Nikt się nie zmienia:
# każda osoba ma stały poziom lęku, a pre i post różnią się tylko błędem pomiaru (rzetelność ok. .60).
set.seed(1967)
n_w <- 150
wydzial <- factor(rep(c("A (porównanie)", "B (program)"), each = n_w))
poziom <- ifelse(wydzial == "B (program)", 28, 35) + rnorm(2 * n_w, sd = 5.4)   # stały poziom lęku osoby
lord <- data.frame(wydzial,
                   pre  = poziom + rnorm(2 * n_w, sd = 4.4),
                   post = poziom + rnorm(2 * n_w, sd = 4.4))
lord$zmiana <- lord$post - lord$pre
opis_lord <- aggregate(cbind(pre, post, zmiana) ~ wydzial, data = lord, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
print(do.call(data.frame, opis_lord), row.names = FALSE)
round(cor(lord$pre, lord$post), 2)

# Analiza różnic wyników: brak różnicy w zmianie (zgodnie z prawdą – nikt się nie zmienił)
t.test(zmiana ~ wydzial, data = lord, var.equal = TRUE)
# ANCOVA: „istotny efekt” programu, bo nachylenie pre–post < 1 i grupy różnią się na starcie
anc_lord <- lm(post ~ pre + wydzial, data = lord)
round(summary(anc_lord)$coefficients, 3)
round(confint(anc_lord)["wydzialB (program)", ], 2)
signif(summary(anc_lord)$coefficients["wydzialB (program)", "Pr(>|t|)"], 3)
Wynik w R
        wydzial pre.M pre.SD post.M post.SD zmiana.M zmiana.SD
 A (porównanie) 35.07   6.21  34.99    6.82    -0.08      6.13
    B (program) 28.07   6.18  28.01    6.20    -0.06      6.11
[1] 0.64

	Two Sample t-test

data:  zmiana by wydzial
t = -0.031903, df = 298, p-value = 0.9746
alternative hypothesis: true difference in means between group A (porównanie) and group B (program) is not equal to 0
95 percent confidence interval:
 -1.413697  1.368593
sample estimates:
mean in group A (porównanie)    mean in group B (program)
                 -0.07802714                  -0.05547508

                   Estimate Std. Error t value Pr(>|t|)
(Intercept)          15.174      1.861   8.154        0
pre                   0.565      0.051  10.973        0
wydzialB (program)   -3.021      0.731  -4.133        0
 2.5 % 97.5 %
 -4.46  -1.58
[1] 4.66e-05
4. Symulacja mocy trzech analiz
R
# Symulacja mocy: RCT, 64 + 64 osoby, prawdziwy efekt −3 pkt (SD wyniku = 7, d ≈ 0.43),
# różne korelacje pre–post; 2000 powtórzeń na warunek
set.seed(2024)
moc_jednej <- function(rho, n = 64, efekt = -3, sd = 7, R = 2000) {
  g <- rep(0:1, each = n)
  wyn <- replicate(R, {
    pre  <- rnorm(2 * n, 32, sd)
    post <- 31 + rho * (pre - 32) + sqrt(1 - rho^2) * rnorm(2 * n, 0, sd) + efekt * g
    p_post   <- t.test(post[g == 1], post[g == 0], var.equal = TRUE)$p.value
    p_zmiana <- t.test((post - pre)[g == 1], (post - pre)[g == 0], var.equal = TRUE)$p.value
    p_ancova <- summary(lm(post ~ pre + g))$coefficients["g", 4]
    c(post = p_post, zmiana = p_zmiana, ancova = p_ancova) < .05
  })
  rowMeans(wyn)
}
rho <- c(0, .2, .4, .6, .8)
moc <- t(sapply(rho, moc_jednej))
moc <- data.frame(rho = rho, round(moc, 3))
moc
Wynik w R
  rho  post zmiana ancova
1 0.0 0.647  0.378  0.649
2 0.2 0.695  0.482  0.701
3 0.4 0.677  0.598  0.750
4 0.6 0.663  0.760  0.846
5 0.8 0.669  0.967  0.983
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W artykule podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- afex (wersja 1.5-1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2-1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Osobne testy t dla prób zależnych w każdej grupie. „W grupie programu spadek był istotny, a w kontrolnej nie” nie jest testem różnicy między grupami. Różnica między istotnym a nieistotnym wynikiem sama nie musi być istotna. Porównuj grupy jedną analizą.
- Interpretowanie efektu głównego grupy w ANOVA mieszanej. Uśrednia on pretest i posttest, więc w przykładzie „wykazuje” różnicę, której część istniała przed interwencją. Efektem programu jest interakcja.
- Podwójne liczenie tego samego wyniku. Interakcja czas × grupa i test t na zmianach przy dwóch pomiarach to ten sam test (F = t²).
- Wybór analizy po obejrzeniu wyników. Raportowanie tej z trzech analiz, która dała najmniejsze p, zawyża ryzyko fałszywego alarmu. Zapisz analizę główną w planie, a pozostałe pokaż jako analizy wrażliwości.
- Testowanie istotności różnic wyjściowych w RCT i dobieranie analizy do wyniku tego testu (Schulz i in., 2010).
- ANCOVA jako „wyrównanie” grup nierandomizowanych. Kowariant nie usuwa różnic, które wynikają z tego, kto trafił do której grupy (Miller i Chapman, 2001). W quasi-eksperymencie pokaż obie analizy i opisz założenia.
- Kowariant zmierzony po interwencji albo kowarianty dobierane po fakcie według tego, co „poprawia” wynik.
- Wielkość efektu bez opisu, np. samo „d = 0.53” bez informacji, czy to różnica skorygowana, czy różnica zmian, i przez jakie SD ją podzielono.
- Analiza tylko osób z kompletem pomiarów bez uzasadnienia. Przy odpadaniu z badania rozważ model mieszany (cLDA) albo imputację wielokrotną i opisz mechanizm braków (zob. braki danych MCAR, MAR i MNAR).
Najczęstsze pytania
Czy w badaniu przed i po z grupą kontrolną wystarczy porównać wyniki końcowe?
W badaniu randomizowanym takie porównanie jest nieobciążone, ale marnuje informację z pomiaru wyjściowego. ANCOVA z pretestem jako kowariantem szacuje ten sam efekt dokładniej: w przykładzie z tego wpisu błąd standardowy różnicy spadł z 1.08 do 0.86 pkt. Przy korelacji pre–post .60 oznacza to mniej więcej o jedną trzecią mniejszą potrzebną próbę.
Dlaczego ANCOVA i analiza różnic wyników dają różne wyniki?
Obie odejmują od różnicy w posttescie część różnicy wyjściowej: analiza zmian całą (zakłada nachylenie pre–post równe 1), ANCOVA tylko tyle, ile wynika z oszacowanego nachylenia. Gdy grupy różnią się na starcie, wyniki się rozchodzą. W badaniu randomizowanym różnica jest przypadkowa i obie metody są nieobciążone, ale ANCOVA ma większą moc (Van Breukelen, 2006).
Co zrobić, gdy grupy w RCT różnią się w pomiarze wyjściowym?
Nie testuj istotności tej różnicy i nie zmieniaj z jej powodu analizy. W badaniu randomizowanym nierównowaga wyjściowa jest przypadkowa, a ANCOVA z pomiarem wyjściowym ją koryguje. Analiza zmian albo interakcja czas × grupa korygują ją niepełnie (Clifton i Clifton, 2019).
Na czym polega paradoks Lorda w analizie badania przed i po?
To sytuacja opisana przez Lorda (1967), w której analiza zmian i ANCOVA zastosowane do tych samych danych z grup nierandomizowanych prowadzą do sprzecznych wniosków. ANCOVA może wtedy wykazać efekt tam, gdzie nikt się nie zmienił, bo różnicę w regresji do średniej grup o innym poziomie wyjściowym traktuje jak efekt grupy. Rozstrzygnięcie wymaga założeń o tym, jak powstały grupy, a nie innego testu.
Jak policzyć wielkość efektu w badaniu z pretestem, posttestem i grupą kontrolną?
Podaj różnicę średnich skorygowanych z ANCOVA podzieloną przez zbiorcze SD wyników po interwencji albo miarę dppc2: różnicę średnich zmian w obu grupach podzieloną przez zbiorcze SD pretestu (Morris, 2008). Nie dziel przez SD reszt z ANCOVA, bo zawyża to efekt. Zawsze opisz, co jest w liczniku i mianowniku.
Czy interakcja czas × grupa w ANOVA mieszanej to to samo co test na różnicach wyników?
Tak, przy dwóch pomiarach to ta sama analiza: statystyka F interakcji jest kwadratem statystyki t z testu na zmianach, a wartości p są identyczne. Nie raportuj ich jako dwóch niezależnych potwierdzeń efektu.
Powiązane hasła
Przeczytaj też
ANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikStatystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →Analizujesz badanie interwencyjne albo odpowiadasz recenzentowi?
Pomożemy zaplanować analizę główną i analizy wrażliwości, sprawdzimy model ANCOVA lub model mieszany i wyjaśnimy wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Clifton, L., & Clifton, D. A. (2019). The correlation between baseline score and post-intervention score, and its implications for statistical analysis. Trials, 20(1), Article 43. https://doi.org/10.1186/s13063-018-3108-3 ● Otwarty dostęp
- Egbewale, B. E., Lewis, M., & Sim, J. (2014). Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study. BMC Medical Research Methodology, 14(1), Article 49. https://doi.org/10.1186/1471-2288-14-49 ● Otwarty dostęp
- IBM. (b.d.). IBM SPSS Statistics 30.0.0 documentation. Pobrano 21 października 2026 z https://www.ibm.com/docs/en/spss-statistics/30.0.0 ● Otwarty dostęp
- Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
- Lu, K. (2010). On efficiency of constrained longitudinal data analysis versus longitudinal analysis of covariance. Biometrics, 66(3), 891–896. https://doi.org/10.1111/j.1541-0420.2009.01332.x
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Morris, S. B. (2008). Estimating effect sizes from pretest-posttest-control group designs. Organizational Research Methods, 11(2), 364–386. https://doi.org/10.1177/1094428106291059
- Schulz, K. F., Altman, D. G., Moher, D., & CONSORT Group. (2010). CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, Article c332. https://doi.org/10.1136/bmj.c332 ● Otwarty dostęp
- Senn, S. (2006). Change from baseline and analysis of covariance revisited. Statistics in Medicine, 25(24), 4334–4344. https://doi.org/10.1002/sim.2682
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Vickers, A. J., & Altman, D. G. (2001). Analysing controlled trials with baseline and follow up measurements. BMJ, 323(7321), 1123–1124. https://doi.org/10.1136/bmj.323.7321.1123 ● Otwarty dostęp
- Wright, D. B. (2006). Comparing groups in a before–after design: When t test and ANCOVA produce different results. British Journal of Educational Psychology, 76(3), 663–675. https://doi.org/10.1348/000709905x52210
Cytowania BibTeX
@article{clifton2019correlation, author={Clifton, Lei and Clifton, David A.}, title={{The correlation between baseline score and post-intervention score, and its implications for statistical analysis}}, journal={Trials}, year={2019}, volume={20}, number={1}, eid={43}, doi={10.1186/s13063-018-3108-3}}@article{egbewale2014bias, author={Egbewale, Bolaji E. and Lewis, Martyn and Sim, Julius}, title={{Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={49}, doi={10.1186/1471-2288-14-49}}@misc{ibmndspssdokumentacja, author={{IBM}}, title={{IBM SPSS Statistics 30.0.0 documentation}}, url={https://www.ibm.com/docs/en/spss-statistics/30.0.0}}@article{lord1967paradox, author={Lord, Frederic M.}, title={{A paradox in the interpretation of group comparisons}}, journal={Psychological Bulletin}, year={1967}, volume={68}, number={5}, pages={304--305}, doi={10.1037/h0025105}}@article{lu2010efficiency, author={Lu, Kaifeng}, title={{On efficiency of constrained longitudinal data analysis versus longitudinal analysis of covariance}}, journal={Biometrics}, year={2010}, volume={66}, number={3}, pages={891--896}, doi={10.1111/j.1541-0420.2009.01332.x}}@article{miller2001misunderstanding, author={Miller, Gregory A. and Chapman, Jean P.}, title={{Misunderstanding analysis of covariance}}, journal={Journal of Abnormal Psychology}, year={2001}, volume={110}, number={1}, pages={40--48}, doi={10.1037/0021-843x.110.1.40}}@article{morris2008estimating, author={Morris, Scott B.}, title={{Estimating effect sizes from pretest-posttest-control group designs}}, journal={Organizational Research Methods}, year={2008}, volume={11}, number={2}, pages={364--386}, doi={10.1177/1094428106291059}}@article{schulz2010consort, author={Schulz, Kenneth F. and Altman, Douglas G. and Moher, David and {CONSORT Group}}, title={{CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials}}, journal={BMJ}, year={2010}, volume={340}, eid={c332}, doi={10.1136/bmj.c332}}@article{senn2006change, author={Senn, Stephen}, title={{Change from baseline and analysis of covariance revisited}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={24}, pages={4334--4344}, doi={10.1002/sim.2682}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{vickers2001analysing, author={Vickers, Andrew J. and Altman, Douglas G.}, title={{Analysing controlled trials with baseline and follow up measurements}}, journal={BMJ}, year={2001}, volume={323}, number={7321}, pages={1123--1124}, doi={10.1136/bmj.323.7321.1123}}@article{wright2006comparing, author={Wright, Daniel B.}, title={{Comparing groups in a before–after design: When t test and ANCOVA produce different results}}, journal={British Journal of Educational Psychology}, year={2006}, volume={76}, number={3}, pages={663--675}, doi={10.1348/000709905x52210}}