„Czemu ANOVA, a nie regresja?”
Takie pytanie potrafi paść na obronie i brzmi jak pułapka. Odpowiedź jest prostsza, niż się wydaje: przy grupach i zmiennej ciągłej jako wyniku to jeden i ten sam model. Test t, ANOVA, ANCOVA, korelacja i regresja liniowa są odmianami ogólnego modelu liniowego. Różnią się nazwą, układem wydruku i tym, co program pokazuje domyślnie.
Nie jest to nowość. Cohen (1968) przedstawił tożsamość regresji wielorakiej z analizą wariancji i kowariancji z efektami stałymi w artykule skierowanym do psychologów, a podręcznik Gelmana i in. (2020) traktuje regresję jako narzędzie także do zwykłych porównań. Tu policzysz jeden zbiór danych kilkoma sposobami i zobaczysz, które liczby są identyczne, a które nie.
Wykonanie każdej analizy opisują osobne wpisy: test t krok po kroku, ANOVA krok po kroku i regresja wieloraka. Tu chodzi wyłącznie o to, jak te analizy się ze sobą łączą i co z tego wynika dla pracy.
Jeden zbiór danych do wszystkich analiz
Przykład przewodni (fikcyjny, dane symulowane). Studentka sprawdza, czy krótka przerwa w nauce poprawia wynik testu uwagi (0–100). 96 osób losowo przydzielono do trzech warunków: bez przerwy (kontrola), przerwa bierna i przerwa ruchowa. Test wykonano przed nauką i po niej. Liczebności i rozproszenia są nierówne celowo – przydadzą się przy teście Welcha. Dane możesz pobrać: test-t-anova-regresja-dane.csv (96 wierszy) i przeliczyć w swoim programie.
| Grupa | n | M przed | M po | SD po |
|---|---|---|---|---|
| Kontrola | 40 | 53.55 | 55.38 | 8.72 |
| Przerwa bierna | 32 | 49.44 | 52.28 | 10.20 |
| Przerwa ruchowa | 24 | 51.79 | 60.17 | 11.56 |
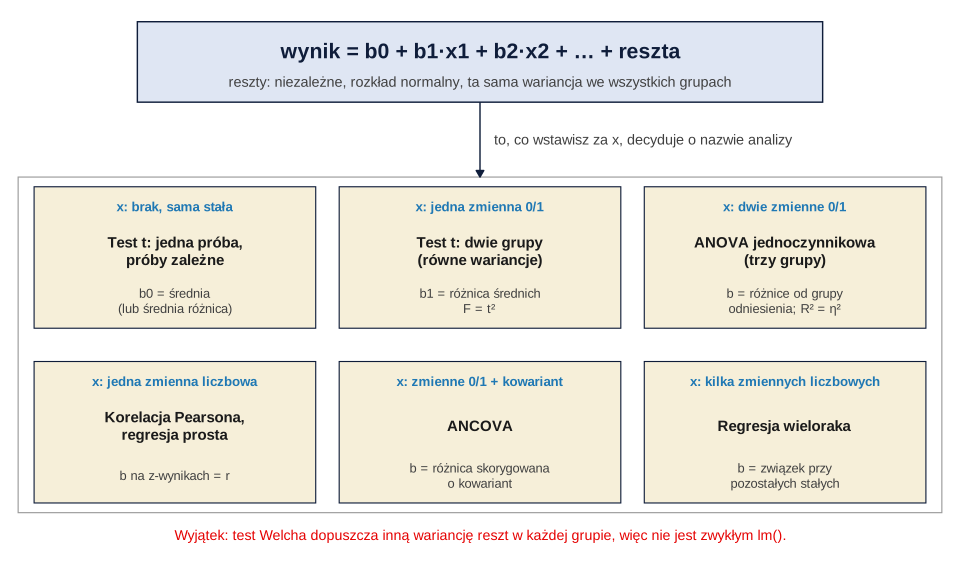
Rysunek 1 to mapa całego wpisu. Równanie jest jedno. Zmienia się tylko to, co wstawiasz w miejsce x.
Test t to regresja z jedną zmienną 0/1
Weź grupę kontrolną i grupę ruchową. Utwórz zmienną ruch: 0 = kontrola, 1 = przerwa ruchowa. Model ma postać:
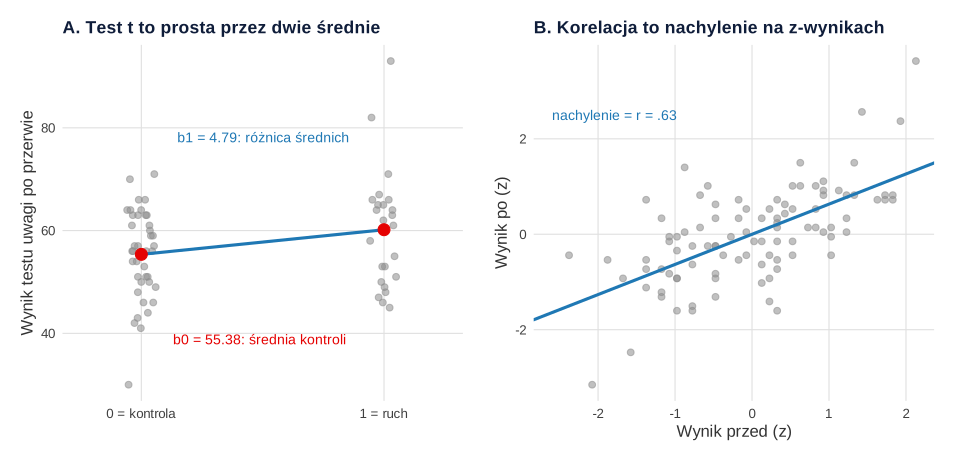
U osoby z kontroli ruch = 0, więc przewidywany wynik to b0. U osoby z grupy ruchowej to b0 + b1. Najlepszym przewidywaniem w grupie jest jej średnia, dlatego b0 to średnia grupy 0, a b1 to różnica średnich. Prosta regresji przechodzi przez dwie średnie (rysunek 2A).
| Liczba | t.test(var.equal = TRUE) | lm(po ~ ruch) | anova() |
|---|---|---|---|
| Różnica średnich | −4.79 (kontrola − ruch) | b1 = 4.79 | – |
| Statystyka | t = −1.88 | t = 1.88 | F = 3.54 = t² |
| Stopnie swobody | 62 | 62 | 1 i 62 |
| p | .065 | .065 | .065 |
| 95% CI różnicy | [−9.89, 0.30] | [−0.30, 9.89] | – |
Różni się tylko znak, a ten zależy od kolejności odejmowania. Dlatego przy wyniku „odwrotnym niż w hipotezie” najpierw sprawdź kodowanie grup, jak we wpisie o wyniku w przeciwnym kierunku.
ANOVA to regresja z dwiema zmiennymi 0/1
Trzy grupy wymagają dwóch zmiennych. Trzeciej nie dodawaj: jedną trzeba pominąć, aby współczynniki dało się jednoznacznie oszacować (Suits, 1957). Tworzenie takich zmiennych szczegółowo opisuje hasło dummy coding.
| Grupa | x_bierna | x_ruch | Przewidywana średnia |
|---|---|---|---|
| Kontrola (kategoria referencyjna) | 0 | 0 | b0 = 55.38 |
| Przerwa bierna | 1 | 0 | b0 + b1 = 55.375 − 3.094 = 52.281 |
| Przerwa ruchowa | 0 | 1 | b0 + b2 = 55.375 + 4.792 = 60.167 |
aov() i lm() dają to samo: F(2, 93) = 4.29, p = .017. R² z regresji (.084) to dokładnie eta kwadrat z ANOVA (.084). Różnica polega na tym, co widać od razu: ANOVA podaje jeden test ogólny, a regresja dodatkowo porównania z grupą odniesienia. Współczynniki te nie mają korekty na wielokrotne porównania, więc nie zastępują testów post hoc.
Spójrz też na grupę ruchową. Różnica znów wynosi 4.79, ale p = .066, a nie .065. Średnie są te same, lecz błąd standardowy liczony jest teraz z reszt wszystkich trzech grup (2.58 zamiast 2.55, 93 stopnie swobody zamiast 62).
Kategoria referencyjna i kodowanie: zmienia się b, nie F
Te same dane można zakodować na kilka sposobów. W kodowaniu efektów współczynnik mówi o odchyleniu grupy od średniej średnich. Własne wagi to kontrasty planowane, które według Schada i in. (2020) są właściwym sposobem zapisania w modelu konkretnych hipotez o różnicach.
| Kodowanie | b0 | b1 | b2 | F(2, 93) | R² |
|---|---|---|---|---|---|
| 0/1, odniesienie: kontrola | 55.38 (M kontroli) | −3.09 (bierna − kontrola), p = .194 | 4.79 (ruch − kontrola), p = .066 | 4.29 | .084 |
| 0/1, odniesienie: ruch | 60.17 (M ruchu) | −4.79 (kontrola − ruch), p = .066 | −7.89 (bierna − ruch), p = .004 | 4.29 | .084 |
| Efektowe | 55.94 (średnia średnich) | −0.57 (kontrola − średnia średnich), p = .683 | −3.66 (bierna − średnia średnich), p = .014 | 4.29 | .084 |
| Kontrasty planowane | 55.94 (średnia średnich) | 0.85 (średnia dwóch przerw − kontrola), p = .683 | 7.89 (ruch − bierna), p = .004 | 4.29 | .084 |
F, R² i suma kwadratów reszt (9265.18) są takie same w każdym wierszu, bo model przewiduje te same średnie. Współczynniki się zmieniają, ponieważ każde kodowanie zadaje inne pytania. Przy nierównych grupach stała w kodowaniu efektów to średnia średnich (55.94), a nie średnia wszystkich osób (55.54).
Tu kryje się pułapka. Z kontrolą jako odniesieniem żaden współczynnik nie jest istotny, a z odniesieniem „ruch” pojawia się p = .004. W danych nic się nie zmieniło, zmieniło się tylko porównanie. Wybór kategorii odniesienia po obejrzeniu wyników to odmiana p-hackingu. Ustal ją przed analizą, zwykle jako grupę kontrolną lub standardową.
Korelacja to regresja na wartościach standaryzowanych
Korelacja wyniku przed i po wynosi r(94) = .63, t = 7.90. Po standaryzacji obu zmiennych regresja daje nachylenie .632, stałą 0 i to samo t = 7.90 (rysunek 2B). Zasada dotyczy jednego predyktora. Przy kilku predyktorach współczynnik beta nie jest już korelacją, o czym więcej we wpisie o współczynnikach standaryzowanych.
Ta sama zasada łączy korelację z testem t. Korelacja punktowo-dwuseryjna zmiennej ruch z wynikiem to r = .23, a jej test ma t = 1.88, czyli dokładnie tyle, co test t dla dwóch grup.
ANCOVA: dodaj kowariant do tego samego równania
ANCOVA powstaje przez dopisanie wyniku sprzed nauki: lm(po ~ przed + grupa). Test grupy to porównanie modelu bez grupy z modelem z grupą: F(2, 92) = 5.77, p = .004, cząstkowe η² = .11. Wiersz grupa z aov(po ~ przed + grupa) pokazuje te same liczby, gdy grupa stoi w formule po kowariancie.
Różnica ruch − kontrola to teraz b = 5.93, 95% CI [1.99, 9.87], p = .004, czyli różnica średnich skorygowanych (60.13 i 54.20). Bez kowariantu wynosiła 4.79, p = .066. Dwa powody: SD reszt spada z 9.98 do 7.66, a grupy różniły się nieco na starcie. Współczynnik kowariantu to b = 0.65. Założenie równych nachyleń sprawdzasz, dodając interakcję: tutaj F(2, 90) = 1.05, p = .353.
Ten przykład ma losowanie. W badaniach z losowaniem ANCOVA i analiza zmian są nieobciążone, a ANCOVA ma większą moc; bez losowania obie metody mogą prowadzić do sprzecznych wniosków (Van Breukelen, 2006). Miller i Chapman (2001) wyjaśniają, dlaczego zwykle nie da się „wyrównać” w ten sposób rzeczywistych różnic między grupami. Szczegóły znajdziesz w ANCOVA w badaniu przed i po oraz przy paradoksie Lorda. O doborze kowariantów decyduj z góry, jak we wpisie czy kontrolować wiek i płeć: kowariant dopisany dlatego, że p wyszło .066, nie jest planem.
Welch: wyjątek, który warto zrozumieć
Wywołanie t.test(po ~ grupa) bez dodatkowych opcji liczy w R test Welcha i wyniku z lm() nie odtworzy. Model liniowy zakłada jedną wariancję reszt we wszystkich grupach. Welch pozwala każdej grupie mieć własną i inaczej liczy stopnie swobody.
| Metoda | b | SE | t | df | p |
|---|---|---|---|---|---|
Student = lm(po ~ ruch) | 4.79 | 2.55 | 1.88 | 62 | .065 |
| Welch | 4.79 | 2.73 | 1.75 | 38.73 | .087 |
lm z wagami 1/wariancja grupy | 4.79 | 2.73 | 1.75 | 62 | .085 |
Różnica średnich się nie zmienia. Zmienia się niepewność: tu mniejsza grupa ma większe rozproszenie (SD 11.56 wobec 8.72), więc wspólna wariancja zaniża błąd standardowy. Ostatni wiersz pokazuje, że Welch to wciąż model liniowy, tyle że z osobną wariancją w każdej grupie. Regresja ważona odtwarza jego SE i t, a pozostaje różnica w stopniach swobody. Po podstawieniu df Welcha wychodzi to samo p = .087.
Tożsamość z lm() nie jest argumentem za testem Studenta. Delacre i in. (2017) zalecają Welcha jako domyślny test dwóch grup, a Delacre i in. (2019) jego odpowiednik dla ANOVA. Tu klasyczne wersje służą do pokazania tożsamości. Wspólne są też założenia, więc jeśli są złamane w ANOVA, są złamane również w „tej samej” regresji.
Zestawienie: test, równoważny model, co jest czym
| Test | Model w R | Co jest czym |
|---|---|---|
| Test t dla jednej próby | lm(y - mu ~ 1) | b0 = średnia − wartość odniesienia; t identyczne |
| Test t dla prób zależnych | lm(po - przed ~ 1) | b0 = średnia różnica (w przykładzie 3.80; t(95) = 4.27 w obu wersjach) |
| Test t dla dwóch grup, równe wariancje | lm(y ~ x01) | b0 = średnia grupy 0; b1 = różnica; t identyczne; F = t² |
| Test Welcha | lm(y ~ x01, weights = 1/wariancja grupy) | b, SE i t identyczne; df inne (wyjątek) |
| Korelacja Pearsona | lm(scale(y) ~ scale(x)) | b1 = r; t identyczne |
| ANOVA jednoczynnikowa | lm(y ~ x1 + x2) lub lm(y ~ grupa) | b = różnice od grupy odniesienia; F modelu = F ANOVA; R² = η² |
| ANCOVA | lm(y ~ kowariant + grupa) | b grupy = różnica skorygowana; F z porównania modeli = F grupy |
| ANOVA czynnikowa | lm(y ~ a * b) | Interakcja = iloczyny zmiennych; przy nierównych grupach zwróć uwagę na typ sum kwadratów |
Tożsamość ma granice. Test Manna–Whitneya, chi-kwadrat i regresja logistyczna nie są zwykłym lm(), a kilka pomiarów tych samych osób wymaga uwzględnienia zależności, o czym mówi wpis ANOVA powtarzana czy model mieszany.
Co z tego wynika dla pracy
Nazwę dobierz do pytania. Pytasz o różnice między grupami – pisz „ANOVA” lub „test t”. Masz kilka predyktorów i pytasz o związek każdego z nich przy pozostałych – pisz „regresja”. Arytmetyka tego nie rozstrzyga, robią to zwyczaj dziedziny i promotor.
Raportuj to, co zaplanowane. Nazwa nie zmienia F, ale plan analizy ustala rzeczy, które wynik zmieniają: kategorię odniesienia, kontrasty albo testy post hoc, kowarianty, wersję testu (Student czy Welch). Jeśli odchodzisz od planu, napisz o tym wprost.
Nie licz dwa razy. Test t i regresja na tych samych danych to jeden wynik, nie dwa dowody.
| Jak bywa napisane | Co nie tak | Poprawione |
|---|---|---|
| „Wynik testu t potwierdzono dodatkowo analizą regresji.” | To ta sama analiza, więc nic nie potwierdza | „Grupy porównano testem t.” Regresję usuń albo podaj jako inny zapis tego samego wyniku |
| „Zastosowano ANOVA, ponieważ regresja nie dała istotnych wyników.” | Przy tym samym modelu F jest takie samo; zdanie sugeruje wybór po wyniku | „Zgodnie z planem różnice między trzema grupami sprawdzono jednoczynnikową ANOVA.” |
| „Jako kategorię referencyjną przyjęto ruch, ponieważ uzyskano wtedy istotne różnice.” | Wybór porównania po wyniku | „Kategorią referencyjną była grupa kontrolna, co ustalono przed analizą.” |
| „ANCOVA pozwoliła wyeliminować różnice między istniejącymi klasami.” | Zbyt mocne: bez losowania korekta nie wyrównuje grup | „W modelu uwzględniono wynik wyjściowy; różnic między klasami nie można uznać za w pełni skorygowane.” |
| „Regresja wykazała wpływ, a ANOVA tylko różnicę.” | O wnioskowaniu przyczynowym decyduje schemat badania, nie nazwa analizy | „W badaniu z losowym przydziałem grupy różniły się…” albo „Wynik wiązał się z…” przy braku losowania |
Przykłady są fikcyjne.
Jak odpowiedzieć na obronie
Pytania o wybór analizy zbiera wpis pytania na obronie. Poniżej odpowiedzi na to jedno, w dwóch wariantach. Dopasuj je do własnego planu.
„Czemu ANOVA, a nie regresja?” – zmienna niezależna to grupy
„Czemu ANOVA?” – zmienna niezależna była ciągła i podzielono ją na grupy
Tu odpowiedź jest inna. Model z podziałem na grupy to nie to samo co model ze zmienną ciągłą, bo podział traci informację. Jeśli tak zrobiłeś, nie zasłaniaj się tożsamością.
Gotowe zdania do pracy (APA)
Te same dane, różne zapisy. Liczby są fikcyjne. Wybierz wersję zgodną z planem, nie wszystkie naraz.
Metoda
Dwie grupy: test t lub regresja
Test Welcha
Trzy grupy: ANOVA lub regresja
ANCOVA
Najczęstsze błędy
- Grupy wpisane jako liczby 1, 2, 3 i potraktowane jak zmienna liczbowa. Model szuka wtedy jednej prostej przez kolejne numery: w przykładzie F(1, 94) = 2.15 i R² = .022 zamiast F(2, 93) = 4.29 i R² = .084. Użyj
factor()albo zmiennych 0/1. - Tyle zmiennych 0/1, ile kategorii. Potrzeba o jedną mniej.
- Porównywanie domyślnego
t.test()zlm()i szukanie błędu. To Welch kontra Student. - Czytanie współczynników 0/1 w modelu z interakcją jak efektów głównych. Są to efekty przy poziomie odniesienia drugiego czynnika.
- Interpretowanie stałej bez sprawdzenia kodowania. Raz to średnia grupy, raz średnia średnich.
- Traktowanie tożsamości jako zwolnienia z założeń. Reszty trzeba sprawdzić bez względu na nazwę.
Te same wyniki w R: siedem porównań na jednym zbiorze
Jeden skrypt liczy wszystkie liczby z tekstu i tabel. Używa wyłącznie bazowego R. Rysunki powstały w osobnym skrypcie. Średnie, odchylenia i liczebności w symulacji to założenia ilustracyjne, a ziarna nie wybierano pod wynik.
Test t, ANOVA, korelacja, ANCOVA i Welch jako modele liniowe
R
# Przykład fikcyjny: krótka przerwa w nauce a wynik testu uwagi (dane symulowane)
# Tylko bazowy R
set.seed(516)
n <- c(kontrola = 40, bierna = 32, ruch = 24)
grupa <- factor(rep(names(n), n), levels = names(n))
przed <- round(rnorm(sum(n), 50, 10))
efekt <- c(kontrola = 0, bierna = 2, ruch = 7)[as.character(grupa)]
sd_e  <- c(kontrola = 7, bierna = 8, ruch = 12)[as.character(grupa)]
po    <- round(22 + 0.6 * przed + efekt + rnorm(sum(n), 0, sd_e))
d <- data.frame(grupa, przed, po)

r3 <- function(x) round(x, 3)
cat("== Statystyki opisowe ==\n")
print(data.frame(n = tapply(d$po, d$grupa, length),
                 M_przed = r3(tapply(d$przed, d$grupa, mean)),
                 M_po = r3(tapply(d$po, d$grupa, mean)),
                 SD_po = r3(tapply(d$po, d$grupa, sd))))

# 1. Dwie grupy: test t = regresja z jedną zmienną 0/1
cat("\n== 1. Test t (równe wariancje) i regresja 0/1 ==\n")
d2 <- droplevels(subset(d, grupa != "bierna"))
d2$ruch <- as.numeric(d2$grupa == "ruch")
tt <- t.test(po ~ grupa, data = d2, var.equal = TRUE)
m2 <- lm(po ~ ruch, data = d2)
cat("t.test: t =", r3(tt$statistic), " df =", tt$parameter,
    " p:", signif(tt$p.value, 4), "\n")
cat("95% CI (kontrola - ruch):", r3(tt$conf.int), "\n")
print(r3(coef(summary(m2))))
cat("95% CI dla b:", r3(confint(m2)["ruch", ]), "\n")
a2 <- anova(m2)
cat("F =", r3(a2$F[1]), " p:", signif(a2$"Pr(>F)"[1], 4),
    " t^2 =", r3(unname(tt$statistic)^2),
    " R2 =", r3(summary(m2)$r.squared), "\n")

# 2. Trzy grupy: ANOVA = regresja z dwiema zmiennymi 0/1
cat("\n== 2. ANOVA i regresja z dwiema zmiennymi 0/1 ==\n")
d$x_bierna <- as.numeric(d$grupa == "bierna")
d$x_ruch   <- as.numeric(d$grupa == "ruch")
print(summary(aov(po ~ grupa, data = d)))
m3 <- lm(po ~ x_bierna + x_ruch, data = d)
print(r3(coef(summary(m3))))
s3 <- summary(m3)
cat("Regresja: F =", r3(s3$fstatistic[1]), " df =", s3$fstatistic[2:3],
    " p:", signif(anova(aov(po ~ grupa, data = d))$"Pr(>F)"[1], 4),
    " R2 =", r3(s3$r.squared), "\n")
ss <- anova(aov(po ~ grupa, data = d))$"Sum Sq"
cat("eta2 z ANOVA = SS_grupa / SS_całk =", r3(ss[1] / sum(ss)), "\n")

# 3. Inne kodowanie: te same dane, inne b, to samo F
cat("\n== 3. Kategoria referencyjna i kodowanie ==\n")
porownaj <- function(kontrasty, ref = "kontrola") {
  g <- relevel(d$grupa, ref = ref)
  if (!is.null(kontrasty)) contrasts(g) <- kontrasty
  m <- lm(d$po ~ g)
  s <- summary(m)
  cat("b0, b1, b2:", r3(coef(m)), "\n")
  cat("t dla b1, b2:", r3(coef(s)[-1, 3]), "\n")
  cat("p dla b1, b2:", r3(coef(s)[-1, 4]), "\n")
  cat("F =", r3(s$fstatistic[1]), " R2 =", r3(s$r.squared),
      " suma kw. reszt =", r3(sum(resid(m)^2)), "\n")
}
cat("Zero-jedynkowe, referencja: kontrola\n"); porownaj(NULL)
cat("Zero-jedynkowe, referencja: ruch\n");     porownaj(NULL, ref = "ruch")
cat("Efektowe (contr.sum), kolejno: kontrola, bierna\n"); porownaj(contr.sum(3))
planowane <- cbind(przerwa_vs_brak = c(-2/3, 1/3, 1/3),
                   ruch_vs_bierna  = c(0, -1/2, 1/2))
cat("Kontrasty planowane: przerwa vs brak, ruch vs bierna\n")
porownaj(planowane)
sr <- tapply(d$po, d$grupa, mean)
cat("Średnia średnich grup:", r3(mean(sr)), " średnia wszystkich osób:",
    r3(mean(d$po)), "\n")

# Błąd: grupy wpisane jako liczby 1, 2, 3 (jedna zmienna liczbowa)
zle <- summary(lm(po ~ as.numeric(grupa), data = d))
cat("Grupy jako liczby 1-3: F =", r3(zle$fstatistic[1]), " df =",
    zle$fstatistic[2:3], " R2 =", r3(zle$r.squared), "\n")

# 4. Korelacja = regresja na wartościach standaryzowanych
cat("\n== 4. Korelacja i regresja ==\n")
ct <- cor.test(d$przed, d$po)
mz <- lm(scale(po) ~ scale(przed), data = d)
cat("Pearson: r:", r3(ct$estimate), " t =", r3(ct$statistic),
    " df =", ct$parameter, " p:", signif(ct$p.value, 4), "\n")
cat("95% CI dla r:", r3(ct$conf.int), "\n")
print(r3(coef(summary(mz))))
cb <- cor.test(d2$ruch, d2$po)
cat("Punktowo-dwuseryjna (ruch 0/1 a wynik): r:", r3(cb$estimate),
    " t =", r3(cb$statistic), " (test t z punktu 1, moduł:",
    r3(abs(tt$statistic)), ")\n")

# 5. ANCOVA = dodaj kowariant
cat("\n== 5. ANCOVA: model z pomiarem wyjściowym ==\n")
m_bez <- lm(po ~ grupa, data = d)
m_kow <- lm(po ~ przed, data = d)
m_anc <- lm(po ~ przed + grupa, data = d)
print(anova(m_kow, m_anc))
print(r3(coef(summary(m_anc))))
print(summary(aov(po ~ przed + grupa, data = d)))
cat("95% CI, ruch vs kontrola:", r3(confint(m_anc)["gruparuch", ]), "\n")
cat("SD reszt bez kowariantu:", r3(sigma(m_bez)),
    " z kowariantem:", r3(sigma(m_anc)), "\n")
nowe <- data.frame(przed = mean(d$przed), grupa = levels(d$grupa))
cat("Średnie skorygowane (przy średnim wyniku przed):\n")
print(setNames(round(predict(m_anc, nowe), 2), levels(d$grupa)))
an <- anova(m_kow, m_anc)
cat("Cząstkowe eta2 dla grupy:", r3(an$"Sum of Sq"[2] / (an$"Sum of Sq"[2] + an$RSS[2])), "\n")
m_int <- lm(po ~ przed * grupa, data = d)
cat("Jednorodność nachyleń (model z interakcją):\n")
print(anova(m_anc, m_int))

# 6. Welch: inne wariancje w grupach, inna liczba stopni swobody
cat("\n== 6. Welch ==\n")
tw <- t.test(po ~ grupa, data = d2)
cat("Welch: t =", r3(tw$statistic), " df =", r3(tw$parameter),
    " p:", signif(tw$p.value, 4), "\n")
cat("95% CI (kontrola - ruch):", r3(tw$conf.int), "\n")
cat("Student: SE =", r3(coef(summary(m2))["ruch", 2]),
    " Welch: SE =", r3(unname(tw$stderr)), "\n")
wagi <- 1 / ave(d2$po, d2$grupa, FUN = var)
mw <- lm(po ~ ruch, data = d2, weights = wagi)
print(r3(coef(summary(mw))))
cat("Regresja ważona, df reszt =", mw$df.residual, "\n")
cat("p z t ważonego i df Welcha:",
    signif(2 * pt(-abs(coef(summary(mw))["ruch", 3]), tw$parameter), 4), "\n")

# 7. Próby zależne i jedna próba: model z samą stałą
cat("\n== 7. Test t dla prób zależnych = model z samą stałą ==\n")
tp <- t.test(d$po, d$przed, paired = TRUE)
mp <- lm(I(po - przed) ~ 1, data = d)
cat("t.test paired: t =", r3(tp$statistic), " df =", tp$parameter,
    " p:", signif(tp$p.value, 4), " średnia różnica =", r3(tp$estimate), "\n")
print(r3(coef(summary(mp))))
Wynik
== Statystyki opisowe ==
          n M_przed   M_po  SD_po
kontrola 40  53.550 55.375  8.723
bierna   32  49.438 52.281 10.199
ruch     24  51.792 60.167 11.560

== 1. Test t (równe wariancje) i regresja 0/1 ==
t.test: t = -1.88  df = 62  p: 0.06479
95% CI (kontrola - ruch): -9.886 0.303
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   55.375      1.561  35.481    0.000
ruch           4.792      2.549   1.880    0.065
95% CI dla b: -0.303 9.886
F = 3.535  p: 0.06479  t^2 = 3.535  R2 = 0.054

== 2. ANOVA i regresja z dwiema zmiennymi 0/1 ==
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        2    855   427.3   4.289 0.0165 *
Residuals   93   9265    99.6
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   55.375      1.578  35.088    0.000
x_bierna      -3.094      2.367  -1.307    0.194
x_ruch         4.792      2.577   1.859    0.066
Regresja: F = 4.289  df = 2 93  p: 0.01652  R2 = 0.084
eta2 z ANOVA = SS_grupa / SS_całk = 0.084

== 3. Kategoria referencyjna i kodowanie ==
Zero-jedynkowe, referencja: kontrola
b0, b1, b2: 55.375 -3.094 4.792
t dla b1, b2: -1.307 1.859
p dla b1, b2: 0.194 0.066
F = 4.289  R2 = 0.084  suma kw. reszt = 9265.177
Zero-jedynkowe, referencja: ruch
b0, b1, b2: 60.167 -4.792 -7.885
t dla b1, b2: -1.859 -2.926
p dla b1, b2: 0.066 0.004
F = 4.289  R2 = 0.084  suma kw. reszt = 9265.177
Efektowe (contr.sum), kolejno: kontrola, bierna
b0, b1, b2: 55.941 -0.566 -3.66
t dla b1, b2: -0.409 -2.513
p dla b1, b2: 0.683 0.014
F = 4.289  R2 = 0.084  suma kw. reszt = 9265.177
Kontrasty planowane: przerwa vs brak, ruch vs bierna
b0, b1, b2: 55.941 0.849 7.885
t dla b1, b2: 0.409 2.926
p dla b1, b2: 0.683 0.004
F = 4.289  R2 = 0.084  suma kw. reszt = 9265.177
Średnia średnich grup: 55.941  średnia wszystkich osób: 55.542
Grupy jako liczby 1-3: F = 2.145  df = 1 94  R2 = 0.022

== 4. Korelacja i regresja ==
Pearson: r: 0.632  t = 7.901  df = 94  p: 5.159e-12
95% CI dla r: 0.494 0.739
             Estimate Std. Error t value Pr(>|t|)
(Intercept)     0.000       0.08   0.000        1
scale(przed)    0.632       0.08   7.901        0
Punktowo-dwuseryjna (ruch 0/1 a wynik): r: 0.232  t = 1.88  (test t z punktu 1, moduł: 1.88 )

== 5. ANCOVA: model z pomiarem wyjściowym ==
Analysis of Variance Table

Model 1: po ~ przed
Model 2: po ~ przed + grupa
  Res.Df    RSS Df Sum of Sq      F   Pr(>F)
1     94 6081.5
2     92 5403.9  2     677.6 5.7679 0.004366 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   20.633      4.453   4.634    0.000
przed          0.649      0.080   8.108    0.000
grupabierna   -0.426      1.847  -0.230    0.818
gruparuch      5.932      1.984   2.990    0.004
            Df Sum Sq Mean Sq F value   Pr(>F)
przed        1   4038    4038  68.751 8.88e-13 ***
grupa        2    678     339   5.768  0.00437 **
Residuals   92   5404      59
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
95% CI, ruch vs kontrola: 1.992 9.873
SD reszt bez kowariantu: 9.981  z kowariantem: 7.664
Średnie skorygowane (przy średnim wyniku przed):
kontrola   bierna     ruch
   54.20    53.77    60.13
Cząstkowe eta2 dla grupy: 0.111
Jednorodność nachyleń (model z interakcją):
Analysis of Variance Table

Model 1: po ~ przed + grupa
Model 2: po ~ przed * grupa
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1     92 5403.9
2     90 5280.3  2     123.6 1.0533  0.353

== 6. Welch ==
Welch: t = -1.753  df = 38.734  p: 0.08748
95% CI (kontrola - ruch): -10.321 0.738
Student: SE = 2.549  Welch: SE = 2.733
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   55.375      1.379  40.150    0.000
ruch           4.792      2.733   1.753    0.085
Regresja ważona, df reszt = 62
p z t ważonego i df Welcha: 0.08748

== 7. Test t dla prób zależnych = model z samą stałą ==
t.test paired: t = 4.272  df = 95  p: 4.594e-05  średnia różnica = 3.802
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    3.802       0.89   4.272        0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim oddasz rozdział, sprawdź
- Czy nazwa analizy w Metodzie, w tabeli i we Wnioskach jest ta sama?
- Czy zamiast dwóch „potwierdzających się” analiz podajesz jedną?
- Czy kategoria odniesienia, kontrasty i kowarianty pochodzą z planu?
- Czy zmienne grupowe są czynnikami albo zmiennymi 0/1, a nie numerami?
- Czy wiesz, czy Twój test t to Student, czy Welch, i czy df w tekście się z tym zgadzają?
- Czy przy porównaniach parami jest korekta albo plan kontrastów?
- Czy umiesz w jednym zdaniu powiedzieć, co oznacza każdy współczynnik w Twojej tabeli?
Najczęstsze pytania
Czy test t i regresja dają ten sam wynik?
Tak, jeśli test t liczony jest z założeniem równych wariancji, a regresja ma jedną zmienną 0/1. Współczynnik b to różnica średnich, a t, stopnie swobody i p są identyczne. W przykładzie w obu wersjach t(62) = 1.88, p = .065. Nie są to jednak dwa niezależne wyniki, więc w pracy podaj je raz.
Dlaczego test t w R nie zgadza się z wynikiem lm()?
Funkcja t.test() domyślnie liczy test Welcha, który dopuszcza różne wariancje w grupach. Funkcja lm() zakłada jedną wariancję reszt. Aby wyniki były równe, dodaj var.equal = TRUE. Nie znaczy to, że Student jest lepszy – Welch bywa zalecany jako domyślny.
Czy zmiana kategorii referencyjnej zmienia wynik regresji?
Zmienia współczynniki i ich testy, ale nie zmienia F całego modelu, R² ani przewidywanych średnich. Każda kategoria odniesienia to inny zestaw porównań. Ustal ją przed analizą, bo wybór tej, która daje istotny wynik, jest odmianą p-hackingu.
Jak odpowiedzieć na obronie, dlaczego ANOVA, a nie regresja?
Powiedz, że przy porównaniu grup to ten sam model liniowy i daje to samo F, a zapis ANOVA wynikał z hipotezy o różnicach i z planu analizy. Jeśli jednak zmienną ciągłą podzielono na grupy, tożsamość nie zachodzi i trzeba uzasadnić podział.
Czy ANCOVA to regresja z kowariantem?
Tak. To model z pomiarem kowariantu i zmiennymi 0/1 opisującymi grupy, a test grupy to porównanie modelu bez grupy z modelem z grupą. Współczynnik grupy jest różnicą skorygowaną o kowariant. Korekta nie wyrównuje jednak w pełni grup, które nie powstały przez losowanie.
Powiązane hasła
Przeczytaj też
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →Nie wiesz, czy w pracy opisać ANOVA, czy regresję?
Pomożemy dobrać model do hipotez, policzymy go w R lub SPSS i wyjaśnimy każdy współczynnik tak, żebyś umiał(a) samodzielnie opisać wynik i obronić wybór analizy.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1968). Multiple regression as a general data-analytic system. Psychological Bulletin, 70(6, Pt.1), 426–443. https://doi.org/10.1037/h0026714
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Gelman, A., Hill, J., & Vehtari, A. (2020). Regression and other stories. Cambridge University Press. https://doi.org/10.1017/9781139161879
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Schad, D. J., Vasishth, S., Hohenstein, S., & Kliegl, R. (2020). How to capitalize on a priori contrasts in linear (mixed) models: A tutorial. Journal of Memory and Language, 110, Article 104038. https://doi.org/10.1016/j.jml.2019.104038 ● Otwarty dostęp
- Suits, D. B. (1957). Use of dummy variables in regression equations. Journal of the American Statistical Association, 52(280), 548–551. https://doi.org/10.1080/01621459.1957.10501412
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@article{cohen1968multiple, author={Cohen, Jacob}, title={{Multiple regression as a general data-analytic system}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={6, Pt.1}, pages={426--443}, doi={10.1037/h0026714}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@book{gelman2020regression, author={Gelman, Andrew and Hill, Jennifer and Vehtari, Aki}, title={{Regression and other stories}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781139161879}}@article{miller2001misunderstanding, author={Miller, Gregory A. and Chapman, Jean P.}, title={{Misunderstanding analysis of covariance}}, journal={Journal of Abnormal Psychology}, year={2001}, volume={110}, number={1}, pages={40--48}, doi={10.1037/0021-843x.110.1.40}}@article{schad2020capitalize, author={Schad, Daniel J. and Vasishth, Shravan and Hohenstein, Sven and Kliegl, Reinhold}, title={{How to capitalize on a priori contrasts in linear (mixed) models: A tutorial}}, journal={Journal of Memory and Language}, year={2020}, volume={110}, eid={104038}, doi={10.1016/j.jml.2019.104038}}@article{suits1957use, author={Suits, Daniel B.}, title={{Use of dummy variables in regression equations}}, journal={Journal of the American Statistical Association}, year={1957}, volume={52}, number={280}, pages={548--551}, doi={10.1080/01621459.1957.10501412}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}