Hipoteza mówiła „mniej stresu”, a wyszło „więcej”
Przewidujesz, że po warsztacie stres będzie niższy. Test wychodzi istotny, tylko że stres jest wyższy. To inna sytuacja niż wynik nieistotny: dane mówią coś wyraźnego, ale nie to, co zakładała hipoteza. Pisząc o wyniku bez efektu, skorzystaj z poradnika jak opisać wynik nieistotny. Tutaj zajmujemy się kierunkiem.
Kolejność jest ważna: najpierw kontrola danych, potem artefakty, na końcu interpretacja. Student, który zaczyna od szukania teorii tłumaczącej „odwrotny” wynik, może napisać dwie strony o czymś, co było zamianą kodów 1 i 2.
Przykład przewodni (fikcyjny, dane symulowane). Studentka bada warsztat radzenia sobie ze stresem. Hipoteza 1: osoby po warsztacie mają niższy wynik skali stresu (średnia pozycji, 1–5) niż grupa porównawcza. Hipoteza 2: im większe wsparcie, tym niższy stres. Hipoteza 3 w innym badaniu: im więcej godzin superwizji, tym mniejsze wyczerpanie pielęgniarek.
Najpierw sprawdzenie: sześć miejsc, w których znak się odwraca
Na tym etapie nie myślisz o teorii. Zadajesz jedno pytanie: czy liczba ze znakiem minus lub plus oznacza to, co myślisz, że oznacza.
| Miejsce | Co sprawdzić | Sygnał usterki |
|---|---|---|
| Kodowanie grup | Zmienna o kierunku znanym na pewno: frekwencja, lista uczestników, data zabiegu | Frekwencja większa od zera w grupie „porównawczej” |
| Kierunek skali | Klucz z artykułu lub podręcznika: czy wyższy wynik znaczy więcej cechy; korelacja ze zmienną o znanym kierunku | Skala jakości życia czytana jak skala objawów |
| Pozycje odwrócone | Czy pozycje odwrócone przekodowano zgodnie z kluczem; korelacja pozycji z sumą pozostałych | Korelacje pozycji o różnych znakach |
| Etykiety odpowiedzi | Eksport a formularz: czy 1 to „zdecydowanie tak”, czy „zdecydowanie nie”; czy opcji nie zmieniano w trakcie (usterki w ankiecie) | Etykiety w pliku inne niż w ankiecie |
| Znak w kontraście i regresji | Która grupa jest odejmowana od której; kategoria referencyjna w modelu; kolejność grup w oknie testu t w SPSS; poziomy czynnika w R | Dodatnie b, które opisuje inną grupę, niż zakładasz |
| Złączenie plików | Liczba wierszy przed i po, unikalność ID, zgodność zmiennej zapisanej w obu plikach (łączenie plików, import z Excela) | Inna liczba wierszy, wiek niezgodny między plikami |
Przesunięte wiersze zwykle raczej rozmywają związek, niż go porządnie odwracają, dlatego sprawdź je także wtedy, gdy wynik wygląda wiarygodnie. Dwie reguły:
- Tę samą listę przejdź przy każdej hipotezie. Jeśli sprawdzasz tylko wyniki niewygodne, zostają w pracy błędy działające na korzyść hipotezy. Zapisuj kontrole w dzienniku zmian.
- Kod zmieniaj wyłącznie na podstawie dokumentu: eksportu formularza, listy uczestników, klucza. Odwrócenie kodu dlatego, że wynik „nie pasuje”, to fałszowanie danych.
Odwrócone kodowanie grupy
W eksporcie są kody 1 i 2, po 55 osób. Studentka przyjęła, że 1 to warsztat. Wyszło: „warsztat” M = 3.20, „porównawcza” M = 2.90, t(107.37) = 2.40, p = .018, a więc stres wyższy po warsztacie. Kontrola: osoby z kodem 1 miały średnią frekwencję na spotkaniach 0.00 (wszystkie 55 bez żadnego spotkania), osoby z kodem 2 – 4.84. Kod 1 to grupa porównawcza.
Po poprawce różnica warsztat minus porównawcza wynosi −0.30, 95% CI [−0.54, −0.05], t(107.37) = −2.40, p = .018. W regresji to samo zależy od kategorii referencyjnej: b = −0.296 albo b = 0.296, przy tym samym SE = 0.123 i tym samym p. Wartość bezwzględna t i p są identyczne, więc po samym wydruku usterki nie zobaczysz. Wymaga ona informacji spoza testu.
Nieprzekodowane pozycje odwrócone
Skala wsparcia ma sześć pozycji, z których cztery są odwrócone. Bez przekodowania korelacja ze stresem wyniosła r(148) = .29, 95% CI [.13, .43], p < .001, czyli przeciwnie do hipotezy 2. Po przekodowaniu: r(148) = −.44, 95% CI [−.56, −.31], p < .001. Korelacje pozycji z sumą pozostałych w danych surowych miały różne znaki (od −.57 do .36). To sygnał ostrzegawczy, ale o tym, które pozycje odwrócić, decyduje klucz, nie korelacja.
Dane są poprawne: artefakty, które odwracają znak
Skoro kody się zgadzają, kierunek może być prawdziwą cechą tych danych, ale nie odpowiedzią na pytanie z hipotezy. Najczęstszy mechanizm to pominięta zmienna zakłócająca, w skrajnej postaci paradoks Simpsona. Kievit i in. (2013) wskazują, że odwrócenie kierunku związku między populacją a podgrupami zdarza się częściej, niż się przyjmuje, i zwykle prowadzi do błędnych interpretacji.
Przykład z hipotezą 3: 120 pielęgniarek z trzech oddziałów. W całej próbie więcej superwizji idzie w parze z większym wyczerpaniem: r(118) = .67, p < .001, b = 0.185, 95% CI [0.148, 0.223]. Oddziały bardziej obciążone dostają jednak więcej godzin superwizji i są bardziej wyczerpane (oddział A: 2.2 godziny, M = 2.60; oddział C: 7.9 godziny, M = 4.00). W każdym oddziale związek jest ujemny, zgodny z hipotezą: r = −.41, −.50 i −.37. Model z oddziałem daje b = −0.173, 95% CI [−0.241, −0.105], t(116) = −5.01, p < .001.
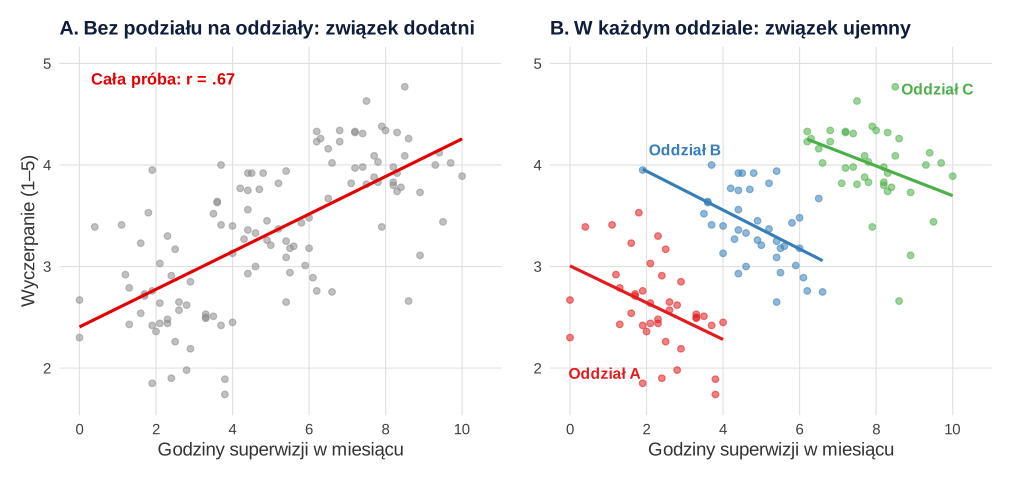
Uwaga: model z oddziałem nie jest automatycznie „prawdziwszy”. Z samych danych nie wynika, czy trzecia zmienna zakłóca związek, czy leży na drodze przyczynowej. O tym decyduje wiedza o badaniu. Jeśli oddziału nie było w planie analizy, podaj oba wyniki, a model z oddziałem oznacz jako dodatkowy. Dzielenie próby według kolejnych zmiennych, aż znak będzie „właściwy”, to p-hacking, a o wiarygodności takich podziałów piszemy w tekście o analizie podgrup.
| Mechanizm | Jak odwraca znak | Co sprawdzić |
|---|---|---|
| Regresja do średniej | Do programu wybrano osoby z wyjątkowo dobrym wynikiem wstępnym; później ich wynik spada, jakby program szkodził. Efekt jest silniejszy przy większym błędzie pomiaru i przy doborze na podstawie pomiaru wyjściowego (Barnett i in., 2005) | Jak wybierano osoby; wyniki przed programem w obu grupach |
| Samoselekcja | W schemacie bez losowania na warsztat zgłaszają się osoby bardziej zestresowane, więc po nim nadal mają wyższy wynik | Pomiar wyjściowy, sposób zapisów |
| Błąd selekcji | Do próby trafiają osoby wybrane według zmiennej zależnej od predyktora i wyniku. Takie warunkowanie to endogenny błąd selekcji (Elwert i Winship, 2014); może zniekształcić związek, także co do kierunku | Kto odpadł i dlaczego (diagram przepływu) |
| Supresja | W regresji z silnie skorelowanymi predyktorami znak b różni się od znaku korelacji prostej | Macierz korelacji obok tabeli regresji |
A może przypadek? Błąd znaku przy małej mocy
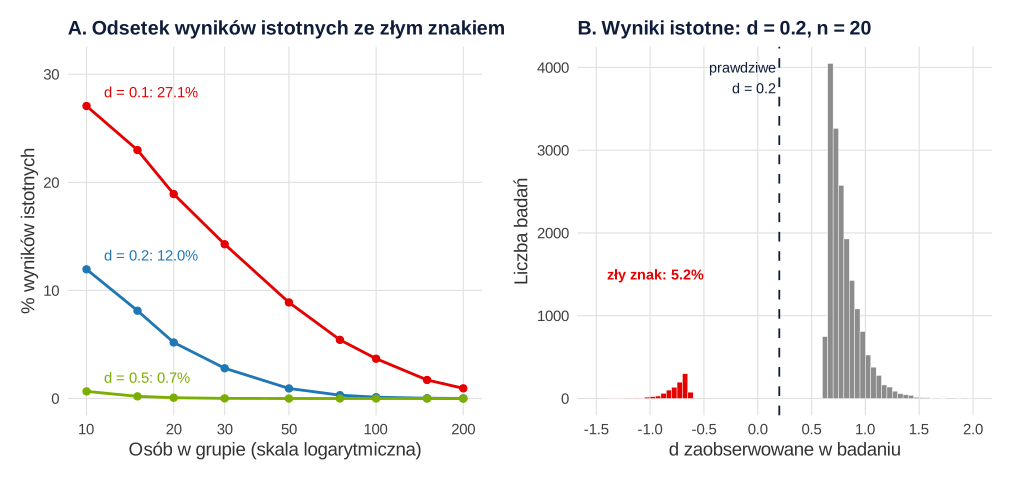
Gelman i Carlin (2014) proponują, by oprócz mocy szacować prawdopodobieństwo, że oszacowanie ma zły kierunek. Nazywają to błędem typu S i zauważają, że w badaniach zaszumionych i na małych próbach wyniki istotne często wprowadzają w błąd. Symulacja: efekt prawdziwy jest zgodny z hipotezą albo równy zero, dwie grupy, test Welcha, 200 000 badań na wiersz.
| Prawdziwe d | Osób w grupie | Istotne, dobry kierunek | Istotne, zły kierunek | Zły kierunek wśród istotnych |
|---|---|---|---|---|
| 0 | 30 | 2.50% | 2.52% | 50.20% |
| 0.1 | 20 | 4.85% | 1.13% | 18.92% |
| 0.2 | 20 | 8.82% | 0.48% | 5.19% |
| 0.2 | 50 | 16.83% | 0.16% | 0.93% |
| 0.5 | 20 | 33.55% | 0.03% | 0.07% |
| 0.5 | 50 | 69.63% | 0.00% | 0.00% |
Co z tego wynika:
- Istotny wynik w złą stronę jest rzadki w skali wszystkich badań. Gdy efekt prawdziwy idzie w kierunku hipotezy lub wynosi zero, przy dwustronnym α = .05 dotyczy to najwyżej około 2.5% badań. Dlatego przypadek sprawdzaj po kontroli danych, nie przed nią.
- Przy małej mocy wśród wyników istotnych zły znak nie jest egzotyką. Dla d = 0.1 i 20 osób w grupie to 18.92%. Button i in. (2013) przypominają, że niska moc obniża też szansę, że wynik istotny odzwierciedla prawdziwy efekt.
- Wynik istotny przy małej próbie jest zawyżony. Przy prawdziwym d = 0.2 i 20 osobach w grupie istotne było tylko |d| ≥ 0.64, średnio 0.80. Duży efekt „w złą stronę” nie jest więc dowodem, że efekt jest duży.
- To liczby dla założonego efektu, a nie prawdopodobieństwo, że Twój wynik jest przypadkowy. Gelman i Carlin (2014) za największą trudność uznają ustalenie wiarygodnych wielkości efektu na podstawie informacji zewnętrznych. Weź je z literatury. Nie wstawiaj własnego d, z tego samego powodu, dla którego nie liczy się mocy po fakcie.
Jak opisać wynik w rozdziale Wyników
Załóżmy, że dane są poprawne: po 50 osób w grupie, stres wyższy po warsztacie. Hipoteza zostaje w brzmieniu z rozdziału metodologicznego. Kerr (1998) nazywa HARKingiem przedstawianie hipotezy opartej na wynikach tak, jakby powstała przed badaniem, a Rubin (2017) zalicza do tej rodziny także pomijanie niepotwierdzonych hipotez (HARKing). Nie dopisuj więc w Metodzie „zakładano wzrost”.
Plan: test dwustronny
Hipoteza badawcza może być kierunkowa, a test dwustronny (pytanie kierunkowe nie wymusza testu jednostronnego). Wynik istotny po drugiej stronie opisujesz wtedy wprost.
Plan: test jednostronny
Przy zaplanowanym teście jednostronnym wynik po drugiej stronie w ogóle nie jest „istotny”: tu p = .988. Ruxton i Neuhäuser (2010) stawiają przy wyborze takiego testu warunek: autor musi wyjaśnić, dlaczego duży efekt w nieoczekiwanym kierunku potraktuje tak samo jak zbyt słaby efekt w oczekiwanym. Po wyniku nie zamieniaj testu na dwustronny ani na jednostronny w drugą stronę (p = .012 to połowa dwustronnego .024, uzyskana przez wybór kierunku po obejrzeniu danych).
Po poprawieniu usterki
Jeśli znak był błędny, opisz korektę w Metodzie. Nikt nie oczekuje, że dane będą bezbłędne za pierwszym razem. Oczekuje się, że powiesz, co zrobiono.
Przy analizie dodatkowej z trzecią zmienną (dane z hipotezy 3):
Dyskusja: wyjaśnienia jako hipotezy na przyszłość
Ogólne zasady są w poradniku o dyskusji wyników. Przy wyniku przeciwnym ważne są trzy rzeczy: powiedz wprost, że się go nie spodziewano, podaj kilka konkurencyjnych wyjaśnień zamiast jednego i nie przedstawiaj żadnego z nich jako ustalonego. Wyjaśnienie wymyślone po wyniku jest hipotezą do kolejnego badania, także wtedy, gdy brzmi przekonująco. Mechanizmy, których nie mierzono, opisz w ograniczeniach.
Jak bywa napisane, co nie tak, jak poprawić
| Jak bywa napisane | Co nie tak | Poprawione |
|---|---|---|
| „Hipoteza została częściowo potwierdzona, bo różnica jest istotna”. | Istotność w przeciwną stronę nie potwierdza hipotezy | „Hipoteza nie została potwierdzona: różnica była istotna, ale w kierunku przeciwnym”. |
| „Wykazano, że warsztat zwiększa stres”. | Język przyczynowy bez losowania | „Uczestnicy warsztatu deklarowali wyższy stres niż grupa porównawcza”. |
| „Założono, że udział w warsztacie wiąże się z wyższym stresem”. | Hipoteza przepisana po wyniku | Pierwotna hipoteza; nowe wyjaśnienie tylko w Dyskusji |
| „Test jednostronny: p = .012 na korzyść grupy porównawczej”. | Kierunek testu wybrany po wyniku | Zaplanowany test i jego p; opis kierunku jako obserwacji |
| „Wynik pominięto, ponieważ był niezgodny z literaturą”. | Selektywne raportowanie | Pełny wynik z przedziałem ufności i kontrolą danych |
| „Wynik jest artefaktem wynikającym z małej próby”. | Przypuszczenie podane jako fakt; przy wyniku zgodnym z hipotezą próba nie byłaby problemem | „Przy tej liczebności przypadku nie można wykluczyć, a przedział ufności jest szeroki”. |
Rozmowa z promotorem
Przyjdź z tabelą kontroli, wynikiem i propozycją opisu, nie z pytaniem „co teraz”. Jeśli promotor zaproponuje zmianę hipotezy, spokojnie zaproponuj zapis z etykietą analizy dodatkowej, jak we wpisie o prośbach o analizy, które nie działają.
Przykłady, nazwy i liczby w tym wpisie są fikcyjne. Gdy termin jest bliski, pomocna będzie lista priorytetów, a przed oddaniem kontrola spójności liczb.
Znak wyniku w R: kodowanie, Simpson i błąd typu S
Trzy przepisy liczą wszystkie liczby z tekstu i tabel, a rysunki powstały na tych samych wynikach. Parametry (średnie grup, wielkości prób, związek w oddziałach) ustawiono ręcznie tak, by przykłady odpowiadały opisanym sytuacjom. Dane są symulowane.
Kodowanie grupy, pozycje odwrócone, wynik przeciwny
R
# Przykład fikcyjny: warsztat radzenia sobie ze stresem (dane symulowane)
library(effectsize)

p3 <- function(p) {
  if (p < .001) "p < .001" else paste0("p = ", sub("^0", "", sprintf("%.3f", p)))
}
opis <- function(y, g) {
  round(sapply(split(y, g), function(x) c(n = length(x), M = mean(x), SD = sd(x))), 2)
}

set.seed(511)

# 1. ODWRÓCONE KODOWANIE GRUPY
# Hipoteza: po warsztacie stres jest niższy niż w grupie porównawczej.
# Prawda w danych: kod 1 = grupa porównawcza, kod 2 = warsztat.
# Na początku przyjęto odwrotnie: kod 1 = warsztat.
n <- 55
kod_grupy <- rep(c(1, 2), each = n)
stres <- round(pmin(pmax(rnorm(2 * n, ifelse(kod_grupy == 1, 3.30, 2.85), 0.70), 1), 5), 2)
frekwencja <- ifelse(kod_grupy == 2, sample(3:6, n, replace = TRUE), 0)

grupa_bledna <- factor(kod_grupy, levels = c(1, 2), labels = c("warsztat", "porownawcza"))
cat("A. Etykiety przyjęte na początku\n")
print(opis(stres, grupa_bledna))
t_zle <- t.test(stres ~ grupa_bledna)
cat(sprintf("Welch (warsztat - porownawcza): t(%.2f) = %.2f, %s, różnica = %.2f\n\n",
            t_zle$parameter, t_zle$statistic, p3(t_zle$p.value), -diff(t_zle$estimate)))

# Kontrola znaku: zmienna, której kierunek znasz na pewno
cat("B. Kontrola: średnia frekwencja na spotkaniach według kodu\n")
print(tapply(frekwencja, kod_grupy, mean))
cat("Osoby z frekwencją > 0 według kodu\n")
print(table(kod_grupy, frekwencja > 0))

grupa <- factor(kod_grupy, levels = c(2, 1), labels = c("warsztat", "porownawcza"))
cat("\nC. Etykiety poprawione\n")
print(opis(stres, grupa))
t_ok <- t.test(stres ~ grupa)
cat(sprintf("Welch (warsztat - porownawcza): t(%.2f) = %.2f, %s, różnica = %.2f, 95%% CI [%.2f, %.2f]\n\n",
            t_ok$parameter, t_ok$statistic, p3(t_ok$p.value), -diff(t_ok$estimate),
            t_ok$conf.int[1], t_ok$conf.int[2]))

# Ten sam model, dwie kategorie referencyjne
cat("D. Regresja: znak b zależy od kategorii referencyjnej\n")
m_por <- lm(stres ~ relevel(grupa, ref = "porownawcza"))
m_war <- lm(stres ~ relevel(grupa, ref = "warsztat"))
print(round(rbind(ref_porownawcza = coef(summary(m_por))[2, ],
                  ref_warsztat    = coef(summary(m_war))[2, ]), 4))

# 2. NIEPRZEKODOWANE POZYCJE ODWRÓCONE
# Hipoteza: im większe wsparcie, tym niższy stres. Pozycje 2, 3, 5 i 6 są odwrócone.
N <- 150
wsparcie_ukryte <- rnorm(N)
stres2 <- round(pmin(pmax(3 - 0.30 * wsparcie_ukryte + rnorm(N, 0, 0.62), 1), 5), 2)
pozycja <- function() {
  as.integer(pmin(pmax(round(3 + 0.80 * wsparcie_ukryte + rnorm(N, 0, 0.75)), 1), 5))
}
surowe <- as.data.frame(replicate(6, pozycja()))
names(surowe) <- paste0("w", 1:6)
odwrocone <- c("w2", "w3", "w5", "w6")
surowe[odwrocone] <- 6 - surowe[odwrocone]

poprawne <- surowe
poprawne[odwrocone] <- 6 - poprawne[odwrocone]
wynik_zly <- rowMeans(surowe)
wynik_dobry <- rowMeans(poprawne)

raport_r <- function(x, y, etykieta) {
  k <- cor.test(x, y)
  cat(sprintf("%s: r(%d) = %s, 95%% CI [%s, %s], %s\n", etykieta, k$parameter,
              sub("0\\.", ".", sprintf("%.2f", k$estimate)),
              sub("0\\.", ".", sprintf("%.2f", k$conf.int[1])),
              sub("0\\.", ".", sprintf("%.2f", k$conf.int[2])), p3(k$p.value)))
}
cat("\nE. Wsparcie a stres\n")
raport_r(wynik_zly, stres2, "Bez przekodowania")
raport_r(wynik_dobry, stres2, "Po przekodowaniu ")

cat("\nKorelacja pozycji z sumą pozostałych, dane surowe\n")
print(round(sapply(names(surowe), function(p) {
  cor(surowe[[p]], rowSums(surowe[setdiff(names(surowe), p)]))
}), 2))

# 3. WYNIK NAPRAWDĘ PRZECIWNY: etykiety i klucz sprawdzone
n3 <- 50
grupa3 <- factor(rep(c("warsztat", "porownawcza"), each = n3),
                 levels = c("warsztat", "porownawcza"))
stres3 <- round(pmin(pmax(rnorm(2 * n3, ifelse(grupa3 == "warsztat", 3.35, 2.95), 0.72), 1), 5), 2)

cat("\nF. Wynik przeciwny po kontroli danych\n")
print(opis(stres3, grupa3))
t_dw <- t.test(stres3 ~ grupa3)
t_je <- t.test(stres3 ~ grupa3, alternative = "less")  # H1: warsztat < porownawcza
d3 <- cohens_d(stres3 ~ grupa3, pooled_sd = TRUE)
cat(sprintf("Welch, test dwustronny: t(%.2f) = %.2f, %s\n",
            t_dw$parameter, t_dw$statistic, p3(t_dw$p.value)))
cat(sprintf("Różnica = %.2f, 95%% CI [%.2f, %.2f]\n",
            -diff(t_dw$estimate), t_dw$conf.int[1], t_dw$conf.int[2]))
cat(sprintf("d = %.2f, 95%% CI [%.2f, %.2f]\n", d3$Cohens_d, d3$CI_low, d3$CI_high))
cat(sprintf("Test jednostronny w kierunku hipotezy: %s\n", p3(t_je$p.value)))
t_odwr <- t.test(stres3 ~ grupa3, alternative = "greater")
cat(sprintf("Test jednostronny z kierunkiem zmienionym po wyniku: %s\n", p3(t_odwr$p.value)))
Wynik
A. Etykiety przyjęte na początku
   warsztat porownawcza
n     55.00       55.00
M      3.20        2.90
SD     0.62        0.67
Welch (warsztat - porownawcza): t(107.37) = 2.40, p = .018, różnica = 0.30

B. Kontrola: średnia frekwencja na spotkaniach według kodu
       1        2
0.000000 4.836364
Osoby z frekwencją > 0 według kodu

kod_grupy FALSE TRUE
        1    55    0
        2     0   55

C. Etykiety poprawione
   warsztat porownawcza
n     55.00       55.00
M      2.90        3.20
SD     0.67        0.62
Welch (warsztat - porownawcza): t(107.37) = -2.40, p = .018, różnica = -0.30, 95% CI [-0.54, -0.05]

D. Regresja: znak b zależy od kategorii referencyjnej
                Estimate Std. Error t value Pr(>|t|)
ref_porownawcza  -0.2956     0.1232 -2.4006   0.0181
ref_warsztat      0.2956     0.1232  2.4006   0.0181

E. Wsparcie a stres
Bez przekodowania: r(148) = .29, 95% CI [.13, .43], p < .001
Po przekodowaniu : r(148) = -.44, 95% CI [-.56, -.31], p < .001

Korelacja pozycji z sumą pozostałych, dane surowe
   w1    w2    w3    w4    w5    w6
-0.54  0.09  0.20 -0.57  0.34  0.36

F. Wynik przeciwny po kontroli danych
   warsztat porownawcza
n     50.00       50.00
M      3.24        2.91
SD     0.62        0.83
Welch, test dwustronny: t(91.05) = 2.29, p = .024
Różnica = 0.33, 95% CI [0.04, 0.63]
d = 0.46, 95% CI [0.06, 0.85]
Test jednostronny w kierunku hipotezy: p = .988
Test jednostronny z kierunkiem zmienionym po wyniku: p = .012
Odwrócenie związku w podgrupach
R
# Przykład fikcyjny: superwizja a wyczerpanie w trzech oddziałach (dane symulowane)
set.seed(5112)

na_oddzial <- 40
oddzial <- factor(rep(c("A", "B", "C"), each = na_oddzial))
# Oddziały bardziej obciążone dostają więcej superwizji i są bardziej wyczerpane.
sr_x <- c(A = 2, B = 5, C = 8)
sr_y <- c(A = 2.60, B = 3.30, C = 4.00)
superwizja <- round(pmax(rnorm(3 * na_oddzial, sr_x[oddzial], 1.0), 0), 1)
# W każdym oddziale wpisano ujemny związek: -0.15 punktu na godzinę
wyczerpanie <- round(pmin(pmax(
  sr_y[oddzial] - 0.15 * (superwizja - sr_x[oddzial]) + rnorm(3 * na_oddzial, 0, 0.35),
  1), 5), 2)

p3 <- function(p) {
  if (p < .001) "p < .001" else paste0("p = ", sub("^0", "", sprintf("%.3f", p)))
}
bez0 <- function(x) sub("0\\.", ".", sprintf("%.2f", x))

k <- cor.test(superwizja, wyczerpanie)
cat(sprintf("Cała próba: r(%d) = %s, %s\n", k$parameter, bez0(k$estimate), p3(k$p.value)))
m0 <- lm(wyczerpanie ~ superwizja)
cat(sprintf("Regresja bez oddziału: b = %.3f, 95%% CI [%.3f, %.3f]\n\n",
            coef(m0)[2], confint(m0)[2, 1], confint(m0)[2, 2]))

cat("W oddziałach\n")
for (o in levels(oddzial)) {
  w <- oddzial == o
  kw <- cor.test(superwizja[w], wyczerpanie[w])
  bw <- coef(lm(wyczerpanie[w] ~ superwizja[w]))[2]
  cat(sprintf("%s: M godzin = %.1f, M wyczerpania = %.2f, r(%d) = %s, b = %.3f, %s\n", o,
              mean(superwizja[w]), mean(wyczerpanie[w]), kw$parameter,
              sub("^(-?)0\\.", "\\1.", sprintf("%.2f", kw$estimate)), bw, p3(kw$p.value)))
}

m1 <- lm(wyczerpanie ~ superwizja + oddzial)
s1 <- coef(summary(m1))["superwizja", ]
cat(sprintf("\nModel z oddziałem: b = %.3f, 95%% CI [%.3f, %.3f], t(%d) = %.2f, %s\n",
            s1[1], confint(m1)["superwizja", 1], confint(m1)["superwizja", 2],
            m1$df.residual, s1[3], p3(s1[4])))
Wynik
Cała próba: r(118) = .67, p < .001
Regresja bez oddziału: b = 0.185, 95% CI [0.148, 0.223]

W oddziałach
A: M godzin = 2.2, M wyczerpania = 2.60, r(38) = -.41, b = -0.181, p = .009
B: M godzin = 4.9, M wyczerpania = 3.39, r(38) = -.50, b = -0.192, p = .001
C: M godzin = 7.9, M wyczerpania = 4.00, r(38) = -.37, b = -0.146, p = .020

Model z oddziałem: b = -0.173, 95% CI [-0.241, -0.105], t(116) = -5.01, p < .001
Symulacja błędu typu S
R
# Jak często wynik istotny ma zły znak? Prawdziwy efekt jest w kierunku hipotezy.
# Dwie grupy po n osób, rozkład normalny, SD = 1, test Welcha, alfa = .05.
set.seed(5113)

jedno_ustawienie <- function(d, n, powt = 200000) {
  # Średnie i wariancje losowane z ich dokładnych rozkładów:
  # to samo co losowanie osób, ale szybciej
  m1 <- rnorm(powt, d, 1 / sqrt(n))
  m2 <- rnorm(powt, 0, 1 / sqrt(n))
  v1 <- rchisq(powt, n - 1) / (n - 1)
  v2 <- rchisq(powt, n - 1) / (n - 1)
  se2 <- v1 / n + v2 / n
  t_stat <- (m1 - m2) / sqrt(se2)
  df <- se2^2 / ((v1 / n)^2 / (n - 1) + (v2 / n)^2 / (n - 1))
  istotny <- 2 * pt(-abs(t_stat), df) < .05
  zly_znak <- istotny & t_stat < 0
  d_obs <- (m1 - m2) / sqrt((v1 + v2) / 2)
  list(wiersz = data.frame(
         d = d, n = n,
         istotne_w_dobra = 100 * mean(istotny & t_stat > 0),
         istotne_w_zla = 100 * mean(zly_znak),
         zly_wsrod_istotnych = 100 * sum(zly_znak) / sum(istotny)),
       d_istotne = d_obs[istotny])
}

siatka <- expand.grid(n = c(10, 15, 20, 30, 50, 75, 100, 150, 200), d = c(0, 0.1, 0.2, 0.5))
wyniki <- Map(jedno_ustawienie, siatka$d, siatka$n)
tabela <- do.call(rbind, lapply(wyniki, `[[`, "wiersz"))
tabela <- tabela[order(tabela$d, tabela$n), ]
cat("Wartości w procentach (200 000 badań na wiersz)\n")
print(cbind(tabela[, 1:2], round(tabela[, 3:5], 2)), row.names = FALSE)

przyklad <- wyniki[[which(siatka$d == 0.2 & siatka$n == 20)]]
d_ist <- przyklad$d_istotne
cat(sprintf("\nd = 0.2, n = 20: istotnych wyników %d, w tym ze złym znakiem %.2f%%\n",
            length(d_ist), przyklad$wiersz$zly_wsrod_istotnych))
cat(sprintf("Najmniejsze istotne |d|: %.2f; średnie |d| wśród istotnych: %.2f\n",
            min(abs(d_ist)), mean(abs(d_ist))))
Wynik
Wartości w procentach (200 000 badań na wiersz)
   d   n istotne_w_dobra istotne_w_zla zly_wsrod_istotnych
 0.0  10            2.40          2.46               50.63
 0.0  15            2.41          2.51               51.06
 0.0  20            2.44          2.52               50.82
 0.0  30            2.50          2.52               50.20
 0.0  50            2.53          2.52               49.91
 0.0  75            2.49          2.50               50.06
 0.0 100            2.54          2.49               49.56
 0.0 150            2.42          2.45               50.34
 0.0 200            2.50          2.51               50.10
 0.1  10            3.92          1.45               27.06
 0.1  15            4.45          1.33               22.99
 0.1  20            4.85          1.13               18.92
 0.1  30            5.72          0.95               14.27
 0.1  50            7.26          0.71                8.89
 0.1  75            8.80          0.50                5.43
 0.1 100           10.54          0.40                3.68
 0.1 150           13.77          0.24                1.72
 0.1 200           16.71          0.16                0.94
 0.2  10            6.12          0.83               11.96
 0.2  15            7.50          0.66                8.12
 0.2  20            8.82          0.48                5.19
 0.2  30           11.50          0.33                2.80
 0.2  50           16.83          0.16                0.93
 0.2  75           22.88          0.07                0.31
 0.2 100           28.89          0.04                0.12
 0.2 150           40.78          0.01                0.03
 0.2 200           51.55          0.00                0.01
 0.5  10           18.08          0.12                0.66
 0.5  15           26.10          0.05                0.20
 0.5  20           33.55          0.03                0.07
 0.5  30           47.72          0.01                0.01
 0.5  50           69.63          0.00                0.00
 0.5  75           86.05          0.00                0.00
 0.5 100           94.07          0.00                0.00
 0.5 150           99.08          0.00                0.00
 0.5 200           99.87          0.00                0.00

d = 0.2, n = 20: istotnych wyników 18605, w tym ze złym znakiem 5.19%
Najmniejsze istotne |d|: 0.64; średnie |d| wśród istotnych: 0.80
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem effectsize; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim opiszesz wynik przeciwny, sprawdź
- Czy grupy zweryfikowano zmienną o znanym kierunku, a nie tylko opisem zmiennych?
- Czy kierunek skali i pozycje odwrócone zgadzają się z kluczem?
- Czy etykiety w pliku odpowiadają ankiecie?
- Czy wiesz, która grupa jest odejmowana od której i jaka jest kategoria referencyjna?
- Czy liczba wierszy i ID zgadzają się po złączeniu plików?
- Czy tę samą kontrolę przeszły wszystkie hipotezy i czy wpisano ją do dziennika?
- Czy rozważono zakłócenie, sposób doboru osób i regresję do średniej?
- Czy hipoteza ma pierwotne brzmienie, a raport stwierdza, że się nie potwierdziła?
- Czy test jest tym z planu, z d i przedziałem ufności?
- Czy wyjaśnienia w Dyskusji oznaczono jako sformułowane po wyniku?
Najczęstsze pytania
Co zrobić, gdy wynik jest istotny, ale odwrotny niż hipoteza?
Najpierw sprawdź kodowanie grup, kierunek skali, pozycje odwrócone, etykiety, znak w kontraście lub regresji i złączenie plików. Jeśli dane są poprawne, rozważ artefakty, np. zmienną zakłócającą. W pracy napisz, że hipoteza się nie potwierdziła, a różnica była istotna w kierunku przeciwnym.
Czy hipoteza jest potwierdzona, jeśli wynik jest istotny w drugą stronę?
Nie. Hipoteza kierunkowa jest potwierdzona tylko wtedy, gdy efekt ma przewidywany kierunek. Wynik istotny po drugiej stronie opisz jako niepotwierdzający hipotezy i podaj wielkość efektu z przedziałem ufności.
Czy można zmienić hipotezę po uzyskaniu wyniku przeciwnego?
Nie w części o hipotezach. Przedstawianie hipotezy opartej na wynikach tak, jakby powstała przed badaniem, to HARKing. Nowe wyjaśnienia umieść w Dyskusji i zaznacz, że powstały po poznaniu wyników.
Test jednostronny dał odwrotny wynik – co napisać?
W zaplanowanym teście jednostronnym wynik po drugiej stronie nie jest istotny: w naszym przykładzie p = .988. Napisz, że nie odrzucono hipotezy zerowej, a obserwowany kierunek podaj jako obserwację eksploracyjną. Nie zmieniaj testu po wyniku.
Skąd może wziąć się odwrotny znak w regresji?
Najczęściej z kategorii referencyjnej, zamienionych kodów lub nieprzekodowanych pozycji. Gdy dane są poprawne, przyczyną bywa zmienna zakłócająca, paradoks Simpsona lub supresja. Porównaj znak współczynnika z korelacją prostą i sprawdź, czy zmienna w modelu była zaplanowana.
Czy mała próba może dać istotny wynik w złym kierunku?
Tak, choć rzadko w skali wszystkich badań: przy dwustronnym α = .05 najwyżej około 2.5%. Wśród wyników istotnych udział ten bywa jednak duży, np. 18.92% przy d = 0.1 i 20 osobach w grupie w naszej symulacji. To błąd typu S.
Powiązane hasła
Przeczytaj też
Wynik wygląda podejrzanie
Tabela objaw × przyczyna × test, plik CSV z usterkami, kod R z wynikami przed naprawą i po niej oraz lista kontrolna na 10 minut.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →PoradnikJak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →PoradnikTest jednostronny czy dwustronny?
Kiedy test jednostronny jest uprawniony, co zmienia w p, wartości krytycznej i liczebności próby oraz jak opisać wybór kierunku testu w pracy.
Czytaj →PoradnikBłąd w ankiecie po zebraniu danych
Dwanaście usterek formularza: jak je wykryć, co zrobić i co napisać w pracy, z symulowaną ankietą w R i gotowymi zdaniami.
Czytaj →Wynik wyszedł odwrotnie, niż zakłada hipoteza?
Sprawdzimy kodowanie i analizę w R lub SPSS, a potem wyjaśnimy wynik tak, żebyś umiał(a) samodzielnie go opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Elwert, F., & Winship, C. (2014). Endogenous selection bias: The problem of conditioning on a collider variable. Annual Review of Sociology, 40(1), 31–53. https://doi.org/10.1146/annurev-soc-071913-043455 ● Otwarty dostęp
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. https://doi.org/10.1207/s15327957pspr0203_4
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
- Rubin, M. (2017). When does HARKing hurt? Identifying when different types of undisclosed post hoc hypothesizing harm scientific progress. Review of General Psychology, 21(4), 308–320. https://doi.org/10.1037/gpr0000128 ● Otwarty dostęp
- Ruxton, G. D., & Neuhäuser, M. (2010). When should we use one-tailed hypothesis testing? Methods in Ecology and Evolution, 1(2), 114–117. https://doi.org/10.1111/j.2041-210X.2010.00014.x ● Otwarty dostęp
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{elwert2014endogenous, author={Elwert, Felix and Winship, Christopher}, title={{Endogenous selection bias: The problem of conditioning on a collider variable}}, journal={Annual Review of Sociology}, year={2014}, volume={40}, number={1}, pages={31--53}, doi={10.1146/annurev-soc-071913-043455}}@article{gelman2014beyond, author={Gelman, Andrew and Carlin, John}, title={{Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={6}, pages={641--651}, doi={10.1177/1745691614551642}}@article{kerr1998harking, author={Kerr, Norbert L.}, title={{HARKing: Hypothesizing after the results are known}}, journal={Personality and Social Psychology Review}, year={1998}, volume={2}, number={3}, pages={196--217}, doi={10.1207/s15327957pspr0203_4}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}@article{rubin2017when, author={Rubin, Mark}, title={{When does HARKing hurt? Identifying when different types of undisclosed post hoc hypothesizing harm scientific progress}}, journal={Review of General Psychology}, year={2017}, volume={21}, number={4}, pages={308--320}, doi={10.1037/gpr0000128}}@article{ruxton2010when, author={Ruxton, Graeme D. and Neuhäuser, Markus}, title={{When should we use one-tailed hypothesis testing?}}, journal={Methods in Ecology and Evolution}, year={2010}, volume={1}, number={2}, pages={114--117}, doi={10.1111/j.2041-210x.2010.00014.x}}