Usterka wyszła po zebraniu danych. Zanim cokolwiek poprawisz
Ankiety są zebrane, a przy pisaniu metody okazuje się, że w jednej pozycji etykiety skali były odwrócone, innej pozycji nie ma w formularzu, a część osób ominęło ważne pytanie. Zwykle nie przekreśla to pracy. Przekreślić ją może dopiero cicha poprawka, o której czytelnik się nie dowie. Zacznij od czterech kroków:
- Zamroź surowy plik. Poprawki rób w skrypcie albo na kopii (zob. porządek w plikach pracy).
- Zabezpiecz dowód tego, co widzieli respondenci. Kopia formularza, zrzuty ekranu, treść zaproszenia i data każdej zmiany. Bez tego nie wiesz, co naprawiasz. Numer pozycji i wersję dopisz też do książki kodowej.
- Wstrzymaj analizy hipotez. Usterkę i decyzję zapisz, zanim policzysz związek, którego usterka dotyczy.
- Napisz do promotora wcześnie, z opisem usterki i własną propozycją. Zasady pracy z danymi bywają różne, więc ostateczny wybór uzgodnij z nim.
Format dziennika i reguły kontroli opisuje wpis o regułach walidacji i dzienniku zmian, a pułapki samego pliku – wpis o imporcie. Tu chodzi o wybór: co zrobić z konkretną usterką formularza. Części takich usterek zapobiega pilotaż i wywiad poznawczy, ale ten etap masz już za sobą.
Trzy pytania, które rozstrzygają większość usterek
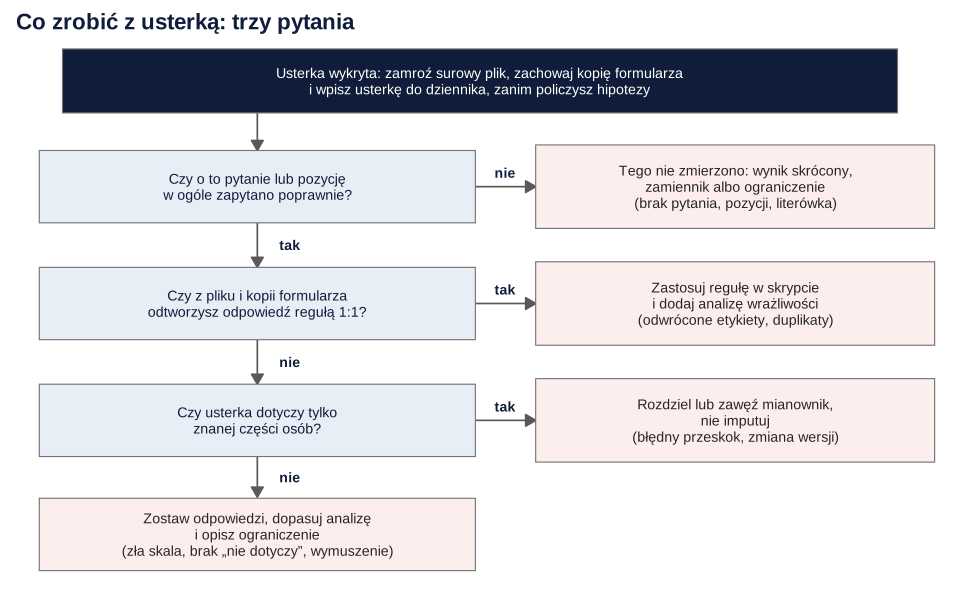
Najważniejsze jest drugie pytanie. Regułą 1:1 jest „osoba, która zaznaczyła pierwszą pozycję, widziała etykietę »zdecydowanie się zgadzam«”, potwierdzona kopią formularza. Nie jest nią „pewnie chodziło o…”. Bez takiej reguły odpowiedzi zostają, jakie są, a zmienia się tylko to, co wolno z nich wywnioskować.
Reguła dla każdej usterki: decyzja przed obejrzeniem wyników dla hipotez, wpis do dziennika, jawny opis w pracy. Wybór tej naprawy, która dała istotność, to p-hacking, nawet jeśli każda z naprawek osobno ma sens. A jeśli wyniki już widziałaś lub widziałeś? Napisz o tym wprost i pokaż wszystkie rozsądne warianty. Steegen i in. (2016) proponują właśnie takie zestawienie analiz na zbiorach danych wynikających z alternatywnych decyzji o kodowaniu i wykluczeniach. Willroth i Atherton (2024) podają ramę raportowania odstępstw od prerejestrowanego planu. Ta sama logika działa przy zwykłej pracy dyplomowej: co planowano, co zmieniono, dlaczego i z jakim skutkiem.
Katalog usterek: jak wykryć, co zrobić, co napisać
| Usterka | Jak wykryć | Co zrobić | Co napisać |
|---|---|---|---|
| Brakujące pytanie | Lista zmiennych z planu analizy a formularz | Zmienna zastępcza, jeśli treścią jest blisko. Krótki dodatkowy pomiar tylko z możliwością połączenia osób (kod); odpowie część próby i później | Czego nie zmierzono, czym przybliżono, ile osób w dodatkowym pomiarze |
| Pominięta pozycja w skali | Liczba kolumn a klucz narzędzia | Wynik z zebranych pozycji, własna alfa, bez norm i progów | Ile pozycji było, której zabrakło, że wersja nie była walidowana |
| Brak punktu skali (1–4 zamiast 1–5) | Etykiety a oryginał | Analizuj zakres, który był. Nie przeliczaj na 1–5, aby porównać z normami | Faktyczny format i brak porównań z oryginałem |
| Nierówne przedziały | Szerokości kategorii | Zmienna porządkowa, bez środków przedziałów jako liczb | Kategorie jak w formularzu; ostrożny opis rozkładu |
| Nachodzące przedziały | Ta sama wartość w dwóch kategoriach | Zostaw jako porządkową. Łączenie ustal z góry; nie przydzielaj osób losowo | Które granice się pokrywały |
| Odwrócone etykiety | Ujemna korelacja pozycji z pozostałymi, widoczna tylko w jednej wersji | Przekoduj w skrypcie, jeśli kopia formularza to potwierdza; analiza wrażliwości | Komu pokazano zły układ, jakie przekodowanie, wynik obu wariantów |
| Brak opcji „nie dotyczy” | Odpowiedzi osób, których pytanie nie dotyczy, skrzyżowane z innym pytaniem | Zamień na „nie dotyczy” tylko z reguły opartej na innym pytaniu (zob. mianownik) | Kto został wyłączony z mianownika i na jakiej podstawie |
| Literówka | Przeczytanie formularza słowo po słowie, korelacje pozycji | Bez zmiany sensu: zostaw. Zmiana sensu („niewiele” zamiast „wiele”): pozycja mierzy co innego, wyłącz ją; nie przekodowuj | Brzmienie, decyzja i powód |
| Błędna logika przejść | Tabela pytanie filtrujące × brak odpowiedzi; 100% w jednej grupie | Zawęź opis do osób, które pytanie widziały. Imputacja nie odtworzy grupy, której nie zapytano | Kogo ominęło pytanie i do kogo odnosi się wynik |
| Zmiana ankiety w trakcie | Daty zmian; kolumna wersji z czasu wypełnienia | Dopisz wersję do danych, porównaj wersje, przy różnicy pokaż wyniki osobno | Data i treść zmiany, n w każdej wersji |
| Pytanie wymuszone | Ustawienia formularza; zero braków w pytaniu drażliwym | Nie da się cofnąć. Sprawdź rozkład i przerwania, a gdy obiecano możliwość pominięcia pytania, omów to z promotorem | Które pytania były obowiązkowe i co to znaczy dla interpretacji |
| Duplikaty | Te same odpowiedzi we wszystkich kolumnach, bliski czas | Regułą ustaloną z góry zostaw jedną kopię. W krótkich ankietach identyczność może być przypadkiem | Ile rekordów usunięto (diagram przepływu) |
Trzy z tych wierszy mają oparcie w badaniach nad ankietami. Schwarz i in. (1985) pokazali, że sam zakres kategorii zmieniał deklarowany czas oglądania telewizji, bo respondenci odczytywali z niego, co jest przeciętne. Złej skali nie naprawisz więc przeliczeniem: odpowiedź powstała pod jej wpływem. Décieux i in. (2015) oraz Sischka i in. (2022) wiążą wymuszanie odpowiedzi z większą liczbą przerwań i słabszą jakością danych, a zatem komplet odpowiedzi nie jest tu dowodem jakości. Teitcher i in. (2015) opisują wielokrotne wypełnienia w badaniach internetowych i pokazują, że ich wykrywanie może kolidować z prywatnością. W ankiecie anonimowej nie zaczynaj więc po fakcie zbierać adresów IP ani e-maili.
Trzy usterki, które wymagają osobnej decyzji
Brakujące pytanie. Zanim zadasz je ponownie, sprawdź, czy inna zmienna z ankiety jest treściowo blisko. Zapomniany staż pracy można zastąpić wiekiem, ale wtedy pisz o wieku, a nie o stażu „w przybliżeniu”. Dodatkowy krótki pomiar jest możliwy tylko wtedy, gdy umiesz połączyć odpowiedzi tych samych osób. To już inna próba: odpowie część osób, po czasie i zapewne nie losowo. Podaj liczbę odpowiedzi i datę, a wynik analizuj wyłącznie w tej podpróbie. Sprawdź też, czy informacja dla uczestników i zgoda komisji obejmują ponowny kontakt.
Brak „nie dotyczy”. Pytanie „jak oceniasz wsparcie opiekuna stażu?” dostały też osoby bez opiekuna, więc zaznaczyły cokolwiek. Jeśli inne pytanie mówi, kto opiekuna miał, regułą przenieś pozostałych do „nie dotyczy”. Jeśli takiego pytania nie ma, odpowiedzi zostają, a wynik opisz jako ocenę całej próby, z zastrzeżeniem o niepewnym znaczeniu.
Literówka zmieniająca sens. Pozycja „Czuję się niedoceniana” zamiast „Czuję się doceniana” wygląda jak pozycja odwrócona, ale przeczenie nie jest lustrzanym odbiciem pierwotnego zdania. Przekodowanie zakłada symetrię, której nie sprawdzisz. Bezpieczniej wyłączyć pozycję i podać to w metodzie.
Przykład: jedna ankieta i pięć usterek
Przykład fikcyjny, dane symulowane. Ankieta online wśród pielęgniarek: wsparcie przełożonych (6 pozycji, 1–5) i wypalenie (narzędzie ma 8 pozycji). Hipoteza: większe wsparcie wiąże się z mniejszym wypaleniem. W pliku jest 278 rekordów (pobierz CSV), a usterek jest pięć:
- Duplikaty. 8 rekordów ma identyczne odpowiedzi we wszystkich 17 kolumnach, więc zostaje 270 osób.
- Odwrócone etykiety WS4. Formularz poprawiono 16 marca. Wersja A to 134 osoby, wersja B – 136.
- Brak pozycji WYP5. Skala wypalenia ma w formularzu 7 z 8 pozycji.
- Nachodzące przedziały stażu. 0–5, 5–10, 10–20, 20 i więcej.
- Błędny przeskok. Pytanie o dyżury nocne ominęło oddziały zabiegowe.
Dane są symulowane, więc wiemy, co pokazałaby poprawna ankieta. W prawdziwym badaniu tej wiedzy nie ma. Wszystkie decyzje zapisano w dzienniku przed policzeniem korelacji wsparcia z wypaleniem.
Odwrócone etykiety: znak i dwie wersje formularza
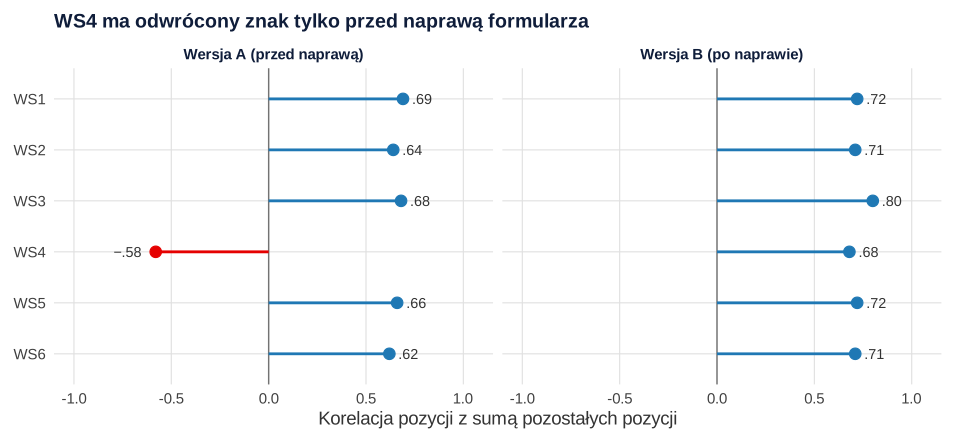
Policz korelację każdej pozycji z sumą pozostałych osobno w każdej wersji. WS4 w wersji A ma −.58, pozostałe pozycje od .62 do .69. W wersji B WS4 ma .68, a pozostałe od .71 do .80 (rysunek 2). Ujemna wartość w obu wersjach oznaczałaby zwykle pozycję odwróconą z założenia, której zapomniano przekodować (zob. liczenie wyniku kwestionariusza). Takie pozycje różnią się treścią, a problemy z odpowiedziami na nie mają kilka źródeł (Weijters i in., 2013). Tu treść jest poprawna, a zawinił układ etykiet.
Przekodowanie 6 − WS4 w wersji A zakłada, że ludzie czytali etykiety. W symulacji robiło to 87.3% osób; pozostałe zaznaczały jak zwykle, więc po przekodowaniu 7.5% odpowiedzi WS4 w wersji A jest błędnych. Stąd analiza wrażliwości: bez WS4 i tylko w wersji B (rysunek 3).
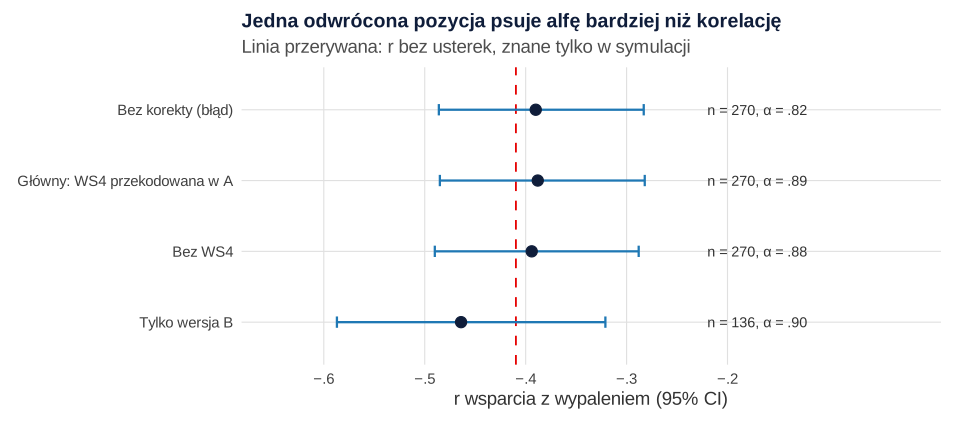
Bez korekty r = −.390, 95% CI [−.486, −.283], α = .82. Po przekodowaniu r = −.388, 95% CI [−.485, −.282], α = .89. Bez WS4 r = −.394, 95% CI [−.490, −.288], α = .88. Tylko w wersji B r = −.464, 95% CI [−.587, −.321], n = 136. Wartość bez usterek to −.410. Jedna z sześciu pozycji słabo porusza korelację wyniku sumarycznego, a wyraźnie obniża alfę. Inaczej jest, gdy raportujesz pozycję osobno: odsetek odpowiedzi 4–5 dla WS4 w wersji A wynosi 23.9% bez korekty, 27.6% po korekcie, a w wersji B 33.8%. Taka różnica może być częściowo przypadkowa, ale pokazuje, że przekodowanie nie zrównuje wersji. Podaj więc wersję także przy opisie tej pozycji.
Pominięta pozycja: alfa nie ostrzeże
Alfa z 7 pozycji wynosi .88, a z 8 pozycji byłaby .89. Sama rzetelność niczego nie zdradzi. Pominięta pozycja była jednak „trudniejsza”, więc średnia z siedmiu pozycji pomnożona przez 8/7 zawyża wynik: M = 24.03 zamiast 23.13. Przy fikcyjnym progu 28 punktów wysoki wynik ma 26.7% osób zamiast 23.3%, a 3.3% osób zmienia kategorię. Korelacja obu sum wynosi .993, ale jest zawyżona, bo siedem pozycji to część ośmiu (zob. jak skrócić kwestionariusz).
Czego więc nie twierdzić: że użyto pełnej skali, że wynik można odnieść do norm i progów autorów, że trafność oryginału przechodzi na tę wersję. Smith i in. (2000) krytykują właśnie zbyt optymistyczne zakładanie takiego przeniesienia przy wersjach skróconych. Wynik pozostawiasz jako średnią z 7 pozycji, z własną alfą.
Przeskok, staż i wersja
Wśród pracujących zmianowo brak odpowiedzi o dyżury to 100% na oddziałach zabiegowych i 0% na pozostałych. Taki błąd logiki przejść nie jest zwykłym brakiem danych. W pliku M = 3.61, SD = 2.12, n = 131, a u wszystkich zmianowych średnia wynosiłaby 4.82. Plik nie zawiera nic, co pozwoliłoby to odtworzyć, więc wynik dotyczy tylko oddziałów niezabiegowych.
Staż ma liczebności 43, 70, 110 i 47. W symulacji 12.6% osób miało dokładnie 5, 10 lub 20 lat stażu, a 5.9% trafiło do innej kategorii niż przy rozłącznych granicach. W prawdziwym pliku tych osób nie zobaczysz. Zmienna zostaje porządkowa, a przedziały opisujesz takimi, jakie były (o przyszłych ankietach: metryczka).
Czy wersje A i B wolno łączyć? Pięć poprawnych pozycji wsparcia różni się o 0.01 (B − A), 95% CI [−0.20, 0.22], p = .900. Przedział jest szeroki, więc nie jest to dowód równoważności, a jedynie brak sygnału o wyraźnej zmianie.
Gotowe zdania do pracy
Pola w nawiasach uzupełnij własnymi danymi. Liczby to przykład.
Puhan i in. (2012) podkreślają, że zbyt mało autorów otwarcie omawia, jak ograniczenia mogły wpłynąć na wyniki. Usterka opisana przez autora zwykle jest mniej kłopotliwa niż usterka znaleziona przez recenzenta. Układ tej części opisuje wpis o ograniczeniach.
| Jak bywa napisane | Co nie tak | Poprawione |
|---|---|---|
| „Pozycja 4 została poprawiona”. | Nie wiadomo jak, u kogo i dlaczego. | „W wersji A (n = 134) odpowiedzi na pozycję 4 przekodowano wzorem 6 − x, ponieważ kopia formularza potwierdziła odwrotny układ etykiet”. |
| „Wypalenie mierzono skalą [nazwa], α = .88”. | Czytelnik myśli o pełnej skali. | „Użyto 7 z 8 pozycji skali [nazwa], jedna pozycja nie znalazła się w formularzu; α = .88, wyników nie odnoszono do norm”. |
| „Pielęgniarki miały średnio 3.61 dyżuru nocnego”. | Wynik dotyczy tylko części osób, a błąd jest ukryty. | „Wśród osób spoza oddziałów zabiegowych (n = 131) M = 3.61, SD = 2.12; osobom z oddziałów zabiegowych pytania nie wyświetlono”. |
Najczęstsze błędy
- Edycja surowego pliku. Znika punkt odniesienia i możliwość sprawdzenia poprawki.
- Naprawa wybrana po wyniku. Warianty analizy wrażliwości mają być ustalone wcześniej i pokazane wszystkie.
- Przekodowanie bez dowodu. Ujemna korelacja to sygnał, nie dowód. Potwierdzić usterkę musi formularz.
- Dopisywanie odpowiedzi „po znajomości”. Dzwonienie do koleżanki i uzupełnianie jej kolumny tworzy dane z innego momentu i innej procedury.
- Doklejenie osób z innego formularza bez kolumny wersji. Po scaleniu nikt już tego nie odróżni (zob. zebrano mniej osób).
- Przemilczenie usterki. Formularz w załączniku pokaże ją każdemu czytelnikowi. Gdy pada pomysł, by o niej nie pisać, zaproponuj analizę dodatkową i notę (zob. rozmowa z promotorem).
Jeśli chcesz, żeby ktoś sprawdził decyzje i policzył warianty, zanim przejdziesz do hipotez, zobacz pomoc w analizie dla studentów.
Ankieta z usterkami w R: diagnoza, dziennik, analiza
Skrypt tworzy plik CSV, wczytuje go jak zwykły eksport i przechodzi przez diagnozę, decyzje i analizę. Korzysta tylko z bazowego R. Rysunki powstały w osobnym skrypcie. Ziarna nie wybierano pod wynik, a parametry symulacji (m.in. 85% osób czytających etykiety) są założeniami ilustracyjnymi.
Pięć usterek w jednym pliku
R
# Ankieta z pięcioma usterkami: od diagnozy do dziennika decyzji (dane symulowane, przykład fikcyjny)
# Hipoteza: większe wsparcie przełożonych wiąże się z mniejszym wypaleniem.
set.seed(5021)

# 1. SYMULACJA: co naprawdę myśleli respondenci i co zapisał formularz
n <- 270
czyta_etykiety <- 0.85                          # założenie: tyle osób w wersji A czyta etykiety
do_skali <- function(z) as.integer(cut(z, c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf)))
wsparcie <- rnorm(n)
wypalenie <- -0.50 * wsparcie + sqrt(1 - 0.50^2) * rnorm(n)
pozycja <- function(cecha, lad = 0.78, przes = 0) do_skali(lad * cecha + sqrt(1 - lad^2) * rnorm(n) + przes)
WS <- sapply(1:6, function(i) pozycja(wsparcie))
colnames(WS) <- paste0("WS", 1:6)
WY <- sapply(1:8, function(i) pozycja(wypalenie, przes = ifelse(i == 5, -0.9, 0)))  # WYP5 jest "trudniejsza"
colnames(WY) <- paste0("WYP", 1:8)
czas <- as.POSIXct("2026-03-02 08:00", tz = "UTC") + sort(runif(n, 0, 28 * 86400))
naprawa <- as.POSIXct("2026-03-16 12:00", tz = "UTC")   # tego dnia poprawiono etykiety WS4
staz_lat <- pmin(round(rgamma(n, 2.2, 0.17)), 40)
staz <- sapply(staz_lat, function(s) {                  # przedziały nachodzą na siebie na granicach
  mozliwe <- c("0-5", "5-10", "10-20", "20+")[c(s <= 5, s >= 5 & s <= 10, s >= 10 & s <= 20, s >= 20)]
  mozliwe[sample.int(length(mozliwe), 1)]
})
oddzial <- sample(c("zachowawczy", "zabiegowy", "inny"), n, TRUE, c(.45, .35, .20))
zmianowy <- ifelse(runif(n) < .75, "tak", "nie")
dyzury_prawda <- ifelse(zmianowy == "tak",
                        rpois(n, ifelse(oddzial == "zabiegowy", 7, 4)), NA)
dyzury <- ifelse(oddzial == "zabiegowy", NA, dyzury_prawda)  # błędny przeskok omija oddział zabiegowy

WS_zapis <- WS
wersja_A <- czas < naprawa
czyta <- runif(n) < czyta_etykiety
WS_zapis[wersja_A & czyta, "WS4"] <- 6L - WS[wersja_A & czyta, "WS4"]

plik <- data.frame(id = sprintf("R%03d", 1:n), czas = format(czas, "%Y-%m-%d %H:%M"), staz, oddzial,
                   zmianowy, dyzury, WS_zapis, WY[, -5])        # WYP5 nie było w formularzu
kopie <- plik[sample.int(n, 8), ]                                # 8 osób wysłało ankietę dwa razy
kopie$id <- sprintf("R%03d", (n + 1):(n + 8))
kopie$czas <- format(as.POSIXct(kopie$czas, tz = "UTC") + sample(120:2400, 8), "%Y-%m-%d %H:%M")
plik <- rbind(plik, kopie)
plik <- plik[order(plik$id), ]
write.csv(plik, "ankieta-z-usterkami.csv", row.names = FALSE, na = "")

# 2. DIAGNOZA: bez liczenia związku wsparcia z wypaleniem
d <- read.csv("ankieta-z-usterkami.csv")
odpowiedzi <- setdiff(names(d), c("id", "czas"))
powtorka <- duplicated(d[, odpowiedzi])
cat("Rekordy:", nrow(d), "| powtórzone odpowiedzi:", sum(powtorka), "\n")
d <- d[!powtorka, ]
d$wersja <- ifelse(as.POSIXct(d$czas, tz = "UTC") < naprawa, "A", "B")
print(table(d$wersja))

ws <- paste0("WS", 1:6)
reszta <- function(x) sapply(seq_along(x), function(i) cor(x[[i]], rowSums(x[-i])))
tab <- data.frame(pozycja = ws, A = round(reszta(d[d$wersja == "A", ws]), 2),
                  B = round(reszta(d[d$wersja == "B", ws]), 2))
cat("\nKorelacja pozycja-reszta skali wsparcia w wersjach formularza\n"); print(tab, row.names = FALSE)

cat("\nBrak odpowiedzi o dyżurach u osób pracujących zmianowo (%)\n")
zm <- d[d$zmianowy == "tak", ]
print(round(tapply(is.na(zm$dyzury), zm$oddzial, mean) * 100, 1))

piec <- rowMeans(d[, setdiff(ws, "WS4")])
por <- t.test(piec[d$wersja == "B"], piec[d$wersja == "A"])
cat(sprintf("\nWersja B - A, 5 poprawnych pozycji wsparcia: %.2f, 95%% CI [%.2f, %.2f], p = %s\n",
            por$estimate[1] - por$estimate[2], por$conf.int[1], por$conf.int[2],
            sub("^0", "", sprintf("%.3f", por$p.value))))

# 3. DECYZJE zapisane, zanim policzymy hipotezę
dziennik <- data.frame(
  usterka = c("duplikaty", "etykiety WS4", "brak WYP5", "przedziały stażu", "przeskok dyżury"),
  rekordy = c(sum(powtorka), sum(d$wersja == "A"), nrow(d), nrow(d), sum(zm$oddzial == "zabiegowy")),
  decyzja = c("usuń późniejszą kopię", "A: 6 - WS4; wrażliwość bez WS4 i tylko B",
              "wynik z 7 pozycji; bez norm", "zostaw jako porządkową; opisz",
              "opis bez zabiegowego; bez imputacji"))
cat("\nDziennik decyzji\n"); print(dziennik, row.names = FALSE)

# 4. ANALIZA: wynik główny i analiza wrażliwości
alfa <- function(x) { k <- ncol(x); k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }
wyp <- paste0("WYP", c(1:4, 6:8))
d$WYP_sr <- rowMeans(d[, wyp])
popr <- d[, ws]
popr$WS4[d$wersja == "A"] <- 6L - popr$WS4[d$wersja == "A"]
wiersz <- function(nazwa, x, y, a) {
  k <- cor.test(rowMeans(x), y)
  data.frame(wariant = nazwa, n = nrow(x), alfa = round(a, 2), r = round(k$estimate, 3),
             dol = round(k$conf.int[1], 3), gora = round(k$conf.int[2], 3), row.names = NULL)
}
B <- d$wersja == "B"
wyniki <- rbind(
  wiersz("bez korekty (błąd)", d[, ws], d$WYP_sr, alfa(d[, ws])),
  wiersz("główny: WS4 przekodowana w A", popr, d$WYP_sr, alfa(popr)),
  wiersz("wrażliwość: bez WS4", d[, setdiff(ws, "WS4")], d$WYP_sr, alfa(d[, setdiff(ws, "WS4")])),
  wiersz("wrażliwość: tylko wersja B", d[B, ws], d$WYP_sr[B], alfa(d[B, ws])))
cat("\nZwiązek wsparcia z wypaleniem\n"); print(wyniki, row.names = FALSE)
cat(sprintf("Alfa skali wypalenia (7 pozycji): %.2f\n", alfa(d[, wyp])))
cat("Alfa WS po przekodowaniu: A =", round(alfa(popr[!B, ]), 2), "| B =", round(alfa(popr[B, ]), 2), "\n")
zgoda <- function(x) round(100 * mean(x >= 4), 1)
cat("WS4, odsetek odpowiedzi 4-5: A surowe =", zgoda(d$WS4[!B]), "| A przekodowane =", zgoda(popr$WS4[!B]),
    "| B =", zgoda(d$WS4[B]), "\n")
ty <- table(d$staz)[c("0-5", "5-10", "10-20", "20+")]
cat("Staż (zapis):", paste(names(ty), ty, collapse = "; "), "\n")
zach <- d[d$zmianowy == "tak" & d$oddzial != "zabiegowy", ]
cat(sprintf("Dyżury nocne, osoby spoza zabiegowego: M = %.2f, SD = %.2f, n = %d\n",
            mean(zach$dyzury), sd(zach$dyzury), nrow(zach)))

# 5. TYLKO W SYMULACJI: co pokazałaby ankieta bez usterek (w prawdziwym badaniu tego nie znasz)
pelna <- rowSums(WY); siedem <- rowSums(WY[, -5]) * 8 / 7; prog <- 28
cat("\n--- Znane tylko w symulacji ---\n")
cat(sprintf("Prawdziwe r (6 WS, 8 WYP): %.3f\n", cor(rowMeans(WS), pelna)))
cat(sprintf("Suma 8 pozycji: M = %.2f | 7 pozycji x 8/7: M = %.2f | r = %s | alfa 8 poz. = %.2f\n",
            mean(pelna), mean(siedem), sub("^0", "", sprintf("%.3f", cor(pelna, siedem))), alfa(as.data.frame(WY))))
cat(sprintf("Odsetek wyników >= %d: suma 8 pozycji %.1f%%, 7 x 8/7 %.1f%%; inna klasyfikacja: %.1f%%\n", prog,
            100 * mean(pelna >= prog), 100 * mean(siedem >= prog), 100 * mean((pelna >= prog) != (siedem >= prog))))
nazwa_kat <- as.character(cut(staz_lat, c(-1, 4, 9, 19, Inf), labels = c("0-5", "5-10", "10-20", "20+")))
cat(sprintf("Osoby na granicy stażu (5, 10 lub 20 lat): %.1f%%; inna kategoria niż przy rozłącznych granicach: %.1f%%\n",
            100 * mean(staz_lat %in% c(5, 10, 20)), 100 * mean(staz != nazwa_kat)))
cat(sprintf("Dyżury, wszyscy zmianowi: M = %.2f | zapisane w pliku: M = %.2f\n",
            mean(dyzury_prawda, na.rm = TRUE), mean(dyzury, na.rm = TRUE)))
cat(sprintf("Wersja A: osoby czytające etykiety = %.1f%%; po przekodowaniu błędnie ocenione WS4 = %.1f%%\n",
            100 * mean(czyta[wersja_A]), 100 * mean(WS[wersja_A, "WS4"] != ifelse(czyta[wersja_A],
            WS[wersja_A, "WS4"], 6L - WS[wersja_A, "WS4"]))))
Wynik
Rekordy: 278 | powtórzone odpowiedzi: 8

  A   B
134 136

Korelacja pozycja-reszta skali wsparcia w wersjach formularza
 pozycja     A    B
     WS1  0.69 0.72
     WS2  0.64 0.71
     WS3  0.68 0.80
     WS4 -0.58 0.68
     WS5  0.66 0.72
     WS6  0.62 0.71

Brak odpowiedzi o dyżurach u osób pracujących zmianowo (%)
       inny   zabiegowy zachowawczy
          0         100           0

Wersja B - A, 5 poprawnych pozycji wsparcia: 0.01, 95% CI [-0.20, 0.22], p = .900

Dziennik decyzji
          usterka rekordy                                  decyzja
        duplikaty       8                    usuń późniejszą kopię
     etykiety WS4     134 A: 6 - WS4; wrażliwość bez WS4 i tylko B
        brak WYP5     270              wynik z 7 pozycji; bez norm
 przedziały stażu     270            zostaw jako porządkową; opisz
  przeskok dyżury      76      opis bez zabiegowego; bez imputacji

Związek wsparcia z wypaleniem
                      wariant   n alfa      r    dol   gora
           bez korekty (błąd) 270 0.82 -0.390 -0.486 -0.283
 główny: WS4 przekodowana w A 270 0.89 -0.388 -0.485 -0.282
          wrażliwość: bez WS4 270 0.88 -0.394 -0.490 -0.288
   wrażliwość: tylko wersja B 136 0.90 -0.464 -0.587 -0.321
Alfa skali wypalenia (7 pozycji): 0.88
Alfa WS po przekodowaniu: A = 0.88 | B = 0.9
WS4, odsetek odpowiedzi 4-5: A surowe = 23.9 | A przekodowane = 27.6 | B = 33.8
Staż (zapis): 0-5 43; 5-10 70; 10-20 110; 20+ 47
Dyżury nocne, osoby spoza zabiegowego: M = 3.61, SD = 2.12, n = 131

--- Znane tylko w symulacji ---
Prawdziwe r (6 WS, 8 WYP): -0.410
Suma 8 pozycji: M = 23.13 | 7 pozycji x 8/7: M = 24.03 | r = .993 | alfa 8 poz. = 0.89
Odsetek wyników >= 28: suma 8 pozycji 23.3%, 7 x 8/7 26.7%; inna klasyfikacja: 3.3%
Osoby na granicy stażu (5, 10 lub 20 lat): 12.6%; inna kategoria niż przy rozłącznych granicach: 5.9%
Dyżury, wszyscy zmianowi: M = 4.82 | zapisane w pliku: M = 3.61
Wersja A: osoby czytające etykiety = 87.3%; po przekodowaniu błędnie ocenione WS4 = 7.5%
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim policzysz hipotezy, sprawdź…
- Czy surowy plik jest nietknięty, a kopia formularza zachowana?
- Czy każda usterka ma wpis: co, u kogo, od kiedy, jaka decyzja?
- Czy w danych jest kolumna wersji, jeśli formularz się zmieniał?
- Czy korelacje pozycja–reszta policzono osobno w każdej wersji?
- Czy mianowniki pytań z usterką zgadzają się z tym, kto je widział?
- Czy wynik ze skróconej skali nie jest porównywany z normami?
- Czy warianty analizy wrażliwości ustalono przed wynikami?
- Czy promotor zna usterki i decyzje?
Najczęstsze pytania
Czy można poprawić błąd w ankiecie po zebraniu odpowiedzi?
Zmienić wolno tylko to, co da się odtworzyć jednoznaczną regułą i potwierdzić kopią formularza, na przykład odwrócone etykiety. Poprawkę zapisz w skrypcie i dzienniku, opisz w pracy i dodaj analizę wrażliwości. Odpowiedzi, której nikt nie udzielił, nie da się poprawić – można tylko zmienić zakres wniosków.
Co zrobić, gdy w ankiecie zabrakło jednej pozycji ze skali?
Policz wynik z zebranych pozycji, podaj alfę dla tej wersji i napisz, której pozycji zabrakło. Nie porównuj wyniku z normami ani progami autorów, bo skrócona wersja nie była walidowana. Przeliczenie średniej na pełną skalę zakłada, że brakująca pozycja zachowuje się jak pozostałe.
Jak sprawdzić, czy etykiety skali w ankiecie były odwrócone?
Policz korelację każdej pozycji z sumą pozostałych, osobno dla każdej wersji formularza. Wartość ujemna w jednej wersji jest silnym sygnałem, ale potwierdzić usterkę musi kopia formularza. W przykładzie pozycja miała korelację −.58 przed naprawą i .68 po niej.
Czy wolno zmienić ankietę w trakcie zbierania danych?
Zmiana jest czasem konieczna, jeśli znalazłeś błąd, ale musi być widoczna w danych. Zapisz datę i treść zmiany, dodaj kolumnę wersji na podstawie czasu wypełnienia i porównaj wersje. Pamiętaj, że osoby z różnych okresów mogą różnić się także bez związku ze zmianą.
Czy błąd w ankiecie trzeba opisać w pracy magisterskiej?
Tak, jeśli wpływa na to, co zmierzono, kogo zapytano albo jak policzono wynik. Podaj, co się stało, kogo dotyczyło, jaką podjęto decyzję i czy wnioski zależą od tej decyzji. Sposób opisu i miejsce w pracy uzgodnij z promotorem.
Powiązane hasła
Przeczytaj też
Wynik wygląda podejrzanie
Tabela objaw × przyczyna × test, plik CSV z usterkami, kod R z wynikami przed naprawą i po niej oraz lista kontrolna na 10 minut.
Czytaj →PoradnikReguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →PoradnikBraki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →PoradnikNajczęstsze błędy w ankietach
Pytania dwa w jednym, złe kafeterie, wielkie macierze i brak „nie dotyczy” – przykłady źle/dobrze z audytów ankiet i lista kontrolna przed startem.
Czytaj →W ankiecie wyszła usterka, a dane są już zebrane?
Sprawdzimy usterkę, policzymy warianty w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Décieux, J. P., Mergener, A., Neufang, K. M., & Sischka, P. (2015). Implementation of the forced answering option within online surveys: Do higher item response rates come at the expense of participation and answer quality? Psihologija, 48(4), 311–326. https://doi.org/10.2298/psi1504311d ● Otwarty dostęp
- Puhan, M. A., Akl, E. A., Bryant, D., Xie, F., Apolone, G., & ter Riet, G. (2012). Discussing study limitations in reports of biomedical studies – the need for more transparency. Health and Quality of Life Outcomes, 10(1), Article 23. https://doi.org/10.1186/1477-7525-10-23 ● Otwarty dostęp
- Schwarz, N., Hippler, H.-J., Deutsch, B., & Strack, F. (1985). Response scales: Effects of category range on reported behavior and comparative judgments. Public Opinion Quarterly, 49(3), 388–395. https://doi.org/10.1086/268936
- Sischka, P. E., Décieux, J. P., Mergener, A., Neufang, K. M., & Schmidt, A. F. (2022). The impact of forced answering and reactance on answering behavior in online surveys. Social Science Computer Review, 40(2), 405–425. https://doi.org/10.1177/0894439320907067
- Smith, G. T., McCarthy, D. M., & Anderson, K. G. (2000). On the sins of short-form development. Psychological Assessment, 12(1), 102–111. https://doi.org/10.1037/1040-3590.12.1.102
- Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
- Teitcher, J. E. F., Bockting, W. O., Bauermeister, J. A., Hoefer, C. J., Miner, M. H., & Klitzman, R. L. (2015). Detecting, preventing, and responding to “fraudsters” in internet research: Ethics and tradeoffs. Journal of Law, Medicine & Ethics, 43(1), 116–133. https://doi.org/10.1111/jlme.12200 ● Otwarty dostęp
- Weijters, B., Baumgartner, H., & Schillewaert, N. (2013). Reversed item bias: An integrative model. Psychological Methods, 18(3), 320–334. https://doi.org/10.1037/a0032121 ● Otwarty dostęp: pełny tekst
- Willroth, E. C., & Atherton, O. E. (2024). Best laid plans: A guide to reporting preregistration deviations. Advances in Methods and Practices in Psychological Science, 7(1), Article 25152459231213802. https://doi.org/10.1177/25152459231213802 ● Otwarty dostęp
Cytowania BibTeX
@article{decieux2015implementation, author={Décieux, Jean Philippe and Mergener, Alexandra and Neufang, Kristina M. and Sischka, Philipp}, title={{Implementation of the forced answering option within online surveys: Do higher item response rates come at the expense of participation and answer quality?}}, journal={Psihologija}, year={2015}, volume={48}, number={4}, pages={311--326}, doi={10.2298/psi1504311d}}@article{puhan2012discussing, author={Puhan, Milo A. and Akl, Elie A. and Bryant, Dianne and Xie, Feng and Apolone, Giovanni and ter Riet, Gerben}, title={{Discussing study limitations in reports of biomedical studies – the need for more transparency}}, journal={Health and Quality of Life Outcomes}, year={2012}, volume={10}, number={1}, eid={23}, doi={10.1186/1477-7525-10-23}}@article{schwarz1985response, author={Schwarz, Norbert and Hippler, Hans-J. and Deutsch, Brigitte and Strack, Fritz}, title={{Response scales: Effects of category range on reported behavior and comparative judgments}}, journal={Public Opinion Quarterly}, year={1985}, volume={49}, number={3}, pages={388--395}, doi={10.1086/268936}}@article{sischka2022impact, author={Sischka, Philipp E. and Décieux, Jean Philippe and Mergener, Alexandra and Neufang, Kristina M. and Schmidt, Alexander F.}, title={{The impact of forced answering and reactance on answering behavior in online surveys}}, journal={Social Science Computer Review}, year={2022}, volume={40}, number={2}, pages={405--425}, doi={10.1177/0894439320907067}}@article{smith2000sins, author={Smith, Gregory T. and McCarthy, Denis M. and Anderson, Kristen G.}, title={{On the sins of short-form development}}, journal={Psychological Assessment}, year={2000}, volume={12}, number={1}, pages={102--111}, doi={10.1037/1040-3590.12.1.102}}@article{steegen2016increasing, author={Steegen, Sara and Tuerlinckx, Francis and Gelman, Andrew and Vanpaemel, Wolf}, title={{Increasing transparency through a multiverse analysis}}, journal={Perspectives on Psychological Science}, year={2016}, volume={11}, number={5}, pages={702--712}, doi={10.1177/1745691616658637}}@article{teitcher2015detecting, author={Teitcher, Jennifer E. F. and Bockting, Walter O. and Bauermeister, José A. and Hoefer, Chris J. and Miner, Michael H. and Klitzman, Robert L.}, title={{Detecting, preventing, and responding to “fraudsters” in internet research: Ethics and tradeoffs}}, journal={Journal of Law, Medicine \& Ethics}, year={2015}, volume={43}, number={1}, pages={116--133}, doi={10.1111/jlme.12200}}@article{weijters2013reversed, author={Weijters, Bert and Baumgartner, Hans and Schillewaert, Niels}, title={{Reversed item bias: An integrative model}}, journal={Psychological Methods}, year={2013}, volume={18}, number={3}, pages={320--334}, doi={10.1037/a0032121}}@article{willroth2024best, author={Willroth, Emily C. and Atherton, Olivia E.}, title={{Best laid plans: A guide to reporting preregistration deviations}}, journal={Advances in Methods and Practices in Psychological Science}, year={2024}, volume={7}, number={1}, eid={25152459231213802}, doi={10.1177/25152459231213802}}