Trzy pliki „final” i żadnej pewności
Na pulpicie leżą praca final.docx, praca final2.docx i praca final2 POPRAWIONA.docx. W folderze obok są dwa pliki z danymi, a w jednym z nich ktoś usunął kilka wierszy. Nie wiesz już kto ani dlaczego. Promotor pyta, skąd wzięła się liczba w tabeli 4, a Ty otwierasz po kolei wszystko, co ma w nazwie „wyniki”.
Ten wpis podaje minimalny system dla jednej osoby piszącej jedną pracę: pięć folderów, jedna reguła dla danych surowych, jeden wzór nazwy, kopie zapasowe i osobne miejsce na dane identyfikujące. Wdrożysz go w godzinę, najlepiej przed pierwszą odpowiedzią w ankiecie. Pozostałe etapy układa harmonogram pracy empirycznej i wpis o tym, w jakiej kolejności pisać.
Większe projekty mają własne narzędzia. Grant zwykle wymaga planu zarządzania danymi (zob. wpis o DMP i FAIR), a publikacja – pakietu replikacyjnego. System opisany niżej jest prostszy i łatwo go do nich rozbudować. Warto zacząć od razu, bo pamięć i stare dyski zawodzą szybko. Vines i in. (2014) poprosili o dane z 516 artykułów sprzed 2–22 lat. Tam, gdzie autorzy podali los swoich danych, szansa (odds), że zbiór nadal istnieje, malała o 17% z każdym rokiem.
Pięć folderów zamiast jednego
Wilson i in. (2017) w zestawie „wystarczająco dobrych” praktyk radzą trzymać każdy projekt w osobnym folderze i rozdzielić dane, wyniki, kod oraz dokumenty. Dla pracy dyplomowej wystarczy pięć podfolderów. Numery w nazwach ustawiają je w kolejności pracy, a rysunek 1 pokazuje, co dokąd przepływa.
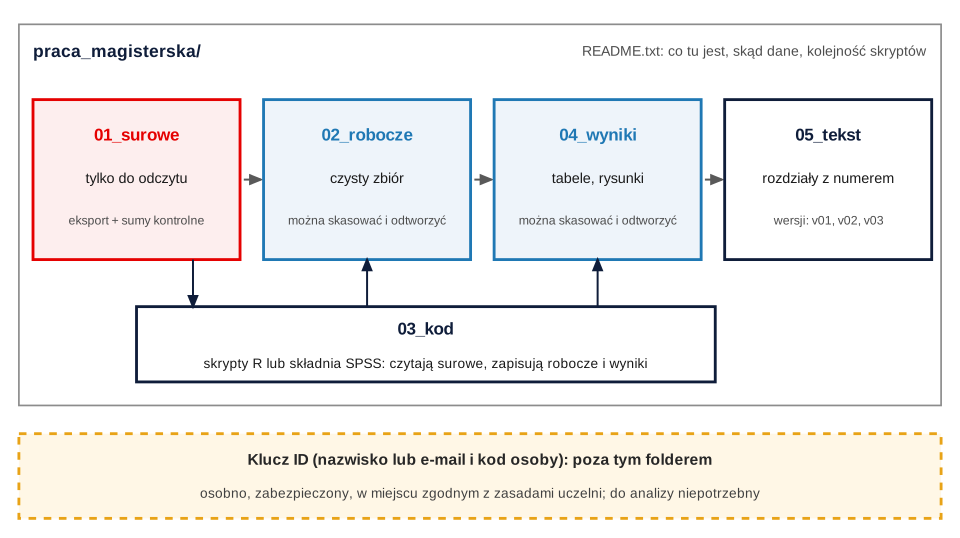
| Folder | Co w nim leży | Zasada |
|---|---|---|
01_surowe | Eksport z formularza, plik z wpisanych ankiet, sumy_kontrolne.csv | Nikt tu niczego nie edytuje |
02_robocze | Czysty zbiór, pliki pośrednie | Powstają z kodu, można je skasować |
03_kod | Skrypty R, składnia SPSS: 01_import, 02_skale, 03_analizy | Numer mówi, co uruchomić najpierw |
04_wyniki | Tabele, rysunki, wydruki z analiz | Nie poprawiasz ich ręcznie |
05_tekst | Rozdziały, uwagi promotora, dziennik_wersji.txt | Każda wersja ma numer |
W folderze głównym połóż README.txt, czyli kilka zdań o tym, co tu jest i skąd pochodzą dane (Wilson i in., 2017; wypełniony wzór znajdziesz niżej). Obok danych trzymaj książkę kodową. Sandve i in. (2013) radzą unikać ręcznych przekształceń danych i zapisywać, jak powstał każdy wynik. Dlatego strzałki z rysunku biegną przez folder z kodem.
Jeśli pracujesz tylko w Excelu, układ się nie zmienia. W 03_kod trzymasz wtedy plik tekstowy z listą kroków, a 01_surowe otwierasz wyłącznie po to, by zrobić kopię do 02_robocze. O granicach takiej pracy piszemy we wpisie czy Excel wystarczy. Program do analizy nie ma tu znaczenia: składnię SPSS opisuje wpis o przygotowaniu danych w SPSS, a od podstaw R zaczyna R dla początkujących. Układ kolumn w arkuszu omawia wpis o bazie danych i hasło dane uporządkowane.
Surowe dane tylko do odczytu
Plik surowy to pierwszy zapis tego, co odpowiedzieli badani. Od chwili pobrania nikt go nie zmienia, także Ty. Każda poprawka powstaje w skrypcie i trafia do innego pliku. Zasadę, reguły kontroli i dziennik zmian pojedynczych wartości opisaliśmy we wpisie o kontroli danych, a import arkusza w poradniku o pułapkach Excela. Dane z papierowych ankiet przygotowuje wpis o wprowadzaniu ankiet. Jeśli pracujesz na cudzych danych, plik od dostawcy traktuj tak samo. Tu liczy się mechanizm, który chroni plik przed Tobą samym.
Wilson i in. (2017) proponują ustawić prawo tylko do odczytu albo włączyć ochronę arkusza, aby trudniej było zepsuć dane przypadkiem. W Windows zaznacz „Tylko do odczytu” we właściwościach pliku, a w macOS użyj blokady w oknie informacji o pliku. Broman i Woo (2018) dodają: nie rób obliczeń w pliku z danymi surowymi i zapisuj je w zwykłym pliku tekstowym, np. CSV. Otwieranie CSV w arkuszu też ma swoją cenę. Ziemann i in. (2016) znaleźli błędy z automatycznej konwersji nazw genów na daty i liczby w około jednej piątej artykułów z czołowych czasopism genomicznych, które dołączały listy genów w Excelu. Jeden zapis z arkusza może po cichu zmienić dane.
Suma kontrolna: jak sprawdzić, że nic się nie zmieniło
Blokada utrudnia zmianę, ale jej nie wyklucza. Hart i in. (2016) radzą wygenerować dla danych surowych skrót kryptograficzny, np. SHA albo MD5, który ujawni ciche uszkodzenie lub zmianę pliku. Taki skrót to krótki ciąg znaków liczony z zawartości pliku. Zmienisz jeden bajt, a ciąg będzie inny.
W fikcyjnym przykładzie 40 osób odpowiedziało na ankietę, a plik 2026-03-14_ankieta_surowe.csv ma 540 bajtów i sumę MD5 4305c9ac9923d3bcd5c95bead41ee533. Skrypt (kod niżej) zapisuje ją w rejestrze i porównuje przy każdym uruchomieniu. Oto, co pokazał:
| Zdarzenie | Wynik kontroli | Co to znaczy |
|---|---|---|
| Plik wczytano i policzono średnią (M = 25.05) | BEZ ZMIAN | Analiza nie rusza oryginału |
| Wiek jednej osoby zmieniono o 9 lat | ZMIENIONY | Wykryta jedna komórka na 120 |
| Te same liczby, inny zapis końca wiersza | ZMIENIONY | Dane identyczne, bajty nie |
| Plik przywrócono z kopii | BEZ ZMIAN | Kopia była wierna |
Trzeci wiersz jest ważny. Suma mówi, że plik się różni, a nie co się zmieniło. Zapis przez inny program albo w innym systemie też ją zmieni, choć dane będą takie same. Wtedy porównaj zawartość. Suma służy do wykrywania przypadkowych zmian i nie zastępuje kopii zapasowej. Wynik „ZMIENIONY” oznacza tylko tyle, że trzeba sięgnąć po kopię.
Nazwy plików: jeden wzór, bez „final2”
- Data z przodu, w formacie RRRR-MM-DD. Pliki same układają się chronologicznie. Ten zapis dat zalecają też Broman i Woo (2018).
- Tylko litery bez ogonków, cyfry, „_” i „-”. Spacje i polskie znaki bywają przekłamywane przy pakowaniu plików, wysyłce i w skryptach.
- Wersja na dwóch cyfrach. Dzięki
v09iv10kolejność zostaje poprawna. - Treść, nie emocje. Słowa „final”, „ostateczny”, „nowy”, „poprawiony” są prawdziwe tylko do następnej poprawki.
| Jak bywa | Co nie tak | Poprawione |
|---|---|---|
praca final2 POPRAWIONA.docx | Trzy obietnice, że to już koniec; spacje | 2026-05-02_praca_calosc_v07.docx |
dane nowe (1).xlsx | Nowe względem czego? „(1)” dopisał system | 2026-03-14_ankieta_surowe.xlsx |
Rozdział4_ostateczny.docx | Ogonek, brak daty i wersji | 2026-05-02_rozdzial4_wyniki_v03.docx |
ankieta 14.03.csv | Rok nieznany, nie sortuje się po czasie | 2026-03-14_ankieta_surowe.csv |
wyniki.spv | Nie wiadomo, z którego zbioru i analizy | 2026-04-11_tabele_h1_h2_v01.spv |
rozdz4 uwagi pana promotora.docx | Spacje, brak numeru wersji, której dotyczą uwagi | 2026-05-09_rozdzial4_wyniki_v03_uwagi-promotora.docx |
Plik surowy nie potrzebuje numeru wersji, bo drugiej wersji nie będzie. Wystarczy słowo surowe. Skrypty mają własne numery: 01_import.R. Gdy oddajesz pracę, nazwa zapisuje fakt, a nie nadzieję: 2026-06-20_praca_calosc_v12_zlozona.pdf. Krótka funkcja w kodzie sprawdza nazwy automatycznie. Pierwsze trzy nazwy z tabeli nie przeszły w niej żadnego testu.
Wersje tekstu: co zapisywać i jak często
Pliki trzymane na koncie w chmurze, także uczelnianym, zwykle mają historię wersji, a Word potrafi z niej korzystać. Włącz tę funkcję i sprawdź, jak długo starsze wersje są przechowywane. Nie zastępuje ona jednak Twojej numeracji, bo historia pamięta chwile zapisu, a nie to, co było ważne. Dlatego nową wersję numerowaną zapisz w trzech momentach:
- przed wysłaniem pliku promotorowi,
- przed większą przebudową rozdziału,
- po wprowadzeniu uwag.
Uwagi promotora zostają jako osobny plik: nie przyjmuj zmian w jedynym egzemplarzu. Sposób pracy z nimi omawia wpis o poprawkach promotora. Wilson i in. (2017) radzą prowadzić plik CHANGELOG.txt z datowanymi notatkami, najnowszą na górze, i kopiować cały projekt do folderu z datą przy każdej istotnej zmianie. W pracy dyplomowej wystarczy dziennik_wersji.txt, po jednym wierszu na wersję. Nie myl go z dziennikiem zmian w danych: tu notujesz, co stało się z tekstem i analizą.
2026-05-02 v03: wysłano promotorowi rozdział 4.
2026-04-27 v02: zmiana układu tabel, bez zmiany analiz.
Kopie zapasowe: 3-2-1
Popularna praktyka nazywa się 3-2-1: trzy kopie, dwa różne nośniki, jedna kopia poza domem (rysunek 2). Hart i in. (2016) opisują podobny układ, czyli dwie kopie na miejscu i jedną w innej lokalizacji, zaznaczając, że ta ostatnia musi być tak samo bezpieczna jak pozostałe. Wilson i in. (2017) również radzą przechowywać dane surowe w więcej niż jednym miejscu i pytać o rozwiązania uczelni.
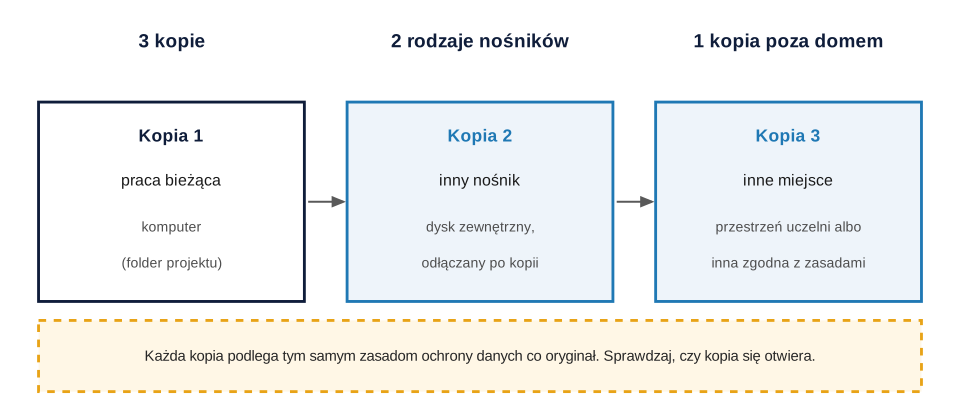
Trzy rzeczy decydują o tym, czy kopia zadziała:
- Synchronizacja to nie kopia zapasowa. Skasowany lub nadpisany plik znika także na drugim urządzeniu. Dlatego dysk odłączaj po każdym kopiowaniu.
- Stały termin. Raz w tygodniu i przed każdą wysyłką do promotora. Po pierwszym dniu zbierania danych kopiuj też eksport.
- Próba odtworzenia. Hart i in. (2016) radzą regularnie testować kopie i podają typowe przyczyny awarii, m.in. błędną konfigurację i utracone hasło do zaszyfrowanej kopii. Otwórz plik z kopii, a dla danych surowych porównaj sumę kontrolną.
Dane osobowe: klucz osobno
To, co zebrałaś lub zebrałeś, często pozwala kogoś rozpoznać: e-mail w eksporcie formularza, adres IP, nazwisko na zgodzie, a w małej grupie nawet kombinacja wieku i stanowiska. Nie przechowuj danych z identyfikatorami na prywatnych dyskach, także w prywatnej chmurze, bez sprawdzenia zasad. Reguły ustalają uczelnia, komisja bioetyczna, instytucja, w której zbierano dane, oraz to, co obiecałaś lub obiecałeś w informacji dla uczestnika. W razie wątpliwości zapytaj promotora albo inspektora ochrony danych uczelni. Ten wpis nie jest poradą prawną; pojęcia wyjaśniają hasła świadoma zgoda i RODO oraz anonimizacja i pseudonimizacja, a o zgodzie komisji piszemy w osobnym haśle.
- Klucz ID osobno. Plik łączący kod osoby z nazwiskiem lub adresem e-mail nie leży w folderze projektu ani w wiadomości do promotora. Budowę kodu i ryzyka omawia wpis o kodzie identyfikacyjnym.
- Usuń identyfikatory na początku. Pierwszy krok skryptu odcina zbędne kolumny (e-mail, IP, odpowiedzi otwarte z nazwiskami) w pliku roboczym. Sprawdź, co naprawdę zawiera eksport.
- Szyfrowanie. Klucz i dane z identyfikatorami trzymaj na zaszyfrowanym nośniku lub w zaszyfrowanym kontenerze, jeśli zasady tego wymagają lub dopuszczają taki sposób. Hasło przechowuj gdzie indziej niż nośnik. Bez hasła nie odzyskasz niczego.
- Chmura uczelniana czy prywatna. Konto uczelniane często jest lepszym wyborem, ale nie zakładaj tego: sprawdź, czy uczelnia dopuszcza tam dane badawcze i kto ma dostęp do folderu.
- Kopie też się liczą. Zasada 3-2-1 obejmuje plik z danymi osobowymi tylko w miejscach, które są dozwolone. Prościej robić kopie zbioru bez identyfikatorów, a klucz chronić osobno.
Jak wysłać plik promotorowi
- Wysyłaj to, o co poproszono: jeden rozdział, a nie cały folder. Format uzgodnij (DOCX do komentarzy, PDF do czytania).
- W wiadomości napisz, co się zmieniło i o co pytasz.
- Nie wysyłaj pocztą danych z identyfikatorami ani klucza. Jeśli promotor chce zajrzeć do danych, przekaż zbiór bez identyfikatorów i uzgodnij kanał dopuszczony przez uczelnię. Przed wysłaniem arkusza sprawdź ukryte karty i kolumny.
- Numer wersji wysłanej zapisz w dzienniku, a plik zostaw bez zmian.
| Jak bywa | Co nie tak | Poprawione |
|---|---|---|
| „W załączniku praca, proszę o sprawdzenie.” | Nie wiadomo, która wersja, co się zmieniło i czego szukać | Wiadomość poniżej: wersja, zakres zmian, jedno konkretne pytanie |
przesyłam rozdział 4 w wersji v03 (plik [nazwa pliku]). Od poprzedniej wersji zmieniłem/zmieniłam [tabele X i Y, opis hipotezy Z], zgodnie z uwagami z [data]. Analizy nie uległy zmianie / uległy zmianie w [zakres].
Proszę o opinię przede wszystkim w sprawie: [jedno konkretne pytanie]. Pliku z danymi nie dołączam, bo zawiera on odpowiedzi uczestników; jeśli będzie potrzebny, przygotuję wersję bez identyfikatorów i przekażę ją sposobem wskazanym przez Pana/Panią.
Z poważaniem,
[imię i nazwisko]
Gdy zgubisz albo nadpiszesz plik
Najpierw przestań pracować na tym nośniku. Każdy kolejny zapis może zająć miejsce usuniętego pliku. Potem idź według tabeli, od najtańszego sposobu.
| Co się stało | Gdzie szukać, po kolei | Na co uważać |
|---|---|---|
| Nadpisany tekst | Historia wersji pliku, autoodzyskiwanie w edytorze, ostatnia wersja wysłana promotorowi, kopia | Odzyskany plik zapisz pod nową nazwą |
| Skasowany plik | Kosz systemu, osobny kosz chmury, kopia na dysku, kopie systemowe | Kosze czyszczą się po pewnym czasie |
| Nadpisane dane surowe | Kopia zapasowa (porównaj sumę), ponowny eksport z formularza, oryginały papierowe | Świeży eksport może mieć inne kolumny: sprawdź liczbę wierszy |
| Zgubione wyniki lub plik roboczy | Uruchom skrypt od nowa | Dlatego te foldery można było skasować |
| Awaria dysku | Przestań go używać, sprawdź kopie | Firma odzyskująca dane zobaczy nośnik: przy danych osobowych najpierw zapytaj uczelnię |
| Zgubiony laptop lub pendrive z danymi osobowymi | Od razu powiadom promotora i inspektora ochrony danych | To już nie tylko utrata pliku; nie czekaj, aż się znajdzie |
| Zgubiony klucz ID | Kopia klucza w dozwolonym miejscu | Bez klucza nie łącz pomiarów „na oko” |
Jeśli danych nie da się odzyskać, powiedz o tym promotorowi. Nie odtwarzaj odpowiedzi z pamięci, z tabel ani z wydruków i nie wpisuj ich jako danych. To byłoby fabrykowanie. Możliwe wyjścia to dodatkowe zbieranie danych, oparcie się na części, która ocalała, albo zmiana planu, i każde z nich trzeba jawnie opisać. Inne awarie na etapie danych omawia wpis o błędzie w ankiecie po zebraniu danych. Odzyskanie pliku odnotuj w dzienniku:
Kiedy co usunąć
Terminy zależą od zasad uczelni, komisji i tego, co napisano w informacji dla uczestnika. Nie ma jednej reguły, więc tabela podaje tylko ogólną kolejność.
| Co | Zwykle kiedy | Co sprawdzić |
|---|---|---|
| Klucz ID, dane kontaktowe | Gdy przestają być potrzebne, często najwcześniej ze wszystkiego | Obietnica z informacji dla uczestnika, zasady komisji |
| Dane surowe, papierowe ankiety, zgody | Nie przed upływem terminu przechowywania | Uczelnia, komisja, instytucja, promotor |
| Pliki robocze | Po obronie; odtworzysz je z kodu | Czy skrypt nadal działa |
| Stare wersje tekstu | Po obronie; zostaw złożoną i ostatnią roboczą | Czy nie czekają poprawki |
| Kopie zapasowe | Razem z oryginałem | Dysk, chmura, kosze, poczta |
Usunięcie obejmuje wszystkie kopie. Klucz, który „skasowano”, ale który został na dysku zapasowym, nadal istnieje. Jak z tych plików wybrać załączniki do pracy, opisuje osobny wpis.
Gotowe teksty: README i zdania do metody
Przykład README (dane i projekt fikcyjne):
DANE: 01_surowe/2026-03-14_ankieta_surowe.csv – eksport z formularza online z 14 marca 2026 r., 40 osób, bez nazwisk i adresów e-mail.
SUMA MD5: 4305c9ac9923d3bcd5c95bead41ee533 (rejestr: 01_surowe/sumy_kontrolne.csv).
OPIS ZMIENNYCH: 01_surowe/ksiazka_kodowa.xlsx.
KOLEJNOŚĆ: 03_kod/01_import.R, 02_skale.R, 03_analizy.R.
KLUCZ ID: nie w tym folderze.
KONTAKT: [adres e-mail].
Jeśli uczelnia lub komisja oczekuje opisu postępowania z danymi, możesz wyjść od takiego fragmentu. Wpisz tylko to, co faktycznie robisz:
Struktura folderów i suma kontrolna w R
Skrypt działa w katalogu tymczasowym i po sobie sprząta. Końce wierszy są ustawione na stałe, dzięki czemu suma nie zależy od systemu. Dane są fikcyjne, a skrypt korzysta tylko z bazowego R i pakietu tools, który jest częścią dystrybucji R.
Foldery, blokada, rejestr sum, kontrola nazw
R
# Porządek w plikach pracy: struktura folderów, plik surowy tylko do odczytu, sumy kontrolne, nazwy plików.
# Dane fikcyjne (symulowane). Cały przykład działa w katalogu tymczasowym.
set.seed(508)
options(width = 100)
projekt <- file.path(tempdir(), "praca_magisterska")
foldery <- c("01_surowe", "02_robocze", "03_kod", "04_wyniki", "05_tekst")
for (f in foldery) dir.create(file.path(projekt, f), recursive = TRUE)
writeLines("Opis projektu: co, skad, kiedy, kolejnosc skryptow.", file.path(projekt, "README.txt"))

# Fikcyjny eksport ankiety: 40 osób, bez nazwisk i adresów e-mail
n <- 40
ankieta <- data.frame(id = sprintf("R%03d", 1:n),
                      wiek = sample(21:48, n, replace = TRUE),
                      stres = sample(10:40, n, replace = TRUE))
nazwa_pliku <- "2026-03-14_ankieta_surowe.csv"
plik <- file.path(projekt, "01_surowe", nazwa_pliku)
write.csv(ankieta, plik, row.names = FALSE, eol = "\n")

# Krok 1: plik surowy tylko do odczytu
Sys.chmod(plik, mode = "444")
cat("Czy można zapisać w pliku surowym:", file.access(plik, mode = 2) == 0, "\n")
zablokowany <- tryCatch({ suppressWarnings(write.csv(ankieta[1:5, ], plik)); FALSE },
                        error = function(e) TRUE)
cat("Próba nadpisania została zablokowana:", zablokowany, "\n")

# Krok 2: wpis sumy kontrolnej do rejestru obok danych
rejestr <- file.path(projekt, "01_surowe", "sumy_kontrolne.csv")
wpisz_sume <- function(p, data_wpisu) {
  wpis <- data.frame(plik = basename(p), bajty = file.size(p),
                     md5 = unname(tools::md5sum(p)), data_wpisu = data_wpisu)
  write.csv(wpis, rejestr, row.names = FALSE, eol = "\n")
  wpis
}
print(wpisz_sume(plik, "2026-03-14"), row.names = FALSE)

# Krok 3: kontrola na początku każdej sesji pracy
sprawdz_surowy <- function(p) {
  wzor <- read.csv(rejestr)
  teraz <- unname(tools::md5sum(p))
  if (identical(teraz, wzor$md5[wzor$plik == basename(p)])) "BEZ ZMIAN" else "ZMIENIONY"
}
dane <- read.csv(plik)
cat("Średni stres:", round(mean(dane$stres), 2), "| plik po analizie:", sprawdz_surowy(plik), "\n")

# Kopia zapasowa: ta sama suma znaczy ten sam plik, także pod inną nazwą
kopia <- file.path(tempdir(), "kopia_zapasowa.csv")
invisible(file.copy(plik, kopia))
cat("Kopia identyczna z oryginałem:",
    identical(unname(tools::md5sum(kopia)), unname(tools::md5sum(plik))), "\n")

# Trzy zdarzenia, które suma ma wykryć albo nie
Sys.chmod(plik, mode = "644")
zmiana <- ankieta; zmiana$wiek[17] <- zmiana$wiek[17] + 9      # jedna cyfra w jednej komórce
write.csv(zmiana, plik, row.names = FALSE, eol = "\n")
cat("Zmiana jednej komórki:", sprawdz_surowy(plik), "\n")

write.csv(ankieta, plik, row.names = FALSE, eol = "\r\n")      # te same dane, inne końce wierszy
cat("Te same liczby, inny zapis końca wiersza:", sprawdz_surowy(plik),
    "| dane identyczne:", isTRUE(all.equal(read.csv(plik), ankieta)), "\n")

invisible(file.copy(kopia, plik, overwrite = TRUE))            # przywrócenie z kopii
cat("Po przywróceniu z kopii:", sprawdz_surowy(plik), "\n")
Sys.chmod(plik, mode = "444")

# Kontrola nazw plików
ocen_nazwe <- function(x) {
  s <- tools::file_path_sans_ext(x)
  data.frame(nazwa = x,
             znaki_ok = !grepl("[^A-Za-z0-9._-]", x),
             data_iso = grepl("^[0-9]{4}-[0-9]{2}-[0-9]{2}_", x),
             wersja = grepl("_v[0-9]{2}", s) | grepl("_surowe$", s),
             bez_final = !grepl("final|ostateczn|now[ey]|popraw", tolower(x)))
}
nazwy <- c("praca final2 POPRAWIONA.docx", "dane nowe (1).xlsx", "Rozdział4_ostateczny.docx",
           "2026-05-02_rozdzial4_wyniki_v03.docx", "2026-03-14_ankieta_surowe.csv")
print(do.call(rbind, lapply(nazwy, ocen_nazwe)), row.names = FALSE)

cat("\nStruktura projektu:\n")
writeLines(list.files(projekt, recursive = TRUE, include.dirs = TRUE))
unlink(c(projekt, kopia), recursive = TRUE)
Wynik
Czy można zapisać w pliku surowym: FALSE
Próba nadpisania została zablokowana: TRUE
                          plik bajty                              md5 data_wpisu
 2026-03-14_ankieta_surowe.csv   540 4305c9ac9923d3bcd5c95bead41ee533 2026-03-14
Średni stres: 25.05 | plik po analizie: BEZ ZMIAN
Kopia identyczna z oryginałem: TRUE
Zmiana jednej komórki: ZMIENIONY
Te same liczby, inny zapis końca wiersza: ZMIENIONY | dane identyczne: TRUE
Po przywróceniu z kopii: BEZ ZMIAN
                                nazwa znaki_ok data_iso wersja bez_final
         praca final2 POPRAWIONA.docx    FALSE    FALSE  FALSE     FALSE
                   dane nowe (1).xlsx    FALSE    FALSE  FALSE     FALSE
            Rozdział4_ostateczny.docx    FALSE    FALSE  FALSE     FALSE
 2026-05-02_rozdzial4_wyniki_v03.docx     TRUE     TRUE   TRUE      TRUE
        2026-03-14_ankieta_surowe.csv     TRUE     TRUE   TRUE      TRUE

Struktura projektu:
01_surowe
01_surowe/2026-03-14_ankieta_surowe.csv
01_surowe/sumy_kontrolne.csv
02_robocze
03_kod
04_wyniki
05_tekst
README.txt
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe i pakiet tools); schematy przygotowano w pakietach ggplot2 i svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Czyszczenie danych w pliku surowym. Po tygodniu nikt nie odtworzy, co usunięto.
- Jedna kopia na pendrive’ie noszonym z laptopem. Zginą razem.
- Uznanie synchronizacji za kopię. Pomyłka rozchodzi się na wszystkie urządzenia.
- Klucz ID w tym samym folderze co dane. Kod przestaje wtedy cokolwiek chronić.
- Eksport z formularza z adresami e-mail w chmurze prywatnej. Bez sprawdzenia zasad to ryzyko dla uczestników i dla Ciebie.
- Ręczne poprawianie tabel w Wordzie. Liczby przestają zgadzać się z wynikami skryptu.
- Pamiętanie zamiast notowania. Bez README i dziennika własne pliki po miesiącu stają się cudze.
- Kopia, której nikt nigdy nie otworzył. O jej stanie dowiesz się w najgorszym momencie.
Lista kontrolna przed pierwszą odpowiedzią w ankiecie
- Czy projekt ma pięć folderów i README?
- Czy plik surowy ma datę, blokadę i wpis sumy kontrolnej?
- Czy nazwy spełniają wzór i nie ma w nich słowa „final”?
- Czy historia wersji działa, a dziennik wersji ma pierwszy wpis?
- Czy są trzy kopie na dwóch nośnikach, a jedna poza domem?
- Czy kopię udało się otworzyć?
- Czy sprawdzono, gdzie wolno trzymać dane z identyfikatorami?
- Czy klucz ID leży poza projektem, a identyfikatory znikają w pierwszym kroku skryptu?
- Czy wiadomo, kiedy i przez kogo zostaną usunięte klucz i dane?
Najczęstsze pytania
Jak nazywać pliki w pracy magisterskiej?
Użyj wzoru RRRR-MM-DD_co-to-jest_v01, np. 2026-05-02_rozdzial4_wyniki_v03.docx. Bez spacji i polskich znaków, z wersją na dwóch cyfrach. Unikaj słów „final” i „poprawiony”, bo przestają być prawdą przy następnej poprawce.
Czy mogę trzymać dane z ankiety na prywatnym dysku w chmurze?
Nie zakładaj, że tak. Dane z identyfikatorami, takimi jak e-mail czy adres IP, trzymaj tylko tam, gdzie pozwalają zasady uczelni, komisji i informacja dla uczestnika. Zapytaj promotora albo inspektora ochrony danych. Zbiór bez identyfikatorów jest prostszy, ale małe grupy nadal mogą pozwalać na rozpoznanie osób.
Co zrobić, gdy nadpisałem plik z danymi?
Przestań zapisywać na tym nośniku, sprawdź historię wersji i kopię zapasową, a przy eksporcie z formularza pobierz go ponownie. Porównaj sumę kontrolną i liczbę wierszy, a zdarzenie opisz w dzienniku. Nigdy nie odtwarzaj odpowiedzi z pamięci ani z tabel.
Po co liczyć sumę kontrolną pliku z danymi?
Suma kontrolna, np. MD5, to krótki ciąg znaków zależny od zawartości pliku. Porównanie z wpisem w rejestrze pokazuje, czy plik zmienił się choćby o jeden bajt. Mówi, że coś się zmieniło, ale nie co; zmieni się też po samym ponownym zapisaniu w innym programie.
Ile kopii zapasowych pracy magisterskiej powinienem mieć?
Dobrą praktyką jest zasada 3-2-1: trzy kopie, dwa rodzaje nośników, jedna kopia poza domem. Synchronizacja nie jest kopią, bo powiela też pomyłki. Regularnie sprawdzaj, czy kopia się otwiera.
Powiązane hasła
Przeczytaj też
Uczestnik wycofuje się po zebraniu danych
Rezygnacja czy usunięcie, ankieta anonimowa a kod: co zrobić, wzory odpowiedzi, usunięcie rekordów w R i zdania do Metody.
Czytaj →PoradnikReguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikPlan zarządzania danymi (DMP) i zasady FAIR
Sześć części DMP według Science Europe, FAIR w praktyce, repozytoria, CC BY i CC0, anonimizacja, książka kodowa i wzór konspektu planu.
Czytaj →PoradnikW jakiej kolejności pisać pracę
Co napisać przed danymi, puste tabele jako szkielet wyników, co dopiero po danych i na końcu, pętle powrotu oraz zamiana czasów.
Czytaj →PoradnikImport z Excela do SPSS i R – pułapki
Nagłówki w dwóch wierszach, „brak” w komórkach, przecinek dziesiętny i daty jako liczby: jak je wykryć i naprawić w R i SPSS.
Czytaj →Masz dane w kilku plikach i nie wiesz, który jest właściwy?
Pomożemy uporządkować zbiór, przygotować go do analizy, policzyć wyniki w R lub SPSS i wyjaśnimy obliczenia tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989 ● Otwarty dostęp: pełny tekst
- Hart, E. M., Barmby, P., LeBauer, D., Michonneau, F., Mount, S., Mulrooney, P., Poisot, T., Woo, K. H., Zimmerman, N. B., & Hollister, J. W. (2016). Ten simple rules for digital data storage. PLOS Computational Biology, 12(10), Article e1005097. https://doi.org/10.1371/journal.pcbi.1005097 ● Otwarty dostęp
- Sandve, G. K., Nekrutenko, A., Taylor, J., & Hovig, E. (2013). Ten Simple Rules for Reproducible Computational Research. PLoS Computational Biology, 9(10), Article e1003285. https://doi.org/10.1371/journal.pcbi.1003285 ● Otwarty dostęp
- Vines, T. H., Albert, A. Y. K., Andrew, R. L., Débarre, F., Bock, D. G., Franklin, M. T., Gilbert, K. J., Moore, J.-S., Renaut, S., & Rennison, D. J. (2014). The availability of research data declines rapidly with article age. Current Biology, 24(1), 94–97. https://doi.org/10.1016/j.cub.2013.11.014 ● Otwarty dostęp
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), Article e1005510. https://doi.org/10.1371/journal.pcbi.1005510 ● Otwarty dostęp
- Ziemann, M., Eren, Y., & El-Osta, A. (2016). Gene name errors are widespread in the scientific literature. Genome Biology, 17(1), Article 177. https://doi.org/10.1186/s13059-016-1044-7 ● Otwarty dostęp
Cytowania BibTeX
@article{broman2018data, author={Broman, Karl W. and Woo, Kara H.}, title={{Data organization in spreadsheets}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={2--10}, doi={10.1080/00031305.2017.1375989}}@article{hart2016ten, author={Hart, Edmund M. and Barmby, Pauline and LeBauer, David and Michonneau, François and Mount, Sarah and Mulrooney, Patrick and Poisot, Timothée and Woo, Kara H. and Zimmerman, Naupaka B. and Hollister, Jeffrey W.}, title={{Ten simple rules for digital data storage}}, journal={PLOS Computational Biology}, year={2016}, volume={12}, number={10}, eid={e1005097}, doi={10.1371/journal.pcbi.1005097}}@article{sandve2013ten, author={Sandve, Geir Kjetil and Nekrutenko, Anton and Taylor, James and Hovig, Eivind}, title={{Ten Simple Rules for Reproducible Computational Research}}, journal={PLoS Computational Biology}, year={2013}, volume={9}, number={10}, eid={e1003285}, doi={10.1371/journal.pcbi.1003285}}@article{vines2014availability, author={Vines, Timothy H. and Albert, Arianne Y. K. and Andrew, Rose L. and Débarre, Florence and Bock, Dan G. and Franklin, Michelle T. and Gilbert, Kimberly J. and Moore, Jean-Sébastien and Renaut, Sébastien and Rennison, Diana J.}, title={{The availability of research data declines rapidly with article age}}, journal={Current Biology}, year={2014}, volume={24}, number={1}, pages={94--97}, doi={10.1016/j.cub.2013.11.014}}@article{wilson2017good, author={Wilson, Greg and Bryan, Jennifer and Cranston, Karen and Kitzes, Justin and Nederbragt, Lex and Teal, Tracy K.}, title={{Good enough practices in scientific computing}}, journal={PLOS Computational Biology}, year={2017}, volume={13}, number={6}, eid={e1005510}, doi={10.1371/journal.pcbi.1005510}}@article{ziemann2016gene, author={Ziemann, Mark and Eren, Yotam and El-Osta, Assam}, title={{Gene name errors are widespread in the scientific literature}}, journal={Genome Biology}, year={2016}, volume={17}, number={1}, eid={177}, doi={10.1186/s13059-016-1044-7}}