Gdzie giną dane z papierowych ankiet
Ankieta papierowa wciąż ma swoje miejsce: na oddziale, w poczekalni poradni, wśród osób starszych. Każdą odpowiedź trzeba przepisać do arkusza, a każde przepisanie to okazja do pomyłki: 4 zamiast 5, „11” zamiast 1, bo palec został na klawiszu, pominięte pole, po którym reszta wiersza przesuwa się o jedną kolumnę. Program do analizy tych błędów nie zauważy.
Ogólne zasady budowy bazy – jeden wiersz to jedna osoba, krótkie nazwy zmiennych, kody zamiast słów, książka kodowa – opisuje poradnik jak przygotować bazę danych do analizy. Ten wpis jest węższy i dotyczy samego przepisywania papieru: jak ponumerować ankiety, jak przygotować arkusz pod wpisywanie, co zrobić z dwoma krzyżykami w jednym pytaniu, jak porównać dwa niezależne wprowadzenia w R i co zrobić, gdy drugiego wprowadzenia nie da się zorganizować.
Przykład przewodni (wymyślony, dane symulowane). Studentka fizjoterapii rozdała w poradni rehabilitacyjnej 220 ponumerowanych ankiet: metryczka, palenie papierosów z pytaniem filtrującym, natężenie bólu 0–10, osiem stwierdzeń o jakości snu i pięć o zadowoleniu z opieki (skala 1–5). Wróciło 200 ankiet, czyli 20 pól do wpisania w każdej i 4000 pól razem. Dwie osoby wpisały je niezależnie do dwóch plików. Wszystkie liczby w tekście pochodzą z kodu R na końcu wpisu.
Krok 1. Ponumeruj ankiety przed rozdaniem
Numer wpisz na każdej ankiecie, zanim trafi do respondenta – najlepiej na każdej stronie, jeśli ankieta ma kilka kartek i ktoś może je rozpiąć. Numer pełni trzy funkcje. Łączy wiersz w arkuszu z kartką papieru, więc każdą wątpliwą wartość sprawdzisz w oryginale. Pozwala policzyć, ile ankiet wróciło (tu 200 z 220, co jest podstawą wskaźnika odpowiedzi). Wreszcie wykrywa zgubione lub podwójnie wpisane kartki: numer, który występuje w bazie dwa razy albo wcale, od razu wskazuje problem.
Numer kwestionariusza nie jest daną osobową, dopóki nigdzie nie zapisujesz, kto dostał który numer. Nie prowadź listy „numer – nazwisko”. Jeśli musisz połączyć dwa pomiary tej samej osoby bez nazwisk, użyj kodu tworzonego przez respondenta, opisanego we wpisie o kodzie identyfikacyjnym w ankiecie anonimowej.
Obok numeracji prowadź rejestr ankiet: arkusz z numerami 1–220 i kolumnami „wróciła”, „data zwrotu”, „wpisała osoba A”, „wpisała osoba B”, „uwagi”. Do rejestru, a nie do arkusza danych, trafiają dopiski z marginesów, informacje o nieczytelnych polach i decyzje podjęte przy wpisywaniu. Rejestr jest gotowym źródłem liczb do opisu przepływu respondentów, opisanego we wpisie o diagramie przepływu respondentów.
Krok 2. Szablon arkusza ułożony pod papier
Arkusz do wpisywania różni się od arkusza do analizy jednym szczegółem: kolumny idą w tej samej kolejności co pytania na kartce. Osoba wpisująca przesuwa wzrok po ankiecie z góry na dół i po arkuszu od lewej do prawej, bez skakania między kolumnami. Pierwsza kolumna to numer ankiety (nr), potem metryczka i kolejne pytania. Pozycje skal mają nazwy z numerem (sen_01…sen_08), tak jak w książce kodowej. Pozycji odwróconych nie odwracaj przy wpisywaniu – wpisz zaznaczoną odpowiedź, a odwrócenie zrób w skrypcie.
Druga zasada: nie zostawiaj pustych komórek. Przy wpisywaniu z papieru pusta komórka jest dwuznaczna – respondent nie odpowiedział czy osoba wpisująca przeoczyła pole? Broman i Woo (2018) zaliczają brak pustych komórek do podstawowych zasad pracy w arkuszu. W szablonie każdy brak ma kod:
| Kod | Znaczenie | Kiedy wpisać |
|---|---|---|
| 99 | brak odpowiedzi | pole puste na papierze |
| 97 | nie dotyczy | pytanie pominięte zgodnie z filtrem (osoba niepaląca nie odpowiada, ile pali) |
| 96 | odpowiedź nieważna | dwa zaznaczenia w pytaniu jednokrotnego wyboru, krzyżyk między kratkami, nieczytelna liczba |
Kody 96–99 działają tylko tam, gdzie takie wartości są niemożliwe. W przykładzie kryterium włączenia to wiek 18–80 lat, więc 96 i 99 nie pomylą się z prawdziwym wiekiem. Szerzej o wyborze kodów i o tym, który z nich wliczać do mianownika, piszą wpisy pytania filtrujące i „nie dotyczy” oraz braki danych w ankiecie. Przed analizą zamień wszystkie trzy kody w skrypcie na braki.
Gotowy szablon możesz pobrać: szablon-wprowadzania-ankiet-papierowych.xlsx. Ma sześć arkuszy: Instrukcja (siedem zasad dla osoby wpisującej), Dane (21 kolumn z regułami poprawności w wierszach 2–301), Ksiazka_kodowa, Reguly (trudne przypadki), Rejestr_ankiet (numery 1–220) i Listy (dozwolone kody dla list rozwijanych). Nazwy kolumn i kody dopasuj do swojego kwestionariusza.
Krok 3. Reguły dla trudnych odpowiedzi – zanim zaczniesz wpisywać
Respondenci nie wypełniają ankiet tak, jak przewidział autor. Ktoś zaznaczy dwie odpowiedzi, ktoś postawi krzyżyk na linii między „3” i „4”, ktoś dopisze „zależy od dnia”. Jeśli każdą sytuację rozstrzygasz na bieżąco, dwie osoby wpisujące rozstrzygną ją inaczej, a po tygodniu nikt nie będzie pamiętać, jaka była decyzja. Dlatego reguły spisz przed wpisywaniem, przekaż obu osobom i dołącz do szablonu.
| Sytuacja na papierze | Co wpisać | Dlaczego |
|---|---|---|
| Puste pole | 99 | odróżnia brak odpowiedzi od przeoczenia przy wpisywaniu |
| Dwa zaznaczenia w pytaniu jednokrotnego wyboru | 96 | wybór jednego z nich byłby zgadywaniem |
| Krzyżyk między dwiema kratkami | 96 | „bliższa kratka” to decyzja osoby wpisującej, nie respondenta |
| Zaznaczenie skreślone, obok inne | to, które nie jest skreślone | respondent sam poprawił odpowiedź |
| Nieczytelna liczba | 96 i notatka w rejestrze | wartość odgadnięta nie jest daną |
| Przedział zamiast liczby („5–10 papierosów”) | 96 i treść w rejestrze | decyzję (np. środek przedziału) podejmiesz jawnie w skrypcie |
| Odpowiedź na pytanie, które filtr kazał pominąć | to, co jest na papierze | niespójność rozstrzyga reguła kontroli w skrypcie, a nie osoba wpisująca |
| Dopisek na marginesie | nic w arkuszu danych | treść trafia do rejestru ankiet |
Wspólna zasada wszystkich reguł: wpisuj to, co jest na papierze, a nie to, co respondent „miał na myśli”. Poprawki logiczne – na przykład osoba niepaląca, która podała liczbę papierosów – rób później w skrypcie, według reguł zapisanych z góry i z dziennikiem zmian. Pokazuje to wpis o regułach kontroli danych przed analizą. Pytania otwarte przepisz dosłownie do osobnej kolumny tekstowej, a kategorie nadaj później (zob. hasło kodowanie odpowiedzi otwartych).
Krok 4. Sprawdzanie poprawności danych w Excelu
Excel może odrzucać wartości spoza ustalonego zakresu jeszcze przy wpisywaniu. Na karcie Dane wybierasz Sprawdzanie poprawności danych i w polu Dozwolone ustawiasz na przykład pełne liczby z przedziału albo listę dozwolonych wartości (Microsoft, b.d.-b). W szablonie:
- kolumny skal (1–5) i pytań kategorialnych mają listy rozwijane z dozwolonymi kodami, np. 1, 2, 3, 4, 5, 96, 99 – wpisanie 6 albo 55 się nie uda;
- wiek i liczba papierosów przyjmują tylko liczby całkowite z określonego przedziału;
- numer ankiety przyjmuje liczby 1–220. Pomoc Microsoft pokazuje też regułę niestandardową z funkcją LICZ.JEŻELI, która pilnuje, żeby wartość w kolumnie się nie powtarzała – warto ją dodać do kolumny
nr.
W karcie Alert o błędzie wybierz styl Stop: wymaga poprawienia wartości, zanim osoba wpisująca przejdzie dalej. Styl Ostrzeżenie pozwala zostawić nieprawidłową wartość jednym kliknięciem (Microsoft, b.d.-b).
Reguły wychwytują tylko wartości niemożliwe: pomyłka 4 zamiast 5 przejdzie bez ostrzeżenia. Wartości wklejone z innego miejsca albo wpisane przed dodaniem reguły też mogą się prześlizgnąć. To pierwsze sito, a nie kontrola końcowa – zakresy i tak sprawdzisz w R. Granice samego arkusza opisuje wpis analiza statystyczna w Excelu.
Krok 5. Podwójne wprowadzanie: dwie osoby, dwa pliki
Podwójne wprowadzanie (ang. double data entry) polega na tym, że te same ankiety wpisuje się dwa razy, do dwóch osobnych plików, a potem porównuje pliki komórka po komórce. Każda niezgodność to miejsce, w którym co najmniej jedna osoba się pomyliła.
Za tą metodą stoją badania porównawcze. Barchard i Pace (2011) pokazali, że sprawdzanie wzrokowe zostawia wielokrotnie więcej błędów niż podwójne wprowadzanie (szczegóły w poradniku o bazie danych). W nowszym badaniu 412 studentów losowo przydzielono do czterech metod sprawdzania danych. Podwójne wprowadzanie okazało się wyraźnie dokładniejsze od sprawdzania wzrokowego i od czytania na głos, samodzielnego i w parze (Barchard i in., 2020). W badaniu kwestionariuszy pacjentów odsetek błędów wyniósł 0.046 na 1000 pól przy podwójnym i 0.370 na 1000 pól przy jednokrotnym ręcznym wprowadzaniu (Paulsen i in., 2012).
Trzy szczegóły decydują o tym, czy podwójne wprowadzanie działa:
- Druga osoba, jeśli to możliwe. W rejestrze przeszczepień nerek podwójne wprowadzanie przez inną osobę wykryło 88.3% błędów pierwszego wpisania, a przez tę samą osobę – 69.0% (Kawado i in., 2003). Ta sama osoba powtarza część własnych pomyłek, np. tak samo źle odczytuje niewyraźną cyfrę. Jeśli wpisujesz dwa razy samodzielnie, zrób przerwę między wprowadzeniami i wpisuj ankiety w innej kolejności.
- Pełna niezależność. Osoba B nie widzi pliku A, a pliki nie są „uzgadniane” po drodze. Obie korzystają z tego samego szablonu i tych samych reguł z kroku 3 – inaczej niezgodności będą wynikać z innych decyzji, a nie z pomyłek.
- Rozstrzyganie z papierem, nie między plikami. Barchard i in. (2020) zauważyli, że osoby stosujące podwójne wprowadzanie, gdy się myliły, uzgadniały oba wpisy między sobą – czasem wprowadzając nowy błąd. Autorzy proponują skupić się na zgodności z oryginalnym arkuszem, np. przez oddanie poprawiania niezgodności nowej osobie. W praktyce: niezgodność rozstrzyga ktoś trzeci, patrząc na ankietę, a nie na dwie wersje w arkuszu.
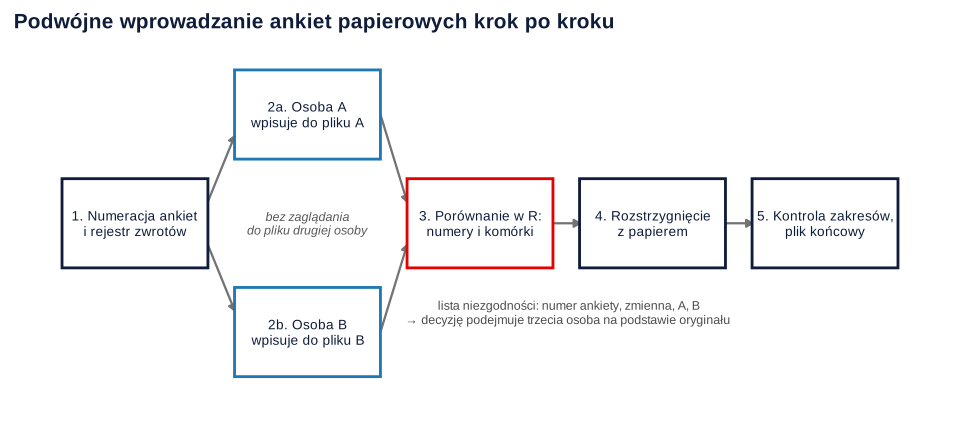
Krok 6. Porównanie dwóch plików w R
Porównanie ma dwa etapy. Najpierw sprawdzasz numery ankiet, bo wszystko inne zależy od tego, czy wiersze się dobrze łączą. W przykładzie oba pliki mają po 200 wierszy, ale w pliku B numer 201 występuje dwa razy, a numeru 102 nie ma wcale. Osoba B wpisała 102 jako 201 – przestawione cyfry. Który z dwóch wierszy B o numerze 201 to naprawdę ankieta 102? Jeden zgadza się z wpisem A dla ankiety 102 w 20 polach na 20, drugi w 5. Po sprawdzeniu numeru na kartce poprawiasz go w pliku B. Jak łączyć pliki po identyfikatorze i wykrywać takie problemy przy kilku źródłach danych, opisuje wpis o łączeniu danych z kilku plików ankiety.
Potem porównujesz komórka po komórce. Kod zamienia obie tabele na tekst (pustą komórkę na „(puste)”, żeby brak też był wartością do porównania), sortuje wiersze po numerze ankiety i wypisuje każdą różnicę: numer ankiety, zmienną, wartość w A i w B. W przykładzie na 4000 pól niezgodnych było 67 (1.68%), w 54 ankietach z 200. Lista wygląda tak:
| Nr ankiety | Zmienna | Plik A | Plik B | Co się stało |
|---|---|---|---|---|
| 4 | pal_ile | 97 | 9 | B opuściła cyfrę kodu „nie dotyczy” |
| 7 | plec | 11 | 1 | A dwa razy nacisnęła klawisz |
| 16 | zad_01 | (puste) | 4 | A przeoczyła pole |
| 21 | zad_03 | 4 | 44 | B dwa razy nacisnęła klawisz |
| 14 | zad_01 | 3 | 2 | wartość sąsiednia – bez kartki nie wiadomo, kto ma rację |
Listę zapisujesz do pliku CSV z pustymi kolumnami „oryginał” i „decyzja”. Trzecia osoba wyjmuje ankiety o podanych numerach, wpisuje wartość z papieru i poprawia plik. W symulacji znamy oryginały, więc widać, kto się mylił: osoba A w 47 polach (1.18%, 95% CI [0.86%, 1.56%]), osoba B w 20 (0.50%, 95% CI [0.31%, 0.77%]). Przedziały to dokładne przedziały Cloppera–Pearsona dla proporcji. Ani jeden błąd nie powtórzył się u obu osób. Błąd wspólny jest jedynym, którego porównanie nie wykryje, i przy niezależnych osobach zdarza się rzadko. Po rozstrzygnięciu wszystkich 67 niezgodności plik końcowy w symulacji nie różni się od oryginałów w żadnym polu.
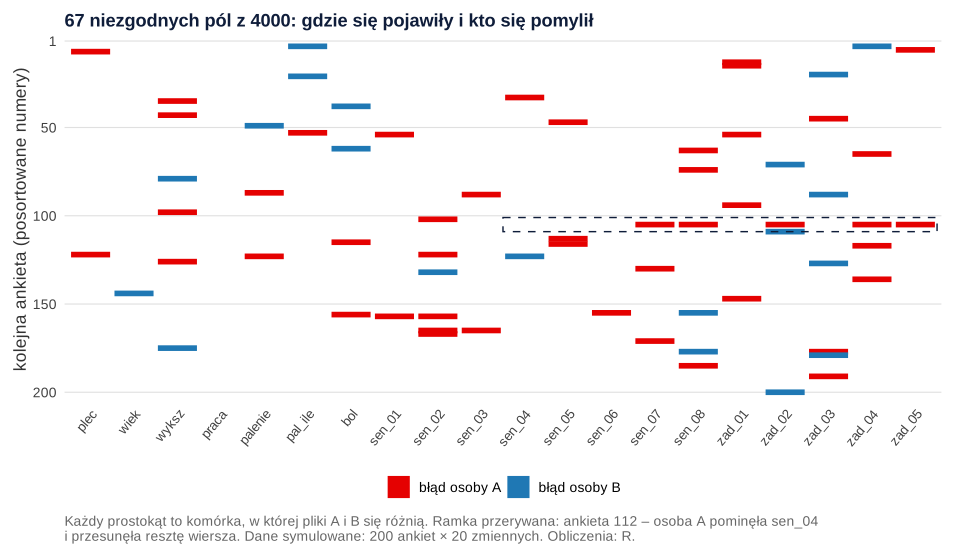
Rysunek 2 pokazuje coś, czego nie widać w samym odsetku: błędy nie rozkładają się równomiernie. Pięć niezgodności w ankiecie 112 to jeden błąd osoby A, która pominęła pole sen_04, przez co reszta wiersza przesunęła się o kolumnę w lewo. Odpowiedzi na sąsiednie stwierdzenia często są takie same, więc niezgodności jest mniej niż przesuniętych pól. Gdy w jednym wierszu widzisz serię niezgodności w kolejnych kolumnach, sprawdź przesunięcie, a nie każdą komórkę osobno.
Odsetek błędów obu osób podaj w rozdziale metodologicznym. Kod to kilkadziesiąt linii bazowego R. Jeśli dopiero zaczynasz, przeczytaj najpierw wpis R dla początkujących. Pliki z obu wprowadzeń możesz pobrać i przećwiczyć porównanie.
Czy nie wystarczy sprawdzić zakresów?
Podwójne wprowadzanie podwaja czas pracy, więc pytanie jest uczciwe. Day, Fayers i Harvey (1998) postawili je w badaniach klinicznych. Na symulowanych pomiarach ciśnienia pokazali, że proste kontrole zakresów wychwytują główne błędy, które zmieniają wyniki i wnioski. Błędy, które przechodzą przez kontrolę zakresów, mogą być liczne, ale miały niewielkie znaczenie dla wniosków. Autorzy podkreślają jednak, że metody łapią inne błędy: podwójne wprowadzanie sprawdza wierność wobec papieru, a analiza eksploracyjna – wiarygodność zapisanych wartości, i ta druga powinna być zawsze obowiązkowa.
W przykładzie kontrola zakresów i logiki pliku A (dozwolone kody, wiek 18–80, liczba papierosów tylko u palących) oznaczyła 20 pól. 19 z nich to rzeczywiste błędy, czyli 40% wszystkich 47 błędów osoby A. Pozostałe 28 to wartości dozwolone, ale inne niż na papierze, np. 3 zamiast 4 na skali 1–5. Kontrola zakresów zatrzyma więc „11” w kolumnie płci, ale nie pomyłkę o jeden punkt. W wyniku uśrednionym z ośmiu pozycji to często mała strata, w zmiennej grupującej – już nie. Dlatego rób jedno i drugie: podwójne wprowadzanie dla wierności z papierem, a reguły kontroli w skrypcie dla wiarygodności (wpis reguły kontroli danych i hasło czyszczenie danych z ankiety).
Gdy nie da się wpisać dwa razy: weryfikacja losowej próbki
Czasem drugiej osoby nie ma, a ankiet jest kilkaset. Wtedy minimum to sprawdzenie losowej próbki ankiet z oryginałami, pole po polu. Ankiety do sprawdzenia wylosuj w R (sample()), a nie wybieraj ręcznie – „kilka z wierzchu stosu” to nie jest próbka losowa. Atkinson (2012) w artykule o badaniach pielęgniarskich proponuje sposób sprawdzania dokładności wprowadzonych danych i oszacowania, z jaką pewnością można określić liczbę błędów. Barchard i in. (2020) radzą, by przy braku podwójnego wprowadzenia sprawdzać dane samodzielnym czytaniem na głos albo wzrokowo.
Regułę ustal przed losowaniem. W przykładzie brzmi ona tak: sprawdzam 20 ankiet (10%), a jeśli górna granica 95% przedziału ufności dla odsetka błędnych pól przekroczy 1%, wpisuję wszystkie ankiety drugi raz. Próg 1% jest umowny – ustal go z promotorem.
Wynik: w 20 wylosowanych ankietach, czyli 400 polach, znalazły się 2 błędy, 0.50%, 95% CI [0.06%, 1.79%]. Górna granica przekracza 1%, więc według reguły trzeba wpisać wszystko drugi raz. Symulacja zna prawdę: w całym pliku A błędnych było 1.18% pól, ponad dwa razy więcej, niż sugerowała próbka. Reguła oparta na granicy przedziału, a nie na samym oszacowaniu, uchroniła przed fałszywym spokojem.
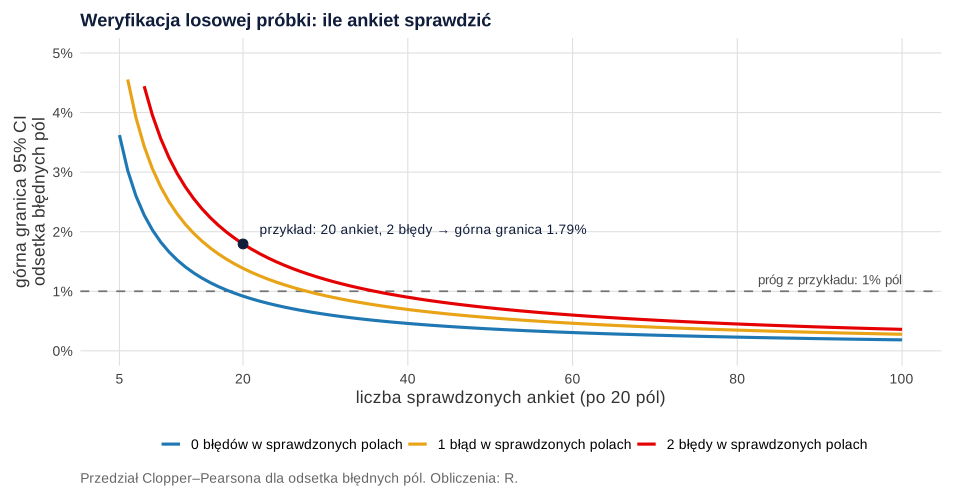
Ile ankiet sprawdzić? To zależy od tego, jak niski poziom błędu chcesz wykazać. Tabela pokazuje górną granicę 95% CI przy 20 polach na ankietę. Wynik pochodzi z rozkładu dwumianowego:
| Sprawdzone ankiety (pola) | 0 błędów | 1 błąd | 2 błędy |
|---|---|---|---|
| 10 (200) | 1.83% | 2.75% | 3.57% |
| 20 (400) | 0.92% | 1.38% | 1.79% |
| 30 (600) | 0.61% | 0.93% | 1.20% |
| 50 (1000) | 0.37% | 0.56% | 0.72% |
| 100 (2000) | 0.18% | 0.28% | 0.36% |
Żeby przy progu 1% obronić wynik z jednym znalezionym błędem, potrzebujesz około 30 ankiet. Dwie uwagi. Po pierwsze, przedział zakłada, że pola są niezależne, a błędy lubią się skupiać: jedno przesunięcie wiersza psuje kilka pól naraz. Dlatego podaj też drugi wskaźnik – odsetek ankiet z co najmniej jednym błędem (tu 2 z 20, 95% CI [1.2%, 31.7%]). Po drugie, weryfikacja mówi, ile błędów jest w bazie, ale poprawia tylko te w sprawdzonych ankietach. To rozwiązanie awaryjne, a nie zamiennik podwójnego wprowadzania.
Przechowywanie oryginałów i plików
Po wpisaniu i porównaniu ankiety papierowe nadal są potrzebne. To one rozstrzygają każdą wątpliwość, także tę, która pojawi się przy analizie albo w pytaniu recenzenta. Przechowuj je ułożone według numerów, w zamykanej szafie lub pudle, z dala od listy obecności czy zgód, jeśli zgody są podpisywane nazwiskiem. Jak długo i gdzie przechowywać materiały z badania, określają zasady Twojej uczelni, komisji bioetycznej i ewentualnie instytucji, w której zbierano dane. Sprawdź je u promotora, zanim cokolwiek zniszczysz. Ogólne zasady opisują hasła świadoma zgoda i RODO w badaniach oraz anonimizacja i pseudonimizacja danych.
Z plikami postępuj podobnie. Zachowaj oba surowe wprowadzenia (A i B), listę niezgodności z decyzjami i plik końcowy. Plik końcowy to od tej chwili surowe dane badania: nie poprawiasz go ręcznie, a wszystkie dalsze zmiany robisz w skrypcie. Broman i Woo (2018) radzą też nie trzymać obliczeń w plikach z danymi surowymi, nie zapisywać informacji kolorem komórki i robić kopie zapasowe. Taki zestaw plików to początek pakietu replikacyjnego, a w większym projekcie część planu zarządzania danymi. Jak potem bezpiecznie wczytać arkusz do SPSS lub R, opisuje wpis o imporcie danych z Excela.
Jak opisać wprowadzanie danych w metodzie
Wzór na podstawie przykładu. Uzupełnij nawiasy i usuń zdania, które Cię nie dotyczą (np. o weryfikacji próbki, jeśli wszystko wpisano dwa razy).
Wariant przy weryfikacji próbki:
Te same liczby muszą się zgadzać w opisie próby, tabelach i diagramie przepływu – pomoże wpis o kontroli spójności liczb w pracy.
Najczęstsze błędy
- Ankiety bez numerów. Nie da się wrócić do oryginału ani wykryć kartki wpisanej dwa razy.
- Reguły ustalane w trakcie. Dwie osoby rozstrzygają dwa zaznaczenia inaczej, a niezgodności mnożą się z powodu decyzji, nie pomyłek.
- „Poprawianie” respondenta przy wpisywaniu. Wybór bliższej kratki, odwracanie pozycji, uzupełnianie brakującego wieku z innej odpowiedzi.
- Uzgadnianie plików A i B między sobą. Niezgodność rozstrzyga papier, najlepiej w rękach trzeciej osoby.
- Porównanie przed sprawdzeniem numerów. Jeden przestawiony numer zestawia dwie różne ankiety i daje dziesiątki fałszywych niezgodności.
- Ręczne poprawki w pliku końcowym. Po zamknięciu wprowadzania każda zmiana idzie przez skrypt.
Jeśli chcesz, żeby ktoś sprawdził z Tobą szablon, reguły kodowania i porównanie plików przed analizą, zobacz pomoc w analizie dla studentów.
Szablon, porównanie plików i weryfikacja próbki w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy szablon XLSX, drugi porównuje dwa wprowadzenia, trzeci weryfikuje losową próbkę. Przepisy 2 i 3 uruchom w folderze z pobranymi plikami: ankiety-papierowe-wprowadzenie-A.csv, ankiety-papierowe-wprowadzenie-B.csv i ankiety-papierowe-oryginaly.csv (200 fikcyjnych ankiet, 21 kolumn; plik z oryginałami zastępuje w ćwiczeniu papierowe kartki). Dane wygenerowano symulacyjnie, a rysunki powstały w osobnym skrypcie na tych samych danych.
1. Szablon arkusza z regułami poprawności
R
# B444, przepis 1: szablon arkusza do wprowadzania ankiet papierowych (XLSX z regułami poprawności)
library(openxlsx)

zm <- c("nr", "plec", "wiek", "wyksz", "praca", "palenie", "pal_ile", "bol",
        sprintf("sen_%02d", 1:8), sprintf("zad_%02d", 1:5))
wiersze <- 2:301                                   # miejsce na 300 ankiet

ksiazka <- data.frame(
  zmienna = zm,
  pytanie = c("Numer z pierwszej strony ankiety (001–220)", "P1. Płeć", "P2. Wiek w latach",
              "P3. Wykształcenie", "P4. Czy obecnie pracuje Pan(i) zawodowo?",
              "P5. Czy pali Pan(i) papierosy? (Nie – przejdź do P7)", "P6. Ile papierosów dziennie?",
              "P7. Natężenie bólu w ostatnim tygodniu (0–10)",
              sprintf("P8.%d. Jakość snu – stwierdzenie %d", 1:8, 1:8),
              sprintf("P9.%d. Zadowolenie z opieki – stwierdzenie %d", 1:5, 1:5)),
  wartosci = c("liczba całkowita", "1 = kobieta, 2 = mężczyzna", "liczba lat (kryterium włączenia 18–80)",
               "1 = podstawowe, 2 = zawodowe, 3 = średnie, 4 = wyższe", "1 = tak, 2 = nie", "1 = tak, 2 = nie",
               "liczba 1–40", "0–10", rep("1 = zdecydowanie się nie zgadzam … 5 = zdecydowanie się zgadzam", 13)),
  kody_brakow = c("–", rep("96 = odpowiedź nieważna, 99 = brak odpowiedzi", 5),
                  "97 = nie dotyczy (P5 = 2), 96, 99", rep("96, 99", 14)),
  stringsAsFactors = FALSE)

reguly <- data.frame(
  sytuacja = c("Puste pole", "Dwa zaznaczenia w pytaniu jednokrotnego wyboru", "Krzyżyk między dwiema kratkami",
               "Zaznaczenie skreślone i obok inne", "Nieczytelna liczba (np. wiek)",
               "Odpowiedź na pytanie, które filtr kazał pominąć", "Przedział zamiast liczby (np. „5–10 papierosów”)",
               "Dopisek na marginesie", "Cała strona pusta"),
  co_wpisac = c("99", "96", "96 (nie wybieraj bliższej kratki)", "to zaznaczenie, które nie jest skreślone",
                "96 i numer ankiety w rejestrze", "to, co jest na papierze (spójność sprawdza skrypt)",
                "96 i treść w rejestrze", "nic w arkuszu danych; treść w rejestrze",
                "99 we wszystkich polach tej strony i notatka w rejestrze"),
  stringsAsFactors = FALSE)

instrukcja <- data.frame(zasada = c(
  "Jeden wiersz = jedna ankieta. Kolumny są w tej samej kolejności co pytania w kwestionariuszu.",
  "Najpierw wpisz numer ankiety (kolumna nr), potem odpowiedzi strona po stronie.",
  "Nie zostawiaj pustych komórek: brak odpowiedzi to 99, odpowiedź nieważna to 96, „nie dotyczy” to 97.",
  "Wpisuj to, co jest na papierze. Nie poprawiaj odpowiedzi i nie odwracaj pozycji.",
  "Trudne przypadki rozstrzygaj według arkusza Reguly; wątpliwości zapisuj w arkuszu Rejestr_ankiet.",
  "Dwie osoby wpisują te same ankiety do dwóch osobnych kopii tego pliku i nie zaglądają do pliku drugiej osoby.",
  "Po wpisaniu nie sortuj, nie koloruj i nie dopisuj sum. Plik idzie do porównania w R."),
  stringsAsFactors = FALSE)

wb <- createWorkbook(creator = "Metodolog.pl", title = "Szablon wprowadzania ankiet papierowych")
addWorksheet(wb, "Instrukcja"); writeData(wb, "Instrukcja", instrukcja)
addWorksheet(wb, "Dane"); writeData(wb, "Dane", as.data.frame(matrix(nrow = 0, ncol = length(zm), dimnames = list(NULL, zm))))
addWorksheet(wb, "Ksiazka_kodowa"); writeData(wb, "Ksiazka_kodowa", ksiazka)
addWorksheet(wb, "Reguly"); writeData(wb, "Reguly", reguly)
addWorksheet(wb, "Rejestr_ankiet")
writeData(wb, "Rejestr_ankiet", data.frame(nr = 1:220, wrocila = "", data_zwrotu = "", wpisala_A = "",
                                           wpisala_B = "", uwagi = ""))
addWorksheet(wb, "Listy")
listy <- list(kody_2 = c(1, 2, 96, 99), kody_4 = c(1:4, 96, 99), likert = c(1:5, 96, 99), bol = c(0:10, 96, 99))
for (i in seq_along(listy)) writeData(wb, "Listy", data.frame(listy[[i]]), startCol = i, colNames = FALSE)

# Reguły poprawności danych w arkuszu Dane (Dane > Sprawdzanie poprawności danych w Excelu)
lista <- function(nazwa) {                         # zakres z dozwolonymi kodami w arkuszu Listy
  k <- LETTERS[match(nazwa, names(listy))]
  sprintf("'Listy'!$%s$1:$%s$%d", k, k, length(listy[[nazwa]]))
}
kol <- function(v) match(v, zm)
dataValidation(wb, "Dane", cols = kol("nr"), rows = wiersze, type = "whole", operator = "between", value = c(1, 220))
dataValidation(wb, "Dane", cols = kol("wiek"), rows = wiersze, type = "whole", operator = "between", value = c(18, 99))
dataValidation(wb, "Dane", cols = kol("pal_ile"), rows = wiersze, type = "whole", operator = "between", value = c(1, 99))
for (v in c("plec", "praca", "palenie"))
  dataValidation(wb, "Dane", cols = kol(v), rows = wiersze, type = "list", value = lista("kody_2"))
dataValidation(wb, "Dane", cols = kol("wyksz"), rows = wiersze, type = "list", value = lista("kody_4"))
dataValidation(wb, "Dane", cols = kol("bol"), rows = wiersze, type = "list", value = lista("bol"))
for (v in grep("^(sen|zad)_", zm, value = TRUE))
  dataValidation(wb, "Dane", cols = kol(v), rows = wiersze, type = "list", value = lista("likert"))

freezePane(wb, "Dane", firstRow = TRUE, firstCol = TRUE)
addStyle(wb, "Dane", createStyle(textDecoration = "bold", fgFill = "#E8EEF7"), rows = 1, cols = seq_along(zm))
setColWidths(wb, "Instrukcja", 1, 110); setColWidths(wb, "Ksiazka_kodowa", 1:4, c(10, 50, 55, 40))
setColWidths(wb, "Reguly", 1:2, c(55, 60))
saveWorkbook(wb, "szablon-wprowadzania-ankiet-papierowych.xlsx", overwrite = TRUE)

spr <- loadWorkbook("szablon-wprowadzania-ankiet-papierowych.xlsx")
cat("Arkusze:", paste(names(spr), collapse = ", "), "\n")
cat("Kolumny w arkuszu Dane:", length(zm), "| wiersze z regułami:", min(wiersze), "–", max(wiersze), "\n")
print(ksiazka[c(1:8, 9, 17), c("zmienna", "kody_brakow")], row.names = FALSE)
Wynik w R
Arkusze: Instrukcja, Dane, Ksiazka_kodowa, Reguly, Rejestr_ankiet, Listy
Kolumny w arkuszu Dane: 21 | wiersze z regułami: 2 – 301
 zmienna                                   kody_brakow
      nr                                             –
    plec 96 = odpowiedź nieważna, 99 = brak odpowiedzi
    wiek 96 = odpowiedź nieważna, 99 = brak odpowiedzi
   wyksz 96 = odpowiedź nieważna, 99 = brak odpowiedzi
   praca 96 = odpowiedź nieważna, 99 = brak odpowiedzi
 palenie 96 = odpowiedź nieważna, 99 = brak odpowiedzi
 pal_ile             97 = nie dotyczy (P5 = 2), 96, 99
     bol                                        96, 99
  sen_01                                        96, 99
  zad_01                                        96, 99
2. Porównanie dwóch wprowadzeń i rozstrzygnięcie niezgodności
R
# B444, przepis 2: porównanie dwóch niezależnych wprowadzeń tych samych ankiet papierowych
A <- read.csv("ankiety-papierowe-wprowadzenie-A.csv")
B <- read.csv("ankiety-papierowe-wprowadzenie-B.csv")
ory <- read.csv("ankiety-papierowe-oryginaly.csv")   # w ćwiczeniu zastępuje stos papierowych ankiet
zm <- names(A)[-1]
stopifnot(identical(names(A), names(B)))
cat(sprintf("Rozdano 220 ponumerowanych ankiet, wróciło %d (%.1f%%)\n", nrow(ory), 100 * nrow(ory) / 220))

# 1. Numery ankiet: duplikaty i numery obecne tylko w jednym pliku
for (p in list(list("A", A), list("B", B))) {
  d <- p[[2]]$nr[duplicated(p[[2]]$nr)]
  cat(sprintf("Plik %s: %d wierszy, powtórzone numery: %s\n", p[[1]], nrow(p[[2]]),
              if (length(d)) paste(d, collapse = ", ") else "brak"))
}
lub_brak <- function(x) if (length(x)) paste(x, collapse = ", ") else "brak"
cat("Numery tylko w A:", lub_brak(setdiff(A$nr, B$nr)), "| tylko w B:", lub_brak(setdiff(B$nr, A$nr)), "\n")

# Który z dwóch wierszy B o numerze 201 to naprawdę ankieta 102? Porównaj z wpisami A
podw <- which(B$nr == 201)
zgodne <- sapply(c(102, 201), function(k) rowSums(B[podw, zm] == A[A$nr == k, zm][rep(1, length(podw)), ], na.rm = TRUE))
dimnames(zgodne) <- list(paste("wiersz B", podw), c("zgodnych pól z A 102", "zgodnych pól z A 201"))
print(zgodne)
B$nr[podw[which.max(zgodne[, 1])]] <- 102          # poprawka po sprawdzeniu numeru na papierze
stopifnot(!anyDuplicated(B$nr), setequal(A$nr, B$nr))

# 2. Porównanie komórka po komórce (puste komórki też są wartością do porównania)
A <- A[order(A$nr), ]; B <- B[order(B$nr), ]; ory <- ory[order(ory$nr), ]
tekst <- function(d) { m <- as.matrix(d[zm]); m[] <- ifelse(is.na(m), "(puste)", trimws(as.character(m))); m }
mA <- tekst(A); mB <- tekst(B); mO <- tekst(ory)
ind <- which(mA != mB, arr.ind = TRUE)
niezg <- data.frame(nr = A$nr[ind[, 1]], zmienna = zm[ind[, 2]], A = mA[ind], B = mB[ind])
niezg <- niezg[order(niezg$nr, match(niezg$zmienna, zm)), ]
pola <- length(mA)
cat(sprintf("\nPorównano %d pól (%d ankiet x %d zmiennych). Niezgodnych: %d (%.2f%%)\n",
            pola, nrow(mA), length(zm), nrow(niezg), 100 * nrow(niezg) / pola))
na_ankiete <- table(niezg$nr)
cat(sprintf("Ankiety z co najmniej jedną niezgodnością: %d z %d; najwięcej w jednej ankiecie: %d (nr %s)\n",
            length(na_ankiete), nrow(mA), max(na_ankiete), names(which.max(na_ankiete))))
cat("\nPierwsze wiersze listy niezgodności:\n"); print(head(niezg, 8), row.names = FALSE)
write.csv(cbind(niezg, oryginal = "", decyzja = ""), "lista-niezgodnosci-do-rozstrzygniecia.csv", row.names = FALSE)

# 3. Rozstrzygnięcie z oryginałem: kto się pomylił?
niezg$oryginal <- mO[cbind(match(niezg$nr, A$nr), match(niezg$zmienna, zm))]
niezg$kto <- ifelse(niezg$A == niezg$oryginal, "B", ifelse(niezg$B == niezg$oryginal, "A", "A i B"))
cat("\nKto wpisał źle (wśród niezgodności):\n"); print(table(niezg$kto))
bladA <- sum(mA != mO); bladB <- sum(mB != mO); wspolne <- sum(mA == mB & mA != mO)
for (p in list(c("A", bladA), c("B", bladB))) {
  k <- as.numeric(p[2]); ci <- binom.test(k, pola)$conf.int
  cat(sprintf("Osoba %s: %d błędnych pól z %d = %.2f%%, 95%% CI [%.2f%%, %.2f%%]\n",
              p[1], k, pola, 100 * k / pola, 100 * ci[1], 100 * ci[2]))
}
cat(sprintf("Ten sam błąd u obu osób (niewykrywalny przez porównanie): %d\n", wspolne))
bez_przes <- sum(mA[A$nr != 112, ] != mO[ory$nr != 112, ])
cat(sprintf("Błędy A bez przesuniętej ankiety nr 112: %d (%.2f%% z %d pól)\n",
            bez_przes, 100 * bez_przes / (pola - length(zm)), pola - length(zm)))

# 4. Czy wystarczyłaby sama kontrola zakresów i logiki pliku A?
dozw <- list(plec = c(1, 2, 96, 99), wyksz = c(1:4, 96, 99), praca = c(1, 2, 96, 99), palenie = c(1, 2, 96, 99),
             bol = c(0:10, 96, 99), wiek = 18:80, pal_ile = c(1:40, 97))
for (v in grep("^(sen|zad)_", zm, value = TRUE)) dozw[[v]] <- c(1:5, 96, 99)
flaga <- sapply(zm, function(v) is.na(A[[v]]) | !(A[[v]] %in% dozw[[v]]))
flaga[, "pal_ile"] <- flaga[, "pal_ile"] | (A$palenie %in% 2 & !(A$pal_ile %in% 97)) |
  (A$palenie %in% 1 & A$pal_ile %in% 97)                 # filtr: P6 tylko dla palących
bA <- mA != mO
cat(sprintf("\nKontrola zakresów i logiki w pliku A: oznaczone pola %d, w tym błędnych %d z %d błędów A (%.0f%%)\n",
            sum(flaga), sum(flaga & bA), sum(bA), 100 * sum(flaga & bA) / sum(bA)))
cat(sprintf("Niewykryte błędy A: %d – wartości dozwolone, ale inne niż na papierze\n", sum(!flaga & bA)))

# 5. Plik końcowy: wartości A z poprawkami z rozstrzygnięcia
kon <- A
for (i in seq_len(nrow(niezg))) {
  w <- niezg$oryginal[i]
  kon[kon$nr == niezg$nr[i], niezg$zmienna[i]] <- if (w == "(puste)") NA else as.numeric(w)
}
cat(sprintf("Plik końcowy: pola różne od oryginałów: %d\n", sum(tekst(kon) != mO)))
write.csv(kon, "ankiety-papierowe-baza-koncowa.csv", row.names = FALSE, na = "")
Wynik w R
Rozdano 220 ponumerowanych ankiet, wróciło 200 (90.9%)
Plik A: 200 wierszy, powtórzone numery: brak
Plik B: 200 wierszy, powtórzone numery: 201
Numery tylko w A: 102 | tylko w B: brak
             zgodnych pól z A 102 zgodnych pól z A 201
wiersz B 80                     5                   20
wiersz B 121                   20                    5

Porównano 4000 pól (200 ankiet x 20 zmiennych). Niezgodnych: 67 (1.68%)
Ankiety z co najmniej jedną niezgodnością: 54 z 200; najwięcej w jednej ankiecie: 5 (nr 112)

Pierwsze wiersze listy niezgodności:
 nr zmienna       A       B
  4 pal_ile      97       9
  4  zad_04       5       4
  6  zad_05       5       4
  7    plec      11       1
 14  zad_01       3       2
 16  zad_01 (puste)       4
 21  zad_03       4      44
 22 pal_ile      97 (puste)

Kto wpisał źle (wśród niezgodności):

 A  B
47 20
Osoba A: 47 błędnych pól z 4000 = 1.18%, 95% CI [0.86%, 1.56%]
Osoba B: 20 błędnych pól z 4000 = 0.50%, 95% CI [0.31%, 0.77%]
Ten sam błąd u obu osób (niewykrywalny przez porównanie): 0
Błędy A bez przesuniętej ankiety nr 112: 42 (1.06% z 3980 pól)

Kontrola zakresów i logiki w pliku A: oznaczone pola 20, w tym błędnych 19 z 47 błędów A (40%)
Niewykryte błędy A: 28 – wartości dozwolone, ale inne niż na papierze
Plik końcowy: pola różne od oryginałów: 0
3. Weryfikacja losowej próbki ankiet
R
# B444, przepis 3: gdy drugie wprowadzenie jest niemożliwe – weryfikacja losowej próbki ankiet
A <- read.csv("ankiety-papierowe-wprowadzenie-A.csv")
ory <- read.csv("ankiety-papierowe-oryginaly.csv")   # tu: ankiety wyjęte ze stosu i porównane z ekranem
zm <- names(A)[-1]
tekst <- function(d) { m <- as.matrix(d[zm]); m[] <- ifelse(is.na(m), "(puste)", as.character(m)); m }

# Reguła ustalona przed losowaniem: 20 ankiet (10%); jeśli górna granica 95% CI
# odsetka błędnych pól przekroczy 1%, wszystkie ankiety wpisuje się drugi raz
set.seed(4442)
los <- sort(sample(A$nr, 20))
cat("Wylosowane numery ankiet:", los, "\n")
bl <- tekst(A[match(los, A$nr), ]) != tekst(ory[match(los, ory$nr), ])
k <- sum(bl); m <- length(bl)
ci <- binom.test(k, m)$conf.int
cat(sprintf("Błędne pola: %d z %d = %.2f%%, 95%% CI [%.2f%%, %.2f%%] (Clopper–Pearson)\n",
            k, m, 100 * k / m, 100 * ci[1], 100 * ci[2]))
z_bledem <- sum(rowSums(bl) > 0); ci2 <- binom.test(z_bledem, length(los))$conf.int
cat(sprintf("Ankiety z co najmniej jednym błędem: %d z %d, 95%% CI [%.1f%%, %.1f%%]\n",
            z_bledem, length(los), 100 * ci2[1], 100 * ci2[2]))
cat("Decyzja:", if (ci[2] > .01) "górna granica > 1% – wpisz wszystkie ankiety drugi raz" else
  "górna granica <= 1% – opisz wynik weryfikacji w metodzie", "\n")
cat(sprintf("Dla porównania (znane tylko w symulacji): błędne pola w całym pliku A %.2f%%\n",
            100 * mean(tekst(A[order(A$nr), ]) != tekst(ory[order(ory$nr), ]))))

# Ile ankiet sprawdzić? Górna granica 95% CI przy 0, 1 lub 2 znalezionych błędach (20 pól na ankietę)
plan <- expand.grid(ankiet = c(10, 20, 30, 50, 100), bledow = 0:2)
plan$gorna_proc <- round(100 * mapply(function(a, b) binom.test(b, 20 * a)$conf.int[2], plan$ankiet, plan$bledow), 2)
print(reshape(plan, idvar = "ankiet", timevar = "bledow", direction = "wide"), row.names = FALSE)
Wynik w R
Wylosowane numery ankiet: 1 17 20 22 23 29 33 38 61 89 113 119 124 130 169 193 198 205 208 210
Błędne pola: 2 z 400 = 0.50%, 95% CI [0.06%, 1.79%] (Clopper–Pearson)
Ankiety z co najmniej jednym błędem: 2 z 20, 95% CI [1.2%, 31.7%]
Decyzja: górna granica > 1% – wpisz wszystkie ankiety drugi raz
Dla porównania (znane tylko w symulacji): błędne pola w całym pliku A 1.18%
 ankiet gorna_proc.0 gorna_proc.1 gorna_proc.2
     10         1.83         2.75         3.57
     20         0.92         1.38         1.79
     30         0.61         0.93         1.20
     50         0.37         0.56         0.72
    100         0.18         0.28         0.36
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; szablon XLSX zapisano pakietem openxlsx, a rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [R package]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed wpisaniem pierwszej ankiety sprawdź…
- Czy każda ankieta (i każda jej strona) ma numer, a rejestr ankiet jest gotowy?
- Czy kolumny arkusza idą w kolejności pytań na kartce, a nazwy zgadzają się z książką kodową?
- Czy kody 96, 97 i 99 są niemożliwe jako prawdziwe odpowiedzi w każdej kolumnie?
- Czy reguły dla trudnych odpowiedzi są spisane i obie osoby je znają?
- Czy w arkuszu działają listy rozwijane i zakresy (sprawdź, wpisując celowo złą wartość)?
- Czy druga osoba wpisuje do osobnego pliku i nie widzi pierwszego?
- Czy wiadomo, kto rozstrzyga niezgodności i na jakiej podstawie?
- Jeśli podwójne wprowadzanie jest niemożliwe: czy liczba ankiet do weryfikacji i próg decyzji są zapisane przed losowaniem?
- Gdzie będą przechowywane oryginały i surowe pliki A, B oraz plik końcowy?
Najczęstsze pytania
Czy podwójne wprowadzanie danych może zrobić ta sama osoba?
Może, ale wykrywa wtedy mniej błędów. W badaniu Kawado i in. (2003) podwójne wprowadzanie przez inną osobę wykryło 88.3% błędów pierwszego wpisania, a przez tę samą – 69.0%. Jeśli nie masz drugiej osoby, zrób przerwę między wprowadzeniami, wpisuj ankiety w innej kolejności i nie zaglądaj do pierwszego pliku.
Co wpisać do bazy, gdy respondent zaznaczył dwie odpowiedzi w pytaniu jednokrotnego wyboru?
Wpisz osobny kod odpowiedzi nieważnej (np. 96), a nie jedną z dwóch zaznaczonych odpowiedzi. Taką regułę ustal przed wpisywaniem i przekaż wszystkim osobom wprowadzającym. Przed analizą kod zamieniasz na brak danych, a w pracy podajesz, ile było takich odpowiedzi.
Ile ankiet sprawdzić, jeśli nie mogę wpisać wszystkich dwa razy?
Zależy od progu błędu, który chcesz wykazać. Przy 20 polach na ankietę i progu 1% wystarczy około 20 losowo wybranych ankiet, jeśli nie znajdziesz żadnego błędu, i około 30 przy jednym błędzie (górna granica 95% przedziału Cloppera–Pearsona). Liczbę ankiet i regułę decyzji zapisz przed losowaniem.
Jak rozstrzygać niezgodności między dwoma wprowadzeniami danych?
Zawsze na podstawie oryginalnej ankiety, a nie przez wybór „bardziej prawdopodobnej” z dwóch wartości w arkuszu. Barchard i in. (2020) zauważyli, że osoby poprawiające niezgodności czasem uzgadniały oba wpisy między sobą i wprowadzały nowe błędy. Najlepiej, żeby listę niezgodności rozstrzygała trzecia osoba z kartkami w ręku.
Czy listy rozwijane w Excelu wystarczą zamiast podwójnego wprowadzania?
Nie. Reguły sprawdzania poprawności zatrzymują wartości niemożliwe, np. 55 na skali 1–5, ale przepuszczają pomyłki w zakresie, np. 4 zamiast 5. W przykładzie kontrola zakresów i logiki wykryła 19 z 47 błędów pierwszej osoby. Traktuj je jako pierwsze sito, a nie kontrolę końcową.
Powiązane hasła
Przeczytaj też
Porządek w plikach pracy
Pięć folderów, surowe dane tylko do odczytu, nazwy bez „final2”, kopie 3-2-1, osobny klucz ID i co robić, gdy plik zniknie.
Czytaj →PoradnikJak przygotować bazę danych do analizy
Układ bazy, nazwy zmiennych, kodowanie ankiety, braki, pułapki Excela, widok zmiennych w SPSS i kontrola jakości – z szablonem .xlsx, .sav i .csv do pobrania.
Czytaj →PoradnikImport z Excela do SPSS i R – pułapki
Nagłówki w dwóch wierszach, „brak” w komórkach, przecinek dziesiętny i daty jako liczby: jak je wykryć i naprawić w R i SPSS.
Czytaj →PoradnikReguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →PoradnikŁączenie danych z kilku plików ankiety
Arkusze od oddziałów, pomiar przed i po, dokumentacja: ujednolicenie kodów, krotność złączeń i kontrola liczby wierszy w R i SPSS.
Czytaj →Masz stos papierowych ankiet i nie wiesz, jak bezpiecznie przenieść je do bazy?
Przygotujemy z Tobą szablon i reguły kodowania, porównamy dwa wprowadzenia w R, a potem policzymy analizy i wyjaśnimy wyniki tak, żebyś umiał(a) je samodzielnie opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Atkinson, I. (2012). Accuracy of data transfer: Double data entry and estimating levels of error. Journal of Clinical Nursing, 21(19–20), 2730–2735. https://doi.org/10.1111/j.1365-2702.2012.04353.x
- Barchard, K. A., & Pace, L. A. (2011). Preventing human error: The impact of data entry methods on data accuracy and statistical results. Computers in Human Behavior, 27(5), 1834–1839. https://doi.org/10.1016/j.chb.2011.04.004
- Barchard, K. A., Freeman, A. J., Ochoa, E., & Stephens, A. K. (2020). Comparing the accuracy and speed of four data-checking methods. Behavior Research Methods, 52(1), 97–115. https://doi.org/10.3758/s13428-019-01207-3 ● Otwarty dostęp
- Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989 ● Otwarty dostęp: pełny tekst
- Day, S., Fayers, P., & Harvey, D. (1998). Double data entry: What value, what price? Controlled Clinical Trials, 19(1), 15–24. https://doi.org/10.1016/s0197-2456(97)00096-2
- Kawado, M., Hinotsu, S., Matsuyama, Y., Yamaguchi, T., Hashimoto, S., & Ohashi, Y. (2003). A comparison of error detection rates between the reading aloud method and the double data entry method. Controlled Clinical Trials, 24(5), 560–569. https://doi.org/10.1016/s0197-2456(03)00089-8
- Microsoft. (b.d.-b). Stosowanie sprawdzania poprawności danych do komórek. Microsoft Support. https://support.microsoft.com/pl-pl/excel/get-started/apply-data-validation-to-cells ● Otwarty dostęp
- Paulsen, A., Overgaard, S., & Lauritsen, J. M. (2012). Quality of data entry using single entry, double entry and automated forms processing – An example based on a study of patient-reported outcomes. PLoS ONE, 7(4), Article e35087. https://doi.org/10.1371/journal.pone.0035087 ● Otwarty dostęp
Cytowania BibTeX
@article{atkinson2012accuracy, author={Atkinson, Ian}, title={{Accuracy of data transfer: Double data entry and estimating levels of error}}, journal={Journal of Clinical Nursing}, year={2012}, volume={21}, number={19–20}, pages={2730--2735}, doi={10.1111/j.1365-2702.2012.04353.x}}@article{barchard2011preventing, author={Barchard, Kimberly A. and Pace, Larry A.}, title={{Preventing human error: The impact of data entry methods on data accuracy and statistical results}}, journal={Computers in Human Behavior}, year={2011}, volume={27}, number={5}, pages={1834--1839}, doi={10.1016/j.chb.2011.04.004}}@article{barchard2020comparing, author={Barchard, Kimberly A. and Freeman, Andrew J. and Ochoa, Elizabeth and Stephens, Amber K.}, title={{Comparing the accuracy and speed of four data-checking methods}}, journal={Behavior Research Methods}, year={2020}, volume={52}, number={1}, pages={97--115}, doi={10.3758/s13428-019-01207-3}}@article{broman2018data, author={Broman, Karl W. and Woo, Kara H.}, title={{Data organization in spreadsheets}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={2--10}, doi={10.1080/00031305.2017.1375989}}@article{day1998double, author={Day, Simon and Fayers, Peter and Harvey, Derek}, title={{Double data entry: What value, what price?}}, journal={Controlled Clinical Trials}, year={1998}, volume={19}, number={1}, pages={15--24}, doi={10.1016/s0197-2456(97)00096-2}}@article{kawado2003comparison, author={Kawado, Miyuki and Hinotsu, Shiro and Matsuyama, Yutaka and Yamaguchi, Takuhiro and Hashimoto, Shuji and Ohashi, Yasuo}, title={{A comparison of error detection rates between the reading aloud method and the double data entry method}}, journal={Controlled Clinical Trials}, year={2003}, volume={24}, number={5}, pages={560--569}, doi={10.1016/s0197-2456(03)00089-8}}@misc{microsoftndwalidacja, author={{Microsoft}}, title={{Stosowanie sprawdzania poprawności danych do komórek}}, howpublished={Microsoft Support}, year={b.d.-b}, publisher={Microsoft}, url={https://support.microsoft.com/pl-pl/excel/get-started/apply-data-validation-to-cells}}@article{paulsen2012quality, author={Paulsen, Aksel and Overgaard, Søren and Lauritsen, Jens Martin}, title={{Quality of data entry using single entry, double entry and automated forms processing – An example based on a study of patient-reported outcomes}}, journal={PLoS ONE}, year={2012}, volume={7}, number={4}, eid={e35087}, doi={10.1371/journal.pone.0035087}}