Po co kod w ankiecie, która ma być anonimowa
Badania o paleniu, alkoholu, przemocy rówieśniczej czy samookaleczeniach prowadzi się zwykle anonimowo, bo bez nazwiska na kartce odpowiedzi są szczersze (zob. aprobata społeczna). Kłopot zaczyna się wtedy, gdy ten sam uczeń ma wypełnić ankietę drugi raz: po programie profilaktycznym (schemat pretest–posttest), w kolejnej fali badania podłużnego albo równolegle z rodzicem lub wychowawcą. Bez łącznika nie da się policzyć zmiany u tej samej osoby ani zbudować pary dziecko–rodzic.
Najczęstsze rozwiązanie to kod tworzony przez respondenta (ang. self-generated identification code, SGIC). Uczestnik składa go z odpowiedzi na kilka pytań o stałe fakty, np. „dwie pierwsze litery imienia matki” i „dzień urodzenia”. Badacz nie prowadzi listy nazwisk, a w kolejnym pomiarze respondent odtwarza ten sam kod z tych samych pytań. Metoda ma ponad 40 lat: Kearney i in. (1984) połączyli tak 92% kwestionariuszy uczniów po miesiącu i 78% po roku, przy bardzo małej liczbie błędnych połączeń.
Techniczną stronę łączenia plików – merge(), ujednolicanie zapisu, duplikaty i ręczne sprawdzanie kodów różniących się jednym znakiem – opisuje wpis jak połączyć dwie bazy z ankiet. Tu zajmiemy się tym, z czego zbudować kod, jaką regułę dopasowania przyjąć i jak oba wybory zależą od liczebności próby.
Z czego zbudować kod
Dobry element kodu spełnia cztery warunki. Po pierwsze, jest stały: odpowiedź za rok będzie taka sama. Po drugie, jest znany każdemu respondentowi bez zastanawiania się. Po trzecie, jest zróżnicowany, czyli dzieli próbę na wiele grup podobnej wielkości. Po czwarte, sam w sobie nie identyfikuje osoby. Warunki te bywają sprzeczne: pełna data urodzenia jest stała i zróżnicowana, ale razem z płcią i klasą wskazuje konkretnego ucznia.
| Element | Stałość i znajomość | Zróżnicowanie | Uwagi |
|---|---|---|---|
| Dwie pierwsze litery imienia matki | wysoka | niskie – kilka imion dominuje | Zdrobnienia („GO” zamiast „MA” dla Małgorzaty) i polskie znaki – podaj instrukcję |
| Dwie pierwsze litery imienia ojca | niższa – nie każdy zna albo chce podać | niskie | Dodaj opcję „nie wiem / nie chcę podać – wpisz XX” |
| Dzień urodzenia (01–31) | wysoka | średnie | Błędy: pominięte zero, przestawione cyfry |
| Miesiąc urodzenia (01–12) | wysoka | niskie | Razem z dniem i rokiem tworzy pełną datę – rozważ, czy to nie za dużo |
| Litery imion dziadków, kolor oczu | niższa | średnie | Vacek i in. (2017) wskazali imię babci ze strony ojca i kolor oczu jako elementy zmieniane najczęściej |
| Numer telefonu, klasa, ulubiony przedmiot | niska | różne | Nie używaj – zmieniają się między pomiarami |
Więcej elementów to mniej przypadkowych zbieżności, ale więcej okazji do pomyłki. McKibben i in. (2026) poprosili 135 osób o utworzenie 12-elementowego kodu dwa razy w odstępie 8 tygodni. Ponad 91.9% zgodziło się w co najmniej 10 elementach, ale tylko 40.0% we wszystkich 12. Zgodność wszystkich elementów wiązała się przy tym z tym, czy uczestnicy uważali badanie za godne zaufania. Długi kod opłaca się więc tylko wtedy, gdy łączysz go regułą tolerującą błędy. Przegląd metod budowy takich kodów i zalecenia dla badaczy podają Audette i in. (2020), a Yurek i in. (2008) opisują techniki podnoszenia odsetka dopasowań.
W kwestionariuszu podaj przykład wypełnienia, wymagaj wielkich liter bez polskich znaków i dwóch cyfr z zerem na początku („05”). Każdy element zbieraj w osobnym polu, a nie jako jeden ciąg wpisywany z pamięci. Pola sprawdź w teście ankiety (zob. test techniczny ankiety online), a ich budowę zapisz w książce kodowej. Płeć i rok urodzenia zbierz jako zwykłe pytania metryczki. Przydadzą się przy dopasowaniu jako zmienne pomocnicze.
Ile osób ma taki sam kod
Kod łączy pomiary tylko wtedy, gdy w próbie jest unikatowy. Tymczasem litery imion są bardzo nierówno rozłożone, a przy setkach osób zaczyna działać „paradoks urodzin”: wspólny dzień urodzenia jest u kogoś prawie pewny. W symulacji imiona matek i ojców losujemy z 40 i 30 popularnych imion o nierównych częstościach, a daty urodzenia z trzech roczników (Rysunek 1).
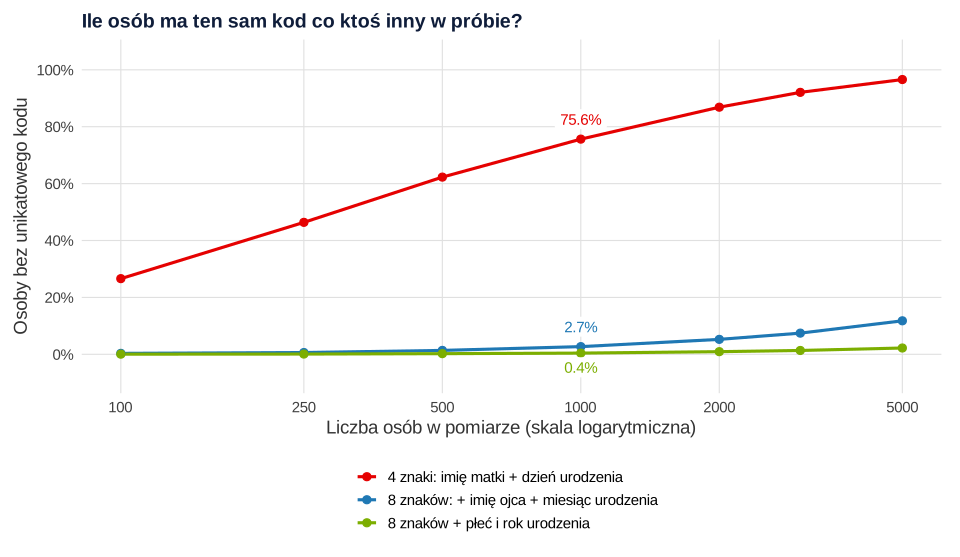
Popularny kod czteroznakowy „dwie litery imienia matki + dzień urodzenia” zawodzi już przy małych próbach. Przy 100 osobach nie jest unikatowy dla 26.6% z nich, przy 1000 – dla 75.6%. Kod ośmioznakowy (dodatkowo imię ojca i miesiąc urodzenia) daje odpowiednio 0.3% i 2.7%, a przy 5000 osób – 11.8%. Dopiero razem z płcią i rokiem urodzenia odsetek spada przy 5000 osobach do 2.2%. Wniosek praktyczny: liczbę elementów kodu dobieraj do planowanej liczebności, a nie z przyzwyczajenia. W badaniu jednej klasy wystarczy krótki kod, w badaniu całego powiatu – nie.
Dopasowanie dokładne i rozmyte
Drugi problem to błędy przy ponownym wpisywaniu. W symulowanym badaniu 1000 uczniów wypełnia ankietę przed programem profilaktycznym. W drugim pomiarze wraca 872 z nich, a dochodzi 100 nowych, nieobecnych za pierwszym razem. Każdy element kodu może zostać wpisany błędnie (od 2% dla imienia matki do 5% dla imienia ojca), a osoby mniej zaangażowane mylą się częściej. Tylko 680 z 872 osób (78.0%) wpisało za drugim razem dokładnie ten sam kod ośmioznakowy. To wynik zbliżony do badań terenowych. Grube i in. (1989) połączyli dokładnie 71% kwestionariuszy po miesiącu.
Dopasowanie rozmyte dopuszcza różnicę. Miarą różnicy jest zwykle odległość Levenshteina, czyli najmniejsza liczba wstawień, usunięć i zamian pojedynczych znaków, która zamienia jeden kod w drugi. „AN05” i „AN5” dzieli odległość 1, a „AN05” i „AN50” – odległość 2. Schnell i in. (2010) pokazali, że kody z większą liczbą elementów łączone tą miarą tracą mniej przypadków niż wcześniejsze metody. W R liczy ją bazowa funkcja adist(). Nasza reguła: kod z pomiaru 2 łączymy z najbliższym kodem z pomiaru 1, jeśli odległość nie przekracza progu, najbliższy kandydat jest jeden i nikt inny nie wskazuje go równie blisko. Remisy zostają bez pary.
| Reguła (kod 8-znakowy, 872 możliwe pary) | Połączono | Fałszywie | Czułość |
|---|---|---|---|
| Dokładna zgodność | 664 | 1 | 76.0% |
| Odległość ≤ 1 | 716 | 4 | 81.7% |
| Odległość ≤ 2 | 726 | 6 | 82.6% |
| Odległość ≤ 1 + zgodna płeć i rok urodzenia | 740 | 2 | 84.6% |
| Odległość ≤ 2 + zgodna płeć i rok urodzenia | 785 | 6 | 89.3% |
Tolerancja dwóch znaków podniosła czułość z 76.0% do 82.6%, a zmienne pomocnicze – do 89.3%. Płeć i rok odsiewają kandydatów z innej grupy i rozstrzygają remisy, które wcześniej zostawały bez pary. Podobny zysk opisują badania terenowe: u Grubego i in. (1989) dopuszczenie różnicy w jednym elemencie podniosło odsetek dopasowań z 71% do 88%. Ripper i in. (2017) przy ośmioelementowym kodzie połączyli 95.7% ankiet, dopuszczając zmiany w najwyżej dwóch elementach. Vacek i in. (2017) połączyli ankiety 2571 dzieci i 1931 rodziców kodem dziewięcioznakowym i jego „lustrzaną” wersją dla rodzica. Sam kod dał precyzję 97.9% i czułość 93.4%, a ze zmienną „szkoła” jednoznacznie połączono 94.9% możliwych par.
Dlaczego tolerancja działa dla kodu ośmioznakowego, a nie dla czteroznakowego, pokazuje Rysunek 2. Porównuje on odległość od własnego kodu z pomiaru 1 z odległością od najbliższego kodu innej osoby.
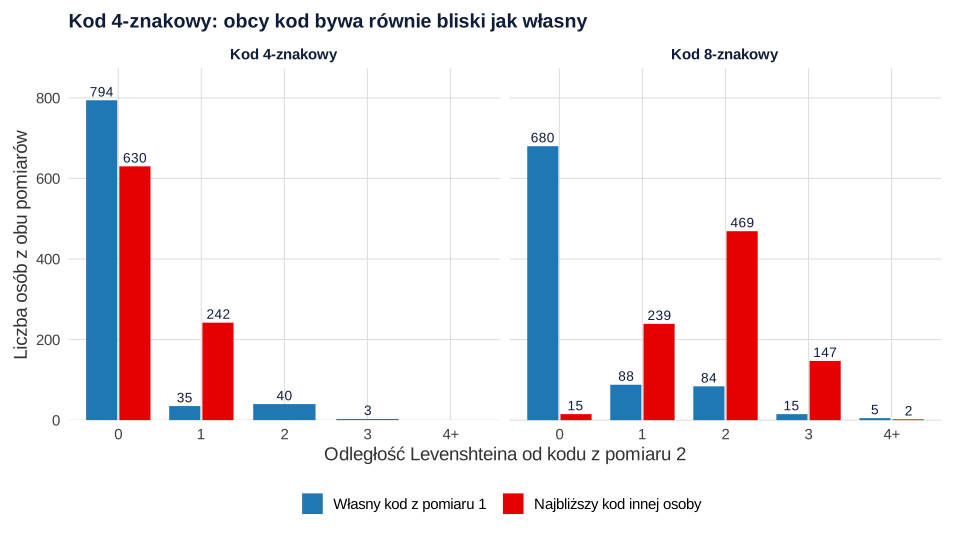
W kodzie czteroznakowym 794 z 872 osób wpisały ten sam kod co w pomiarze 1. Jednocześnie u 630 osób taki sam kod miał ktoś inny, a u pozostałych 242 obcy kod różnił się jednym znakiem. U 77.4% osób obcy kod był co najmniej tak blisko jak własny, więc żadna tolerancja nie pomoże – potrzebne są dodatkowe informacje. W kodzie ośmioznakowym tylko 15 osób miało identyczny kod obcej osoby, a najbliższy obcy kod różnił się najczęściej dwoma (469 osób) albo trzema znakami (147). Własny kod był bliżej niż jakikolwiek obcy u 87.5% osób. Tu tolerancja 1–2 znaków odzyskuje większość pomyłek i rzadko łączy obce osoby.
Fałszywe dopasowania rosną z liczebnością
Jedna próba to za mało, żeby wybrać regułę. Rysunek 3 pokazuje średnie z 40 powtórzeń całego badania dla 250, 1000 i 3000 uczniów. Czułość to odsetek osób z obu pomiarów połączonych poprawnie (zob. czułość i swoistość). Odsetek fałszywych wśród połączeń to dopełnienie precyzji, czyli wartości predykcyjnej dodatniej.
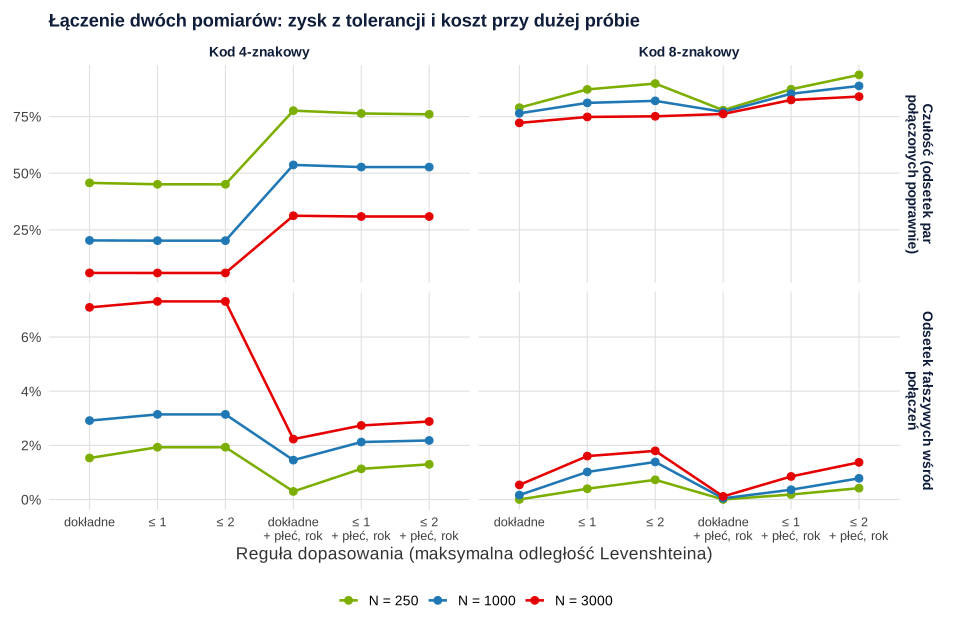
Z rysunku wynikają trzy rzeczy.
- Krótki kod wymaga zmiennych pomocniczych. Bez płci i roku kod czteroznakowy połączył poprawnie 45.7% par przy 250 osobach, 20.3% przy 1000 i 5.9% przy 3000. Większość kodów miała bliźniaka, więc zostawała bez pary. Z płcią i rokiem czułość wynosiła 77.6%, 53.7% i 31.2%.
- Tolerancja kosztuje więcej w dużej próbie. Dla kodu ośmioznakowego reguła „≤ 2” podniosła odsetek fałszywych połączeń z 0.0% do 0.7% przy 250 osobach i z 0.5% do 1.8% przy 3000 osobach. W dużej próbie łatwiej o obcy kod różniący się dwoma znakami, zwłaszcza dla osób nowych w pomiarze 2.
- Najlepszy kompromis to tolerancja plus zmienne pomocnicze. Reguła „≤ 2 + płeć i rok” miała najwyższą czułość we wszystkich liczebnościach (93.4%, 88.6% i 83.9%) przy 0.4%, 0.8% i 1.4% fałszywych połączeń. SD czułości między powtórzeniami: 0.008–0.018.
Liczby zależą od założeń symulacji, więc w swoim badaniu zrób małą walidację. McGloin i in. (1996) sprawdzili kod niezależnym, anonimowym systemem naklejek: 75.2% par połączono poprawnie, 22.1% zostało bez pary, a 2.7% połączono błędnie. Albo przejrzyj ręcznie pary z odległością 1–2 i porównaj ich metryczkę.
Kto ginie przy łączeniu
Osoby, których nie udało się połączyć, nie są losową częścią próby. U Grubego i in. (1989) częściej byli to chłopcy, osoby z rodzin o niższym statusie, słabiej związane ze szkołą i częściej używające substancji. Różnice były jednak małe, a współczynniki regresji w grupach podobne. W naszej symulacji palenie deklarowało 22.9% uczniów w pomiarze 1 i 21.9% uczniów obecnych w obu pomiarach. Wśród par połączonych dokładnie odsetek wyniósł 19.7%, a wśród par z reguły „≤ 2 + płeć i rok” – 21.0%. Błędy w kodzie działają więc jak dodatkowa utrata uczestników, i to zwykle zależna od badanej cechy (zob. mechanizmy braków danych). Łagodniejsza reguła zmniejsza to obciążenie, bo „ratuje” właśnie osoby mniej staranne.
W praktyce zostaw w bazie wszystkich respondentów z obu pomiarów, także niepołączonych, i oznacz ich zmienną. Wtedy możesz porównać połączonych z niepołączonymi w pomiarze 1. Do analizy zmiany wybierz model, który wykorzystuje także osoby z jednym pomiarem, np. model mieszany w formacie długim albo imputację wielokrotną. Szerszy plan analizy ubytku w kilku falach opisuje wpis ankieta w kilku falach.
Kod a RODO: pseudonimizacja, nie anonimizacja
RODO definiuje pseudonimizację jako przetworzenie danych tak, by nie dało się ich przypisać osobie bez dodatkowych informacji (art. 4 pkt 5). Motyw 26 każe oceniać możliwość identyfikacji z uwzględnieniem środków, które ktoś rozsądnie mógłby wykorzystać (Parlament Europejski i Rada Unii Europejskiej, 2016). Kod z liter imienia matki i daty urodzenia nie wymaga listy nazwisk, ale nauczyciel, rodzic albo kolega z klasy może go odtworzyć. W małej grupie z metryczką (płeć, rok, klasa) wskazuje konkretną osobę. Dlatego bezpieczniej traktować takie dane jako spseudonimizowane, a nie anonimowe, i uzgodnić to z inspektorem ochrony danych lub komisją etyczną. Ten wpis nie jest poradą prawną.
Trzy zasady ograniczają ryzyko. Po pierwsze, nie pisz w informacji dla uczestnika „ankieta jest całkowicie anonimowa”, jeśli łączysz pomiary – wyjaśnij, po co jest kod (zob. świadoma zgoda i RODO). Po drugie, po połączeniu zastąp kod losowym numerem i usuń kolumny z elementami kodu. Po trzecie, nigdy nie umieszczaj kodów w danych udostępnianych w pakiecie replikacyjnym.
Jak opisać łączenie w artykule
Podaj elementy kodu, regułę dopasowania z progiem i zmiennymi pomocniczymi, sposób rozstrzygania remisów, liczbę połączonych par i niepołączonych osób w każdym pomiarze oraz porównanie połączonych z niepołączonymi. Jeśli robiłeś(-aś) walidację albo ręczny przegląd, podaj jego wynik.
Jeśli planujesz badanie z kilkoma pomiarami albo masz już dane z kodami, które nie chcą się połączyć, możemy wspólnie dobrać kod i regułę oraz sprawdzić skutki ubytku w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi korzysta z funkcji z pierwszego). Wystarczy podstawowa instalacja R: odległość Levenshteina liczy bazowa funkcja adist(). Pierwszy przepis liczy się kilka sekund, drugi (240 symulowanych badań) – kilka minut. Przy własnych danych zamiast funkcji wpisz() wczytaj kody z obu pomiarów, policz macierz adist(kody2, kody1), wpisz dużą wartość tam, gdzie płeć lub rok się nie zgadzają, i wywołaj polacz().
1. Kody, błędy przy wpisywaniu i łączenie dwóch pomiarów
R
# Krok 1. Kod tworzony przez respondenta: populacja, błędy przy wpisywaniu i łączenie dwóch pomiarów
options(width = 110)
# Scenariusz: anonimowa ankieta o używkach w szkołach średnich, pomiar przed programem profilaktycznym i po nim.
imiona_k <- c("ANNA", "MARIA", "KATARZYNA", "MALGORZATA", "AGNIESZKA", "BARBARA", "EWA", "KRYSTYNA",
              "ELZBIETA", "MAGDALENA", "JOANNA", "ALEKSANDRA", "MONIKA", "ZOFIA", "TERESA", "DANUTA",
              "NATALIA", "KAROLINA", "MARTA", "BEATA", "DOROTA", "HALINA", "JADWIGA", "JANINA", "JOLANTA",
              "IWONA", "GRAZYNA", "JUSTYNA", "RENATA", "IRENA", "PAULINA", "AGATA", "SYLWIA", "PATRYCJA",
              "ALICJA", "URSZULA", "WIOLETTA", "IZABELA", "KAMILA", "EDYTA")
imiona_m <- c("PIOTR", "KRZYSZTOF", "ANDRZEJ", "TOMASZ", "PAWEL", "JAN", "MICHAL", "MARCIN", "STANISLAW",
              "JAKUB", "ADAM", "MAREK", "LUKASZ", "GRZEGORZ", "MATEUSZ", "WOJCIECH", "MARIUSZ", "DARIUSZ",
              "ZBIGNIEW", "JERZY", "MACIEJ", "RAFAL", "ROBERT", "KAMIL", "JOZEF", "JANUSZ", "RYSZARD",
              "JACEK", "KAZIMIERZ", "DAWID")
waga <- function(k) 1 / seq_len(k)^0.9                  # kilka imion bardzo częstych, reszta rzadsza

osoby <- function(n) {
  ur <- as.Date("2008-01-01") + sample(0:1095, n, replace = TRUE)   # roczniki 2008–2010
  z <- rnorm(n)                                    # niskie zaangażowanie w ankietę (cecha niezmierzona)
  data.frame(matka = sample(imiona_k, n, TRUE, waga(40)), ojciec = sample(imiona_m, n, TRUE, waga(30)),
             dzien = as.integer(format(ur, "%d")), mies = as.integer(format(ur, "%m")),
             rok = as.integer(format(ur, "%Y")), plec = sample(c("K", "M"), n, TRUE), z = z,
             palenie = rbinom(n, 1, plogis(-1.4 + 0.7 * z)))
}

# Jak respondent wpisuje kod w danym pomiarze: każdy element może być błędny niezależnie,
# a osoby mniej zaangażowane mylą się częściej
blad_litery <- function(x) {                     # literówka albo inne imię (np. zdrobnienie) w 2 literach
  if (runif(1) < 0.5) { p <- sample(1:2, 1); substr(x, p, p) <- sample(LETTERS, 1); x }
  else substr(sample(c(imiona_k, imiona_m), 1), 1, 2)
}
blad_liczby <- function(v) {                     # pominięte zero, przestawione cyfry albo inna liczba
  s <- sprintf("%02d", v); r <- runif(1)
  if (r < 0.35 && v < 10) as.character(v)
  else if (r < 0.65) paste(rev(strsplit(s, "")[[1]]), collapse = "")
  else sprintf("%02d", (v + sample(c(-1, 1, 10, -10), 1) - 1) %% 31 + 1)
}
wpisz <- function(o, p = c(matka = 0.02, ojciec = 0.05, dzien = 0.03, mies = 0.03)) {
  mn <- exp(0.6 * o$z) / mean(exp(0.6 * o$z))    # mnożnik ryzyka błędu
  el <- data.frame(matka = substr(o$matka, 1, 2), ojciec = substr(o$ojciec, 1, 2),
                   dzien = sprintf("%02d", o$dzien), mies = sprintf("%02d", o$mies))
  for (e in names(p)) for (i in which(runif(nrow(o)) < pmin(p[[e]] * mn, 1)))
    el[i, e] <- if (e %in% c("matka", "ojciec")) blad_litery(el[i, e]) else blad_liczby(o[i, e])
  rok <- ifelse(runif(nrow(o)) < 0.01, o$rok + sample(c(-1, 1), nrow(o), TRUE), o$rok)
  data.frame(kod4 = paste0(el$matka, el$dzien),                         # np. AN05
             kod8 = paste0(el$matka, el$ojciec, el$dzien, el$mies),     # np. ANPI0503
             plec = o$plec, rok = rok)
}

# Łączenie: dla każdego kodu z pomiaru 2 szukamy kodu z pomiaru 1 o najmniejszej odległości Levenshteina.
# Para powstaje tylko wtedy, gdy najbliższy kandydat jest jeden i nikt inny nie wskazuje go równie blisko.
polacz <- function(D, maks) {
  m <- apply(D, 1, min)
  ile <- rowSums(D == m)
  i <- which(m <= maks & ile == 1)
  j <- apply(D[i, , drop = FALSE], 1, which.min)
  ok <- !(duplicated(j) | duplicated(j, fromLast = TRUE))   # ten sam kod z pomiaru 1 wskazany dwa razy – bez pary
  data.frame(i = i[ok], j = j[ok], odl = m[i][ok])
}
ocena <- function(pary, id1, id2) {
  prawdziwe <- sum(id2 %in% id1)                 # osoby z pomiaru 2, które były też w pomiarze 1
  dobre <- sum(id1[pary$j] == id2[pary$i])
  c(par_mozliwych = prawdziwe, polaczono = nrow(pary), poprawnie = dobre, falszywie = nrow(pary) - dobre,
    czulosc = dobre / prawdziwe, odsetek_falszywych = if (nrow(pary)) (nrow(pary) - dobre) / nrow(pary) else 0)
}
reguly <- list(dokladne = c(0, 0), lev1 = c(1, 0), lev2 = c(2, 0),
               dokladne_plec_rok = c(0, 1), lev1_plec_rok = c(1, 1), lev2_plec_rok = c(2, 1))
jedno_badanie <- function(n, kod = "kod8", zwroc_pary = FALSE) {
  pop <- osoby(round(n * 1.1)); pop$id <- seq_len(nrow(pop))
  id1 <- 1:n                                                     # pomiar 1: n uczniów
  wraca <- runif(n) < plogis(1.9 - 0.4 * pop$z[id1])             # ok. 85% wraca w pomiarze 2
  id2 <- c(id1[wraca], (n + 1):nrow(pop))                        # plus nowi uczniowie (ok. 10%)
  t1 <- wpisz(pop[id1, ]); t2 <- wpisz(pop[id2, ])
  D <- adist(t2[[kod]], t1[[kod]])
  inne <- outer(t2$plec, t1$plec, "!=") | outer(t2$rok, t1$rok, "!=")
  wyn <- lapply(reguly, function(r) { Dr <- D; if (r[2] == 1) Dr[inne] <- 99; polacz(Dr, r[1]) })
  if (zwroc_pary) return(list(pop = pop, id1 = id1, id2 = id2, t1 = t1, t2 = t2, pary = wyn))
  t(sapply(wyn, ocena, id1 = id1, id2 = id2))
}

# A. Jeden przykład: 1000 uczniów w pomiarze 1
set.seed(3671)
b <- jedno_badanie(1000, "kod8", zwroc_pary = TRUE)
cat("Przykładowe kody z pomiaru 1:", head(b$t1$kod8, 6), "\n")
prawdziwy8 <- with(b$pop[b$id1, ], paste0(substr(matka, 1, 2), substr(ojciec, 1, 2), sprintf("%02d", dzien), sprintf("%02d", mies)))
prawdziwy4 <- substr(prawdziwy8, 1, 2); prawdziwy4 <- paste0(prawdziwy4, substr(prawdziwy8, 5, 6))
cat("Osoby w pomiarze 1:", length(b$id1), "| w pomiarze 2:", length(b$id2),
    "| w obu:", sum(b$id2 %in% b$id1), "\n")
cat("Osoby, których bezbłędny kod ma ktoś jeszcze (pomiar 1):\n")
round(c(kod4 = mean(duplicated(prawdziwy4) | duplicated(prawdziwy4, fromLast = TRUE)),
        kod8 = mean(duplicated(prawdziwy8) | duplicated(prawdziwy8, fromLast = TRUE))), 3)
wsp <- b$id1[b$id1 %in% b$id2]
k1 <- b$t1$kod8[match(wsp, b$id1)]; k2 <- b$t2$kod8[match(wsp, b$id2)]
cat("Osoby w obu pomiarach, które wpisały ten sam kod 8-znakowy:", round(mean(k1 == k2), 3), "\n")
cat("Odległość Levenshteina między kodami tej samej osoby:\n"); print(table(diag(adist(k2, k1))))
tab <- t(sapply(b$pary, ocena, id1 = b$id1, id2 = b$id2))
print(round(tab, 3))

# B. Czy osoby połączone są podobne do wszystkich? (palenie w pomiarze 1)
pal <- b$pop$palenie
pol_d <- b$id1[b$pary$dokladne$j]; pol_2 <- b$id1[b$pary$lev2_plec_rok$j]
round(c(wszyscy_pomiar1 = mean(pal[b$id1]), wszyscy_w_obu = mean(pal[wsp]),
        polaczeni_dokladnie = mean(pal[pol_d]), polaczeni_lev2_plec_rok = mean(pal[pol_2])), 3)
cat("Pary z reguły lev2_plec_rok według odległości kodów:\n"); print(table(b$pary$lev2_plec_rok$odl))

# C. Odległość do własnego kodu a odległość do najbliższego kodu innej osoby (osoby z obu pomiarów)
odleglosci <- do.call(rbind, lapply(c("kod4", "kod8"), function(k) {
  D <- adist(b$t2[[k]], b$t1[[k]])
  r <- match(wsp, b$id2); s <- match(wsp, b$id1)
  wlasny <- D[cbind(r, s)]
  D[cbind(r, s)] <- Inf
  data.frame(kod = k, wlasny = wlasny, inny = apply(D[r, , drop = FALSE], 1, min))
}))
write.csv(odleglosci, "b367-odleglosci.csv", row.names = FALSE)
for (k in c("kod4", "kod8")) {
  x <- odleglosci[odleglosci$kod == k, ]
  cat("\n", k, " – odległość do własnego kodu:\n", sep = ""); print(table(pmin(x$wlasny, 4)))
  cat(k, " – odległość do najbliższego kodu innej osoby:\n", sep = ""); print(table(pmin(x$inny, 4)))
  cat("Odsetek osób, dla których inna osoba jest co najmniej tak blisko jak własny kod:", round(mean(x$inny <= x$wlasny), 3), "\n")
}
Wynik w R
Przykładowe kody z pomiaru 1: MOKA0803 ZOPA2112 PAPI3107 KAPI1502 KRTO0511 MAPI0909
Osoby w pomiarze 1: 1000 | w pomiarze 2: 972 | w obu: 872
Osoby, których bezbłędny kod ma ktoś jeszcze (pomiar 1):
 kod4  kod8
0.741 0.022
Osoby w obu pomiarach, które wpisały ten sam kod 8-znakowy: 0.78
Odległość Levenshteina między kodami tej samej osoby:

  0   1   2   3   4
680  88  84  15   5
                  par_mozliwych polaczono poprawnie falszywie czulosc odsetek_falszywych
dokladne                    872       664       663         1   0.760              0.002
lev1                        872       716       712         4   0.817              0.006
lev2                        872       726       720         6   0.826              0.008
dokladne_plec_rok           872       659       658         1   0.755              0.002
lev1_plec_rok               872       740       738         2   0.846              0.003
lev2_plec_rok               872       785       779         6   0.893              0.008
        wszyscy_pomiar1           wszyscy_w_obu     polaczeni_dokladnie polaczeni_lev2_plec_rok
                  0.229                   0.219                   0.197                   0.210
Pary z reguły lev2_plec_rok według odległości kodów:

  0   1   2
634  87  64

kod4 – odległość do własnego kodu:

  0   1   2   3
794  35  40   3
kod4 – odległość do najbliższego kodu innej osoby:

  0   1
630 242
Odsetek osób, dla których inna osoba jest co najmniej tak blisko jak własny kod: 0.774

kod8 – odległość do własnego kodu:

  0   1   2   3   4
680  88  84  15   5
kod8 – odległość do najbliższego kodu innej osoby:

  0   1   2   3   4
 15 239 469 147   2
Odsetek osób, dla których inna osoba jest co najmniej tak blisko jak własny kod: 0.125
2. Powtórzenia: kolizje kodów i reguły dopasowania przy różnych liczebnościach
R
# Krok 2. Powtórzenia: jak odsetek dopasowań i fałszywych połączeń zależy od kodu, reguły i liczebności
# (wymaga funkcji z kroku 1)

# A. Jak często bezbłędny kod nie jest unikatowy (200 powtórzeń dla każdej liczebności)
set.seed(3672)
kolizje <- do.call(rbind, lapply(c(100, 250, 500, 1000, 2000, 3000, 5000), function(n) {
  r <- replicate(200, {
    o <- osoby(n)
    k8 <- paste0(substr(o$matka, 1, 2), substr(o$ojciec, 1, 2), sprintf("%02d", o$dzien), sprintf("%02d", o$mies))
    k4 <- paste0(substr(o$matka, 1, 2), sprintf("%02d", o$dzien))
    k8pr <- paste0(k8, o$plec, o$rok)
    dup <- function(k) mean(duplicated(k) | duplicated(k, fromLast = TRUE))
    c(kod4 = dup(k4), kod8 = dup(k8), kod8_plec_rok = dup(k8pr))
  })
  data.frame(n = n, t(rowMeans(r)))
}))
print(round(kolizje, 3))
write.csv(kolizje, "b367-kolizje.csv", row.names = FALSE)

# B. Łączenie dwóch pomiarów: 2 kody × 6 reguł × 3 liczebności, 40 powtórzeń
set.seed(3673)
siatka <- expand.grid(n = c(250, 1000, 3000), kod = c("kod4", "kod8"), stringsAsFactors = FALSE)
sym <- do.call(rbind, lapply(seq_len(nrow(siatka)), function(s) {
  r <- replicate(40, jedno_badanie(siatka$n[s], siatka$kod[s]), simplify = FALSE)
  do.call(rbind, lapply(seq_along(r), function(k)
    data.frame(n = siatka$n[s], kod = siatka$kod[s], powt = k, regula = rownames(r[[k]]), r[[k]], row.names = NULL)))
}))
write.csv(sym, "b367-symulacja.csv", row.names = FALSE)
podsum <- aggregate(cbind(czulosc, odsetek_falszywych) ~ kod + n + regula, data = sym, FUN = mean)
podsum$sd_czulosc <- aggregate(czulosc ~ kod + n + regula, data = sym, FUN = sd)$czulosc
podsum$sd_falszywych <- aggregate(odsetek_falszywych ~ kod + n + regula, data = sym, FUN = sd)$odsetek_falszywych
podsum$regula <- factor(podsum$regula, levels = names(reguly))
podsum <- podsum[order(podsum$kod, podsum$n, podsum$regula), ]
print(format(transform(podsum, czulosc = round(czulosc, 3), odsetek_falszywych = round(odsetek_falszywych, 3),
                       sd_czulosc = round(sd_czulosc, 3), sd_falszywych = round(sd_falszywych, 3))), row.names = FALSE)
Wynik w R
     n  kod4  kod8 kod8_plec_rok
1  100 0.266 0.003         0.001
2  250 0.464 0.006         0.001
3  500 0.623 0.014         0.002
4 1000 0.756 0.027         0.004
5 2000 0.869 0.053         0.009
6 3000 0.921 0.075         0.014
7 5000 0.966 0.118         0.022
  kod    n            regula czulosc odsetek_falszywych sd_czulosc sd_falszywych
 kod4  250          dokladne   0.457              0.015      0.042         0.011
 kod4  250              lev1   0.451              0.019      0.045         0.013
 kod4  250              lev2   0.451              0.019      0.045         0.013
 kod4  250 dokladne_plec_rok   0.776              0.003      0.039         0.005
 kod4  250     lev1_plec_rok   0.764              0.011      0.039         0.009
 kod4  250     lev2_plec_rok   0.760              0.013      0.039         0.010
 kod4 1000          dokladne   0.203              0.029      0.012         0.011
 kod4 1000              lev1   0.202              0.031      0.012         0.012
 kod4 1000              lev2   0.202              0.031      0.012         0.012
 kod4 1000 dokladne_plec_rok   0.537              0.015      0.019         0.006
 kod4 1000     lev1_plec_rok   0.527              0.021      0.020         0.008
 kod4 1000     lev2_plec_rok   0.527              0.022      0.020         0.008
 kod4 3000          dokladne   0.059              0.071      0.004         0.018
 kod4 3000              lev1   0.059              0.073      0.004         0.018
 kod4 3000              lev2   0.059              0.073      0.004         0.018
 kod4 3000 dokladne_plec_rok   0.312              0.022      0.007         0.006
 kod4 3000     lev1_plec_rok   0.309              0.027      0.007         0.007
 kod4 3000     lev2_plec_rok   0.309              0.029      0.007         0.007
 kod8  250          dokladne   0.790              0.000      0.027         0.000
 kod8  250              lev1   0.870              0.004      0.027         0.005
 kod8  250              lev2   0.896              0.007      0.022         0.006
 kod8  250 dokladne_plec_rok   0.778              0.000      0.025         0.000
 kod8  250     lev1_plec_rok   0.871              0.002      0.023         0.003
 kod8  250     lev2_plec_rok   0.934              0.004      0.018         0.005
 kod8 1000          dokladne   0.765              0.002      0.013         0.001
 kod8 1000              lev1   0.811              0.010      0.014         0.003
 kod8 1000              lev2   0.820              0.014      0.013         0.004
 kod8 1000 dokladne_plec_rok   0.771              0.000      0.014         0.001
 kod8 1000     lev1_plec_rok   0.851              0.004      0.014         0.002
 kod8 1000     lev2_plec_rok   0.886              0.008      0.010         0.003
 kod8 3000          dokladne   0.722              0.005      0.008         0.002
 kod8 3000              lev1   0.749              0.016      0.009         0.003
 kod8 3000              lev2   0.751              0.018      0.010         0.003
 kod8 3000 dokladne_plec_rok   0.762              0.001      0.007         0.001
 kod8 3000     lev1_plec_rok   0.824              0.009      0.007         0.002
 kod8 3000     lev2_plec_rok   0.839              0.014      0.008         0.003
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 (funkcje pakietów base, utils i stats, w tym adist()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Kod czteroznakowy w dużym badaniu. Przy 1000 osobach większość kodów ma bliźniaka. Dobierz liczbę elementów do liczebności i dodaj płeć oraz rok urodzenia.
- Tylko dopasowanie dokładne. Traci się wtedy osoby, które pomyliły jeden znak. Są to zwykle respondenci mniej staranni, a więc różniący się badaną cechą.
- Wysoki próg bez kontroli. Tolerancja trzech czy czterech znaków w próbie kilku tysięcy osób tworzy fałszywe pary, które rozmywają zmianę między pomiarami.
- Remisy rozstrzygane „pierwszym z listy”. Gdy dwa kody są równie blisko, para jest przypadkowa. Zostaw je bez pary albo rozstrzygnij zmiennymi pomocniczymi.
- Analiza tylko połączonych par bez opisu reszty. Podaj, ile osób nie znalazło pary, i porównaj je z połączonymi.
- „Ankieta anonimowa” w informacji dla uczestnika przy kodzie łączącym pomiary. Opisz kod jako pseudonimizację i usuń go po połączeniu.
Najczęstsze pytania
Jak połączyć dwie anonimowe ankiety tej samej osoby?
Poproś o kod tworzony według stałej reguły, np. z dwóch pierwszych liter imienia matki i ojca oraz dnia i miesiąca urodzenia. W drugim pomiarze uczestnik odtwarza go z tych samych pytań. Łącz kody regułą tolerującą drobne błędy i zbierz płeć oraz rok urodzenia jako zmienne pomocnicze.
Ile znaków powinien mieć kod uczestnika w ankiecie?
Tyle, by przy planowanej liczebności prawie każdy kod był unikatowy. W symulacji kod czteroznakowy nie był unikatowy dla 26.6% osób już przy 100 uczestnikach, a ośmioznakowy z płcią i rokiem urodzenia – dla 2.2% nawet przy 5000 osobach. Więcej elementów oznacza jednak więcej pomyłek, więc długi kod łącz z tolerancją.
Co zrobić, gdy kod z drugiego pomiaru różni się jednym znakiem?
Użyj dopasowania rozmytego: policz odległość Levenshteina, np. funkcją adist() w R, i łącz z najbliższym kodem, jeśli różnica nie przekracza progu, a kandydat jest jeden. W przykładzie 1000 uczniów próg 2 znaków z kontrolą płci i roku urodzenia połączył 785 par, z czego 6 fałszywie.
Czy kod z imienia matki i daty urodzenia jest danymi osobowymi?
Bezpieczniej traktować go jako dane spseudonimizowane. Nie wymaga listy nazwisk, ale osoba znająca respondenta może go odtworzyć, a w małej grupie z metryczką wskazuje konkretną osobę. Po połączeniu pomiarów zastąp kod losowym numerem i skonsultuj rozwiązanie z inspektorem ochrony danych.
Czy osoby, których kodów nie udało się połączyć, zniekształcają wyniki?
Mogą, bo częściej mylą się osoby mniej zaangażowane, które różnią się też badaną cechą. W symulacji palenie deklarowało 22.9% uczestników pomiaru 1, ale tylko 19.7% osób połączonych dokładnie. Porównaj połączonych z niepołączonymi i użyj modelu, który wykorzystuje także osoby z jednym pomiarem.
Powiązane hasła
Przeczytaj też
Nie da się połączyć pomiaru przed i po
Uczciwe łączenie kodów regułami ustalonymi z góry, analiza jak dla dwóch grup, utrata mocy, selektywne łączenie, kod R i gotowe zdania.
Czytaj →PoradnikUczestnik wycofuje się po zebraniu danych
Rezygnacja czy usunięcie, ankieta anonimowa a kod: co zrobić, wzory odpowiedzi, usunięcie rekordów w R i zdania do Metody.
Czytaj →PoradnikPorządek w plikach pracy
Pięć folderów, surowe dane tylko do odczytu, nazwy bez „final2”, kopie 3-2-1, osobny klucz ID i co robić, gdy plik zniknie.
Czytaj →PoradnikŁączenie danych z kilku plików ankiety
Arkusze od oddziałów, pomiar przed i po, dokumentacja: ujednolicenie kodów, krotność złączeń i kontrola liczby wierszy w R i SPSS.
Czytaj →PoradnikJak połączyć dwie bazy z ankiet?
Doklejanie wierszy i kolumn, kod uczestnika, duplikaty i literówki w kodach, kontrola utraty osób oraz wzór opisu – z przykładem w R i SPSS.
Czytaj →PoradnikAnkieta w kilku falach
Łączenie fal, stałe pytania, książka kodów i analiza ubytku: kompletne przypadki, model mieszany i wagi IPW w R.
Czytaj →PoradnikRodzaje badań ankietowych
Czas, dobór, kanał i cel badania ankietowego oraz ich konsekwencje dla wniosków – z symulacją autoselekcji w R i wzorem opisu schematu.
Czytaj →Planujesz anonimowe badanie z kilkoma pomiarami albo kody nie chcą się połączyć?
Pomożemy dobrać elementy kodu do liczebności, ustalić i sprawdzić regułę dopasowania, ocenić skutki ubytku i przygotować opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Audette, L. M., Hammond, M. S., & Rochester, N. K. (2020). Methodological issues with coding participants in anonymous psychological longitudinal studies. Educational and Psychological Measurement, 80(1), 163–185. https://doi.org/10.1177/0013164419843576 ● Otwarty dostęp
- Grube, J. W., Morgan, M., & Kearney, K. A. (1989). Using self-generated identification codes to match questionnaires in panel studies of adolescent substance use. Addictive Behaviors, 14(2), 159–171. https://doi.org/10.1016/0306-4603(89)90044-0
- Kearney, K. A., Hopkins, R. H., Mauss, A. L., & Weisheit, R. A. (1984). Self-generated identification codes for anonymous collection of longitudinal questionnaire data. Public Opinion Quarterly, 48(1B), 370–378. https://doi.org/10.1093/poq/48.1b.370
- McGloin, J., Holcomb, S., & Main, D. S. (1996). Matching anonymous pre-posttests using subject-generated information. Evaluation Review, 20(6), 724–736. https://doi.org/10.1177/0193841x9602000604
- McKibben, J. B. A., Bucklin, K., & Salafia, J. (2026). The anonymous collection of longitudinal data: An evaluation of self-generated identification codes and methodological challenges. Educational and Psychological Measurement, Article 00131644261453059. https://doi.org/10.1177/00131644261453059 ● Otwarty dostęp: pełny tekst
- Parlament Europejski i Rada Unii Europejskiej. (2016). Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2016/679 z dnia 27 kwietnia 2016 r. w sprawie ochrony osób fizycznych w związku z przetwarzaniem danych osobowych i w sprawie swobodnego przepływu takich danych oraz uchylenia dyrektywy 95/46/WE (ogólne rozporządzenie o ochronie danych). Dziennik Urzędowy Unii Europejskiej. https://eur-lex.europa.eu/eli/reg/2016/679/oj ● Otwarty dostęp: pełny tekst
- Ripper, L., Ciaravino, S., Jones, K., Jaime, M. C. D., & Miller, E. (2017). Use of a respondent-generated personal code for matching anonymous adolescent surveys in longitudinal studies. Journal of Adolescent Health, 60(6), 751–753. https://doi.org/10.1016/j.jadohealth.2017.01.003
- Schnell, R., Bachteler, T., & Reiher, J. (2010). Improving the use of self-generated identification codes. Evaluation Review, 34(5), 391–418. https://doi.org/10.1177/0193841x10387576
- Vacek, J., Vonkova, H., & Gabrhelík, R. (2017). A successful strategy for linking anonymous data from students’ and parents’ questionnaires using self-generated identification codes. Prevention Science, 18(4), 450–458. https://doi.org/10.1007/s11121-017-0772-6
- Yurek, L. A., Vasey, J., & Sullivan Havens, D. (2008). The use of self-generated identification codes in longitudinal research. Evaluation Review, 32(5), 435–452. https://doi.org/10.1177/0193841x08316676
Cytowania BibTeX
@article{audette2020methodological, author={Audette, Lillian M. and Hammond, Marie S. and Rochester, Natalie K.}, title={{Methodological issues with coding participants in anonymous psychological longitudinal studies}}, journal={Educational and Psychological Measurement}, year={2020}, volume={80}, number={1}, pages={163--185}, doi={10.1177/0013164419843576}}@article{grube1989using, author={Grube, Joel W. and Morgan, Mark and Kearney, Kathleen A.}, title={{Using self-generated identification codes to match questionnaires in panel studies of adolescent substance use}}, journal={Addictive Behaviors}, year={1989}, volume={14}, number={2}, pages={159--171}, doi={10.1016/0306-4603(89)90044-0}}@article{kearney1984self, author={Kearney, Kathleen A. and Hopkins, Ronald H. and Mauss, Armand L. and Weisheit, Ralph A.}, title={{Self-generated identification codes for anonymous collection of longitudinal questionnaire data}}, journal={Public Opinion Quarterly}, year={1984}, volume={48}, number={1B}, pages={370--378}, doi={10.1093/poq/48.1b.370}}@article{mcgloin1996matching, author={McGloin, Joe and Holcomb, Sherry and Main, Deborah S.}, title={{Matching anonymous pre-posttests using subject-generated information}}, journal={Evaluation Review}, year={1996}, volume={20}, number={6}, pages={724--736}, doi={10.1177/0193841x9602000604}}@article{mckibben2026anonymous, author={McKibben, Jodi B. A. and Bucklin, Kimberly and Salafia, Jordan}, title={{The anonymous collection of longitudinal data: An evaluation of self-generated identification codes and methodological challenges}}, journal={Educational and Psychological Measurement}, year={2026}, eid={00131644261453059}, doi={10.1177/00131644261453059}}@misc{eu2016regulation, author={{Parlament Europejski i Rada Unii Europejskiej}}, title={{Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2016/679 z dnia 27 kwietnia 2016 r. w sprawie ochrony osób fizycznych w związku z przetwarzaniem danych osobowych i w sprawie swobodnego przepływu takich danych oraz uchylenia dyrektywy 95/46/WE (ogólne rozporządzenie o ochronie danych)}}, howpublished={Dziennik Urzędowy Unii Europejskiej}, year={2016}, volume={L 119}, pages={1--88}, url={https://eur-lex.europa.eu/eli/reg/2016/679/oj}}@article{ripper2017use, author={Ripper, Lisa and Ciaravino, Samantha and Jones, Kelley and Jaime, Maria Catrina D. and Miller, Elizabeth}, title={{Use of a respondent-generated personal code for matching anonymous adolescent surveys in longitudinal studies}}, journal={Journal of Adolescent Health}, year={2017}, volume={60}, number={6}, pages={751--753}, doi={10.1016/j.jadohealth.2017.01.003}}@article{schnell2010improving, author={Schnell, Rainer and Bachteler, Tobias and Reiher, Jörg}, title={{Improving the use of self-generated identification codes}}, journal={Evaluation Review}, year={2010}, volume={34}, number={5}, pages={391--418}, doi={10.1177/0193841x10387576}}@article{vacek2017successful, author={Vacek, Jaroslav and Vonkova, Hana and Gabrhel{\'i}k, Roman}, title={{A successful strategy for linking anonymous data from students’ and parents’ questionnaires using self-generated identification codes}}, journal={Prevention Science}, year={2017}, volume={18}, number={4}, pages={450--458}, doi={10.1007/s11121-017-0772-6}}@article{yurek2008use, author={Yurek, Leo A. and Vasey, Joseph and Sullivan Havens, Donna}, title={{The use of self-generated identification codes in longitudinal research}}, journal={Evaluation Review}, year={2008}, volume={32}, number={5}, pages={435--452}, doi={10.1177/0193841x08316676}}