Test techniczny to nie pilotaż
Ankieta jest gotowa: pytania poprawione po uwagach promotora, skale wpisane, link prawie wysłany. Zostaje jeden krok, który studenci często pomijają, bo „przecież sam(a) ją wypełniłem/am”. Chodzi o test techniczny, czyli sprawdzenie, czy narzędzie robi dokładnie to, co zaplanowałeś: pokazuje właściwe pytania właściwym osobom i zapisuje odpowiedzi z kodami z książki kodowej.
Test techniczny różni się od dwóch innych form sprawdzania ankiety. Wywiad poznawczy pyta, czy ludzie rozumieją pytania. Badanie pilotażowe sprawdza na małej grupie z populacji czas, rozkłady i braki. Test techniczny robisz sam(a), czasem z jedną lub dwiema osobami do pomocy, na ostatecznej wersji w narzędziu. Pytanie brzmi: czy maszyna działa. Podręczniki projektowania ankiet internetowych prowadzą przez kolejne etapy przygotowania i uruchomienia ankiety (Couper, 2008). Callegaro i in. (2015) dzielą je na etap przed realizacją, realizację i etap po realizacji, a test techniczny zamyka pierwszy z nich.
Ten wpis uzupełnia listy kontrolne z poradników jak zrobić ankietę do pracy dyplomowej i najczęstsze błędy w ankietach. Tam jest lista tego, co powinno działać. Tu pokazujemy, jak to sprawdzić: plan testów, dane testowe i kontrolę eksportu w R.
Plan testów: każda ścieżka co najmniej raz
Ankieta z pytaniami filtrującymi nie jest jedną ankietą, tylko kilkoma ścieżkami. Jeśli przejdziesz ją raz, jako osoba pracująca i zgadzająca się na wszystko, sprawdzisz jedną z nich. Dlatego zacznij od rysunku ścieżek, a potem przypisz do każdej co najmniej jeden test.
W przykładzie (dane symulowane) ankieta dla studentów ma stronę zgody, pytanie kwalifikujące „Czy studiujesz?”, pytanie „Czy pracujesz zarobkowo?” z pytaniem dalszym o liczbę godzin, metryczkę, losowanie jednej z dwóch wersji instrukcji i czteropozycyjną skalę stresu z pozycją str_3 odwróconą. Daje to cztery ścieżki: brak zgody, osoba spoza grupy (screen-out), osoba pracująca i niepracująca. Plan obejmuje sześć testów (Rysunek 1).
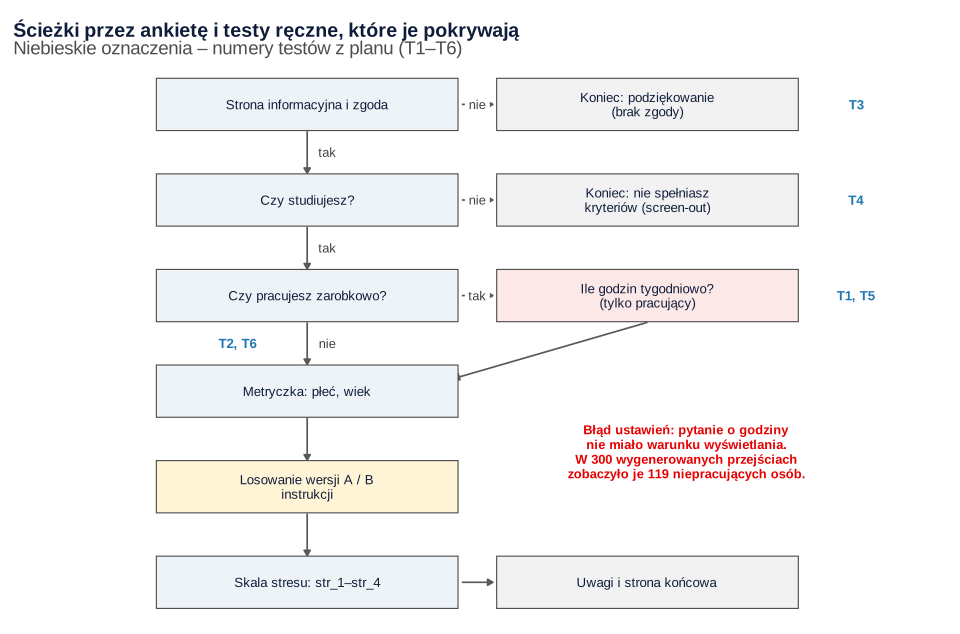
| Test | Ścieżka i urządzenie | Co klikasz | Czego oczekujesz w eksporcie |
|---|---|---|---|
| T1 | pracujący, komputer | 20 godzin; we wszystkich pozycjach skali „zdecydowanie się zgadzam” | godz_pracy = 20; str_1–str_4 = 5 |
| T2 | niepracujący, telefon | wszędzie „zdecydowanie się nie zgadzam” | godz_pracy puste; skala = 1 |
| T3 | brak zgody, telefon | „nie wyrażam zgody” | tylko zgoda = 2, reszta pusta |
| T4 | nie studiuje, komputer | „nie” w pytaniu kwalifikującym | koniec ankiety, dalsze kolumny puste |
| T5 | pracujący, telefon | pomija pytania nieobowiązkowe, płeć „wolę nie odpowiadać” | plec = 9; puste tylko pytania nieobowiązkowe |
| T6 | niepracujący, komputer | w skali różne odpowiedzi: 1, 2, 4, 5 | każda pozycja w swojej kolumnie, z właściwym kodem |
Trzy zasady sprawiają, że taki plan coś wykrywa:
- Odpowiadaj tak, żeby wynik był przewidywalny. Skrajne odpowiedzi (same 5, same 1) i jeden test z różnymi wartościami pokażą, czy kody nie są odwrócone i czy pozycje trafiają do właściwych kolumn. Odpowiedź środkowa tego nie pokaże. Jeśli kody idą od końca, „3” nadal daje 3.
- Testuj na telefonie i na komputerze. W planie są trzy testy na każdym urządzeniu. Dillman i in. (2014) w czwartym wydaniu swojego podręcznika osobno omawiają ankiety wypełniane na smartfonach i tabletach. O projektowaniu ankiety z myślą o telefonie piszemy we wpisie ankieta na telefonie.
- Oznacz każdy test. W polu uwag na końcu wpisz np. „TEST T1”. Dzięki temu połączysz rekord z planem i łatwo usuniesz go przed startem.
Co sprawdzić w narzędziu w czasie przejścia
Podczas każdego testu notuj nie tylko to, czy ankieta „przeszła”, ale też to, co widziałeś/aś. Część błędów widać od razu na ekranie, a część dopiero w eksporcie.
| Element | Jak przetestować | Typowy błąd |
|---|---|---|
| Przejścia i filtry | Każda ścieżka z planu; po każdym filtrze sprawdź, które pytanie pojawiło się jako następne | Warunek ustawiony na złe pytanie albo na złą odpowiedź; pytanie dalsze widzą wszyscy |
| Obowiązkowość | Spróbuj przejść dalej bez odpowiedzi na każdej stronie | Wszystko obowiązkowe, także metryczka i pytania otwarte |
| Walidacja pól | Wpisz wartość błędną (wiek 199, przecinek w liczbie, tekst w polu liczbowym) | Pole przyjmuje wszystko albo odrzuca poprawny format |
| Losowanie | Kilka przejść; czy w eksporcie jest zmienna z wersją lub kolejnością | Losowanie działa, ale nie zapisuje, kto dostał którą wersję |
| Strona zgody i zakończenia | Odmowa zgody, osoba spoza kryteriów, pełne przejście | Odmowa nie kończy ankiety; brak podziękowania albo informacji o wykluczeniu |
| Eksport | Pobierz plik po testach i otwórz go w programie do analizy | Etykiety zamiast kodów, inne nazwy kolumn niż w książce kodowej |
Przy obowiązkowości warto się zatrzymać, bo wiele narzędzi pozwala oznaczyć wszystkie pytania jednym kliknięciem. Décieux i in. (2015) pokazali, że wymuszanie odpowiedzi na każde pytanie zwiększało odsetek przerwań i obniżało jakość odpowiedzi. Sischka i in. (2022) potwierdzili to w eksperymencie: wymuszanie odpowiedzi zwiększało reaktancję i odsetek przerwań oraz skracało odpowiedzi na pytania otwarte. Przerwania i braki w pojedynczych pytaniach to dwa osobne źródła błędu braku odpowiedzi w ankietach internetowych (Tourangeau i in., 2013), a pełne wymuszanie zamienia drugie w pierwsze. Obowiązkowe zrób pytanie o zgodę i pytania kwalifikujące, a resztę zostaw do decyzji respondenta. Braki, które z tego wynikną, łatwiej obsłużyć w analizie (zob. braki danych w ankiecie) niż przypadkowe kliknięcia osoby, która chciała tylko przejść dalej. Peytchev (2009) wiąże przerwania ankiety internetowej z cechami kwestionariusza, które respondent poznaje dopiero po rozpoczęciu, m.in. z obciążeniem respondenta.
Przy stronie zgody sprawdź, czy treść odpowiada temu, co narzędzie naprawdę zapisuje, np. czy nie zbiera adresów e-mail, gdy obiecujesz anonimowość (zob. świadoma zgoda i RODO). Ustawienia anonimowości w popularnych narzędziach omawiamy w porównaniu narzędzi do ankiet online.
Dane testowe: przejścia ręczne i odpowiedzi wygenerowane
Przejścia ręczne nie wystarczą, bo jest ich kilka. Błąd, który dotyczy tylko rzadkiej kombinacji odpowiedzi, łatwo przeoczyć. Dlatego do testu dołóż odpowiedzi wygenerowane: kilkaset losowych przejść przez ankietę. Część narzędzi ma funkcję automatycznego wypełniania ankiety w trybie testowym. Jeśli Twoje jej nie ma, poproś kilka osób o szybkie przejście z losowymi odpowiedziami albo zrób to sam(a) kilkanaście razy, wybierając różne ścieżki.
Oba rodzaje danych wykrywają co innego:
- Przejścia ręczne ze znanymi odpowiedziami wykrywają błędy kodowania. Wiesz, co kliknąłeś/aś, więc możesz porównać to z eksportem pole po polu.
- Odpowiedzi wygenerowane wykrywają błędy logiki: pytanie dalsze u osób, które nie powinny go zobaczyć, kody spoza listy i nierówne losowanie wersji. Nie wykryją odwróconych kodów, bo losowa odpowiedź nie ma „prawdziwej” wartości.
Danych wygenerowanych nie używaj do niczego poza testem. W przykładzie mediana czasu ręcznego przejścia całej ankiety wyniosła 380 s, a przejścia wygenerowanego 4 s. Na takich danych nie ustalisz progu dla zbyt szybkiego wypełniania ani nie policzysz rzetelności skali. Czas i inne paradane ocenisz dopiero na prawdziwych odpowiedziach, najlepiej z pilotażu.
Kontrola eksportu w R: książka kodowa jako tabela reguł
Zamiast przeglądać plik wzrokiem, zapisz książkę kodową jako tabelę reguł, którą da się sprawdzić automatycznie. Każdy wiersz to zmienna, a kolumny mówią, jakie kody są dozwolone, jaki jest zakres, kiedy pytanie powinno się wyświetlić i czy jest obowiązkowe. Funkcja w R (kod na końcu wpisu) sprawdza każdą regułę i wypisuje, ile rekordów ją łamie i które to są. Pliki z przykładu możesz pobrać: plan testów, eksport testów ręcznych i eksport odpowiedzi wygenerowanych (CSV, dane symulowane).
| zmienna | kody | min–max | pokaż, gdy | obowiązkowe |
|---|---|---|---|---|
zgoda | 1, 2 | – | zawsze | tak |
pracuje | 1, 2 | – | zgoda == 1 & student == 1 | tak |
godz_pracy | – | 1–60 | … & pracuje == 1 | nie |
plec | 1, 2, 3, 9 | – | zgoda == 1 & student == 1 | nie |
str_1–str_4 | 1–5 | – | zgoda == 1 & student == 1 | tak |
wersja | A, B | – | zgoda == 1 & student == 1 | tak |
W symulacji narzędzie miało cztery celowo wprowadzone błędy ustawień: brak warunku przy pytaniu o godziny pracy, kody płci nadane po kolei (1–4 zamiast 1, 2, 3, 9), odwrócone kody pozycji str_3 i nazwę str4 zamiast str_4. Oto co znalazła kontrola.
Odpowiedzi wygenerowane (300 przejść). Funkcja sprawdziła 43 reguły i zgłosiła cztery problemy: brak zmiennej str_4 wraz z nadmiarową kolumną str4, odpowiedź na pytanie o godziny pracy u 119 osób niepracujących („odpowiedź mimo przejścia”) i kod płci spoza książki w 66 rekordach. Kod 4 to w narzędziu „wolę nie odpowiadać”, a w książce ta odpowiedź ma kod 9. Gdyby nikt tego nie zauważył, w analizie „4” mogłaby trafić do jednej z kategorii płci albo zniknąć jako wartość niemożliwa.
Testy ręczne (7 rekordów). Porównanie z planem znalazło sześć niezgodności (Rysunek 2B). Pozycja str_3 miała odwrócone kody w T1 (5 → 1), T2 (1 → 5) i T6 (4 → 2), ale nie w T5, gdzie tester zaznaczył środek skali. Testerzy T2 i T6, którzy nie pracują, zobaczyli pytanie o godziny i wpisali 0. Wybór „wolę nie odpowiadać” w T5 zapisał się jako 4. Kontrola reguł wykryła też, że T1 jest w pliku dwa razy (rekordy 1 i 7), bo test powtórzono rano w dniu startu.
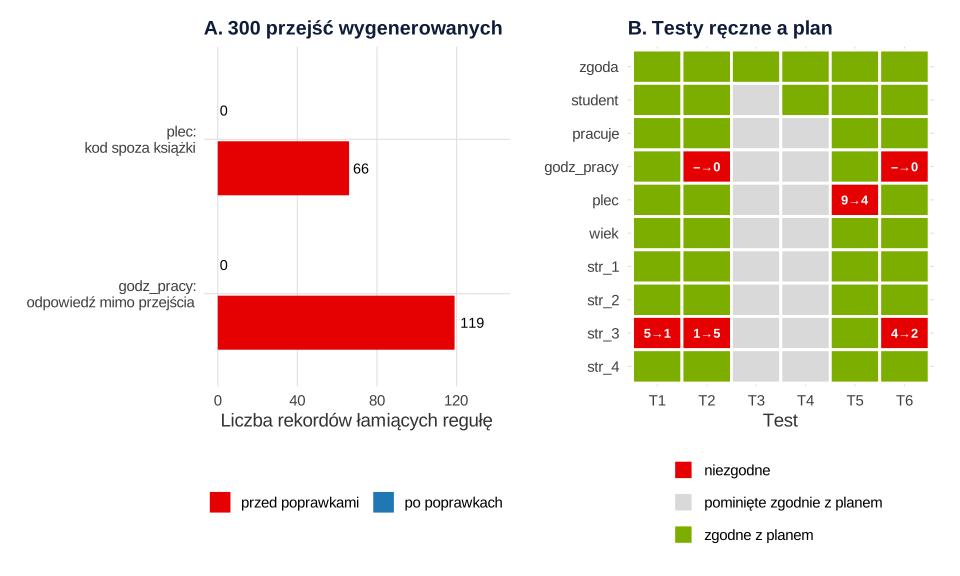
str4 dotyczy kolumny, nie rekordów, więc go nie pokazano). B: porównanie eksportu testów ręcznych z planem; w czerwonych polach wartość z planu → wartość w eksporcie („–” = pole puste). Obliczenia: R (dane symulowane).Zwróć uwagę, że każdy rodzaj danych testowych złapał coś, czego drugi by nie złapał. Odwróconą pozycję str_3 pokazały tylko testy ręczne ze znanymi odpowiedziami. Gdyby została w danych, po standardowym przekodowaniu pozycji odwróconej w analizie odwróciłbyś/odwróciłabyś ją drugi raz, a wynik skali byłby błędny bez żadnego komunikatu. Skalę problemu z godzinami pracy pokazały dopiero setki przejść.
Odpowiedzi wygenerowane posłużyły też do sprawdzenia losowania. Wersję A dostało 117 osób, a wersję B 110. Test dwumianowy nie wskazuje na nierówne losowanie (p = .691), a zmienna wersja jest w eksporcie. Jeśli w ankiecie jest eksperyment, np. split-ballot z dwiema wersjami pytania, ten krok jest obowiązkowy: bez zapisu wersji nie da się policzyć żadnego porównania. Więcej o samym losowaniu znajdziesz w haśle randomizacja.
Po poprawieniu czterech ustawień w narzędziu i wygenerowaniu nowych 300 przejść ta sama funkcja zgłosiła 0 naruszonych reguł z 44 (o jedną więcej, bo kolumna str_4 wreszcie istnieje). Dopiero to jest sygnał do startu. Gdy już masz prawdziwe dane, ta sama tabela reguł przyda się do czyszczenia danych z ankiety online. Przekodowanie etykiet i pozycji odwróconych pokazujemy we wpisie dane z Google Forms i LimeSurvey do SPSS i R.
Usuń dane testowe przed startem
Ostatni krok przed wysłaniem linku: w bazie nie może zostać żaden rekord testowy. Najpierw pobierz eksport z testów i zachowaj go jako dokumentację. Potem usuń odpowiedzi w narzędziu, jeśli na to pozwala, albo zapisz datę i godzinę startu, od której liczysz dane.
Sam filtr daty bywa zawodny. W przykładzie za początek badania przyjęto 2 marca, a filtr „od 2 marca” zostawił w danych jeden rekord: powtórzony test T1 wysłany o 8:05 w dniu startu. Usunął go dopiero znacznik „TEST” w polu uwag. Dlatego stosuj oba zabezpieczenia: datę startu i znacznik w każdym teście.
Po starcie nie zmieniaj ankiety. Jeśli musisz coś poprawić, zapisz datę zmiany i dodaj do danych zmienną z wersją ankiety, żeby w analizie dało się sprawdzić, czy zmiana miała znaczenie.
Jak opisać test w pracy
W rozdziale metodologicznym wystarczy kilka zdań obok opisu pilotażu. Pokazują, że dane powstały w sprawdzonym narzędziu, a w razie pytań na obronie masz dokumentację.
Najczęstsze błędy
- Jedno przejście „na szybko”. Sprawdza jedną ścieżkę z kilku.
- Test tylko na komputerze. Część osób wypełni ankietę na telefonie, gdzie ten sam ekran wygląda inaczej.
- Odpowiedzi środkowe w teście. Nie ujawniają odwróconych kodów.
- Brak próbnego eksportu. Błąd kodów wychodzi dopiero przy analizie, gdy danych nie da się już zebrać ponownie.
- Wszystkie pytania obowiązkowe. Więcej przerwań i odpowiedzi „byle przejść”.
- Rekordy testowe w danych. Fałszywe osoby w próbie, często z nierealnym czasem.
- Poprawka po teście bez ponownego testu. Zmiana jednego warunku potrafi zepsuć inny – po każdej poprawce powtórz przynajmniej testy ścieżek, których dotyczyła.
Jeśli chcesz, żeby ktoś przed startem przejrzał z Tobą ankietę, plan analizy i próbny eksport, zobacz naszą pomoc w analizie dla studentów.
Test eksportu w R: kod i wynik
Dwa przepisy liczą wszystkie wyniki z tekstu. Pierwszy udaje platformę ankietową z czterema błędami ustawień i tworzy pliki CSV z testów (zapisuje je w folderze nadrzędnym ../). Drugi wczytuje te pliki, zapisuje książkę kodową jako tabelę reguł i sprawdza eksport. Rysunki powstały w osobnym skrypcie na tych samych plikach. Do własnej ankiety wystarczy drugi przepis: podmień nazwy plików i wiersze tabeli reguł.
Symulowany eksport z testów ręcznych i odpowiedzi wygenerowanych
R
# B374 – symulowany eksport z testu ankiety online (dane symulowane)
# Ankieta: zgoda -> czy studiujesz -> czy pracujesz -> [godziny pracy] -> płeć, wiek, 4 pozycje skali stresu -> uwagi.
# Funkcja narzedzie() udaje platformę ankietową. Przy bledy = TRUE ma cztery błędy ustawień:
#  1) pytanie o godziny pracy nie ma warunku wyświetlania (widzą je wszyscy studenci),
#  2) w pytaniu o płeć kody nadano po kolei 1–4, a w książce kodów „wolę nie odpowiadać” = 9,
#  3) w pozycji str_3 odpowiedzi wpisano od końca, więc kody idą 5–1,
#  4) pozycja str_4 ma w narzędziu nazwę „str4”.
set.seed(374)

narzedzie <- function(o, bledy = TRUE) {
  n <- nrow(o)
  widzi_studia <- o$zgoda == 1                       # bez zgody ankieta się kończy
  widzi_reszte <- widzi_studia & o$student == 1      # osoby niestudiujące kończą (screen-out)
  widzi_godz <- if (bledy) widzi_reszte else widzi_reszte & o$pracuje == 1
  tylko <- function(x, warunek) ifelse(warunek, x, NA)
  e <- data.frame(id = seq_len(n), start = o$start, zgoda = o$zgoda,
                  student = tylko(o$student, widzi_studia),
                  pracuje = tylko(o$pracuje, widzi_reszte),
                  godz_pracy = tylko(o$godz_pracy, widzi_godz),
                  plec = tylko(if (bledy) match(o$plec, c(1, 2, 3, 9)) else o$plec, widzi_reszte),
                  wiek = tylko(o$wiek, widzi_reszte),
                  str_1 = tylko(o$str_1, widzi_reszte), str_2 = tylko(o$str_2, widzi_reszte),
                  str_3 = tylko(if (bledy) 6 - o$str_3 else o$str_3, widzi_reszte),
                  str_4 = tylko(o$str_4, widzi_reszte),
                  wersja = tylko(sample(c("A", "B"), n, replace = TRUE), widzi_reszte),  # losowanie wersji instrukcji
                  uwagi = o$uwagi, czas_s = o$czas_s)
  if (bledy) names(e)[names(e) == "str_4"] <- "str4"
  e
}

# 1. Plan testów ręcznych: co tester klika i czego oczekujemy w eksporcie (kody z książki kodów)
plan <- data.frame(
  test = paste0("T", 1:6),
  sciezka = c("pracujący", "niepracujący", "brak zgody", "nie studiuje", "pracujący, pomija", "niepracujący"),
  urzadzenie = c("komputer", "telefon", "telefon", "komputer", "telefon", "komputer"),
  zgoda = c(1, 1, 2, 1, 1, 1), student = c(1, 1, NA, 2, 1, 1), pracuje = c(1, 2, NA, NA, 1, 2),
  godz_pracy = c(20, NA, NA, NA, 10, NA), plec = c(1, 2, NA, NA, 9, 3), wiek = c(22, 24, NA, NA, 30, 19),
  str_1 = c(5, 1, NA, NA, 3, 1), str_2 = c(5, 1, NA, NA, 3, 2),
  str_3 = c(5, 1, NA, NA, 3, 4), str_4 = c(5, 1, NA, NA, 3, 5))
write.csv(plan, "../test-ankiety-plan-testow.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

klik <- plan
klik$student[is.na(klik$student)] <- 1; klik$pracuje[is.na(klik$pracuje)] <- 2
klik$godz_pracy[is.na(klik$godz_pracy)] <- 0     # osoba niepracująca, która zobaczy pytanie, wpisze 0
klik$uwagi <- paste("TEST", plan$test)            # znacznik testu w polu uwag
klik$start <- sprintf("2026-03-01 %02d:%02d", 18, c(5, 12, 20, 24, 31, 40))
klik$czas_s <- c(412, 365, 41, 58, 297, 388)
klik <- rbind(klik, transform(klik[1, ], start = "2026-03-02 08:05", czas_s = 380))  # T1 wysłany drugi raz rano w dniu startu
reczne <- narzedzie(klik, bledy = TRUE)
write.csv(reczne, "../test-ankiety-eksport-reczny.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# 2. Odpowiedzi wygenerowane automatycznie (300 losowych przejść) – przed poprawkami i po nich
losowe <- function(n) {
  data.frame(zgoda = sample(1:2, n, TRUE, c(.9, .1)), student = sample(1:2, n, TRUE, c(.85, .15)),
             pracuje = sample(1:2, n, TRUE, c(.45, .55)), godz_pracy = sample(1:40, n, TRUE),
             plec = sample(c(1, 2, 3, 9), n, TRUE), wiek = sample(18:35, n, TRUE),
             str_1 = sample(1:5, n, TRUE), str_2 = sample(1:5, n, TRUE),
             str_3 = sample(1:5, n, TRUE), str_4 = sample(1:5, n, TRUE),
             uwagi = "", start = "2026-03-01 21:00", czas_s = round(runif(n, 2, 6)))
}
gen_przed <- narzedzie(losowe(300), bledy = TRUE)
gen_po <- narzedzie(losowe(300), bledy = FALSE)
write.csv(gen_przed, "../test-ankiety-eksport-generowany.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")
write.csv(gen_po, "b374-eksport-generowany-po-poprawkach.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

cat("Eksport testów ręcznych:", nrow(reczne), "wierszy,", ncol(reczne), "kolumn\n")
cat("Eksport wygenerowany przed poprawkami:", nrow(gen_przed), "wierszy; po poprawkach:", nrow(gen_po), "wierszy\n")
print(head(reczne, 3), row.names = FALSE)
Wynik w R
Eksport testów ręcznych: 7 wierszy, 15 kolumn
Eksport wygenerowany przed poprawkami: 300 wierszy; po poprawkach: 300 wierszy
 id            start zgoda student pracuje godz_pracy plec wiek str_1 str_2
  1 2026-03-01 18:05     1       1       1         20    1   22     5     5
  2 2026-03-01 18:12     1       1       2          0    2   24     1     1
  3 2026-03-01 18:20     2      NA      NA         NA   NA   NA    NA    NA
 str_3 str4 wersja   uwagi czas_s
     1    5      B TEST T1    412
     5    1      A TEST T2    365
    NA   NA   <NA> TEST T3     41
Kontrola eksportu według tabeli reguł i porównanie z planem testów
R
# B374 – kontrola eksportu z testu ankiety według książki kodów (dane symulowane)
# Uruchom po b374-1-eksport.R; pliki CSV leżą w folderze nadrzędnym (../).
reczne <- read.csv("../test-ankiety-eksport-reczny.csv", na.strings = "")
gen <- read.csv("../test-ankiety-eksport-generowany.csv", na.strings = "")
plan <- read.csv("../test-ankiety-plan-testow.csv", na.strings = "")

# Książka kodów jako tabela reguł: dozwolone kody lub zakres, warunek wyświetlenia, obowiązkowość
ksiazka <- read.csv(text = "
zmienna,kody,min,max,pokaz_gdy,obowiazkowe
id,,1,,,TRUE
start,,,,,TRUE
zgoda,\"1,2\",,,,TRUE
student,\"1,2\",,,zgoda == 1,TRUE
pracuje,\"1,2\",,,zgoda == 1 & student == 1,TRUE
godz_pracy,,1,60,zgoda == 1 & student == 1 & pracuje == 1,FALSE
plec,\"1,2,3,9\",,,zgoda == 1 & student == 1,FALSE
wiek,,18,99,zgoda == 1 & student == 1,TRUE
str_1,\"1,2,3,4,5\",,,zgoda == 1 & student == 1,TRUE
str_2,\"1,2,3,4,5\",,,zgoda == 1 & student == 1,TRUE
str_3,\"1,2,3,4,5\",,,zgoda == 1 & student == 1,TRUE
str_4,\"1,2,3,4,5\",,,zgoda == 1 & student == 1,TRUE
wersja,\"A,B\",,,zgoda == 1 & student == 1,TRUE
uwagi,,,,,FALSE
czas_s,,1,,,TRUE", na.strings = "", colClasses = "character")

sprawdz <- function(d, k) {
  wynik <- data.frame(regula = character(), zmienna = character(), n = integer(), id = character())
  dodaj <- function(regula, zmienna, ktore) {
    n <- if (is.null(ktore)) NA else length(ktore)          # NA = reguła dotyczy nazwy kolumny, nie rekordów
    wynik[nrow(wynik) + 1, ] <<- list(regula, zmienna, n, paste(head(d$id[ktore], 5), collapse = " "))
  }
  for (v in setdiff(k$zmienna, names(d))) dodaj("brak zmiennej z książki kodów", v, NULL)
  for (v in setdiff(names(d), k$zmienna)) dodaj("zmienna spoza książki kodów", v, NULL)
  dodaj("powtórzony id", "id", which(duplicated(d$id)))
  tresc <- d[, setdiff(names(d), c("id", "start", "czas_s", "wersja"))]
  pelne <- rowSums(!is.na(tresc)) > 5          # porównujemy tylko rekordy z odpowiedziami na pytania
  dodaj("powtórzone odpowiedzi", "(cały wiersz)",
        which(pelne & (duplicated(tresc) | duplicated(tresc, fromLast = TRUE))))
  for (i in seq_len(nrow(k))) {
    v <- k$zmienna[i]; if (!v %in% names(d)) next
    x <- d[[v]]
    pokaz <- if (is.na(k$pokaz_gdy[i])) rep(TRUE, nrow(d)) else with(d, eval(parse(text = k$pokaz_gdy[i])))
    pokaz[is.na(pokaz)] <- FALSE
    if (!is.na(k$kody[i])) dodaj("kod spoza książki", v, which(!is.na(x) & !as.character(x) %in% strsplit(k$kody[i], ",")[[1]]))
    if (!is.na(k$min[i])) dodaj("poniżej minimum", v, which(!is.na(x) & as.numeric(x) < as.numeric(k$min[i])))
    if (!is.na(k$max[i])) dodaj("powyżej maksimum", v, which(!is.na(x) & as.numeric(x) > as.numeric(k$max[i])))
    dodaj("odpowiedź mimo przejścia", v, which(!pokaz & !is.na(x)))
    if (k$obowiazkowe[i] == "TRUE") dodaj("brak w pytaniu obowiązkowym", v, which(pokaz & is.na(x)))
  }
  wynik
}

# 1. Odpowiedzi wygenerowane automatycznie – pokaż tylko reguły, które coś znalazły
w_gen <- sprawdz(gen, ksiazka)
cat("Eksport wygenerowany (", nrow(gen), " wierszy): reguł sprawdzonych ", nrow(w_gen),
    ", naruszonych ", sum(is.na(w_gen$n) | w_gen$n > 0), "\n", sep = "")
print(w_gen[is.na(w_gen$n) | w_gen$n > 0, ], row.names = FALSE)

w_rek <- sprawdz(reczne, ksiazka)
cat("\nEksport testów ręcznych (", nrow(reczne), " wierszy): reguły naruszone\n", sep = "")
print(w_rek[is.na(w_rek$n) | w_rek$n > 0, ], row.names = FALSE)

# 2. Testy ręczne: porównaj eksport z planem (test rozpoznajemy po znaczniku „TEST Tx” w uwagach)
names(reczne)[names(reczne) == "str4"] <- "str_4"     # tylko na potrzeby porównania; nazwę popraw w narzędziu
reczne$test <- sub("TEST ", "", reczne$uwagi)
cat("\nTesty ręczne: ścieżki i urządzenia\n")
print(table(plan$sciezka, plan$urzadzenie))
pola <- c("zgoda", "student", "pracuje", "godz_pracy", "plec", "wiek", paste0("str_", 1:4))
r <- merge(plan, reczne, by = "test", suffixes = c("_plan", "_eksport"))
rozne <- do.call(rbind, lapply(pola, function(v) {
  a <- r[[paste0(v, "_plan")]]; b <- r[[paste0(v, "_eksport")]]
  z <- which(!(is.na(a) & is.na(b)) & (is.na(a) | is.na(b) | a != b))
  if (length(z)) data.frame(test = r$test[z], zmienna = v, plan = a[z], eksport = b[z])
}))
cat("\nNiezgodności eksportu z planem testów:\n")
print(unique(rozne), row.names = FALSE)

# 3. Losowanie wersji, czas i usunięcie danych testowych
cat("\nWersja instrukcji w odpowiedziach wygenerowanych:\n"); print(table(gen$wersja))
cat("Test dwumianowy równowagi wersji: p =", sub("^0", "", sprintf("%.3f", binom.test(table(gen$wersja))$p.value)), "\n")
cat("Mediana czasu (s): testy ręczne pełnej ankiety =",
    median(reczne$czas_s[!is.na(reczne$str_1)]), "; odpowiedzi wygenerowane =", median(gen$czas_s), "\n")
start_badania <- as.POSIXct("2026-03-02 00:00", tz = "UTC")      # dzień startu badania
po_dacie <- reczne[as.POSIXct(reczne$start, tz = "UTC") >= start_badania, ]
cat("Rekordy testowe po odfiltrowaniu daty startu:", nrow(po_dacie), "-", paste(po_dacie$uwagi, po_dacie$start), "\n")
cat("Po odfiltrowaniu także znacznika TEST:", nrow(po_dacie[!grepl("^TEST", po_dacie$uwagi), ]), "\n")

# 4. Ta sama kontrola po poprawieniu ustawień w narzędziu
w_po <- sprawdz(read.csv("b374-eksport-generowany-po-poprawkach.csv", na.strings = ""), ksiazka)
cat("\nPo poprawkach: reguł naruszonych =", sum(is.na(w_po$n) | w_po$n > 0), "z", nrow(w_po), "\n")
write.csv(rbind(cbind(etap = "przed", w_gen), cbind(etap = "po", w_po)), "b374-wynik-kontroli.csv", row.names = FALSE)
Wynik w R
Eksport wygenerowany (300 wierszy): reguł sprawdzonych 43, naruszonych 4
                        regula    zmienna   n           id
 brak zmiennej z książki kodów      str_4  NA
   zmienna spoza książki kodów       str4  NA
      odpowiedź mimo przejścia godz_pracy 119  4 5 7 10 11
             kod spoza książki       plec  66 3 5 10 17 23

Eksport testów ręcznych (7 wierszy): reguły naruszone
                        regula       zmienna  n  id
 brak zmiennej z książki kodów         str_4 NA
   zmienna spoza książki kodów          str4 NA
         powtórzone odpowiedzi (cały wiersz)  2 1 7
               poniżej minimum    godz_pracy  2 2 6
      odpowiedź mimo przejścia    godz_pracy  2 2 6
             kod spoza książki          plec  1   5

Testy ręczne: ścieżki i urządzenia

                    komputer telefon
  brak zgody               0       1
  nie studiuje             1       0
  niepracujący             1       1
  pracujący                1       0
  pracujący, pomija        0       1

Niezgodności eksportu z planem testów:
 test    zmienna plan eksport
   T2 godz_pracy   NA       0
   T6 godz_pracy   NA       0
   T5       plec    9       4
   T1      str_3    5       1
   T2      str_3    1       5
   T6      str_3    4       2

Wersja instrukcji w odpowiedziach wygenerowanych:

  A   B
117 110
Test dwumianowy równowagi wersji: p = .691
Mediana czasu (s): testy ręczne pełnej ankiety = 380 ; odpowiedzi wygenerowane = 4
Rekordy testowe po odfiltrowaniu daty startu: 1 - TEST T1 2026-03-02 08:05
Po odfiltrowaniu także znacznika TEST: 0

Po poprawkach: reguł naruszonych = 0 z 44
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base, stats i utils); rysunki przygotowano w pakietach ggplot2, patchwork, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Czym różni się test techniczny ankiety od badania pilotażowego?
Test techniczny sprawdza narzędzie: czy filtry, obowiązkowość, losowanie i eksport działają tak, jak zaplanowano. Robisz go sam(a) na ostatecznej wersji, z odpowiedziami ustalonymi w planie testów. Pilotaż sprawdza ankietę na małej grupie z populacji: zrozumiałość, czas, rozkłady odpowiedzi i braki danych.
Ile razy przejść ankietę online przed wysłaniem linku?
Tyle, żeby każda ścieżka wynikająca z pytań filtrujących i kwalifikujących została przetestowana co najmniej raz, na telefonie i na komputerze. W przykładzie z czterema ścieżkami plan obejmował 6 przejść ręcznych ze skrajnymi i mieszanymi odpowiedziami. Dodaj do nich kilkaset przejść wygenerowanych, które wyłapią rzadsze błędy logiki.
Czy wszystkie pytania w ankiecie online powinny być obowiązkowe?
Nie. Badania nad wymuszaniem odpowiedzi pokazują, że zwiększa ono odsetek przerwań i obniża jakość odpowiedzi. Obowiązkowe zrób pytanie o zgodę i pytania kwalifikujące, a przy pozostałych pozwól pominąć odpowiedź i obsłuż braki w analizie.
Jak usunąć odpowiedzi testowe z ankiety przed rozpoczęciem badania?
Najpierw pobierz eksport z testów i zachowaj go jako dokumentację, potem usuń odpowiedzi w narzędziu albo zapisz datę i godzinę startu. Każdy test oznacz w polu uwag (np. „TEST T1”) i w analizie odfiltruj rekordy zarówno po dacie, jak i po znaczniku, bo test powtórzony w dniu startu przejdzie przez filtr daty.
Jak sprawdzić, czy eksport z ankiety zgadza się z książką kodową?
Zapisz książkę kodową jako tabelę reguł: nazwa zmiennej, dozwolone kody lub zakres, warunek wyświetlenia i obowiązkowość. Skrypt w R porówna z nią eksport z testów i wypisze brakujące lub nadmiarowe kolumny, kody spoza listy, odpowiedzi mimo przejścia i braki w pytaniach obowiązkowych.
Powiązane hasła
Przeczytaj też
Reguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →PoradnikJak zrobić ankietę do pracy dyplomowej
12 kroków od hipotez do czystych danych: skale, pytania, zgoda, pilotaż, Google Forms czy LimeSurvey, książka kodów, harmonogram i lista kontrolna.
Czytaj →PoradnikBadanie pilotażowe: po co, ile osób, co sprawdzić
Pilotaż a pretest, ile osób zbadać, co sprawdzić w danych i dlaczego nie liczyć mocy z efektu z pilotażu. Z symulacją, kodem R i wzorem opisu.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →Chcesz sprawdzić ankietę, zanim wyślesz link?
Przejrzymy z Tobą ankietę, plan analizy i próbny eksport danych, sprawdzimy kody i przejścia w R, a potem wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie opisać i obronić każdą decyzję.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Callegaro, M., Lozar Manfreda, K., & Vehovar, V. (2015). Web survey methodology. SAGE Publications. https://doi.org/10.4135/9781529799651 ● Otwarty dostęp: pełny tekst
- Couper, M. P. (2008). Designing effective web surveys. Cambridge University Press. https://doi.org/10.1017/cbo9780511499371
- Décieux, J. P., Mergener, A., Neufang, K. M., & Sischka, P. (2015). Implementation of the forced answering option within online surveys: Do higher item response rates come at the expense of participation and answer quality? Psihologija, 48(4), 311–326. https://doi.org/10.2298/psi1504311d ● Otwarty dostęp
- Dillman, D. A., Smyth, J. D., & Christian, L. M. (2014). Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.). Wiley. https://doi.org/10.1002/9781394260645
- Peytchev, A. (2009). Survey breakoff. Public Opinion Quarterly, 73(1), 74–97. https://doi.org/10.1093/poq/nfp014
- Sischka, P. E., Décieux, J. P., Mergener, A., Neufang, K. M., & Schmidt, A. F. (2022). The impact of forced answering and reactance on answering behavior in online surveys. Social Science Computer Review, 40(2), 405–425. https://doi.org/10.1177/0894439320907067
- Tourangeau, R., Conrad, F. G., & Couper, M. P. (2013). The science of web surveys. Oxford University Press. https://doi.org/10.1093/acprof:oso/9780199747047.001.0001 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@book{callegaro2015web, author={Callegaro, Mario and Lozar Manfreda, Katja and Vehovar, Vasja}, title={{Web survey methodology}}, year={2015}, publisher={SAGE Publications}, doi={10.4135/9781529799651}}@book{couper2008designing, author={Couper, Mick P.}, title={{Designing effective web surveys}}, year={2008}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511499371}}@article{decieux2015implementation, author={Décieux, Jean Philippe and Mergener, Alexandra and Neufang, Kristina M. and Sischka, Philipp}, title={{Implementation of the forced answering option within online surveys: Do higher item response rates come at the expense of participation and answer quality?}}, journal={Psihologija}, year={2015}, volume={48}, number={4}, pages={311--326}, doi={10.2298/psi1504311d}}@book{dillman2014internet, author={Dillman, Don A. and Smyth, Jolene D. and Christian, Leah Melani}, title={{Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.)}}, year={2014}, publisher={Wiley}, doi={10.1002/9781394260645}}@article{peytchev2009survey, author={Peytchev, Andy}, title={{Survey breakoff}}, journal={Public Opinion Quarterly}, year={2009}, volume={73}, number={1}, pages={74--97}, doi={10.1093/poq/nfp014}}@article{sischka2022impact, author={Sischka, Philipp E. and Décieux, Jean Philippe and Mergener, Alexandra and Neufang, Kristina M. and Schmidt, Alexander F.}, title={{The impact of forced answering and reactance on answering behavior in online surveys}}, journal={Social Science Computer Review}, year={2022}, volume={40}, number={2}, pages={405--425}, doi={10.1177/0894439320907067}}@book{tourangeau2013science, author={Tourangeau, Roger and Conrad, Frederick G. and Couper, Mick P.}, title={{The science of web surveys}}, year={2013}, publisher={Oxford University Press}, doi={10.1093/acprof:oso/9780199747047.001.0001}}