Paradane: zapis tego, jak ktoś wypełniał ankietę
Każda platforma ankietowa zapisuje więcej niż same odpowiedzi: kiedy osoba weszła na stronę, kiedy ją wysłała, z jakiego urządzenia korzystała i na której stronie zamknęła kartę. Te dane o procesie to paradane. Nie myl ich z metadanymi: metadane opisują same dane (nazwy i etykiety zmiennych, kody odpowiedzi, treść pytań – to, co trafia do książki kodowej), a paradane opisują przebieg zbierania danych. Kreuter (2013) opisuje je jako informację na poziomie mikro, dostępną już w trakcie badania, więc nadającą się do monitorowania realizacji niemal na bieżąco. Definicję i najprostszy przykład znajdziesz w haśle. Ten wpis jest dla badacza, który chce paradane zaplanować przed startem ankiety, a potem przeanalizować je tak samo starannie jak odpowiedzi.
Pokazujemy cztery analizy na jednym symulowanym zbiorze: 1500 osób, które rozpoczęły ankietę o 20 stronach. Kolejno są to rozkład czasów i ich logarytm, speeding mierzony na poziomie strony zamiast całej ankiety, krzywa przerwań liczona jak analiza przeżycia oraz model wielopoziomowy czasu strony. Prostą regułę dla całego czasu wypełniania opisuje hasło speeding, a pozostałe wskaźniki nieuwagi – wpis o nieuważnych odpowiedziach w ankietach online. Tu ich nie powtarzamy.
Jakie paradane zbierać
Nie wszystko, co da się zapisać, warto zapisać. Wybierz paradane pod pytania, które zadasz danym: o jakość odpowiedzi, o trudne pytania i o miejsca, w których ludzie rezygnują.
| Paradane | Poziom zapisu | Do czego służą | Na co uważać |
|---|---|---|---|
| Znacznik czasu startu i końca | osoba | czas całkowity, speeding całej ankiety | zależy od ścieżki filtrów i od przerw |
| Znacznik wejścia na każdą stronę | osoba × strona | czas strony, speeding strony, trudność pytań | czas ostatniej strony wymaga znacznika końca |
| Czas pojedynczego pytania | osoba × pytanie | modele czasu odpowiedzi, wykrywanie trudnych pytań | zwykle wymaga skryptu w przeglądarce |
| Zmiany odpowiedzi | osoba × pytanie | niepewność, niejasne sformułowania, pomyłki dotykowe | tylko po stronie przeglądarki |
| Ostatnia wyświetlona strona | osoba | punkt przerwania, krzywa przerwań | odróżnij przerwanie od niewysłania ostatniej strony |
| Urządzenie, system, przeglądarka | osoba (sesja) | kontrola urządzenia w analizie, błędy wyświetlania | urządzenie miesza selekcję i pomiar |
| Liczba wejść i powrotów | osoba | przerywanie i wznawianie, wielokrotne wypełnienie | wznowienie zmienia sens czasu całkowitego |
| Kliknięcia, ruchy kursora, utrata aktywności okna | zdarzenie | odejście od ekranu, przełączanie kart | dużo danych, mało gotowych reguł |
Heerwegh (2003) rozróżnia paradane zapisywane po stronie serwera (moment wysłania strony) i po stronie klienta, czyli skryptem w przeglądarce. Te drugie opisują proces dokładniej: rejestrują np. zmiany odpowiedzi przed wysłaniem strony. W tym samym badaniu osoby o mniej stabilnych postawach odpowiadały dłużej na pytanie o postawę.
Skąd je wziąć i co z RODO
Większość narzędzi eksportuje czas startu i końca, a część także czasy stron. Sprawdź to przed startem, bo paradanych nie da się dopisać po zebraniu danych. Znaczniki stron wymagają zwykle włączenia opcji zapisu czasu albo osobnego eksportu. Czasy pojedynczych pytań i zmiany odpowiedzi wymagają skryptu JavaScript w ankiecie, jeśli narzędzie na to pozwala. Eksport paradanych sprawdź w teście technicznym ankiety: wypełnij ankietę kilka razy z zegarkiem w ręku i porównaj czasy z eksportem.
Paradane są danymi o uczestniku. W informacji o badaniu napisz, co rejestrujesz, np. „czas spędzony na stronach i typ urządzenia” (zob. świadoma zgoda i RODO). Zbieraj tylko to, czego użyjesz w analizie. Adres IP czy szczegółowy identyfikator przeglądarki to dane, które łatwo powiązać z osobą, więc nie zapisuj ich bez potrzeby. Paradane trzymaj pod tym samym identyfikatorem co odpowiedzi, czyli jako dane pseudonimizowane, a nie anonimowe.
Od dziennika zdarzeń do czasu strony
Najbardziej uniwersalny format eksportu to dziennik zdarzeń: jeden wiersz na wejście osoby na stronę ze znacznikiem czasu (w przykładzie w sekundach od startu). Czas strony to różnica kolejnych znaczników. Strona, na której osoba przerwała, ma znacznik wejścia, ale nie ma następnego, więc jej czas jest brakiem danych. Takiego braku nie zastępuj zerem. Po przekształceniu dostajesz dane w formacie długim: osoba × strona, w przykładzie 25 913 wysłanych stron.
Rozkład czasu strony jest silnie prawoskośny. Mediana wyniosła 27.50 s, średnia 36.98 s, a najdłuższy czas 1638.10 s, czyli prawie pół godziny przerwy na jednej stronie. Skośność wyniosła 11.84. Po transformacji logarytmicznej spadła do −0.30. Dlatego czasy porównuj medianami, a modeluj na skali logarytmu. Wtedy współczynnik oznacza procentową zmianę czasu, a pojedyncza przerwa na kawę nie zdominuje wyniku.
Speeding na poziomie strony
Reguła „czas całkowity poniżej 30% mediany” zakłada, że ktoś przeklikuje całą ankietę. Greszki i in. (2015) na danych z dziewięciu ankiet pokazali jednak, że zachowanie tych samych osób zmienia się w trakcie wypełniania. Dlatego obok miary dla całej osoby stosowali miary liczone dla każdej strony. Miara strony porównuje czas z medianą tej strony, więc sama uwzględnia jej długość i trudność. Iloraz „czas / mediana strony” jest bezwymiarowy i porównywalny między stronami (rysunek 1).
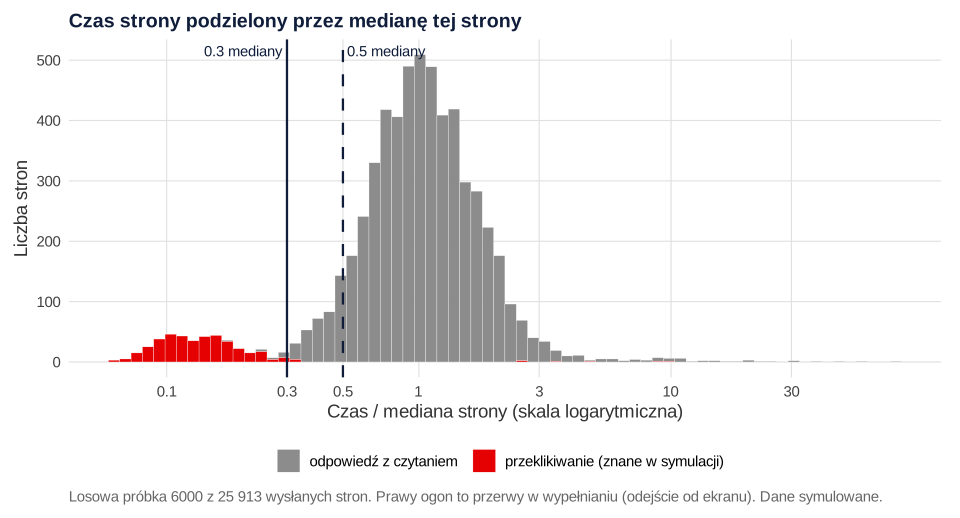
Skąd próg 0.3 lub 0.5 mediany? Nie ma jednej wartości z teorii. Próg ma leżeć w „dolinie” między czasem czytania a czasem kliknięcia, a taką dolinę widać na rozkładzie z pilotażu. Próg 0.3 to strona przeczytana ponad trzy razy szybciej niż przez typową osobę. Przy stronie, której typowy czas to 25–30 s, zostaje kilka sekund – za mało, by przeczytać pytanie i odpowiedzi. Próg 0.5 łapie więcej przeklikujących, ale też szybkich czytelników. W symulacji próg 0.3 oznaczył 1729 stron i wykrył 96.9% epizodów przeklikiwania przy 0.3% fałszywych alarmów. Próg 0.5 oznaczył 3077 stron: wykrył 98.2% epizodów, ale fałszywie oznaczył 5.8% stron wypełnionych normalnie.
Reguła dla całego czasu sprawdziła się dużo gorzej. Ankietę ukończyło 92 respondentów skłonnych do przeklikiwania, którzy przeklikiwali około 60% stron, a resztę czytali. Reguła „czas całkowity < 0.3 mediany” wskazała tylko 7 z nich. Reguła „co najmniej 25% stron poniżej 0.3 mediany strony” wskazała wszystkich 92 i dodatkowo 2 inne osoby. Wyniki te pochodzą z symulacji, w której wiemy, kto przeklikiwał. W prawdziwych danych tej wiedzy nie masz, więc próg i regułę zapisz w planie analizy, zanim zobaczysz wyniki.
Oznaczenie strony nie musi oznaczać usunięcia osoby. Możesz potraktować odpowiedzi z przeklikanych stron jako braki danych i zostawić resztę. Greszki i in. (2015) stwierdzili, że usuwanie zbyt szybkich odpowiedzi lub osób nie zmieniało rozkładów brzegowych, a współczynniki modeli zmieniały się zwykle o około jeden błąd standardowy. Speeding głównie dodawał szum i osłabiał korelacje. Policz więc wyniki w obu wersjach i podaj obie. Kolejność całego czyszczenia danych opisuje osobne hasło.
Czas strony i zmiany odpowiedzi a trudność pytania
Yan i Tourangeau (2008) pokazali, że czas odpowiedzi zależy od liczby słów i zdań w pytaniu, od liczby i rodzaju kategorii odpowiedzi, od miejsca pytania w kwestionariuszu oraz od wieku, wykształcenia i doświadczenia respondenta. Skoro długość tak silnie wyznacza czas, to strona, która trwa dłużej, niż wynika z jej długości, jest kandydatką do poprawy. Na rysunku 2 mediany czasu stron układają się wzdłuż linii długości. Odstaje strona 10: mediana 49.2 s przy 150 słowach. Zmiany odpowiedzi wyniosły na niej 36.9 na 100 wyświetleń wobec 3.3–11.1 na innych stronach z pojedynczymi pytaniami. Siatki mają podobną liczbę zmian, ale zawierają 12 pozycji, a strona 10 tylko dwie.
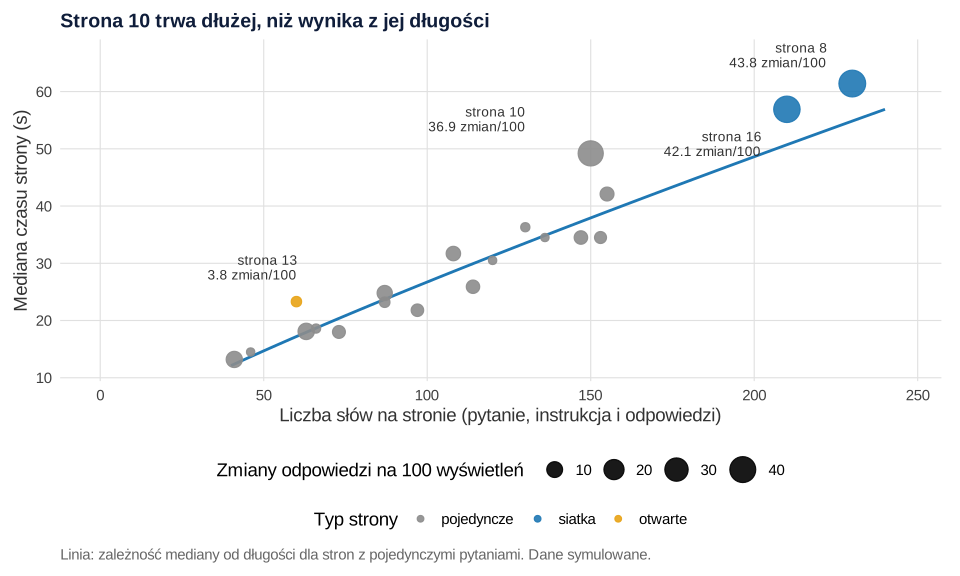
Długi czas i częste zmiany nie mówią, co jest nie tak z pytaniem. Wskazują tylko, które pytanie sprawdzić. Przyczynę ustalisz w pilotażu albo w ocenie eksperckiej kwestionariusza. Tę analizę najlepiej zrobić na danych z pilotażu, kiedy da się jeszcze zmienić brzmienie pytania.
Krzywa przerwań jako analiza przeżycia
Przerwanie ankiety po jej rozpoczęciu to zdarzenie w „czasie” mierzonym numerem strony. Osoby, które ukończyły ankietę, nie przerwały do strony 20, więc są obserwacjami uciętymi, a nie brakami. To dokładnie układ krzywej Kaplana–Meiera. Peytchev (2009) pokazał, że przerwania są szczególnie częste w ankietach internetowych. Przewidywały je cechy kwestionariusza widoczne dopiero po rozpoczęciu, czyli konstrukcja pytań i obciążenie respondenta, a także wykształcenie. Osoby przerywające nie wyglądały na nieuważne. Galesic i Bosnjak (2009) stwierdzili z kolei, że im dłuższa zapowiadana ankieta, tym mniej osób ją zaczynało i kończyło.
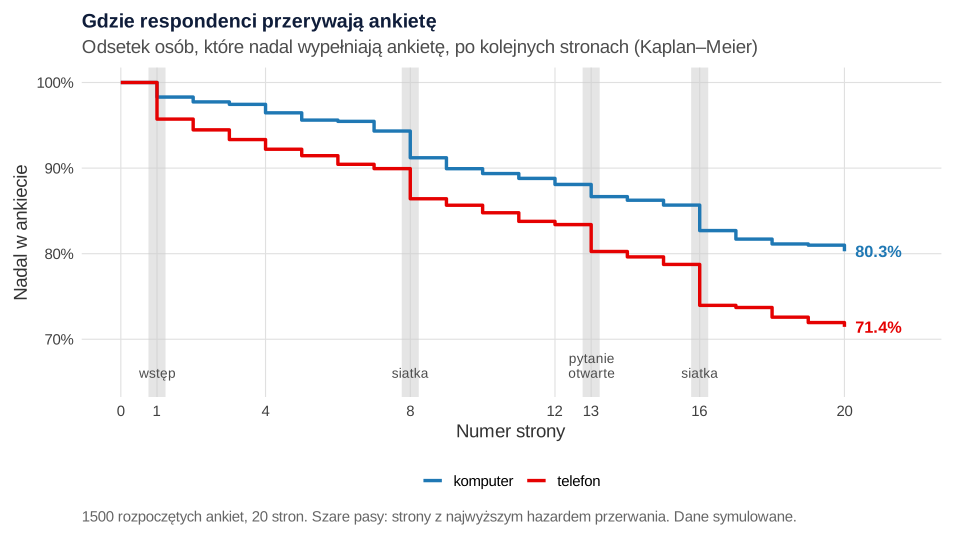
W przykładzie ankietę ukończyło 80.3% osób na komputerze i 71.4% na telefonie, log-rank χ²(1) = 16.2, p < .001. Ważniejsze od ogólnego odsetka jest to, gdzie ludzie odchodzą. Hazard, czyli odsetek przerywających spośród osób, które stronę zobaczyły, wynosił na zwykłych stronach 0.52–1.13%. Na stronie wstępnej wyniósł 3.07%, na pytaniu otwartym 2.73%, a na siatkach 3.62% i 4.80%. Siatkę na stronie 16 warto więc rozbić albo skrócić (zob. pytania matrycowe).
Żeby uwzględnić kilka cech naraz, użyj modelu hazardu dyskretnego. To regresja binarna na danych osoba × strona, w której każda osoba ma wiersze do strony przerwania lub do końca ankiety. Willett i Singer (1993) pokazują, jak taka dyskretna analiza przeżycia odpowiada na pytania o to, czy i kiedy zachodzi zdarzenie. Z łączem cloglog wykładniki współczynników mają sens ilorazów hazardów. Siatka zwiększała hazard przerwania 5.05 raza, pytanie otwarte 3.27 raza, a telefon 1.54 raza, 95% CI [1.25, 1.90]. Pamiętaj, że różnica urządzeń w danych obserwacyjnych łączy to, kto wybiera telefon, z tym, jak telefon zmienia wypełnianie. Projekt ankiety pod telefon omawia wpis ankieta na telefonie, a rozdzielanie selekcji i pomiaru – wpis o efekcie trybu.
Model wielopoziomowy czasu odpowiedzi
Czas strony zależy jednocześnie od osoby (tempo czytania) i od strony (długość, trudność). Każda osoba odpowiada na wiele stron, a każda strona jest wypełniana przez wiele osób, więc to układ efektów skrzyżowanych. Couper i Kreuter (2013) w modelach wielopoziomowych stwierdzili, że czas odpowiedzi zależy od cech pytania, respondenta i ankietera. Yan i Tourangeau (2008) użyli modelu klasyfikacji krzyżowej pytań i respondentów.
Model dopasowano do logarytmu czasu 24 184 stron, po wyłączeniu stron oznaczonych jako speeding. Przeklikiwanie to inny proces, a nie wolniejsze lub szybsze czytanie. Przewidywany czas strony o 100 słowach wyniósł 26.9 s. Dwukrotnie dłuższy tekst wydłużał czas o 86.5%, pytanie otwarte o 43.6%, a telefon o 12.2%. Każde 10 lat wieku dodawało 5.2%, a każde 10 stron dalej w ankiecie skracało czas o 9.4%. Ten ostatni wynik zgadza się z obserwacją, że pytania dalej w kwestionariuszu dostają szybsze odpowiedzi (Galesic i Bosnjak, 2009). Siatka po uwzględnieniu długości nie różniła się istotnie od zwykłej strony (p = .329). Efekty cech stron szacuje się jednak z 20 stron, a nie z 1500 osób, więc ich błędy standardowe są duże.
Wariancje efektów losowych mówią, skąd bierze się zmienność czasu po uwzględnieniu predyktorów. Na osoby przypadło 29.8% wariancji, na strony 3.0%, a reszta to zmienność w obrębie osoby i strony (zob. ICC). Efekt losowy strony wskazał tę samą stronę 10 co rysunek 2: trwała o 27.75% dłużej, niż przewiduje model. Efekt losowy osoby to indeks indywidualnego tempa. W symulacji osoby skłonne do przeklikiwania miały na stronach przeczytanych tempo typowe (średni efekt 0.014 wobec −0.001). Ich problem nie polegał na szybkim czytaniu, tylko na epizodach klikania bez czytania. Dlatego miary strony i indeks tempa uzupełniają się, a nie zastępują.
Jak opisać paradane w artykule
W części o metodzie podaj, jakie paradane zbierano i jak, a w wynikach – reguły i ich skutek. Wzór dla przykładu:
Jeśli paradane pokazały problem z konkretnym pytaniem, napisz to w ograniczeniach badania. Jeśli potrzebujesz pomocy przy takim planie analizy albo przy odpowiedzi recenzentowi, zobacz ofertę dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi i trzeci korzystają z obiektów z pierwszego). Pierwszy zapisuje dziennik zdarzeń do pliku paradane-dziennik.csv (możesz go pobrać tutaj). Potrzebne pakiety: survival i lmerTest (z lme4).
1. Dziennik zdarzeń, czasy stron i speeding
R
# Krok 1. Paradane z ankiety online: dziennik zdarzeń, czasy stron i speeding na poziomie strony (dane symulowane)
set.seed(370)
n <- 1500; J <- 20
typ <- rep("pojedyncze", J); typ[c(8, 16)] <- "siatka"; typ[13] <- "otwarte"
strony <- data.frame(strona = 1:J, typ = typ,
                     slowa = round(runif(J, 40, 160)),
                     pozycje = ifelse(typ == "siatka", 12, ifelse(typ == "otwarte", 1, sample(1:3, J, TRUE))),
                     trudna = 1:J == 10)                      # strona 10: pytanie o zawiłym brzmieniu
strony$slowa[c(8, 10, 13, 16)] <- c(230, 150, 60, 210); strony$pozycje[10] <- 2
v <- rnorm(J, 0, 0.10)                                         # specyfika strony niewyjaśniona długością
osoby <- data.frame(osoba = 1:n, telefon = rbinom(n, 1, 0.55), wiek = round(runif(n, 18, 75)),
                    u = rnorm(n, 0, 0.30), szybki = rbinom(n, 1, 0.08))   # u: indywidualne tempo; szybki: skłonność do przeklikiwania

d <- merge(expand.grid(osoba = 1:n, strona = 1:J), osoby)
d <- merge(d, strony); d <- d[order(d$osoba, d$strona), ]
S <- d$typ == "siatka"; O <- d$typ == "otwarte"
log_t <- log(25) + 0.8 * log(d$slowa / 100) + 0.25 * S + 0.40 * O + 0.35 * d$trudna + 0.006 * (d$wiek - 45) +
  0.12 * d$telefon - 0.015 * (d$strona - 10) + v[d$strona] + d$u + rnorm(nrow(d), 0, 0.35)
d$epizod <- rbinom(nrow(d), 1, ifelse(d$szybki == 1, 0.6, 0.02))  # prawda znana tylko w symulacji
d$czas_prawdziwy <- ifelse(d$epizod == 1, runif(nrow(d), 1.5, 4) + 0.01 * d$slowa, exp(log_t))
pauza <- rbinom(nrow(d), 1, 0.015) == 1                        # odejście od ekranu
d$czas_prawdziwy[pauza] <- d$czas_prawdziwy[pauza] + rexp(sum(pauza), 1 / 240)
# Przerwanie: osoba widzi stronę, ale jej nie wysyła (hazard zależny od typu strony i urządzenia)
h <- plogis(-5.0 + 1.0 * (d$strona == 1) + 1.5 * S + 1.2 * O + 0.5 * d$telefon)
d$przerywa <- rbinom(nrow(d), 1, h)
pierwsze <- tapply(ifelse(d$przerywa == 1, d$strona, Inf), d$osoba, min)   # Inf = ukończył(a)
d$ostatnia <- as.numeric(pierwsze[as.character(d$osoba)])
d <- d[d$strona <= d$ostatnia, ]                               # stron po przerwaniu nie ma w danych
d$zmiany <- rpois(nrow(d), 0.03 * d$pozycje * (1 + 0.3 * d$telefon) * ifelse(d$trudna, 5, 1))

# Tak wygląda eksport paradanych: znacznik czasu wejścia na każdą stronę i zakończenia ankiety
d$t_wejscia <- ave(d$czas_prawdziwy, d$osoba, FUN = function(x) round(c(0, cumsum(x)[-length(x)]), 1))
koniec <- aggregate(czas_prawdziwy ~ osoba, d[is.infinite(d$ostatnia), ], function(x) round(sum(x), 1))
dziennik <- rbind(data.frame(osoba = d$osoba, zdarzenie = paste0("strona_", d$strona), sekunda = d$t_wejscia),
                  data.frame(osoba = koniec$osoba, zdarzenie = "koniec", sekunda = koniec$czas_prawdziwy))
dziennik <- dziennik[order(dziennik$osoba, dziennik$sekunda), ]
write.csv(dziennik, "paradane-dziennik.csv", row.names = FALSE)
print(head(dziennik, 4), row.names = FALSE)

# Czas strony = różnica kolejnych znaczników; strona, na której osoba przerwała, nie ma czasu (NA)
dziennik$czas <- ave(dziennik$sekunda, dziennik$osoba, FUN = function(x) c(diff(x), NA))
dziennik <- subset(dziennik, zdarzenie != "koniec")
dziennik$strona <- as.integer(sub("strona_", "", dziennik$zdarzenie))
p <- merge(dziennik[, c("osoba", "strona", "czas")], d[, c("osoba", "strona", "typ", "slowa", "trudna", "telefon",
                                                          "wiek", "zmiany", "epizod", "szybki")])
p <- p[!is.na(p$czas), ]
cat("Osób:", n, " stron wysłanych:", nrow(p), "\n")

# Rozkład czasu strony: skrajna skośność, logarytm ją usuwa
skos <- function(x) mean((x - mean(x))^3) / sd(x)^3
round(c(mediana_s = median(p$czas), srednia_s = mean(p$czas), max_s = max(p$czas),
        skosnosc = skos(p$czas), skosnosc_log = skos(log(p$czas))), 2)

# Strony: mediana czasu, długość i zmiany odpowiedzi; reszta z log(mediana) ~ log(słowa) wskazuje strony trudne
st <- aggregate(cbind(czas, zmiany) ~ strona + typ + slowa, p, function(x) c(median(x), mean(x)))
st <- data.frame(strona = st$strona, typ = st$typ, slowa = st$slowa, mediana_s = round(st$czas[, 1], 1),
                 zmiany_na_100 = round(100 * st$zmiany[, 2], 1))
st <- st[order(st$strona), ]
st$reszta <- round(resid(lm(log(mediana_s) ~ log(slowa) + typ, st)), 2)
print(st, row.names = FALSE)

# Speeding na poziomie strony: czas < 0.3 (albo 0.5) mediany tej strony; na poziomie osoby: czas całkowity < 0.3 mediany
p$med_strony <- ave(p$czas, p$strona, FUN = median)
cal <- aggregate(czas ~ osoba, p[p$osoba %in% koniec$osoba, ], sum)
osoba_flag <- cal$osoba[cal$czas < 0.3 * median(cal$czas)]
ocena <- function(flag) c(oznaczone_strony = sum(flag), czulosc = mean(flag[p$epizod == 1]),
                          falszywe_alarmy = mean(flag[p$epizod == 0]))
round(rbind(strona_0.3 = ocena(p$czas < 0.3 * p$med_strony), strona_0.5 = ocena(p$czas < 0.5 * p$med_strony),
            osoba_0.3 = ocena(p$osoba %in% osoba_flag)), 3)
# Reguła dla osoby: ukończone ankiety z co najmniej 25% stron poniżej 0.3 mediany strony
udzial <- tapply(p$czas < 0.3 * p$med_strony, p$osoba, mean)[as.character(koniec$osoba)]
sz <- osoby$szybki[koniec$osoba] == 1
c(ukonczyli = nrow(koniec), ukonczyli_proc = round(100 * nrow(koniec) / n, 1), szybcy_ukonczyli = sum(sz), wskazani_czas_calkowity = sum(osoby$szybki[osoba_flag]),
  wskazani_25proc_stron = sum(udzial >= .25 & sz), nieszybcy_wskazani_25proc = sum(udzial >= .25 & !sz))
Wynik w R
 osoba zdarzenie sekunda
     1  strona_1     0.0
     1  strona_2    21.0
     1  strona_3    35.1
     1  strona_4    64.8
Osób: 1500  stron wysłanych: 25913
   mediana_s    srednia_s        max_s     skosnosc skosnosc_log
       27.50        36.98      1638.10        11.84        -0.30
 strona        typ slowa mediana_s zmiany_na_100 reszta
      1 pojedyncze    87      23.2           3.9  -0.02
      2 pojedyncze    46      14.5           3.3   0.06
      3 pojedyncze    63      18.1          11.1   0.01
      4 pojedyncze   155      42.1           7.1   0.08
      5 pojedyncze   130      36.3           3.4   0.08
      6 pojedyncze    41      13.2          10.8   0.06
      7 pojedyncze    87      24.8           9.0   0.05
      8     siatka   230      61.4          43.8   0.00
      9 pojedyncze   108      31.7           7.8   0.10
     10 pojedyncze   150      49.2          36.9   0.26
     11 pojedyncze   120      30.5           3.3  -0.03
     12 pojedyncze   147      34.5           6.5  -0.08
     13    otwarte    60      23.3           3.8   0.00
     14 pojedyncze   153      34.5           4.9  -0.11
     15 pojedyncze   136      34.5           3.3  -0.01
     16     siatka   210      56.9          42.1   0.00
     17 pojedyncze    97      21.8           5.4  -0.18
     18 pojedyncze    73      18.0           5.8  -0.12
     19 pojedyncze    66      18.6           3.4   0.00
     20 pojedyncze   114      25.9           6.4  -0.14
           oznaczone_strony czulosc falszywe_alarmy
strona_0.3             1729   0.969           0.003
strona_0.5             3077   0.982           0.058
osoba_0.3               140   0.051           0.002
                ukonczyli            ukonczyli_proc          szybcy_ukonczyli
                   1134.0                      75.6                      92.0
  wskazani_czas_calkowity     wskazani_25proc_stron nieszybcy_wskazani_25proc
                      7.0                      92.0                       2.0
2. Krzywa przerwań i model hazardu dyskretnego
R
# Krok 2. Krzywa przerwań: Kaplan–Meier po numerze strony i model hazardu dyskretnego (wymaga obiektów z kroku 1)
suppressPackageStartupMessages(library(survival))
# Jedna osoba = jeden wiersz: ostatnia wyświetlona strona i czy przerwała (ukończenie = obserwacja ucięta na stronie 20)
o <- aggregate(strona ~ osoba + telefon + wiek, d, max)
o$przerwanie <- as.integer(o$osoba %in% d$osoba[d$przerywa == 1])
o$urzadzenie <- factor(ifelse(o$telefon == 1, "telefon", "komputer"))
table(o$urzadzenie, o$przerwanie, dnn = c("urządzenie", "przerwanie"))

km <- survfit(Surv(strona, przerwanie) ~ urzadzenie, data = o)
summary(km, times = c(1, 7, 8, 12, 13, 15, 16, 20))
survdiff(Surv(strona, przerwanie) ~ urzadzenie, data = o)

# Hazard na stronie: odsetek przerywających spośród tych, którzy stronę zobaczyli
hz <- aggregate(przerywa ~ strona + typ, d, function(x) c(w_ryzyku = length(x), przerwali = sum(x)))
hz <- data.frame(strona = hz$strona, typ = hz$typ, hz$przerywa)
hz$hazard_proc <- round(100 * hz$przerwali / hz$w_ryzyku, 2)
print(hz[order(hz$strona), ], row.names = FALSE)
write.csv(hz[order(hz$strona), ], "hazard-stron.csv", row.names = FALSE)

# Model hazardu dyskretnego (cloglog) na danych osoba × strona: typ strony, urządzenie, wiek
d$typ_f <- relevel(factor(d$typ), ref = "pojedyncze")
d$wstep <- as.integer(d$strona == 1)
m_h <- glm(przerywa ~ wstep + typ_f + telefon + I((wiek - 45) / 10), family = binomial(link = "cloglog"), data = d)
ci <- confint.default(m_h)
round(exp(cbind(HR = coef(m_h), dolna = ci[, 1], gorna = ci[, 2]))[-1, ], 2)
Wynik w R
          przerwanie
urządzenie   0   1
  komputer 566 139
  telefon  568 227
Call: survfit(formula = Surv(strona, przerwanie) ~ urzadzenie, data = o)

                urzadzenie=komputer
 time n.risk n.event survival std.err lower 95% CI upper 95% CI
    1    705      12    0.983 0.00487        0.973        0.993
    7    673      28    0.943 0.00871        0.926        0.960
    8    665      22    0.912 0.01067        0.891        0.933
   12    626      22    0.881 0.01220        0.857        0.905
   13    621      10    0.867 0.01280        0.842        0.892
   15    608       7    0.857 0.01319        0.831        0.883
   16    604      21    0.827 0.01425        0.799        0.855
   20    571      17    0.803 0.01498        0.774        0.833

                urzadzenie=telefon
 time n.risk n.event survival std.err lower 95% CI upper 95% CI
    1    795      34    0.957 0.00718        0.943        0.971
    7    719      46    0.899 0.01067        0.879        0.921
    8    715      28    0.864 0.01215        0.841        0.888
   12    666      24    0.834 0.01320        0.808        0.860
   13    663      25    0.803 0.01412        0.775        0.831
   15    633      12    0.787 0.01451        0.759        0.816
   16    626      38    0.740 0.01556        0.710        0.771
   20    572      20    0.714 0.01602        0.684        0.747

Call:
survdiff(formula = Surv(strona, przerwanie) ~ urzadzenie, data = o)

                      N Observed Expected (O-E)^2/E (O-E)^2/V
urzadzenie=komputer 705      139      177      8.19      16.2
urzadzenie=telefon  795      227      189      7.68      16.2

 Chisq= 16.2  on 1 degrees of freedom, p= 6e-05
 strona        typ w_ryzyku przerwali hazard_proc
      1 pojedyncze     1500        46        3.07
      2 pojedyncze     1454        14        0.96
      3 pojedyncze     1440        11        0.76
      4 pojedyncze     1429        16        1.12
      5 pojedyncze     1413        12        0.85
      6 pojedyncze     1401         9        0.64
      7 pojedyncze     1392        12        0.86
      8     siatka     1380        50        3.62
      9 pojedyncze     1330        15        1.13
     10 pojedyncze     1315        11        0.84
     11 pojedyncze     1304        12        0.92
     12 pojedyncze     1292         8        0.62
     13    otwarte     1284        35        2.73
     14 pojedyncze     1249         8        0.64
     15 pojedyncze     1241        11        0.89
     16     siatka     1230        59        4.80
     17 pojedyncze     1171         9        0.77
     18 pojedyncze     1162        13        1.12
     19 pojedyncze     1149         6        0.52
     20 pojedyncze     1143         9        0.79
                    HR dolna gorna
wstep             3.66  2.65  5.06
typ_fotwarte      3.27  2.27  4.69
typ_fsiatka       5.05  3.97  6.41
telefon           1.54  1.25  1.90
I((wiek - 45)/10) 1.01  0.95  1.08
3. Model wielopoziomowy logarytmu czasu strony
R
# Krok 3. Model wielopoziomowy logarytmu czasu strony: osoby skrzyżowane ze stronami (wymaga obiektu p z kroku 1)
suppressPackageStartupMessages(library(lmerTest))
q <- subset(p, czas >= 0.3 * med_strony)                    # bez stron oznaczonych jako speeding
q$typ_f <- relevel(factor(q$typ), ref = "pojedyncze")
q$log2_slowa <- log2(q$slowa / 100); q$wiek10 <- (q$wiek - 45) / 10; q$pozycja10 <- (q$strona - 10) / 10
cat("Stron w modelu:", nrow(q), "z", nrow(p), "\n")
m <- lmer(log(czas) ~ log2_slowa + typ_f + telefon + wiek10 + pozycja10 + (1 | osoba) + (1 | strona), data = q)
ef <- summary(m)$coefficients
zm <- 100 * (exp(ef[, "Estimate"]) - 1); zm[1] <- NA          # zmiana czasu w % (bez wyrazu wolnego)
round(cbind(ef[, c("Estimate", "Std. Error", "Pr(>|t|)")], zmiana_proc = zm), 3)
cat("Przewidywany czas strony 100 słów (komputer, 45 lat, strona 10):", round(exp(fixef(m)[[1]]), 1), "s\n")
vc <- as.data.frame(VarCorr(m))[, c("grp", "vcov")]
vc$udzial <- vc$vcov / sum(vc$vcov)
print(transform(vc, vcov = round(vcov, 3), udzial = round(udzial, 3)), row.names = FALSE)

# Reszty stron (efekt losowy strony): która strona trwa dłużej, niż wynika z długości i typu
re_s <- ranef(m)$strona
re_s <- data.frame(strona = rownames(re_s), efekt = re_s[, 1], zmiana_proc = 100 * (exp(re_s[, 1]) - 1))
print(head(re_s[order(-re_s$efekt), ], 3), row.names = FALSE, digits = 3)

# Efekt losowy osoby jako indeks tempa: czy odróżnia osoby skłonne do przeklikiwania?
re_o <- ranef(m)$osoba
tempo <- data.frame(osoba = as.integer(rownames(re_o)), tempo = re_o[, 1])
tempo <- merge(tempo, osoby[, c("osoba", "szybki")])
round(tapply(tempo$tempo, tempo$szybki, mean), 3)
Wynik w R
Stron w modelu: 24184 z 25913
             Estimate Std. Error Pr(>|t|) zmiana_proc
(Intercept)     3.293      0.025    0.000          NA
log2_slowa      0.623      0.039    0.000      86.518
typ_fotwarte    0.362      0.100    0.002      43.636
typ_fsiatka     0.083      0.082    0.329       8.654
telefon         0.115      0.016    0.000      12.239
wiek10          0.051      0.005    0.000       5.245
pozycja10      -0.099      0.037    0.017      -9.438
Przewidywany czas strony 100 słów (komputer, 45 lat, strona 10): 26.9 s
      grp  vcov udzial
    osoba 0.084  0.298
   strona 0.008  0.030
 Residual 0.189  0.672
 strona  efekt zmiana_proc
     10 0.2449       27.75
     19 0.0914        9.57
      9 0.0862        9.00
     0      1
-0.001  0.014
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje pakietów base i stats, w tym glm()) z pakietami survival, lme4 i lmerTest; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Paradane planowane po fakcie. Czasów stron i zmian odpowiedzi nie da się odtworzyć z eksportu, który ich nie zawierał. Włącz zapis przed startem i sprawdź go w teście.
- Średnia czasu zamiast mediany. Jedna przerwa na pół godziny przesuwa średnią, a nie zmienia mediany. W modelach używaj logarytmu czasu.
- Jeden próg dla całej ankiety. Osoba może przeklikać połowę stron i mieć „normalny” czas całkowity. Licz speeding także dla stron, względem mediany każdej z nich.
- Próg dobrany po obejrzeniu wyników. Ustal go z góry i pokaż, czy wnioski zmieniają się bez wykluczeń.
- Ukończenie ankiety traktowane jak brak danych w analizie przerwań. Osoby, które doszły do końca, to obserwacje ucięte. Bez tego hazard na późnych stronach będzie błędny.
- Różnica urządzeń nazwana efektem urządzenia. W danych obserwacyjnych to suma selekcji i pomiaru.
- Zbieranie wszystkiego „na zapas”. Każda zmienna paradanych to dane o osobie, które trzeba opisać w informacji o badaniu i zabezpieczyć.
Najczęstsze pytania
Jakie paradane zapisać w ankiecie internetowej?
Minimum to znacznik czasu wejścia na każdą stronę, znacznik końca, ostatnia wyświetlona strona i typ urządzenia. Pozwalają policzyć czas stron, speeding na poziomie strony i krzywą przerwań. Czasy pojedynczych pytań i zmiany odpowiedzi wymagają zapisu w przeglądarce i warto je dodać, gdy chcesz oceniać trudność pytań.
Jak ustalić próg speedingu dla jednej strony ankiety?
Podziel czas strony przez medianę tej strony i ustal próg w dolinie między czasem czytania a czasem kliknięcia, zwykle 0.3–0.5 mediany. W przykładzie próg 0.3 wykrył 96.9% epizodów przeklikiwania przy 0.3% fałszywych alarmów, a próg 0.5 fałszywie oznaczył 5.8% normalnie wypełnionych stron. Próg zapisz w planie analizy przed obejrzeniem wyników.
Jak analizować przerwania ankiety online?
Potraktuj numer strony jak czas, przerwanie jak zdarzenie, a ukończenie jak obserwację uciętą. Krzywa Kaplana–Meiera pokaże, na których stronach ludzie odchodzą, a model hazardu dyskretnego z łączem cloglog oszacuje ilorazy hazardów dla typu strony i urządzenia, np. HR = 1.54 dla telefonu w przykładzie.
Czy trzeba informować uczestników, że ankieta mierzy czas odpowiedzi?
Tak. Paradane są danymi o uczestniku, więc w informacji o badaniu napisz, co rejestrujesz, np. czas spędzony na stronach i typ urządzenia. Zbieraj tylko to, czego użyjesz w analizie, a paradane przechowuj razem z odpowiedziami jako dane pseudonimizowane.
Dlaczego czas odpowiedzi w ankiecie analizuje się po logarytmowaniu?
Czasy są silnie prawoskośne, bo pojedyncze przerwy trwają minuty. W przykładzie skośność wyniosła 11.84, a po logarytmie −0.30. Na skali logarytmu współczynnik regresji oznacza procentową zmianę czasu, a długie przerwy nie dominują wyniku.
Powiązane hasła
Przeczytaj też
Nieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikAnkieta na telefonie – projekt mobile-first
Strony, siatki, suwaki i pytania otwarte na smartfonie oraz analiza efektu urządzenia i układu ankiety w R z regresją logistyczną.
Czytaj →PoradnikTest techniczny ankiety online
Plan testów dla każdej ścieżki, obowiązkowe pytania, dane testowe ręczne i wygenerowane oraz kontrola eksportu w R według książki kodowej przed wysłaniem linku.
Czytaj →Masz paradane z ankiety i nie wiesz, jak je wykorzystać?
Pomożemy zaplanować zapis paradanych, ustalić reguły speedingu, przeanalizować przerwania i czasy odpowiedzi oraz opisać to tak, żebyś samodzielnie obronił(-a) decyzje przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Couper, M. P., & Kreuter, F. (2013). Using paradata to explore item level response times in surveys. Journal of the Royal Statistical Society Series A: Statistics in Society, 176(1), 271–286. https://doi.org/10.1111/j.1467-985x.2012.01041.x
- Galesic, M., & Bosnjak, M. (2009). Effects of questionnaire length on participation and indicators of response quality in a web survey. Public Opinion Quarterly, 73(2), 349–360. https://doi.org/10.1093/poq/nfp031 ● Otwarty dostęp: pełny tekst
- Greszki, R., Meyer, M., & Schoen, H. (2015). Exploring the effects of removing “too fast” responses and respondents from web surveys. Public Opinion Quarterly, 79(2), 471–503. https://doi.org/10.1093/poq/nfu058
- Heerwegh, D. (2003). Explaining response latencies and changing answers using client-side paradata from a web survey. Social Science Computer Review, 21(3), 360–373. https://doi.org/10.1177/0894439303253985
- Kreuter, F. (Red.). (2013). Improving surveys with paradata: Analytic uses of process information. Wiley. https://doi.org/10.1002/9781118596869
- Peytchev, A. (2009). Survey breakoff. Public Opinion Quarterly, 73(1), 74–97. https://doi.org/10.1093/poq/nfp014
- Willett, J. B., & Singer, J. D. (1993). Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence. Journal of Consulting and Clinical Psychology, 61(6), 952–965. https://doi.org/10.1037/0022-006X.61.6.952
- Yan, T., & Tourangeau, R. (2008). Fast times and easy questions: The effects of age, experience and question complexity on web survey response times. Applied Cognitive Psychology, 22(1), 51–68. https://doi.org/10.1002/acp.1331 ● Otwarty dostęp
Cytowania BibTeX
@article{couper2013using, author={Couper, Mick P. and Kreuter, Frauke}, title={{Using paradata to explore item level response times in surveys}}, journal={Journal of the Royal Statistical Society Series A: Statistics in Society}, year={2013}, volume={176}, number={1}, pages={271--286}, doi={10.1111/j.1467-985x.2012.01041.x}}@article{galesic2009effects, author={Galesic, M. and Bosnjak, M.}, title={{Effects of questionnaire length on participation and indicators of response quality in a web survey}}, journal={Public Opinion Quarterly}, year={2009}, volume={73}, number={2}, pages={349--360}, doi={10.1093/poq/nfp031}}@article{greszki2015exploring, author={Greszki, Robert and Meyer, Marco and Schoen, Harald}, title={{Exploring the effects of removing “too fast” responses and respondents from web surveys}}, journal={Public Opinion Quarterly}, year={2015}, volume={79}, number={2}, pages={471--503}, doi={10.1093/poq/nfu058}}@article{heerwegh2003explaining, author={Heerwegh, Dirk}, title={{Explaining response latencies and changing answers using client-side paradata from a web survey}}, journal={Social Science Computer Review}, year={2003}, volume={21}, number={3}, pages={360--373}, doi={10.1177/0894439303253985}}@book{kreuter2013improving, author={Kreuter, Frauke}, title={{Improving surveys with paradata: Analytic uses of process information}}, year={2013}, publisher={Wiley}, doi={10.1002/9781118596869}}@article{peytchev2009survey, author={Peytchev, Andy}, title={{Survey breakoff}}, journal={Public Opinion Quarterly}, year={2009}, volume={73}, number={1}, pages={74--97}, doi={10.1093/poq/nfp014}}@article{willett1993investigating, author={Willett, John B. and Singer, Judith D.}, title={{Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence}}, journal={Journal of Consulting and Clinical Psychology}, year={1993}, volume={61}, number={6}, pages={952--965}, doi={10.1037/0022-006x.61.6.952}}@article{yan2008fast, author={Yan, Ting and Tourangeau, Roger}, title={{Fast times and easy questions: The effects of age, experience and question complexity on web survey response times}}, journal={Applied Cognitive Psychology}, year={2008}, volume={22}, number={1}, pages={51--68}, doi={10.1002/acp.1331}}