Pytanie matrycowe: wygodne dla badacza, ryzykowne dla danych
Pytanie matrycowe (siatka, tabela, ang. grid albo matrix question) to kilka pozycji z tą samą skalą odpowiedzi ułożonych w wierszach, z kategoriami w kolumnach. To najczęstsza forma podawania pozycji skali Likerta w ankietach internetowych. Ma realne zalety. Zajmuje mało miejsca, instrukcję i etykiety skali czyta się raz, a wszystkie pozycje mają identyczny układ, więc odpowiedzi łatwo porównać. DeBell i in. (2021) w eksperymencie na próbie probabilistycznej stwierdzili, że siatka dawała najszybsze odpowiedzi, a jej trafność kryterialna nie różniła się od formatu pytanie po pytaniu.
Ta sama zwięzłość ma swoją cenę. Gdy wiersze wyglądają jednakowo, najłatwiej zaznaczyć jedną kolumnę od góry do dołu. Krosnick (1991) nazywa taką strategię satysfakcjonowaniem: przy dużym wysiłku poznawczym respondent zadowala się odpowiedzią „wystarczającą”, a jednym z jej przejawów jest brak różnicowania ocen. Definicję i wskaźniki tego zjawiska opisuje hasło straightlining, a procedurę czyszczenia danych wpis nieuważne odpowiedzi w ankietach online. Ten wpis zajmuje się etapem wcześniejszym: kiedy w ogóle używać siatki, jak ją zaprojektować i co jej użycie robi z korelacjami, rzetelnością i strukturą czynnikową.
Co pokazują eksperymenty z formatem
Format pytania łatwo badać eksperymentalnie, bo można go losować. Wyniki układają się w dość spójny obraz.
- Bliskość sugeruje podobieństwo. Tourangeau i in. (2004) pokazali, że respondenci traktują pozycje stojące blisko siebie jako powiązane treściowo. Korelacje między pozycjami baterii były najwyższe, gdy wszystkie stały na jednym ekranie, niższe, gdy rozdzielono je na dwa ekrany albo podano każdą na osobnym ekranie.
- Mniej różnicowania w siatce. Roßmann i in. (2018) rozbijali wymagające poznawczo siatki na pojedyncze pozycje. Czas odpowiedzi się wydłużał, ale brak różnicowania i odpowiedzi niemerytoryczne istotnie spadały. Mavletova i in. (2018) także stwierdzili więcej straightliningu w siatce, nieco większy błąd pomiaru i niższą trafność współbieżną na komputerze i na smartfonie.
- Nie zawsze jest różnica. Liu i Cernat (2018) nie znaleźli różnicy w straightliningu ani w czasie odpowiedzi. Siatka miała jednak więcej braków odpowiedzi, zwłaszcza na urządzeniach mobilnych. Przy mniej niż siedmiu kategoriach modele pomiaru były równoważne, a przy 9 i 11 kategoriach formaty wyraźnie się różniły.
- Projekt siatki ma znaczenie. W eksperymentach Couper i in. (2013) dynamiczne podpowiedzi prowadzące przez tabelę zmniejszały braki danych, a podział dużej tabeli na osobne pytania ograniczał je jeszcze bardziej. Grady i in. (2019) porównali 5, 10 i 20 wierszy na stronie oraz 3, 5 i 7 kolumn. Najlepiej wypadł układ 5 × 5: więcej wierszy zwiększało odsetek przerwań i ocenianą trudność ankiety.
Wniosek praktyczny: krótka, dobrze zrobiona siatka na komputerze jest akceptowalna. Długa siatka i siatka na telefonie to główne źródło problemów. O projektowaniu dla smartfonów piszemy osobno we wpisie ankieta na telefonie – projekt mobile-first.
Przykład: ta sama ankieta w dwóch formatach
Symulujemy eksperyment z losowym przydziałem formatu. Po 800 osób odpowiada na 10 pozycji ze skalą 1–5. Pięć pozycji mierzy zaangażowanie w pracę (z1–z5), pięć wyczerpanie (w1–w5), a prawdziwa korelacja obu cech wynosi −.40. W jednej grupie wszystkie pozycje stoją w jednej siatce na jednym ekranie, w drugiej każda pozycja ma osobny ekran. Założyliśmy dwa mechanizmy znane z eksperymentów opisanych wyżej. Pierwszy to częstsze klikanie w jednej kolumnie: 12% osób w siatce i 4% przy pytaniach pojedynczych. Drugi to wspólne przesunięcie wszystkich wierszy jednego ekranu u danej osoby (SD = 0.30 na skali odpowiedzi ukrytych). Te wartości są ilustracyjne, a nie oszacowane z literatury.
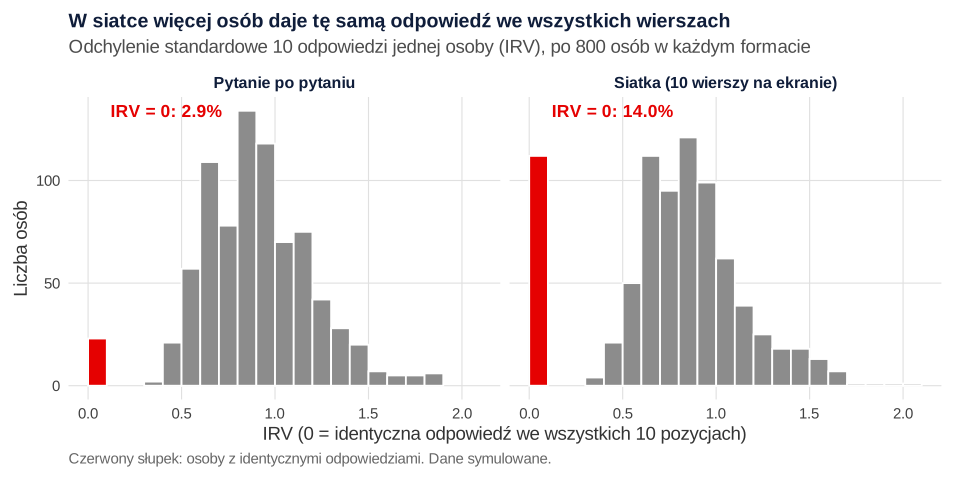
Identyczną odpowiedź we wszystkich 10 pozycjach dało 14.0% osób w siatce i 2.9% przy pytaniach pojedynczych. Iloraz szans wyniósł OR = 5.50, 95% CI [3.47, 8.71], a różnica odsetków 11.1 punktu procentowego, 95% CI [8.5, 13.8] (efekt krańcowy z regresji logistycznej). Średnie odchylenie wewnątrzosobowe (IRV) spadło z 0.90 do 0.77, a średni longstring wzrósł z 3.15 do 3.99 (Rysunek 1). Kim i in. (2019) porównali pięć takich wskaźników, m.in. prosty brak zróżnicowania i odchylenie standardowe odpowiedzi w baterii. W krótkim bloku uważaj z interpretacją: w samych pięciu pozycjach zaangażowania IRV = 0 miało w siatce 16.4% osób, czyli więcej niż w całej dziesięciopozycyjnej siatce.
Wyższa alfa, słabszy pomiar
Straightlining zwykle opisuje się jako problem jakości danych. Ważniejsze jest jednak, co robi z wynikami analiz. Tabela zestawia te same wskaźniki w obu formatach i w siatce po usunięciu osób z identycznymi odpowiedziami. Wiersz „wariancja wyniku z cechy” to kwadrat korelacji wyniku sumarycznego skali zaangażowania z prawdziwą cechą. Tę wartość znamy tylko w symulacji.
| Wskaźnik | Pytania pojedyncze | Siatka | Siatka bez identycznych odpowiedzi |
|---|---|---|---|
| Średnia korelacja pozycji zaangażowania | .460 | .574 | .500 |
| Średnia korelacja pozycji z różnych skal | −.144 | .108 | −.051 |
| Alfa Cronbacha (zaangażowanie) | .811 | .871 | .833 |
| Omega McDonalda (zaangażowanie) | .815 | .873 | .836 |
| Wariancja wyniku z cechy (r²) | .806 | .668 | .703 |
| Korelacja czynników w CFA (prawda: −.40) | −.308 | .168 | −.122 |
| CFI / RMSEA modelu dwuczynnikowego | .992 / .026 | .992 / .033 | .996 / .021 |
W siatce alfa Cronbacha wzrosła z .811 do .871, a omega McDonalda z .815 do .873. Jednocześnie udział wariancji cechy w wyniku spadł z .806 do .668. Wyższa rzetelność nie oznaczała lepszego pomiaru. Część wspólnej wariancji pozycji pochodzi z formatu, a nie z zaangażowania. Alfa i omega nie odróżniają tych dwóch źródeł, bo obie są zgodnością pozycji.
Jeszcze wyraźniej widać to w związku między skalami (Rysunek 2). Przy pytaniach pojedynczych CFA dała korelację czynników −.308, a w siatce .168. Znak się odwrócił. Osoba, która zaznacza „4” we wszystkich wierszach, deklaruje jednocześnie wysokie zaangażowanie i wysokie wyczerpanie. To samo dzieje się w każdej analizie łączącej skale z jednej siatki. Mechanizm przypomina wspólną wariancję metody, ale tu źródłem jest sam układ ekranu. Dopasowanie modelu tego nie zdradziło: CFI = .992 i RMSEA = .033, czyli tyle samo co przy pytaniach pojedynczych. Test inwariancji metrycznej między formatami był na granicy istotności: Δχ²(8) = 15.49, p = .050.
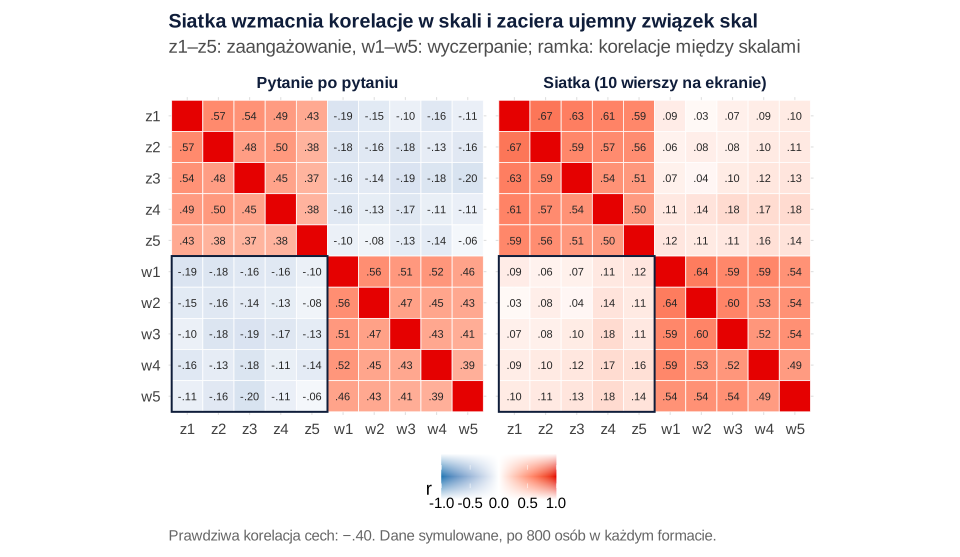
Usunięcie osób z identycznymi odpowiedziami (112 osób) pomogło tylko częściowo. Korelacja czynników wróciła do −.122, ale nie do −.308, bo wspólne przesunięcie w siatce dotyczy wszystkich respondentów, a nie tylko tych z IRV = 0. Czyszczenie danych nie naprawi więc formatu.
Kiedy straightlining zawyża, a kiedy zaniża rzetelność
Kierunek obciążenia zależy od tego, czy skala ma pozycje odwrócone. Sprawdziliśmy to symulacją Monte Carlo: 300 prób po 800 osób dla każdego odsetka straightliningu od 0% do 30%, bez wspólnego przesunięcia, żeby pokazać sam straightlining (Rysunek 3).
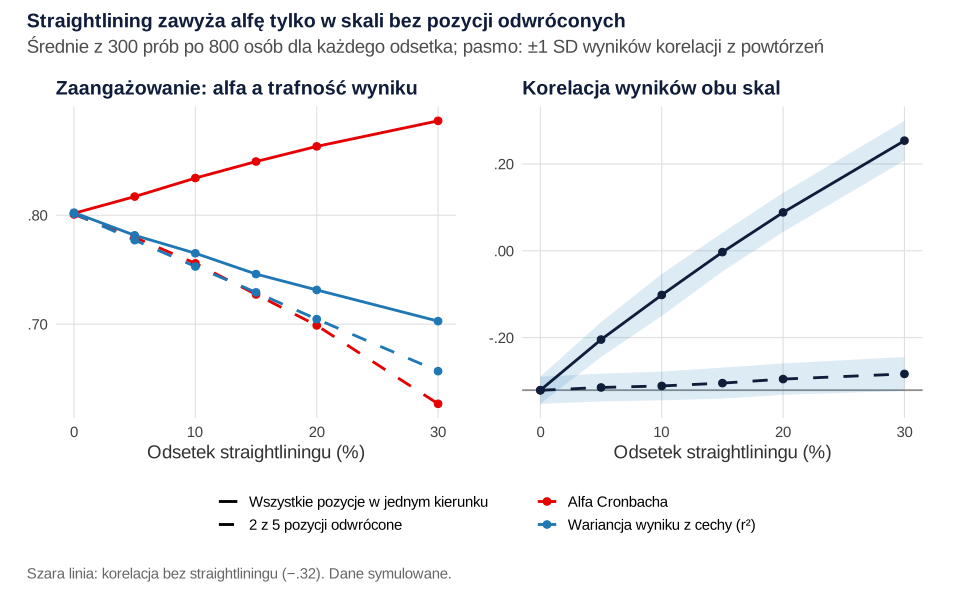
Gdy wszystkie pozycje mają ten sam kierunek, alfa rośnie z .802 do .887 przy 30% straightliningu, a udział wariancji cechy spada do .703. Korelacja wyników skal przechodzi z −.321 do +.254; przy 15% wynosi −.003. Wartość −.321 przy braku straightliningu jest słabsza niż −.40 z powodu zwykłej atenuacji przez błąd pomiaru. Gdy 2 z 5 pozycji są odwrócone, straightlining po rekodowaniu przestaje być zgodny. Alfa spada wtedy do .627, a korelacja skal zmienia się niewiele (do −.284). Tę drugą sytuację opisuje wpis o nieuważnych odpowiedziach, gdzie nieuwaga obniżała alfę. Obie obserwacje są prawdziwe, tylko dotyczą różnych skal. Pozycje odwrócone nie usuwają problemu, bo mają własne koszty (zob. czynnik metody i pozycje odwrócone w CFA). Zmieniają jednak kierunek obciążenia i ułatwiają wykrycie straightliningu.
Jak zaprojektować siatkę albo czym ją zastąpić
Do wyboru masz kilka formatów. Żaden nie jest najlepszy w każdej ankiecie.
| Format | Zalety | Ryzyka | Kiedy wybrać |
|---|---|---|---|
| Siatka na jednym ekranie | Najkrótszy czas, łatwe porównanie pozycji | Straightlining, sztucznie podobne odpowiedzi, braki na telefonie | Krótkie baterie (do ok. 5 wierszy) wypełniane głównie na komputerze |
| Kilka krótkich siatek na osobnych stronach | Kompromis między czasem a jakością | Wspólne przesunięcie w obrębie strony nadal działa | Dłuższe skale; pozycje jednej skali rozdziel między strony |
| Pytanie po pytaniu (pionowo, na osobnych ekranach albo jedno pod drugim) | Mniej braku różnicowania, dobry na telefonie | Dłuższy czas, więcej kliknięć | Ankiety mobilne, pozycje wymagające namysłu, skale o kluczowym znaczeniu dla hipotez |
| Format rozgałęziony (najpierw kierunek, potem siła) | Prostsze pojedyncze decyzje | Najdłuższy czas, słabsza trafność kryterialna (DeBell i in., 2021) | W ankietach internetowych raczej nie |
Jeśli zostajesz przy siatce, sprawdź siedem rzeczy:
- Liczba wierszy. Około pięciu na stronę (Grady i in., 2019). Dłuższą skalę podziel na kilka stron, a zbędne pozycje usuń: każda kolejna zwiększa obciążenie respondenta.
- Liczba kolumn. Około pięciu kategorii. Przy 9–11 kolumnach siatka przestała być równoważna z pytaniami pojedynczymi (Liu i Cernat, 2018). Dobór liczby kategorii omawia wpis ile stopni skali Likerta wybrać.
- Etykiety. Każda kolumna z etykietą słowną, opcje niemerytoryczne („nie wiem”) oddzielone odstępem albo linią. Tourangeau i in. (2004) pokazali, że bez takiego oddzielenia wizualny środek skali przesuwa odpowiedzi.
- Kolejność pozycji. Losuj kolejność wierszy dla każdej osoby. Efekt kolejności i zmęczenie rozłożą się wtedy równo między pozycje. Zapisz kolejność w danych, bo longstring liczy się w kolejności prezentacji.
- Telefon. Sprawdź, jak siatka wygląda na smartfonie. Część narzędzi automatycznie zamienia ją na pytania pojedyncze. Revilla i Couper (2018) pokazali jednak, że w formacie pytanie po pytaniu stale widoczny przycisk „dalej” zwiększał braki na smartfonach.
- Mieszanie skal. Nie umieszczaj w jednej siatce pozycji różnych skal, które będziesz potem korelować. Jak pokazuje przykład, wspólny ekran przenosi wariancję formatu na korelacje między skalami.
- Kontrola jakości. W długiej siatce dodaj pytanie kontrolne, zapisz czasy stron (paradane) i z góry ustal regułę wykluczeń.
Gdy nie wiesz, który format wybrać dla kluczowej skali, sprawdź to w pilotażu albo w małym eksperymencie split-ballot: wylosuj format i porównaj wskaźniki z tego wpisu.
Jak opisać format i kontrolę jakości w artykule
W części o narzędziu podaj format każdej skali, liczbę pozycji na stronie, losowanie kolejności i zachowanie na telefonie. W wynikach podaj odsetek identycznych odpowiedzi i jego wpływ na wyniki (analiza wrażliwości).
Jeśli planujesz eksperyment z formatem albo recenzent pyta, czy wysoka rzetelność nie wynika z układu kwestionariusza, możemy wspólnie przygotować analizę wrażliwości w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi i trzeci korzystają z funkcji i obiektów z pierwszego). Pierwszy zapisuje odpowiedzi obu grup do pliku pytania-matrycowe.csv (możesz go pobrać tutaj). Całość liczy się kilka sekund. Potrzebne pakiety: marginaleffects, psych i lavaan.
1. Eksperyment z formatem i wskaźniki straightliningu
R
# Krok 1. Eksperyment: siatka 10 pozycji na jednym ekranie vs pytanie po pytaniu (dane symulowane)
# Dwie skale po 5 pozycji (zaangażowanie w pracę i wyczerpanie), odpowiedzi 1–5, korelacja cech −.40.
suppressPackageStartupMessages(library(marginaleffects))

generuj <- function(n, siatka, p_sl, sd_wspolne = 0.30, odwrocone = integer(0)) {
  r <- -0.40
  z <- rnorm(n); w <- r * z + sqrt(1 - r^2) * rnorm(n)        # cechy: zaangażowanie (z) i wyczerpanie (w)
  lam <- c(0.80, 0.75, 0.70, 0.65, 0.60)
  ystar <- cbind(outer(z, lam), outer(w, lam)) + sapply(rep(lam, 2), function(l) rnorm(n, 0, sqrt(1 - l^2)))
  kier <- ifelse(1:10 %in% odwrocone, -1, 1)                 # pozycje odwrócone: treść przeciwna do skali
  surowe_lat <- sweep(ystar, 2, kier, "*")
  # W siatce: wspólne przesunięcie wszystkich wierszy jednego ekranu („to, co blisko, jest podobne”)
  if (siatka) surowe_lat <- surowe_lat + rnorm(n, 0, sd_wspolne)
  progi <- c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf)
  surowe <- matrix(as.integer(cut(surowe_lat, progi)), n)    # to, co respondent zaznacza (1–5)
  sl <- rbinom(n, 1, p_sl) == 1                              # „klikanie w jednej kolumnie”
  surowe[sl, ] <- surowe[sl, 1]                              # cała siatka = odpowiedź z pierwszego wiersza
  x <- surowe; x[, kier == -1] <- 6 - x[, kier == -1]        # rekodowanie pozycji odwróconych
  colnames(surowe) <- colnames(x) <- c(paste0("z", 1:5), paste0("w", 1:5))
  list(x = x, surowe = surowe, z = z, w = w, sl = sl)
}
irv <- function(m) apply(m, 1, sd)                                     # odchylenie wewnątrzosobowe
longstring <- function(m) apply(m, 1, function(v) max(rle(v)$lengths))  # najdłuższa seria identycznych

set.seed(3641)
n <- 800                                    # po 800 osób w każdym formacie (losowy przydział)
S <- generuj(n, siatka = TRUE,  p_sl = 0.12)
P <- generuj(n, siatka = FALSE, p_sl = 0.04)
d <- data.frame(format = rep(c("siatka", "pojedyncze"), each = n), rbind(S$surowe, P$surowe))
d$identyczne <- as.integer(apply(d[, 2:11], 1, function(v) all(v == v[1])))
d$irv <- irv(as.matrix(d[, 2:11])); d$longstring <- longstring(as.matrix(d[, 2:11]))
write.csv(d[, 1:11], "pytania-matrycowe.csv", row.names = FALSE)

# Wskaźniki jakości odpowiedzi w obu formatach
aggregate(cbind(identyczne, irv, longstring) ~ format, data = d, FUN = function(v) round(mean(v), 3))
cat("Odsetek IRV = 0 w siatce dla samego zaangażowania (5 pozycji):",
    round(mean(irv(S$surowe[, 1:5]) == 0), 3), "\n")

# Różnica odsetka identycznych odpowiedzi: regresja logistyczna i efekt krańcowy w punktach procentowych
d$format <- factor(d$format, levels = c("pojedyncze", "siatka"))
m <- glm(identyczne ~ format, family = binomial, data = d)
round(exp(cbind(OR = coef(m), confint.default(m)))[2, ], 2)
avg_comparisons(m, variables = "format")
Wynik w R
      format identyczne   irv longstring
1 pojedyncze      0.029 0.898      3.154
2     siatka      0.140 0.765      3.989
Odsetek IRV = 0 w siatce dla samego zaangażowania (5 pozycji): 0.164
    OR  2.5 % 97.5 %
  5.50   3.47   8.71

 Estimate Std. Error    z Pr(>|z|)    S  2.5 % 97.5 %
    0.111     0.0136 8.17   <0.001 51.5 0.0846  0.138

Term: format
Type: response
Comparison: siatka - pojedyncze
2. Korelacje, alfa, omega, CFA i inwariancja
R
# Krok 2. Jak format zmienia korelacje, alfę, omegę i strukturę czynnikową (obiekty z kroku 1)
suppressPackageStartupMessages({library(psych); library(lavaan)})
omega1 <- function(x) {                       # omega z jednoczynnikowej CFA: (Σλ)² / ((Σλ)² + Σθ)
  f <- cfa(paste("f =~", paste(colnames(x), collapse = " + ")), data = as.data.frame(x), std.lv = TRUE)
  pe <- parameterEstimates(f); l <- pe$est[pe$op == "=~"]; th <- pe$est[pe$op == "~~" & pe$lhs != "f"]
  sum(l)^2 / (sum(l)^2 + sum(th))
}
sr_r <- function(R, i, j = i) { b <- R[i, j]; mean(if (identical(i, j)) b[upper.tri(b)] else b) }
model2 <- "zaang =~ z1 + z2 + z3 + z4 + z5
           wycz  =~ w1 + w2 + w3 + w4 + w5"
podsumuj <- function(G, wybor = rep(TRUE, length(G$z))) {
  x <- G$x[wybor, ]; z <- G$z[wybor]; w <- G$w[wybor]
  R <- cor(x); Z <- rowSums(x[, 1:5]); W <- rowSums(x[, 6:10])
  f2 <- cfa(model2, data = as.data.frame(x), std.lv = TRUE)
  c(n = nrow(x),
    r_wewn_zaang = sr_r(R, 1:5), r_wewn_wycz = sr_r(R, 6:10), r_miedzy = sr_r(R, 1:5, 6:10),
    alfa_zaang = psych::alpha(x[, 1:5], warnings = FALSE)$total$raw_alpha, omega_zaang = omega1(x[, 1:5]),
    r2_wynik_cecha = cor(Z, z)^2,            # ile wariancji wyniku pochodzi z mierzonej cechy (znane tylko w symulacji)
    r_sum_Z_W = cor(Z, W),
    r_czynniki_cfa = lavInspect(f2, "std")$psi["zaang", "wycz"],
    cfi = fitMeasures(f2, "cfi"), rmsea = fitMeasures(f2, "rmsea"))
}
tab <- rbind(siatka = podsumuj(S), pojedyncze = podsumuj(P),
             siatka_bez_identycznych = podsumuj(S, !apply(S$surowe, 1, function(v) all(v == v[1]))))
print(round(tab, 3))
cat("Prawdziwa korelacja cech w próbie (siatka, pojedyncze):", round(cor(S$z, S$w), 3), round(cor(P$z, P$w), 3), "\n")

# Inwariancja metryczna między formatami (wielogrupowa CFA, grupa = format)
dd <- rbind(data.frame(format = "siatka", S$x), data.frame(format = "pojedyncze", P$x))
fk <- cfa(model2, data = dd, group = "format")
fm <- cfa(model2, data = dd, group = "format", group.equal = "loadings")
lavTestLRT(fk, fm)
Wynik w R
                          n r_wewn_zaang r_wewn_wycz r_miedzy alfa_zaang
siatka                  800        0.574       0.559    0.108      0.871
pojedyncze              800        0.460       0.462   -0.144      0.811
siatka_bez_identycznych 688        0.500       0.480   -0.051      0.833
                        omega_zaang r2_wynik_cecha r_sum_Z_W r_czynniki_cfa
siatka                        0.873          0.668     0.165          0.168
pojedyncze                    0.815          0.806    -0.254         -0.308
siatka_bez_identycznych       0.836          0.703    -0.086         -0.122
                        cfi.cfi rmsea.rmsea
siatka                    0.992       0.033
pojedyncze                0.992       0.026
siatka_bez_identycznych   0.996       0.021
Prawdziwa korelacja cech w próbie (siatka, pojedyncze): -0.408 -0.373

Chi-Squared Difference Test

   Df   AIC   BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
fk 68 40381 40715 116.16
fm 76 40381 40671 131.65     15.492 0.034214       8    0.05026 .
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
3. Monte Carlo: odsetek straightliningu i pozycje odwrócone
R
# Krok 3. Monte Carlo: odsetek „klikających w jednej kolumnie” a alfa, trafność wyniku i korelacja skal
# (funkcja generuj() z kroku 1; tu bez wspólnego przesunięcia, żeby pokazać sam straightlining)
alfa <- function(x) { k <- ncol(x); k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }
jedna <- function(p_sl, odwr) {
  G <- generuj(800, siatka = FALSE, p_sl = p_sl, odwrocone = odwr)
  Z <- rowSums(G$x[, 1:5]); W <- rowSums(G$x[, 6:10])
  c(alfa = alfa(G$x[, 1:5]), r2_cecha = cor(Z, G$z)^2, r_Z_W = cor(Z, W))
}
siatka_war <- expand.grid(p_sl = c(0, 0.05, 0.10, 0.15, 0.20, 0.30),
                          klucz = c("bez odwróconych", "2 z 5 odwrócone"), stringsAsFactors = FALSE)
set.seed(3643)
R <- 300
wyn <- do.call(rbind, lapply(seq_len(nrow(siatka_war)), function(i) {
  odwr <- if (siatka_war$klucz[i] == "bez odwróconych") integer(0) else c(4, 5, 9, 10)
  m <- t(replicate(R, jedna(siatka_war$p_sl[i], odwr)))
  data.frame(siatka_war[i, ], srednia = t(colMeans(m)), sd = t(apply(m, 2, sd)))
}))
write.csv(wyn, "mc-straightlining.csv", row.names = FALSE)
tabela <- with(wyn, data.frame(klucz, p_sl, alfa = round(srednia.alfa, 3), sd_alfa = round(sd.alfa, 3),
                                r2_cecha = round(srednia.r2_cecha, 3), r_Z_W = round(srednia.r_Z_W, 3),
                                sd_r_Z_W = round(sd.r_Z_W, 3)))
print(tabela, row.names = FALSE)
cat("Błąd Monte Carlo średniej r_Z_W (maksymalny):", round(max(wyn$sd.r_Z_W) / sqrt(R), 4), "\n")
Wynik w R
           klucz p_sl  alfa sd_alfa r2_cecha  r_Z_W sd_r_Z_W
 bez odwróconych 0.00 0.802   0.011    0.802 -0.321    0.031
 bez odwróconych 0.05 0.817   0.010    0.782 -0.205    0.040
 bez odwróconych 0.10 0.834   0.010    0.765 -0.102    0.048
 bez odwróconych 0.15 0.849   0.009    0.746 -0.003    0.045
 bez odwróconych 0.20 0.863   0.008    0.731  0.088    0.045
 bez odwróconych 0.30 0.887   0.007    0.703  0.254    0.046
 2 z 5 odwrócone 0.00 0.801   0.011    0.801 -0.321    0.031
 2 z 5 odwrócone 0.05 0.780   0.013    0.777 -0.315    0.032
 2 z 5 odwrócone 0.10 0.756   0.016    0.753 -0.311    0.033
 2 z 5 odwrócone 0.15 0.727   0.019    0.729 -0.305    0.036
 2 z 5 odwrócone 0.20 0.699   0.021    0.705 -0.296    0.036
 2 z 5 odwrócone 0.30 0.627   0.031    0.657 -0.284    0.039
Błąd Monte Carlo średniej r_Z_W (maksymalny): 0.0028
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje glm(), cor() i replicate() z pakietów stats i base) z pakietami marginaleffects, psych i lavaan; rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Wysoka alfa jako dowód dobrego pomiaru. W siatce część zgodności pozycji pochodzi z formatu. Alfa była wyższa, a wynik słabiej mierzył cechę.
- Kilka skal w jednej siatce, potem korelacje między nimi. Straightlining i wspólne przesunięcie podnoszą korelacje między skalami, a przy przeciwnych cechach mogą odwrócić znak.
- Dobre dopasowanie CFA jako dowód braku problemu. W przykładzie CFI był taki sam w obu formatach.
- Usuwanie osób z IRV = 0 jako pełna naprawa. Usuwa tylko skrajny przypadek, a wpływ formatu dotyczy wszystkich respondentów.
- Siatka 20 × 7 „bo tak było w oryginale”. Oryginalny kwestionariusz papierowy nie przesądza o formacie w ankiecie internetowej. Podziel go na krótkie bloki.
- Brak informacji o formacie w artykule. Bez niej czytelnik nie oceni, czy rzetelność i korelacje są porównywalne z innymi badaniami.
Najczęstsze pytania
Czy pytania w siatce zawyżają rzetelność skali?
Mogą. Gdy część osób zaznacza jedną kolumnę, a pozycje mają ten sam kierunek, rośnie zgodność pozycji, więc rośnie alfa i omega. W symulacji alfa wzrosła z .811 do .871, a jednocześnie udział wariancji mierzonej cechy w wyniku spadł z .806 do .668. Przy pozycjach odwróconych obciążenie działa odwrotnie i alfa spada.
Ile pozycji może mieć pytanie matrycowe w ankiecie internetowej?
W eksperymencie Grady i in. (2019) najlepiej wypadł układ około pięciu wierszy na stronę i pięciu kategorii odpowiedzi; więcej wierszy zwiększało odsetek przerwań i ocenianą trudność ankiety. Dłuższą skalę podziel na kilka stron albo podaj pytanie po pytaniu.
Siatka czy pytanie po pytaniu na telefonie?
Na smartfonie zwykle lepsze są pytania pojedyncze, bo szeroka tabela źle się wyświetla, a w siatkach na urządzeniach mobilnych bywa więcej braków odpowiedzi (Liu i Cernat, 2018). Sprawdź jednak układ w swoim narzędziu: stale widoczny przycisk „dalej” w formacie pytanie po pytaniu też zwiększał braki (Revilla i Couper, 2018).
Czy można umieścić dwie różne skale w jednej siatce?
Lepiej tego unikać, jeśli będziesz korelować wyniki tych skal. Straightlining i podobne odpowiedzi w wierszach jednego ekranu podnoszą korelacje między skalami. W przykładzie ujemna korelacja zaangażowania i wyczerpania (−.308 przy pytaniach pojedynczych) w siatce zmieniła się w dodatnią (.168).
Czy usunięcie osób ze straightliningiem naprawia dane z siatki?
Tylko częściowo. Usuwa osoby z identycznymi odpowiedziami, ale wpływ formatu na pozostałych respondentów zostaje. W przykładzie po usunięciu 112 osób korelacja czynników wyniosła −.122, a nie −.308 jak przy pytaniach pojedynczych. Format lepiej dobrać przed badaniem, a wykluczenia traktować jako analizę wrażliwości.
Powiązane hasła
Przeczytaj też
Nieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikAnkieta na telefonie – projekt mobile-first
Strony, siatki, suwaki i pytania otwarte na smartfonie oraz analiza efektu urządzenia i układu ankiety w R z regresją logistyczną.
Czytaj →PoradnikCzynnik metody i pozycje odwrócone w CFA
Potakiwanie, nieuwaga czy sformułowanie? Pięć modeli CFA w lavaan, symulacja wyboru modelu i wpływ czynnika metody na omegę skali.
Czytaj →Masz skale podane w siatce i zbyt piękną rzetelność?
Pomożemy ocenić wpływ formatu na alfę i korelacje, przygotować analizę wrażliwości albo zaplanować eksperyment z formatem oraz opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Couper, M. P., Tourangeau, R., Conrad, F. G., & Zhang, C. (2013). The design of grids in web surveys. Social Science Computer Review, 31(3), 322–345. https://doi.org/10.1177/0894439312469865 ● Otwarty dostęp: pełny tekst
- DeBell, M., Wilson, C., Jackman, S., & Figueroa, L. (2021). Optimal response formats for online surveys: Branch, grid, or single item? Journal of Survey Statistics and Methodology, 9(1), 1–24. https://doi.org/10.1093/jssam/smz039
- Grady, R. H., Greenspan, R. L., & Liu, M. (2019). What is the best size for matrix-style questions in online surveys? Social Science Computer Review, 37(3), 435–445. https://doi.org/10.1177/0894439318773733
- Kim, Y., Dykema, J., Stevenson, J., Black, P., & Moberg, D. P. (2019). Straightlining: Overview of measurement, comparison of indicators, and effects in mail–web mixed-mode surveys. Social Science Computer Review, 37(2), 214–233. https://doi.org/10.1177/0894439317752406
- Krosnick, J. A. (1991). Response strategies for coping with the cognitive demands of attitude measures in surveys. Applied Cognitive Psychology, 5(3), 213–236. https://doi.org/10.1002/acp.2350050305
- Liu, M., & Cernat, A. (2018). Item-by-item versus matrix questions: A web survey experiment. Social Science Computer Review, 36(6), 690–706. https://doi.org/10.1177/0894439316674459 ● Otwarty dostęp
- Mavletova, A., Couper, M. P., & Lebedev, D. (2018). Grid and item-by-item formats in PC and mobile web surveys. Social Science Computer Review, 36(6), 647–668. https://doi.org/10.1177/0894439317735307
- Revilla, M., & Couper, M. P. (2018). Comparing grids with vertical and horizontal item-by-item formats for PCs and smartphones. Social Science Computer Review, 36(3), 349–368. https://doi.org/10.1177/0894439317715626
- Roßmann, J., Gummer, T., & Silber, H. (2018). Mitigating satisficing in cognitively demanding grid questions: Evidence from two web-based experiments. Journal of Survey Statistics and Methodology, 6(3), 376–400. https://doi.org/10.1093/jssam/smx020 ● Otwarty dostęp
- Tourangeau, R., Couper, M. P., & Conrad, F. (2004). Spacing, position, and order: Interpretive heuristics for visual features of survey questions. Public Opinion Quarterly, 68(3), 368–393. https://doi.org/10.1093/poq/nfh035
Cytowania BibTeX
@article{couper2013design, author={Couper, Mick P. and Tourangeau, Roger and Conrad, Frederick G. and Zhang, Chan}, title={{The design of grids in web surveys}}, journal={Social Science Computer Review}, year={2013}, volume={31}, number={3}, pages={322--345}, doi={10.1177/0894439312469865}}@article{debell2021optimal, author={DeBell, Matthew and Wilson, Catherine and Jackman, Simon and Figueroa, Lucila}, title={{Optimal response formats for online surveys: Branch, grid, or single item?}}, journal={Journal of Survey Statistics and Methodology}, year={2021}, volume={9}, number={1}, pages={1--24}, doi={10.1093/jssam/smz039}}@article{grady2019best, author={Grady, Rebecca Hofstein and Greenspan, Rachel Leigh and Liu, Mingnan}, title={{What is the best size for matrix-style questions in online surveys?}}, journal={Social Science Computer Review}, year={2019}, volume={37}, number={3}, pages={435--445}, doi={10.1177/0894439318773733}}@article{kim2019straightlining, author={Kim, Yujin and Dykema, Jennifer and Stevenson, John and Black, Penny and Moberg, D. Paul}, title={{Straightlining: Overview of measurement, comparison of indicators, and effects in mail–web mixed-mode surveys}}, journal={Social Science Computer Review}, year={2019}, volume={37}, number={2}, pages={214--233}, doi={10.1177/0894439317752406}}@article{krosnick1991response, author={Krosnick, Jon A.}, title={{Response strategies for coping with the cognitive demands of attitude measures in surveys}}, journal={Applied Cognitive Psychology}, year={1991}, volume={5}, number={3}, pages={213--236}, doi={10.1002/acp.2350050305}}@article{liu2018item, author={Liu, Mingnan and Cernat, Alexandru}, title={{Item-by-item versus matrix questions: A web survey experiment}}, journal={Social Science Computer Review}, year={2018}, volume={36}, number={6}, pages={690--706}, doi={10.1177/0894439316674459}}@article{mavletova2018grid, author={Mavletova, Aigul and Couper, Mick P. and Lebedev, Daniil}, title={{Grid and item-by-item formats in PC and mobile web surveys}}, journal={Social Science Computer Review}, year={2018}, volume={36}, number={6}, pages={647--668}, doi={10.1177/0894439317735307}}@article{revilla2018comparing, author={Revilla, Melanie and Couper, Mick P.}, title={{Comparing grids with vertical and horizontal item-by-item formats for PCs and smartphones}}, journal={Social Science Computer Review}, year={2018}, volume={36}, number={3}, pages={349--368}, doi={10.1177/0894439317715626}}@article{rossmann2018mitigating, author={Roßmann, Joss and Gummer, Tobias and Silber, Henning}, title={{Mitigating satisficing in cognitively demanding grid questions: Evidence from two web-based experiments}}, journal={Journal of Survey Statistics and Methodology}, year={2018}, volume={6}, number={3}, pages={376--400}, doi={10.1093/jssam/smx020}}@article{tourangeau2004spacing, author={Tourangeau, Roger and Couper, Mick P. and Conrad, Frederick}, title={{Spacing, position, and order: Interpretive heuristics for visual features of survey questions}}, journal={Public Opinion Quarterly}, year={2004}, volume={68}, number={3}, pages={368--393}, doi={10.1093/poq/nfh035}}