Skąd się biorą „dwa czynniki” w skali z pozycjami odwróconymi?
Walidujesz skalę, w której połowa pozycji jest sformułowana odwrotnie. Po rekodowaniu model jednoczynnikowy pasuje słabo, a model z czynnikiem „pozytywnym” i „negatywnym” – świetnie. Kusi, by opisać dwa wymiary konstruktu. Marsh (1996) sprawdził tę interpretację w skali samooceny Rosenberga. Lepiej opisywał ją jeden czynnik z efektami metody pozycji negatywnych niż dwa odrębne czynniki. Jak liczyć wynik skali Rosenberga i jak wygląda tam ten spór, pokazuje wpis o skali samooceny Rosenberga.
Weijters i in. (2013) wskazują trzy źródła błędu związanego z pozycjami odwróconymi: potakiwanie, nieuważne odpowiadanie i efekt potwierdzania. Do tego dochodzi trudność z przeczeniami. Wystarczy niewielka grupa osób, które nie zauważają kierunku pozycji. Schmitt i Stuits (1985) pokazali, że już 10% takich respondentów daje wyraźny czynnik pozycji negatywnych. Woods (2006) stwierdziła, że przy około 10% nieuważnych odrzucenie modelu jednoczynnikowego dla skali jednowymiarowej jest prawdopodobne. Wykrywanie takich osób opisuje wpis nieuważne odpowiedzi w ankietach online. Tu zajmiemy się tym, jak modelować ich ślad w CFA i co wybór modelu zmienia we wnioskach.
Przykład. 600 dorosłych (dane symulowane, set.seed(3611)) wypełniło 10-pozycyjną skalę optymizmu (1–5). Pozycje p1–p5 są proste, n1–n5 odwrócone. W populacji jest jeden czynnik optymizmu i dwa zakłócenia. Każda osoba ma własną skłonność do zgadzania się, która przesuwa wszystkie jej surowe odpowiedzi. Ponadto 51 osób (8.5%) odpowiada na pozycje odwrócone tak, jakby były proste. Po rekodowaniu średnia korelacja wynosiła .454 między pozycjami prostymi, .485 między odwróconymi i tylko .322 w parach mieszanych. Dane możesz pobrać jako plik CSV.
Pięć modeli pomiaru i ich założenia
Każdy model to inna hipoteza o tym, skąd bierze się nadwyżka korelacji w obrębie bloków. Wszystkie szacujemy na danych po rekodowaniu, estymatorem MLR, w pakiecie lavaan (Rosseel, 2012). Składnię modeli zawiera przykład w R, a podstawy CFA – wpis analiza czynnikowa EFA i CFA.
| Model | Co zakłada | Co oznacza dodatkowy parametr |
|---|---|---|
| M1: jeden czynnik | wszystkie korelacje wyjaśnia optymizm | – |
| M2: dwa skorelowane czynniki | pozycje proste i odwrócone mierzą dwie różne cechy | korelacja czynników < 1 jako „odrębność” wymiarów |
| M3: CT-C(M−1) | czynnik optymizmu na wszystkich pozycjach i nieskorelowany czynnik metody tylko na pozycjach odwróconych | efekt specyficzny dla pozycji odwróconych (przeczenia, nieuwaga, sformułowanie) |
| M4: losowy wyraz wolny | czynnik optymizmu i czynnik o ładunkach ustalonych na +1 (proste) i −1 (odwrócone po rekodowaniu) | wariancja skłonności do zgadzania się między osobami |
| M5: M3 + M4 | oba źródła naraz | rozdzielenie potakiwania i efektu pozycji odwróconych |
M3 to wersja modelu CT-C(M−1), który Eid i in. (2003) opisują dla danych wielu cech i wielu metod. Jedna metoda, tu pozycje proste, jest metodą odniesienia i nie ma czynnika metody. Czynnik metody pozycji odwróconych to ta część odpowiedzi, której nie przewiduje odpowiedź na pozycje proste. Symetryczny model bifactor z czynnikiem metody także dla pozycji prostych łatwo daje rozwiązania niestabilne. Porównanie modeli bifactor opisuje wpis model bifactor i ESEM.
M4 pochodzi od Maydeu-Olivaresa i Coffman (2006). Autorzy pozwalają wyrazom wolnym modelu czynnikowego różnić się między osobami, np. gdy ktoś systematycznie używa skali odpowiedzi po swojemu. Model przydaje się, gdy teoria przewiduje m czynników, a do odtworzenia danych potrzeba m + 1. Na surowych danych wszystkie ładunki tego czynnika wynoszą 1. Po rekodowaniu pozycje odwrócone mają ładunek −1. Model kosztuje tylko jeden parametr: wariancję losowego wyrazu wolnego.
Dopasowanie modeli w przykładzie
| Model | χ² (df) | CFI | RMSEA | SRMR | BIC |
|---|---|---|---|---|---|
| M1: jeden czynnik | 283.22 (35) | .875 | .109 | .069 | 16628.73 |
| M2: dwa czynniki | 30.30 (34) | 1.000 | .000 | .019 | 16378.92 |
| M3: CT-C(M−1) | 27.00 (30) | 1.000 | .000 | .016 | 16401.28 |
| M4: losowy wyraz wolny | 32.23 (34) | 1.000 | .000 | .019 | 16381.00 |
| M5: M3 + M4 | 26.64 (29) | 1.000 | .000 | .017 | 16406.95 |
Model jednoczynnikowy jest wyraźnie odrzucony. Pozostałe cztery pasują niemal idealnie, a różnice BIC między M2 i M4 są minimalne (2.08 punktu). Model dwuczynnikowy daje korelację czynników .684. Gdyby była to jedyna analiza, łatwo byłoby napisać o „optymizmie i pesymizmie jako częściowo odrębnych wymiarach”. W populacji był jednak tylko jeden czynnik.
W M3 standaryzowane ładunki czynnika metody wyniosły od .47 do .54. W M4 wariancja losowego wyrazu wolnego wyniosła 0.091, 95% CI [0.068, 0.115]. Model M5, który miał rozdzielić oba źródła, dał ujemną wariancję losowego wyrazu wolnego (−0.078, SE = 0.114). To rozwiązanie niedopuszczalne. Przy tej liczbie pozycji dane nie rozdzielają potakiwania i efektu pozycji odwróconych. Dobre dopasowanie modelu z czynnikiem metody mówi tylko, że jakaś metoda działa, a nie która.
Czy dopasowanie wskaże mechanizm? Symulacja
Żeby to sprawdzić, wygenerowaliśmy 200 prób po 500 osób w trzech scenariuszach. Każdy zawierał tylko jeden mechanizm: (A) potakiwanie, (B) 8% osób nieuważnych wobec kierunku pozycji, (C) efekt sformułowania, czyli dodatkowy czynnik działający tylko na pozycje odwrócone. W scenariuszu A prawdziwy jest model M4, w C – model M3. W B żaden model CFA nie jest prawdziwy, bo dane są mieszaniną dwóch grup osób.
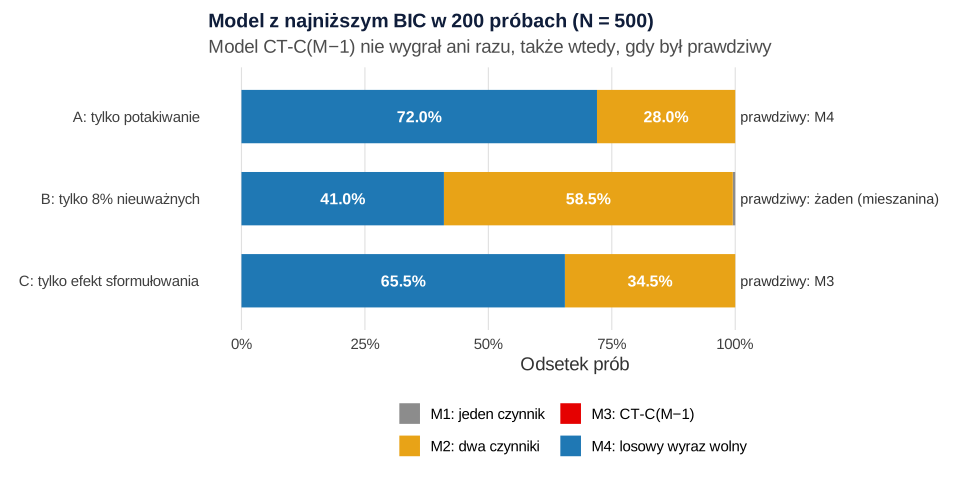
BIC trafił z modelem prawdziwym tylko przy potakiwaniu (72.0% prób). Przy efekcie sformułowania model CT-C(M−1) nie wygrał ani razu. W 65.5% prób wygrywał model z losowym wyrazem wolnym, a w 34.5% – dwuczynnikowy. Powód jest prosty. Gdy ładunki pozycji są podobne, M2, M3 i M4 odtwarzają prawie tę samą macierz kowariancji, a M3 ma cztery parametry więcej. Średnia korelacja czynników w M2 wyniosła .657 przy potakiwaniu, .838 przy nieuwadze i .862 przy efekcie sformułowania. Za każdym razem „dwa czynniki” były artefaktem.
Czynnik metody a omega skali
Wybór modelu ma znaczenie, bo zmienia ocenę rzetelności. Omega czynnika treściowego to udział optymizmu w wariancji sumy pozycji. Rodriguez i in. (2016) opisują takie wskaźniki dla modeli z czynnikiem ogólnym i czynnikami specyficznymi, m.in. omegę hierarchiczną. Liczymy ją wprost z parametrów modelu (funkcja omegi() w przepisie 1).
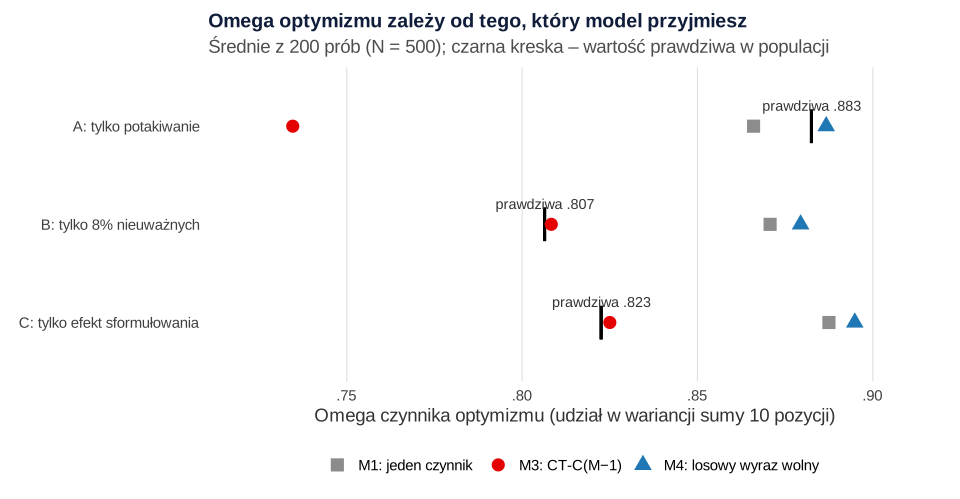
Każdy model jest trafny tylko dla „swojego” mechanizmu. Przy potakiwaniu model z losowym wyrazem wolnym daje .887 przy wartości prawdziwej .883, a CT-C(M−1) zaniża omegę do .735. Przy nieuwadze i efekcie sformułowania jest odwrotnie. CT-C(M−1) trafia (.808 i .825), a model z losowym wyrazem wolnym zawyża omegę o około .07. Skąd ta asymetria? W skali zrównoważonej potakiwanie dodaje się do pięciu pozycji i odejmuje od pięciu pozostałych po rekodowaniu. W sumie znosi się więc całkowicie. Dlatego w M4 czynnik losowego wyrazu wolnego ma udział .000 w wariancji sumy. Efekt pozycji odwróconych się nie znosi i zanieczyszcza wynik.
W przykładzie, gdzie działały oba mechanizmy, omega optymizmu wyniosła .864 w M1, .738 w M3 (czynnik metody: .145) i .883 w M4. Wartość prawdziwa to .827. Żaden model nie trafił, bo jedyny model obejmujący oba źródła (M5) był niedopuszczalny. Różnica między skrajnymi oszacowaniami wyniosła .145.
Przesiewanie respondentów jako analiza wrażliwości
Po rekodowaniu średnia pozycji prostych i średnia pozycji odwróconych powinny być u każdej osoby podobne. Różnica co najmniej 1.5 punktu oznacza, że ktoś zgadza się z twierdzeniami o przeciwnej treści albo z obydwoma się nie zgadza (rysunek 3).
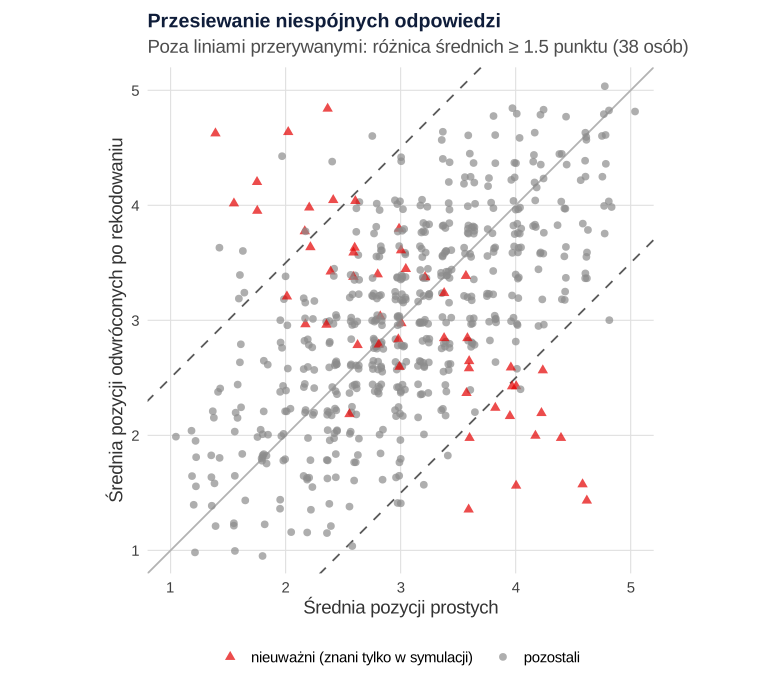
Reguła oznaczyła 38 osób: 22 z 51 nieuważnych i 16 osób uważnych. Pozostałych 29 nieuważnych nie wykryła. Mieli przeciętny optymizm, więc odwrócenie kierunku niewiele zmieniało w ich odpowiedziach. Oznaczone osoby uważne to silni potakiwacze. Średnia bezwzględna skłonność do zgadzania się wyniosła u nich 0.472, a u osób nieoznaczonych 0.190. Wskaźnik niespójności nie odróżnia więc nieuwagi od potakiwania.
Po wykluczeniu 38 osób model jednoczynnikowy pasował już dobrze: CFI = .985, RMSEA = .039, SRMR = .028. Ładunki czynnika metody w M3 spadły do .29–.38, a wariancja losowego wyrazu wolnego w M4 – do 0.031, 95% CI [0.021, 0.041]. BIC nadal wskazywał M4 (15119.29 wobec 15153.79 dla M1). Wykluczenie zmniejsza problem, ale go nie usuwa. Raportuj je obok analizy na pełnej próbie, a regułę zapisz przed zebraniem danych. Pomoże też pytanie kontrolne, które daje niezależny od skali sygnał nieuwagi.
Jak wybrać model
- Zacznij od hipotezy o mechanizmie, nie od dopasowania. Jeśli skala jest zrównoważona i zakładasz potakiwanie, modelem głównym może być M4. Jeśli pozycje odwrócone zawierają przeczenia albo spodziewasz się nieuwagi, wybierz M3. Zapisz to w planie analiz.
- Traktuj M2 jako hipotezę merytoryczną. Dwa wymiary przyjmij tylko wtedy, gdy przewiduje je teoria, a czynniki mają różne związki z kryteriami mierzonymi inną metodą. Sama korelacja czynników poniżej 1 niczego nie dowodzi.
- Pokaż wrażliwość wniosków. Podaj omegę i kluczowe korelacje z M1, M3 i M4 oraz po przesiewaniu respondentów. Jeśli wnioski się nie zmieniają, problem jest kosmetyczny.
- Zaplanuj pomiar stylu. Potakiwanie da się mierzyć osobno, np. pozycjami o niezwiązanej treści, podobnie jak style odpowiedzi skrajnych i środkowych. Weijters i in. (2013) formułują zalecenia dotyczące stosowania pozycji odwróconych w kwestionariuszach. Szerszy kontekst daje hasło o wspólnej wariancji metody.
- Przy pozycjach porządkowych te same modele oszacujesz estymatorem WLSMV (zob. kategorialna CFA w lavaan). Model z losowym wyrazem wolnym zapisuje się tak samo.
Jak opisać czynnik metody w artykule
Podaj liczbę pozycji odwróconych, przyjętą hipotezę o źródle efektu metody, tabelę dopasowania wszystkich modeli i omegę czynnika treściowego. Jeśli wykluczasz respondentów, opisz regułę i podaj wyniki z wykluczeniem i bez niego.
Jeśli recenzent pyta, dlaczego nie przyjąłeś(-ęłaś) dwóch czynników, możemy wspólnie przygotować porównanie modeli i analizę wrażliwości w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Przepisy uruchamiaj po kolei w jednej sesji R: przepis 2 korzysta z funkcji z przepisu 1. Pierwszy tworzy plik optymizm-pozycje-odwrocone.csv (możesz go pobrać tutaj). Symulacja w przepisie 2 trwa około dwóch minut. Potrzebny pakiet: lavaan.
1. Dane, pięć modeli, omega i przesiewanie
R
# Dane symulowane: 600 dorosłych, 10-pozycyjna skala optymizmu (1–5), pozycje p1–p5 proste, n1–n5 odwrócone.
# W populacji jest JEDEN czynnik optymizmu i dwa źródła zakłóceń:
#  (1) potakiwanie – każda osoba ma własne przesunięcie surowych odpowiedzi (SD 0.25) na wszystkich pozycjach,
#  (2) 6% osób nieuważnych – na pozycje odwrócone odpowiada tak, jakby były proste (nie zauważa kierunku).
# Argument slowa: opcjonalny czynnik sformułowania, który działa tylko na pozycje odwrócone (używany w przepisie 2).
suppressPackageStartupMessages(library(lavaan))
generuj <- function(N, p_nieuwaz = 0.06, sd_potak = 0.25, slowa = 0) {
  eta <- rnorm(N); potak <- rnorm(N, 0, sd_potak); w <- rnorm(N); nieuwazny <- runif(N) < p_nieuwaz
  lam <- c(0.85, 0.75, 0.80, 0.70, 0.75)
  odp <- function(znak, dodatek) sapply(1:5, function(j)
    pmin(pmax(round(3 + znak * lam[j] * eta + potak + dodatek + rnorm(N, 0, 0.8)), 1), 5))
  d <- as.data.frame(cbind(odp(+1, 0), odp(ifelse(nieuwazny, +1, -1), -slowa * w)))
  names(d) <- c(paste0("p", 1:5), paste0("n", 1:5))
  d[paste0("n", 1:5)] <- 6 - d[paste0("n", 1:5)]           # rekodowanie pozycji odwróconych (6 − x)
  list(dane = d, eta = eta, potak = potak, nieuwazny = nieuwazny)
}
set.seed(3611)
sym <- generuj(600); dane <- sym$dane
write.csv(cbind(id = 1:600, dane), "optymizm-pozycje-odwrocone.csv", row.names = FALSE)
c(N = nrow(dane), nieuwazni = sum(sym$nieuwazny))
r <- cor(dane); round(c(proste = mean(r[1:5, 1:5][upper.tri(diag(5))]), odwrocone = mean(r[6:10, 6:10][upper.tri(diag(5))]),
                        mieszane = mean(r[1:5, 6:10])), 3)                    # średnie korelacje w blokach

# Pięć modeli pomiaru (pozycje po rekodowaniu, estymator MLR)
P <- paste0("p", 1:5, collapse = " + "); Q <- paste0("n", 1:5, collapse = " + ")
RI <- paste0("\nri =~ ", paste0("1*p", 1:5, collapse = " + "), " + ", paste0("-1*n", 1:5, collapse = " + "), "\nri ~~ NA*ri")
modele <- list(
  M1_jeden_czynnik = paste("opt =~", P, "+", Q),
  M2_dwa_czynniki  = paste0("pozyt =~ ", P, "\nnegat =~ ", Q),
  M3_CTC_M1        = paste0("opt =~ ", P, " + ", Q, "\nmet_odwr =~ ", Q),
  M4_losowy_wyraz  = paste0("opt =~ ", P, " + ", Q, RI),
  M5_RI_i_metoda   = paste0("opt =~ ", P, " + ", Q, "\nmet_odwr =~ ", Q, RI))
dopasuj <- function(m, d = dane, orto = TRUE) cfa(m, data = d, estimator = "MLR", std.lv = TRUE, orthogonal = orto)
fit <- lapply(modele, function(m) suppressWarnings(dopasuj(m)))            # M5 daje ostrzeżenie (zob. niżej)
fit$M2_dwa_czynniki <- dopasuj(modele$M2_dwa_czynniki, orto = FALSE)          # w M2 czynniki są skorelowane
wsk <- c("chisq.scaled", "df", "cfi.robust", "rmsea.robust", "srmr", "bic")
round(t(sapply(fit, fitMeasures, wsk)), 3)
round(lavInspect(fit$M2_dwa_czynniki, "cor.lv")[1, 2], 3)                       # korelacja czynników „pozytywnego” i „negatywnego”

# Ładunki standaryzowane czynnika metody (M3) i wariancja losowego wyrazu wolnego (M4)
st <- function(f, lv) { s <- standardizedSolution(f); s <- s[s$op == "=~" & s$lhs == lv, ]; setNames(round(s$est.std, 2), s$rhs) }
st(fit$M3_CTC_M1, "met_odwr")
wariancja_ri <- function(f) { p <- parameterEstimates(f); round(p[p$lhs == "ri" & p$op == "~~", c("est", "se", "ci.lower", "ci.upper")], 3) }
wariancja_ri(fit$M4_losowy_wyraz)
wariancja_ri(fit$M5_RI_i_metoda)                                               # ujemna wariancja: rozwiązanie niedopuszczalne

# Omega: jaka część wariancji SUMY 10 pozycji pochodzi z optymizmu, a jaka z czynników metody
omegi <- function(f) {
  e <- lavInspect(f, "est"); L <- e$lambda; Ps <- e$psi
  wariancja_sumy <- sum(L %*% Ps %*% t(L)) + sum(e$theta)
  c(sapply(colnames(L), function(k) sum(L[, k])^2 * Ps[k, k]) / wariancja_sumy,
    omega_calk = sum(L %*% Ps %*% t(L)) / wariancja_sumy)
}
lapply(fit[c("M1_jeden_czynnik", "M3_CTC_M1", "M4_losowy_wyraz")], function(f) round(omegi(f), 3))
populacja <- generuj(2e5)                                                        # ten sam mechanizm, bardzo duża próba
round(c(omega_prawdziwa = cor(rowSums(populacja$dane), populacja$eta)^2), 3)    # udział optymizmu w wariancji sumy

# Przesiewanie: osoba zgadza się (albo nie zgadza) z twierdzeniami o przeciwnej treści
roznica <- rowMeans(dane[paste0("p", 1:5)]) - rowMeans(dane[paste0("n", 1:5)])   # po rekodowaniu powinna być bliska 0
flaga <- abs(roznica) >= 1.5
table(oznaczony = flaga, nieuwazny = sym$nieuwazny)
round(c(potakiwanie_oznaczeni_uwazni = mean(abs(sym$potak[flaga & !sym$nieuwazny])),
        potakiwanie_pozostali = mean(abs(sym$potak[!flaga]))), 3)
bez_oznaczonych <- lapply(modele[c("M1_jeden_czynnik", "M3_CTC_M1", "M4_losowy_wyraz")], dopasuj, d = dane[!flaga, ])
round(t(sapply(bez_oznaczonych, fitMeasures, wsk)), 3)
st(bez_oznaczonych$M3_CTC_M1, "met_odwr")
wariancja_ri(bez_oznaczonych$M4_losowy_wyraz)
write.csv(data.frame(srednia_proste = rowMeans(dane[paste0("p", 1:5)]), srednia_odwrocone = rowMeans(dane[paste0("n", 1:5)]),
                     nieuwazny = sym$nieuwazny, oznaczony = flaga), "b361-przesiewanie.csv", row.names = FALSE)
Wynik w R
        N nieuwazni
      600        51
   proste odwrocone  mieszane
    0.454     0.485     0.322
                 chisq.scaled df cfi.robust rmsea.robust  srmr      bic
M1_jeden_czynnik      283.222 35      0.875        0.109 0.069 16628.73
M2_dwa_czynniki        30.298 34      1.000        0.000 0.019 16378.92
M3_CTC_M1              27.002 30      1.000        0.000 0.016 16401.28
M4_losowy_wyraz        32.229 34      1.000        0.000 0.019 16381.00
M5_RI_i_metoda         26.644 29      1.000        0.000 0.017 16406.95
[1] 0.684
  n1   n2   n3   n4   n5
0.53 0.51 0.48 0.47 0.54
     est    se ci.lower ci.upper
21 0.091 0.012    0.068    0.115
      est    se ci.lower ci.upper
26 -0.078 0.114   -0.301    0.146
$M1_jeden_czynnik
       opt omega_calk
     0.864      0.864

$M3_CTC_M1
       opt   met_odwr omega_calk
     0.738      0.145      0.883

$M4_losowy_wyraz
       opt         ri omega_calk
     0.883      0.000      0.883

omega_prawdziwa
          0.827
         nieuwazny
oznaczony FALSE TRUE
    FALSE   533   29
    TRUE     16   22
potakiwanie_oznaczeni_uwazni        potakiwanie_pozostali
                       0.472                        0.190
                 chisq.scaled df cfi.robust rmsea.robust  srmr      bic
M1_jeden_czynnik       64.993 35      0.985        0.039 0.028 15153.79
M3_CTC_M1              22.220 30      1.000        0.000 0.015 15142.82
M4_losowy_wyraz        23.968 34      1.000        0.000 0.016 15119.29
  n1   n2   n3   n4   n5
0.32 0.31 0.29 0.29 0.38
     est    se ci.lower ci.upper
21 0.031 0.005    0.021    0.041
2. Symulacja: trzy mechanizmy osobno
R
# Symulacja: trzy mechanizmy, każdy osobno, po 200 prób z N = 500 (wymaga funkcji generuj, modele, dopasuj i omegi z przepisu 1)
#  A – tylko potakiwanie (SD 0.35), B – tylko 8% nieuważnych, C – tylko czynnik sformułowania pozycji odwróconych (0.45)
suppressPackageStartupMessages(library(lavaan))
set.seed(3612)
scenariusze <- list(A_potakiwanie = list(p_nieuwaz = 0, sd_potak = 0.35, slowa = 0),
                    B_nieuwaga    = list(p_nieuwaz = 0.08, sd_potak = 0, slowa = 0),
                    C_sformulowanie = list(p_nieuwaz = 0, sd_potak = 0, slowa = 0.45))
jedna_proba <- function(sc) {
  d <- do.call(generuj, c(N = 500, sc))$dane
  f <- lapply(modele[1:4], function(m) suppressWarnings(dopasuj(m, d = d)))
  f$M2_dwa_czynniki <- suppressWarnings(dopasuj(modele$M2_dwa_czynniki, d = d, orto = FALSE))
  bic <- sapply(f, fitMeasures, "bic")
  c(najlepszy_BIC = unname(which.min(bic)), cfi_M1 = unname(fitMeasures(f$M1_jeden_czynnik, "cfi.robust")),
    r_M2 = lavInspect(f$M2_dwa_czynniki, "cor.lv")[1, 2],
    omega_M1 = omegi(f$M1_jeden_czynnik)[["opt"]], omega_M3 = omegi(f$M3_CTC_M1)[["opt"]], omega_M4 = omegi(f$M4_losowy_wyraz)[["opt"]])
}
wyniki <- lapply(scenariusze, function(sc) t(replicate(200, jedna_proba(sc))))
prawdziwa <- sapply(scenariusze, function(sc) { p <- do.call(generuj, c(N = 2e5, sc)); cor(rowSums(p$dane), p$eta)^2 })

# Który model wygrywa według BIC (odsetek prób)
wybor <- t(sapply(wyniki, function(w) table(factor(w[, "najlepszy_BIC"], 1:4, names(modele)[1:4])) / 200))
round(100 * wybor, 1)
# Średnie: CFI modelu jednoczynnikowego, korelacja czynników w M2, omega optymizmu w trzech modelach i wartość prawdziwa
srednie <- t(sapply(wyniki, function(w) colMeans(w[, -1])))
tab <- cbind(round(srednie, 3), omega_prawdziwa = round(prawdziwa, 3))
tab
bladMC <- t(sapply(wyniki, function(w) apply(w[, -1], 2, sd) / sqrt(200)))
round(max(bladMC[, c("omega_M1", "omega_M3", "omega_M4")]), 4)                 # największy błąd Monte Carlo średnich omegi
write.csv(data.frame(scenariusz = rownames(wybor), 100 * wybor, srednie, omega_prawdziwa = prawdziwa),
          "b361-symulacja.csv", row.names = FALSE)
Wynik w R
                M1_jeden_czynnik M2_dwa_czynniki M3_CTC_M1 M4_losowy_wyraz
A_potakiwanie                0.0            28.0         0            72.0
B_nieuwaga                   0.5            58.5         0            41.0
C_sformulowanie              0.0            34.5         0            65.5
                cfi_M1  r_M2 omega_M1 omega_M3 omega_M4 omega_prawdziwa
A_potakiwanie    0.848 0.657    0.866    0.735    0.887           0.883
B_nieuwaga       0.961 0.838    0.871    0.808    0.879           0.807
C_sformulowanie  0.968 0.862    0.887    0.825    0.895           0.823
[1] 0.0016
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lavaan; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Dwa czynniki, bo dwa pasują lepiej”. Model dwuczynnikowy wygrywa z jednoczynnikowym przy każdym z opisanych mechanizmów. Lepsze dopasowanie nie świadczy o odrębności wymiarów.
- Wybór między M3 a M4 według BIC. W symulacji BIC ani razu nie wskazał prawdziwego modelu CT-C(M−1). Decyzję uzasadnij hipotezą o mechanizmie.
- Omega z modelu jednoczynnikowego, który nie pasuje. Podaj omegę z przyjętego modelu i jej zakres w modelach konkurencyjnych.
- Interpretowanie czynnika metody jako cechy. To mieszanina nieuwagi, przeczeń i stylu. Jego korelacje z innymi zmiennymi interpretuj ostrożnie.
- Usuwanie pozycji odwróconych po fakcie. Zmienia narzędzie i odbiera skali ochronę przed potakiwaniem. W skali zrównoważonej potakiwanie znosi się w sumie.
Najczęstsze pytania
Czy dwa czynniki z pozycji prostych i odwróconych oznaczają dwa wymiary konstruktu?
Zwykle nie. Taki układ powstaje, gdy część osób potakuje, nie zauważa przeczeń albo inaczej reaguje na negatywne sformułowania. W przykładzie dane pochodziły z jednego czynnika, a mimo to model dwuczynnikowy pasował świetnie i dawał korelację czynników .684. O drugim wymiarze świadczyłyby dopiero teoria i odmienne związki z kryteriami mierzonymi inną metodą.
Jak zapisać w lavaan model z losowym wyrazem wolnym (random intercept)?
Dodaj czynnik, na który wszystkie pozycje ładują wartością ustaloną na 1, uwolnij jego wariancję i ustaw go jako nieskorelowany z czynnikiem treściowym. Na danych po rekodowaniu pozycje odwrócone dostają ładunek −1, np. ri =~ 1*p1 + … + -1*n1 i ri ~~ NA*ri. Wariancja tego czynnika opisuje różnice między osobami w skłonności do zgadzania się.
Czym różni się model CT-C(M−1) od modelu bifactor dla pozycji odwróconych?
W CT-C(M−1) pozycje proste są metodą odniesienia: definiują czynnik treściowy, a czynnik metody mają tylko pozycje odwrócone. W symetrycznym modelu bifactor czynnik metody dostają obie grupy pozycji, co łatwo prowadzi do problemów z identyfikacją i znikających czynników specyficznych. Interpretacja CT-C(M−1) jest jasna: czynnik metody to ta część pozycji odwróconych, której nie przewiduje odpowiedź na pozycje proste.
Czy usunięcie nieuważnych respondentów usuwa czynnik metody?
Tylko częściowo. W przykładzie po wykluczeniu 38 osób z niespójnymi odpowiedziami ładunki czynnika metody spadły z .47–.54 do .29–.38, ale nie zniknęły. Wskaźnik niespójności oznaczył też osoby silnie potakujące, a pominął nieuważnych o przeciętnym poziomie cechy. Wykluczenie traktuj jako analizę wrażliwości, a regułę zapisz przed analizą.
Którą omegę podać, gdy skala ma czynnik metody?
Podaj omegę czynnika treściowego z przyjętego modelu i napisz, jaką część wariancji sumy przypisano metodzie. Gdy wybór modelu jest niepewny, podaj zakres z modeli konkurencyjnych. W przykładzie omega optymizmu wyniosła .738 w CT-C(M−1), .864 w modelu jednoczynnikowym i .883 w modelu z losowym wyrazem wolnym.
Powiązane hasła
Przeczytaj też
Nieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikModel bifactor i ESEM
Od CFA do bifactor-ESEM na jednym kwestionariuszu: ładunki krzyżowe, czynnik ogólny, omega H, ECV, trafność podskal, tabela APA i kod lavaan.
Czytaj →PoradnikMacierz MTMM: wiele cech i wiele metod
Kryteria Campbella i Fiske’a, modele CTCM, CTCU i CT-C(M−1) w lavaan, problemy z identyfikacją i przykład 3 cechy × 3 metody.
Czytaj →Pozycje odwrócone tworzą w Twojej skali osobny czynnik, a recenzent pyta o strukturę?
Pomożemy dobrać i oszacować modele z czynnikiem metody, policzyć omegę i analizę wrażliwości oraz sprawdzić opis tak, żebyś mógł(a) samodzielnie uzasadnić decyzje przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Eid, M., Lischetzke, T., Nussbeck, F. W., & Trierweiler, L. I. (2003). Separating trait effects from trait-specific method effects in multitrait-multimethod models: A multiple-indicator CT-C(M-1) model. Psychological Methods, 8(1), 38–60. https://doi.org/10.1037/1082-989x.8.1.38
- Marsh, H. W. (1996). Positive and negative global self-esteem: A substantively meaningful distinction or artifactors? Journal of Personality and Social Psychology, 70(4), 810–819. https://doi.org/10.1037/0022-3514.70.4.810
- Maydeu-Olivares, A., & Coffman, D. L. (2006). Random intercept item factor analysis. Psychological Methods, 11(4), 344–362. https://doi.org/10.1037/1082-989x.11.4.344
- Rodriguez, A., Reise, S. P., & Haviland, M. G. (2016). Evaluating bifactor models: Calculating and interpreting statistical indices. Psychological Methods, 21(2), 137–150. https://doi.org/10.1037/met0000045
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Schmitt, N., & Stuits, D. M. (1985). Factors defined by negatively keyed items: The result of careless respondents? Applied Psychological Measurement, 9(4), 367–373. https://doi.org/10.1177/014662168500900405 ● Otwarty dostęp: pełny tekst
- Weijters, B., Baumgartner, H., & Schillewaert, N. (2013). Reversed item bias: An integrative model. Psychological Methods, 18(3), 320–334. https://doi.org/10.1037/a0032121 ● Otwarty dostęp: pełny tekst
- Woods, C. M. (2006). Careless responding to reverse-worded items: Implications for confirmatory factor analysis. Journal of Psychopathology and Behavioral Assessment, 28(3), 186–191. https://doi.org/10.1007/s10862-005-9004-7
Cytowania BibTeX
@article{eid2003separating, author={Eid, Michael and Lischetzke, Tanja and Nussbeck, Fridtjof W. and Trierweiler, Lisa I.}, title={{Separating trait effects from trait-specific method effects in multitrait-multimethod models: A multiple-indicator CT-C(M-1) model}}, journal={Psychological Methods}, year={2003}, volume={8}, number={1}, pages={38--60}, doi={10.1037/1082-989x.8.1.38}}@article{marsh1996positive, author={Marsh, Herbert W.}, title={{Positive and negative global self-esteem: A substantively meaningful distinction or artifactors?}}, journal={Journal of Personality and Social Psychology}, year={1996}, volume={70}, number={4}, pages={810--819}, doi={10.1037/0022-3514.70.4.810}}@article{maydeuolivares2006random, author={Maydeu-Olivares, Albert and Coffman, Donna L.}, title={{Random intercept item factor analysis}}, journal={Psychological Methods}, year={2006}, volume={11}, number={4}, pages={344--362}, doi={10.1037/1082-989x.11.4.344}}@article{rodriguez2016evaluating, author={Rodriguez, Anthony and Reise, Steven P. and Haviland, Mark G.}, title={{Evaluating bifactor models: Calculating and interpreting statistical indices}}, journal={Psychological Methods}, year={2016}, volume={21}, number={2}, pages={137--150}, doi={10.1037/met0000045}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{schmitt1985factors, author={Schmitt, Neal and Stuits, Daniel M.}, title={{Factors defined by negatively keyed items: The result of careless respondents?}}, journal={Applied Psychological Measurement}, year={1985}, volume={9}, number={4}, pages={367--373}, doi={10.1177/014662168500900405}}@article{weijters2013reversed, author={Weijters, Bert and Baumgartner, Hans and Schillewaert, Niels}, title={{Reversed item bias: An integrative model}}, journal={Psychological Methods}, year={2013}, volume={18}, number={3}, pages={320--334}, doi={10.1037/a0032121}}@article{woods2006careless, author={Woods, Carol M.}, title={{Careless responding to reverse-worded items: Implications for confirmatory factor analysis}}, journal={Journal of Psychopathology and Behavioral Assessment}, year={2006}, volume={28}, number={3}, pages={186--191}, doi={10.1007/s10862-005-9004-7}}