Co mierzy Skala Samooceny Rosenberga
Skala Samooceny Rosenberga (ang. Rosenberg Self-Esteem Scale, RSES lub SES) mierzy samoocenę globalną, czyli ogólny stosunek do samego siebie: na ile ktoś uważa się za wartościową osobę i akceptuje siebie. Morris Rosenberg (1965) opisał ją w monografii z badania ponad pięciu tysięcy uczniów szkół średnich. Od tego czasu stała się jednym z najczęściej używanych narzędzi do pomiaru samooceny (Donnellan i in., 2016). W pracach z pielęgniarstwa, fizjoterapii i zdrowia publicznego pojawia się jako zmienna opisująca pacjentów (np. po urazie lub w chorobie przewlekłej) albo studentów i personel.
Skala jest krótka i prosta, ale studenci najczęściej mylą się w trzech miejscach: przy pozycjach odwróconych, przy wyborze zakresu wyniku (0–30 czy 10–40) i przy interpretacji, bo szukają progu „niskiej samooceny”, którego nie ma. W tym poradniku po kolei liczymy wynik na symulowanym zbiorze danych, sprawdzamy rzetelność i w R pokazujemy, skąd bierze się spór o jednowymiarowość skali.
| Cecha | Skala Samooceny Rosenberga |
|---|---|
| Liczba pozycji | 10, bez podskal w oryginalnym sposobie liczenia |
| Skala odpowiedzi | 4 stopnie: od „zdecydowanie się zgadzam” do „zdecydowanie się nie zgadzam”, bez odpowiedzi środkowej |
| Pozycje sformułowane pozytywnie | 1, 2, 4, 6, 7: zgoda oznacza wyższą samoocenę |
| Pozycje odwrócone | 3, 5, 8, 9, 10: zgoda oznacza niższą samoocenę |
| Punktacja pozycji | 0–3 (albo 1–4) |
| Zakres wyniku | 0–30 (albo 10–40); wyższy wynik = wyższa samoocena |
| Progi interpretacyjne | brak oficjalnych punktów odcięcia |
Zasady liczenia w tabeli pochodzą ze strony Wydziału Socjologii University of Maryland, gdzie Rosenberg pracował (University of Maryland, Department of Sociology, b.d.-a). Strona przypomina, że skalę zaprojektowano pierwotnie jako skalę Guttmana, a dziś zwykle liczy się ją jak skalę Likerta. Treści pozycji tu nie przytaczamy. Pozycje pozytywne dotyczą poczucia własnej wartości i zadowolenia z siebie, a odwrócone opisują krytyczne myśli o sobie.
Numery pozycji odwróconych odnoszą się do kolejności z wersji na stronie University of Maryland. Jeśli używasz przekładu albo wersji z artykułu, sprawdź kolejność pozycji w źródle swojej wersji. Pozycje odwrócone rozpoznawaj po treści, nie po numerze. To zwykły klucz odpowiedzi, ale błąd w nim psuje cały wynik, co pokażemy w kroku 2.
Badanie przykładowe: samoocena studentów pierwszego roku
Wyobraź sobie pracę licencjacką o samoocenie studentów pierwszego roku pielęgniarstwa i fizjoterapii. Skalę wypełniło 312 osób: 169 z pielęgniarstwa i 143 z fizjoterapii. Odpowiedzi zakodowano w arkuszu jako 1–4, gdzie 1 to „zdecydowanie się nie zgadzam”, a 4 to „zdecydowanie się zgadzam”. Tak zwykle wygląda eksport z formularza internetowego. Dane są symulowane, ale mają typowe problemy prawdziwych baz: pojedyncze braki, dwie osoby z kilkoma pominiętymi pozycjami i jedną literówkę. Możesz je pobrać jako plik CSV (kolumny id, kierunek, rses1–rses10) i powtórzyć obliczenia w swoim programie. Ogólną procedurę dla dowolnego kwestionariusza opisujemy w poradniku jak policzyć wynik kwestionariusza krok po kroku. Tutaj skupiamy się na tym, co specyficzne dla skali Rosenberga.
Krok 1. Sprawdź wartości niemożliwe
Każda pozycja może przyjąć tylko wartości 1, 2, 3 i 4. Zanim cokolwiek policzysz, wyszukaj wszystkie inne wartości. W naszych danych jest jedna: osoba nr 203 ma w pozycji 7 wartość 44. Najpewniej ktoś dwa razy nacisnął klawisz, ale pewności nie ma. Jeśli masz oryginalny arkusz papierowy, popraw wartość na jego podstawie. Jeśli nie masz, zamień ją na brak danych i zapisz tę decyzję w opisie przygotowania danych. Średnia z wartością 44 w jednej pozycji dałaby tej osobie wynik daleko poza zakresem skali.
Krok 2. Odwróć pozycje 3, 5, 8, 9 i 10
W pozycji odwróconej zgoda oznacza niższą samoocenę. Żeby wszystkie pozycje „szły” w tę samą stronę, przekoduj je według wzoru:
Przy kodowaniu 1–4 dla pozycji odwróconej oznacza to 5 − x, a przy kodowaniu 0–3 – 3 − x. Najpierw zamieniliśmy kody 1–4 na 0–3, odejmując 1, a potem odwróciliśmy pozycje 3, 5, 8, 9 i 10. Po tej operacji w każdej pozycji 3 punkty oznaczają odpowiedź najbardziej świadczącą o wysokiej samoocenie.
| Odpowiedź | Pozycje 1, 2, 4, 6, 7 (0–3) | Pozycje 3, 5, 8, 9, 10 (0–3) | Pozycje 1, 2, 4, 6, 7 (1–4) | Pozycje 3, 5, 8, 9, 10 (1–4) |
|---|---|---|---|---|
| Zdecydowanie się zgadzam | 3 | 0 | 4 | 1 |
| Zgadzam się | 2 | 1 | 3 | 2 |
| Nie zgadzam się | 1 | 2 | 2 | 3 |
| Zdecydowanie się nie zgadzam | 0 | 3 | 1 | 4 |
Obie punktacje są poprawne i dają wyniki różniące się o stałą 10 (University of Maryland, Department of Sociology, b.d.-a). Wynik 21 w wersji 0–30 to 31 w wersji 10–40. W pracy zawsze napisz, którą punktację przyjęłaś lub przyjąłeś, i podaj zakres. Bez tego czytelnik nie porówna Twojej średniej z innymi badaniami. Jeśli porównujesz wyniki z kilku skal o różnych zakresach, pomocny bywa POMP, czyli procent maksymalnego wyniku.
Co się dzieje, gdy zapomnisz o odwróceniu? Policzyliśmy to na 296 osobach z kompletnymi odpowiedziami. Po poprawnym odwróceniu korelacje każdej pozycji z sumą pozostałych mieszczą się w przedziale od .49 do .72, a alfa Cronbacha wynosi α = .89. Bez odwrócenia alfa spada do α = −.074, a błędny wynik ogólny koreluje z poprawnym na poziomie r = −.22. Taki wynik nie mierzy już samooceny. Ujemna alfa albo ujemne korelacje pozycja–reszta niemal zawsze oznaczają, że któraś pozycja nie została odwrócona.
Krok 3. Zdecyduj, co zrobisz z brakami
W danych 296 osób odpowiedziało na wszystkie pozycje, 14 osób pominęło jedną pozycję (razem z osobą, której literówkę zamieniliśmy na brak), a 2 osoby pominęły trzy. Strona University of Maryland nie podaje reguły postępowania z brakami danych, więc musisz ją przyjąć sama lub sam i opisać. W przykładzie zastosowaliśmy umowną regułę: przy jednym braku wynik to średnia z dziewięciu pozostałych pozycji pomnożona przez 10, a przy dwóch brakach lub więcej wyniku nie liczymy. Dzięki temu wynik osoby z brakiem ma ten sam zakres co wynik osoby z kompletem odpowiedzi. Gdyby zamiast tego zsumować tylko dostępne pozycje, ta osoba dostałaby zaniżony wynik.
Ostatecznie wynik ma 310 osób. Przy większej liczbie braków, zwłaszcza gdy skupiają się w jednej grupie, rozważ imputację wielokrotną (zob. braki danych i imputacja wielokrotna w R). Sumę czy średnią wybierasz tak samo jak w innych skalach (wynik skali: średnia czy suma). Strona University of Maryland opisuje wynik skali Rosenberga jako sumę, więc przy tej skali zostań przy sumie, chyba że wersja, której używasz, zaleca inaczej.
Krok 4. Opisz rozkład wyniku
W przykładzie średni wynik wyniósł M = 21.51 (SD = 5.18, Me = 22) przy zakresie od 6 do 30. Rozkład jest lewostronnie skośny (skośność = −0.54): większość osób ma wyniki wysokie, a ogon tworzy niewielka grupa z niską samooceną (rysunek 1). Wynik maksymalny, czyli 30 punktów, uzyskało 2.3% osób, więc wyraźnego efektu sufitu nie ma. W próbach o bardzo wysokiej samoocenie warto jednak ten odsetek zawsze podawać.
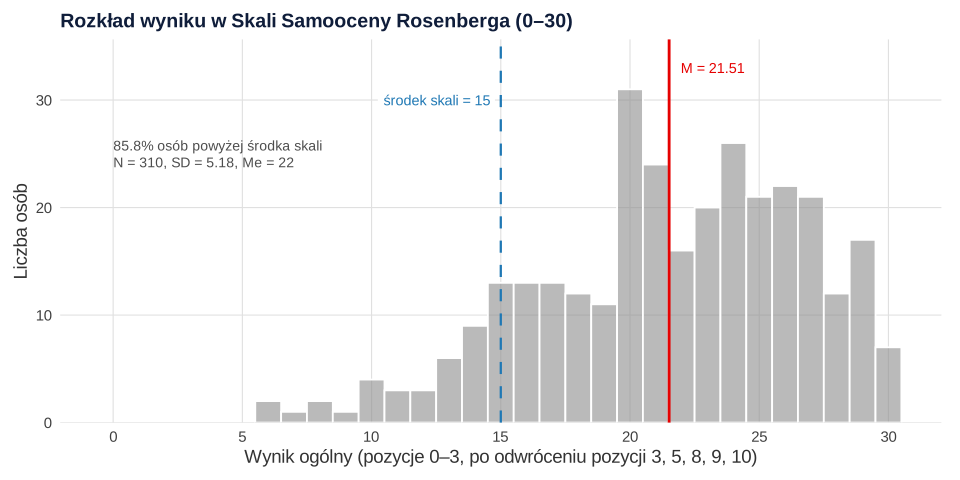
Aż 85.8% osób ma wynik powyżej teoretycznego środka skali, czyli 15 punktów. To nie jest osobliwość naszych danych. W badaniu prowadzonym w 53 krajach średnia w każdym kraju była wyższa od środka skali (Schmitt i Allik, 2005). Środek skali nie jest więc „przeciętną samooceną”, a wynik 18 nie oznacza, że ktoś ma samoocenę „niską”, tylko że jest niższa niż u większości badanych. Do opisu użyj średniej i odchylenia standardowego, a przy wyraźnej skośności dodaj medianę. Wzór tabeli znajdziesz w poradniku statystyki opisowe w pracy.
Krok 5. Sprawdź rzetelność we własnej próbie
Strona University of Maryland podaje, powołując się na wcześniejsze przeglądy, że współczynniki alfa w różnych próbach mieszczą się zwykle w przedziale od .77 do .88, a korelacje test–retest – od .82 do .88 (University of Maryland, Department of Sociology, b.d.-a). Wartości z literatury nie zastąpią jednak oszacowania z Twoich danych. W przykładzie spójność wewnętrzna wyniosła α = .89. Najniższą korelację z resztą skali miała pozycja 4 (.49), a najwyższą pozycja 10 (.72). Jak opisać alfę i kiedy dodać omegę McDonalda, pokazujemy w poradnikach alfa Cronbacha – rzetelność skali i wzór raportowania alfy Cronbacha.
Jak interpretować wynik bez progów
Skala Rosenberga nie ma oficjalnych punktów odcięcia dla wysokiej i niskiej samooceny. Strona University of Maryland mówi to wprost i zaleca sięganie do literatury dotyczącej badanej populacji (University of Maryland, Department of Sociology, b.d.-b). Jeśli trafisz na progi typu „poniżej X punktów to niska samoocena” bez źródła w publikacji naukowej, nie stosuj ich w pracy. Nawet dobrze udokumentowany próg z jednej populacji nie przenosi się automatycznie na inną. Wynik w skali samooceny nie jest też diagnozą żadnego zaburzenia.
W praktyce masz trzy uczciwe możliwości:
- Analizuj wynik ciągły. To rozwiązanie najlepsze statystycznie. Korelacje, regresja czy porównania grup zachowują całą informację z pomiaru.
- Porównaj się z opublikowanymi wynikami podobnych prób. Pamiętaj wtedy, że wynik zależy od punktacji (0–30 czy 10–40), wersji językowej i kraju (Schmitt i Allik, 2005). Jeśli korzystasz z przekładu, sprawdź w jego publikacji, jakie dane porównawcze podano. O normach testowych możesz mówić tylko wtedy, gdy autorzy adaptacji je opublikowali.
- Jeśli promotor wymaga poziomów, wyznacz je jawnie. Może to być podział teoretyczny albo tercyle z próby. Nazwij je „niższy” i „wyższy wynik w tej próbie”, a nie „niska samoocena”. Zalety i wady każdego sposobu omawiamy w poradniku niski, przeciętny, wysoki wynik. Główne analizy i tak prowadź na wyniku ciągłym, bo dzielenie medianą i podobne podziały obniżają moc.
Przekłady skali, także polski, publikują ich autorzy, a uniwersytet nie gromadzi wersji w innych językach (University of Maryland, Department of Sociology, b.d.-b). W pracy cytuj zarówno oryginał, jak i adaptację, z której korzystasz. Warunki użycia sprawdź u autorów adaptacji albo u wydawcy, który ją rozpowszechnia.
Jeden czynnik czy dwa? Spór o pozycje odwrócone
Wynik ogólny ma sens, jeśli skala mierzy jedną cechę. Wokół tego toczy się długi spór. Część analiz czynnikowych wyodrębnia z pozycji pozytywnych i odwróconych dwa odrębne czynniki, nazywane czasem „pewnością siebie” i „deprecjacją siebie” (University of Maryland, Department of Sociology, b.d.-a). Marsh (1996) pokazał w konfirmacyjnej analizie czynnikowej, że dane lepiej opisuje jeden czynnik samooceny z efektami metody dla pozycji negatywnych niż dwie odrębne samooceny. Do podobnego wniosku doszli Tomás i Oliver (1999): pod odpowiedziami leży jeden czynnik globalny, ale do dobrego dopasowania potrzebne są efekty metody. DiStefano i Motl (2006) traktują te efekty jako styl odpowiadania, który pojawia się także w innych skalach z pozycjami negatywnymi. Bliskim zjawiskiem jest tendencja do zgadzania się. Pozycje odwrócone bywają też rozumiane różnie w różnych krajach (Schmitt i Allik, 2005).
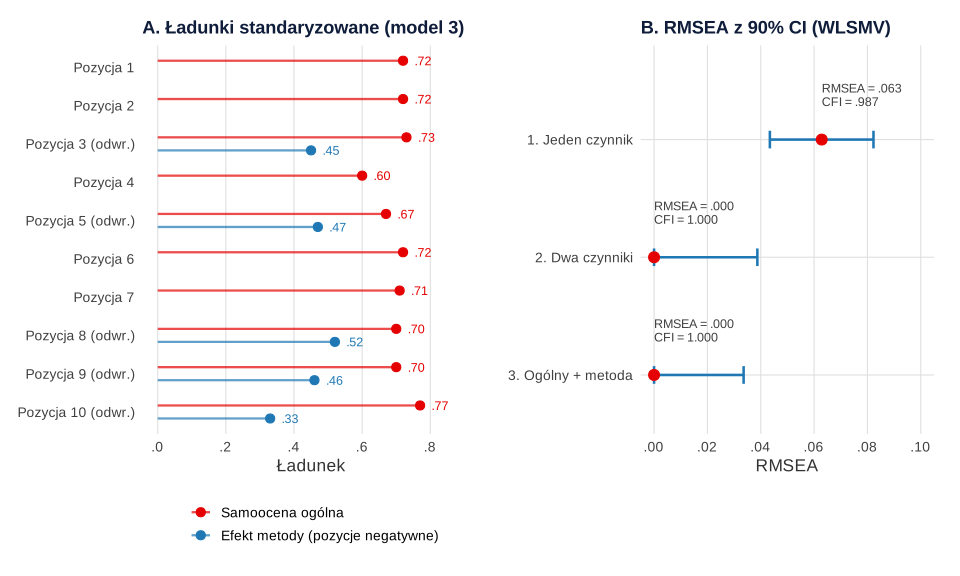
W przykładzie porównaliśmy trzy modele CFA na 296 osobach z kompletem odpowiedzi. Pozycje mają tylko cztery kategorie, dlatego modele oszacowano estymatorem WLSMV, który opiera się na korelacjach polichorycznych. Model 1 to jeden czynnik. Model 2 to dwa skorelowane czynniki: pozycje pozytywne i odwrócone. Model 3 to czynnik ogólny plus niezależny od niego czynnik metody, na który ładują tylko pozycje odwrócone.
| Model | χ²(df) | p | CFI | TLI | RMSEA [90% CI] | SRMR |
|---|---|---|---|---|---|---|
| 1. Jeden czynnik | 75.80 (35) | < .001 | .987 | .984 | .063 [.043, .082] | .049 |
| 2. Dwa skorelowane czynniki | 31.93 (34) | .569 | 1.000 | 1.001 | .000 [.000, .039] | .030 |
| 3. Czynnik ogólny + metoda | 25.01 (30) | .724 | 1.000 | 1.002 | .000 [.000, .034] | .026 |
Model jednoczynnikowy jest dopasowany gorzej od obu pozostałych. Skorygowany test różnicy chi-kwadrat wypada na jego niekorzyść zarówno w porównaniu z modelem 2, Δχ²(1) = 19.59, p < .001, jak i z modelem 3, Δχ²(5) = 37.44, p < .001. Według CFI, TLI, RMSEA i SRMR nie wypada jednak źle. Orientacyjne progi Hu i Bentlera (1999) wyznaczono w symulacjach dla estymacji metodą największej wiarygodności, więc przy WLSMV traktuj je jako przybliżenie. TLI powyżej 1 to sytuacja możliwa przy bardzo dobrym dopasowaniu i czyta się ją jak 1.
Najważniejsze informacje są w parametrach modeli. W modelu 2 korelacja czynników wynosi .85, 95% CI [.79, .91], więc obie „samooceny” w dużej mierze mierzą to samo. W modelu 3 ładunki czynnika ogólnego mieszczą się w przedziale .60–.77, a ładunki czynnika metody – .33–.52 (rysunek 2). Pozycje odwrócone mają więc wspólną wariancję, której nie wyjaśnia sama samoocena.
Czy to podważa wynik ogólny? W przykładzie suma 10 pozycji koreluje z oszacowaniem czynnika ogólnego z modelu 3 na poziomie r = .982. Podobnie wyszło w badaniu 1127 studentów: model ściśle jednoczynnikowy był dopasowany słabo, ale czynniki globalne z lepszych modeli wiązały się z kryteriami prawie tak samo jak zwykła suma (Donnellan i in., 2016). Wniosek praktyczny: licz jeden wynik ogólny, w opisie narzędzia wspomnij o efekcie metody pozycji odwróconych, a jeśli robisz CFA, porównaj model jednoczynnikowy z modelem uwzględniającym ten efekt. Pamiętaj tylko, że dane w przykładzie symulowaliśmy z efektem metody, więc nasz wynik ilustruje procedurę i niczego nie dowodzi. Rozbudowany przykład CFA w lavaan (Rosseel, 2012) znajdziesz w poradniku CB-SEM w R. Porównywanie wyników między grupami wymaga jeszcze sprawdzenia inwariancji (zob. inwariancja pomiaru krok po kroku).
Jak opisać skalę i wyniki w pracy
Opis narzędzia w rozdziale metodologicznym powinien zawierać autora, liczbę pozycji, skalę odpowiedzi, pozycje odwrócone, zakres wyniku i rzetelność z Twojej próby. Pełny wzór opisu narzędzia, z elementami dotyczącymi adaptacji i licencji, znajdziesz w poradniku opis narzędzia badawczego w pracy.
Skala Rosenberga w R: wynik, alfa i CFA
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom oba przepisy po kolei w jednej sesji R, bo przepis 2 korzysta z obiektów z przepisu 1. Pierwszy przepis zapisuje też dane do pliku CSV, który możesz pobrać powyżej. Alfę liczy funkcja alpha() z pakietu psych, a modele CFA – funkcja cfa() z pakietu lavaan z argumentem ordered = TRUE, który traktuje pozycje jako porządkowe.
1. Wartości niemożliwe, odwrócenie pozycji, braki, rozkład i alfa
R
# Skala Samooceny Rosenberga: wynik, braki, wartości niemożliwe, rozkład i rzetelność (dane symulowane, set.seed(6610)).
# 312 osób studiujących pielęgniarstwo i fizjoterapię (I rok). Odpowiedzi zakodowane 1–4:
# 1 = zdecydowanie się nie zgadzam, 2 = nie zgadzam się, 3 = zgadzam się, 4 = zdecydowanie się zgadzam.
# Numeracja pozycji jak na stronie University of Maryland: pozycje odwrócone 3, 5, 8, 9, 10.
suppressPackageStartupMessages(library(psych))
set.seed(6610)
n <- 312
odwr <- c(3, 5, 8, 9, 10)                                   # pozycje odwrócone (UMD)
g <- rnorm(n); m <- rnorm(n)                                # samoocena ogólna i styl odpowiadania na pozycje negatywne
lg <- c(.72, .68, .70, .66, .62, .74, .71, .69, .65, .67)    # ładunki czynnika ogólnego
lmet <- ifelse(1:10 %in% odwr, .50, 0)                      # efekt metody tylko w pozycjach negatywnych
progi <- c(-2.0, -1.0, 0.45)                                 # przesunięte progi: większość osób się zgadza z pozycjami pozytywnymi
surowe <- sapply(1:10, function(j) {
  y <- lg[j] * g + lmet[j] * m + sqrt(1 - lg[j]^2 - lmet[j]^2) * rnorm(n)
  if (j %in% odwr) findInterval(-y, -rev(progi)) + 1         # zgoda z pozycją negatywną oznacza niższą samoocenę
  else findInterval(y, progi) + 1                            # kategorie 1–4
})
colnames(surowe) <- paste0("rses", 1:10)
dane <- data.frame(id = 1:n, kierunek = sample(c("pielęgniarstwo", "fizjoterapia"), n, TRUE, c(.55, .45)), surowe)
dane[sample(n, 9), "rses4"] <- NA                            # pojedyncze braki
dane[sample(n, 4), "rses8"] <- NA
dane[c(17, 140), c("rses2", "rses6", "rses9")] <- NA         # dwie osoby z trzema brakami
dane$rses7[203] <- 44                                        # literówka przy wprowadzaniu danych
table(dane$kierunek)
write.csv(dane, "../skala-samooceny-rosenberga-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

pozycje <- paste0("rses", 1:10)
# Krok 1. Wartości niemożliwe: wszystko poza 1–4 i brakiem
which(!is.na(as.matrix(dane[pozycje])) & !(as.matrix(dane[pozycje]) %in% 1:4), arr.ind = TRUE)
dane$rses7[dane$rses7 == 44] <- NA                           # nie zgadujemy, czy chodziło o 4 – wartość staje się brakiem
# Krok 2. Odwrócenie pozycji 3, 5, 8, 9, 10 i przekodowanie na 0–3 (jak na stronie UMD)
x <- as.matrix(dane[pozycje]) - 1                            # 0–3: 3 = zdecydowanie się zgadzam
x[, odwr] <- 3 - x[, odwr]                                   # max + min − x = 3 + 0 − x
# Krok 3. Braki: ile brakuje u każdej osoby
table(liczba_brakow = rowSums(is.na(x)))
# Umowna reguła tej pracy: przy 1 braku – średnia z 9 pozycji × 10, przy 2 i więcej – wynik nieobliczony
nb <- rowSums(is.na(x))
dane$rses_0_30 <- ifelse(nb <= 1, round(rowMeans(x, na.rm = TRUE) * 10, 1), NA)
dane$rses_10_40 <- dane$rses_0_30 + 10                       # wersja 1–4: zakres 10–40
summary(dane$rses_0_30)
# Krok 4. Opis rozkładu
w <- dane$rses_0_30
round(c(N = sum(!is.na(w)), M = mean(w, na.rm = TRUE), SD = sd(w, na.rm = TRUE), Me = median(w, na.rm = TRUE),
        min = min(w, na.rm = TRUE), max = max(w, na.rm = TRUE), skosnosc = skew(w, na.rm = TRUE)), 2)
round(100 * mean(w > 15, na.rm = TRUE), 1)                   # odsetek powyżej środka skali (15)
round(100 * mean(w == 30, na.rm = TRUE), 1)                  # odsetek z wynikiem maksymalnym
tapply(w, dane$kierunek, function(v) round(c(n = sum(!is.na(v)), M = mean(v, na.rm = TRUE), SD = sd(v, na.rm = TRUE)), 2))
# Krok 5. Rzetelność: alfa Cronbacha po odwróceniu i – dla pokazania błędu – bez odwrócenia
kompletne <- x[nb == 0, ]
nrow(kompletne)
a_dobrze <- alpha(kompletne)
round(a_dobrze$total[, c("raw_alpha", "std.alpha")], 3)
round(a_dobrze$item.stats[, "r.drop", drop = FALSE], 2)
bez_odwr <- as.matrix(dane[nb == 0, pozycje]) - 1            # te same osoby, pozycje nieodwrócone
round(alpha(bez_odwr, check.keys = FALSE, warnings = FALSE)$total$raw_alpha, 3)
round(cor(rowSums(bez_odwr), rowSums(kompletne)), 2)         # jak bardzo błędny wynik odbiega od poprawnego
Wynik w R
  fizjoterapia pielęgniarstwo
           143            169
     row col
[1,] 203   7
liczba_brakow
  0   1   3
296  14   2
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.    NA's
   6.00   18.00   22.00   21.51   26.00   30.00       2
       N        M       SD       Me      min      max skosnosc
  310.00    21.51     5.18    22.00     6.00    30.00    -0.54
[1] 85.8
[1] 2.3
$fizjoterapia
     n      M     SD
142.00  21.43   5.29

$pielęgniarstwo
     n      M     SD
168.00  21.59   5.09

[1] 296
 raw_alpha std.alpha
      0.89      0.89
       r.drop
rses1    0.58
rses2    0.58
rses3    0.71
rses4    0.49
rses5    0.67
rses6    0.58
rses7    0.57
rses8    0.69
rses9    0.69
rses10   0.72
[1] -0.074
[1] -0.22
2. Trzy modele CFA i porównanie z wynikiem sumarycznym
R
# CFA Skali Samooceny Rosenberga: jeden czynnik, dwa czynniki i czynnik ogólny z efektem metody (WLSMV).
# Korzysta z obiektów z przepisu 1 (x: pozycje 0–3 po odwróceniu, nb: liczba braków).
suppressPackageStartupMessages(library(lavaan))
d <- as.data.frame(x[nb == 0, ])                              # 296 osób bez braków
poz <- paste0("rses", c(1, 2, 4, 6, 7)); neg <- paste0("rses", c(3, 5, 8, 9, 10))
m1 <- 'samoocena =~ rses1 + rses2 + rses3 + rses4 + rses5 + rses6 + rses7 + rses8 + rses9 + rses10'
m2 <- 'pozytywne =~ rses1 + rses2 + rses4 + rses6 + rses7
       negatywne =~ rses3 + rses5 + rses8 + rses9 + rses10'
m3 <- 'samoocena =~ rses1 + rses2 + rses3 + rses4 + rses5 + rses6 + rses7 + rses8 + rses9 + rses10
       metoda_neg =~ rses3 + rses5 + rses8 + rses9 + rses10
       samoocena ~~ 0 * metoda_neg'
dopasuj <- function(model) cfa(model, data = d, ordered = TRUE, estimator = "WLSMV")
f1 <- dopasuj(m1); f2 <- dopasuj(m2); f3 <- dopasuj(m3)
wsk <- c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.scaled", "tli.scaled", "rmsea.scaled",
         "rmsea.ci.lower.scaled", "rmsea.ci.upper.scaled", "srmr")
round(rbind(jeden_czynnik = fitMeasures(f1, wsk), dwa_czynniki = fitMeasures(f2, wsk),
            ogolny_plus_metoda = fitMeasures(f3, wsk)), 3)
# Korelacja czynników w modelu dwuczynnikowym
st2 <- standardizedSolution(f2)
round(st2[st2$op == "~~" & st2$lhs == "pozytywne" & st2$rhs == "negatywne", c("est.std", "ci.lower", "ci.upper")], 2)
# Porównanie modeli zagnieżdżonych (skorygowany test różnicy chi-kwadrat)
lavTestLRT(f1, f2)
lavTestLRT(f1, f3)
# Ładunki standaryzowane w modelu 3
st3 <- standardizedSolution(f3)
l3 <- st3[st3$op == "=~", c("lhs", "rhs", "est.std")]
l3$est.std <- round(l3$est.std, 2)
reshape(l3, idvar = "rhs", timevar = "lhs", direction = "wide")
# Wynik sumaryczny a oszacowanie czynnika ogólnego z modelu 3
fs <- lavPredict(f3)
round(cor(rowSums(d), fs[, "samoocena"]), 3)
round(cor(rowSums(d[poz]), rowSums(d[neg])), 2)               # suma pozycji pozytywnych a negatywnych (po odwróceniu)
Wynik w R
                   chisq.scaled df.scaled pvalue.scaled cfi.scaled tli.scaled rmsea.scaled
jeden_czynnik            75.803        35         0.000      0.987      0.984        0.063
dwa_czynniki             31.930        34         0.569      1.000      1.001        0.000
ogolny_plus_metoda       25.014        30         0.724      1.000      1.002        0.000
                   rmsea.ci.lower.scaled rmsea.ci.upper.scaled  srmr
jeden_czynnik                      0.043                 0.082 0.049
dwa_czynniki                       0.000                 0.039 0.030
ogolny_plus_metoda                 0.000                 0.034 0.026
   est.std ci.lower ci.upper
53    0.85     0.79     0.91

Scaled and Shifted Chi-Squared Difference Test (method = “satorra.2000”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the robust test that
   should be reported per model. A robust difference test is a function of two standard (not
   robust) statistics.

   Df AIC BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
f2 34         16.288
f1 35         43.718      19.59 0.29882       1  9.595e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Scaled and Shifted Chi-Squared Difference Test (method = “satorra.2000”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the robust test that
   should be reported per model. A robust difference test is a function of two standard (not
   robust) statistics.

   Df AIC BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
f3 30         12.053
f1 35         43.718     37.441 0.13423       5  4.886e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
      rhs est.std.samoocena est.std.metoda_neg
1   rses1              0.72                 NA
2   rses2              0.72                 NA
3   rses3              0.73               0.45
4   rses4              0.60                 NA
5   rses5              0.67               0.47
6   rses6              0.72                 NA
7   rses7              0.71                 NA
8   rses8              0.70               0.52
9   rses9              0.70               0.46
10 rses10              0.77               0.33
[1] 0.982
[1] 0.69
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy skali Rosenberga
- Brak odwrócenia pozycji albo odwrócenie niewłaściwych. Objawem jest niska lub ujemna alfa i ujemne korelacje pozycja–reszta. Sprawdź klucz w źródle swojej wersji, bo kolejność pozycji bywa różna.
- Zakres wyniku bez informacji o punktacji. Średnia 21 przy punktacji 0–3 to co innego niż 21 przy punktacji 1–4. Zawsze podaj zakres.
- Wymyślone progi. Skala nie ma oficjalnych punktów odcięcia (University of Maryland, Department of Sociology, b.d.-b). Nie pisz o „odsetku osób z niską samooceną” na podstawie progu bez źródła.
- Sumowanie dostępnych pozycji przy brakach. Osoba, która pominęła dwie pozycje, dostaje wtedy zaniżony wynik. Przyjmij regułę dla braków i ją opisz.
- Dwa wyniki „pozytywny” i „negatywny” liczone dlatego, że EFA dała dwa czynniki. Taki podział często odzwierciedla sposób sformułowania pozycji, a nie dwie odrębne cechy (Marsh, 1996). Jeśli chcesz o tym pisać, uzasadnij to teoretycznie i modelem z czynnikiem metody.
- Środek skali jako „przeciętna”. W wielu krajach większość badanych ma wyniki powyżej środka skali (Schmitt i Allik, 2005), więc ten punkt nie wyznacza przeciętnej samooceny.
- Przedruk pozycji w aneksie. Nie przepisuj treści pozycji z cudzego przekładu bez sprawdzenia warunków u autorów adaptacji. W pracy wystarczy opis narzędzia i źródło.
Jeśli chcesz, żeby ktoś sprawdził Twój klucz, rzetelność albo model CFA, zanim oddasz rozdział, zobacz, jak wygląda pomoc w analizie danych do pracy dyplomowej. Podobne poradniki dla innych krótkich skal: skala SWLS, PSS-10 oraz GAD-7 i PHQ-9.
Najczęstsze pytania
Które pozycje w skali Rosenberga są odwrócone?
W numeracji ze strony University of Maryland odwrócone są pozycje 3, 5, 8, 9 i 10, czyli te, w których zgoda oznacza niższą samoocenę. Przy punktacji 0–3 zamieniasz w nich 0 na 3, 1 na 2 itd., a przy punktacji 1–4 liczysz 5 − x. Jeśli korzystasz z przekładu, sprawdź kolejność pozycji w jego źródle i rozpoznawaj pozycje odwrócone po treści.
Jaki jest zakres wyników w Skali Samooceny Rosenberga?
Przy punktacji 0–3 wynik ogólny mieści się w zakresie 0–30, a przy punktacji 1–4 – w zakresie 10–40. Obie wersje są poprawne i różnią się o stałą 10. W pracy zawsze napisz, którą punktację przyjęto, bo bez tego średniej nie da się porównać z innymi badaniami.
Od ilu punktów zaczyna się niska samoocena w skali Rosenberga?
Skala nie ma oficjalnych punktów odcięcia dla niskiej i wysokiej samooceny. Strona University of Maryland zaleca porównywanie wyników z literaturą dotyczącą podobnej populacji. Nie stosuj progów podawanych bez źródła i nie traktuj wyniku jako diagnozy. Jeśli musisz wyznaczyć poziomy, opisz, jak to zrobiono (zob. niski, przeciętny, wysoki wynik).
Czy skala Rosenberga jest jednoczynnikowa?
W części analiz czynnikowych pozycje pozytywne i odwrócone tworzą dwa osobne czynniki. Badania CFA pokazują jednak, że dane dobrze opisuje jeden czynnik samooceny z dodatkowym efektem metody dla pozycji sformułowanych negatywnie (Marsh, 1996; Tomás i Oliver, 1999). Dlatego zwykle liczy się jeden wynik ogólny.
Jaka jest rzetelność Skali Samooceny Rosenberga?
Strona University of Maryland podaje, że alfa Cronbacha w różnych próbach wynosi zwykle od .77 do .88, a rzetelność test–retest od .82 do .88. W pracy podaj jednak alfę (lub omegę) policzoną na własnej próbie, po odwróceniu pozycji. Ujemna alfa prawie zawsze oznacza nieodwrócone pozycje.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikNiski, przeciętny, wysoki wynik
Steny, punkty odcięcia, podział skali i tercyle na jednym przykładzie: odsetki z CI, wady podziału z próby, wynik ciągły zamiast poziomów i wzór opisu.
Czytaj →PoradnikOpis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →Liczysz wynik skali Rosenberga do pracy dyplomowej?
Sprawdzimy klucz, braki i rzetelność, a w razie potrzeby model CFA, i wyjaśnimy wyniki tak, żebyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- DiStefano, C., & Motl, R. W. (2006). Further investigating method effects associated with negatively worded items on self-report surveys. Structural Equation Modeling: A Multidisciplinary Journal, 13(3), 440–464. https://doi.org/10.1207/s15328007sem1303_6
- Donnellan, M. B., Ackerman, R. A., & Brecheen, C. (2016). Extending structural analyses of the Rosenberg Self-Esteem Scale to consider criterion-related validity: Can composite self-esteem scores be good enough? Journal of Personality Assessment, 98(2), 169–177. https://doi.org/10.1080/00223891.2015.1058268
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Marsh, H. W. (1996). Positive and negative global self-esteem: A substantively meaningful distinction or artifactors? Journal of Personality and Social Psychology, 70(4), 810–819. https://doi.org/10.1037/0022-3514.70.4.810
- Rosenberg, M. (1965). Society and the adolescent self-image. Princeton University Press. https://doi.org/10.1515/9781400876136
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Schmitt, D. P., & Allik, J. (2005). Simultaneous administration of the Rosenberg Self-Esteem Scale in 53 nations: Exploring the universal and culture-specific features of global self-esteem. Journal of Personality and Social Psychology, 89(4), 623–642. https://doi.org/10.1037/0022-3514.89.4.623
- Tomás, J. M., & Oliver, A. (1999). Rosenberg's self-esteem scale: Two factors or method effects. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 84–98. https://doi.org/10.1080/10705519909540120
- University of Maryland, Department of Sociology. (b.d.-a). Using the Rosenberg Self-Esteem Scale. Department of Sociology, University of Maryland. https://socy.umd.edu/about-us/using-rosenberg-self-esteem-scale ● Otwarty dostęp
- University of Maryland, Department of Sociology. (b.d.-b). Rosenberg Scale FAQ. Department of Sociology, University of Maryland. https://socy.umd.edu/quick-links/rosenberg-scale-faq-0 ● Otwarty dostęp
Cytowania BibTeX
@article{distefano2006further, author={DiStefano, Christine and Motl, Robert W.}, title={{Further investigating method effects associated with negatively worded items on self-report surveys}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2006}, volume={13}, number={3}, pages={440--464}, doi={10.1207/s15328007sem1303_6}}@article{donnellan2016extending, author={Donnellan, M. Brent and Ackerman, Robert A. and Brecheen, Courtney}, title={{Extending structural analyses of the Rosenberg Self-Esteem Scale to consider criterion-related validity: Can composite self-esteem scores be good enough?}}, journal={Journal of Personality Assessment}, year={2016}, volume={98}, number={2}, pages={169--177}, doi={10.1080/00223891.2015.1058268}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{marsh1996positive, author={Marsh, Herbert W.}, title={{Positive and negative global self-esteem: A substantively meaningful distinction or artifactors?}}, journal={Journal of Personality and Social Psychology}, year={1996}, volume={70}, number={4}, pages={810--819}, doi={10.1037/0022-3514.70.4.810}}@book{rosenberg1965society, author={Rosenberg, Morris}, title={{Society and the adolescent self-image}}, year={1965}, publisher={Princeton University Press}, doi={10.1515/9781400876136}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{schmitt2005simultaneous, author={Schmitt, David P. and Allik, Jüri}, title={{Simultaneous administration of the Rosenberg Self-Esteem Scale in 53 nations: Exploring the universal and culture-specific features of global self-esteem}}, journal={Journal of Personality and Social Psychology}, year={2005}, volume={89}, number={4}, pages={623--642}, doi={10.1037/0022-3514.89.4.623}}@article{tomas1999rosenberg, author={Tomás, José M. and Oliver, Amparo}, title={{Rosenberg's self-esteem scale: Two factors or method effects}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={84--98}, doi={10.1080/10705519909540120}}@misc{umdndusing, author={{University of Maryland, Department of Sociology}}, title={{Using the Rosenberg Self-Esteem Scale}}, howpublished={Department of Sociology, University of Maryland}, year={b.d.-a}, publisher={University of Maryland}, url={https://socy.umd.edu/about-us/using-rosenberg-self-esteem-scale}}@misc{umdndfaq, author={{University of Maryland, Department of Sociology}}, title={{Rosenberg Scale FAQ}}, howpublished={Department of Sociology, University of Maryland}, year={b.d.-b}, publisher={University of Maryland}, url={https://socy.umd.edu/quick-links/rosenberg-scale-faq-0}}