Niski, przeciętny, wysoki: po co poziomy i skąd je wziąć
W wielu pracach dyplomowych pojawia się zdanie w rodzaju: „Większość badanych (58%) prezentowała przeciętny poziom poczucia skuteczności, 24% – wysoki, a 18% – niski”. Promotor pyta wtedy: według jakich granic? Odpowiedź „podzieliłam wyniki na trzy równe części” albo „według tercyli” może być poprawna. Każdy z tych sposobów odpowiada jednak na inne pytanie i daje inne odsetki. Czasem też różni się wnioskiem.
Poziomy wyniku wyznacza się na cztery sposoby. Kolejność nie jest przypadkowa: od granic najlepiej uzasadnionych do najsłabiej uzasadnionych.
| Sposób | Skąd granice | Na jakie pytanie odpowiada | Główne ograniczenie |
|---|---|---|---|
| 1. Normy z podręcznika (steny, staniny, centyle) | Rozkład wyników w próbie normalizacyjnej | Jak wynik osoby wypada na tle populacji odniesienia? | Tylko dla narzędzi z normami pasującymi do Twojej grupy |
| 2. Punkty odcięcia z literatury | Badanie walidacyjne z kryterium zewnętrznym | Czy wynik wskazuje na prawdopodobny problem, który warto sprawdzić? | Przesiew, nie rozpoznanie; próg zależy od populacji |
| 3. Podział teoretyczny skali | Równe części zakresu odpowiedzi | Gdzie na skali odpowiedzi leży wynik? | Granice umowne, bez związku z populacją |
| 4. Podział z próby (tercyle, M ± 1 SD) | Rozkład w Twojej własnej próbie | Kto w tej próbie ma wynik niższy lub wyższy niż inni? | Zależy od próby i wyrzuca informację |
Zanim zaczniesz, ustal, po co Ci poziomy. Do opisu próby, czyli do odpowiedzi na pytanie, ilu badanych ma wysoki wynik, poziomy bywają przydatne. Do testowania hipotez prawie zawsze lepszy jest wynik ciągły, co pokażemy na liczbach w dalszej części. Sam wynik musi być oczywiście najpierw dobrze policzony. Klucz, pozycje odwrócone i reguły braków opisuje poradnik jak policzyć wynik kwestionariusza krok po kroku.
Badanie przykładowe: fikcyjna skala SSĆ-8 w rehabilitacji
Przykład pochodzi z fizjoterapii. W pracy magisterskiej zbadano 220 pacjentów oddziału rehabilitacji po endoprotezoplastyce stawu kolanowego. Pacjenci wypełnili Skalę Skuteczności w Ćwiczeniach (SSĆ-8) – narzędzie fikcyjne, wymyślone na potrzeby tego poradnika. SSĆ-8 ma 8 pozycji ocenianych od 1 do 5. Wynikiem jest średnia pozycji, a wyższy wynik oznacza silniejsze przekonanie, że pacjent poradzi sobie z ćwiczeniami domowymi. Po sześciu tygodniach zanotowano adherencję, czyli odsetek zaleconych sesji ćwiczeń domowych, które pacjent wykonał.
Średni wynik SSĆ-8 wynosił M = 3.14 (SD = 0.80, mediana 3.125, zakres 1.125–4.875). Adherencja wynosiła średnio 63.05% (SD = 16.25). Do porównania mamy drugą próbę: 220 uczestników zajęć ruchowych w klubie seniora. Mają oni wyraźnie wyższe wyniki SSĆ-8 (M = 3.67, SD = 0.78). Dane obu prób są symulowane i możesz je pobrać jako plik poziomy-wynikow-dane.csv (kolumny proba, id, ssc, adherencja).
Sposób 1. Normy z podręcznika: steny, staniny i centyle
Normy testowe to tabele, które przekładają wynik surowy na pozycję osoby w populacji odniesienia. Najczęściej spotkasz:
- steny – skalę 1–10 o średniej 5.5 i odchyleniu 2;
- staniny – skalę 1–9 o średniej 5 i odchyleniu 2;
- rangi centylowe, które mówią, jaki odsetek populacji ma wynik niższy.
Słowne kategorie przypisuje się przedziałom tych skal. Często spotykana konwencja dla stenów to 1–3 wynik niski, 4–7 przeciętny i 8–10 wysoki. Dla staninów to 1–3, 4–6 i 7–9. W pracy stosuj jednak podział z podręcznika Twojego narzędzia, bo różne podręczniki przyjmują różne przedziały.
Normy mają przewagę nad pozostałymi sposobami: odnoszą wynik do jasno opisanej populacji, a nie do przypadkowej grupy osób w Twoim badaniu. Standardy testowania wymagają, by raport z normalizacji podawał populację, sposób doboru próby, daty badania i precyzję norm (American Educational Research Association i in., 2014). Z tego wynikają dwa warunki użycia norm w pracy:
- Normy muszą pasować do Twojej grupy pod względem wieku, płci i rodzaju populacji. Normy dla dorosłych z populacji ogólnej nie opisują dobrze pacjentów oddziału rehabilitacji.
- Do przeliczeń używasz średniej i odchylenia z populacji normalizacyjnej, a nie z własnej próby (Andrade, 2021). Gdy podręcznik podaje gotowe tabele przeliczeniowe, korzystaj z tabel, a nie ze wzoru.
W przykładzie przyjmujemy fikcyjne normy (M = 3.10, SD = 0.75) wyłącznie po to, by pokazać rachunek. Nie są to normy żadnego istniejącego narzędzia. Sten to zaokrąglona wartość 5.5 + 2z, gdzie z = (wynik − 3.10) / 0.75, obcięta do przedziału 1–10. Sten 3 lub niższy dostają więc osoby z wynikiem poniżej 2.35 (z < −1), a sten 8 lub wyższy – osoby z wynikiem od 3.85 wzwyż (z ≥ 1). Wyniki niskie miało 14.1% pacjentów, przeciętne 63.6%, a wysokie 22.3%. W populacji normalizacyjnej o rozkładzie normalnym spodziewalibyśmy się około 16% wyników niskich i 16% wysokich. To właśnie te odsetki są punktem odniesienia przy interpretacji Twojej próby.
Normy też mają niepewność. Crawford i in. (2009) zwracają uwagę, że współistnieją trzy definicje rangi centylowej. Mogą one dawać wyraźnie różne wyniki, a oszacowanie pozycji wyniku na podstawie próby normalizacyjnej zawsze obarczone jest błędem. Oosterhuis i in. (2016) pokazali, że do wiarygodnych norm potrzebne są duże próby, choć normy regresyjne wymagają mniejszych prób niż tradycyjne tabele dla podgrup. Jak powstają normy, opisuje hasło normalizacja. O licencjach i dostępie do podręczników piszemy w poradniku gdzie znaleźć kwestionariusze psychologiczne.
Sposób 2. Punkty odcięcia z literatury
Punkt odcięcia dzieli wyniki na dwie grupy, zwykle „poniżej progu” i „od progu wzwyż”. W odróżnieniu od norm nie mówi, jak wynik wypada na tle populacji. Mówi tylko, czy wynik wskazuje na prawdopodobną obecność stanu, który zmierzono niezależnym kryterium, np. wywiadem klinicznym. Taki próg wyznacza się w badaniu walidacyjnym, najczęściej z krzywej ROC, szukając kompromisu między czułością i swoistością, np. indeksem Youdena.
Trzy zasady pracy z punktami odcięcia:
- Podawaj próg tylko ze źródła i z cytowaniem, najlepiej z publikacji autorów narzędzia albo z badania walidacyjnego w podobnej populacji. Nie wymyślaj progu i nie przenoś go z innego narzędzia.
- Wynik powyżej progu przesiewowego to nie rozpoznanie. W pracy pisz o „wynikach wskazujących na podwyższone ryzyko” albo „wynikach powyżej punktu odcięcia”, a nie o „osobach z depresją” czy „pacjentach z zaburzeniem”. Przykłady takich progów i ich opis omawiamy we wpisie o GAD-7 i PHQ-9.
- Uważaj na progi „optymalne” wyznaczone na tych samych danych. Leeflang i in. (2008) pokazali, że wybór progu na podstawie danych daje zbyt optymistyczną czułość i swoistość, zwłaszcza w małych badaniach. Taki próg trzeba sprawdzić na niezależnej próbie (Naggara i in., 2011).
McNeish i Wolf (2020) dodają jeszcze jedno zastrzeżenie: sposób liczenia wyniku wpływa na klasyfikację według progu. Prosta suma pozycji może inaczej przydzielać osoby do grup niż wynik z modelu pomiarowego. Licz więc wynik dokładnie tak, jak liczono go w badaniu, z którego pochodzi próg.
W przykładzie przyjmujemy fikcyjny próg 2.50 z równie fikcyjnego badania walidacyjnego. Poniżej progu znalazło się 42 pacjentów, czyli 19.1%, 95% CI [14.4, 24.8]. Przedział ufności liczymy metodą Wilsona (zob. przedział ufności dla proporcji). Przy 220 osobach jego szerokość przekracza 10 punktów procentowych, więc odsetek z próby to tylko przybliżenie odsetka w populacji.
Sposób 3. Podział teoretyczny skali
Gdy narzędzie nie ma norm ani progów, a tak jest w przypadku większości ankiet własnych, studenci często dzielą zakres odpowiedzi na trzy równe części. Dla średniej z pozycji 1–5 zakres ma długość 4, więc każda część ma 4/3 ≈ 1.33 punktu. Granice wypadają w punktach 2.33 i 3.67, a typowy zapis to 1–2.33 (niski), 2.34–3.66 (przeciętny) i 3.67–5 (wysoki).
Taki podział mówi, gdzie na skali odpowiedzi leży wynik. Średnia 2.0 oznacza, że osoba przeciętnie wybierała odpowiedź „raczej się nie zgadzam”. Ten sposób dobrze łączy się z POMP, czyli przeliczeniem wyniku na procent maksymalnego możliwego wyniku. Cohen i in. (1999) pokazują, że POMP w wielu sytuacjach daje użyteczną informację, której nie niosą jednostki standaryzowane. Trzy równe części skali to po prostu POMP 0–33.3, 33.3–66.7 i 66.7–100.
Ograniczenia trzeba jednak nazwać wprost:
- Granice są umowne. Nic nie wskazuje, że „niski” poziom kończy się akurat w punkcie 2.33. Równie dobrze można by przyjąć podział na pięć części albo inne granice. Wybór musisz uzasadnić i opisać przed analizą.
- „Przeciętny” oznacza tu środek skali, a nie przeciętnego pacjenta. Jeśli prawie wszyscy odpowiadają „zgadzam się”, większość próby trafi do poziomu wysokiego. To informacja o rozkładzie odpowiedzi, a nie o tym, że badani wyróżniają się na tle populacji.
- Zapis granic z dwoma miejscami po przecinku zostawia luki. Średnia trzech pozycji może wynosić 2.333…, a więc mniej niż 2.34 i więcej niż 2.33. Granice zapisz jako ułamki albo jednoznaczne przedziały: niski od 1 do 7/3 włącznie, przeciętny powyżej 7/3 do 11/3 włącznie, wysoki powyżej 11/3. W SSĆ-8 średnie są wielokrotnościami 0.125, więc problem nie wystąpił. W skalach o innej liczbie pozycji trzeba go jednak rozwiązać.
W przykładzie podział teoretyczny dał 14.1% wyników niskich, 59.1% przeciętnych i 26.8% wysokich.
Sposób 4. Podział z próby: tercyle i M ± 1 SD
Ostatni sposób wyznacza granice z rozkładu w Twojej własnej próbie. Popularne są dwie wersje:
- tercyle, czyli punkty, poniżej których leży 1/3 i 2/3 wyników. Założenie jest takie, że każdy poziom obejmuje mniej więcej jedną trzecią próby;
- M ± 1 SD: wynik niski to wynik poniżej średniej minus jedno odchylenie standardowe, wysoki – od średniej plus jedno odchylenie wzwyż. Przy rozkładzie normalnym daje to w przybliżeniu 16%, 68% i 16% osób.
W przykładzie tercyle wynoszą 2.75 i 3.50. Proporcje nie wyszły jednak równe: 36.4%, 32.7% i 30.9%. Przyczyną są remisy. Wynik dokładnie 2.75 ma 10 osób i wynik dokładnie 3.50 również 10 osób. To, czy trafią do niższego, czy wyższego poziomu, zależy wyłącznie od tego, czy granica jest „włącznie”, czy „wyłącznie”. Programy liczą też kwantyle różnymi metodami. W R funkcja quantile() ma dziewięć typów i dla innych danych mogą one dać różne granice. W tym przykładzie typy 6 i 7 dały te same wartości. M ± 1 SD dało granice 2.34 i 3.95 oraz odsetki 14.1%, 65.9% i 20.0%. Rozkład jest lekko asymetryczny, więc proporcje odbiegają od 16/68/16.
Zwróć uwagę na granice M ± 1 SD. Wyglądają podobnie do granic ze stenów (2.35 i 3.85), bo tamte też leżą w odległości jednego odchylenia od średniej. Są to jednak średnia i odchylenie Twojej próby, a nie populacji normalizacyjnej. Dlatego dolna granica prawie się pokrywa, a górna już nie: 3.95 zamiast 3.85.
Ten sam wynik, pięć klasyfikacji
Rysunek 1 pokazuje jeden rozkład wyników SSĆ-8 podzielony pięcioma sposobami. Odsetek wyników „niskich” waha się od 14.1% do 36.4%, a „wysokich” od 20.0% do 30.9%. Dane są te same. Zmieniła się tylko reguła.
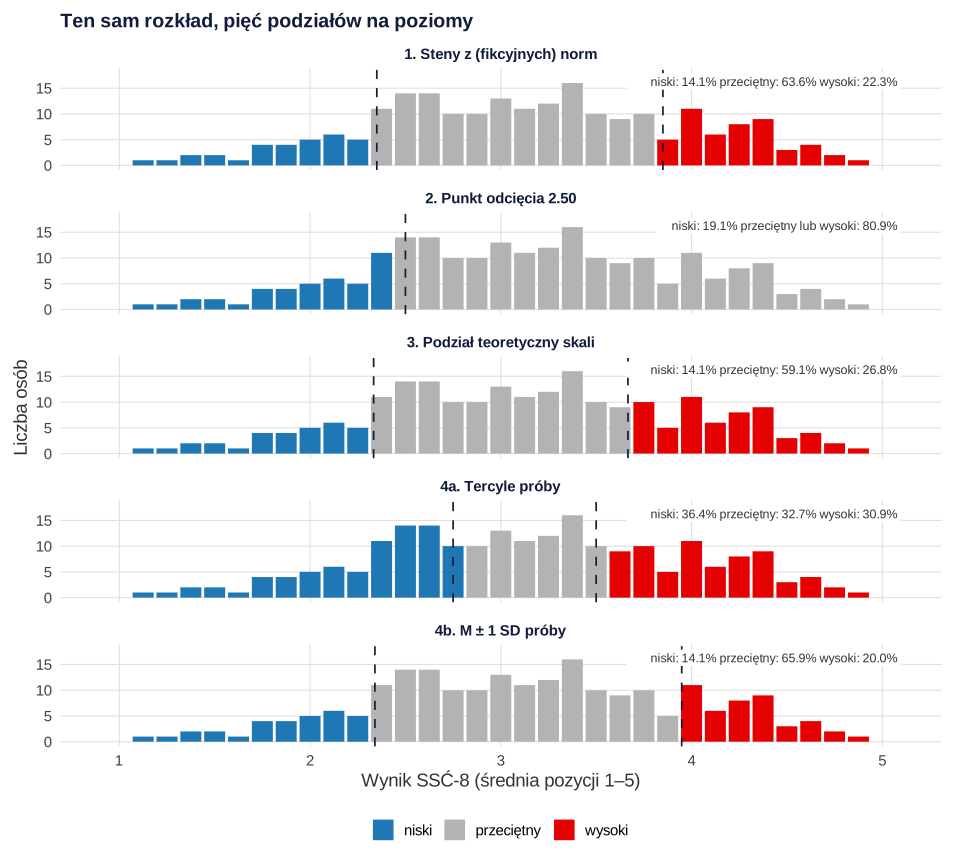
Klasyfikacje różnią się nie tylko odsetkami, ale też tym, kto trafia do którego poziomu. Tercyle i steny przypisały do tego samego poziomu 152 z 220 osób (69%). 49 osób, które według stenów mają wynik przeciętny, według tercyli ma wynik niski. Podział teoretyczny i M ± 1 SD zgodziły się u 205 osób. Tabela 1 zbiera odsetki z przedziałami ufności w formie gotowej do pracy.
Tabela 1
Odsetek pacjentów z niskim, przeciętnym i wysokim wynikiem SSĆ-8 według czterech sposobów wyznaczania poziomów
| Sposób (granice) | Niski, % [95% CI] | Przeciętny, % [95% CI] | Wysoki, % [95% CI] |
|---|---|---|---|
| Steny z norm (1–3 / 4–7 / 8–10)a | 14.1 [10.1, 19.3] | 63.6 [57.1, 69.7] | 22.3 [17.3, 28.2] |
| Punkt odcięcia (< 2.50)a | 19.1 [14.4, 24.8] | 80.9 [75.2, 85.6]b | |
| Podział teoretyczny (2.33 / 3.67) | 14.1 [10.1, 19.3] | 59.1 [52.5, 65.4] | 26.8 [21.4, 33.0] |
| Tercyle próby (2.75 / 3.50) | 36.4 [30.3, 42.9] | 32.7 [26.9, 39.2] | 30.9 [25.2, 37.3] |
| M ± 1 SD próby (2.34 / 3.95) | 14.1 [10.1, 19.3] | 65.9 [59.4, 71.9] | 20.0 [15.2, 25.8] |
Uwaga. N = 220. Przedziały ufności metodą Wilsona. Dane symulowane.
a Fikcyjne normy (M = 3.10, SD = 0.75) i fikcyjny punkt odcięcia, użyte wyłącznie do ilustracji.
b Wynik równy punktowi odcięcia lub wyższy.
W pracy nie pokazuj wszystkich pięciu podziałów, bo to tylko ilustracja. Wybierz jeden sposób, uzasadnij go i trzymaj się go w całej pracy. Jeśli narzędzie ma normy pasujące do Twojej grupy, wybierz normy. Jeśli ma zwalidowany próg przesiewowy, a pytanie dotyczy przesiewu – wybierz próg. Podział teoretyczny i podział z próby zostaw na sytuacje, w których nie ma ani norm, ani progu, i opisz je jako umowne.
Wady podziału z próby: zależność od próby i utrata informacji
Ten sam wynik, inny poziom w innej próbie
Tercyle i M ± 1 SD opisują pozycję osoby w tej konkretnej próbie. Gdy próba się zmienia, zmieniają się granice. Rysunek 2 pokazuje to na dwóch próbach o różnym rozkładzie. Wśród pacjentów po endoprotezoplastyce tercyle wynoszą 2.75 i 3.50, a wśród uczestników zajęć w klubie seniora – 3.375 i 4.00. Pacjent z wynikiem 3.25 ma więc wynik „przeciętny” w pierwszej próbie i „niski” w drugiej. Osoba z wynikiem 3.625 ma wynik „wysoki” wśród pacjentów, a „przeciętny” wśród seniorów. Według fikcyjnych norm oba wyniki są przeciętne w każdej próbie (sten 6 i sten 7).
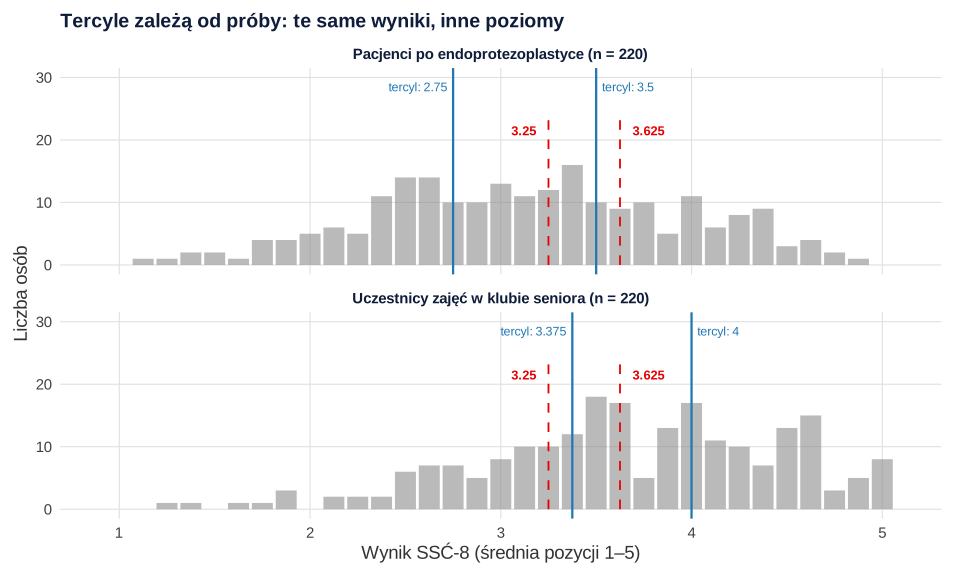
Z tego wynika praktyczny zakaz: nie porównuj odsetków „wysokich” wyników między badaniami, jeśli każde liczyło tercyle ze swojej próby. Z definicji w każdej próbie wyjdzie około jednej trzeciej. Gdyby seniorów ocenić granicami z próby pacjentów, wysokie wyniki miałoby 56.4% z nich. Według ich własnych tercyli – 32.7%. Bennette i Vickers (2012) krytykują rutynowe dzielenie zmiennych na tercyle, kwartyle i kwintyle właśnie dlatego, że granice zależą od próby, a wyniki trudno porównywać między badaniami.
Utrata informacji i mocy
Każdy podział zamienia wiele różnych wyników na jedną etykietę. Pacjent z wynikiem 2.875 i pacjent z wynikiem 3.50 mają ten sam poziom „przeciętny”, choć różnią się bardziej niż pacjenci z wynikami 3.50 i 3.625, którzy trafiają do różnych poziomów. MacCallum i in. (2002) pokazują, że dychotomizacja zmiennych ilościowych rzadko daje się obronić i często prowadzi do mylących wyników. Cohen (1983) obliczył, że podział jednej zmiennej w punkcie średniej zmniejsza wyjaśnianą wariancję do .647 wartości wyjściowej. Pod względem mocy to tak, jakby odrzucić 38% obserwacji. Royston i in. (2006) dodają, że dychotomizacja osłabia też kontrolę zmiennych zakłócających. Maxwell i Delaney (1993) pokazali z kolei, że podział dwóch predyktorów naraz może dać pozornie istotne efekty. Więcej o tym w hasłach dzielenie medianą i moc testu.
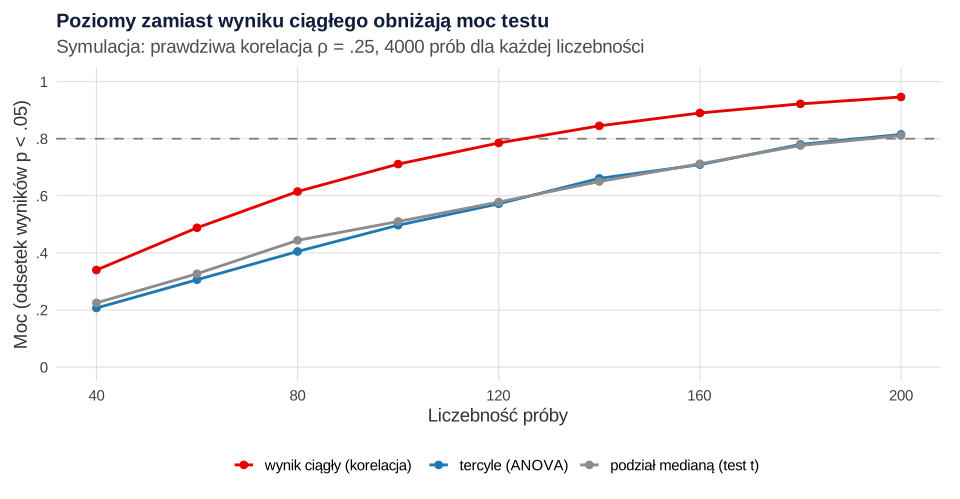
Rysunek 3 pokazuje to w symulacji. Przy prawdziwej korelacji ρ = .25 i 100 osobach test korelacji wykrył związek w 71.1% prób. ANOVA na tercylach wykryła go w 49.7%, a test t po podziale medianą w 51.0%. Moc .80 test korelacji osiągnął już przy 140 osobach, a obie analizy na poziomach dopiero przy 200. Średnia korelacja po podziale medianą wyniosła .197 zamiast .247, czyli 0.797 wartości wyjściowej. To zgodne z wynikiem Cohena (1983), bo √.647 ≈ 0.80.
Do tego dochodzi błąd pomiaru. Wynik osoby leżący tuż przy granicy może w powtórnym badaniu trafić po drugiej stronie, choć jej poziom cechy się nie zmienił. Im mniejsza rzetelność skali, tym częściej tak się dzieje. Hasło skala stenowa pokazuje to na przykładzie przedziału ufności wokół stena, a hasło standardowy błąd pomiaru wyjaśnia, skąd bierze się ta niepewność.
Analizy z wynikiem ciągłym zamiast poziomów
Załóżmy, że hipoteza brzmi: pacjenci z wyższym poczuciem skuteczności częściej wykonują zalecone ćwiczenia. Można ją sprawdzić na trzy sposoby. Wynik z każdego z nich zebrano w tabeli.
| Analiza | Wynik | Wariancja adherencji wyjaśniona |
|---|---|---|
| Korelacja Pearsona / regresja liniowa z wynikiem ciągłym | r = .45, 95% CI [.34, .55], p < .001; b = 9.07, 95% CI [6.66, 11.48] | 20.2% |
| ANOVA z tercylami | F(2, 217) = 25.92, p < .001, η² = .19 | 19.3% |
| Test t Welcha po podziale medianą (3.125) | t(217.18) = −5.50, p < .001 | 12.2% |
Wszystkie trzy analizy są tu istotne, bo próba jest duża, a związek wyraźny. Różnią się jednak tym, co mówią. Regresja podaje wielkość efektu w jednostkach, które można wprost zinterpretować. Każdy punkt SSĆ-8 wiąże się średnio z adherencją wyższą o 9.07 punktu procentowego. ANOVA mówi tylko, że średnie trzech grup się różnią (56.65%, 60.35% i 73.45%). Sugeruje przy tym schodkowy związek, którego w danych nie ma. Podział medianą wyjaśnia już tylko 12.2% wariancji zamiast 20.2%. W mniejszej próbie albo przy słabszym związku taka strata decyduje o tym, czy wynik będzie istotny.
Dlatego hipotezy testuj na wyniku ciągłym: korelacją, regresją, a przy porównaniu grup – modelem z wynikiem jako predyktorem albo zmienną zależną. Poziomy zostaw do opisu próby. Jeśli promotor prosi o grupy, możesz je dodać jako analizę uzupełniającą i napisać, że wnioski opierasz na analizie wyniku ciągłego (Naggara i in., 2011; Royston i in., 2006). Gdy chcesz pokazać nieliniowy związek, zamiast kategorii użyj regresji z członem kwadratowym albo splajnami. Bennette i Vickers (2012) omawiają te alternatywy.
Jak opisać poziomy wyniku w pracy
Opis musi odpowiadać na trzy pytania: skąd pochodzą granice, jak wyglądały odsetki z przedziałami ufności i na czym oparto testy hipotez. Poniżej dwa wzory. Pierwszy dotyczy narzędzia z normami, drugi – ankiety własnej bez norm. W miejsca w nawiasach kwadratowych wstaw dane swojego narzędzia. Liczby w drugim wzorze pochodzą z przykładu.
Jeśli używasz tercyli albo M ± 1 SD, napisz to wprost i dodaj, że granice wyznaczono w badanej próbie, więc odsetków nie należy porównywać z innymi badaniami. Podaj też wartości granic i sposób traktowania wyników równych granicy. Jak przedstawić statystyki opisowe wyników, pokazuje poradnik statystyki opisowe w pracy. Pełny opis narzędzia, z normami i licencją, opisujemy we wpisie opis narzędzia badawczego w pracy.
Poziomy wyniku w R
Przepis wczytuje plik z danymi do pobrania i wyznacza poziomy czterema sposobami. Dla każdego liczy odsetki z 95% przedziałami ufności Wilsona (funkcja BinomCI() z pakietu DescTools), a na końcu porównuje regresję z wynikiem ciągłym z ANOVA na tercylach. Zależność od próby, test t po podziale medianą i porównanie klasyfikacji liczy skrypt b61-1-poziomy.R, a symulację mocy – b61-2-symulacja.R (set.seed(6120)).
Cztery sposoby wyznaczania poziomów i wynik ciągły
R
library(DescTools)                                  # BinomCI(): przedział Wilsona dla odsetka
d <- read.csv("poziomy-wynikow-dane.csv")           # plik do pobrania ze strony wpisu
p <- d[d$proba == "pacjenci", ]
x <- p$ssc; poz <- c("niski", "przeciętny", "wysoki")

# 1. Steny z norm podręcznika (tu: FIKCYJNE normy M = 3.10, SD = 0.75); 1–3 / 4–7 / 8–10
sten <- pmin(10, pmax(1, round(5.5 + 2 * (x - 3.10) / 0.75)))
p$normy <- cut(sten, c(0, 3, 7, 10), labels = poz)
# 2. Punkt odcięcia z literatury (tu: FIKCYJNY punkt 2.50)
p$odciecie <- ifelse(x < 2.50, "poniżej", "co najmniej 2.50")
# 3. Podział teoretyczny skali 1–5 na trzy równe części
p$teoria <- cut(x, c(1, 7/3, 11/3, 5), labels = poz, include.lowest = TRUE)
# 4. Podział z próby: tercyle i M ± 1 SD
p$tercyle <- cut(x, c(-Inf, quantile(x, c(1/3, 2/3)), Inf), labels = poz)
p$m_sd <- cut(x, c(-Inf, mean(x) + c(-1, 1) * sd(x), Inf), labels = poz, right = FALSE)

# Odsetki z 95% CI (Wilson) dla każdej metody
for (m in c("normy", "odciecie", "teoria", "tercyle", "m_sd")) {
  t <- table(p[[m]]); cat("\n", m, "\n"); print(round(100 * BinomCI(t, sum(t), method = "wilson"), 1))
}

# Zamiast poziomów: wynik ciągły w regresji i dla porównania ANOVA na tercylach
m1 <- lm(adherencja ~ ssc, data = p)
round(c(summary(m1)$coefficients["ssc", ], R2 = summary(m1)$r.squared), 3)
round(confint(m1)["ssc", ], 2)
summary(aov(adherencja ~ tercyle, data = p))
Wynik w R
 normy
            est lwr.ci upr.ci
niski      14.1   10.1   19.3
przeciętny 63.6   57.1   69.7
wysoki     22.3   17.3   28.2

 odciecie
                  est lwr.ci upr.ci
co najmniej 2.50 80.9   75.2   85.6
poniżej          19.1   14.4   24.8

 teoria
            est lwr.ci upr.ci
niski      14.1   10.1   19.3
przeciętny 59.1   52.5   65.4
wysoki     26.8   21.4   33.0

 tercyle
            est lwr.ci upr.ci
niski      36.4   30.3   42.9
przeciętny 32.7   26.9   39.2
wysoki     30.9   25.2   37.3

 m_sd
            est lwr.ci upr.ci
niski      14.1   10.1   19.3
przeciętny 65.9   59.4   71.9
wysoki     20.0   15.2   25.8
  Estimate Std. Error    t value   Pr(>|t|)         R2
     9.074      1.223      7.420      0.000      0.202
 2.5 % 97.5 %
  6.66  11.48
             Df Sum Sq Mean Sq F value   Pr(>F)
tercyle       2  11152    5576   25.92 8.06e-11 ***
Residuals   217  46688     215
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia kodu w R 4.5.3 (funkcje quantile(), lm(), aov(), cor.test() i t.test() z pakietu stats). Przedziały Wilsona liczy pakiet DescTools, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy wyznaczaniu poziomów
- Brak informacji, skąd pochodzą granice. Zdanie „43% badanych miało wysoki poziom” bez reguły podziału nic nie znaczy.
- Normy z innej populacji, np. normy dla młodych dorosłych zastosowane do pacjentów geriatrycznych, albo średnia i SD własnej próby wstawione do wzoru na steny.
- Próg przesiewowy opisany jak diagnoza („28% pacjentów ma depresję”) zamiast „28% uzyskało wynik powyżej punktu odcięcia”.
- Próg wymyślony albo przeniesiony z innego narzędzia, bez cytowania badania walidacyjnego.
- Granice zapisane z luką (2.33 i 2.34), przez co część wyników nie należy do żadnego poziomu albo jest przydzielana niekonsekwentnie.
- Porównywanie odsetków z tercyli między badaniami albo nazywanie górnego tercyla próby „wysokim poziomem cechy” w sensie populacyjnym.
- Testowanie hipotez na poziomach zamiast na wyniku ciągłym, np. chi-kwadrat dla poziomu wyniku i płci zamiast testu na wynikach. To strata mocy i ryzyko pozornych efektów.
- Odsetki bez przedziałów ufności w małej próbie, gdzie różnica 10 punktów procentowych mieści się w błędzie losowym.
Jeśli chcesz przedyskutować, który sposób wyznaczania poziomów pasuje do Twojego narzędzia i hipotez, możesz skonsultować analizę w ramach analiz statystycznych dla studentów. Wybór i jego uzasadnienie w pracy muszą być jednak Twoje.
Najczęstsze pytania
Jak podzielić wyniki skali na niskie, przeciętne i wysokie?
Najpierw sprawdź, czy narzędzie ma normy (np. steny) albo zwalidowany punkt odcięcia – wtedy użyj ich i zacytuj źródło. Jeśli nie ma, możesz przyjąć umowny podział zakresu odpowiedzi na trzy równe części albo podział z próby (tercyle, M ± 1 SD), ale opisz go jako umowny i podaj granice. Hipotezy i tak testuj na wyniku ciągłym.
Czy w pracy magisterskiej można dzielić wyniki na tercyle?
Do opisu próby tak, jeśli napiszesz, że granice wyznaczono w badanej próbie. Tercyle z definicji dają około jednej trzeciej osób w każdej grupie, więc nie mówią, czy wyniki są wysokie na tle populacji, i nie da się ich porównywać między badaniami. Do testowania hipotez użyj wyniku ciągłego, bo podział obniża moc testu.
Jakie przedziały stosować dla średniej na skali 1–5?
Równy podział zakresu 1–5 na trzy części daje granice w punktach 7/3 ≈ 2.33 i 11/3 ≈ 3.67. Zapisz je bez luk, np. niski od 1 do 2.33 włącznie, przeciętny powyżej 2.33 do 3.67 włącznie, wysoki powyżej 3.67. Pamiętaj, że to podział umowny: opisuje położenie na skali odpowiedzi, a nie pozycję osoby w populacji.
Czym różni się podział M ± 1 SD od stenów?
Steny liczy się ze średniej i odchylenia populacji normalizacyjnej podanych w podręczniku, więc pokazują pozycję osoby na tle tej populacji. Podział M ± 1 SD korzysta ze średniej i odchylenia Twojej próby, więc pokazuje tylko pozycję osoby wśród badanych. W przykładzie granice wyszły podobne (2.35 i 3.85 wobec 2.34 i 3.95), ale ich znaczenie jest inne.
Jak opisać odsetek osób z wysokim wynikiem w pracy?
Podaj regułę podziału ze źródłem, liczbę i odsetek osób z 95% przedziałem ufności, np. „wyniki wysokie (steny 8–10) uzyskało 49 badanych (22.3%, 95% CI [17.3, 28.2])”. Przy normach dodaj, jaki odsetek byłby oczekiwany w populacji normalizacyjnej. Przy progu przesiewowym pisz o wynikach powyżej punktu odcięcia, a nie o rozpoznaniu.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikOpis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →PoradnikStatystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →Nie wiesz, jak podzielić i opisać wyniki swojej skali?
Pomożemy dobrać sposób wyznaczania poziomów do Twojego narzędzia, policzyć odsetki z przedziałami ufności i przeprowadzić analizy na wyniku ciągłym, które zrozumiesz i obronisz.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Andrade, C. (2021). Z scores, standard scores, and composite test scores explained. Indian Journal of Psychological Medicine, 43(6), 555–557. https://doi.org/10.1177/02537176211046525 ● Otwarty dostęp
- Bennette, C., & Vickers, A. (2012). Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents. BMC Medical Research Methodology, 12(1), Article 21. https://doi.org/10.1186/1471-2288-12-21 ● Otwarty dostęp
- Cohen, J. (1983). The cost of dichotomization. Applied Psychological Measurement, 7(3), 249–253. https://doi.org/10.1177/014662168300700301 ● Otwarty dostęp: pełny tekst
- Cohen, P., Cohen, J., Aiken, L. S., & West, S. G. (1999). The problem of units and the circumstance for POMP. Multivariate Behavioral Research, 34(3), 315–346. https://doi.org/10.1207/s15327906mbr3403_2
- Crawford, J. R., Garthwaite, P. H., & Slick, D. J. (2009). On percentile norms in neuropsychology: Proposed reporting standards and methods for quantifying the uncertainty over the percentile ranks of test scores. The Clinical Neuropsychologist, 23(7), 1173–1195. https://doi.org/10.1080/13854040902795018
- Leeflang, M. M. G., Moons, K. G. M., Reitsma, J. B., & Zwinderman, A. H. (2008). Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions. Clinical Chemistry, 54(4), 729–737. https://doi.org/10.1373/clinchem.2007.096032
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- Maxwell, S. E., & Delaney, H. D. (1993). Bivariate median splits and spurious statistical significance. Psychological Bulletin, 113(1), 181–190. https://doi.org/10.1037/0033-2909.113.1.181
- McNeish, D., & Wolf, M. G. (2020). Thinking twice about sum scores. Behavior Research Methods, 52(6), 2287–2305. https://doi.org/10.3758/s13428-020-01398-0 ● Otwarty dostęp
- Naggara, O., Raymond, J., Guilbert, F., Roy, D., Weill, A., & Altman, D. G. (2011). Analysis by categorizing or dichotomizing continuous variables is inadvisable: An example from the natural history of unruptured aneurysms. American Journal of Neuroradiology, 32(3), 437–440. https://doi.org/10.3174/ajnr.a2425 ● Otwarty dostęp
- Oosterhuis, H. E. M., van der Ark, L. A., & Sijtsma, K. (2016). Sample size requirements for traditional and regression-based norms. Assessment, 23(2), 191–202. https://doi.org/10.1177/1073191115580638 ● Otwarty dostęp: pełny tekst
- Royston, P., Altman, D. G., & Sauerbrei, W. (2006). Dichotomizing continuous predictors in multiple regression: A bad idea. Statistics in Medicine, 25(1), 127–141. https://doi.org/10.1002/sim.2331
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{andrade2021z, author={Andrade, Chittaranjan}, title={{Z scores, standard scores, and composite test scores explained}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={6}, pages={555--557}, doi={10.1177/02537176211046525}}@article{bennette2012against, author={Bennette, Caroline and Vickers, Andrew}, title={{Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={21}, doi={10.1186/1471-2288-12-21}}@article{cohen1983cost, author={Cohen, Jacob}, title={{The cost of dichotomization}}, journal={Applied Psychological Measurement}, year={1983}, volume={7}, number={3}, pages={249--253}, doi={10.1177/014662168300700301}}@article{cohen1999problem, author={Cohen, Patricia and Cohen, Jacob and Aiken, Leona S. and West, Stephen G.}, title={{The problem of units and the circumstance for POMP}}, journal={Multivariate Behavioral Research}, year={1999}, volume={34}, number={3}, pages={315--346}, doi={10.1207/s15327906mbr3403_2}}@article{crawford2009percentile, author={Crawford, John R. and Garthwaite, Paul H. and Slick, Daniel J.}, title={{On percentile norms in neuropsychology: Proposed reporting standards and methods for quantifying the uncertainty over the percentile ranks of test scores}}, journal={The Clinical Neuropsychologist}, year={2009}, volume={23}, number={7}, pages={1173--1195}, doi={10.1080/13854040902795018}}@article{leeflang2008bias, author={Leeflang, Mariska M. G. and Moons, Karel G. M. and Reitsma, Johannes B. and Zwinderman, Aeilko H.}, title={{Bias in sensitivity and specificity caused by data-driven selection of optimal cutoff values: Mechanisms, magnitude, and solutions}}, journal={Clinical Chemistry}, year={2008}, volume={54}, number={4}, pages={729--737}, doi={10.1373/clinchem.2007.096032}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{maxwell1993bivariate, author={Maxwell, Scott E. and Delaney, Harold D.}, title={{Bivariate median splits and spurious statistical significance}}, journal={Psychological Bulletin}, year={1993}, volume={113}, number={1}, pages={181--190}, doi={10.1037/0033-2909.113.1.181}}@article{mcneish2020thinking, author={McNeish, Daniel and Wolf, Melissa Gordon}, title={{Thinking twice about sum scores}}, journal={Behavior Research Methods}, year={2020}, volume={52}, number={6}, pages={2287--2305}, doi={10.3758/s13428-020-01398-0}}@article{naggara2011analysis, author={Naggara, O. and Raymond, J. and Guilbert, F. and Roy, D. and Weill, A. and Altman, D. G.}, title={{Analysis by categorizing or dichotomizing continuous variables is inadvisable: An example from the natural history of unruptured aneurysms}}, journal={American Journal of Neuroradiology}, year={2011}, volume={32}, number={3}, pages={437--440}, doi={10.3174/ajnr.a2425}}@article{oosterhuis2016sample, author={Oosterhuis, Hannah E. M. and van der Ark, L. Andries and Sijtsma, Klaas}, title={{Sample size requirements for traditional and regression-based norms}}, journal={Assessment}, year={2016}, volume={23}, number={2}, pages={191--202}, doi={10.1177/1073191115580638}}@article{royston2006dichotomizing, author={Royston, Patrick and Altman, Douglas G. and Sauerbrei, Willi}, title={{Dichotomizing continuous predictors in multiple regression: A bad idea}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={1}, pages={127--141}, doi={10.1002/sim.2331}}