Po co opisywać narzędzie tak dokładnie?
Opis narzędzia to akapit w rozdziale metodologicznym, z którego czytelnik ma się dowiedzieć, czym naprawdę zmierzyłeś zmienne. Promotor, recenzent i komisja na obronie sprawdzają w nim trzy rzeczy. Czy narzędzie mierzy to, o czym piszesz w hipotezach? Czy wiesz, jak policzyć wynik? Czy wynik w Twojej próbie był wystarczająco rzetelny, żeby na nim wnioskować? Jeśli opis tego nie mówi, nawet poprawna analiza wisi w powietrzu.
W publikacjach nie jest z tym dobrze. Flake i in. (2017) przejrzeli artykuły z czołowego czasopisma psychologii społecznej i osobowości. Pomiar za pomocą skal był powszechny, ale dowodów trafności zwykle brakowało, a alfa Cronbacha często była jedynym podanym wskaźnikiem psychometrycznym. Flake i Fried (2020) idą dalej i mówią o wątpliwych praktykach pomiarowych. Gdy autor nie opisuje, jak mierzył, czytelnik nie może ocenić, czy wnioski są trafne. W pracy dyplomowej działa to tak samo, tylko oceniającym jest komisja.
Ten poradnik daje Ci jeden schemat opisu i cztery gotowe wzory: dla narzędzia standaryzowanego, ankiety własnej, testu wiedzy i skali klinicznej wypełnianej przez osobę badającą. Wszystkie liczby we wzorach pochodzą z jednego badania przykładowego, policzonego w R. Nazwy narzędzi w przykładach są fikcyjne (oznaczamy je dopiskiem „[narzędzie fikcyjne]”), żeby nie przypisać prawdziwym kwestionariuszom właściwości, których nie mają. Wzór dla prawdziwej, popularnej skali znajdziesz w poradniku PSS-10 – jak policzyć i zinterpretować wynik.
Dziesięć elementów opisu narzędzia
Każde narzędzie, czy to test psychometryczny, czy krótka ankieta, opisz według tego samego porządku. Rysunek 1 grupuje elementy w pięć pytań, na które odpowiada kolejny fragment akapitu. Nie każde narzędzie wymaga wszystkich dziesięciu elementów. Ankieta własna nie ma norm ani autorów adaptacji. Pominięcie elementu powinno jednak wynikać z decyzji, a nie z zapomnienia.
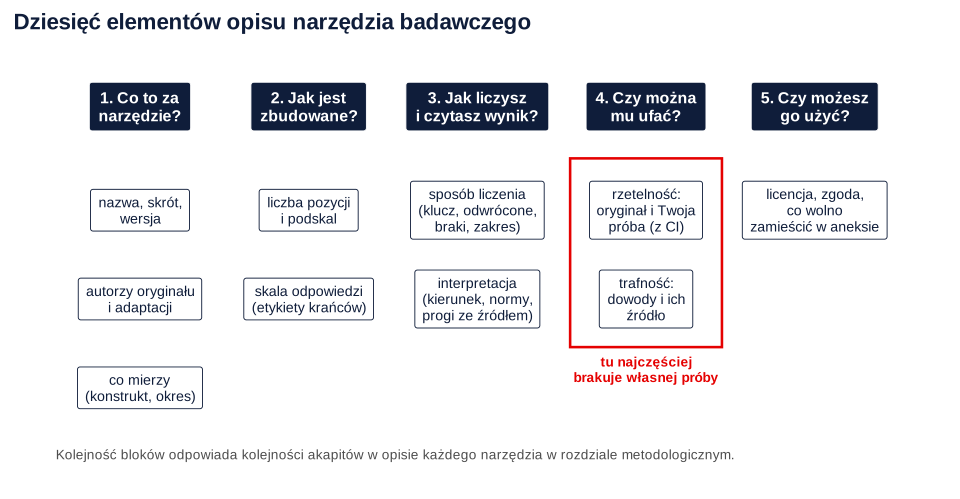
| Element | Co napisać | Skąd wziąć | Typowy błąd |
|---|---|---|---|
| Nazwa i skrót | Pełna polska nazwa, nazwa oryginalna, skrót, wersja lub wydanie | Podręcznik, artykuł adaptacyjny | Sam skrót albo nazwa „z internetu” |
| Autorzy | Autorzy oryginału i polskiej adaptacji, z cytowaniem obu prac | Artykuł adaptacyjny, podręcznik | Cytowanie tylko oryginału przy polskiej wersji |
| Co mierzy | Konstrukt, okres, którego dotyczą odpowiedzi, populacja docelowa | Definicja autorów narzędzia | Definicja konstruktu inna niż autorów |
| Budowa | Liczba pozycji, podskale i liczba pozycji w każdej | Podręcznik | Brak informacji, które pozycje tworzą podskalę |
| Skala odpowiedzi | Liczba stopni i etykiety krańców | Arkusz narzędzia | „Skala Likerta” bez liczby stopni |
| Sposób liczenia | Pozycje odwrócone, suma czy średnia, braki, zakres wyniku | Klucz z podręcznika | Pominięcie przekodowania pozycji odwróconych |
| Interpretacja | Co oznacza wyższy wynik; normy lub progi tylko ze źródła | Podręcznik, publikacja autorów | Progi wymyślone albo wzięte z nieznanego źródła |
| Rzetelność | Wartości z oryginału lub adaptacji oraz z własnej próby, z 95% CI | Literatura i Twoje obliczenia | Tylko alfa z podręcznika |
| Trafność | Jakie dowody zebrali autorzy; co sprawdziłeś sam | Artykuł adaptacyjny, własne analizy | Zdanie „narzędzie jest trafne” bez dowodów |
| Licencja i zgoda | Czyja zgoda, na jakich warunkach, co zamieszczasz w aneksie | Autor, wydawca, strona autora | Przedruk pozycji chronionego testu w aneksie |
Nazwa, autorzy i to, co narzędzie mierzy
Podaj pełną nazwę polską, w nawiasie skrót i nazwę oryginalną. Jeśli narzędzie ma kilka wersji (np. pełną i skróconą albo kolejne wydania podręcznika), napisz, której użyłeś. Stanowisko Międzynarodowej Komisji Testów (ITC) zaleca, by opis metody podawał nazwę, wydanie i datę publikacji narzędzia, a przy przekładach także sposób adaptacji i dowody jej trafności (International Test Commission, 2014). Cytuj dwie prace: oryginał i polską adaptację. Jeżeli przetłumaczyłeś skalę sam, napisz to wprost. Samodzielny przekład nie jest właściwą adaptacją, a różnicę wyjaśnia poradnik adaptacja kulturowa kwestionariusza.
„Co mierzy” to jedno lub dwa zdania o konstrukcie, sformułowane tak, jak definiują go autorzy narzędzia. Dopisz okres, którego dotyczą odpowiedzi („w ostatnim miesiącu”, „zwykle”), bo od niego zależy, czy mierzysz stan, czy cechę. Jeśli definicja z Twojej części teoretycznej różni się od definicji autorów, wróć do operacjonalizacji. Inaczej hipoteza dotyczy jednego pojęcia, a wynik innego.
Budowa i skala odpowiedzi
Napisz, ile jest pozycji, czy tworzą jeden wynik, czy kilka (zob. podskala i wynik ogólny), i które numery pozycji należą do każdej podskali. Przy skali odpowiedzi podaj liczbę stopni i etykiety krańców, np. „od 1 – zdecydowanie się nie zgadzam do 5 – zdecydowanie się zgadzam”. Samo określenie skala Likerta nie wystarczy, bo nie mówi, ile jest stopni ani co oznaczają. Treść przykładowej pozycji podawaj tylko wtedy, gdy pozwalają na to warunki użycia narzędzia (wracamy do tego przy licencji). Bezpieczniej opisać temat pozycji własnymi słowami.
Sposób liczenia wyniku
To element, którego brak promotor wyłapuje najszybciej. Opisz kolejno: które pozycje są odwrócone i jak je przekodowałeś (przy skali 1–5: 6 − odpowiedź), czy wynik to suma, czy średnia (zob. wynik skali: średnia czy suma), jak postąpiłeś z brakami odpowiedzi i jaki jest możliwy zakres wyniku. Zakres jest ważny, bo pozwala czytelnikowi umieścić średnią na skali: M = 3.2 znaczy coś innego przy zakresie 1–5 niż przy 0–40. W testach wiedzy dopisz klucz odpowiedzi i sposób punktowania odpowiedzi „nie wiem”. Krok po kroku, z formułami Excela i składnią, liczenie wyniku pokazuje poradnik jak policzyć wynik kwestionariusza.
Interpretacja wyniku
Zawsze napisz, co oznacza wyższy wynik. Jeśli porównujesz osoby z normami (np. w stenach), podaj, z jakiego podręcznika i dla jakiej populacji pochodzą. Standardy testowe wymagają, by normy odnosiły się do jasno opisanej populacji, a raport z normalizacji podawał m.in. sposób doboru próby i daty badania (American Educational Research Association i in., 2014). Punkt odcięcia podawaj tylko z oryginalnej publikacji albo z oficjalnej strony autora, z cytowaniem. Progów nie wymyślaj i nie przepisuj z niesprawdzonych stron. Przy narzędziach przesiewowych dodaj, że wynik powyżej progu nie jest rozpoznaniem. Jak opisać poziomy „niski, przeciętny, wysoki” i czego unikać przy dzieleniu wyników z próby, wyjaśnia poradnik niski, przeciętny, wysoki wynik.
Rzetelność: w oryginale i we własnej próbie
Rzetelność jest właściwością wyników w konkretnej próbie, a nie narzędzia raz na zawsze. Dlatego JARS–Quant zaleca podawać współczynniki rzetelności oszacowane we własnych danych, a przy wartościach z innych badań opisać te próby (Appelbaum i in., 2018). W opisie umieść dwie informacje: co podają autorzy adaptacji (wartość i próba) oraz co wyszło u Ciebie. Dla skali z pozycjami Likerta podaj spójność wewnętrzną: alfę Cronbacha, a obok niej omegę McDonalda. McNeish (2018) przypomina, że nierealistyczne założenia alfy sprawiają, że zwykle zaniża ona rzetelność, i pokazuje alternatywy, wśród nich omegę.
Inne narzędzia wymagają innych współczynników. Dla testu wiedzy z pytaniami 0/1 podaj KR-20, czyli współczynnik Kudera i Richardsona (1937). Dla oceny wystawianej przez osobę badającą podaj zgodność oceniających jako ICC. Gdy cecha ma być stała w czasie, przyda się rzetelność test–retest. Polit (2014) zwraca uwagę, że w badaniach test–retest odstęp między pomiarami trzeba uzasadnić, a kryterium akceptowalności ustalić przed badaniem. Gotowe zdania dla siedmiu typowych sytuacji, m.in. niskiej alfy i usunięcia pozycji, są we wzorze raportowania alfy Cronbacha.
Trafność: jakie dowody, czyje i skąd
Zdanie „narzędzie ma dobrą trafność” nic nie mówi. Napisz, jakie dowody trafności zebrali autorzy adaptacji: potwierdzenie struktury w konfirmacyjnej analizie czynnikowej (CFA), korelacje z innymi miarami zgodne z teorią (trafność teoretyczna), związek z kryterium. Przy ankiecie własnej najważniejsza jest trafność treściowa, czyli ocena ekspertów. Jeśli coś sprawdziłeś we własnej próbie, choćby jedną korelację przewidywaną przez teorię, dodaj to do opisu. To mocniejszy argument niż sama wartość z podręcznika.
Licencja, zgoda i aneks
Napisz, czy narzędzie jest w domenie publicznej, czy chronione, kto wyraził zgodę na jego użycie i kiedy. Według stanowiska ITC prawa autorskie do testu obejmują m.in. pozycje, podręcznik i klucz. Przed użyciem chronionego testu w badaniach trzeba uzyskać zgodę właściciela praw, a pozycji testu nie drukuje się w publikacjach, także w pracach dyplomowych (International Test Commission, 2014). Pracownia Testów Psychologicznych PTP informuje, że jej narzędzi nie wolno bez zgody kopiować, zmieniać ani przenosić do formy elektronicznej, a studenci korzystają z nich pod opieką promotora z upoważnieniem do zakupu (Pracownia Testów Psychologicznych PTP, b.d.). Warunki użycia polskich adaptacji różnią się między narzędziami, więc sprawdź je u autorów adaptacji albo u wydawcy. Jak szukać narzędzi i prosić o zgodę, pokazuje poradnik gdzie znaleźć kwestionariusze psychologiczne. W aneksie zamieść ankietę własną, metryczkę i narzędzia z domeny publicznej. Przy narzędziach chronionych wystarczą pełne odwołania bibliograficzne.
Badanie przykładowe: cztery narzędzia w jednej pracy
Wyobraź sobie pracę licencjacką z pielęgniarstwa o opiekunach rodzinnych osób po udarze. Wzięło w niej udział 126 opiekunów, a pielęgniarki oceniły samodzielność ich podopiecznych. Badanie wykorzystuje cztery rodzaje narzędzi, z którymi często spotkasz się w pracach z nauk o zdrowiu (zob. statystyka w pracy z pielęgniarstwa):
- KOO-12 [narzędzie fikcyjne] – Kwestionariusz Obciążenia Opiekuna: 12 pozycji ocenianych od 1 do 5, dwie podskale po 6 pozycji (obciążenie emocjonalne EMO i organizacyjne ORG), trzy pozycje odwrócone;
- ankieta własna o źródłach wsparcia: 9 pytań zamkniętych, oceniona przez 5 ekspertów;
- TWO-16 – test wiedzy o profilaktyce odleżyn (opracowanie własne): 16 pytań punktowanych 0/1;
- SSC [narzędzie fikcyjne] – Skala Samodzielności Chorego: pielęgniarka ocenia 10 czynności od 0 do 2; 25 podopiecznych oceniły niezależnie dwie pielęgniarki.
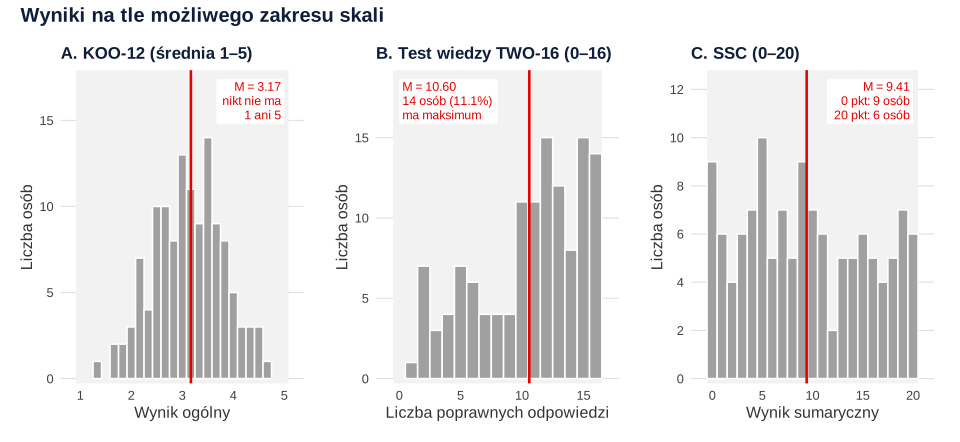
Dane są symulowane. Tabela 1 zbiera to, co z własnej próby trafia do opisów: zakres możliwy i uzyskany, średnią, odchylenie standardowe i rzetelność. Taką tabelę możesz umieścić w rozdziale metodologicznym albo na początku rozdziału z wynikami.
Tabela 1
Wyniki i rzetelność narzędzi w badaniu opiekunów osób po udarze (N = 126)
| Narzędzie | k | Zakres możliwy | M | SD | Zakres uzyskany | Rzetelność [95% CI] |
|---|---|---|---|---|---|---|
| KOO-12: obciążenie emocjonalne | 6 | 1–5 | 3.22 | 0.83 | 1.00–4.83 | α = .85 [.81, .89] |
| KOO-12: obciążenie organizacyjne | 6 | 1–5 | 3.11 | 0.73 | 1.67–4.67 | α = .75 [.67, .81] |
| TWO-16: wiedza o profilaktyce odleżyn | 16 | 0–16 | 10.60 | 4.28 | 1–16 | KR-20 = .89 [.86, .91] |
| SSC: samodzielność podopiecznego | 10 | 0–20 | 9.41 | 6.14 | 0–20 | ICC(A,1) = .96 [.91, .98]a |
Uwaga. k – liczba pozycji. Wyniki KOO-12 to średnie odpowiedzi, wyniki TWO-16 i SSC – sumy punktów. Przedziały ufności: α i KR-20 – metoda Feldta. KOO-12 i SSC to narzędzia fikcyjne; dane symulowane.
a Zgodność dwóch pielęgniarek oceniających niezależnie 25 podopiecznych.
Już z tej tabeli widać rzeczy, które trzeba skomentować w opisie. W teście wiedzy 14 osób (11.1%) uzyskało maksimum, a w SSC 9 podopiecznych ma 0 punktów, a 6 – 20 punktów. Rysunek 2 pokazuje to na tle możliwego zakresu.
Wzór 1. Narzędzie standaryzowane z polską adaptacją
To najczęstsza sytuacja w pracy z psychologii i pielęgniarstwa. Korzystasz z gotowego kwestionariusza z polską adaptacją i podręcznikiem albo artykułem walidacyjnym. Opis ma najwięcej elementów, ale większość przepisujesz ze źródła. Od siebie dodajesz wyniki z własnej próby i informację o zgodzie.
Kilka uwag do wzoru:
- Przekodowanie pozycji odwróconych sprawdź liczbowo. Przed przekodowaniem pozycja 3 korelowała z sumą pozostałych pozycji podskali EMO na poziomie −.60. Ujemna korelacja pozycja–reszta to typowy sygnał, że zapomniałeś odwrócić punktację.
- Struktura czynnikowa we własnej próbie nie jest obowiązkowa w pracy licencjackiej. Przyda się, gdy liczysz wyniki podskal, a próba jest inna niż w adaptacji. Podaj wskaźniki dopasowania i zakres ładunków, a ocenę dopasowania uzasadnij, zamiast pisać tylko, że „model był dobrze dopasowany”.
- Korelacja z samodzielnością podopiecznego to prosty dowód trafności teoretycznej we własnej próbie. Zapisz ją tylko wtedy, gdy kierunek związku przewidziałeś przed analizą.
- Jeżeli podręcznik nie podaje reguły dla braków danych, zapisz własną regułę, zanim zobaczysz wyniki, i podaj, ilu osób dotyczyła.
Wzór 2. Ankieta własna
Ankieta własna nie ma podręcznika, więc opis musi zastąpić go w całości. Czytelnik chce wiedzieć, skąd wzięły się pytania, kto je sprawdził i co z nich liczysz. Zasady budowania pytań i typowe błędy omawia poradnik jak zrobić ankietę do pracy dyplomowej.
W przykładzie trafność treściową oceniło 5 ekspertów na skali od 1 do 4. I-CVI to odsetek ekspertów, którzy ocenili pytanie na 3 lub 4. Polit i in. (2007) proponują, by przy trzech lub więcej ekspertach za dowód dobrej trafności treściowej uznawać I-CVI co najmniej .78. W przykładzie tego progu nie osiągnęło tylko pytanie 3 (I-CVI = .60), a średni wskaźnik dla całej ankiety wyniósł S-CVI/Ave = .91. Gdyby liczyć wskaźnik pełnej zgodności (S-CVI/UA, odsetek pytań ocenionych na 3 lub 4 przez wszystkich ekspertów), wyszłoby .67. Polit i Beck (2006) pokazują, że obie wersje S-CVI dają różne wartości, więc w opisie trzeba napisać, którą policzyłeś.
Po ocenie ekspertów sprawdź, jak pytania rozumieją osoby z grupy docelowej. Służy do tego wywiad poznawczy: osoba odpowiada na pytanie i jednocześnie mówi, jak je rozumie i dlaczego wybiera daną odpowiedź (Beatty i Willis, 2007). Taki krok to też element badania pilotażowego.
Zwróć uwagę na zdanie o braku wyniku sumarycznego. Jeśli pytania dotyczą różnych rzeczy (korzystanie z poradni nie jest „wskaźnikiem” tego samego co korzystanie z pomocy rodziny), alfa Cronbacha nie ma sensu. Liczy się ją tylko dla pozycji, które mierzą jeden konstrukt. Promotorzy czasem o nią proszą, a wtedy to zdanie jest gotową odpowiedzią.
Wzór 3. Test wiedzy opracowany samodzielnie
Test wiedzy to osobny przypadek, bo ma poprawne i błędne odpowiedzi. W opisie podaj więc, na jakiej podstawie ułożyłeś pytania i kto sprawdził klucz. Podaj też, jak punktujesz odpowiedź „nie wiem” oraz jaką rzetelność i jaką łatwość mają pytania. Łatwość i moc różnicującą pytań liczy się w analizie pozycji testu, a całą analizę jednorazowej ankiety wiedzy prowadzi poradnik ankieta wiedzy – analiza krok po kroku. Jeśli test stosujesz przed szkoleniem i po nim, zobacz też badanie wiedzy przed i po szkoleniu.
Ostatnie zdanie wzoru nie jest ozdobnikiem. Gdy wiele osób ma maksimum, test nie odróżnia osób dobrze przygotowanych od bardzo dobrze przygotowanych, a różnice między grupami mogą wyjść mniejsze, niż są naprawdę (zob. efekt sufitu i podłogi). Terwee i in. (2007) uwzględniają efekty podłogi i sufitu wśród kryteriów jakości właściwości pomiarowych kwestionariuszy zdrowotnych, obok trafności, rzetelności i responsywności. Warto więc podać odsetek osób z wynikiem skrajnym przy każdym narzędziu, nie tylko przy teście wiedzy.
Wzór 4. Skala kliniczna wypełniana przez osobę badającą
Skale oceniane przez pielęgniarkę, fizjoterapeutę albo lekarza (samodzielność, ryzyko odleżyn, nasilenie bólu oceniane przez obserwatora) mają jedną cechę, której nie mają kwestionariusze samoopisowe. Wynik zależy od osoby, która ocenia. Dlatego w opisie, oprócz budowy i sposobu liczenia, napisz, kto oceniał, jak go przeszkolono i jak zgodne były oceny dwóch osób. Koo i Li (2016) zwracają uwagę, że przy ICC trzeba jawnie podać model, typ i definicję współczynnika, bo różne formy ICC dają różne wartości. Wzór zawiera wszystkie trzy informacje.
We wzorze punkt odcięcia jest w nawiasie kwadratowym, bo SSC jest narzędziem fikcyjnym i żadnego progu nie ma. Przy prawdziwej skali sięgnij po próg do oryginalnej publikacji albo podręcznika i zacytuj źródło. Jeśli źródła są niezgodne, napisz, który próg wybrałeś i dlaczego. Gdy autorzy podają czułość i swoistość progu, możesz je przytoczyć. Planowanie badania rzetelności pomiaru klinicznego, wybór formy ICC, błąd pomiaru i wykres Blanda–Altmana omawia poradnik badanie rzetelności pomiaru klinicznego. Zgodność ocen w kategoriach (kappa) opisuje poradnik zgodność sędziów.
Rzetelność we własnej próbie: co policzyć i jak pokazać
Rysunek 3 zestawia współczynniki rzetelności wszystkich narzędzi z badania przykładowego razem z 95% przedziałami ufności. Widać na nim dwie rzeczy, które warto przenieść do opisu.
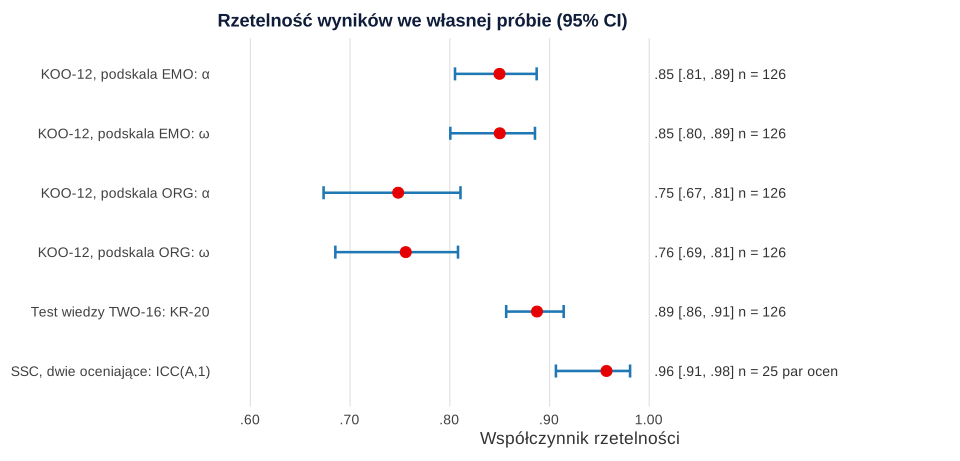
Po pierwsze, podskala ORG ma wyraźnie niższą rzetelność niż EMO, a jej przedział sięga .67. Jeśli autorzy adaptacji podają dla tej podskali wartość wyższą, napisz o tej różnicy i rozważ, skąd się wzięła: z innej populacji, mniejszej zmienności wyników albo słabszej pozycji. Analiza pozycji pokazuje, że najniższa skorygowana korelacja pozycja–reszta w ORG wynosiła .32, a w EMO .56. Porównanie z wartością z podręcznika testem Feldta pokazujemy we wzorze raportowania alfy, w sytuacji 6. Po drugie, wysoka zgodność oceniających w SSC opiera się tylko na 25 parach. Przedział jest szerszy, niż sugeruje sama wartość .96, i to on mówi, jak precyzyjne jest oszacowanie.
Nie oceniaj rzetelności wyłącznie przez porównanie z progiem „.70”. Rzetelność potrzebna do porównania grup jest inna niż przy decyzjach o pojedynczym pacjencie. Napisz, jaka jest wartość z przedziałem i co z niej wynika dla Twoich analiz.
Źle → dobrze: sformułowania, które poprawi promotor
| Źle | Dobrze |
|---|---|
| „Zastosowano skalę stresu.” | „Zastosowano [pełna nazwa] ([skrót]; [autorzy, rok]) w polskiej adaptacji [autorzy, rok].” |
| „Odpowiedzi udzielano na skali Likerta.” | „Odpowiedzi udzielano na skali od 1 (zdecydowanie się nie zgadzam) do 5 (zdecydowanie się zgadzam).” |
| „Wynik obliczono zgodnie z kluczem.” | „Pozycje 3, 8 i 11 przekodowano (6 − odpowiedź); wynik to średnia odpowiedzi (zakres 1–5).” |
| „Narzędzie jest rzetelne (α = .82).” | „Autorzy adaptacji podają α = [wartość] w próbie [opis]; w niniejszym badaniu α = .85, 95% CI [.81, .89].” |
| „Narzędzie ma wysoką trafność.” | „Autorzy potwierdzili dwuczynnikową strukturę w CFA [źródło]; w niniejszym badaniu wynik EMO korelował z samodzielnością podopiecznego, r = −.37.” |
| „Wynik powyżej 10 punktów oznacza depresję.” | „Wynik [próg] lub wyższy autorzy uznają za [wskazanie do dalszej diagnozy] ([źródło]); nie jest to rozpoznanie.” |
| „Ankieta własna, alfa Cronbacha = .41.” | „Pytania ankiety dotyczą różnych zagadnień i nie tworzą skali, dlatego nie obliczano wyniku sumarycznego ani alfy.” |
| „Kwestionariusz w aneksie” (pełny przedruk testu chronionego) | „Ze względu na warunki licencji treści narzędzia nie zamieszczono; pełne dane bibliograficzne podano w bibliografii.” |
| „Test wiedzy składał się z 16 pytań.” | „Test zawierał 16 pytań jednokrotnego wyboru z opcją „nie wiem”; 1 punkt za poprawną odpowiedź, zakres 0–16, KR-20 = .89.” |
| „Skalę oceniała pielęgniarka.” | „Oceny prowadziły przeszkolone pielęgniarki; zgodność dwóch ocen u 25 podopiecznych: ICC(A,1) = .96, 95% CI [.91, .98].” |
Lista kontrolna przed oddaniem rozdziału
Przejdź tę listę dla każdego narzędzia osobno. Jeśli przy którymś punkcie odpowiadasz „nie wiem”, wróć do źródła albo do danych.
- Pełna nazwa, skrót i wersja; cytowanie oryginału i polskiej adaptacji (albo informacja, że to przekład własny lub ankieta własna).
- Jedno lub dwa zdania o konstrukcie, zgodne z definicją autorów, z okresem, którego dotyczą odpowiedzi.
- Liczba pozycji, podskale i numery pozycji w każdej podskali.
- Skala odpowiedzi z liczbą stopni i etykietami krańców.
- Numery pozycji odwróconych i sposób przekodowania; suma czy średnia; reguła dla braków; możliwy zakres wyniku.
- Kierunek interpretacji; normy i progi tylko z cytowanym źródłem; przy progach przesiewowych zdanie, że to nie diagnoza.
- Rzetelność z oryginału lub adaptacji z opisem próby oraz rzetelność we własnej próbie z 95% CI, właściwym współczynnikiem dla typu narzędzia (α i ω, KR-20, ICC).
- Dowody trafności: jakie, z jakiego źródła; co sprawdziłeś sam.
- Odsetek wyników minimalnych i maksymalnych, gdy jest wyraźny.
- Zgoda na użycie: od kogo, kiedy, na jakich warunkach; co jest w aneksie, a czego nie wolno zamieścić.
- Te same nazwy i skróty narzędzi w opisie, tabelach i wynikach.
Wszystkie cztery wzory, listę kontrolną i tabelę „źle → dobrze” możesz pobrać jako plik Word (wzor-opisu-narzedzia-badawczego.docx) i uzupełnić danymi swojego narzędzia. Jeśli chcesz, żeby ktoś sprawdził opis narzędzi razem z obliczeniami rzetelności, możesz skonsultować to w ramach oferty analizy statystyczne dla studentów. Opis i wyniki pozostają Twoje i musisz umieć je obronić.
Liczby do opisu narzędzi w R
Kod odtwarza wszystkie liczby z tabeli 1, wzorów i rysunków. Uruchom oba przepisy po kolei w jednej sesji R, bo drugi korzysta z danych z pierwszego. Alfę i KR-20 z przedziałem Feldta oraz ICC liczy pakiet psych, omegę – pakiet semTools na podstawie jednoczynnikowego modelu z pakietu lavaan, a przedział dla omegi – bootstrap z pakietu boot. Ten sam kod możesz zastosować do własnych danych: zmień nazwy pozycji, numery pozycji odwróconych i zakres skali.
1. Dane przykładowe: cztery narzędzia
R
# B62 – opis narzędzia badawczego: dane przykładowe (dane symulowane, set.seed(6202)).
# Praca licencjacka z pielęgniarstwa: 126 opiekunów rodzinnych osób po udarze i ich podopieczni.
# Wszystkie nazwy narzędzi są FIKCYJNE (wymyślone na potrzeby przykładu):
#   KOO-12 – Kwestionariusz Obciążenia Opiekuna: 12 pozycji 1–5, podskale EMO (o1–o6) i ORG (o7–o12),
#            pozycje o3, o8 i o11 sformułowane odwrotnie (w danych surowe, nieprzekodowane odpowiedzi);
#   TWO-16 – test wiedzy o profilaktyce odleżyn (opracowanie własne): 16 pytań, 1 = poprawna, 0 = błędna lub „nie wiem”;
#   SSC    – Skala Samodzielności Chorego: pielęgniarka ocenia 10 czynności 0–2 (0 = pełna pomoc, 2 = samodzielnie);
#            25 podopiecznych oceniły niezależnie dwie pielęgniarki (rzetelność międzyoceniająca);
#   ankieta własna o źródłach wsparcia: 9 pytań, trafność treściowa oceniana przez 5 ekspertów (trafność 1–4).
library(MASS)
set.seed(6202)
n <- 126
R <- matrix(c(1, .55, -.10, -.35,
              .55, 1, -.05, -.45,
              -.10, -.05, 1, .10,
              -.35, -.45, .10, 1), 4)
L <- mvrnorm(n, rep(0, 4), R)                       # EMO, ORG, wiedza, samodzielność chorego
colnames(L) <- c("emo", "org", "wiedza", "samodz")

progi5 <- c(-1.5, -0.55, 0.35, 1.25)
lik <- function(f, l) findInterval(l * f + rnorm(length(f), 0, sqrt(1 - l^2)), progi5) + 1
lam <- c(.78, .74, .60, .70, .66, .72,   .72, .58, .70, .68, .55, .66)
koo <- sapply(1:12, function(j) lik(L[, if (j <= 6) "emo" else "org"], lam[j]))
colnames(koo) <- paste0("o", 1:12)
odwr <- c("o3", "o8", "o11")
koo[, odwr] <- 6 - koo[, odwr]                      # surowe odpowiedzi na pozycje odwrócone

trud <- seq(-2.4, 0.6, length.out = 16); a <- rep(c(1.2, 1.6, 2.0, 1.4), 4)
two <- sapply(1:16, function(j) rbinom(n, 1, plogis(a[j] * (1.25 * L[, "wiedza"] - trud[j]))))
colnames(two) <- paste0("w", 1:16)

progi3 <- c(-0.35, 0.75)
ocena <- function(s, sd_bl) sapply(1:10, function(j) findInterval(.85 * s + rnorm(length(s), 0, sd_bl) + (j - 5.5) * 0.06, progi3))
ssc_A <- ocena(L[, "samodz"], .45)                  # pielęgniarka A – wszyscy podopieczni
podpr <- sort(sample(n, 25))                         # 25 podopiecznych oceniła też pielęgniarka B
ssc_B <- ocena(L[podpr, "samodz"] + 0.05, .45)
colnames(ssc_A) <- colnames(ssc_B) <- paste0("s", 1:10)

dane <- data.frame(id = 1:n, koo, two, ssc_A)
oceny_par <- data.frame(id = podpr, A = rowSums(ssc_A[podpr, ]), B = rowSums(ssc_B))

# Trafność treściowa ankiety własnej: 5 ekspertów ocenia trafność 9 pytań na skali 1–4
p_traf <- c(.92, .92, .85, .92, .85, .55, .92, .85, .92)
cvi <- t(sapply(p_traf, function(p) sample(c(3, 4, 2, 1), 5, replace = TRUE, prob = c(p / 2, p / 2, (1 - p) * .7, (1 - p) * .3))))
dimnames(cvi) <- list(paste0("p", 1:9), paste0("ekspert", 1:5))
c(N = nrow(dane), N_oceny_par = nrow(oceny_par))
Wynik w R
          N N_oceny_par
        126          25
2. Wyniki, rzetelność, trafność treściowa i zgodność oceniających
R
# B62 – liczby do wzorów opisu narzędzi (wymaga obiektów z b62-0-dane.R)
suppressPackageStartupMessages({ library(psych); library(lavaan); library(semTools); library(boot) })
opis <- function(x, min_mozl, max_mozl) round(c(M = mean(x), SD = sd(x), min = min(x), max = max(x),
  proc_min = 100 * mean(x == min_mozl), proc_max = 100 * mean(x == max_mozl)), 2)
omega1 <- function(x) { m <- paste("F =~", paste(names(x), collapse = " + "))
  as.numeric(compRelSEM(cfa(m, data = x, std.lv = TRUE))[[1]]) }

# 1. KOO-12 [fikcyjny]: przekodowanie pozycji odwróconych (max + min − x = 6 − x) i wyniki podskal (średnie 1–5)
k <- dane[, paste0("o", 1:12)]
k[, odwr] <- 6 - k[, odwr]
emo <- paste0("o", 1:6); org <- paste0("o", 7:12)
dane$EMO <- rowMeans(k[, emo]); dane$ORG <- rowMeans(k[, org]); dane$KOO <- rowMeans(k)
rbind(EMO = opis(dane$EMO, 1, 5), ORG = opis(dane$ORG, 1, 5), KOO = opis(dane$KOO, 1, 5))
set.seed(6203)
rzet <- function(x) {
  a <- alpha(x, check.keys = FALSE, warnings = FALSE)
  b <- boot(x, function(d, i) omega1(d[i, ]), R = 500)
  round(c(alfa = a$total$raw_alpha, alfa_lo = a$feldt$lower.ci[[1]], alfa_hi = a$feldt$upper.ci[[1]],
          omega = b$t0, omega_lo = boot.ci(b, type = "perc")$percent[4], omega_hi = boot.ci(b, type = "perc")$percent[5],
          r_poz_min = min(a$item.stats$r.drop), r_poz_max = max(a$item.stats$r.drop)), 4)
}
r_emo <- rzet(k[, emo]); r_org <- rzet(k[, org])
round(rbind(EMO = r_emo, ORG = r_org), 3)
round(alpha(k, check.keys = FALSE, warnings = FALSE)$total$raw_alpha, 3)            # alfa całego KOO-12
# Pozycje odwrócone bez przekodowania – kontrola (ujemne korelacje pozycja–reszta)
round(alpha(dane[, emo], check.keys = FALSE, warnings = FALSE)$item.stats["o3", "r.drop"], 2)

# Struktura dwuczynnikowa we własnej próbie (CFA, pozycje porządkowe, WLSMV)
m_cfa <- cfa("EMO =~ o1 + o2 + o3 + o4 + o5 + o6\nORG =~ o7 + o8 + o9 + o10 + o11 + o12",
         data = k, std.lv = TRUE, ordered = TRUE, estimator = "WLSMV")
dop <- fitMeasures(m_cfa, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.scaled", "tli.scaled",
                           "rmsea.scaled", "rmsea.ci.lower.scaled", "rmsea.ci.upper.scaled", "srmr"))
noquote(formatC(dop, format = "f", digits = 3))                                    # RMSEA z 90% CI
noquote(c(chi2 = formatC(dop[["chisq.scaled"]], format = "f", digits = 2)))         # chi-kwadrat do zapisu APA
std <- standardizedSolution(m_cfa)
round(range(std$est.std[std$op == "=~"]), 2)
round(std$est.std[std$op == "~~" & std$lhs == "EMO" & std$rhs == "ORG"], 2)

# 2. Test wiedzy TWO-16 (opracowanie własne): suma punktów 0–16, KR-20 = alfa dla pozycji 0/1
w <- dane[, paste0("w", 1:16)]
dane$TWO <- rowSums(w)
opis(dane$TWO, 0, 16)
a_w <- alpha(w, check.keys = FALSE, warnings = FALSE)
round(c(KR20 = a_w$total$raw_alpha, lo = a_w$feldt$lower.ci[[1]], hi = a_w$feldt$upper.ci[[1]]), 3)
round(range(colMeans(w)), 2)                                                        # łatwość pytań (odsetek poprawnych)
round(range(a_w$item.stats$r.drop), 2)                                              # moc różnicująca: r pozycja–reszta

# 3. Skala kliniczna SSC [fikcyjna]: suma 0–20 (wyższy wynik = większa samodzielność)
dane$SSC <- rowSums(dane[, paste0("s", 1:10)])
opis(dane$SSC, 0, 20)
round(alpha(dane[, paste0("s", 1:10)], check.keys = FALSE, warnings = FALSE)$total$raw_alpha, 3)
icc <- ICC(oceny_par[, c("A", "B")])$results
icc[icc$type == "ICC2", c("ICC", "lower bound", "upper bound")] |> round(3)          # dwuczynnikowy losowy, zgodność bezwzględna, jedna ocena
round(c(M_roznicy = mean(oceny_par$B - oceny_par$A), zgodne_dokladnie = sum(oceny_par$A == oceny_par$B)), 2)

# 4. Trafność treściowa ankiety własnej: I-CVI (odsetek ekspertów z oceną 3 lub 4) i S-CVI
icvi <- rowMeans(cvi >= 3)
round(icvi, 2)
round(c(S_CVI_Ave = mean(icvi), S_CVI_UA = mean(icvi == 1)), 2)
names(icvi)[icvi < .78]

# 5. Trafność teoretyczna KOO-12 we własnej próbie: obciążenie a samodzielność podopiecznego
ct <- function(x, y) { t <- cor.test(x, y); c(round(c(r = unname(t$estimate), lo = t$conf.int[1], hi = t$conf.int[2]), 3), p = signif(t$p.value, 3)) }
rbind(EMO_SSC = ct(dane$EMO, dane$SSC), ORG_SSC = ct(dane$ORG, dane$SSC))

# 6. Wartości w zapisie do tekstu (dwa miejsca po kropce, bez zera wiodącego)
bz <- function(x) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = 2))
przedzial <- function(e, lo, hi) paste0(bz(e), " [", bz(lo), ", ", bz(hi), "]")
c(EMO_alfa = przedzial(r_emo["alfa"], r_emo["alfa_lo"], r_emo["alfa_hi"]),
  EMO_omega = przedzial(r_emo["omega"], r_emo["omega_lo"], r_emo["omega_hi"]),
  ORG_alfa = przedzial(r_org["alfa"], r_org["alfa_lo"], r_org["alfa_hi"]),
  ORG_omega = przedzial(r_org["omega"], r_org["omega_lo"], r_org["omega_hi"]),
  KR20 = przedzial(a_w$total$raw_alpha, a_w$feldt$lower.ci[[1]], a_w$feldt$upper.ci[[1]]),
  ICC = with(icc[icc$type == "ICC2", ], przedzial(ICC, `lower bound`, `upper bound`)))
c(TWO_max_n = sum(dane$TWO == 16), SSC_min_n = sum(dane$SSC == 0), SSC_max_n = sum(dane$SSC == 20))
Wynik w R
       M   SD  min  max proc_min proc_max
EMO 3.22 0.83 1.00 4.83     0.79        0
ORG 3.11 0.73 1.67 4.67     0.00        0
KOO 3.17 0.69 1.42 4.75     0.00        0
     alfa alfa_lo alfa_hi omega omega_lo omega_hi r_poz_min r_poz_max
EMO 0.850   0.805   0.887 0.850    0.800    0.885     0.561     0.703
ORG 0.748   0.673   0.811 0.756    0.685    0.808     0.319     0.607
[1] 0.859
[1] -0.6
         chisq.scaled             df.scaled         pvalue.scaled            cfi.scaled
               87.465                53.000                 0.002                 0.960
           tli.scaled          rmsea.scaled rmsea.ci.lower.scaled rmsea.ci.upper.scaled
                0.950                 0.072                 0.044                 0.098
                 srmr
                0.070
 chi2
87.47
[1] 0.51 0.79
[1] 0.69
       M       SD      min      max proc_min proc_max
   10.60     4.28     1.00    16.00     0.00    11.11
 KR20    lo    hi
0.887 0.857 0.914
[1] 0.36 0.93
[1] 0.40 0.68
       M       SD      min      max proc_min proc_max
    9.41     6.14     0.00    20.00     7.14     4.76
[1] 0.949
boundary (singular) fit: see help('isSingular')
                       ICC lower bound upper bound
Single_random_raters 0.957       0.906       0.981
       M_roznicy zgodne_dokladnie
            0.32             8.00
 p1  p2  p3  p4  p5  p6  p7  p8  p9
0.8 1.0 0.6 1.0 1.0 0.8 1.0 1.0 1.0
S_CVI_Ave  S_CVI_UA
     0.91      0.67
[1] "p3"
             r     lo     hi        p
EMO_SSC -0.370 -0.512 -0.209 1.97e-05
ORG_SSC -0.372 -0.514 -0.211 1.79e-05
        EMO_alfa        EMO_omega         ORG_alfa        ORG_omega             KR20
".85 [.81, .89]" ".85 [.80, .89]" ".75 [.67, .81]" ".76 [.69, .81]" ".89 [.86, .91]"
             ICC
".96 [.91, .98]"
TWO_max_n SSC_min_n SSC_max_n
       14         9         6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork, a plik Word w pakiecie officer. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- boot (wersja 1.3.32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents (R package version 0.7.4) [Computer software]. https://doi.org/10.32614/CRAN.package.officer
Najczęstsze pytania
Jak opisać kwestionariusz w pracy licencjackiej?
Podaj pełną nazwę i skrót, autorów oryginału i polskiej adaptacji, co mierzy kwestionariusz, liczbę pozycji i podskal, skalę odpowiedzi z etykietami krańców, numery pozycji odwróconych, sposób liczenia wyniku z zakresem oraz rzetelność z adaptacji i z własnej próby. Na końcu napisz, za czyją zgodą użyłeś narzędzia. Gotowe wzory dla czterech typów narzędzi są w sekcjach Wzór 1–Wzór 4.
Czy w opisie narzędzia trzeba podać rzetelność z własnego badania?
Tak. Rzetelność jest właściwością wyników w konkretnej próbie, dlatego JARS–Quant zaleca podawać współczynniki oszacowane we własnych danych, a wartości z innych badań uzupełniać opisem tamtych prób (Appelbaum i in., 2018). Najlepiej podaj wartość z 95% przedziałem ufności.
Jak opisać ankietę własnego autorstwa w rozdziale metodologicznym?
Napisz, na jakiej podstawie ułożyłeś pytania, ile ich jest i jakiego są rodzaju, kto ocenił ich trafność (np. eksperci i wskaźnik CVI) i czy sprawdziłeś zrozumiałość w pilotażu lub wywiadach poznawczych. Dodaj, co liczysz z odpowiedzi. Jeśli pytania nie tworzą skali, wyjaśnij, dlaczego nie podajesz wyniku sumarycznego ani alfy Cronbacha.
Czy w opisie kwestionariusza można przytoczyć przykładową pozycję?
Przy narzędziach z domeny publicznej tak, z cytowaniem źródła. Przy testach chronionych prawem autorskim na przytoczenie nawet jednej pozycji potrzebujesz zgody właściciela praw (International Test Commission, 2014). Bezpieczniej opisz temat pozycji własnymi słowami, np. „pozycje dotyczą poczucia braku czasu dla siebie”.
Jak opisać test wiedzy w pracy z pielęgniarstwa?
Podaj podstawę merytoryczną pytań, liczbę i rodzaj pytań, sposób punktowania (np. 1 punkt za poprawną odpowiedź, 0 za błędną i „nie wiem”), zakres wyniku, rzetelność KR-20 oraz zakres łatwości pytań. Jeśli dużo osób ma wynik maksymalny, napisz o efekcie sufitu. Szczegóły analizy są w poradniku ankieta wiedzy – analiza krok po kroku.
Co napisać o trafności narzędzia, jeśli sam jej nie badałem?
Przytocz dowody zebrane przez autorów adaptacji: jaką metodą potwierdzili strukturę, z jakimi miarami i jak silnie korelował wynik, na jakiej próbie. Nie pisz ogólnie, że narzędzie „jest trafne”. Jeśli w Twoich danych jest zmienna, z którą wynik powinien się wiązać według teorii, podaj tę korelację jako dodatkowy dowód z własnej próby.
Powiązane hasła
Przeczytaj też
Rozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikWzór raportowania alfy Cronbacha
Gotowe zdania i tabela APA: podskale, niska alfa, pozycje odwrócone, skala adaptowana, porównanie z podręcznikiem – z plikiem .docx.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →Nie wiesz, co napisać o narzędziach w swojej pracy?
Policzymy rzetelność narzędzi w Twojej próbie, sprawdzimy sposób liczenia wyników i wyjaśnimy, jak je opisać, tak żebyś umiał(a) obronić rozdział metodologiczny.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Beatty, P. C., & Willis, G. B. (2007). Research synthesis: The practice of cognitive interviewing. Public Opinion Quarterly, 71(2), 287–311. https://doi.org/10.1093/poq/nfm006 ● Otwarty dostęp
- Flake, J. K., & Fried, E. I. (2020). Measurement schmeasurement: Questionable measurement practices and how to avoid them. Advances in Methods and Practices in Psychological Science, 3(4), 456–465. https://doi.org/10.1177/2515245920952393 ● Otwarty dostęp: pełny tekst
- Flake, J. K., Pek, J., & Hehman, E. (2017). Construct validation in social and personality research: Current practice and recommendations. Social Psychological and Personality Science, 8(4), 370–378. https://doi.org/10.1177/1948550617693063
- International Test Commission. (2014). ITC statement on the use of tests and other assessment instruments for research purposes (Version 1.2). https://www.intestcom.org/files/statement_using_tests_for_research.pdf ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Kuder, G. F., & Richardson, M. W. (1937). The theory of the estimation of test reliability. Psychometrika, 2(3), 151–160. https://doi.org/10.1007/bf02288391
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Polit, D. F. (2014). Getting serious about test–retest reliability: A critique of retest research and some recommendations. Quality of Life Research, 23(6), 1713–1720. https://doi.org/10.1007/s11136-014-0632-9
- Polit, D. F., & Beck, C. T. (2006). The content validity index: Are you sure you know what’s being reported? Critique and recommendations. Research in Nursing & Health, 29(5), 489–497. https://doi.org/10.1002/nur.20147
- Polit, D. F., Beck, C. T., & Owen, S. V. (2007). Is the CVI an acceptable indicator of content validity? Appraisal and recommendations. Research in Nursing & Health, 30(4), 459–467. https://doi.org/10.1002/nur.20199
- Pracownia Testów Psychologicznych PTP. (b.d.). Kwestie dotyczące legalności używania testów psychologicznych. Pobrano 25 października 2026 z https://practest.com.pl/kwestie-dotyczace-legalnosci-uzywania-testow-psychologicznych ● Otwarty dostęp
- Terwee, C. B., Bot, S. D. M., de Boer, M. R., van der Windt, D. A. W. M., Knol, D. L., Dekker, J., Bouter, L. M., & de Vet, H. C. W. (2007). Quality criteria were proposed for measurement properties of health status questionnaires. Journal of Clinical Epidemiology, 60(1), 34–42. https://doi.org/10.1016/j.jclinepi.2006.03.012 ● Otwarty dostęp
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{beatty2007research, author={Beatty, Paul C. and Willis, Gordon B.}, title={{Research synthesis: The practice of cognitive interviewing}}, journal={Public Opinion Quarterly}, year={2007}, volume={71}, number={2}, pages={287--311}, doi={10.1093/poq/nfm006}}@article{flake2020measurement, author={Flake, Jessica Kay and Fried, Eiko I.}, title={{Measurement schmeasurement: Questionable measurement practices and how to avoid them}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={456--465}, doi={10.1177/2515245920952393}}@article{flake2017construct, author={Flake, Jessica K. and Pek, Jolynn and Hehman, Eric}, title={{Construct validation in social and personality research: Current practice and recommendations}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={370--378}, doi={10.1177/1948550617693063}}@techreport{itc2014statement, author={{International Test Commission}}, title={{ITC statement on the use of tests and other assessment instruments for research purposes}}, year={2014}, institution={International Test Commission}, url={https://www.intestcom.org/files/statement_using_tests_for_research.pdf}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{kuder1937theory, author={Kuder, G. F. and Richardson, M. W.}, title={{The theory of the estimation of test reliability}}, journal={Psychometrika}, year={1937}, volume={2}, number={3}, pages={151--160}, doi={10.1007/bf02288391}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{polit2014getting, author={Polit, Denise F.}, title={{Getting serious about test–retest reliability: A critique of retest research and some recommendations}}, journal={Quality of Life Research}, year={2014}, volume={23}, number={6}, pages={1713--1720}, doi={10.1007/s11136-014-0632-9}}@article{polit2006content, author={Polit, Denise F. and Beck, Cheryl Tatano}, title={{The content validity index: Are you sure you know what’s being reported? Critique and recommendations}}, journal={Research in Nursing \& Health}, year={2006}, volume={29}, number={5}, pages={489--497}, doi={10.1002/nur.20147}}@article{polit2007cvi, author={Polit, Denise F. and Beck, Cheryl Tatano and Owen, Steven V.}, title={{Is the CVI an acceptable indicator of content validity? Appraisal and recommendations}}, journal={Research in Nursing \& Health}, year={2007}, volume={30}, number={4}, pages={459--467}, doi={10.1002/nur.20199}}@misc{ptpndlegalnosc, author={{Pracownia Testów Psychologicznych PTP}}, title={{Kwestie dotyczące legalności używania testów psychologicznych}}, url={https://practest.com.pl/kwestie-dotyczace-legalnosci-uzywania-testow-psychologicznych}}@article{terwee2007quality, author={Terwee, Caroline B. and Bot, Sandra D. M. and de Boer, Michael R. and van der Windt, Daniëlle A. W. M. and Knol, Dirk L. and Dekker, Joost and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{Quality criteria were proposed for measurement properties of health status questionnaires}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={1}, pages={34--42}, doi={10.1016/j.jclinepi.2006.03.012}}